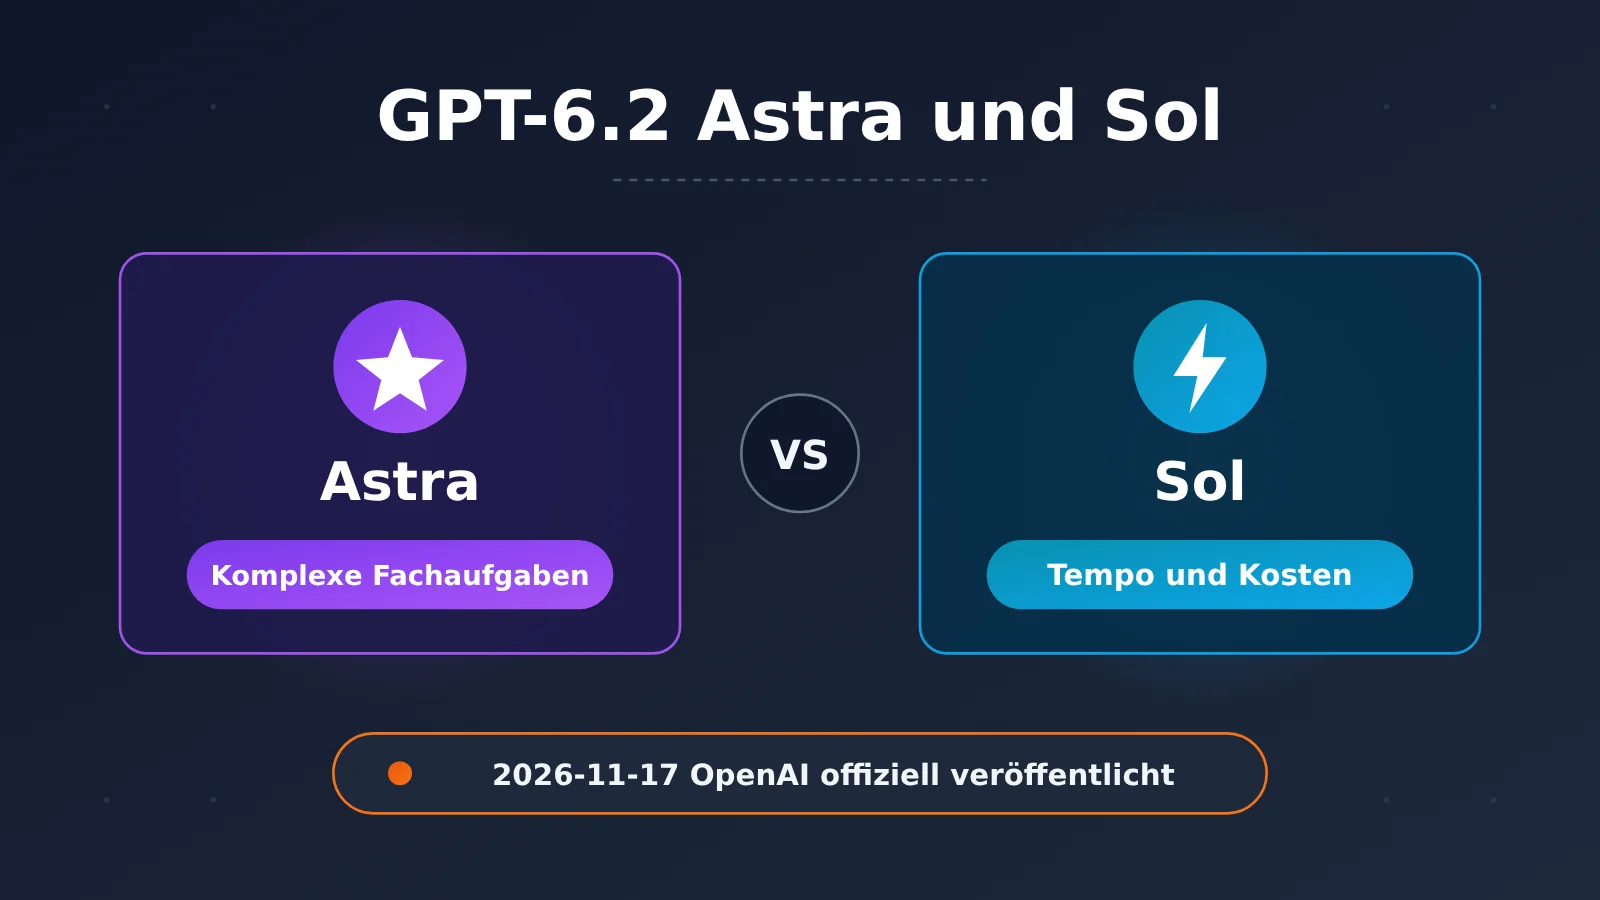
Direkte Antwort: OpenAI hat am 17. November 2026 GPT-6.2 Astra und GPT-6.2 Sol veröffentlicht. Dem offiziellen Bericht zufolge haben beide auf GDPval v2 gegenüber ihren jeweiligen Vorgängern zugelegt; Astra benötigt außerdem 22 % weniger Ausgabe-Tokens.Für die Auswahl gilt: Bei komplexen, hochwertigen professionellen Aufgaben, bei denen Fehler teuer werden können, solltest du vorrangig Astra wählen; bei häufigen Aufgaben, die auf Geschwindigkeit und Kosten empfindlich reagieren, vorrangig Sol. Zu beachten ist, dass diese Runde nur schrittweise für ChatGPT Work, Codex und die API geöffnet wird; normale ChatGPT-Unterhaltungen gehören nicht zum Umfang dieser Runde. Wenn du also nur normales ChatGPT verwendest, musst du deine Arbeitsweise wegen dieser Veröffentlichung vorerst nicht anpassen.
Was du aus diesem Artikel mitnimmst
- Veröffentlichungszeitpunkt, offizielle Quellen und Zugangswege von GPT-6.2 Astra und Sol.
- Was die offiziell veröffentlichten Daten zu GDPval v2, ALE und FrontierCode 2.0 jeweils belegen – und was nicht.
- Die Grenzen der Eingabe- und Ausgabefähigkeiten beider Modelle sowie die offizielle Standardpreisstruktur der API.
- Wie normale Nutzer und Entwickler jeweils zwischen Astra und Sol wählen sollten.
Gliederung: Weiter unten erklärt zunächst eine Begriffstabelle die Terminologie – etwa Benchmark-Namen und Cache-Abrechnung; danach zeigt ein Kurzüberblick über die Auswirkungen, was diese Veröffentlichung für verschiedene Zielgruppen bedeutet. Der erste Hauptteil stellt die offiziellen Fakten gebündelt dar, einschließlich 1.1 Rollout-Umfang, 1.2 offizielle Evaluierungen, 1.3 Fähigkeitsgrenzen und 1.4 Preise. Der zweite Teil ist eine redaktionelle Einschätzung: welche praktische Bedeutung das Upgrade hat, wie sich die beiden Modelle die Aufgaben teilen, Empfehlungen zur Auswahl und Methoden zur Prüfung der Integration.
Zum Einstieg: Diese Begriffe zuerst verstehen
Die folgenden Begriffe tauchen in den offiziellen Unterlagen und in diesem Artikel auf. Wer ihre Bedeutung kennt, vermeidet Fehlinterpretationen bei Evaluierungsdaten und Preisen.
| Konzept | Kurze Erklärung |
|---|---|
| GPT-6.2 Astra | Modell aus dieser Veröffentlichung, das eher auf komplexe Fachaufgaben ausgerichtet ist; der offizielle API-Preis ist höher |
| GPT-6.2 Sol | Modell aus dieser Veröffentlichung, das eher auf Geschwindigkeit und Kosten ausgerichtet ist; der offizielle API-Preis beträgt etwa ein Viertel von Astra |
| GDPval v2 | Eine der offiziell von OpenAI verwendeten Evaluierungen; die zentralen Vergleichsdaten von Astra und Sol in dieser Veröffentlichung stammen aus ihr |
| ALE | Eine weitere Evaluierung aus dem offiziellen Bericht; diesmal wurde nur der Verbesserungswert von Astra veröffentlicht |
| FrontierCode 2.0 | Eine Programmier-Evaluierung aus dem offiziellen Bericht; sie dient diesmal dem Vergleich des Unterschieds zwischen Sol und Astra auf der max-Reasoning-Stufe |
| Prozentpunkte | Die Differenz zwischen zwei Prozentwerten; beispielsweise entspricht ein Anstieg von 50% auf 56.2% einer Verbesserung um 6.2 Prozentpunkte |
| Reasoning-Stufe (max) | Eine konfigurierbare Stufe der Reasoning-Intensität des Modells; max steht für die Einstellung mit dem höchsten Reasoning-Aufwand |
| Ausgabe-Token | Die Abrechnungseinheit für den vom Modell erzeugten Inhalt; je knapper die Ausgabe, desto niedriger sind in der Regel die Kosten |
| Cache-Lesen | Der Teil, der bei einem Cache-Treffer für wiederverwendete Eingabeaufforderungsinhalte zu einem niedrigeren Preis abgerechnet wird |
| Cache-Schreiben | Geschriebene Token werden zum Schreibtarif der jeweiligen Aufbewahrungsdauer abgerechnet; dieselben Token werden nicht erneut mit der normalen Eingabegebühr belegt |
| 272K-Langkontext-Schwelle | Wenn die Eingabe einer einzelnen Anfrage etwa 272.000 Token überschreitet, wird die gesamte Anfrage zu einem höheren Tarif abgerechnet |
| ChatGPT Work | OpenAI-ChatGPT-Produkt für Arbeitsszenarien; einer der Einstiegspunkte, die in dieser Runde eingeführt wurden |
| Codex | OpenAI-Produkt für Programmier-Szenarien; einer der Einstiegspunkte, die in dieser Runde eingeführt wurden |
Kurzüberblick: Wie GPT-6.2 Astra und Sol verschiedene Nutzergruppen betreffen
- Reguläre ChatGPT-Nutzer: Der reguläre Chat gehört in dieser Runde nicht zum Rollout-Umfang – die tägliche Nutzungserfahrung ändert sich kurzfristig also nicht direkt.
- ChatGPT-Work-Nutzer: Sie erhalten im Rahmen der schrittweisen Freigabe Zugang zum neuen Modell. Die wichtigste Entscheidung wird sein, welche Aufgaben sie Astra und welche sie Sol überlassen.
- Codex-Nutzer und Programmierer: Die offiziellen Daten von FrontierCode 2.0 zeigen, dass Sol in diesem Test dicht an Astra herankommt – ein Vergleich auf der eigenen Codebasis lohnt sich.
- API-Entwickler: Die Preise der beiden Modelle unterscheiden sich deutlich, hinzu kommen Caching und die Abrechnungsregeln für den langen Kontext mit 272K. Modell-Routing und Prompt-Design wirken sich direkt auf die Rechnung aus.
- Kreative, die Videogenerierung brauchen: Das neue Modell nimmt Text und Bilder als Eingabe und gibt Text aus; es ist kein natives Videogenerierungsmodell, solche Anforderungen sind also nicht direkt betroffen.
1. Die objektiven Fakten zur Veröffentlichung von GPT-6.2 Astra und Sol
Dieser Abschnitt enthält ausschließlich offiziell veröffentlichte Informationen. Alle Benchmark-Daten in diesem Artikel stammen aus dem offiziellen OpenAI-Bericht und sind nicht von unserem APIYI-Team selbst gemessen – wir haben weder eigene Benchmarks durchgeführt noch Interviews geführt.
1.1 Veröffentlichungszeitpunkt und Verfügbarkeit von GPT-6.2 Astra und Sol
OpenAI hat am 17. November 2026 GPT-6.2 Astra und Sol auf einer offiziellen Seite veröffentlicht. Die Informationen in diesem Artikel wurden am 18. November 2026 geprüft. Die offizielle Release-Seite, die Dokumentation im Hilfe-Center und die Modellseite für Entwickler sind derzeit die direktesten Informationsquellen; die genauen Adressen finden Sie in den Referenzen am Ende des Artikels.
| Information | Details |
|---|---|
| Veröffentlichungszeitpunkt | 17. November 2026 |
| Herausgeber | OpenAI |
| Veröffentlichte Modelle | GPT-6.2 Astra, GPT-6.2 Sol |
| Zugangswege | ChatGPT Work, Codex, API; schrittweise Freigabe |
| Nicht im aktuellen Umfang | Normale ChatGPT-Unterhaltung (Chat) |
| Eingabemodalitäten | Text, Bilder |
| Ausgabemodalitäten | Text |
| Offizielle Quellen | openai.com Release-Seite, help.openai.com Hilfedokumentation, developers.openai.com Modellseite |
„Schrittweise Freigabe“ bedeutet, dass nicht alle Konten die neuen Modelle am Veröffentlichungstag sehen können. Wenn Sie in ChatGPT Work oder Codex vorübergehend keinen Zugang finden, ist das ein normales Phänomen der gestaffelten Einführung. Hinweise dazu finden Sie in der offiziellen Hilfedokumentation.
1.2 GPT-6.2 Astra und Sol: die offiziellen Evaluationsdaten
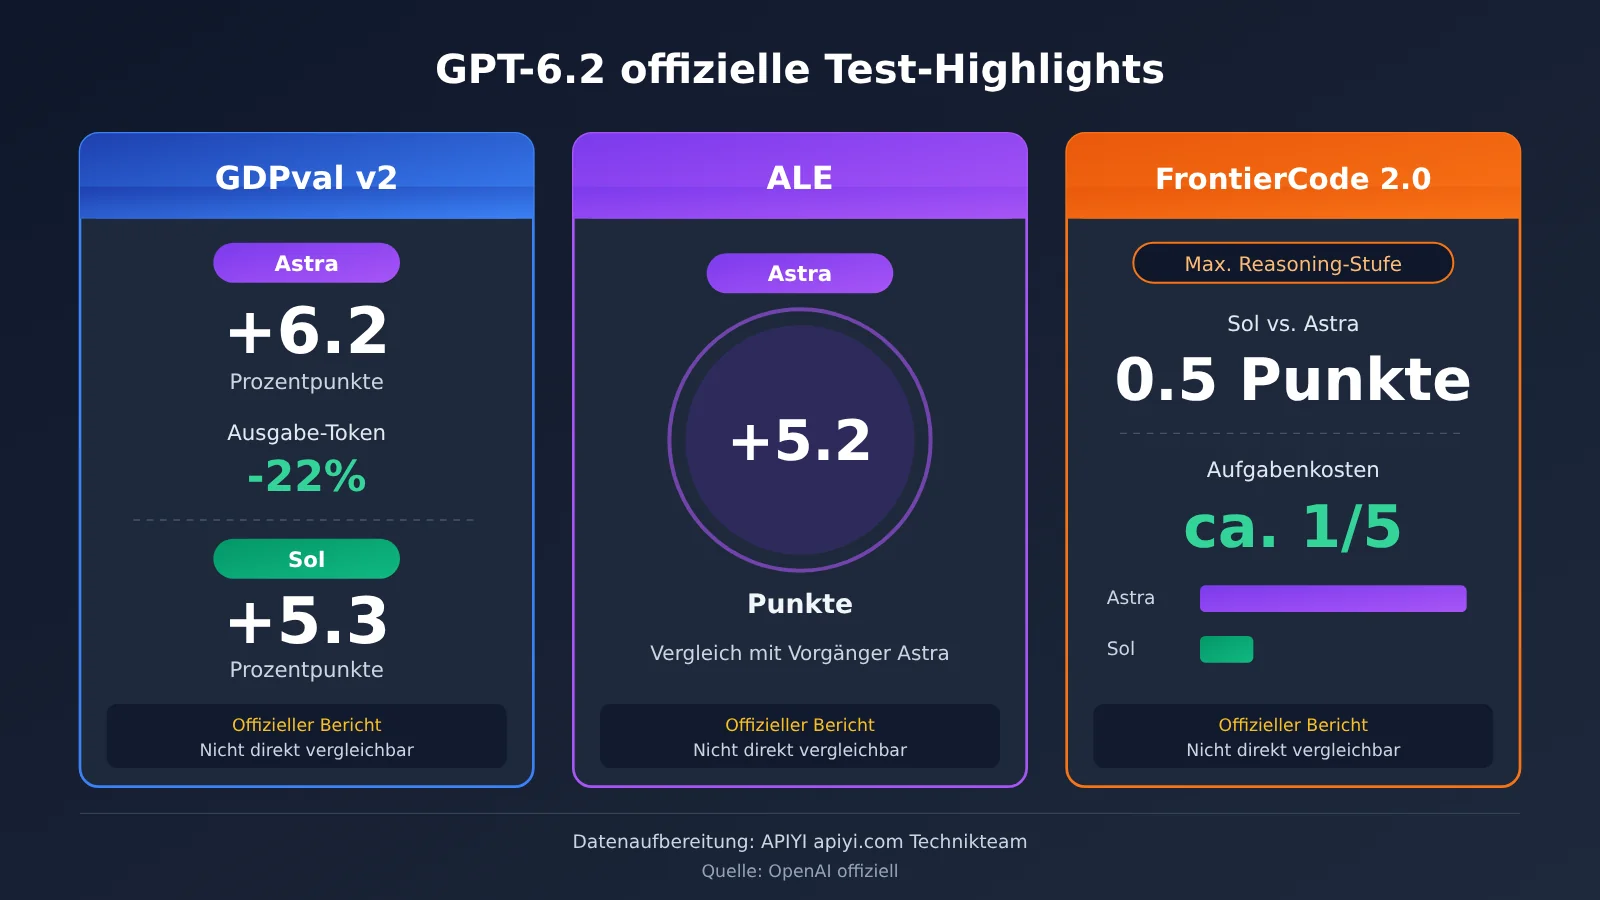
Der offizielle Bericht nennt drei Datengruppen. Sie stammen aus unterschiedlichen Evaluierungen und beziehen sich jeweils auf andere Vergleichsobjekte – man darf sie deshalb nicht über einen Kamm scheren. Die folgende Tabelle gibt sie in der ursprünglichen Form wieder.
| Evaluierung | Modell | Ergebnis im offiziellen Bericht | Vergleichsobjekt |
|---|---|---|---|
| GDPval v2 | GPT-6.2 Astra | +6,2 Prozentpunkte, 22 % weniger Ausgabe-Token | GPT-6 Astra |
| GDPval v2 | GPT-6.2 Sol | +5,3 Prozentpunkte | GPT-6.1 Sol |
| ALE | GPT-6.2 Astra | +5,2 Punkte | vorherige Astra-Generation |
FrontierCode 2.0 (Reasoning-Stufe max) |
GPT-6.2 Sol | Abstand zu Astra unter 0,5 Punkten, Aufgabenkosten etwa 1/5 von Astra | GPT-6.2 Astra |
Dazu drei Anmerkungen. Erstens: Astra und Sol haben bei GDPval v2 unterschiedliche Vorgängermodelle als Vergleichsbasis – Astra wird gegen GPT-6 Astra gemessen, Sol gegen GPT-6.1 Sol. Die Zahlen 6,2 und 5,3 lassen sich daher nicht direkt dahingehend vergleichen, wer den größeren Fortschritt gemacht hat. Zweitens: ALE rechnet in „Punkten“, GDPval v2 in „Prozentpunkten“ – Einheiten und Evaluierungsmethoden unterscheiden sich. Drittens: Die Aussage zu FrontierCode 2.0 gilt nur für die max-Reasoning-Stufe dieses Tests. OpenAI behauptet weder, dass Sol bei allen Aufgaben innerhalb von 0,5 Punkten an Astra heranreicht, noch, dass Sol in allen Szenarien nur ein Fünftel der Kosten verursacht.
1.3 Die Grenzen der Fähigkeiten von GPT-6.2 Astra und Sol
Laut den offiziellen Modellunterlagen akzeptieren beide Modelle Text und Bilder als Eingabe, die Ausgabe ist Text. Das heißt: Sie können Bilder lesen, Screenshots analysieren, Diagramme verstehen und dann in Textform eine Antwort oder Code liefern – sie sind aber selbst keine nativen Videogenerierungsmodelle.
Wenn Sie Videos erzeugen möchten, bietet diese Veröffentlichung dafür keine direkte Möglichkeit. Wenn Sie Materialien lesen, Berichte schreiben, Code schreiben oder mehrstufige Analysen durchführen möchten, betrifft Sie dieses Upgrade deutlich stärker.
1.4 Die offiziellen Standard-API-Preise von GPT-6.2 Astra und Sol
Die offizielle Entwicklerseite zum Modell nennt die Standardpreise, angegeben pro Million Token. Die folgenden Preise sind die offiziellen Preise und stellen keine Angebote von Drittanbieterplattformen dar.
| Abrechnungsposten | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Nicht gecachte Eingabe | $8 | $2 |
| Cache-Lesen | $0,4 | $0,1 |
| Ausgabe | $40 | $10 |
| Cache-Schreiben | Wird nach dem Schreibtarif der jeweiligen Aufbewahrungsfrist abgerechnet, ohne zusätzliche normale Eingabegebühr | Wird nach dem Schreibtarif der jeweiligen Aufbewahrungsfrist abgerechnet, ohne zusätzliche normale Eingabegebühr |
| Bei Eingabe über 272K | Eingabe- und Cache-Tarife der gesamten Anfrage ×2, Ausgabe ×1,5 | Eingabe- und Cache-Tarife der gesamten Anfrage ×2, Ausgabe ×1,5 |
Bei der Cache-Abrechnung nicht doppelt summieren. Die Eingabemenge sollte in vier sich gegenseitig ausschließende Teile aufgeteilt werden: normale Eingabe, Cache-Lesen, 30-Minuten-Cache-Schreiben und 12-Stunden-Cache-Schreiben; normale Eingabemenge = Gesamteingabemenge − Cache-Lesemenge − sämtliche Cache-Schreibmengen. Jeder Teil wird mit dem entsprechenden Tarif multipliziert, und dieselben geschriebenen Token werden nicht zusätzlich zum normalen Eingabepreis berechnet. Beispielsweise liegt bei Astra im Standard-Kurzkontext der 30-Minuten-Schreibpreis bei $10 pro Million Token – das ist der vollständige Schreibtarif für diesen Teil und nicht etwa $10 zusätzlich zum normalen Eingabepreis von $8. Offizielle Hinweise zur Cache-Abrechnung
Die 272K-Regel verdient besondere Beachtung. Sie gilt nicht nur für den überschreitenden Teil, sondern sobald die Eingabe einer einzelnen Anfrage 272K Token übersteigt, verdoppeln sich die Eingabe- und Cache-Tarife der gesamten Anfrage, und der Ausgabetarif steigt auf das 1,5-Fache. Wer gewohnt ist, die gesamte Wissensdatenbank auf einmal in das Kontextfenster zu packen, könnte am Ende eine Rechnung bekommen, die deutlich höher ausfällt als erwartet.
2. Analyse und Einschätzung zu GPT-6.2 Astra und Sol
Die folgenden Ausführungen sind eine Interpretation des APIYI-Redaktionsteams auf Basis der zuvor genannten offiziellen Fakten. Sie sind weder offizielle Schlussfolgerungen noch Ergebnisse unserer eigenen Tests. Aussagen zu Trends sind Einschätzungen; bitte überprüfen Sie sie im Kontext Ihrer eigenen Aufgaben.
2.1 Was wurde bei GPT-6.2 Astra und Sol diesmal verbessert?
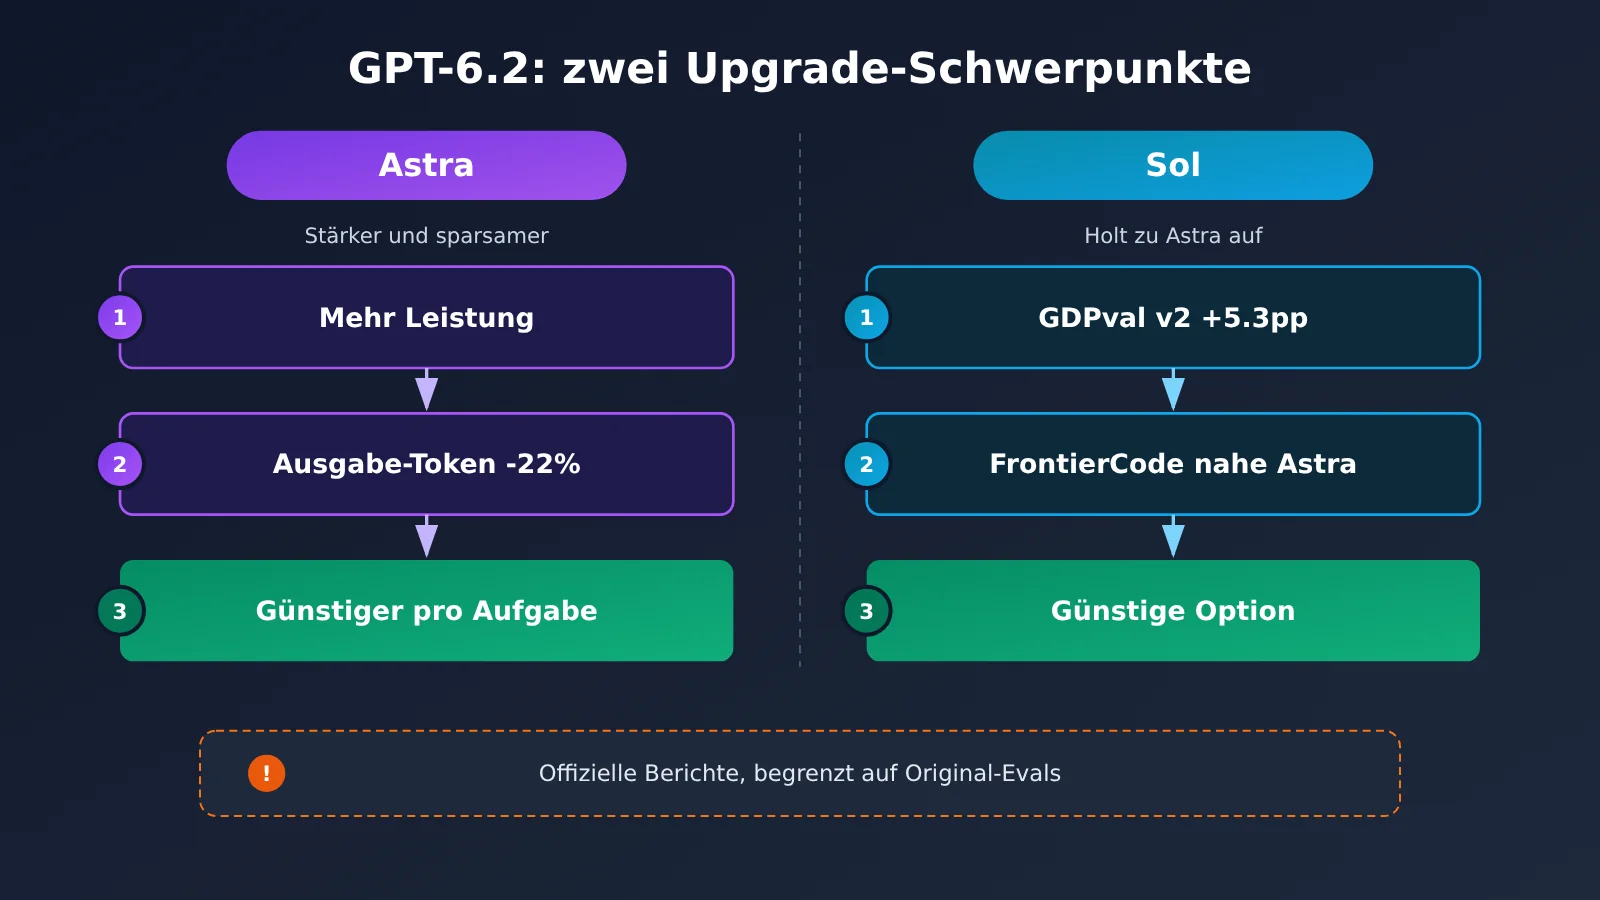
Den offiziellen Daten zufolge lassen sich die Änderungen dieses Upgrades in zwei Hauptlinien zusammenfassen. Die eine ist Astra: „stärker und sparsamer“ – auf GDPval v2 ein Plus von 6,2 Prozentpunkten bei gleichzeitig 22 % weniger Ausgabe-Tokens. Die 22 % beziehen sich auf die Veränderung des Ausgabe-Token-Verbrauchs in dieser Evaluierung und lassen sich nicht direkt auf die sichtbare Länge jeder Antwort oder die Einsparungsquote übertragen.
Die andere ist Sols „Heranrücken“. Ein Plus von 5,3 Prozentpunkten auf GDPval v2 und ein Abstand von weniger als 0,5 Punkten zu Astra in der Max-Inferenzstufe von FrontierCode 2.0 zeigen, dass die offizielle Seite Sol zu einer Option mit solider Leistung und deutlich niedrigerem Preis positioniert. Allerdings stützt sich die Einschätzung des „Heranrückens“ derzeit nur auf einen einzelnen Programmier-Test; ob sie auch für Aufgaben wie Schreiben, Analyse und lange Dokumente gilt, muss mit weiteren Daten belegt werden.
2.2 Die Positionierung und Arbeitsteilung von GPT-6.2 Astra und Sol
Die folgende Tabelle stellt die beiden Modelle entlang derselben Dimensionen gegenüber. Die Spalte „Geeignete Szenarien“ ist eine redaktionelle Einschätzung, die sich aus dem Preis und der Ausrichtung der offiziellen Evaluierungen ableitet; sie bedeutet nicht, dass das jeweils andere Modell in diesem Szenario völlig unbrauchbar wäre.
| Dimension | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Ausrichtungstendenz | Komplexe, professionelle, hochwertige Aufgaben | Geschwindigkeits- und kostenkritische Aufgaben |
| Offizieller Preis (Eingabe/Ausgabe) | $8 / $40 | $2 / $10 |
| Offizielle Evaluierungs-Highlights | GDPval v2 +6.2 Prozentpunkte, Ausgabe-Token -22%, ALE +5.2 Punkte | GDPval v2 +5.3 Prozentpunkte, FrontierCode 2.0 max-Stufe liegt innerhalb von 0.5 Punkten zu Astra |
| Geeignete Szenarien (redaktionelle Einschätzung) | Kritische Berichte, komplexe Code-Refactorings, mehrstufige Schlussfolgerungen, Entscheidungshilfen mit hohen Fehlerkosten | Batch-Verarbeitung, alltägliche Q&A, routinemäßige Programmierung, hochfrequente Aufrufe, Prototypenvalidierung |
| Worauf zu achten ist | Hoher Stückpreis, Kostensteigerung bei langem Kontext deutlicher | Programmier-Tests kommen nah an Astra heran, lässt sich nicht auf alle Aufgaben extrapolieren |
| Zugriffswege | ChatGPT Work, Codex, offizielle API; bei Drittanbieter-Aggregatoren wie APIYI apiyi.com beachten Sie bitte deren Modellliste | Wie links |
Ein leicht zu übersehendes Detail: Nach offizieller Preisliste liegt der Stückpreis von Sol bei etwa 1/4 von Astra, während die Aufgabenkosten in FrontierCode 2.0 etwa 1/5 betragen. Dass beide Werte nicht übereinstimmen, ist normal, denn die Aufgabenkosten hängen auch von der tatsächlich verbrauchten Token-Menge ab. Das erinnert uns auch daran, dass wir beim Kostenvergleich auf „die Gesamtkosten für die Erledigung derselben Aufgabe“ schauen sollten und nicht nur auf den Stückpreis.
Ein Rechenbeispiel nach offizieller Preisliste: Bei einer Anfrage mit 100.000 Eingabe-Token und 10.000 Ausgabe-Token ergibt sich ohne Cache-Nutzung für Astra etwa $0.8 + $0.4 = $1.2 und für Sol etwa $0.2 + $0.1 = $0.3. Die tatsächlichen Kosten variieren je nach Inferenzstufe, Ausgabelänge und Cache-Treffern; eine konkrete Kostenkalkulation wird in diesem Artikel nicht weiter ausgeführt.
2.3 Was sollten normale Nutzer wählen: GPT-6.2 Astra oder Sol?
Für normale Nutzer, die ChatGPT Work verwenden, lässt sich die Entscheidung anhand der „Kosten eines Fehlers“ treffen. Wenn eine Aufgabe bei einem Fehler eine lange Nacharbeit erfordert oder wichtige Entscheidungen beeinflussen kann – etwa das Herausarbeiten von Vertragskernpunkten, komplexe Datenanalysen oder den Entwurf eines offiziellen Berichts –, dann sollte man sie vorrangig Astra überlassen. Wenn die Aufgabe einfach ist, in großer Zahl anfällt und sich das Ergebnis schnell prüfen lässt – etwa das Umformulieren von E-Mails, das Zusammenfassen von Meeting-Notizen oder alltägliche Recherchen –, dann reicht Sol in der Regel aus.
Für Codex-Nutzer liefert die Auswertung von FrontierCode 2.0 eine Richtung, die einen Versuch wert ist: Zuerst Sol für reguläre Entwicklungsaufgaben einsetzen und erst bei modulübergreifendem Refactoring, schwer auffindbaren Bugs oder Architekturdesign auf Astra wechseln. Das ist allerdings nur eine Empfehlung auf Basis einzelner Tests – entscheidend ist letztlich, wie sich die Modelle in deiner eigenen Codebasis schlagen.
Wenn du ChatGPT nur im normalen Dialog verwendest, ist dieser Zugang in dieser Ausrollrunde nicht enthalten. Bis offiziell eine Ausweitung angekündigt wird, musst du für dieses Release nichts vorbereiten.
2.4 Wie Entwickler GPT-6.2 Astra und Sol per API verifizieren
Am zuverlässigsten rufen Entwickler beide Modelle mit derselben Auswahl echter Aufgaben auf und vergleichen Qualität, Latenz und den tatsächlichen Token-Verbrauch. Das folgende Beispiel orientiert sich an der offiziellen SDK-Dokumentation, wurde jedoch noch nicht ausgeführt und verifiziert; es nutzt die offizielle OpenAI-Schnittstelle, die Modell-IDs entnehmen Sie bitte der offiziellen Modellseite. Wenn Sie eine Drittanbieter-Plattform verwenden, prüfen Sie zunächst in der Modellliste der Plattform, ob das Modell dort bereits verfügbar ist – in diesem Artikel wurde die Verfügbarkeit auf keiner Drittanbieter-Plattform überprüft.
import openai

client = openai.OpenAI(
    api_key=__import__("os").environ["OPENAI_API_KEY"]  # Offizielle API, Schlüssel wird über eine Umgebungsvariable bereitgestellt
)

response = client.chat.completions.create(
    model="gpt-6.2-sol",  # Modell-ID gemäß offizieller Modellliste oder Plattform-Modellliste
    messages=[{"role": "user", "content": "用三句话总结这份需求文档的风险点"}]
)
print(response.choices[0].message.content)
Vollständigen Code für den Vergleichsaufruf von Astra und Sol ansehen
import time
import openai

client = openai.OpenAI(
    api_key=__import__("os").environ["OPENAI_API_KEY"]  # Offizielle API, Schlüssel wird über eine Umgebungsvariable bereitgestellt
)

# Modell-IDs gemäß offizieller Modellseite oder Plattform-Modellliste
MODELS = ["gpt-6.2-astra", "gpt-6.2-sol"]

# Durch eigene echte Aufgaben ersetzen, um nicht nur einzelne öffentliche Benchmarks zu betrachten
TASKS = [
    "阅读以下函数并指出潜在的并发问题:...",
    "把这段会议记录整理成 5 条待办事项:...",
]

def run(model: str, prompt: str) -> dict:
    start = time.time()
    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
        )
        usage = resp.usage
        return {
            "model": model,
            "seconds": round(time.time() - start, 2),
            "input_tokens": usage.prompt_tokens,
            "output_tokens": usage.completion_tokens,
            "answer": resp.choices[0].message.content,
        }
    except Exception as e:
        return {"model": model, "error": str(e)}

for task in TASKS:
    for model in MODELS:
        result = run(model, task)
        print(result)
Erfassen Sie dabei zugleich die Gesamtmenge der Eingabe, Cache-Lesevorgänge, die nach Aufbewahrungsfrist unterschiedenen Cache-Schreibvorgänge, die abgerechnete Ausgabe (einschließlich Reasoning) sowie die Tool-Nutzung, und berechnen Sie die Kosten nach den Tarifen des tatsächlichen Anbieters und Service-Tiers; die offiziellen Preise gelten nur für Kostenschätzungen der offiziellen API. Zusätzlich empfiehlt es sich, die Eingabe pro Anfrage unter 272K Token zu halten, damit nicht die gesamte Anfrage einen höheren Tarif auslöst.
🎯 Technischer Hinweis: Wenn Sie mehrere Modelle im selben Code vergleichen möchten, können Sie die OpenAI-kompatible Schnittstelle von APIYI apiyi.com nutzen – mit einem einzigen API-Schlüssel wechseln Sie zwischen gängigen Modellen wie OpenAI, Claude, Gemini und weiteren. Ob die GPT-6.2-Serie bereits auf der Plattform verfügbar ist, entnehmen Sie bitte der Modellliste der Plattform.
2.5 Variablen, die bei GPT-6.2 Astra und Sol künftig beachtet werden sollten
Die erste Variable ist der Ausrollbereich. Der normale Chat ist derzeit nicht Teil dieser Runde, und ob und wann die offizielle Seite den Zugang ausweitet, ist öffentlich nicht bekannt. Das wird entscheiden, wann die meisten normalen Nutzer das neue Modell verwenden können. Die zweite Variable sind Daten zu weiteren Aufgabentypen. Ob Sol auch außerhalb der Programmierung an Astra heranreicht, müssen Dritte und weitere offizielle Evaluierungen beantworten.
Die dritte Variable ist die tatsächliche Kostenentwicklung. Die 22 % weniger Ausgabe-Token bei Astra sind ein Ergebnis auf GDPval v2 und müssen bei Ihren eigenen Aufgaben nicht im gleichen Verhältnis gelten. Es empfiehlt sich, die echten Aufrufdaten kontinuierlich zu erfassen, statt auf Basis der Zahlen aus der Präsentation einmalig eine langfristige Strategie festzulegen.
In den „Gesprächen des Konfuzius · Wei Ling Gong“ heißt es: „Will man seine Arbeit gut verrichten, muss man zuerst seine Werkzeuge schärfen.“
📚 Referenzen
OpenAI API-Änderungsprotokoll (Abgleich des Veröffentlichungsdatums)
-
Offizielle OpenAI-Veröffentlichungsseite: Ankündigung und offizielle Evaluierungen zu GPT-6.2 Astra und Sol
- Link: Offizieller Originaltext
- Erläuterung: Quelle für Veröffentlichungszeitpunkt, GDPval v2, ALE und FrontierCode 2.0
-
OpenAI Help Center: Erläuterungen zu ChatGPT Work und Codex
- Link: Offizieller Originaltext
- Erläuterung: Zugangspunkte und schrittweiser Ausrollbereich
-
OpenAI-Entwicklerdokumentation – GPT-6.2 Astra: Modellinformationen und API-Preise
- Link: Offizieller Originaltext
- Erläuterung: Ein- und Ausgabemodalitäten, Standardpreise, Abrechnungsregeln für lange Kontextfenster
-
OpenAI-Entwicklerdokumentation – GPT-6.2 Sol: Modellinformationen und API-Preise
- Link: Offizieller Originaltext
- Erläuterung: Ein- und Ausgabemodalitäten, Standardpreise, Abrechnungsregeln für lange Kontextfenster
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI auf apiyi.com; weitere Integrationsinformationen finden Sie im Dokumentationszentrum unter docs.apiyi.com