Anmerkung des Autors: Gemini 4 Neon hat vier Denkstufen, standardmäßig ist HIGH aktiv, und Thinking-Token werden zum Ausgabepreis abgerechnet. Dieser Artikel erklärt, welche Stufe für welche Aufgaben passt, und macht klar, warum Sie die Stufenkonfiguration von Carbon nicht einfach auf Neon übertragen sollten.
Nach der Integration von Gemini 4 Neon ist das erste Problem vieler Entwickler nicht die Ergebnisqualität, sondern die Rechnung. Thinking-Token werden zum Ausgabepreis abgerechnet: Je höher die Stufe, desto länger überlegt das Modell, bevor es antwortet, und desto mehr Ausgabe-Token fallen an. Die Empfehlung dieses Artikels lautet: Stufe nach Aufgabe wählen, aufhören, wenn es reicht – so finden Sie die passende Stufe zwischen Ergebnisqualität und Kosten.
Dies ist kein Parameter-Ratgeber nach dem Motto „höher ist immer besser“. Die Google-Cloud-Dokumentation beschreibt die Einsatzszenarien der einzelnen Neon-Stufen bereits sehr konkret. Dieser Artikel stützt sich auf die offizielle Dokumentation, fasst sie in einer Vergleichstabelle zusammen, die Sie direkt für die Konfiguration verwenden können, und ergänzt einige häufige Fehlermeldungen und Verwechslungsfallen.
Kernaussage: Nach dem Lesen dieses Artikels wissen Sie, dass Gemini 4 Neon standardmäßig HIGH verwendet, dass LOW für Klassifizierungs- und Routing-Aufgaben ausreicht und dass XHIGH nur für die anspruchsvollsten Arbeiten gedacht ist – und Sie übertragen Einstellungen aus Carbon oder Antigravity nicht versehentlich auf API-Aufrufe.
Die wichtigsten Punkte zu den Denkstufen von Gemini 4 Neon
Zuerst die entscheidenden Ergebnisse. Alles stammt aus der Gemini 4 Neon-Dokumentation von Google Cloud (Version 2026-11-19) und der aktuellen Modellseite in AI Studio:
| Punkt | Erläuterung | Nutzen für dich |
|---|---|---|
| Vier Denkstufen | LOW, MEDIUM, HIGH, XHIGH, Standard ist HIGH | Ohne Parameter ist bereits eine eher hohe Stufe aktiv – du musst aktiv herunterstufen |
| Alte Parameter führen zu Fehlern | thinking_budget und MINIMAL liefern HTTP 400 |
Beim Migrieren alten Codes müssen die Parameter zwingend geändert werden |
| Abrechnung der Denk-Token | Denk-Token werden zum Preis der Ausgabe-Token berechnet | Die Stufe wirkt sich direkt auf die Kosten auf der Ausgabeseite aus |
| Stufen gelten nicht modellübergreifend | Carbon hat nur drei Stufen, Standard medium; Hydrogen hat wie Neon vier Stufen | Eine Konfiguration lässt sich nicht von einem Modell auf ein anderes kopieren |
| Oberfläche und API unterscheiden sich | „Extra“ in der Antigravity-Oberfläche entspricht xhigh, auch das Kontextlimit ist anders | Vermeide es, vom IDE-Erlebnis auf das API-Verhalten zu schließen |
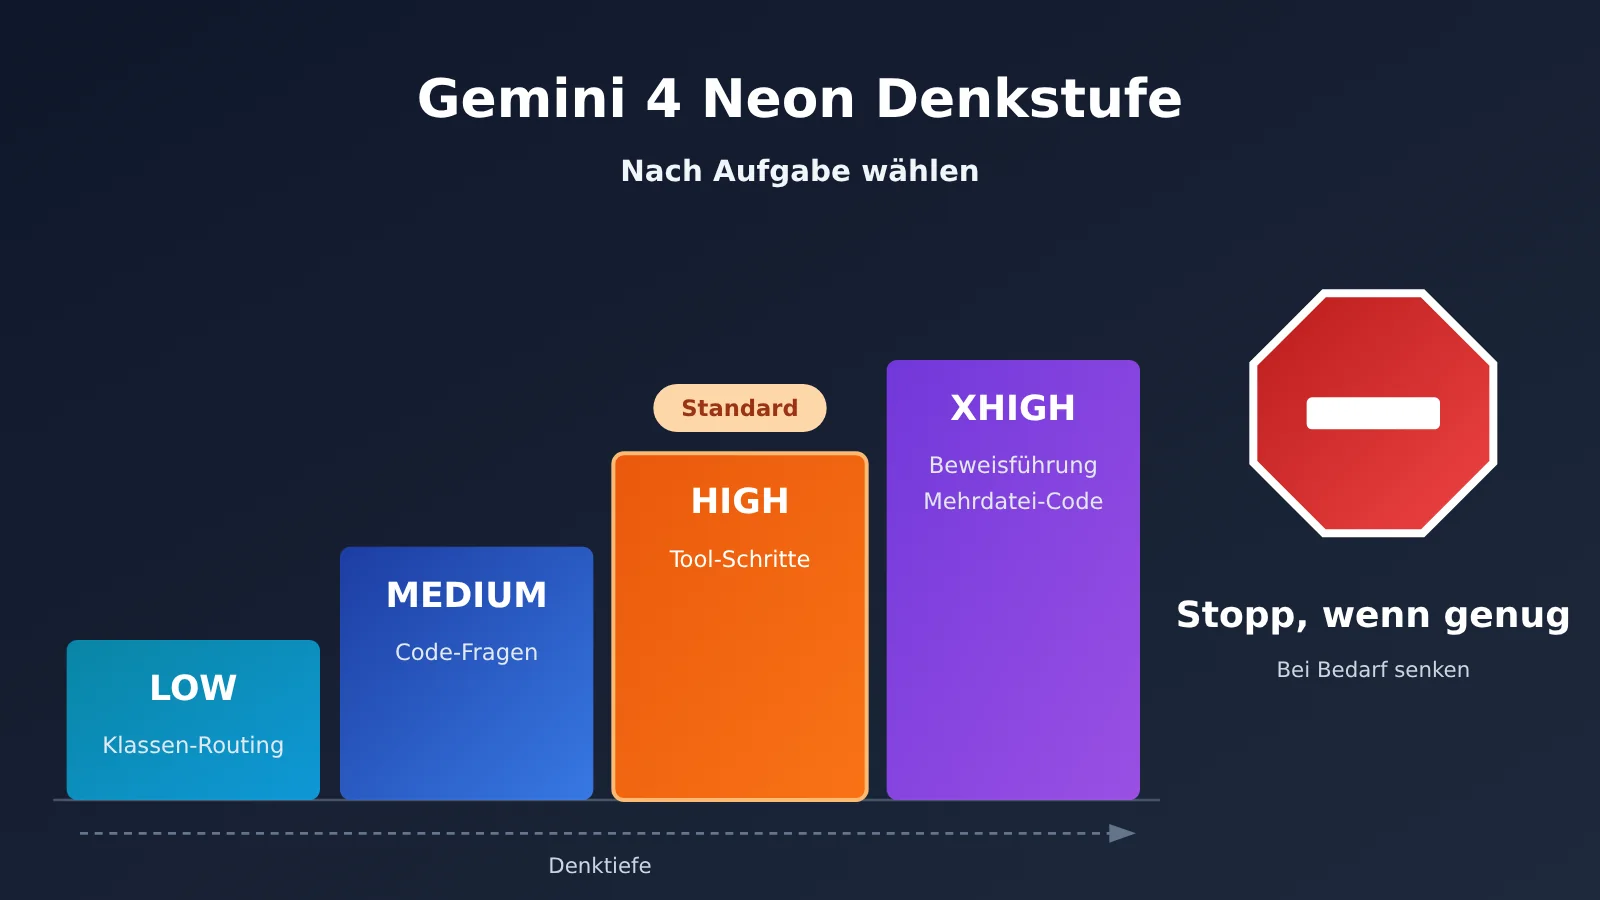
Die vier Denkstufen von Gemini 4 Neon und ihre passenden Aufgaben
Die offizielle Dokumentation nennt für jede Stufe empfohlene Einsatzszenarien. Hier übersichtlich in einer Tabelle, damit du beim Konfigurieren direkt vergleichen kannst:
| Denkstufe | Offiziell empfohlene Szenarien | Typische Beispiele aus der Praxis | Hinweis zur Auswahl |
|---|---|---|---|
LOW |
Klassifizierung, Routing und Zusammenfassungen mit hohem Durchsatz | Tickets mit Tags versehen, Intent-Erkennung, Kernpunkte aus langen Texten ziehen | Bei Batch-Aufgaben bevorzugt diese Stufe wählen |
MEDIUM |
Normales Coding, Fragen zu Dokumenten | Funktionen schreiben, Bugs beheben, Fragen anhand einer Wissensdatenbank beantworten | Für die meisten alltäglichen Entwicklungsanfragen ausreichend |
HIGH (Standard) |
Mehrstufige Tool-Aufrufe, komplexe multimodale Aufgaben | Agent ruft Tools nacheinander auf, gemischte Analyse von Text und Bild | Diese Stufe ist aktiv, wenn kein Parameter übergeben wird |
XHIGH |
Beweise, wissenschaftliche Analysen, schwerste Multi-Datei-Projekte | Mathematische Herleitungen, Analyse experimenteller Daten, Refactoring über mehrere Module hinweg | Nur für die schwersten Aufgaben einsetzen |
Bei dieser Tabelle sind zwei Dinge wichtig. Erstens: Der Standardwert ist HIGH, nicht MEDIUM. Wenn du im Code also gar nichts angibst, denkt jede Klassifizierungsanfrage mit der Intensität eines „mehrstufigen Tool-Aufrufs“ – bei Szenarien mit hohem Durchsatz ist das meist Verschwendung. Zweitens: XHIGH ist die obere Stufe von Neon und für Beweise sowie die schwersten Engineering-Aufgaben gedacht. Alltägliche Coding-Anfragen auf XHIGH zu stellen, bringt in den meisten Fällen nur längere Wartezeiten und mehr Ausgabe-Token.
Warum Gemini 4 Neon rechtzeitig aufhören sollte
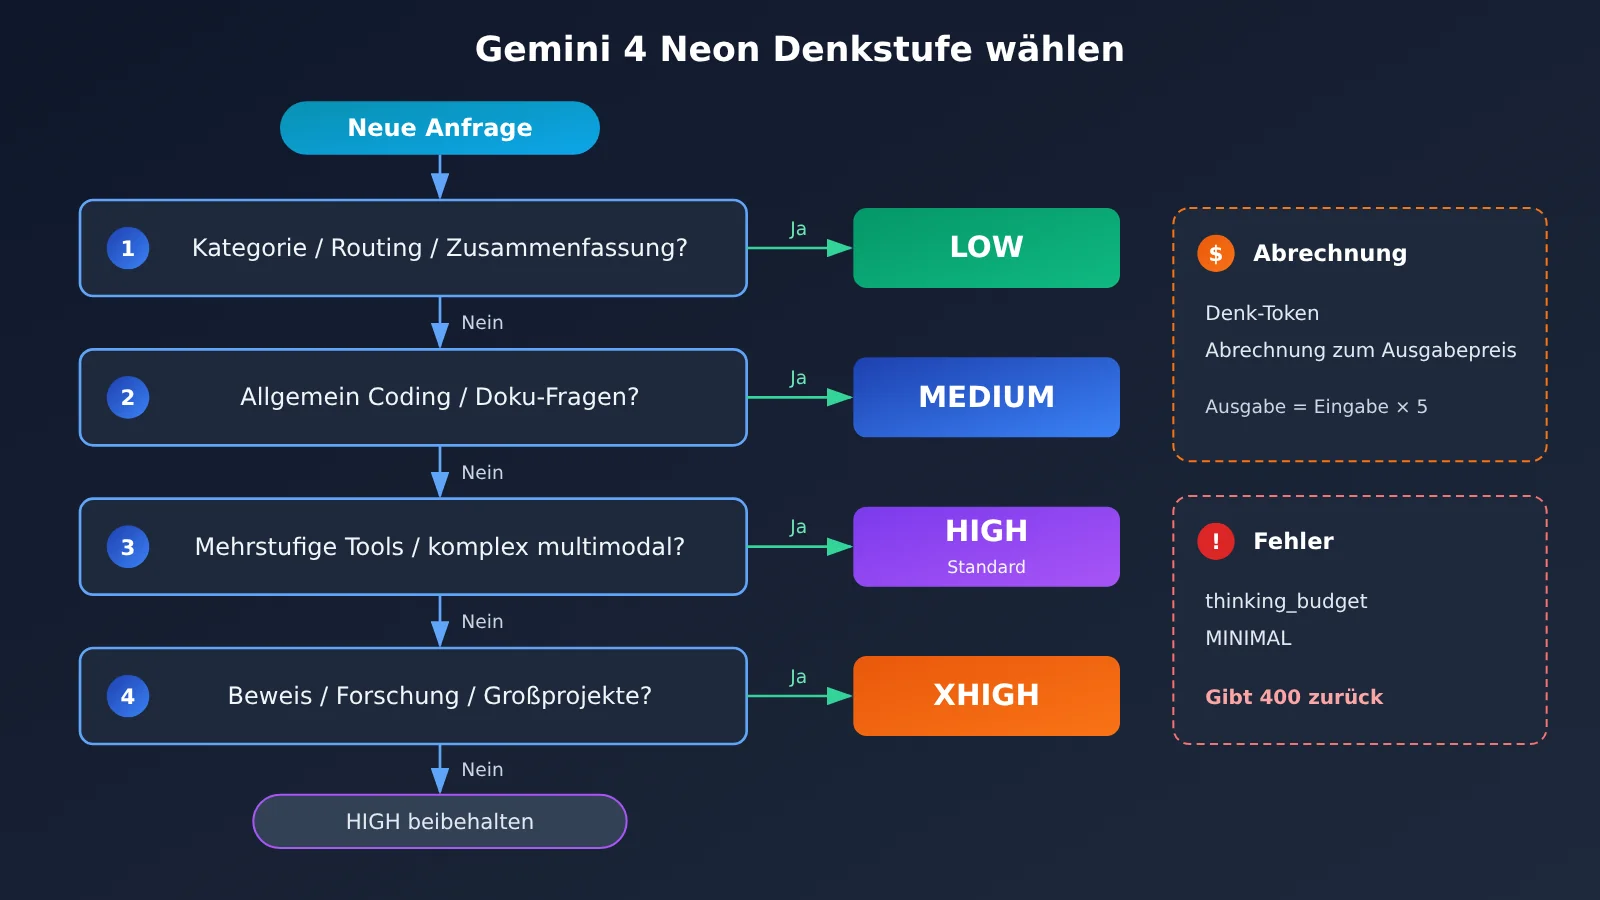
Der Kostenhebel liegt in der Abrechnungslogik. Thinking-Token werden zum Output-Preis abgerechnet, und der Output-Preis von Gemini 4 Neon liegt fünfmal so hoch wie der Input-Preis (Google nennt $3 für Input, $0.15 für Cache und $15 für Output, jeweils pro Million Token). Je mehr gedacht wird, desto größer wird der Anteil der teuersten Token.
Wie viele zusätzliche Thinking-Token jede Stufe kostet, hängt von der Komplexität der Aufgabe ab. Google gibt dafür kein festes Verhältnis an, und dieser Artikel nennt auch keine Zahlen à la „eine Stufe niedriger spart X Euro“. Der pragmatische Weg: die eigenen Beispiele aus dem Geschäftsbetrieb einmal mit LOW und einmal mit dem Standard-HIGH laufen lassen, die zurückgegebenen Output-Token und die Antwortqualität vergleichen und dann entscheiden, ob eine niedrigere Stufe sinnvoll ist.
Schnelleinstieg in die Denkstufen von Gemini 4 Neon
Minimalbeispiel: Klassifizierung mit der LOW-Stufe
APIYI bietet eine OpenAI-kompatible Schnittstelle. Sie können Gemini 4 Neon aufrufen, indem Sie im offiziellen openai Python SDK einfach die base_url ändern. Im Folgenden sind die wichtigsten Code-Schritte beschrieben – jeder davon lässt sich direkt kopieren:
- SDK installieren:
pip install openai - Client erstellen:
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1") - Modell angeben:
model="gemini-4-neon" - Denkstufe festlegen:
reasoning_effort="low" - Anfrage senden:
client.chat.completions.create(model="gemini-4-neon", reasoning_effort="low", messages=[{"role": "user", "content": "Ordnen Sie dieses Ticket ein: Abrechnung / Technik / Sonstiges. Ticketinhalt: …"}]) - Ergebnis auslesen:
resp.choices[0].message.content
Für Klassifizierungsaufgaben wird nur ein Label benötigt – die LOW-Stufe erfüllt die Anforderungen bereits. Wenn Sie stattdessen Code schreiben oder Fragen auf Basis von Dokumenten beantworten möchten, ersetzen Sie einfach Schritt 4 durch reasoning_effort="medium".
Anzumerken ist, dass der Parametername vom verwendeten Schnittstellenformat abhängt. In der nativen Gemini-Schnittstelle wird die Denkstufe im Feld thinking_level von thinking_config angegeben, mit den Werten LOW / MEDIUM / HIGH / XHIGH. Im OpenAI-kompatiblen Format wird die Denkintensität üblicherweise über reasoning_effort übergeben. Die genaue Feldzuordnung entnehmen Sie der Plattformdokumentation; vor dem Go-Live sollten Sie mit einer einzigen Anfrage bestätigen, dass die Stufe tatsächlich wirksam ist.
Vollständige Implementierung anzeigen: Automatische Stufenauswahl nach Aufgabentyp
In der Produktionsumgebung ist es besser, den Geschäftscode die Stufe anhand des Aufgabentyps auswählen zu lassen, statt global einen festen Wert zu setzen. Die Implementierung lässt sich in folgende Schritte gliedern:
1. Zuordnungstabelle definieren: `LEVEL_MAP = {„classify“: „low“, „route“: „low“, „summary“: „low“, „code“: „medium“, „doc_qa“: „medium“, „agent“: „high“, „multimodal“: „high“, „proof“: „xhigh“, „multi_file“: „xhigh“}`
2. Fallback-Wert setzen: `level = LEVEL_MAP.get(task_type, „high“)` – unbekannte Aufgaben verwenden den offiziellen Standard HIGH, sodass die Qualität nicht versehentlich reduziert wird
3. Einheitlicher Client: `client = OpenAI(api_key=os.getenv(„APIYI_KEY“), base_url=“https://api.apiyi.com/v1″)`
4. Aufruf auslösen: `client.chat.completions.create(model=“gemini-4-neon“, reasoning_effort=level, messages=messages)`
5. Verbrauch protokollieren: Schreiben Sie die Anzahl der Ausgabe-Token aus `resp.usage` zusammen mit `task_type` und `level` ins Log, damit sich die Denk-Kosten nach Aufgabentyp auswerten lassen
6. 400-Fehler behandeln: Prüfen Sie nach dem Abfangen der Exception, ob die Anfrage noch `thinking_budget` oder `MINIMAL` enthält – beide Werte führen bei Neon zu einem HTTP 400
Der Fallback-Wert aus Schritt 2 ist wichtig. Wenn die Zuordnungstabelle eine Aufgabe auslässt, ist es besser, mit dem Standard HIGH etwas mehr Token zu verbrauchen, als stillschweigend auf LOW herunterzugehen und fehlerhafte Antworten zu riskieren. Sobald sich über einen längeren Zeitraum Logs angesammelt haben, können Sie die Stufen anhand der Daten aufgabentypweise schrittweise nach unten anpassen.
Empfehlung: Testen Sie zunächst mit einer kleinen Menge echter Geschäftsdaten die Stufen LOW, MEDIUM und den Standard HIGH und entscheiden Sie dann über die Stufe für den Produktivbetrieb. Bei der Registrierung über APIYI apiyi.com erhalten Sie ein kostenloses Testkontingent – mit einem einzigen API-Schlüssel können Sie zwischen Neon, Hydrogen und Carbon wechseln und vergleichen.
Vergleich der Denkstufen von Gemini 4 Neon, Carbon und Hydrogen
Viele stolpern, weil sie annehmen, die Gemini-4-Serie verwende standardmäßig ein einheitliches Set an Stufen. Laut der aktuellen Modellseite in AI Studio ist das nicht der Fall:
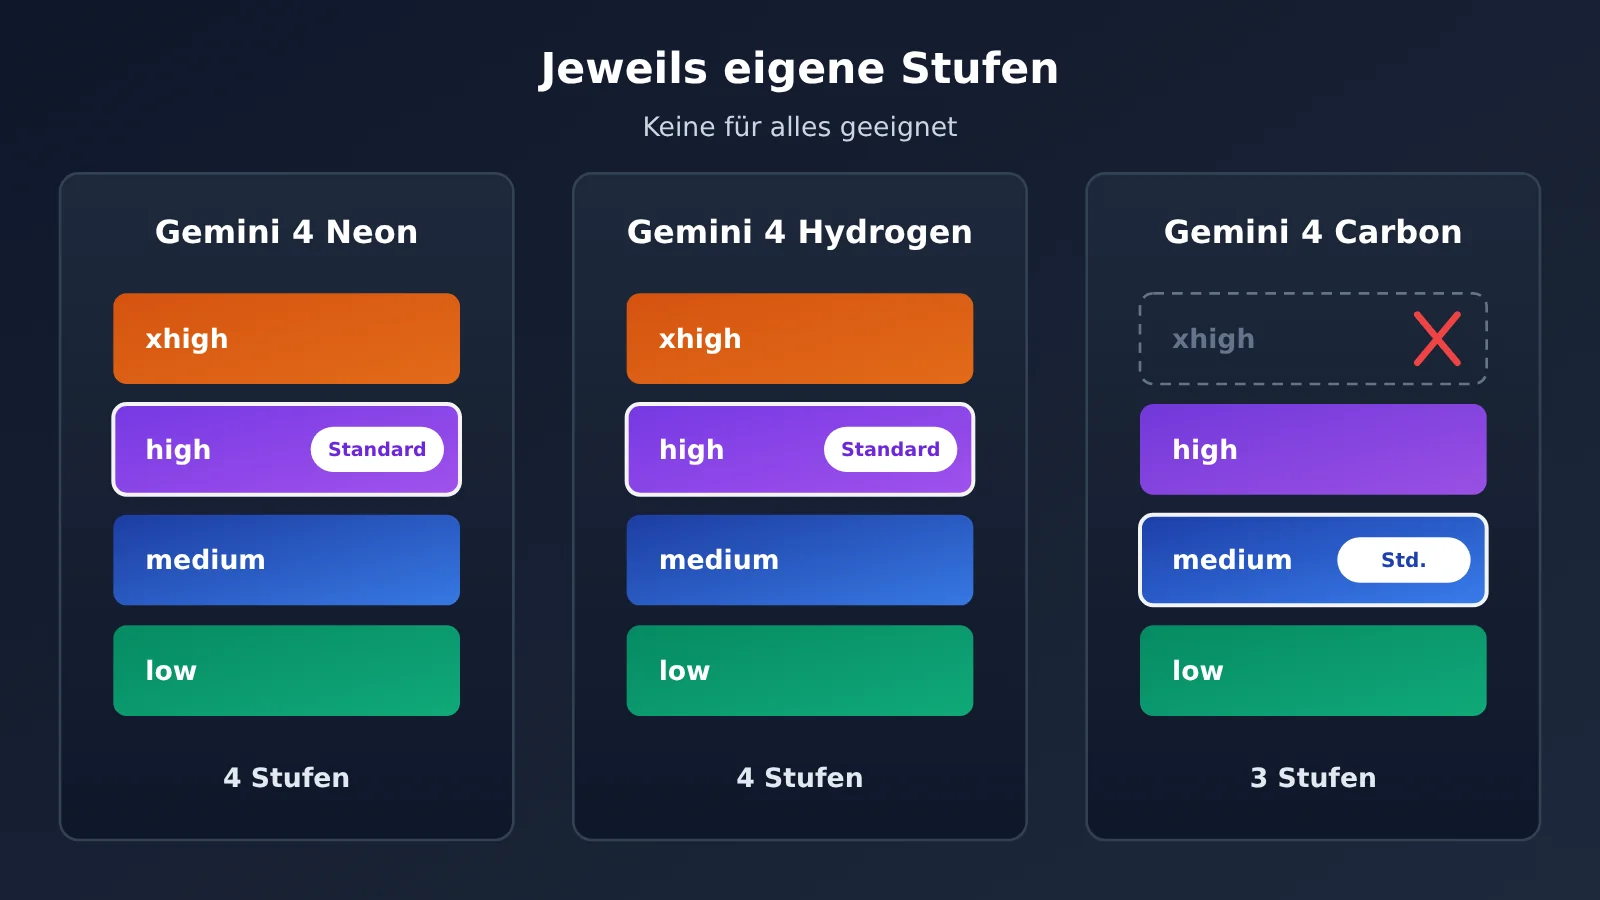
| Modell | Denkstufen | Standardstufe | xhigh verfügbar? | Verfügbare Plattformen |
|---|---|---|---|---|
| gemini-4-neon | low / medium / high / xhigh | high | Ja | APIYI, Google (offiziell) |
| gemini-4-hydrogen | low / medium / high / xhigh | high | Ja | APIYI, Google (offiziell) |
| gemini-4-carbon | low / medium / high | medium | Nein | APIYI, Google (offiziell) |
Die Unterschiede zwischen den Stufen
Carbon im Vergleich: Bei Carbon ist die Standardstufe medium, die höchste Stufe high, und xhigh gibt es nicht. Wenn du eine für Carbon geschriebene Konfiguration (zum Beispiel „standardmäßig medium, bei aufwendigen Aufgaben high“) direkt auf Neon überträgst, landet Neons „aufwendige Aufgabe“ nur auf der mittleren Stufe; Aufgaben, die tatsächlich XHIGH benötigen, erreichen dann nicht die maximale Denkintensität. Umgekehrt liegt xhigh von Neon auch außerhalb des von Carbon unterstützten Wertebereichs, wenn du es an Carbon übergibst.
Hydrogen im Vergleich: Hydrogen hat wie Neon vier Stufen und standardmäßig ebenfalls high. Die Stufenkonfigurationen der beiden können daher als gegenseitige Orientierung dienen. Gleiche Stufennamen bedeuten jedoch nicht, dass Denktiefe und Kosten auf derselben Stufe identisch sind; nach einem Modellwechsel musst du neu bewerten.
Der Fall Antigravity: In der Antigravity-Oberfläche wird xhigh als Extra angezeigt, in der CLI heißt es weiterhin xhigh. Das Kontextlimit liegt bei 512K, während das Kontextfenster der API 1,048,576 Token umfasst – das sind nicht dieselben Fenster. Die Erfahrung in der IDE lässt sich daher nicht direkt nutzen, um das Langkontextverhalten von API-Aufrufen einzuschätzen.
Hinweis zum Vergleich: Alle drei Modelle lassen sich über denselben Endpunkt
https://api.apiyi.com/v1aufrufen; du musst nur das Feldmodeländern. Teste sie jeweils einzeln innerhalb des unterstützten Stufenbereichs und übernimm die Stufenkonfiguration nicht ungeprüft von einem Modell auf ein anderes.
Preis- und Endpunktprüfung für Gemini 4 Neon
Bei der Wahl der Tarifstufe kommt man am Token-Preis nicht vorbei. Die folgende Tabelle zeigt die am 2026-11-20 geprüften APIYI-Preise; alle Angaben in US-Dollar pro Million Token. Es gibt zwei Datenquellen: die Modellübersicht von APIYI apiyi.com unter docs.apiyi.com/models.md (aktualisiert am 2026-11-19 10:59, UTC+8) sowie die Preis-API https://api.apiyi.com/api/pricing (Version shell-api-modelmak-v1, wobei model_ratio von 1 einer Eingabe von $2 pro Million Token entspricht).
| Modell-ID | Eingabe | Cache-Lesen | Ausgabe | Anmerkung |
|---|---|---|---|---|
gemini-4-neon |
$3 |
$0.15 |
$15 |
Preis-API: model_ratio 1.5, completion_ratio 5, cache_ratio 0.05; entspricht dem Google-Listenpreis |
gemini-4-hydrogen |
$1.5 |
$0.075 |
$7.5 |
ebenfalls vier Tarifstufen, Standard: high |
gemini-4-carbon |
$2 |
$0.1 |
$10 |
entspricht dem Einführungspreis von Google bis 2026-11-30; ab dem 1. Dezember gilt bei Google der Standardpreis von $4 für die Eingabe und $20 für die Ausgabe |
Beachten Sie, dass gemini-4-neon in dieser Version der Modellübersicht noch nicht aufgeführt ist, die Preis-API aber bereits einen entsprechenden Eintrag enthält; der umgerechnete Preis stimmt mit der Google-Ankündigung überein. Bei der Preisprüfung sollten Sie sich an der Preis-API orientieren. Bei Neon gilt der Ausgabepreis von $15 auch für Thinking-Token. Je höher die Tarifstufe, desto stärker wirkt sich diese Spalte aus.
Häufig gestellte Fragen (FAQ)
F1: Welche Denkstufen bietet Gemini 4 Neon?
Die Denkstufe bestimmt, wie viel interne Inferenz das Modell vor der finalen Antwort durchführt. Neon bietet vier Stufen – LOW, MEDIUM, HIGH und XHIGH –, Standard ist HIGH. Die durch das Denken erzeugten Token werden zum Ausgabepreis abgerechnet, daher beeinflusst die Stufe sowohl Antwortqualität als auch Kosten.
F2: Worin unterscheiden sich die Denkstufen von Gemini 4 Neon und Carbon?
Carbon hat nur drei Stufen – low, medium, high –, Standard ist medium, xhigh gibt es nicht; Neon hat vier Stufen, Standard ist high. Die Stufensysteme der beiden unterscheiden sich, Konfigurationen lassen sich nicht direkt übernehmen. Hydrogen hat dieselben Stufen wie Neon, also ebenfalls vier, mit Standard high.
F3: Warum gibt meine Gemini 4 Neon-Anfrage HTTP 400 zurück?
Die häufigste Ursache ist, dass in der Anfrage noch der alte Parameter `thinking_budget` verwendet oder die Stufe auf `MINIMAL` gesetzt wird. Die offizielle Dokumentation stellt ausdrücklich klar, dass beide Schreibweisen bei Neon HTTP 400 zurückgeben. Verwenden Sie stattdessen eine Stufe von LOW bis XHIGH.
F4: Für welche Aufgaben eignet sich welche Denkstufe von Gemini 4 Neon?
– **LOW**: Ticket-Klassifizierung, Anfrage-Routing, Stapelzusammenfassung und andere Aufgaben mit hohem Durchsatz
– **MEDIUM**: alltägliches Coding, dokumentbasierte Fragen und Antworten
– **HIGH**: mehrstufige Tool-Aufrufe von Agenten, komplexe multimodale Bild-Text-Analyse
– **XHIGH**: mathematische Beweise, wissenschaftliche Datenanalyse, die schwersten Multi-Datei-Projekte
F5: Wie rufe ich Gemini 4 Neon schnell über die API auf und setze die Denkstufe?
1. Besuchen Sie APIYI unter apiyi.com, registrieren Sie ein Konto und erhalten Sie einen API Key sowie ein kostenloses Testkontingent
2. Setzen Sie die `base_url` des SDK auf `https://api.apiyi.com/v1` und `model` auf `gemini-4-neon`
3. Übergeben Sie die Denkstufe je nach Aufgabentyp, z. B. `low` für Klassifizierungsaufgaben
Mit demselben Key können Sie auch Hydrogen und Carbon aufrufen, um die Ergebnisse innerhalb ihrer jeweiligen Stufenspektren zu vergleichen.
F6: Welche Einschränkungen gibt es beim Festlegen der Denkstufe für Gemini 4 Neon?
– **Kosten**: Denk-Token werden zum Ausgabstarif von `$15` pro Million Token abgerechnet; hohe Stufen erhöhen den Ausgabeverbrauch deutlich
– **Parameter**: `thinking_budget` und `MINIMAL` werden nicht unterstützt
– **Kontext**: Das 512K-Limit in Antigravity und die 1.048.576 bei der API sind nicht dasselbe Fenster
– **Einsparung**: Offiziell gibt es kein festes Verhältnis für den Token-Verbrauch der einzelnen Stufen; messen Sie es anhand Ihrer eigenen Geschäftssamples
F7: Welche Stufe sollte ich wählen, wenn ich die Aufgabenkomplexität nicht kenne?
Behalten Sie das Standard-HIGH bei und protokollieren Sie den Verbrauch an Ausgabe-Token. Wenn die Daten zeigen, dass die Qualität einer Aufgabengruppe unter MEDIUM oder LOW nicht nachlässt, senken Sie die Stufe gezielt für diese Aufgaben. XHIGH als Standardwert zu setzen ist in der Regel unnötig.
Gemini 4 Neon Denkstufen – die wichtigsten Punkte
- Standard ist HIGH: Wird kein Parameter übergeben, denkt Neon bereits mit der Intensität für mehrstufige Tool-Aufrufe.
- Für Klassifizierung und Routing: LOW: Bei Aufgaben mit hohem Durchsatz – Tagging, Routing, Zusammenfassungen – empfiehlt die offizielle Dokumentation LOW.
- XHIGH für die schwersten Aufgaben aufsparen: Nur für Beweise, wissenschaftliche Analysen und Multi-File-Engineering.
- Carbon-Konfiguration nicht einfach übernehmen: Carbon hat nur drei Stufen, Standard ist medium, kein xhigh.
- Alte Parameter führen zu Fehlern:
thinking_budgetundMINIMALliefern HTTP 400 zurück. - Denken wird als Output abgerechnet: Je höher die Stufe, desto mehr teure Output-Token.
- Erst testen, dann festlegen: Bei APIYI apiyi.com mit demselben Key verschiedene Stufen in puncto Ergebnisqualität und Verbrauch vergleichen.
Zusammenfassung
Die Kernpunkte zu den Denkstufen von Gemini 4 Neon:
- Stufe nach Aufgabe wählen: LOW für Klassifizierung, Routing und Zusammenfassungen, MEDIUM für Coding und Frage-Antwort, HIGH für mehrstufige Tool-Aufrufe und Multimodal, XHIGH nur für die schwersten Aufgaben
- Vorsicht bei Standardwerten: Standard ist HIGH – bei Aufgaben mit hohem Durchsatz muss man aktiv herunterstufen
- Stufen gelten nicht modellübergreifend: Neon und Hydrogen haben vier Stufen, Carbon drei – jedes Modell wird separat konfiguriert
„Gerade genug ist genug“ heißt: Erst mit der Standardstufe den Betrieb zum Laufen bringen, dann anhand der Output-Token-Logs jede Kategorie schrittweise herunterstufen – statt alle Anfragen von Anfang an auf Maximum zu stellen. Empfohlen: Bei APIYI apiyi.com mit dem kostenlosen Kontingent einen Vergleich von LOW, MEDIUM und HIGH durchführen und erst danach die Konfiguration für den Produktivbetrieb festlegen.
📚 Referenzen
-
Google Cloud – Modellhandbuch für Gemini 4 Neon: Denkstufen, Standardstufe, Fehlererläuterungen und passende Einsatzszenarien
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Beschreibung: Hauptgrundlage für die Zuordnung der vier Stufen in diesem Artikel sowie für die Erläuterungen zu HTTP 400 (2026-11-19)
- Link:
-
Aktuelle Modellseite von Google AI Studio: Stufen und Standardwerte von Carbon und Hydrogen
- Link:
aistudio.google.com - Beschreibung: Dient zur Bestätigung der Stufenunterschiede zwischen den verschiedenen Gemini-4-Modellen
- Link:
Autor: APIYI-Team
Technischer Austausch: Falls bei der Konfiguration der Denkstufe von Gemini 4 Neon Probleme auftreten, kontaktieren Sie uns gerne über die Startseite der APIYI-Website.