Hinweis des Autors: Wechselt eine WebRTC-Sitzung von GPT-Live-1.1 in den Standby-Modus, sinkt der Sprachpreis von 0,05 US-Dollar auf 0,02 US-Dollar pro Minute. Dieser Artikel erklärt, wie man das konfiguriert, wie man die Abrechnung prüft und wie viel ein einzelner Anruf tatsächlich sparen kann.
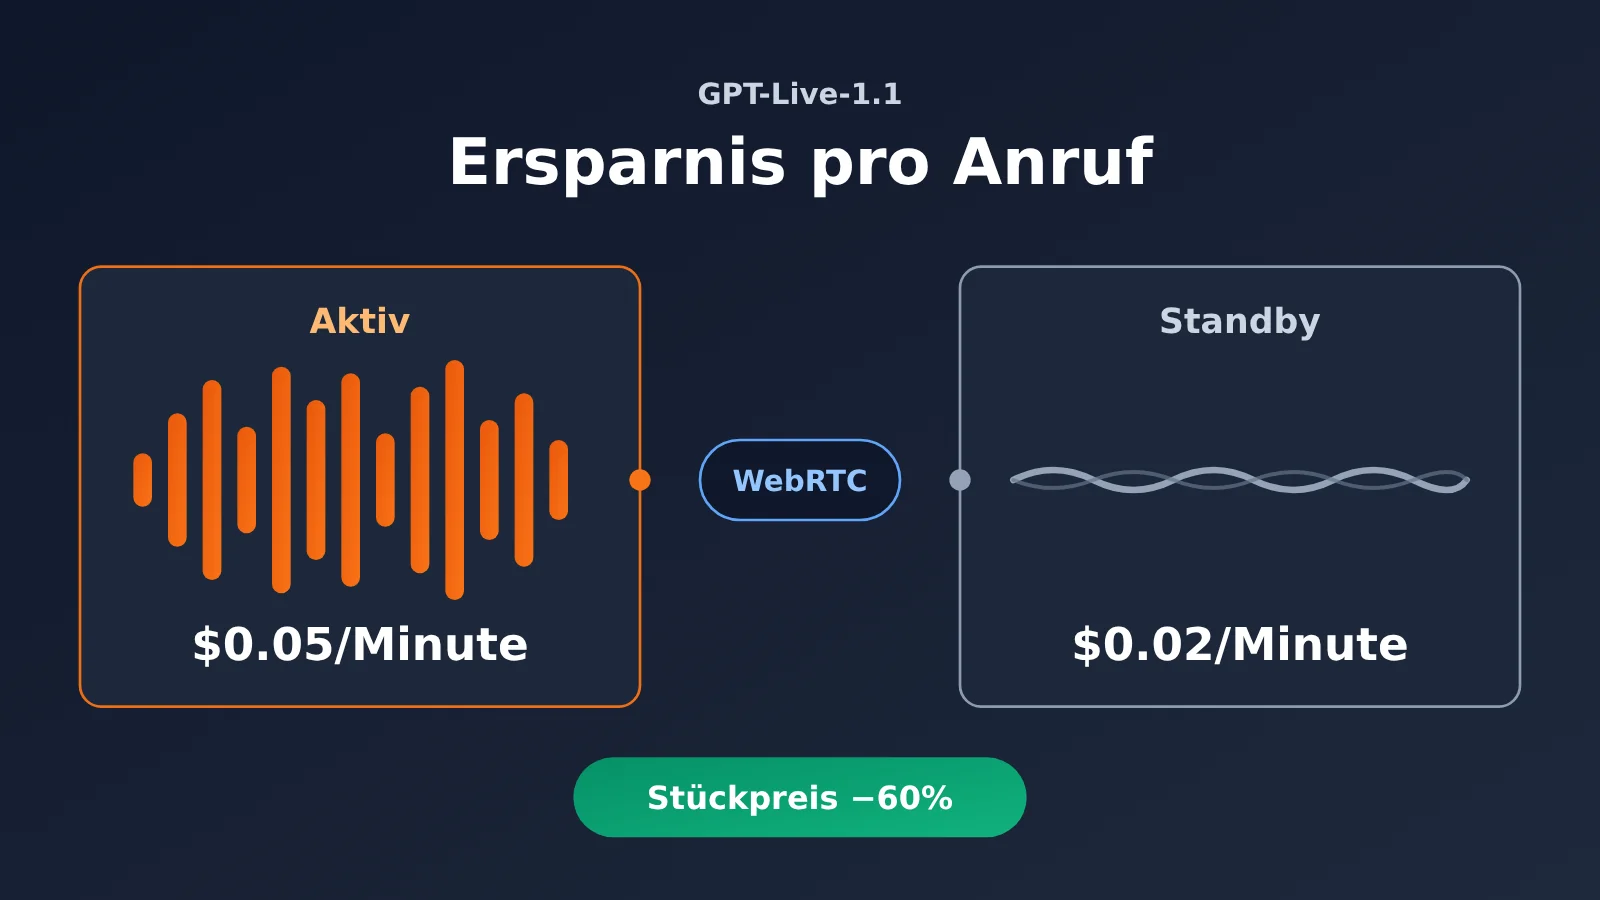
Zusammenfassung in einem Satz: Bei einer WebRTC-Sitzung von GPT-Live-1.1 sinkt der Sprachpreis von 0,05 US-Dollar auf 0,02 US-Dollar pro Minute, sobald die Bedingungen erfüllt sind und die Sitzung in den Standby-Modus wechselt. Wie viel tatsächlich gespart wird, hängt davon ab, wie viel Zeit auf aktiven Betrieb und Standby-Modus entfällt, und auch von der Nutzung der Backend-Modelle und Tools.
Das Fazit gilt nur unter bestimmten Voraussetzungen. Nur in WebRTC-Sitzungen, in denen der Standby-Modus konfiguriert und die Inferenz pausiert ist, gibt es den Standby-Preis von 0,02 US-Dollar pro Minute. Unter dieser Voraussetzung entspricht die Einsparquote ungefähr „Standby-Zeitanteil × 60 %“. Wenn in der Sitzung durchgehend gesprochen wird oder sie über WebSocket bzw. die SIP-Hauptverbindung läuft, lässt sich diese Preissenkung praktisch nicht nutzen. Außerdem werden Backend-Inferenz und Tool-Aufrufe separat abgerechnet; bei langen Anrufen sind diese Kosten oft höher als die Sprachkosten.
Dies ist keine Kurzmeldung, die eine Preistabelle nacherzählt. Im Folgenden schlüssele ich anhand der offiziellen OpenAI-Dokumentation die Abrechnungsbedingungen und Konfigurationsfelder auf und liefere eine nachvollziehbare Berechnungsmethode, mit der sich die Abrechnung prüfen lässt. Die in diesem Artikel genannten Szenariorechnungen sind hypothetisch, dienen nur der Veranschaulichung der Berechnungsmethode und stellen keine echten Abrechnungen dar.
GPT-Live-1.1 WebRTC: Begriffe rund um den Standby (To Know)
Zuerst ein paar Begriffe vereinheitlichen – Abrechnung und Konfiguration weiter unten richten sich nach diesen Definitionen:
- WebRTC: ein Kommunikationsverfahren, mit dem Audio und andere Medien in Echtzeit zwischen Browser und Gerät übertragen werden; zugleich die einzige Übertragungsart, die für den nativen Standby von GPT-Live infrage kommt.
- WebSocket: eine dauerhafte bidirektionale Verbindung. Anwendungen können darüber Audio, Sitzungsereignisse oder Sideband-Steuernachrichten übertragen.
- SIP: das in Telefonnetzen übliche Protokoll zum Aufbau und Steuern von Sitzungen; der Telefonzugang von GPT-Live läuft über diesen Weg.
- Standby: in diesem Artikel ausschließlich der Abrechnungszustand, in dem eine WebRTC-Sitzung, die die Bedingungen erfüllt, verbunden bleibt, aber keine Inferenz mehr stattfindet.
- Aktivzeit: die Phase, die zum Aktivtarif abgerechnet wird – einschließlich der Ruhephase, bis die Pause-Bedingung erreicht ist.
- Sprachaktivierung: der Dienst erkennt, dass jemand spricht, und startet die Inferenz neu bzw. nimmt sie wieder auf.
- Leerlaufschwelle: legt fest, nach welcher Zeit ohne Sprache die Sitzung in den Standby wechselt; der Wert ist konfigurierbar.
- Sideband-Verbindung: eine von der Haupt-Sprachverbindung getrennte Verbindung für Serversteuerung und Ereignisüberwachung, üblicherweise in Form eines Sideband-WebSocket.
GPT-Live-1.1 WebRTC-Bereitschaftsmodus: die wichtigsten Punkte
| Punkt | Beschreibung | Wert für Entwickler |
|---|---|---|
| Zwei Preisstufen | Aktiv $0.05/Minute, qualifizierter WebRTC-Bereitschaftsmodus $0.02/Minute (OpenAI Pricing) | Minutenpreis in ruhigen Phasen sinkt um 60% |
| Sekundengenaue Abrechnung | Beide Tarife werden pro Sekunde abgerechnet, nicht auf volle Minuten aufgerundet | Auch kurze Pausen zählen als Ersparnis |
| Nur WebRTC | Der native günstige Bereitschaftsmodus gilt ausschließlich für WebRTC-Sitzungen, die für Bereitschaft konfiguriert sind und deren Inferenz pausiert ist | Die Kostenfrage muss man schon bei der Wahl des Transportwegs mitdenken |
| Backend separat | Backend-Modell und Tool-Nutzung werden getrennt abgerechnet | Der Bereitschaftsmodus optimiert nur einen Posten der Rechnung |
| Latenz der ersten Antwort | Nach dem Aufwachen aus dem Bereitschaftsmodus kann die erste Antwort auf kurze Spracheingaben langsamer ausfallen | Man muss zwischen Kosten und Erlebnis abwägen |
Was im Nenner der 60% beim GPT-Live-1.1-Bereitschaftsmodus steckt – erklärt an der Abrechnungstabelle
Zuerst zur Datumsfrage. Der OpenAI API Changelog führt dieses Update unter 2026-11-19, die Ankündigungsseite der OpenAI-Entwickler-Community zeigt 2026-11-20. Die Abweichung von einem Tag kommt sehr wahrscheinlich durch unterschiedliche Zeitzonen zustande; bei Datumsangaben nenne ich in diesem Artikel jeweils die Quelle. Laut der OpenAI-Pricing-Seite kosten beide GPT-Live-Modelle im aktiven Sprachbetrieb $0.05/Minute, der qualifizierte WebRTC-Bereitschaftsmodus $0.02/Minute, abgerechnet pro Sekunde, Backend-Modell und Tool-Nutzung separat.
„60% günstiger“ wird oft fälschlich als „die ganze Session kostet 60% weniger“ gelesen. Der Nenner der 60% ist der aktive Minutenpreis: (0.05 − 0.02) ÷ 0.05 = 60%. Das beschreibt nur den Rückgang des Minutenpreises, sobald der Bereitschaftsmodus greift. Der Sparanteil über die gesamte Session ergibt sich erst, wenn man diesen Wert zusätzlich mit dem Anteil der Bereitschaftszeit multipliziert.
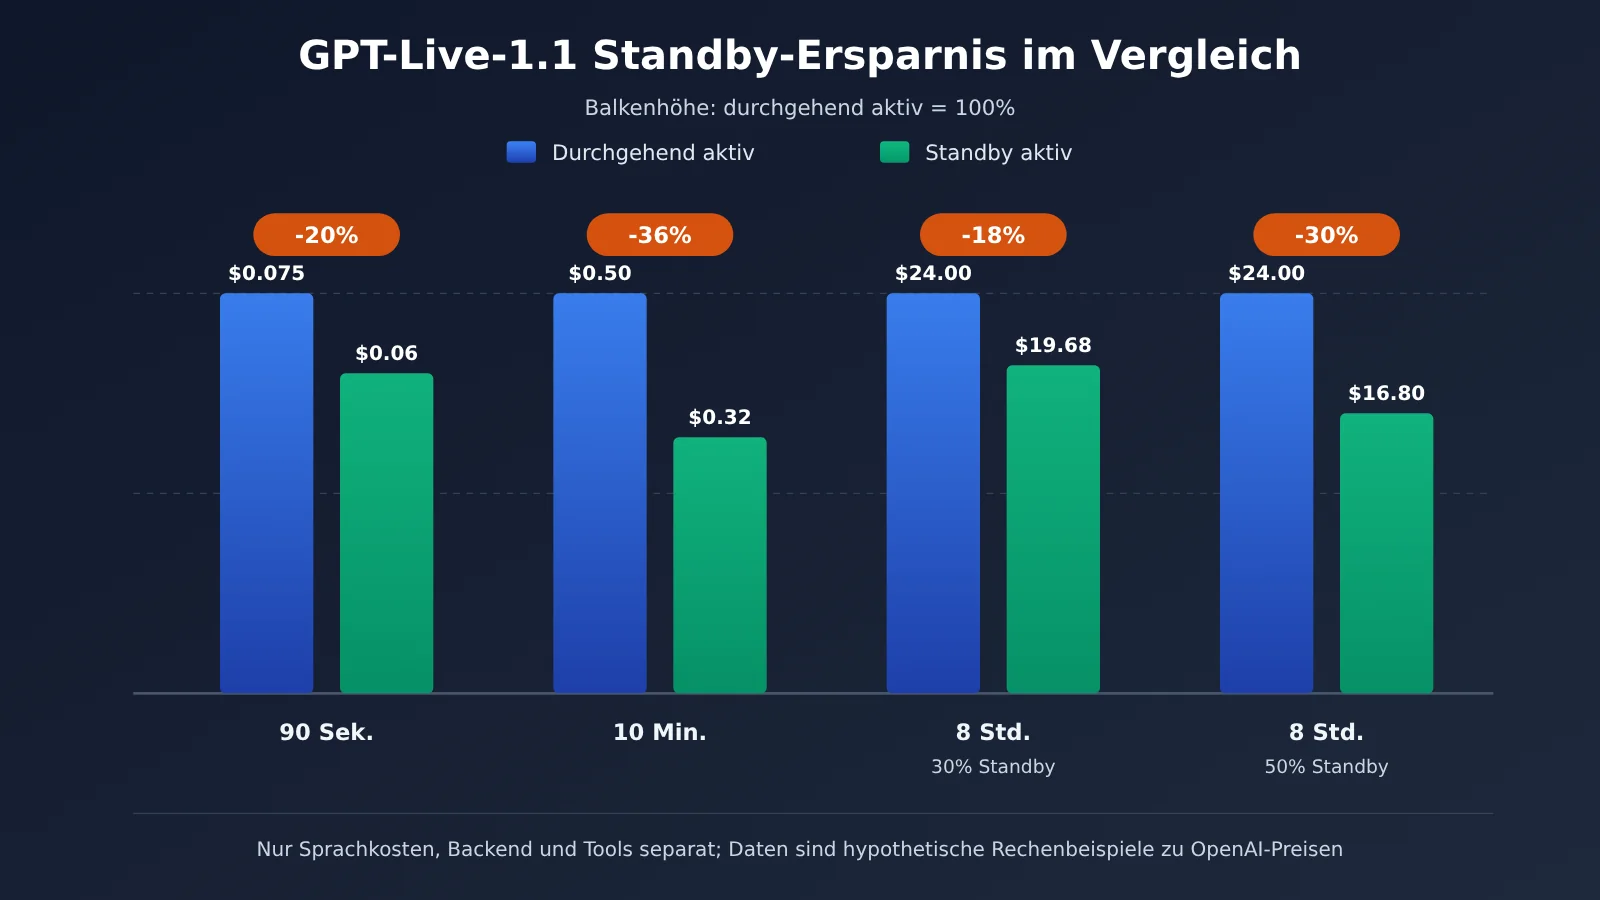
Ein hypothetisches Beispiel: Eine 10-minütige Session, in der abgerechneten Zeit 4 Minuten aktiv und 6 Minuten im Bereitschaftsmodus. Die Sprachkosten betragen 4×0.05 + 6×0.02 = $0.32. Durchgehend aktiv wären es für dieselben 10 Minuten $0.50. Im Vergleich sinken die Sprachkosten um 36% – genau 60% × 60% Bereitschaftsanteil.
| Abrechnungsposten | Preis (offizielle OpenAI-Preisliste) | Abrechnungsgranularität | Vom Bereitschaftsmodus betroffen? |
|---|---|---|---|
| Aktive Sprache | $0.05/Minute | pro Sekunde | Ja, wird teilweise durch Bereitschaft ersetzt |
| WebRTC-Bereitschaftssprache | $0.02/Minute | pro Sekunde | Nur qualifiziertes WebRTC |
| Backend-Modell-Tokens | nach Preisliste des gewählten Modells | pro Token | Nein |
| Tool-Aufrufe | nach Preisliste des Tools | pro Aufruf oder pro Menge | Nein |
GPT-Live-1.1 WebRTC-Standby konfigurieren: von den Sitzungseinstellungen bis zum Abrechnungsabgleich
Gemäß der OpenAI-Dokumentation „Managing GPT-Live sessions“ gibt es für den WebRTC-Standby nur wenige Konfigurationsoptionen, aber jede davon wirkt sich direkt darauf aus, wie die Abrechnungsphasen aufgeteilt werden.
| Feld / Ereignis | Wert oder Bedeutung | Konfigurationshinweis |
|---|---|---|
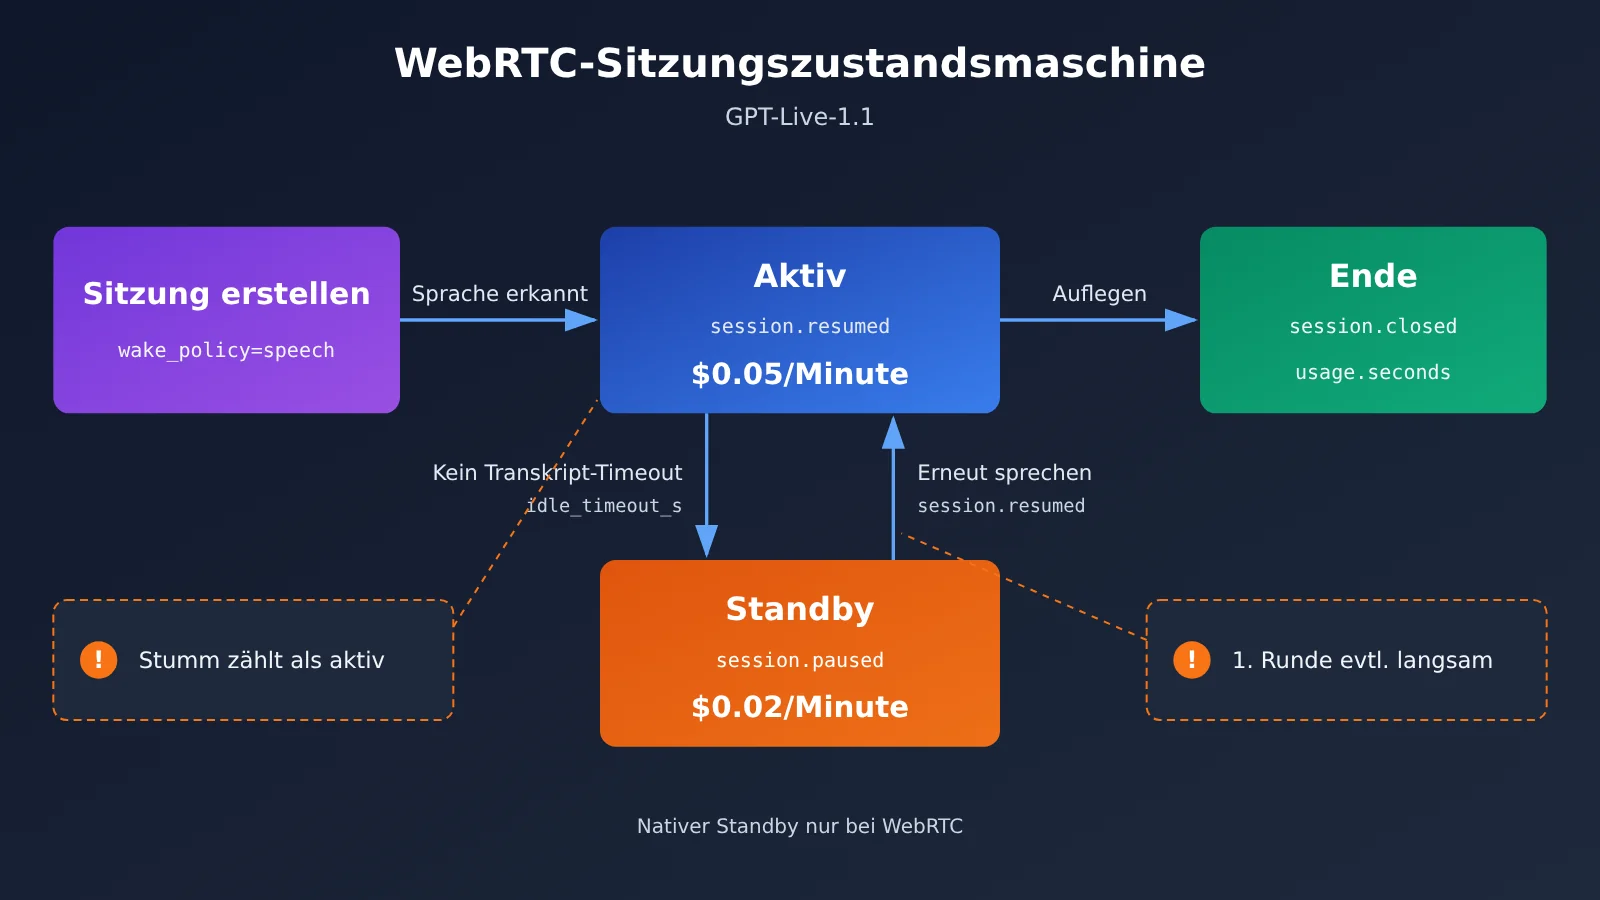
session.wake_policy.type |
auf "speech" gesetzt |
Die Sitzung startet die Inferenz erst, wenn Sprache erkannt wird – nicht sofort beim Verbindungsaufbau |
session.idle_timeout_s |
Ganzzahl von 5–60 (Sekunden) | Ohne diese Einstellung bleibt die Inferenz nach dem ersten Wecken dauerhaft aktiv |
session.wake_policy.vad_threshold |
0–1, Standard 0.5 (eine Zusammenfassung der Dokumentation durch den Drittanbieter OrcaRouter) | Bei lauter Umgebung und häufigen Fehlaktivierungen höher setzen |
session.paused |
Inferenz nach Inaktivitäts-Timeout pausiert | Gilt als Beginn des Standby |
session.resumed |
Inferenz wieder bereit; wird auch beim ersten Wecken ausgelöst | Gilt als Beginn der aktiven Phase |
session.closed |
Sitzung beendet, enthält den finalen usage.seconds-Wert |
Dient dem Abgleich mit der Abrechnung |
Die 4 Schritte zur Standby-Konfiguration von GPT-Live-1.1
- Sprachaufweckung beim Erstellen der WebRTC-Sitzung aktivieren: Legen Sie
session.wake_policy.type = "speech"fest. - Inaktivitäts-Timeout festlegen:
session.idle_timeout_smuss eine Ganzzahl zwischen 5 und 60 sein. Je kürzer der Timeout, desto früher geht die Sitzung in den Standby – allerdings kann dann schon eine etwas längere Sprechpause des Nutzers eine Pausierung auslösen. - Mikrofon-Track aktiv halten: Während des Standby muss der Mikrofon-Track aktiv bleiben, damit der Dienst Sprache erkennen und die Sitzung aufwecken kann. Verbindung und Sitzungs-ID bleiben unverändert; bei der Wiederaufnahme wird der Gesprächsverlauf mitgeführt.
- Ereignisse überwachen und Zeitstempel erfassen: Anhand von
session.pausedundsession.resumedlässt sich bestimmen, in welcher Phase sich der Server gerade befindet.
Unten steht ein Beispielausschnitt für die Sitzungskonfiguration. Die Feldpfade stammen aus der offiziellen Dokumentation; für die vollständige Anfragestruktur ist OpenAIs „Create session“ maßgeblich:
{
  "session": {
    "wake_policy": {
      "type": "speech",
      "vad_threshold": 0.5
    },
    "idle_timeout_s": 15
  }
}
Welche Ruhezeiten weiterhin zum Aktivpreis abgerechnet werden
Bei drei Arten von „Ruhe“ passieren die meisten Rechenfehler:
- Die Ruhephase vor dem Timeout: Zwischen dem Ende des letzten Satzes und dem Ablauf von
idle_timeout_sgilt die Sitzung weiterhin als aktiv und wird entsprechend abgerechnet. Bei einem Schwellenwert von 30 Sekunden wird also jede Pause mindestens 30 Sekunden lang zum Aktivpreis berechnet. - Stummgeschaltetes Mikrofon: Wenn der Nutzer im Client auf Stumm schaltet, wechselt die Sitzung dadurch nicht in den Standby-Modus – sie bleibt aktiv.
- Warten auf die Backend-Antwort: Auch die Zeit, in der die Inferenz nicht pausiert und gerade auf ein Backend-Modell oder ein Tool-Ergebnis wartet, wird der aktiven Phase zugerechnet.
Dazu kommt eine Initialisierungsgebühr. Laut der Zusammenfassung der offiziellen Dokumentation durch OrcaRouter wird beim Anlegen einer WebRTC-Sitzung über POST /v1/live/sessions zunächst eine Sprachdauer von 15 Sekunden berechnet; sobald die Sitzung läuft, wird dieser Betrag von den Dauergebühren abgezogen. Für Anwendungen, die häufig probehalber Sitzungen aufbauen, sind das echte Kosten – maßgeblich ist letztlich die OpenAI Pricing.
Mit Ereigniszeiten die Abrechnung prüfen
Der Ansatz beim Nachrechnen: Mit den Ereignis-Zeitstempeln die Dauer der einzelnen Phasen schätzen und diese dann mit den finalen usage.seconds aus session.closed sowie der tatsächlichen Rechnung abgleichen. Unten ein Beispiel für einen Ereignis-Logger. Über welchen Kanal die Ereignisse ankommen (WebRTC-Datenkanal oder Sideband-Verbindung), richtet sich nach der offiziellen Dokumentation:
const timeline = [];
function onServerEvent(evt) {
  if (["session.resumed", "session.paused", "session.closed"].includes(evt.type)) {
    timeline.push({ type: evt.type, t: Date.now() / 1000 });
  }
  if (evt.type === "session.closed") {
    console.log("usage.seconds =", evt.usage?.seconds, timeline);
  }
}
Beim Testen sollte dasselbe Skript, dasselbe Backend und dieselbe Aufnahme jeweils einmal mit „Standby an“ und einmal mit „Standby aus“ durchlaufen – und zusätzlich der Zeitpunkt erfasst werden, zu dem das erste Audiosegment zurückkommt, um die Latenzkosten der ersten Runde nach dem Aufwachen zu quantifizieren.
Noch ein Hinweis auf der Workflow-Ebene. CellCog hat eine kontrollierte Testreihe mit identischer Konfiguration veröffentlicht: zuerst 560 geskriptete Meetings, dann 120 Wiederholungsläufe. Das ursprüngliche Skript fragte früh nach; die alte Version übergab 134 von 160 Fragen an das Backend, Version 1.1 übergab 91 – also etwa 84 % gegenüber 57 %. Im Wiederholungslauf wurde die erste Frage auf nach Sekunde 10 verschoben, und beide Versionen lagen bei 48/60 (80 %). Das ist nur das Delegationsverhalten eines einzelnen Teams bei kurzen Meetings und einem bestimmten Prompt; die Standby-Kosten wurden nicht gemessen. Es zeigt aber eines: Wie oft an das Backend delegiert wird, hängt vom Skript ab – die Backend-Kosten dagegen sind vom Standby unabhängig.
Implementierungsgrenzen des GPT-Live-1.1-Standby bei WebSocket und SIP
OpenAI unterstützt drei Arten von Live-Verbindungen: WebRTC, WebSocket und Telefonie über SIP. Der kostengünstige native Standby-Modus gilt jedoch nur für WebRTC. Wichtig ist die Unterscheidung: Eine WebRTC- oder SIP-Sitzung kann zusätzlich einen Sidecar-WebSocket für Steuerung und Monitoring haben. Das ist nicht dasselbe wie „WebSocket als Träger für das Haupt-Audio“. Auch wenn an der WebRTC-Hauptverbindung ein Sidecar-WebSocket hängt, kann der Standby-Modus weiterhin genutzt werden.
| Haupt-Audioübertragung | Natives Standby $0.02 | Offiziell empfohlene Leerlaufbehandlung | Kostenhinweis |
|---|---|---|---|
| WebRTC | ✅ gilt bei erfüllten Bedingungen | wake_policy + idle_timeout_s | Die stille Phase vor dem Timeout wird als aktiv abgerechnet |
| WebRTC + Sidecar-WebSocket | ✅ gilt für die Hauptverbindung | Sidecar übernimmt nur Steuerung und Events | Der Sidecar selbst ändert die Abrechnungsphase nicht |
| Haupt-WebSocket | ❌ keine Grundlage | Anwendungsseitig Leerlauf erkennen, schließen und neu aufbauen | Der Neuaufbau einer Sitzung verursacht Initialisierungskosten |
| SIP-Telefon | ❌ keine Grundlage | Zuerst prüfen, wie sich das Schließen der Sitzung auf eingehende Anrufe auswirkt | Während des gehaltenen Anrufs wird nach aktivem Budget abgerechnet |
Vorgehen bei Haupt-WebSocket: Den Leerlaufstatus auf Anwendungsseite verwalten und dabei Audioeingang und -ausgang, Wiedergabestatus sowie noch ausstehende Backend-Aufgaben verfolgen. Nur wenn es längere Zeit still ist und eine Trennung zulässig ist, session.close aufrufen und auf session.closed warten. Wenn der Nutzer zurückkehrt, wird die Sitzung neu aufgebaut. Bei einer alten Sitzung, die gespeichert werden darf und deren Protokollierung abgeschlossen ist, kann ein Fork ausgeführt werden; alternativ lässt sich der Kontext aus einem vom Anwendungssystem selbst gespeicherten Textstatus wiederherstellen. Wenn lokales Voice-Wakeup aktiviert ist, zuerst das Audio am Anfang puffern, damit während des Verbindungsaufbaus keine Wörter verloren gehen.
Vorgehen bei SIP: Das Schließen einer Sitzung kann die eingehende Anrufverbindung selbst beeinflussen. „Auflegen und neu verbinden“ ist daher kein Standby am selben Ort. Wenn der Anruf erhalten bleiben muss, muss die Anwendung oder das Telefonsystem den Hold-Flow verwalten und die aktiven Sprachkosten von OpenAI im Budget berücksichtigen. Eine Alternative ist eine selbst gebaute Media-Bridge, um auf der OpenAI-Seite tatsächlich WebRTC-Standby zu nutzen und zu verifizieren. All dies sind Implementierungsgrenzen auf Ebene von Transport und Sitzungsstatus. Es gibt keine Grundlage für die Annahme, dass Transporte außer WebRTC ebenfalls den Standby-Preis von $0.02 erhalten können.
Wie viel ein ganzes Telefonat spart: Schnelleinstieg in die Standby-Kosten von GPT-Live-1.1
Schnelle Kostenrechnung
Der folgende Code setzt die Formel „Einsparquote = Standby-Anteil × 60 %“ um; die Eingabe erfolgt in Sekunden:
ACTIVE, STANDBY = 0.05, 0.02  # OpenAI offizieller Listenpreis, USD/Minute

def voice_cost(active_s: float, standby_s: float) -> tuple[float, float]:
    with_standby = active_s / 60 * ACTIVE + standby_s / 60 * STANDBY
    all_active = (active_s + standby_s) / 60 * ACTIVE
    return round(with_standby, 4), round(1 - with_standby / all_active, 4)

print(voice_cost(240, 360))      # 10 Minuten: 4 Minuten aktiv + 6 Minuten Standby
print(voice_cost(60, 30))        # 90 Sekunden: 60 Sekunden aktiv + 30 Sekunden Standby
| Angenommenes Szenario | Aktiv / Standby | Sprachkosten mit Standby | Sprachkosten durchgehend aktiv | Rückgang der Sprachkosten |
|---|---|---|---|---|
| Offizielles Beispiel (von OrcaRouter wiedergegeben) | 60 Sek. / 30 Sek. | $0.06 | $0.075 | 20 % |
| 10-Minuten-Beratung (Annahme in diesem Artikel) | 4 Min. / 6 Min. | $0.32 | $0.50 | 36 % |
| 8 Stunden Bereitschaft, 30 % Standby (OrcaRouter-Rechenbeispiel) | 5.6 Std. / 2.4 Std. | $19.68 | $24.00 | 18 % |
| 8 Stunden Bereitschaft, 50 % Standby (OrcaRouter-Rechenbeispiel) | 4 Std. / 4 Std. | $16.80 | $24.00 | 30 % |
Die Tabelle berücksichtigt nur die Sprachkosten. In einem echten Deployment sind die Kosten für Backend-Modelle und Tools oft der größere Posten auf der Rechnung. Im OrcaRouter-Artikel heißt es, die OpenAI-Dokumentation empfehle zunächst gpt-6-luna und für komplexe Backend-Aufgaben dann gpt-6-sol; beide werden standardmäßig nach Tokens abgerechnet. Bei langen Gesprächen können die Backend-Kosten die Sprachkosten durchaus übersteigen.
💡 Empfehlung zur Berechnung: Die Werte in der Tabelle oben sind Schätzungen auf Basis der offiziellen Listenpreise; für die echte Rechnung sind
usage.secondsund die Abrechnung der Plattform maßgeblich. Wenn du parallel andere Echtzeit-Sprachlösungen evaluierst, kannst du das kostenlose Testkontingent von APIYI apiyi.com nutzen, um Realtime-Modelle, die nach Tokens abgerechnet werden, mit demselben Gesprächsskript zu vergleichen.
Getrennte Betrachtung von GPT-Live-1.1-Sprachschicht, Backend-Modell und API-Zugang
Zum Recherchestand (2026-11-20) stammen die dedizierten Sitzungsschnittstellen und die Minutentarife für GPT-Live-1.1 ausschließlich von OpenAI selbst. Laut der Übersicht des Drittanbieters OrcaRouter ist GPT-Live nur über den Endpunkt „Live sessions“ erreichbar; andere Endpunkte wie Chat Completions, Responses oder Realtime werden nicht unterstützt.
Bei APIYI fehlen im öffentlichen Modellregister (erstellt am 2026-11-20 um 15:17 UTC+8, insgesamt 289 Einträge) sowohl gpt-live-1 als auch gpt-live-1.1. Auch im dynamischen Archiv gibt es keine entsprechende Ankündigung zur Verfügbarkeit. Deshalb lässt sich derzeit nicht sagen, dass APIYI die GPT-Live-Serie, /v1/live/sessions oder eine minutenbasierte Abrechnung anbietet. Ebenso wenig folgt aus der Kompatibilität von APIYI mit OpenAI-Schnittstellen, dass solche dedizierten Sprachsitzungen unterstützt werden.
Die bereits öffentlich verfügbare Echtzeit-Sprachoption bei APIYI ist ein eigenständiges Realtime-Produkt:
| Option | Anbindung | Abrechnung | Standby / WebRTC / SIP | Verfügbare Plattform |
|---|---|---|---|---|
| GPT-Live-1.1 | /v1/live/sessions, WebRTC / WebSocket / SIP |
Aktiv $0.05, Standby $0.02 pro Minute; Backend separat abgerechnet | WebRTC unterstützt natives Standby | OpenAI offiziell |
| gpt-realtime-2.1 | /v1/realtime WebSocket |
Audio-Eingang/-Ausgang $32/$64 pro Million Audio-Token | WebRTC, SIP nicht freigeschaltet | APIYI apiyi.com |
| gpt-realtime-2.1-mini | /v1/realtime WebSocket |
Audio-Eingang/-Ausgang $10/$20 pro Million Audio-Token | WebRTC, SIP nicht freigeschaltet | APIYI |
Die Realtime-Preise von APIYI stammen aus der zugehörigen Dokumentation (auf der Seite ist ein Abgleich vom 2026-09-14 vermerkt). Abgerechnet wird nach Text-, Audio- und Bild-Token; eine direkte Umrechnung in die minutenbasierte Abrechnung von GPT-Live ist nicht möglich.
APIYI Realtime – minimales Verbindungsbeispiel
import os, asyncio, websockets

BASE_URL = "https://api.apiyi.com/v1"  # Einheitliche APIYI-Schnittstelle
WS_URL = BASE_URL.replace("https://", "wss://") + "/realtime?model=gpt-realtime-2.1"

async def main():
    headers = {"Authorization": f"Bearer {os.environ['APIYI_API_KEY']}"}
    async with websockets.connect(WS_URL, additional_headers=headers) as ws:
        print(await ws.recv())  # Erstes Server-Ereignis ausgeben

asyncio.run(main())
Vollständigen Code ansehen: anwendungsseitiges Schließen des Haupt-WebSockets bei Leerlauf
import os, time, asyncio, websockets

BASE_URL = "https://api.apiyi.com/v1"  # APIYI Realtime-Einstiegspunkt
WS_URL = BASE_URL.replace("https://", "wss://") + "/realtime?model=gpt-realtime-2.1-mini"
IDLE_LIMIT_S = 45          # Anwendungsseitige Leerlaufschwelle, je nach Geschäftslogik anpassbar
pending_backend_tasks = 0  # Von der Anwendung selbst verwaltet: Anzahl unerledigter Backend-Aufgaben
is_playing = False         # Von der Anwendung selbst verwaltet: ob Audio gerade abgespielt wird

async def run_session():
    headers = {"Authorization": f"Bearer {os.environ['APIYI_API_KEY']}"}
    last_activity = time.monotonic()
    async with websockets.connect(WS_URL, additional_headers=headers) as ws:
        async def reader():
            nonlocal last_activity
            async for _ in ws:
                last_activity = time.monotonic()  # Jedes Server-Ereignis gilt als Aktivität

        task = asyncio.create_task(reader())
        while True:
            await asyncio.sleep(1)
            idle = time.monotonic() - last_activity
            busy = pending_backend_tasks > 0 or is_playing
            if idle > IDLE_LIMIT_S and not busy:
                print(f"空闲 {idle:.0f}s,主动关闭,用户回来后再重建")
                await ws.close()
                break
        task.cancel()

asyncio.run(run_session())
Ereignisformate und Query-Parameter richten sich nach der APIYI-Dokumentation „Realtime – Echtzeit-Sprache (WebSocket)“. Dieses Schließen und erneute Aufbauen spart lediglich auf Anwendungsebene die Leerlaufverbindung ein und entspricht keinem offiziellen günstigen Standby-Tarif.
🚀 Integrationsempfehlung: Für WebRTC-Szenarien, die den nativen Standby von GPT-Live benötigen, sollten Sie derzeit direkt OpenAI anbinden. Wenn Sie mit WebSocket schnell einen Echtzeit-Sprach-Prototyp bauen und mehrere Modelle einheitlich verwalten möchten, können Sie zunächst auf APIYI apiyi.com mit
gpt-realtime-2.1-miniden Ablauf durchspielen und dann anhand der Kosten über die endgültige Lösung entscheiden.
Häufig gestellte Fragen (FAQ)
F1: Was ist der WebRTC-Standby von GPT-Live-1.1?
Das ist ein Abrechnungsstatus einer WebRTC-Sitzung: Sind Sprachaktivierung und Leerlaufschwelle konfiguriert, stellt die Sitzung in Phasen ohne Sprache die Inferenz ein, die Verbindung bleibt jedoch bestehen und wird mit $0.02/Minute berechnet. Spricht wieder jemand, wird die Inferenz fortgesetzt und der bisherige Gesprächsverlauf mitgeführt.
F2: Bedeutet eine Preissenkung um 60 %, dass ein ganzes Telefonat 60 % günstiger wird?
Nein. Die 60 % sind der Rückgang des Standby-Preises gegenüber dem Aktiv-Preis. Der Rückgang der Sprachkosten für ein ganzes Telefonat entspricht dem Standby-Anteil multipliziert mit 60 %: Bei einem Standby-Anteil von der Hälfte spart man etwa 30 % der Sprachkosten. Backend- und Tool-Kosten bleiben davon unberührt.
F3: Wann wurde GPT-Live-1.1 in der API verfügbar?
Der Eintrag im OpenAI API Changelog ist auf den 2026-11-19 datiert, die Ankündigungsseite der OpenAI-Entwicklercommunity zeigt den 2026-11-20; die Differenz kommt möglicherweise durch unterschiedliche Zeitzonen zustande. GPT-Live-1 war zuvor bereits am 2026-09-10 allgemein verfügbar (laut einer Zusammenstellung von OrcaRouter).
F4: In welchen Szenarien lohnt sich Standby am meisten?
– **Warteschlange im Kundenservice**: Kunden bleiben in der Leitung, sprechen aber lange nicht.
– **Fahrzeug- oder Desktop-Assistenten**: dauerhaft verbunden, gelegentlich aktiviert.
– **Langzeit-Bereitschaftsplätze**: Je höher der Standby-Anteil, desto mehr spart man.
Bei kurzen, dialogintensiven Sitzungen ist der Standby-Anteil niedrig, und man zahlt zusätzlich den Preis einer langsameren ersten Runde nach der Aktivierung – der Nutzen ist begrenzt.
F5: Kann man GPT-Live-1.1 über APIYI aufrufen?
Stand 2026-11-20 gibt es im öffentlichen Modellregister von APIYI keine GPT-Live-Serie und auch keine Ankündigung. Wenn Sie Echtzeit-Sprache benötigen, können Sie die bereits öffentlich verfügbaren `gpt-realtime-2.1` / `gpt-realtime-2.1-mini` von APIYI apiyi.com nutzen, sie über WebSocket unter `/v1/realtime` anbinden und nach Audio-Tokens abrechnen. Neue Nutzer erhalten ein kostenloses Testkontingent, mit dem sie das zunächst überprüfen können.
F6: Welche bekannten Einschränkungen gibt es beim Standby von GPT-Live-1.1?
– Gilt nur für WebRTC; für WebSocket- und SIP-Hauptverbindungen gibt es keine Grundlage für $0.02.
– Die stille Phase vor dem Timeout, stummgeschaltetes Mikrofon und Wartezeiten auf das Backend werden als aktiv abgerechnet.
– Nach der Aktivierung kann die erste Antwort bei kurzer Sprache langsamer ausfallen.
– Derzeit fehlen Daten von Drittanbietern zur Standby-Aktivierung und zur Überprüfung der Abrechnung; die Werte in der Artificial-Analysis-Rangliste beziehen sich außerdem nur auf GPT-Live-1 und lassen sich nicht auf 1.1 übertragen.
GPT-Live-1.1 WebRTC-Standby – die wichtigsten Punkte
- Preis: aktive Sitzung $0.05/Minute, qualifizierter WebRTC-Standby $0.02/Minute – beide werden sekundengenau abgerechnet.
- Rechenweg: Die Reduktion der Sprachkosten über das gesamte Gespräch entspricht dem Standby-Anteil multipliziert mit 60 % – nicht festen 60 %.
- Konfiguration:
wake_policy.type="speech"plusidle_timeout_szwischen 5 und 60 Sekunden; der Mikrofon-Track bleibt dabei aktiv. - Abrechnung prüfen: Phasendauer mit paused/resumed-Zeitstempeln schätzen und anschließend
usage.secondsmit der Rechnung abgleichen. - Grenzen: WebSocket und SIP lassen sich erst nach dem Schließen auf Anwendungsseite neu aufbauen und gelten nicht als günstiger Standby.
- Einstieg: GPT-Live erfordert eine direkte Verbindung zu OpenAI; WebSocket-Echtzeitsprache können Sie mit Realtime-Modellen bei APIYI apiyi.com testen.
Fazit
Die Kernpunkte zum GPT-Live-1.1-WebRTC-Standby:
- Der günstigere Preis ist an Bedingungen geknüpft: Nur WebRTC-Sitzungen, in denen Standby konfiguriert und die Inferenz bereits pausiert ist, werden mit $0.02/Minute abgerechnet.
- Die Ersparnis hängt vom Anteil ab: Bei 10 Minuten Gespräch mit 6 Minuten Standby sinken die Sprachkosten von $0.50 auf $0.32 – rund 36 % weniger.
- Die Rechnung im Ganzen betrachten: Backend-Modelle und Tools werden separat abgerechnet; Standby optimiert nur einen dieser Posten.
Empfehlung: Führen Sie zuerst einen A/B-Test mit demselben Sprechskript durch – einmal mit, einmal ohne Standby –, protokollieren Sie die Ereigniszeiten und die Latenz der ersten Antwortrunde und legen Sie danach den Idle-Schwellenwert fest. Wenn Sie noch verschiedene Echtzeitsprach-Lösungen vergleichen, lohnt es sich, zuerst einen Realtime-Prototyp über APIYI apiyi.com zum Laufen zu bringen und mit dem kostenlosen Kontingent Kosten und Erlebnis gegenüberzustellen.
📚 Referenzen
-
OpenAI API-Preise: GPT-Live-Tarife für Aktiv- und Standby-Betrieb
- Link:
developers.openai.com/api/docs/pricing - Beschreibung: Quelle der offiziellen Preise von $0.05 und $0.02
- Link:
-
OpenAI Managing GPT-Live sessions: Standby-Konfiguration und Ereignisbeschreibung
- Link:
developers.openai.com/api/docs/guides/live-conversations - Beschreibung: wake_policy, idle_timeout_s und Transportgrenzen
- Link:
-
OpenAI API Changelog: Aktualisierungseintrag zu GPT-Live-1.1
- Link:
developers.openai.com/api/docs/changelog - Beschreibung: Eintragsdatum 2026-11-19
- Link:
-
CellCog-Kontrollversuch: GPT-Live-1.1 vs. GPT-Live-1
- Link:
cellcog.ai/blog/gpt-live-1-1-vs-gpt-live-1/ - Beschreibung: Delegationsdaten aus 680 geskripteten Sitzungen, ohne Standby-Kosten
- Link:
-
OrcaRouter Release-Analyse: Analyse der Standby-Abrechnung von GPT-Live-1.1
- Link:
orcarouter.ai/blog/gpt-live-1-1-api-release-standby-pricing - Beschreibung: Wiedergabe der offiziellen Rechenbeispiele und Kalkulation für eine 8-Stunden-Schicht
- Link:
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website; Details zur Realtime-Anbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com