Anmerkung des Autors: Im November 2026 erscheinen viele neue Modelle in kurzer Folge. Dieser Artikel zeigt, wie Sie über einen einzigen Einstiegspunkt das Modell wechseln, sie über Endpunkte anbinden und die Abrechnung für jeden Kanal getrennt durchführen.
In den ersten drei Wochen des November hat Google bereits drei Gemini-4-Modelle hintereinander veröffentlicht: Carbon am 10. November, Hydrogen am 12. November und Neon am 18. November. Auch in Bereichen wie Bilderzeugung und Coding tauchen nach und nach neue Modelle in den Nachrichten auf. Für Entwickler, die neue Modelle ausprobieren möchten, liegt die Hürde nicht darin, den Aufrufcode zu schreiben, sondern darin, dass jeder Anbieter sein eigenes SDK, seine eigene Authentifizierung und sein eigenes Abrechnungsschema hat. Dieser Artikel stellt einen weniger aufwendigen Ansatz vor: Ein einziger Einstiegspunkt für den Modellwechsel, Abrechnung getrennt nach Kanälen.
Dies ist keine Marketingliste im Sinne eines „Komplettpakets aller neuen Modelle“. Wir unterscheiden in diesem Artikel ausdrücklich zwischen Modellen, die in den Nachrichten auftauchen, und solchen, die auf der Plattform bereits aufgerufen werden können. MAI Image 2.7 aus den Nachrichten ist derzeit beispielsweise noch nicht im Sortiment von APIYI; in diesem Artikel wird es nicht als aufrufbares Modell behandelt.
Kernnutzen: Nach dem Lesen dieses Artikels wissen Sie, wo Sie zuerst die Modellliste abgleichen, wie Sie entscheiden, welche Modell-ID Sie einsetzen, welchen Endpunkt welche Modellklasse nutzen sollte und wie Sie vermeiden, die gesamte Rechnung anhand des Preises eines einzelnen Modells zu schätzen. Die im Folgenden genannten Modelle und Preise richten sich nach der Modellliste und der Preisschnittstelle von APIYI apiyi.com mit Stand vom 2026-11-20.
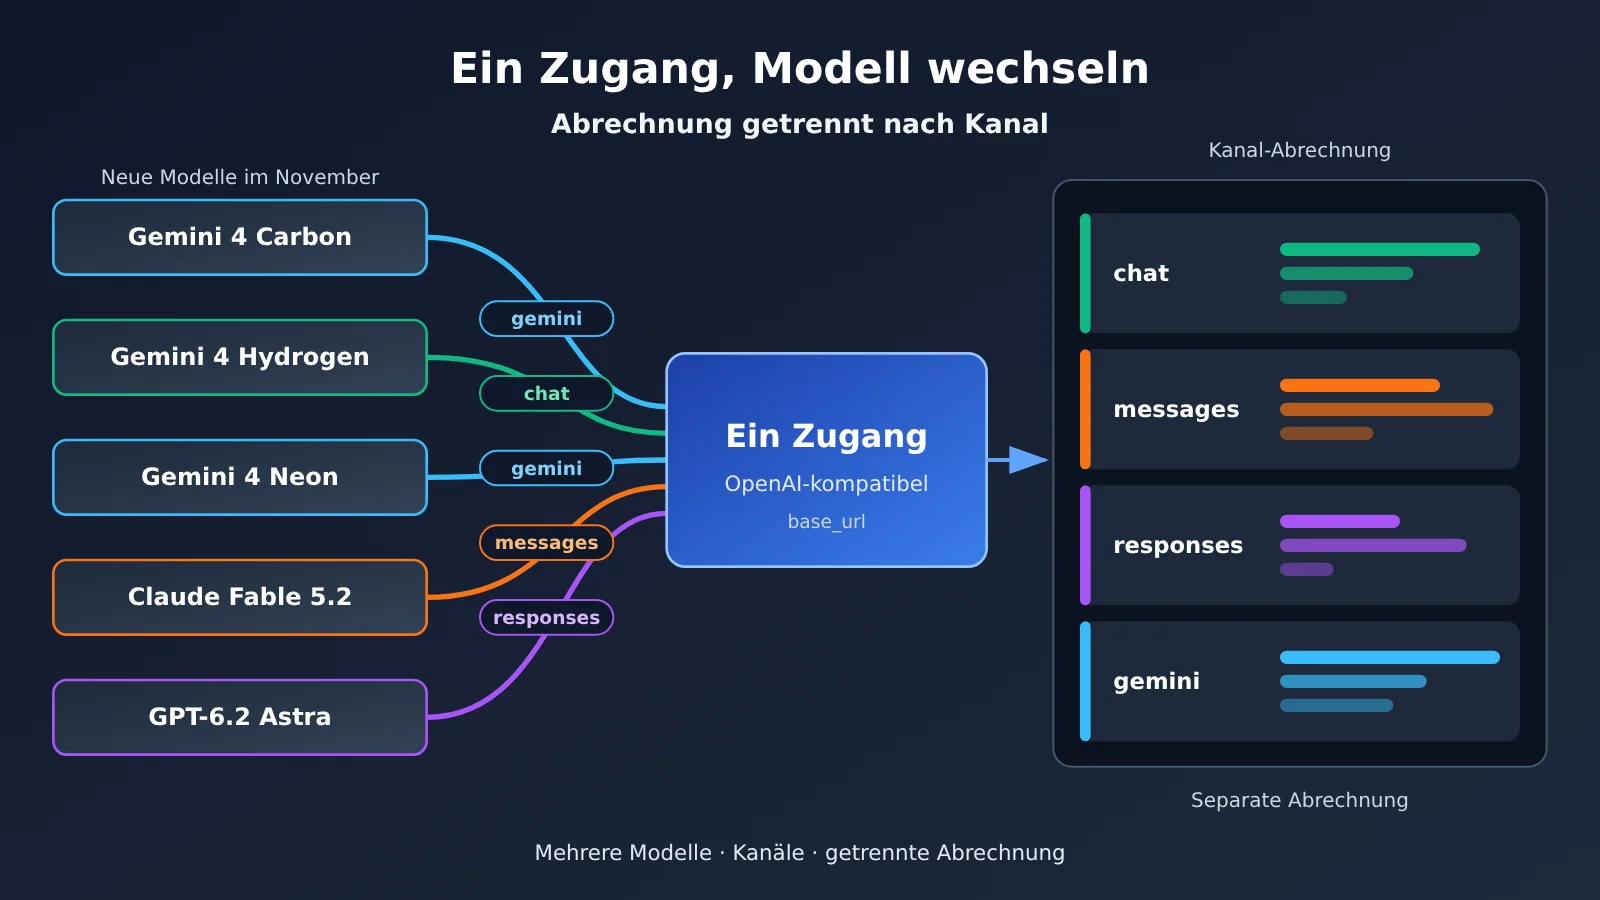
Kernpunkte zur Integration neuer Modelle im November
Wenn neue Modelle in kurzen Abständen erscheinen, treten Fehler am häufigsten an drei Stellen auf: Man hält ein in der Presse vorgestelltes Modell für ein bereits verfügbares Modell, man verwendet den falschen Endpunkt und man schätzt alle Kosten mit einem einzigen Stückpreis. Die folgende Tabelle stellt diese drei Punkte und die jeweilige Vorgehensweise gegenüber.
| Punkt | Erläuterung | Nutzen |
|---|---|---|
| Zuerst die Modellliste abgleichen | Maßgeblich sind die Gesamtübersicht der Plattform und die Preis-API; in der Presse genannte Modelle und tatsächlich aufrufbare Modelle getrennt notieren | Vermeidet, dass man den Modellnamen aus der Produktpräsentation direkt aufruft und dann einen Fehler erhält |
| Modellwechsel = neue Modell-ID + Endpunkt prüfen | Unter derselben base_url den Parameter model ändern und dann prüfen, ob der Aufruf über chat, messages, responses oder gemini läuft |
Man muss nicht für jeden Anbieter ein eigenes SDK schreiben |
| Abrechnung getrennt nach Kanal betrachten | Für jedes Modell und jeden Endpunkt Eingabe-, Ausgabe- und Cache-Lese-Token separat erfassen | Modelle mit mehrfach unterschiedlichen Stückpreisen werden nicht miteinander verrechnet, die Kosten bleiben nachvollziehbar |
| Einführungspreise haben ein Enddatum | Für einige neue Modelle gibt es zeitlich begrenzte Einführungspreise; nach Ablauf ändert sich der offizielle Standardpreis | Das Budget für den nächsten Monat frühzeitig schätzen, damit eine Preiserhöhung den Plan nicht durcheinanderbringt |
Integration neuer Modelle im Detail: Presse-Modell ≠ Regal-Modell
Der erste Schritt bei der Integration ist, das Regal zu prüfen – nicht, Code zu schreiben. Die Modellübersicht von APIYI liegt unter docs.apiyi.com/models.md; die hier referenzierte Version wurde am 2026-11-19 10:59 (UTC+8) aktualisiert. Daneben gibt es eine maschinenlesbare Preis-API unter https://api.apiyi.com/api/pricing mit der Versionskennung shell-api-modelmak-v1. Beide werden möglicherweise nicht im gleichen Takt aktualisiert: gemini-4-neon fehlt beispielsweise noch in dieser Version der Übersicht, während die Preis-API bereits vollständige Preisfelder enthält. Wenn Sie also beurteilen wollen, ob sich ein Modell aufrufen lässt, prüfen Sie am besten beide Quellen – und sobald eine davon einen Eintrag hat, bestätigen Sie das mit einer kleinen Testanfrage.
Auch der umgekehrte Fall verdient Aufmerksamkeit. MAI Image 2.7 ist ein Bildmodell aus den aktuellen News, doch in der derzeitigen Übersicht und der Preis-API von APIYI finden sich nur MAI-Image-2.6 und MAI-Image-2.6-Flash, nicht 2.7. Mit anderen Worten: MAI Image 2.7 ist noch nicht erhältlich. Wir werden dieses Modell so schnell wie möglich aufnehmen; Modellbezeichnung und Preis richten sich dann nach der Modellliste der Plattform. Außerdem sind Kling, Muse und gemini-4-flash-lite derzeit weder in der Übersicht noch in der Preis-API zu finden – kalkulieren Sie sie bei der Planung also nicht ein.
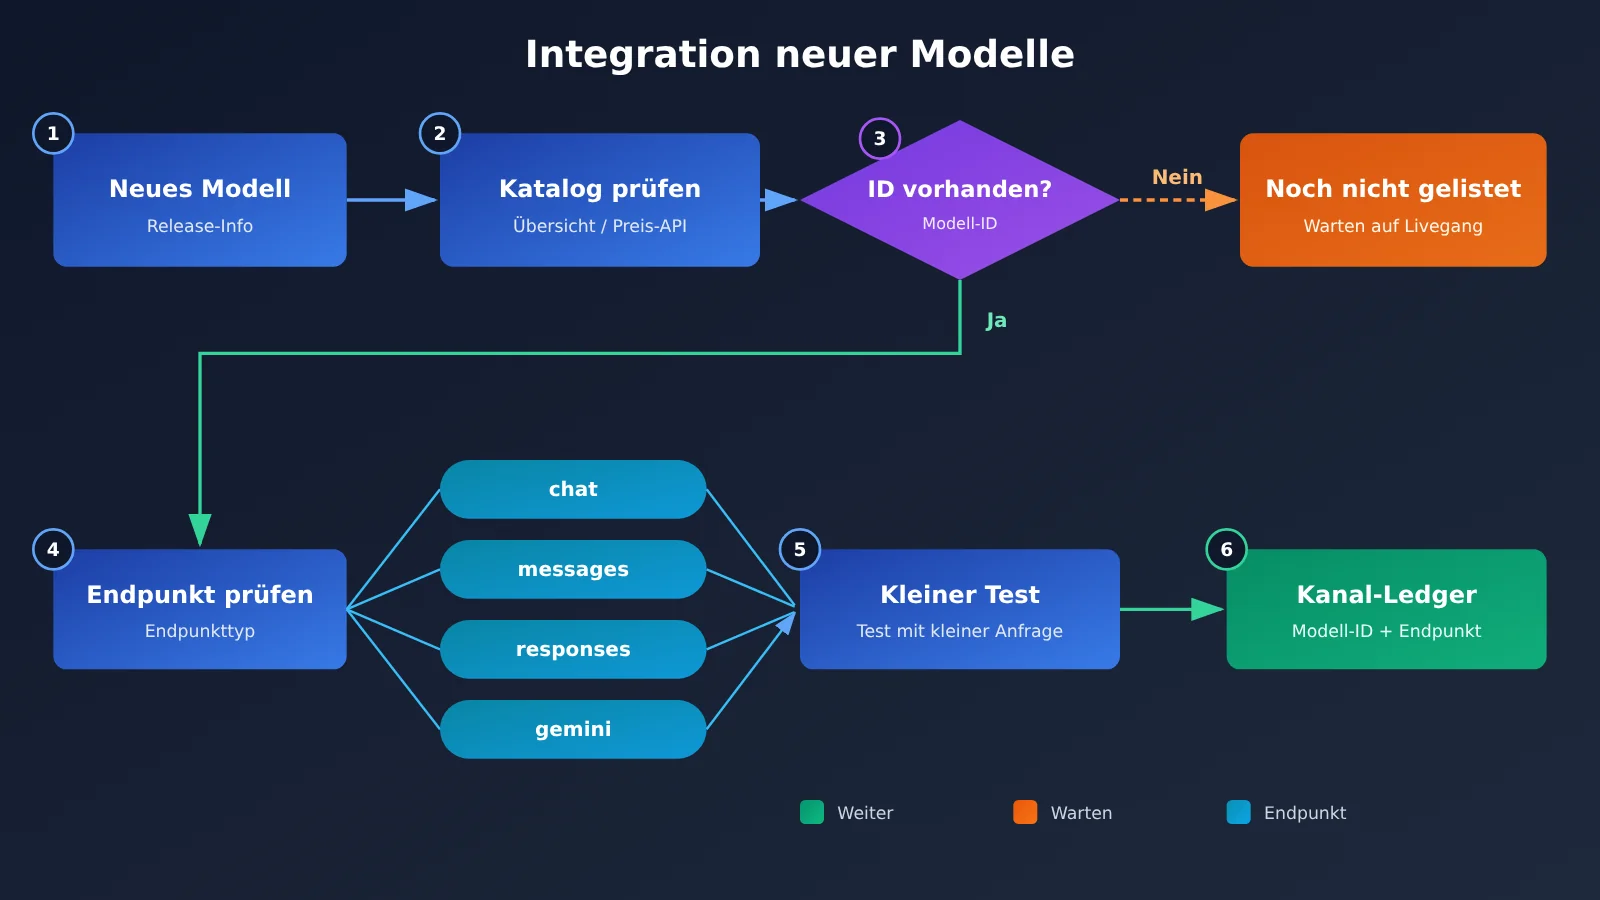
Abgleich der neuen Modelle im November mit dem Verfügbarkeitsstatus
Die folgende Tabelle ordnet die in den November-Nachrichten genannten Modelle dem Verfügbarkeitsstatus bei APIYI am 2026-11-20 zu. Aufgeführt werden nur Informationen, die sich in den Quellen belegen lassen; zu nicht belegten Punkten werden keine Vermutungen angestellt.
| Modell | Informationen aus den Nachrichten | Verfügbarkeit bei APIYI (2026-11-20) | Modell-ID |
|---|---|---|---|
| Gemini 4 Carbon | Veröffentlicht am 2026-11-10, für langkettige, anspruchsvolle Aufgaben | In der Gesamtübersicht und über die Preis-API abrufbar | gemini-4-carbon |
| Gemini 4 Hydrogen | Veröffentlicht am 2026-11-12, schnelle Variante für den Alltag | In der Gesamtübersicht und über die Preis-API abrufbar | gemini-4-hydrogen |
| Gemini 4 Neon | Veröffentlicht am 2026-11-18, mittlere Leistungsfähigkeit | In der Preis-API bereits vorhanden, in der Gesamtübersicht dieser Version nicht gelistet | gemini-4-neon |
| Gemini 4 Argon | — | In der Gesamtübersicht abrufbar | gemini-4-argon |
| MAI Image 2.7 | In den Nachrichten genanntes Bildmodell | Noch nicht im Sortiment, wird so bald wie möglich aufgenommen | Es gilt die Plattformliste |
| MAI Image 2.6 / 2.6 Flash | — | Abrufbar, Abrechnung pro Aufruf | MAI-Image-2.6 / MAI-Image-2.6-Flash |
Die Positionierung der drei Gemini-4-Stufen lässt sich vereinfacht so verstehen: Carbon ist auf lange, schwierige Aufgabenketten ausgerichtet, Hydrogen setzt auf Geschwindigkeit für häufige Alltagsaufrufe, Neon liegt dazwischen. Bei der Modellauswahl wählen Sie zuerst die Stufe nach der Aufgabenschwierigkeit und prüfen dann den Preis – das ist solider, als direkt das günstigste Modell zu nehmen.
Schnellstart mit den neuen Modellen im November: ein Einstiegspunkt für den Modellwechsel
Minimalbeispiel: Mit zwei Parametern das Modell wechseln
APIYI bietet eine OpenAI-kompatible Schnittstelle. Beim Anbinden neuer Modelle ändert sich meist nur zweierlei: base_url und model. Am offiziellen Python SDK von OpenAI sieht der minimale Ablauf so aus:
- SDK installieren:
pip install openai - Client erstellen:
client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1") - Dialog starten:
client.chat.completions.create(model="gemini-4-hydrogen", messages=[{"role": "user", "content": "Hello!"}]) - Ergebnis lesen:
response.choices[0].message.content
Wenn Sie von Hydrogen auf Carbon wechseln möchten, ändern Sie einfach model="gemini-4-hydrogen" in model="gemini-4-carbon" – Client, Authentifizierung und Nachrichtenstruktur bleiben unverändert. Genau das bedeutet „ein Einstiegspunkt für den Modellwechsel“: Beim Modellwechsel tauscht man in der Regel nur die Modell-ID aus und prüft den Endpunkt. Ein eigenes SDK pro Anbieter ist nicht nötig.
Vollständige Integrationsstrategie ansehen (inkl. Endpunktwechsel und Kanal-Abrechnung)
In einem vollständigen Projekt empfiehlt es sich, das Mapping „Modell-ID → Endpunkt“ in die Konfiguration zu legen, statt es über den Code zu verstreuen:
1. Definieren Sie die Konfiguration `MODEL_ROUTES`; jeder Eintrag enthält die drei Felder `model`, `endpoint` und `price_key`. Beispielsweise entspricht `gemini-4-neon` dem Wert `chat`, `claude-fable-5-2` dem Wert `messages` und `gpt-6.2-astra` dem Wert `responses`.
2. Kapseln Sie die Funktion `call_model(model, prompt)`: Je nach `endpoint` rufen Sie `client.chat.completions.create` oder `client.responses.create` auf – oder senden eine Anfrage im Messages-Format über das Anthropic SDK (base_url wie oben).
3. Nach jeder Anfrage lesen Sie aus dem `usage`-Feld der Antwort die Input-, Output- und Cache-Token und schreiben sie unter dem Kanal-Schlüssel `model+endpoint` in ein lokales Ledger.
4. Fragen Sie täglich einmal die Preis-Schnittstelle ab, rechnen Sie anhand von `model_ratio`, `completion_ratio` und `cache_ratio` den Stückpreis um und multiplizieren Sie ihn mit der Token-Zahl im Ledger, um die geschätzten Kosten pro Kanal zu erhalten.
5. Bei einem fehlgeschlagenen Aufruf protokollieren Sie `model` und die Fehlermeldung. Wenn die Meldung besagt, dass das Modell nicht existiert, prüfen Sie zuerst die Modellliste – statt blind zu wiederholen.
So müssen Sie nach der Veröffentlichung eines neuen Modells nur eine Zeile in `MODEL_ROUTES` ergänzen – der Geschäftscode bleibt unverändert.
🚀 Empfehlung für den Schnellstart: Registrieren Sie sich zuerst bei APIYI apiyi.com und holen Sie sich das kostenlose Testkontingent für neue Nutzer. Bringen Sie die Anbindung mit einem Alltagsmodell wie Hydrogen zum Laufen und wechseln Sie dann zu Neon und Carbon, um die Ergebnisse zu vergleichen. Der gesamte Prozess benötigt nur einen API-Schlüssel.
Vergleich der Endpunkte neuer Modelle: Packen Sie nicht alle Modelltypen in chat
„Ein Eingang“ bedeutet nicht „ein Endpunkt“. Die bereits aufrufbaren Textmodelle unterstützen jeweils unterschiedliche Endpunkte – beim Wechsel des Modells muss dieser Schritt unbedingt geprüft werden:
| Modellreihe | Beispiele für Modell-IDs | Verfügbare Endpunkte | Beschreibung |
|---|---|---|---|
| Gemini 4-Serie | gemini-4-carbon / gemini-4-neon / gemini-4-hydrogen |
chat oder gemini | chat ist das OpenAI-kompatible /v1/chat/completions; gemini ist das native Gemini-Format, der genaue Pfad richtet sich nach der Plattformdokumentation |
| Claude Fable 5.2 | claude-fable-5-2 / claude-fable-5-2-thinking |
chat oder messages | messages ist das Anthropic-artige /v1/messages |
| GPT-6.2 Astra | gpt-6.2-astra |
empfohlen: responses | Empfohlen wird /v1/responses |
| MAI Image 2.6 | MAI-Image-2.6 / MAI-Image-2.6-Flash |
Bilderzeugung | Abrechnung pro Aufruf, die Aufrufmethode richtet sich nach der Plattformdokumentation |
In der Praxis: Wenn ein Team bereits über viel Code auf Basis des chat-Formats verfügt, können Gemini und Claude zunächst weiterhin den chat-Endpunkt verwenden – das verursacht die geringsten Migrationskosten. Wenn die nativen Funktionen des Anbieters benötigt werden, wechselt man zum gemini- oder messages-Endpunkt. Bei GPT-6.2 Astra empfiehlt es sich, direkt über den responses-Endpunkt anzubinden und nicht aus Gewohnheit am chat-Format festzuhalten.
Abrechnung neuer Modelle im November: nach Kanälen getrennt betrachtet
Zuerst die Preis-API lesen lernen
Die Preis-API von APIYI gibt Preise als Faktoren an. Die Umrechnung funktioniert so:
- Eingabepreis =
model_ratio × 2(Einheit: USD pro Million Token; beimodel_ratio1 entspricht das$2 / 1M) - Ausgabepreis = Eingabepreis ×
completion_ratio - Cache-Lesepreis = Eingabepreis ×
cache_ratio
Am Beispiel gemini-4-neon: Die Preis-API liefert model_ratio 1.5, completion_ratio 5 und cache_ratio 0.05. Umgerechnet ergibt das einen Eingabepreis von $3 / 1M, einen Ausgabepreis von $15 / 1M und einen Cache-Lesepreis von $0.15 / 1M – identisch mit Googles Listenpreis. Wenn du diese Umrechnung beherrschst, kannst du bei jedem neu gelisteten Modell die Preise selbst aus https://api.apiyi.com/api/pricing berechnen, ohne auf ein Artikel-Update warten zu müssen.
Preisvergleich der einzelnen Kanäle (Stand: 2026-11-20)
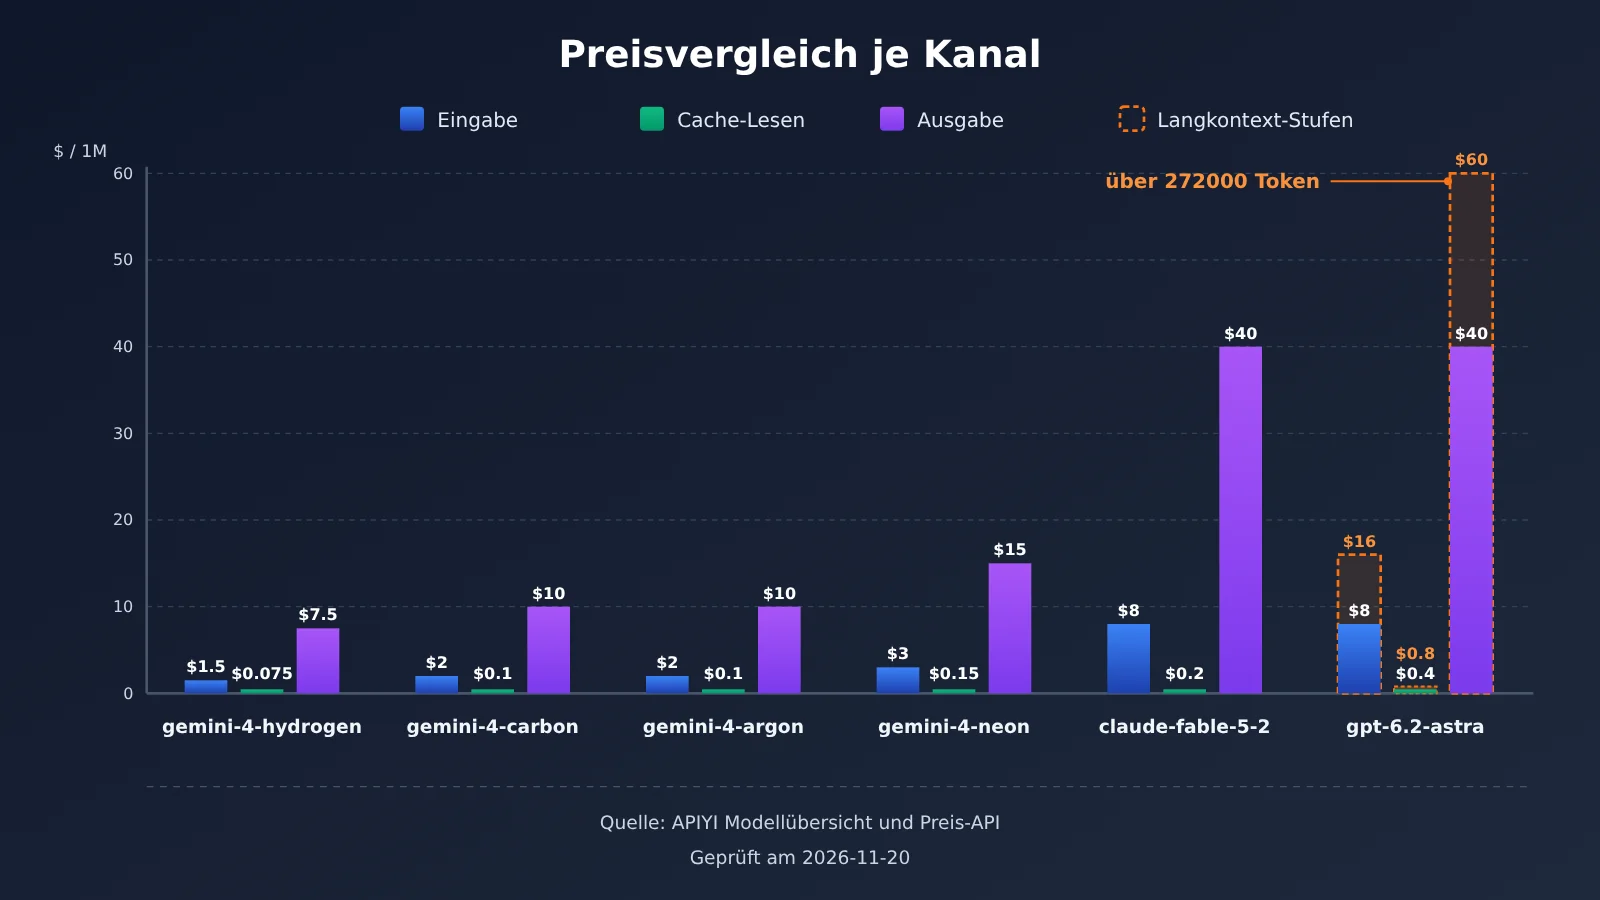
📊 Hinweis zur Datenquelle: Die Preise in der Grafik oben und der Tabelle unten stammen aus der Modellübersicht und der Pricing-API von APIYI apiyi.com. Stand der Prüfung ist der 2026-11-20; spätere Anpassungen richten sich nach der tagesaktuellen Liste der Plattform.
| Kanal (Modell-ID) | Eingabe | Cache-Lesen | Ausgabe | Hinweis |
|---|---|---|---|---|
gemini-4-hydrogen |
$1.5 / 1M |
$0.075 / 1M |
$7.5 / 1M |
schnelle Alltagsvariante |
gemini-4-carbon |
$2 / 1M |
$0.1 / 1M |
$10 / 1M |
entspricht dem Einführungspreis von Google bis 2026-11-30 |
gemini-4-argon |
$2 / 1M |
$0.1 / 1M |
$10 / 1M |
aus der Modellübersicht |
gemini-4-neon |
$3 / 1M |
$0.15 / 1M |
$15 / 1M |
aus der Pricing-API |
claude-fable-5-2 / -thinking |
$8 / 1M |
$0.2 / 1M |
$40 / 1M |
beide IDs kosten dasselbe |
gpt-6.2-astra (erste Staffel) |
$8 / 1M |
$0.4 / 1M |
$40 / 1M |
über 272000 Token siehe unten |
MAI-Image-2.6 |
pro Aufruf $0.12 |
— | — | Bild |
MAI-Image-2.6-Flash |
pro Aufruf $0.06 |
— | — | Bild |
Zwei Punkte in der Tabelle brauchen eine eigene Erläuterung.
Der erste Punkt ist die Langkontext-Staffel von GPT-6.2 Astra. In der Modellübersicht steht, dass die Eingabe bei mehr als 272000 Token auf $16 / 1M steigt; die Pricing-API liefert zusätzlich, dass über 272000 Token die Ausgabe mit $60 / 1M und das Cache-Lesen mit $0.8 / 1M berechnet werden. Wenn Ihre Anwendung sehr lange Kontexte verarbeitet, sollten Sie unbedingt getrennt nach Staffel kalkulieren und nicht den Preis der ersten Staffel auf alle Anfragen anwenden.
Der zweite Punkt ist der Einführungspreis von Gemini 4 Carbon. Der aktuelle Preis entspricht dem Einführungspreis von Google bis 2026-11-30. Ab dem 1. Dezember gilt bei Google der Standardpreis von $4 / 1M für die Eingabe und $20 / 1M für die Ausgabe. Für spätere Preise der Plattform gilt die Modellliste von APIYI als Referenz; für die Budgetplanung im Dezember sollten Sie diese Differenz vorsorglich einplanen.
Warum sich die Kosten nicht mit dem Stückpreis eines einzigen Anbieters zusammenfassen lassen
Aus der obigen Tabelle wird deutlich: Bei derselben Ausgabemenge von einer Million Token kostet Hydrogen $7.5, während Claude Fable 5.2 und GPT-6.2 Astra in der ersten Preisstufe $40 kosten – mehr als das Fünffache. Wenn ein Team drei oder vier Modelle gleichzeitig betreibt und nur einen „Durchschnittspreis“ oder den Preis eines einzelnen Anbieters betrachtet, besteht schnell die Gefahr, die Kosten stark zu unterschätzen oder zu überschätzen. Ein robusterer Ansatz besteht darin, „Modell-ID + Endpunkt“ als Kanal-Schlüssel zu verwenden, für jeden Kanal Eingabe-, Ausgabe- und Cache-Lese-Token getrennt zu erfassen, jeweils mit dem eigenen Stückpreis zu multiplizieren und erst am Ende zu summieren.
Außerdem gilt: Ein einheitlicher Zugang senkt die Anbindungskosten, bedeutet aber nicht, dass jedes Modell zwangsläufig günstiger ist. In der obigen Tabelle entsprechen die Preise mehrerer Gemini-4-Modelle den Listenpreisen von Google. Ob sich das preislich lohnt, sollten Sie für jeden Kanal einzeln mit Ihrer tatsächlichen Nutzung vergleichen, statt pauschal zu urteilen.
💰 Kostenhinweis: Für einen Vergleich bei der Modellauswahl können Sie bei APIYI (apiyi.com) mit denselben Testbeispielen Hydrogen, Neon und Carbon separat aufrufen, den Tokenverbrauch anschließend pro Kanal festhalten, die tatsächlichen Kosten pro Aufruf für jeden Kanal berechnen und dann das Hauptmodell wählen.
Häufig gestellte Fragen (FAQ)
Q1: Was bedeutet „ein Zugang, Modellwechsel inklusive“?
Damit ist gemeint, dass sich alle Modelle denselben base_url und denselben API-Schlüssel teilen. Beim Wechsel des Modells ändern Sie einfach die Modell-ID im `model`-Parameter und prüfen, ob der Endpunkt für dieses Modell unterstützt wird. Sie müssen sich nicht bei jedem Anbieter einzeln registrieren und auch nicht jeweils ein eigenes SDK anbinden.
Q2: Kann ich ein Modell, das gerade erst in den Nachrichten erschienen ist, direkt aufrufen?
Nicht unbedingt. Veröffentlicht heißt nicht automatisch verfügbar. Stand 20.11.2026 zum Beispiel tauchte MAI Image 2.7 nur in den Nachrichten auf, im Angebot von APIYI gab es lediglich `MAI-Image-2.6` und `MAI-Image-2.6-Flash`; 2.7 war noch nicht gelistet und wird so schnell wie möglich aufgenommen. Prüfen Sie vor dem Aufruf die Übersichtstabelle und die Preis-API und stellen Sie sicher, dass die Modell-ID existiert, bevor Sie integrieren.
Q3: Wie wähle ich bei Gemini 4 zwischen Carbon, Hydrogen und Neon?
Wählen Sie die Stufe nach der Aufgabenschwierigkeit: Für lange Ketten und anspruchsvolle Aufgaben Carbon; für häufige Alltagsaufrufe, bei denen Geschwindigkeit zählt, Hydrogen; für alles dazwischen Neon. Die drei wurden am 10., 12. und 18. November veröffentlicht, und die Preise unterscheiden sich. Am besten vergleichen Sie sie mit demselben Samplesatz und legen danach fest, welches Modell Ihr Hauptmodell wird.
Q4: Ich finde gemini-4-neon nicht in der Übersichtstabelle – heißt das, es ist noch nicht nutzbar?
Schauen Sie nicht nur auf die Übersichtstabelle. In der Version vom 19.11.2026 fehlte `gemini-4-neon`, aber die Preis-API liefert bereits den vollständigen Faktor: umgerechnet `$3 / 1M` für die Eingabe, `$15 / 1M` für die Ausgabe und `$0.15 / 1M` für das Lesen aus dem Cache. Die beiden Informationsquellen sind zeitlich versetzt; verlassen Sie sich auf die Preis-API und auf einen kleinen Test mit echtem Aufruf.
Q5: Wie rufe ich diese neuen Modelle vom November schnell über die API auf?
Empfohlenes Vorgehen:
1. Registrieren Sie sich bei APIYI unter apiyi.com, holen Sie sich den API-Schlüssel und das kostenlose Testkontingent für neue Nutzer.
2. Prüfen Sie die Modellübersicht und die Preis-API und bestätigen Sie die Ziel-Modell-ID.
3. Setzen Sie base_url auf die OpenAI-kompatible Adresse der Plattform und wählen Sie gemäß der oben genannten Endpunkt-Tabelle chat, messages, responses oder gemini.
4. Senden Sie zuerst eine kurze Anfrage, vergewissern Sie sich, dass sie funktioniert, und binden Sie das Modell erst dann in Ihre Anwendung ein.
Q6: Kostet dasselbe Claude Fable 5.2 über chat anders als über messages?
In den Referenzmaterialien haben `claude-fable-5-2` und `claude-fable-5-2-thinking` denselben Preis: `$8 / 1M` für die Eingabe, `$0.2 / 1M` für das Lesen aus dem Cache und `$40 / 1M` für die Ausgabe. Die Unterlagen unterscheiden nicht nach Endpunkt. Beim Abrechnen empfiehlt es sich trotzdem, den Endpunkt als Teil des Kanalschlüssels zu führen, damit Sie Probleme und spätere Abgleiche leichter nachvollziehen können.
Q7: Ist ein einheitlicher Zugang immer günstiger als die direkte Anbindung an den offiziellen Anbieter?
So pauschal lässt sich das nicht sagen. Der Hauptvorteil eines einheitlichen Zugangs liegt darin, dass Sie weniger Schnittstellen anbinden müssen und Authentifizierung sowie Abrechnung an einer Stelle gebündelt sind. Die Preise müssen Sie Kanal für Kanal prüfen – bei `gemini-4-neon` etwa entspricht der Preis dem Google-Listenpreis. Ob es unterm Strich günstiger ist, hängt von Ihrem Modellmix und Ihrem Volumen ab; das müssen Sie selbst pro Kanal durchrechnen.
Q8: Welche bekannten Einschränkungen sollte ich im Voraus einplanen?
Im Wesentlichen gibt es drei Punkte. Erstens sind einige neue Modelle noch nicht gelistet, zum Beispiel MAI Image 2.7, Kling, Muse und `gemini-4-flash-lite` lassen sich derzeit nicht finden. Zweitens gibt es bei Einführungspreisen ein Enddatum: Der Google-Einführungspreis für Gemini 4 Carbon gilt bis zum 30. November. Drittens gilt bei GPT-6.2 Astra ab mehr als 272000 Token eine Staffelpreisregelung. In diesen Fällen passen Sie zuerst den Plan an die Plattformliste an und ändern erst danach den Code.
Kernpunkte zur Integration neuer Modelle im November
- Erst das Angebot prüfen, dann Code schreiben: Orientieren Sie sich an der Modellübersicht und der Preis-API und halten Sie in den News angekündigte Modelle und tatsächlich aufrufbare Modelle getrennt fest.
- Beim Modellwechsel nur zwei Stellen ändern: Unter derselben
base_urldie Modell-ID ändern und anschließend den Endpunkttyp prüfen. - Den passenden Endpunkt wählen: Gemini über
chatodergemini, Claude überchatodermessages, für GPT-6.2 Astra empfiehlt sichresponses. - Wer die Multiplikatoren lesen kann, kann auch den Preis berechnen:
model_ratio × 2entspricht dem Eingabepreis pro Einheit; danach mit den Multiplikatoren für Ausgabe und Cache multiplizieren. - Abrechnung nach Kanälen trennen: Buchen Sie getrennt mit dem Schlüssel „Modell-ID + Endpunkt“ und verwenden Sie nicht einen Einheitspreis für alles.
- Fristen und Staffelpreise beachten: Der Einführungspreis für Carbon und die 272000-Token-Staffel bei Astra beeinflussen das Budget.
- Einstiegsweg: Bei APIYI mit einem API-Schlüssel das kostenlose Kontingent abholen, zuerst das Alltagsmodell testen und dann einen Quervergleich anstellen.
Fazit: Im November drängen sich neue Modelle – ein Zugang für den Modellwechsel, Abrechnung nach Kanälen getrennt betrachtet
Wenn im November die neuen Modelle in Scharen eintreffen, liegt der Schlüssel zur Integration nicht darin, jeder einzelnen Meldung hinterherzujagen, sondern einen festen Ablauf zu etablieren:
- Modellliste abgleichen: Sowohl die Übersichtstabelle als auch die Preis-API prüfen. Das in den News erwähnte MAI Image 2.7 ist noch nicht im Sortiment – plane es nicht für den Go-live ein.
- Modell-ID wechseln, Endpunkt prüfen: Eine einzige base_url deckt mehrere Modelle ab; wähle anhand der Endpunkt-Zuordnungstabelle chat, messages, responses oder gemini.
- Abrechnung nach Kanal prüfen: Token und Kosten für jedes Modell und jeden Endpunkt separat berechnen und dabei das Ende des Einführungspreises sowie die Langkontext-Staffelung im Auge behalten.
Sobald der Ablauf steht, reicht beim nächsten Modell-Release ein einziger Eintrag der Modell-ID in der Konfiguration plus ein Blick in die Preis-API, und Integration und Kostenbewertung sind erledigt. Empfehlung: Bei APIYI apiyi.com zunächst mit dem kostenlosen Guthaben für neue Nutzer einen Kanal durchtesten und dann nach und nach Gemini 4, Claude Fable 5.2 und GPT-6.2 Astra in den Vergleich aufnehmen.
📚 Referenzen
-
Google offizieller Blog – Ankündigung von Gemini 4 Neon: Vorstellung der Gemini-4-Modellreihe
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Beschreibung: Positionierung und Erscheinungsdatum von Carbon, Hydrogen und Neon kennenlernen
- Link:
-
APIYI Modellübersicht und Preis-API: Quelle zum Abgleich von Modellbezeichnung und Preis
- Link: siehe Abschnitt „Modell in den News ≠ Modell im Sortiment“ im Haupttext
- Beschreibung: Die Versionen von Übersichtstabelle und Preis-API können voneinander abweichen; am besten beide Stellen vergleichend prüfen
Autor: APIYI-Team
Technischer Austausch: Kontaktiere uns gerne über die Startseite der APIYI-Website; weitere Integrationsdokumente findest du im Dokumentationszentrum unter docs.apiyi.com