Autorenhinweis: Auf Basis der veröffentlichten Messdaten zu Kimi K3 schätze ich die Hardwareanforderungen, monatlichen Kosten, Kosten pro Token und den Break-even-Punkt für den lokalen Betrieb von K3.1 Pro. So kannst du entscheiden, wann sich Mieten, Kaufen oder die direkte Nutzung der API lohnt.
Das Wichtigste vorweg: Kimi K3.1 Pro soll bald als Open-Weight-Modell verfügbar sein, aber der lokale Betrieb ist nicht für Privatpersonen gedacht. Laut offizieller Ankündigung werden die vollständigen Gewichte bis zum 4. November veröffentlicht. Das Modell ist als Open-Weight-Modell der 3-T-Parameterklasse positioniert. Am 26. Oktober 2026 sind die Gewichte von K3.1 Pro noch nicht verfügbar. Alle Angaben zu Hardware und VRAM in diesem Artikel beruhen auf Messwerten zum bereits veröffentlichten Kimi K3. Nach der Veröffentlichung der Gewichte müssen sie überprüft werden.
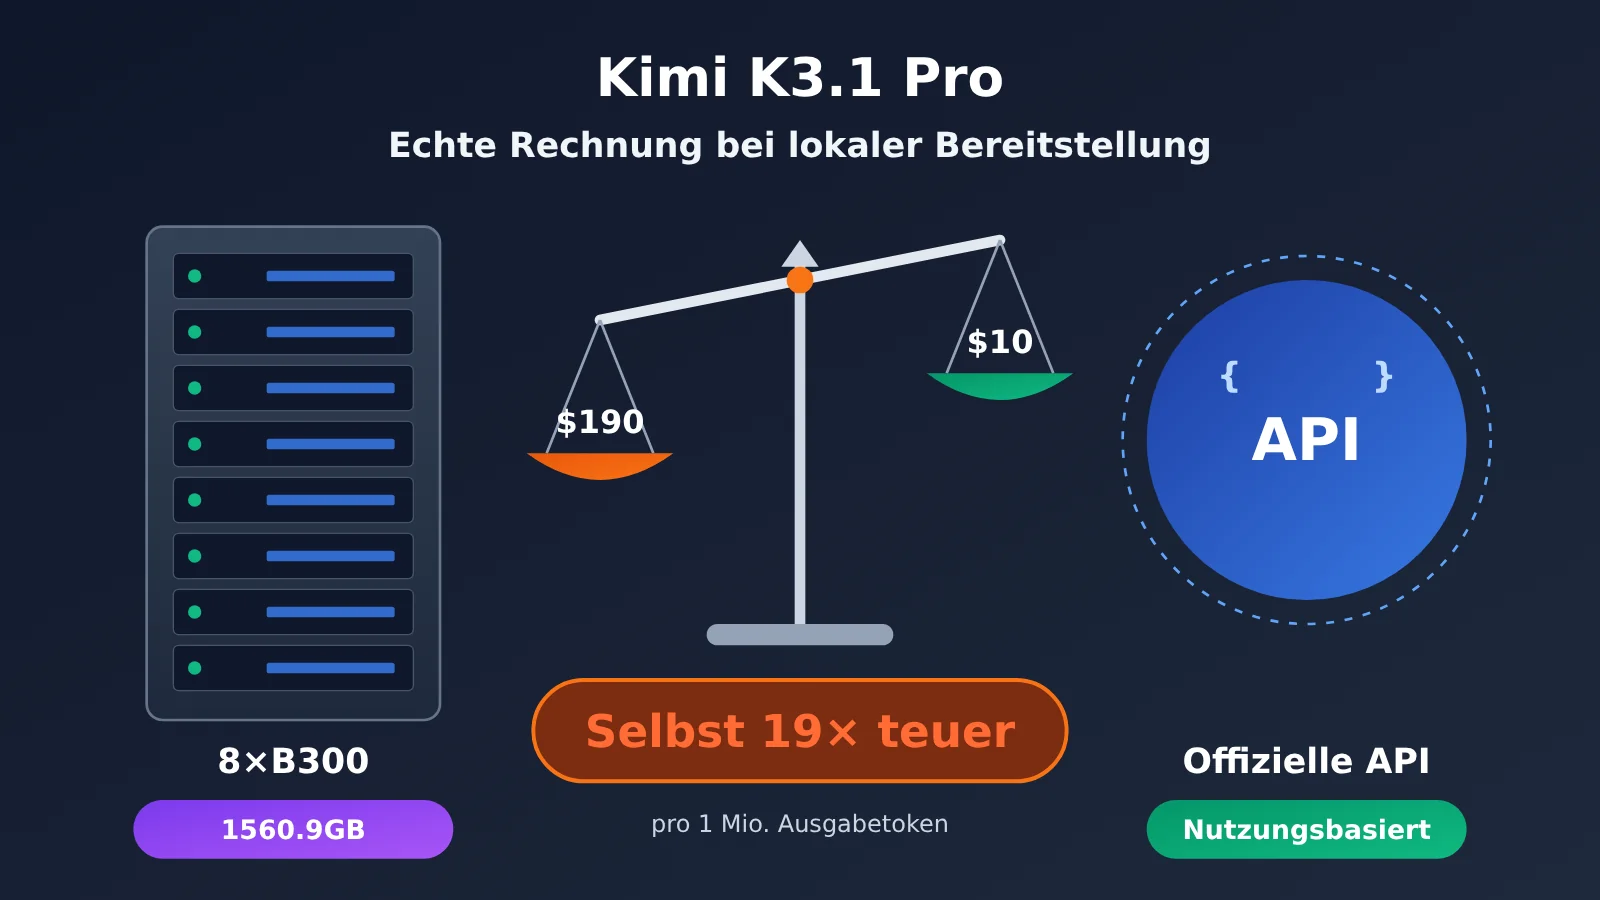
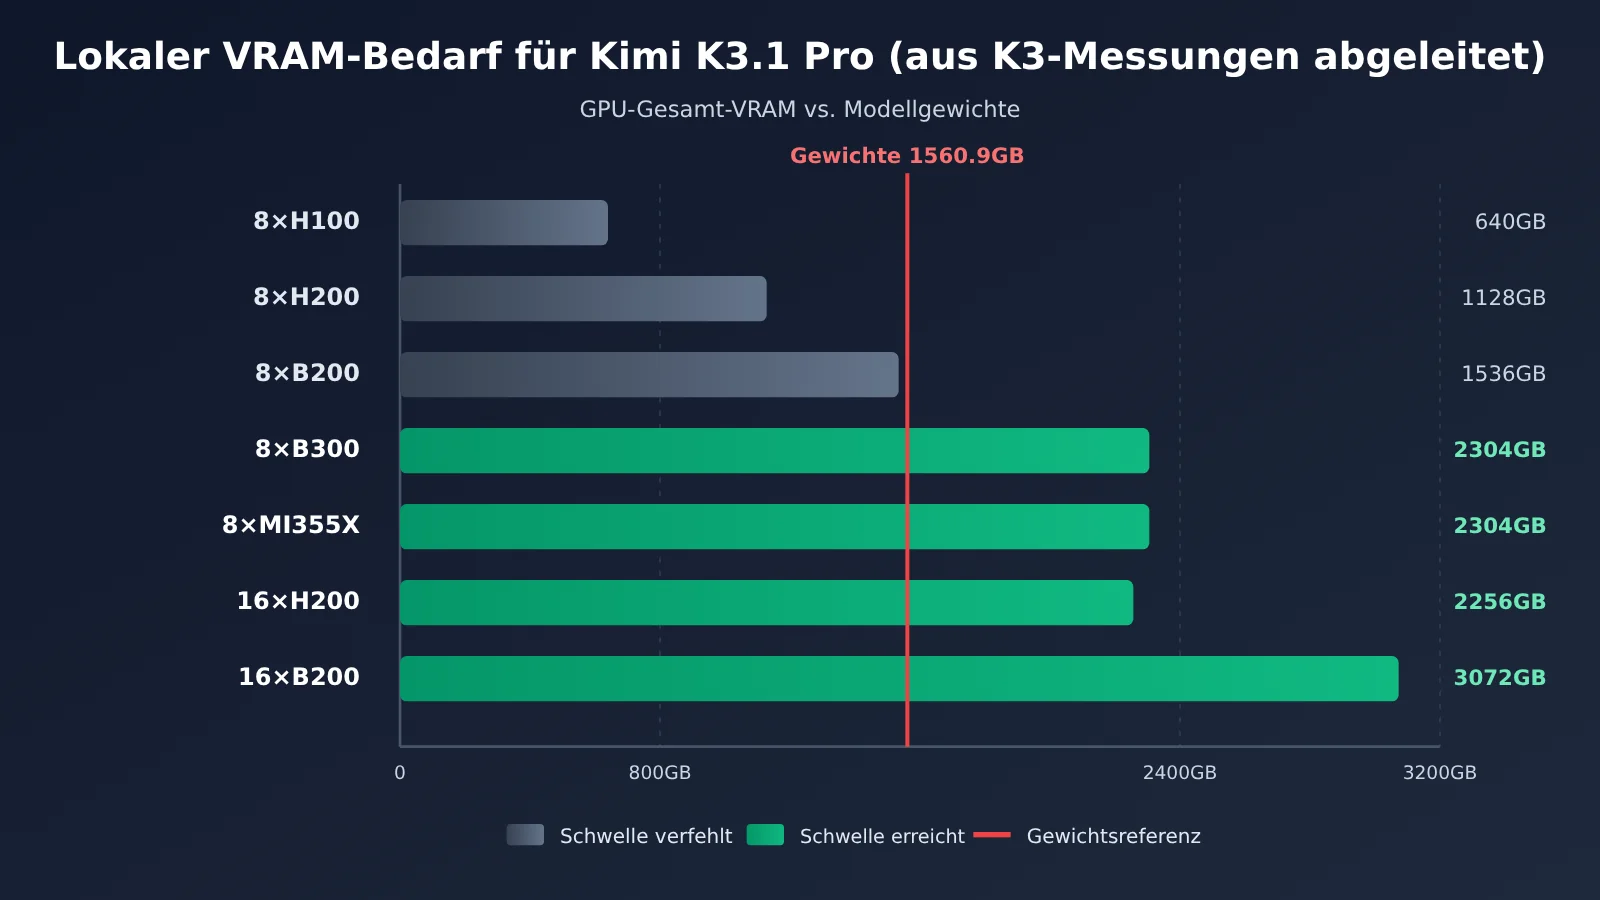
Laut den Messungen zu K3 belegen allein die Gewichte 1.560,9 GB. Acht B300-Karten reichen gerade aus, acht H200-Karten fehlen dagegen rund 400 GB. Wenn du eine Maschine mit 8 × B300 allein nutzt, kostet dich eine Million ausgegebene Tokens rund 190,00 $ – also das 19-Fache des offiziellen API-Preises von 10,00 $.
Dieser Artikel soll dich nicht abschrecken, sondern dir die Entscheidungsgrundlage für den Eigenbetrieb liefern. Zu jeder Zahl ist angegeben, ob sie aus einer offiziellen Quelle, einem unabhängigen Praxistest oder einer Schätzung dieses Artikels stammt. Du kannst die Berechnungen direkt auf dein eigenes Nutzungsvolumen übertragen.
Der zentrale Nutzen: Nach der Lektüre kannst du die tatsächlichen Kosten für den Eigenbetrieb von Kimi K3.1 Pro berechnen und anhand einer Checkliste entscheiden, ob du eine Maschine mieten, kaufen oder direkt die API nutzen solltest.
Zentrale Punkte zur lokalen Bereitstellung von Kimi K3.1 Pro
| Punkt | Ergebnis | Belegebene |
|---|---|---|
| Status der Gewichte | Noch nicht veröffentlicht; laut offizieller Angabe erfolgt die Veröffentlichung vor dem 4. November | Offizielle Quelle |
| Umfang der Gewichte | Die K3-Gewichte umfassen 1.560,9 GB; K3.1 Pro verwendet dieselbe Architektur | Messung eines Drittanbieters (K3) |
| Mindestkonfiguration für einen einzelnen Rechner | 8×B300 / 8×GB300 / 8×MI355X | Rezepte für Inferenz-Frameworks + Messungen |
| Kosten pro Million Ausgabetoken bei Eigenbetrieb | Etwa 190,00 $ | Abrechnung eines Drittanbieters |
| Voraussetzung, um mit der API gleichzuziehen | Langfristig stabil über 1.500 tok/s ausgeben | Schätzung in diesem Artikel |
Einordnung der Fakten zur lokalen Bereitstellung von Kimi K3.1 Pro
In diesem Artikel unterscheiden wir drei Belegebenen. Offizielle Quelle bezieht sich auf Angaben von Moonshot im Kimi.ai-Blog, in der Dokumentation auf platform.kimi.ai und auf der Modellkarte bei Hugging Face. Messungen von Drittanbietern umfasst veröffentlichte Testergebnisse von AWS, GPUStack, OpenZeka und Modal-Nutzern. Die jeweiligen Quellen und Daten nennen wir im Artikel. Schätzungen in diesem Artikel beruhen auf öffentlich verfügbaren Preisen und Durchsatzwerten. Wir legen die Formeln und Annahmen offen; die Ergebnisse sind keine offiziellen Angaben.
Auch die Grundlage für unsere Schätzung stammt aus offiziellen Angaben: Kimi K3.1 Pro ist eine nachtrainierte Version von Kimi K3 (post-trained version of Kimi K3) und übernimmt dessen Architektur. Lediglich der Rechenaufwand für das RL-Nachtraining wurde erhöht. Daher sind Parameteranzahl, Quantisierungsformat und Umfang der K3-Gewichte ein sinnvoller Richtwert für die Mindestanforderungen an die Bereitstellung von Kimi K3.1 Pro.
Kimi K3.1 Pro: Hardwareanforderungen für den lokalen Betrieb – warum es erst ab 8 B300 losgeht
【Offizielle Angaben】Laut Modellkarte von K3 hat das Modell insgesamt 2,8 T Parameter, davon sind 104 B aktiv. Es umfasst 93 Layer. Von 896 gerouteten Experten werden pro Token 16 ausgewählt; zusätzlich gibt es 2 gemeinsam genutzte Experten. Das Kontextfenster umfasst 1.048.576 Token. Die Gewichte verwenden MXFP4, die Aktivierungen MXFP8. Bereits in der SFT-Phase kam quantisierungsbewusstes Training zum Einsatz.
【Messungen Dritter】Jemand hat die Dateien im Hugging-Face-Repository einzeln erfasst: Die 96 Safetensors-Shards umfassen insgesamt 1.560.936.091.448 Byte, also rund 1.560,9 GB. Der gemessene Umfang liegt über dem theoretischen Wert von „2,8 T × 0,5 Byte = 1.400 GB“, weil in der Config unter anderem Attention-Layer, gemeinsam genutzte Experten, lm_head und der Vision-Tower auf einer Whitelist stehen und deshalb mit höherer Präzision gespeichert werden. Das vLLM-Rezept setzt mindestens 1.680 GB VRAM voraus und gibt an, dass mindestens 8×GB300 benötigt werden. Für den produktiven Einsatz mit realer Auslastung sind mehrere Knoten nötig.
| Konfiguration | Gesamter VRAM | Läuft es? | Hinweise |
|---|---|---|---|
| 8×H100 80GB | 640GB | Nein | Die Gewichte sind 2,4-mal so groß wie der VRAM |
| 32×H100 | 2,56TB | Knapp | Für SGLang gibt es ein Rezept, aber Hopper unterstützt MXFP4 nicht nativ; es ist eine Dequantisierung zur Laufzeit erforderlich |
| 8×H200 141GB | 1,13TB | Nein | Rund 400GB fehlen – die enttäuschendste Option |
| 16×H200 (zwei Rechner) | 2,26TB | Ja | Auch hier ist eine Dequantisierung erforderlich |
| 8×B200 180GB | 1,44TB | Nein | Rund 120GB fehlen |
| 16×B200 / GB200 | 2,88TB | Ja | Blackwell-Referenzkonfiguration |
| 8×B300 / GB300 | 2,30TB | Ja | Offizieller Standardweg; passt gerade so in einen einzelnen Rechner |
| 8×MI355X | 2,30TB | Ja | AMD-Day-0-Validierung |
| Einzelne Karte / RTX 4090 / 512GB Mac | — | Nein | Für die Gewichte bräuchte man 75 RTX 4090 |
Der KV-Cache ist dagegen kein Engpass. Bei K3 verwenden nur 24 Layer Gated MLA und benötigen etwa 27 KiB pro Token. Die übrigen 69 KDA-Layer brauchen pro Sequenz lediglich einen festen Zustand. Berechnungen Dritter zufolge beträgt der KV-Cache für einen einzelnen Nutzer bei einem Kontext von 1M etwa 29,5GB und bei 8K Kontext etwa 0,7GB. Der eigentliche Engpass sind die Gewichte mit ihren 1,56TB.
Wenn du das Modell trotzdem bereitstellen möchtest, gelten auf Framework-Seite folgende zwingende Voraussetzungen (aus dem vLLM-Rezept und dem SGLang-Cookbook für K3):
- vLLM-Image:
vllm/vllm-openai:kimi-k3. Es gibt nur eine CUDA-13-Version; erforderlich sind Treiber ab r580 und vLLM ≥ 0.27.0. - Parallelisierungsstrategie: mindestens 8 Karten für TP / TEP und mindestens 16 Karten für DEP. Verteilte KV-Caches werden für alle aufgeführten Hardwarekonfigurationen als nicht unterstützt ausgewiesen.
- SGLang-Knotenplanung: Für B300 reicht ein Knoten mit 8 Karten; für B200 und H200 sind jeweils zwei Knoten mit 8 Karten erforderlich.
- Nach Angaben von Moonshot aus dem August 2026 (über Dritte wiedergegeben) werden für den Produktivbetrieb Supernodes mit mehr als 64 Beschleunigern empfohlen.
Reale Kosten für den lokalen Einsatz von Kimi K3.1 Pro: vier Wege und ihre monatlichen Kosten
Die folgende Schätzung geht von einem einzelnen 8×B300-Server aus, der rund um die Uhr läuft. Für die Umrechnung gilt einheitlich: 1 US-Dollar = 7,25 Yuan. Die Preise stammen aus drei Quellen: stundenweise Abrechnungspreise von ComputeUnion, erhoben am 24. und 25. Oktober 2026, tatsächliche Abrechnungsdaten eines Modal-Nutzers sowie das Protokoll der „Branchenstudie zur Anmietung von Rechenleistung“ (am 20. Mai 2026 von Sina Finance veröffentlicht).
⚠️ Preise für die Anmietung und den Kauf kompletter Server in China (z. B. rund 80.000 Yuan pro Monat und H200-Server, 160.000–190.000 Yuan pro Monat für einen B300-Server bei einem Fünfjahresvertrag sowie 6,8–7 Millionen Yuan für einen B300-Server zum aktuellen Marktpreis) stammen aus Branchenrecherchen und sind keine öffentlich verfügbaren Herstellerpreise. Sie dienen lediglich als grobe Orientierung. Üblicherweise werden komplette 8-Karten-Server angeboten; die Mindestvertragslaufzeit beträgt ein Jahr.
| Modell | Berechnungsgrundlage | Monatliche Kosten | Anmerkungen |
|---|---|---|---|
| Stundenweise Anmietung im Ausland (24/7) | B300-Server: 342–464 Yuan pro Stunde × 730 Stunden | ca. 249.800–338.700 Yuan (34.500–46.700 US-Dollar) | Drittanbieterpreise + Schätzung in diesem Artikel |
| Modal-Messung (24/7) | 56,79 $/Stunde × 730 Stunden | 41.457,00 $, ca. 300.600 Yuan | Tatsächliche Abrechnung eines Drittanbieters |
| Anmietung eines kompletten Servers in China mit Fünfjahresvertrag | Grundlage: Branchenrecherche | 160.000–190.000 Yuan | Nicht öffentliche Preise, Mindestlaufzeit 1 Jahr |
| Kauf + Stromkosten | 6,8–7 Millionen Yuan, linear über 3 Jahre abgeschrieben, zuzüglich ca. 8.800 Yuan Stromkosten | ca. 198.000–203.000 Yuan | Ohne Personal für den Betrieb, Ersatzteile, Stellfläche und Bandbreite |
| Täglicher Betrieb für 4 Stunden, danach herunterfahren | Stundenweise Anmietung im Ausland | ca. 26.000–30.000 Yuan | Jeder Neustart verursacht einen Kaltstart von etwa 27 Minuten |
Die Stromkosten beruhen auf den folgenden Annahmen: 13,2 kW Last, PUE von 1,3 und ein Strompreis von 0,7 Yuan/kWh. Das ergibt rund 12 Yuan pro Stunde. Der Kauf scheint auf den ersten Blick am günstigsten, doch die Personalkosten für Betriebsingenieure sind in der Tabelle nicht berücksichtigt – und genau sie sind für kleine Teams oft der größte versteckte Kostenfaktor.
„Jeden Tag nur vier Stunden laufen lassen und dann herunterfahren“ klingt sparsam, ist in der Praxis aber schwer umzusetzen. Laut Messungen mit Modal dauert der Kaltstart etwa 27 Minuten: Dabei müssen 1,56 TB Modellgewichte geladen, eine JIT-Kompilierung durchgeführt und 51 CUDA Graphs erfasst werden. Bei kurzen Aufgaben kann die Wartezeit nach dem Start länger sein als die eigentliche Inferenz.
Kimi K3.1 Pro: Kosten pro Einheit – der Durchsatz entscheidet, wie viel teurer du im Vergleich zur API bist
Die Monatsmiete ist nur der sichtbare Teil der Rechnung. Entscheidend für die Wirtschaftlichkeit sind die Kosten pro einer Million Token. Die Berechnung in diesem Artikel lautet: Kosten pro einer Million ausgegebener Token = Maschinenkosten pro Stunde ÷ ausgegebene Token pro Stunde (in Millionen). Für den Zähler setzen wir einheitlich die von Modal gemessenen 56,79 $/Stunde an.
【Messungen Dritter】Hier einige Durchsatzwerte für 8×B300-Systeme:
- Modal, Einzelserver (TP8, natives MXFP4): stabil 92 tok/s, TTFT 0,92–1,02 Sekunden
- OpenZeka (DGX B300, TP8, vLLM): bei Parallelität 1 sind es 105,7 tok/s, bei Parallelität 64 pro Nutzer 32,45 tok/s. Geschätzt reicht die Kapazität für 150 Chat-Nutzer oder 50 Agent-Nutzer.
- Offizielles AWS-Beispiel (29. Juli 2026, p6-b300.48xlarge): bei Parallelität 8 sind es 516 tok/s, bei hoher Parallelität insgesamt 4.634 tok/s
- GPUStack (30. Juli 2026): bei 64K Eingabe und Parallelität 10 dauerte die Ende-zu-Ende-Verarbeitung mit vLLM 100,5 Sekunden; der aggregierte Prefill-Durchsatz lag bei etwa 19K–23K tok/s
| Stabiler Ausgabedurchsatz | Ausgegebene Token pro Stunde | Kosten pro einer Million ausgegebener Token | Im Vergleich zur offiziellen API für 10,00 $ |
|---|---|---|---|
| 92 tok/s (eine Anfrage bei voller Auslastung) | 0,33M | 171,50 $ (nach Berechnung des ursprünglichen Autors: 190,00 $) | etwa 17–19-mal so teuer |
| 500 tok/s | 1,80M | 31,50 $ | etwa 3-mal so teuer |
| 1.000 tok/s | 3,60M | 15,80 $ | etwa 1,6-mal so teuer |
| 1.500 tok/s | 5,40M | 10,50 $ | ungefähr gleichauf |
| 3.000 tok/s | 10,80M | 5,30 $ | etwa halb so teuer |
| 4.634 tok/s (gemessener AWS-Spitzenwert) | 16,68M | 3,40 $ | etwa ein Drittel |
Bei einem oder wenigen Nutzern liegt der tatsächliche Durchsatz auf dem Niveau der ersten Zeile. Ohne genügend parallele Anfragen steht ein Großteil der Rechenleistung still. Dann kostet eine Million ausgegebener Token etwa 190,00 $ – daher die „19-mal teurer“ im Titel. Erst wenn die Workload den Durchsatz dauerhaft über 1.500 tok/s hält, können die Kosten pro Einheit beim Eigenbetrieb mit der API gleichziehen.
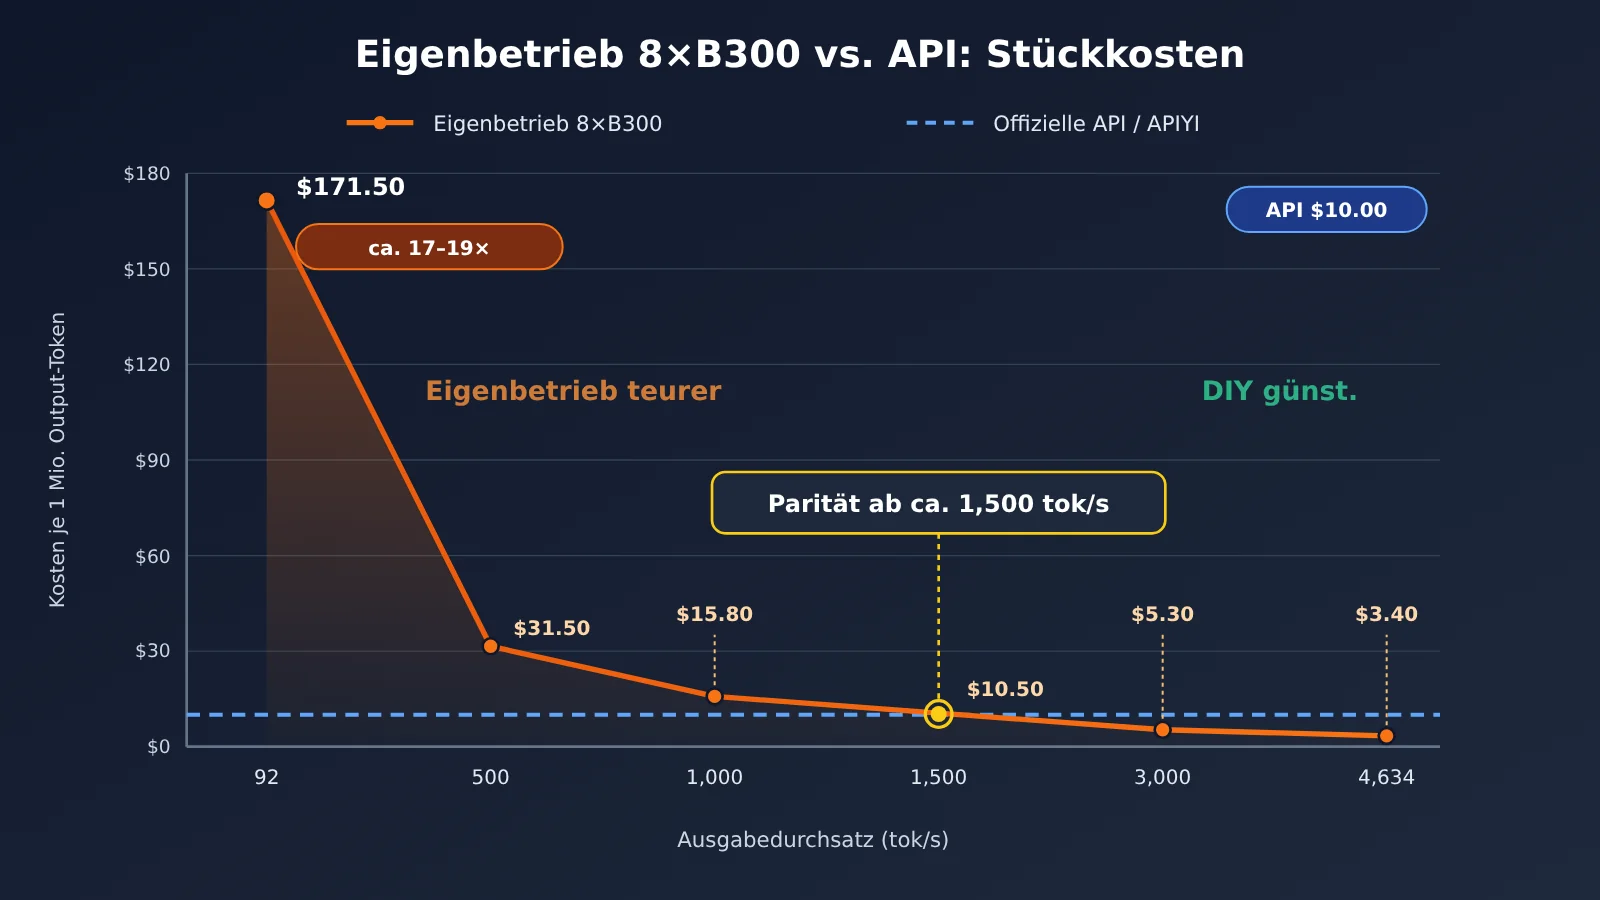
💡 Hinweis zum Vergleich: Als Referenzwert für die API verwendet das Diagramm den offiziellen Preis von 10,00 $ pro einer Million ausgegebener Token. Der Ausgabepreis von kimi-k3.1-pro bei APIYI apiyi.com entspricht dem offiziellen Preis und kann daher direkt als Vergleichswert dienen.
Break-even bei der lokalen Bereitstellung von Kimi K3.1 Pro: Wie viele Token pro Monat sind nötig?
Ein anderer Blickwinkel: Wie viele Token müssen Sie pro Monat nutzen, damit sich der Eigenbetrieb gegenüber der API rechnet? Die Schätzung in diesem Artikel basiert auf folgenden Annahmen: Zum Vergleich dienen die Preise der offiziellen API von 2,00 $ für Eingaben und 10,00 $ für Ausgaben. Das Verhältnis von Eingabe- zu Ausgabe-Token beträgt 5:1, wie in Agent-Szenarien häufig üblich. Cache-Treffer werden nicht berücksichtigt.
| Eigenbetriebsvariante | Monatliche Kosten | Benötigte Eingabe-Token pro Monat | Benötigte Ausgabe-Token pro Monat |
|---|---|---|---|
| Ausland, nutzungsbasiert und rund um die Uhr | 41.457,00 $ | ca. 10,4 Mrd. | ca. 2,07 Mrd. |
| Inlandsmaschine mit fünfjähriger Laufzeit | 190.000 Yuan | ca. 6,55 Mrd. | ca. 1,31 Mrd. |
| Kauf (Abschreibung + Stromkosten) | 203.000 Yuan | ca. 6,98 Mrd. | ca. 1,4 Mrd. |
Was bedeuten mehr als eine Milliarde Ausgabe-Token pro Monat in der Praxis? OpenZeka schätzt, dass ein System mit 8×B300 50 parallel arbeitende Agent-Nutzer unterstützen kann. Ein kleines Team mit weniger als zehn Personen kommt bei Weitem nicht auf dieses Nutzungsvolumen.
Ein weiterer Faktor wird leicht übersehen: der Cache. Für Cache-Treffer berechnet die offizielle API lediglich 0,20 $ pro Million Token. In Agent-Szenarien und bei langen Dokumenten sind die Cache-Trefferraten oft recht hoch. Je größer der Cache-Anteil, desto günstiger wird die API – und desto höher liegt der Schwellenwert, ab dem sich der Eigenbetrieb rechnet.
Wann sich ein Self-Hosting von Kimi K3.1 Pro lohnt
Ein Self-Hosting ist nicht grundsätzlich ausgeschlossen, sollte aber einen klaren Grund haben. In den folgenden Fällen ist es eine sinnvolle Wahl:
- Compliance oder Offline-Betrieb sind zwingend erforderlich: Die Daten dürfen das interne Netzwerk nicht verlassen oder müssen physisch isoliert bleiben. Selbst eine günstige API kommt dann nicht infrage. Die offizielle API unterstützt jedoch bereits Zero Data Retention (ZDR). Prüfen Sie daher zuerst, ob das Ihre Compliance-Anforderungen erfüllt.
- Sie möchten Fine-Tuning und Destillation durchführen: Sie wollen K3.1 Pro für ein bestimmtes Fachgebiet weitertrainieren oder zu einem kleineren Modell mit 30 bis 120 Milliarden Parametern destillieren. Dafür benötigen Sie die vollständigen Gewichte.
- Sie haben ungenutzte GPUs und eigenes Betriebspersonal: Die Grenzkosten sind erst dann niedrig, wenn beispielsweise 8×B300, 8×MI355X oder zwei H200-Systeme ungenutzt bereitstehen und ein erfahrener Engineer den Betrieb mit vLLM oder SGLang übernimmt.
- Ihr Geschäftsvolumen ist tatsächlich hoch genug: Sie erreichen dauerhaft mehr als 1.500 tok/s und kommen monatlich auf eine Milliarde ausgegebene Tokens.
Auch die Lizenz sollten Sie frühzeitig prüfen. K3 wird unter der Kimi K3 License veröffentlicht. Laut Zusammenfassungen von Drittanbietern ist eine separate Genehmigung erforderlich, wenn der Jahresumsatz mit dem externen Angebot von Modelldiensten 20 Millionen US-Dollar übersteigt. Für K3.1 Pro ist die Lizenz maßgeblich, die nach Veröffentlichung der Gewichte im Hugging-Face-Repository hinterlegt wird. Derzeit lässt sich dazu keine verbindliche Aussage im Namen des Anbieters treffen.
Wann Sie Kimi K3.1 Pro auf keinen Fall selbst hosten sollten
Bei den folgenden Motiven machen Sie mit einem selbst gehosteten Modell wahrscheinlich Verlust:
- Sie möchten Geld sparen: Nur wenn Ihr Durchsatz dauerhaft über 1.500 Tok/s liegt, lohnt sich der Betrieb. Andernfalls sind die Kosten pro Einheit höher als bei der API – bei privater Nutzung etwa um den Faktor 19.
- Sie möchten lange Aufgaben ausführen und den Betrieb bei Bedarf ein- und ausschalten: Der Kaltstart dauert etwa 27 Minuten. Ein bedarfsgesteuertes Ein- und Ausschalten ist damit praktisch nicht machbar.
- Das Modell ist nur für Sie oder ein kleines Team gedacht: Sie werden die verfügbare Parallelität nicht auslasten. Im Ergebnis zahlen Sie 56,79 $ pro Stunde für eine Geschwindigkeit von 92 Tok/s.
- Sie hoffen, das Modell durch Quantisierung auf eine einzelne Maschine zu bekommen: Keine der Community-Lösungen eignet sich für den Produktiveinsatz. Unsloth 1-bit (UD-IQ1_S, 594 GB) erreicht auf 8×A100 etwa 9 Tok/s. Das entspricht Kosten von 620,00 $ pro Million ausgegebener Token – also dem 3,3-Fachen der Vollversion. Die Top-1-Übereinstimmung zwischen dem 1-Bit-Modell und dem vollständigen Modell liegt bei etwa 79 %.
kimi-k3-in-ckann die vollständigen Gewichte mit 8,24 GB Speicher ausführen, braucht aber 10 bis 32 Sekunden pro Token und ist daher nur als technische Demonstration zu verstehen.
Die wirklich geeignete Form für den lokalen Betrieb sind künftig von der Community veröffentlichte destillierte Versionen. Bis dahin ist die API für Privatpersonen und kleine Teams die unkomplizierteste Lösung.
Kimi K3.1 Pro schnell starten: Erst den Geschäftsablauf per API testen
Bevor Sie sich für einen Eigenbetrieb entscheiden, sollten Sie unbedingt einen Monat lang echte Geschäftsabläufe über die API testen. So erhalten Sie konkrete Werte zu Eingaben, Ausgaben und Cache-Treffern und können anschließend mit der obigen Tabelle die Wirtschaftlichkeit berechnen. APIYI apiyi.com bietet kimi-k3.1-pro zu denselben Preisen wie der offizielle Anbieter an: 2,00 $ für Eingaben / 10,00 $ für Ausgaben / 0,20 $ für Cache-Lesezugriffe (in US-Dollar pro Million Tokens). Modell und Preise entnehmen Sie bitte der Modellliste auf der Plattform.
Wichtige Hinweise zur Anbindung (OpenAI-kompatible Schnittstelle):
- Registrieren Sie sich bei APIYI apiyi.com und erstellen Sie einen API-Schlüssel. Neue Nutzer erhalten ein kostenloses Testguthaben.
- Setzen Sie
base_urlim SDK aufhttps://api.apiyi.com/v1. - Geben Sie als Modell-ID
kimi-k3.1-proan. Wenn Sie eine höhere Geschwindigkeit benötigen, können Sie zukimi-k3.1-pro-highspeedwechseln (4,00 $ für Eingaben / 20,00 $ für Ausgaben). - Für die Inferenzstärke können Sie
reasoning_effortauflow,highodermaxsetzen. Die offizielle Voreinstellung istmax. Bei den offiziellen Benchmarks wurdentemperature = 1.0undtop_p = 0.95verwendet. - Bei mehrstufigen Dialogen und Tool-Aufrufen müssen Sie Assistant-Nachrichten mit
reasoning_contentunverändert zurücksenden. Andernfalls kann der Kontext fehlerhaft sein. - Erstellen Sie ein Skript zur Erfassung der Nutzungsdaten. Protokollieren Sie täglich
prompt_tokens,completion_tokensund die Cache-Treffer, um später fundiert über einen Eigenbetrieb entscheiden zu können.
| Modell | Eingaben | Ausgaben | Cache-Lesezugriffe | Verfügbare Plattformen |
|---|---|---|---|---|
| kimi-k3.1-pro | 2,00 $ | 10,00 $ | 0,20 $ | APIYI apiyi.com, offizielle Kimi-API |
| kimi-k3.1-pro-highspeed | 4,00 $ | 20,00 $ | 0,20 $ | APIYI, offizielle Kimi-API |
| kimi-k3 | 3,00 $ | 15,00 $ | 0,30 $ | APIYI |
🚀 Schnellstart: Wenn sich Ihr Projekt noch in der Validierungsphase befindet, empfiehlt es sich, über APIYI apiyi.com mit demselben Schlüssel sowohl kimi-k3.1-pro als auch andere gängige Modelle zu testen. Prüfen Sie zuerst, ob K3.1 Pro für Ihre Aufgaben tatsächlich die beste Wahl ist, und entscheiden Sie erst danach, ob sich ein Eigenbetrieb lohnt.
Häufige Fragen zur lokalen Bereitstellung von Kimi K3.1 Pro
F1: Können die Gewichte von Kimi K3.1 Pro bereits heruntergeladen werden?
Noch nicht. Im offiziellen Original heißt es: „The full model weights will be released by Nov 4“ – die vollständigen Modellgewichte sollen also bis zum 4. November 2026 veröffentlicht werden. Alle Hardwareangaben in diesem Artikel basieren auf Hochrechnungen anhand des bereits veröffentlichten K3. Sobald die Gewichte verfügbar sind, sollten Sie die Angaben anhand der tatsächlichen Dateigröße noch einmal überprüfen.
F2: Warum lässt sich Kimi K3.1 Pro nicht mit 8 H200 ausführen?
8 × H200 bieten insgesamt 1,13 TB VRAM. Die K3-Gewichte sind in Messungen jedoch 1560,9 GB groß – es fehlen also rund 400 GB. Außerdem unterstützt Hopper MXFP4 nicht nativ. Selbst mit zwei Systemen mit jeweils 16 × H200 ist daher eine Laufzeit-Dequantisierung erforderlich, die die Geschwindigkeit begrenzt.
F3: Wie kommt die Angabe „19-mal teurer“ zustande?
Die Zahl stammt aus einer Messung eines Drittanbieters: 8 × B300 bei Modal kosten 56,79 $ pro Stunde. Bei einer stabilen Geschwindigkeit von etwa 92 Token/s pro Anfrage ergeben sich Kosten von rund 190,00 $ pro einer Million ausgegebener Token. Im Vergleich zum offiziellen API-Preis von 10,00 $ für die Ausgabe entspricht das dem 19-Fachen. Bei einer strikten Berechnung mit 92 Token/s wären es 171,50 $; in der Berechnung des ursprünglichen Autors sind auch Verluste aus dem realen Betrieb enthalten.
F4: Gibt es eine kostengünstige Möglichkeit für kleine Teams, Kimi K3.1 Pro selbst zu betreiben?
Im Grunde nicht. Bei einem Kauf fallen monatlich rund 200.000 Yuan an, Personalkosten noch nicht eingerechnet. Eine Quantisierung für den Betrieb auf einem einzelnen Rechner ist sogar teurer und liefert schlechtere Ergebnisse. Für kleine Teams ist eine nutzungsbasierte API realistischer: Über APIYI auf apiyi.com können Sie beispielsweise kimi-k3.1-pro aufrufen und zahlen nur für die tatsächliche Nutzung. Für Token, die durch Cache-Treffer abgedeckt sind, fallen lediglich 0,20 $ pro einer Million Token an.
F5: Wie kann ich Kimi K3.1 Pro schnell über eine API aufrufen?
Registrieren Sie sich bei APIYI auf apiyi.com und rufen Sie Ihren API-Schlüssel ab. Setzen Sie `base_url` auf `https://api.apiyi.com/v1` und tragen Sie als Modell `kimi-k3.1-pro` ein. Vorhandener Code mit dem OpenAI-SDK muss in der Regel nicht angepasst werden. Achten Sie bei mehrstufigen Gesprächen darauf, `reasoning_content` zurückzusenden.
F6: Welche bekannten Einschränkungen gibt es bei der lokalen Bereitstellung von Kimi K3.1 Pro?
Es gibt vor allem drei Einschränkungen. Erstens dauert der Kaltstart etwa 27 Minuten, weshalb sich das Modell nicht für eine elastische Skalierung eignet. Zweitens gibt es das vLLM-Image nur für CUDA 13; der Treiber muss mindestens Version r580 haben. Ältere Cluster müssen daher zunächst aktualisiert werden. Drittens wird der verteilte KV-Cache von keiner der aufgeführten Hardwarekonfigurationen unterstützt, was die Skalierung über mehrere Rechner hinweg einschränkt.
F7: Wann wird eine lokale Bereitstellung realistisch?
Erst wenn die Community destillierte Versionen mit 30 bis 120 Milliarden Parametern veröffentlicht. Solche Modelle eignen sich für den lokalen Betrieb durch Privatpersonen und kleine Teams. Ein vollständiges Modell mit 3 Billionen Parametern bleibt auf absehbare Zeit eine Aufgabe für Rechenzentren.
Wichtige Erkenntnisse zur lokalen Bereitstellung von Kimi K3.1 Pro
- Gewichte noch nicht veröffentlicht: Der Anbieter hat die Veröffentlichung bis zum 4. November zugesagt. Alle derzeitigen Zahlen sind Schätzungen auf Basis von K3.
- Mindestanforderungen an die Hardware: Die Gewichte umfassen 1.560,9 GB. Ein einzelner Server benötigt mindestens 8× B300, GB300 oder MI355X.
- Monatliche Kosten: Ein einzelner Server im 24/7-Betrieb kostet etwa 160.000–340.000 Yuan pro Monat – abhängig von der gewählten Variante.
- Kosten pro Einheit: Bei Eigenbetrieb liegen die Kosten bei etwa 190,00 US-Dollar pro 1 Million ausgegebener Tokens und damit beim 19-Fachen der offiziellen API.
- Voraussetzungen für Kostengleichheit: Langfristiger Durchsatz von mehr als 1.500 tok/s und ein monatliches Ausgabevolumen in der Größenordnung von einer Milliarde Tokens.
- Empfehlung für den Einstieg: Rufen Sie zunächst über APIYI (apiyi.com) das Modell kimi-k3.1-pro auf und testen Sie es mit realen Aufgaben. Entscheiden Sie anhand der Daten, ob sich ein Eigenbetrieb lohnt.
Checkliste: Welche Bereitstellungsart passt zu Ihnen?
Beantworten Sie die folgenden fünf Fragen, um herauszufinden, ob Sie besser mieten, selbst Hardware anschaffen oder eine API nutzen sollten:
- Müssen Daten aus Compliance-Gründen zwingend im internen Netzwerk bleiben, und reicht auch die offizielle ZDR-Option nicht aus? – Nein: Nutzen Sie direkt die API.
- Müssen Sie die Gewichte für Fine-Tuning oder Destillation verwenden? – Ja: Mieten Sie die Maschinen am besten kurzfristig nach Bedarf und schalten Sie sie ab, sobald Sie fertig sind.
- Liegt die monatliche Ausgabe stabil über 1,3 Milliarden Tokens? – Nein: Ein Eigenbetrieb ist definitiv teurer als die API.
- Haben Sie bereits ungenutzte Maschinen der Leistungsklasse 8× B300 oder MI355X und ein eigenes Betriebsteam? – Ja: Ein Eigenbetrieb kommt infrage. Andernfalls sollten Sie nicht eigens dafür Hardware anschaffen.
- Muss sich Ihr Betrieb jederzeit starten und stoppen sowie flexibel skalieren lassen? – Ja: Eine Kaltstartzeit von 27 Minuten ist im Eigenbetrieb nicht tragbar. Nutzen Sie die API.
Zusammenfassung
Die wichtigsten Erkenntnisse zur lokalen Bereitstellung von Kimi K3.1 Pro:
- Hohe Anforderungen: Ausgehend von K3 wird das Gewicht auf etwa 1,56 TB geschätzt. 8×B300 reichen gerade aus.
- Teuer für den Eigenbedarf: Im Einzelbetrieb kostet eine Million Ausgabetoken etwa 190,00 US-Dollar – das 19-Fache des API-Preises.
- Lohnt sich erst bei großem Umfang: Selbstbetrieb kommt erst infrage, wenn der Durchsatz dauerhaft über 1.500 tok/s liegt und monatlich Ausgabetoken im Milliardenbereich anfallen.
Für die meisten Entwickler und kleinen Teams in China ist die sinnvollste Reihenfolge: zuerst das Geschäft mit der API zum Laufen bringen, Nutzungsdaten sammeln und anschließend beurteilen, ob sich der Selbstbetrieb lohnt. Für Aufrufe von Kimi K3.1 Pro empfehlen wir APIYI apiyi.com: Die Preise entsprechen denen des offiziellen Anbieters, neue Nutzer erhalten ein kostenloses Guthaben und mit nur einem API-Schlüssel lassen sich nebenbei auch andere führende Modelle vergleichen.
📚 Referenzmaterial
- Offizieller Blogbeitrag zur Veröffentlichung von Kimi K3.1 Pro: Zeitpunkt der Veröffentlichung der Gewichte und Positionierung des Modells
- Link:
kimi.ai/blog/kimi-k3-1-pro -
Hinweis: Offizielle Quelle; bestätigt, dass die Gewichte vor dem 4. November veröffentlicht werden sollen
-
Offizielle API-Preisliste von Kimi: Preise für Eingabe, Ausgabe und Cache bei K3.1 Pro
- Link:
platform.kimi.ai/docs/pricing/chat -
Hinweis: Quelle für die API-Preisvergleiche in diesem Artikel
-
Kimi-K3-Modellkarte: Architektur, Quantisierung und Lizenz
- Link:
huggingface.co/moonshotai/Kimi-K3 -
Hinweis: 2,8 Billionen Parameter insgesamt, MXFP4-Quantisierung, Kimi-K3-Lizenz
-
vLLM-Kimi-K3-Rezept: Mindestanforderungen an den VRAM und Bereitstellung
- Link:
recipes.vllm.ai/moonshotai/Kimi-K3 -
Hinweis: Mindestens 8×GB300, mindestens 1.680 GB VRAM
-
Inferenzmessung mit 8×B300 auf AWS: Durchsatzwerte
- Link:
github.com/aws-samples/sample-llm-inference-on-eks -
Hinweis: Gesamtdurchsatz von 4.634 tok/s bei hoher Parallelität
-
GPUStack-Messung mit 8×B300: Vergleich von vLLM und SGLang bei langen Kontexten
- Link:
cnblogs.com/gpustack/p/22073008 - Hinweis: Ende-zu-Ende-Laufzeit bei Eingaben mit 64K und 200K Token
Autor: APIYI-Technikteam
Technischer Austausch: Sie können uns über die Startseite der APIYI-Website kontaktieren. Weitere Informationen zur Modellintegration finden Sie im Dokumentationszentrum unter docs.apiyi.com