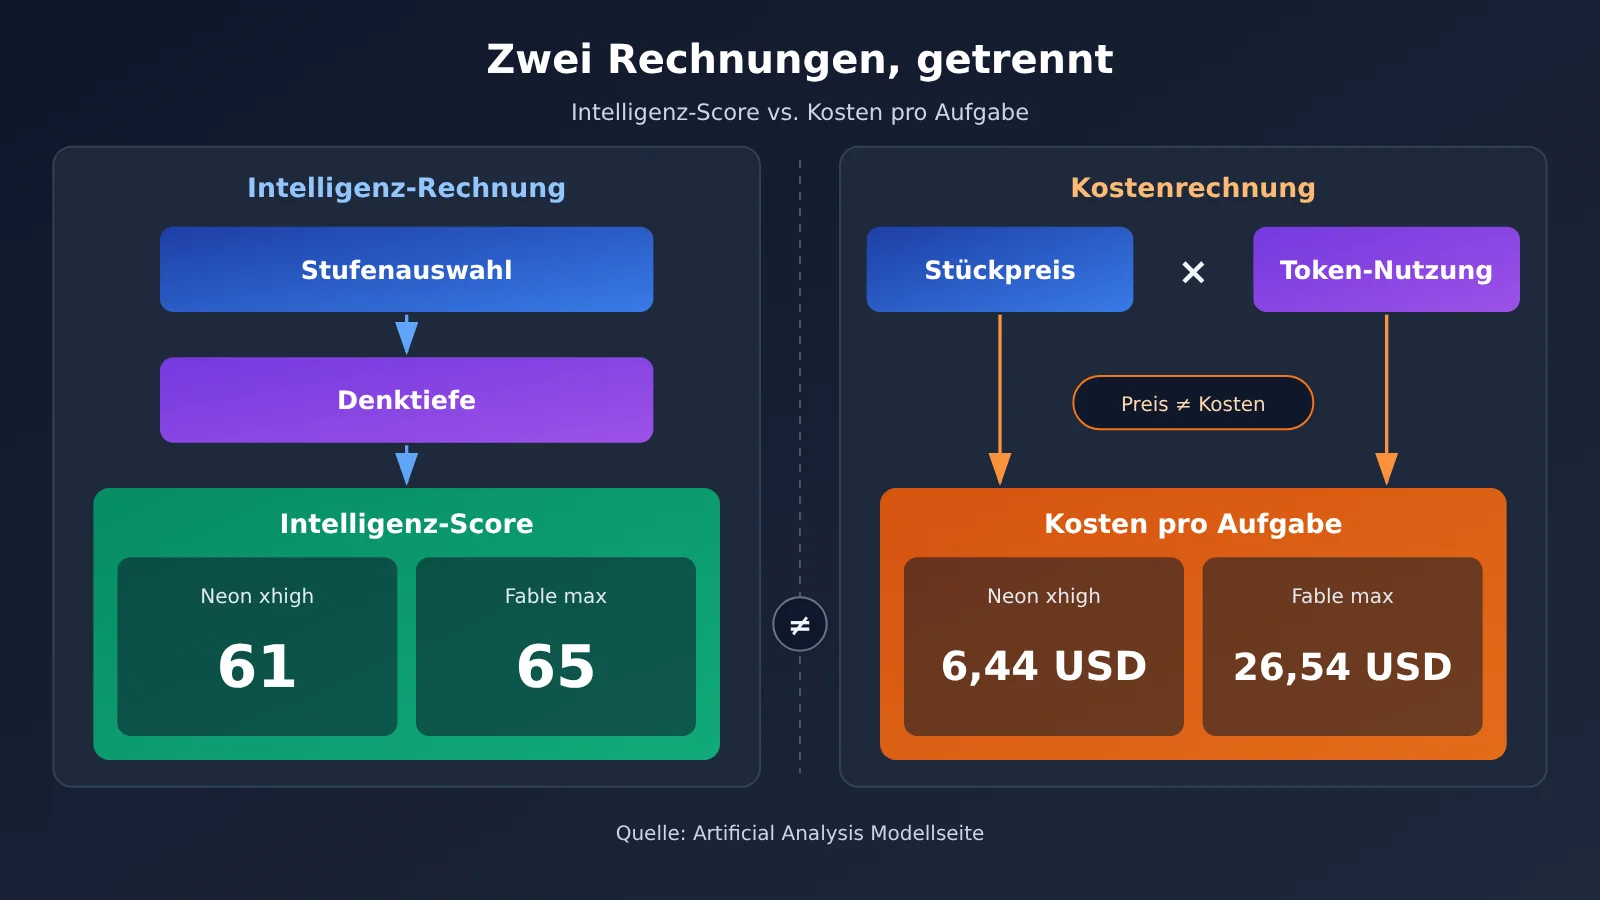
Autorenhinweis: Im Gesamtranking von Artificial Analysis liegt Claude Fable 5.2 vor Gemini 4 Neon. Dieser Artikel trennt den Intelligenzwert und die Kosten pro Aufgabe in zwei getrennte Rechnungen und gleicht sie Punkt für Punkt nach Stufe ab, damit sich leichter beurteilen lässt, wo genau die Unterschiede zwischen beiden liegen.
Gemini 4 Neon wurde am 18. November 2026 veröffentlicht. Nach der Rangfolge im Artikel von Artificial Analysis belegt Neon in der xhigh-Stufe mit 61 Punkten Platz 3 im Gesamtranking. Vor ihm liegen GPT-6.2 Astra (max) und Claude Fable 5.2 (max). Angesichts dieser Rangfolge fragen sich viele Entwickler: Worauf ist der Vorsprung von Fable 5.2 zurückzuführen – auf den Intelligenzwert oder auf die Bereitschaft, mehr Geld auszugeben?
Diese beiden Rechnungen müssen getrennt betrachtet werden. Der Intelligenzwert bezieht sich bei Fable auf die max-Stufe und bei Neon auf die xhigh-Stufe; im Coding-Index wird Fable in der xhigh-Stufe geführt. In der Google-Modellkarte gibt es überhaupt keine Fable-Spalte, daher lassen sich Fables Teilwerte nicht einfach von anderen Modellen übernehmen. Dieser Artikel verwendet ausschließlich Kennzahlen, die sowohl im Artikel von Artificial Analysis als auch auf den beiden Modellseiten von Artificial Analysis übereinstimmend angegeben sind; für jede Zahl ist die Quelle angegeben. Wenn Sie Modelle und Preise prüfen möchten, finden Sie die passenden Angaben direkt in der Modellliste von APIYI apiyi.com.
Der Kernnutzen: Nach dem Lesen dieses Artikels wissen Sie, wie hoch Intelligenzwert, Kosten pro Aufgabe, Dauer, Ausgabegeschwindigkeit und Zeit bis zum ersten Token bei Gemini 4 Neon und Claude Fable 5.2 sind, welche Stufe jeweils gilt und welche Zahlen sich nicht voneinander abziehen oder zusammenfassen lassen. Stand der Datenprüfung: 19. November 2026.
Gemini 4 Neon und Claude Fable 5.2: die Kernpunkte in zwei getrennten Rechnungen – Intelligenzwert und Kosten
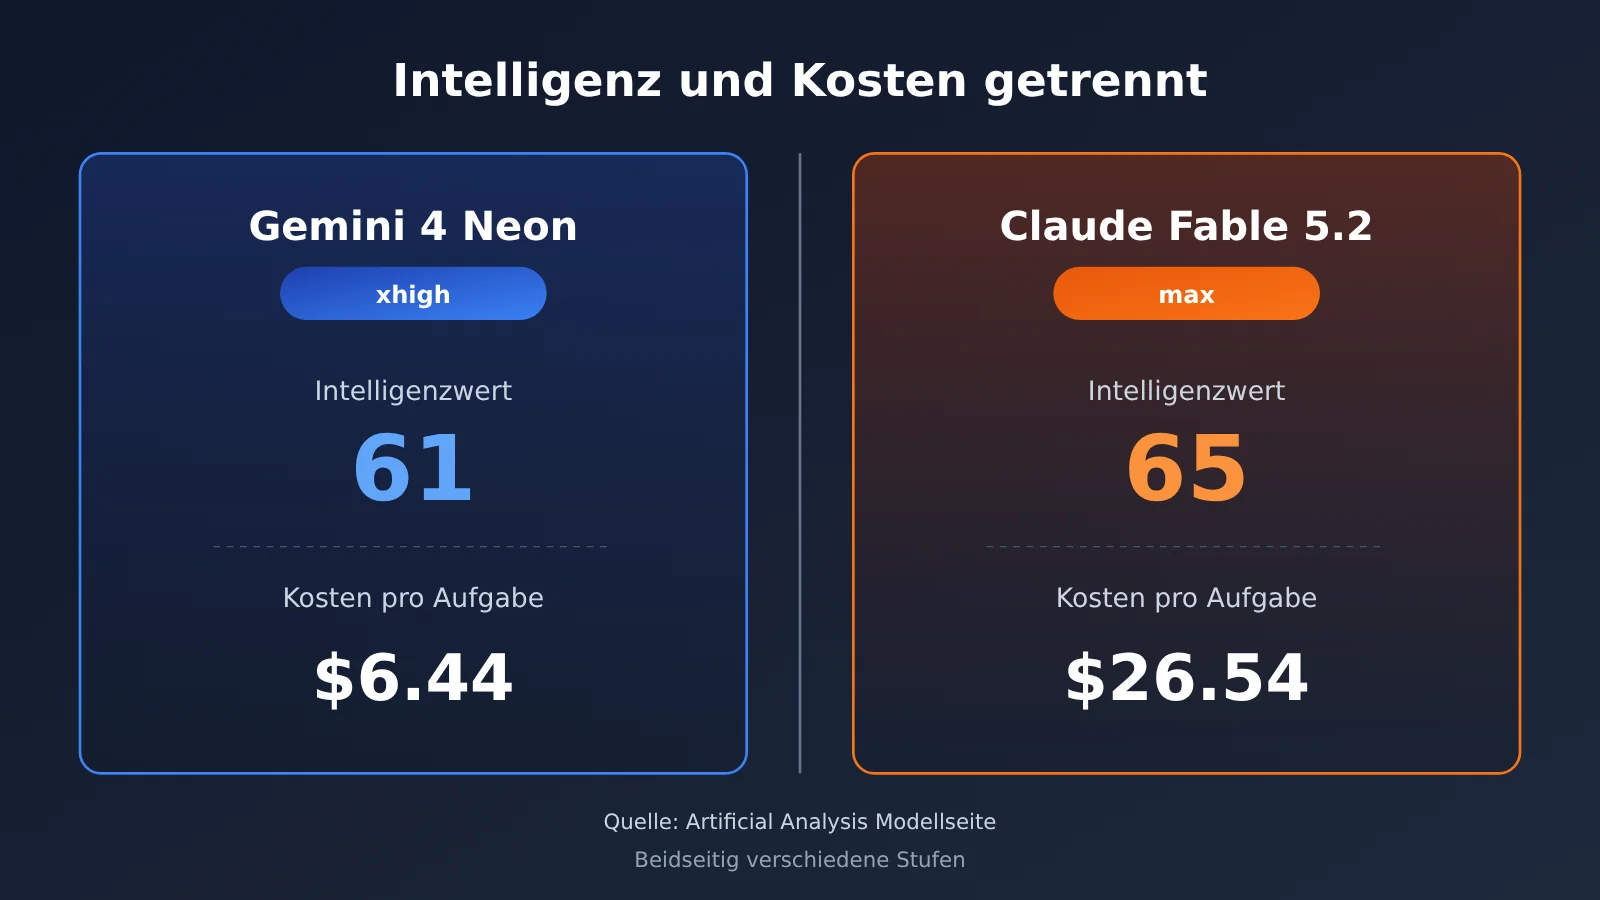
Alle Daten in der folgenden Tabelle stammen von der Modellseite von Artificial Analysis (abgerufen am 19.11.2026, Index v5.0.1). Wichtig: Die verglichenen Stufen sind nicht identisch. Bei Fable wird max verwendet (das ist dort auch der Default Fallback der Seite), bei Neon xhigh.
| Kennzahl | Gemini 4 Neon (xhigh) | Claude Fable 5.2 (max) | Quelle |
|---|---|---|---|
| Intelligenzwert | 61 | 65 | Modellseite von Artificial Analysis |
| Kosten pro Aufgabe | 6,44 US-Dollar | 26,54 US-Dollar | Modellseite von Artificial Analysis |
| Zeit pro Aufgabe | 21,5 Minuten | 41,6 Minuten | Modellseite von Artificial Analysis |
| Ausgabegeschwindigkeit | 110 Token/Sekunde | 110 Token/Sekunde | Modellseite von Artificial Analysis |
| Erstes Antwort-Token | 56,51 Sekunden | 247,46 Sekunden | Modellseite von Artificial Analysis |
| Listenpreis (Eingabe/Ausgabe, pro Million Token) | 3,00 / 15,00 US-Dollar | 8,00 / 40,00 US-Dollar | Modellseite von Artificial Analysis |
Die Intelligenzwert-Rechnung von Gemini 4 Neon und Claude Fable 5.2
In der Spalte Intelligenzwert stehen 61 gegen 65 – verglichen werden dabei Neon xhigh und Fable max. Laut dem Artikel von Artificial Analysis liegt Neon xhigh einen Punkt über Gemini 4 Carbon high und belegt in der Gesamtwertung Platz 3; die ersten beiden Plätze gehen an GPT-6.2 Astra (max) und Claude Fable 5.2 (max). Auch im Google-Blog steht, dass der Artificial Analysis Intelligence Index bei xhigh 61 beträgt – das ist allerdings eine Angabe des Anbieters selbst. Die 61 stimmt an allen drei Stellen überein: Google-Blog, Modellkarte und Artificial Analysis.
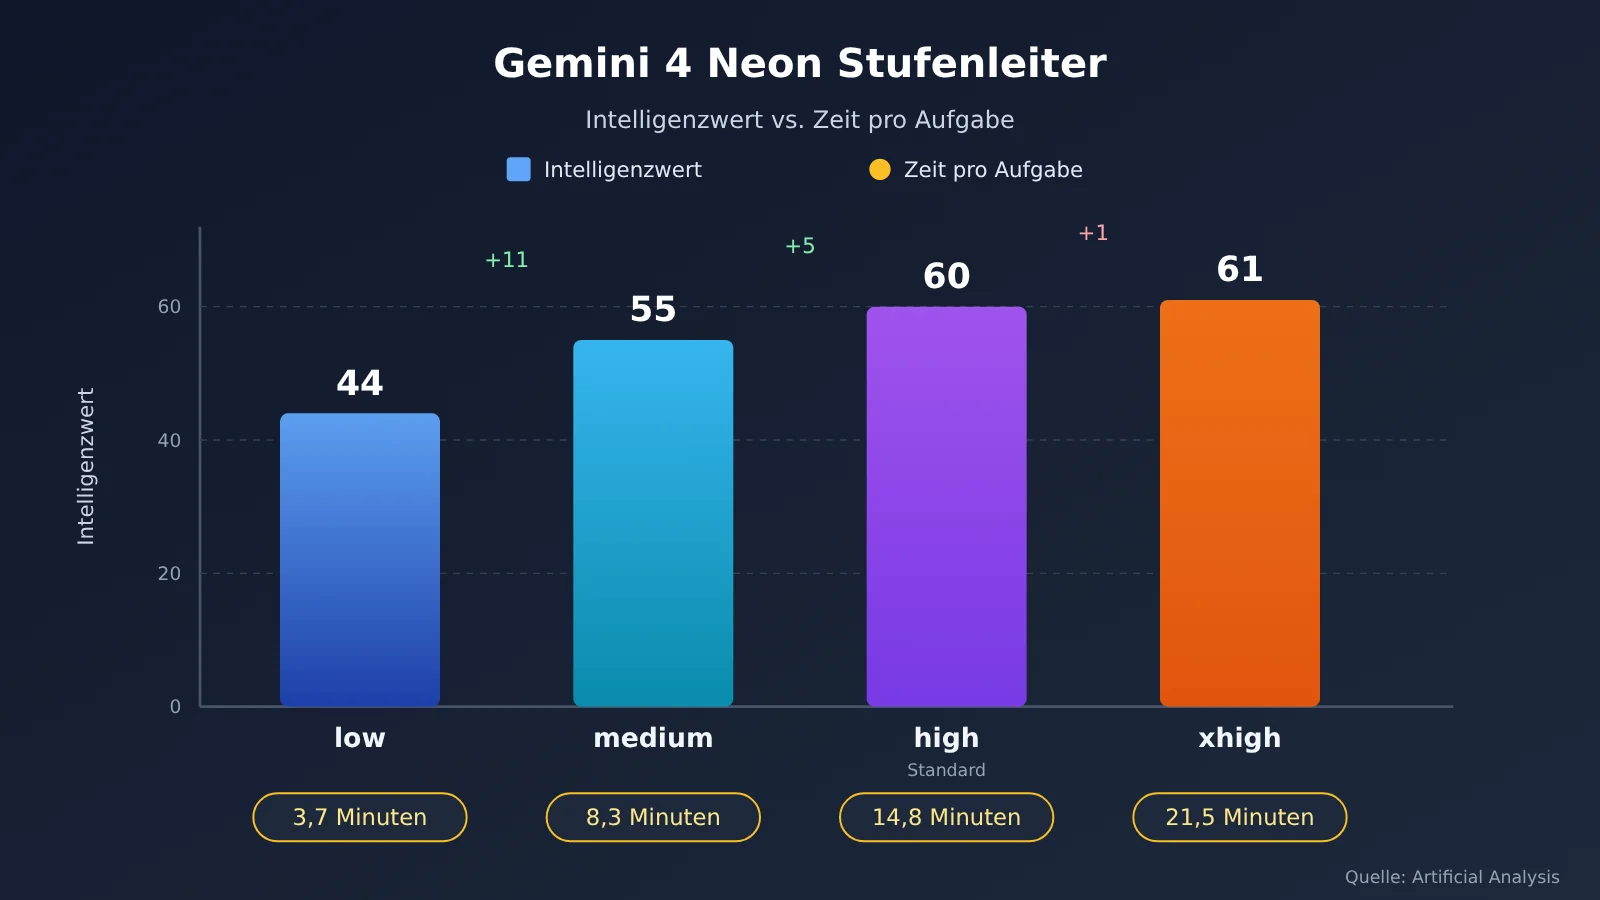
Fable veröffentlicht auf der Modellseite nur Daten für die Stufe max. Ein direkter Vergleich mit anderen Stufen von Neon findet daher nicht unter gleichen Bedingungen statt. Die Standard-Denkstufe von Neon ist high; das geht sowohl aus dem Google-Cloud-Entwicklerhandbuch als auch aus der aktuellen Modellseite in AI Studio hervor. Auf der Modellseite von Artificial Analysis kommt Neon high auf 60 Punkte. Wer beim Aufruf keine zusätzliche Stufe angibt, bekommt faktisch high – nicht xhigh.
Die Kosten-pro-Aufgabe-Rechnung von Gemini 4 Neon und Claude Fable 5.2
Bei den Kosten pro Aufgabe stehen 6,44 US-Dollar gegen 26,54 US-Dollar, bei der Zeit pro Aufgabe 21,5 Minuten gegen 41,6 Minuten. Der Artikel von Artificial Analysis nennt für Neon „etwa 21 Minuten“, die Modellseite 21,5 Minuten – beide Angaben bleiben jeweils für sich stehen. Die Ausgabegeschwindigkeit ist auf beiden Seiten gleich: 110 Token/Sekunde. Beim ersten Antwort-Token klafft dagegen ein großer Unterschied: Neon xhigh 56,51 Sekunden, Fable max 247,46 Sekunden.
Stückpreis und Kosten pro Aufgabe darf man nicht in einen Topf werfen. Auf der Modellseite von Artificial Analysis hat GPT-6.2 Astra denselben Listenpreis von 8,00/40,00 US-Dollar, doch die Kosten pro Aufgabe liegen in der Stufe max bei 4,00 US-Dollar – weil beim Lauf des Index deutlich weniger Token ausgegeben werden. Für die Beurteilung der Kosten pro Aufgabe muss man daher Stückpreis und Token-Verbrauch zusammen betrachten, nicht nur den Listenpreis.
Gemini 4 Neon und Claude Fable 5.2 Coding-Index: Stufen gesondert ausgewiesen
Die Daten für diesen Coding-Abschnitt stammen aus einem Artikel von Artificial Analysis; Stufe und Laufzeitumgebung müssen jeweils separat angegeben werden. Neon wurde auf der Antigravity CLI getestet, Fable und Opus 5.5 auf Claude Code – die Harnesses der beiden Seiten unterscheiden sich.
| Modell und Stufe | Coding Agent Index | Kosten pro Coding-Aufgabe | Laufzeitumgebung | Quelle |
|---|---|---|---|---|
| Gemini 4 Neon xhigh | 59 | 6,86 USD | Antigravity CLI | Artificial Analysis Artikel |
| Claude Fable 5.2 xhigh | 58 | 15,47 USD | Claude Code | Artificial Analysis Artikel |
| Claude Opus 5.5 max | 58 | 12,61 USD | Claude Code | Artificial Analysis Artikel |
| Gemini 4 Carbon high | 55 | im Artikel nicht angegeben | Antigravity CLI | Artificial Analysis Artikel |
Fable verwendet hier die Stufe xhigh, nicht die Stufe max aus der Spalte mit dem Intelligenzwert – diese beiden Zahlen dürfen nicht unter denselben Bedingungen interpretiert werden. Außerdem nennt der Google-Blog für den Neon Coding Agent Index 58,6, während der Artikel von Artificial Analysis 59 angibt. Der erste Wert ist eine offizielle Selbstauskunft, der zweite eine Zahl aus einem Drittanbieter-Artikel. Dieser Text behält beide bei, trifft keine Auswahl und bildet auch keinen Durchschnitt.
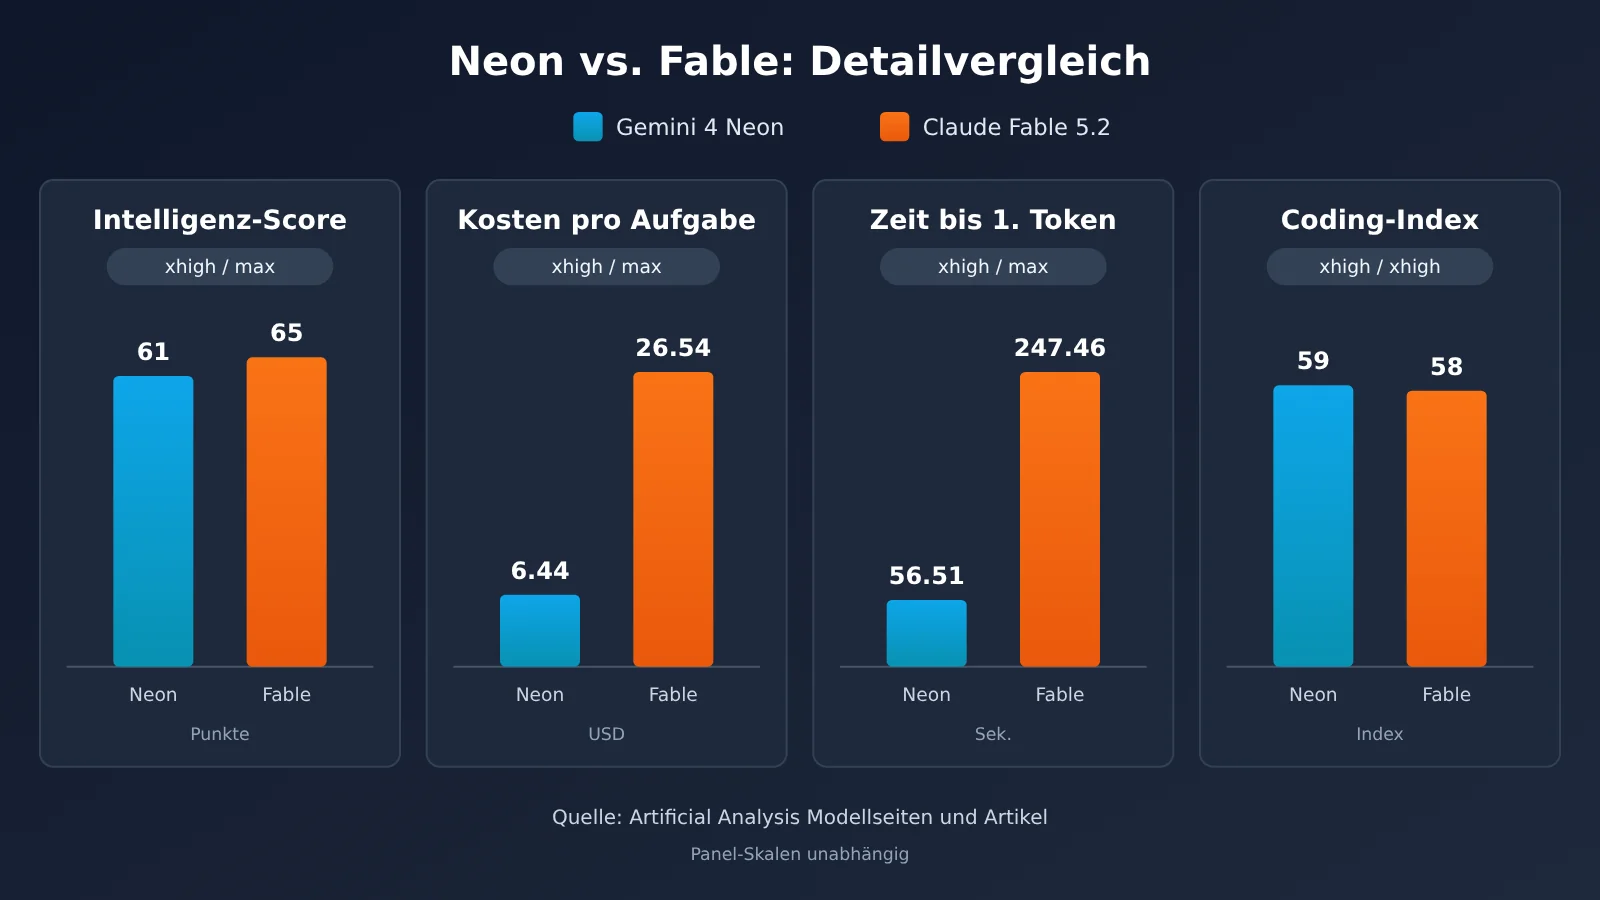
Hinweis zu den Daten: Die Zahlen im obigen Diagramm stammen jeweils von der Artificial-Analysis-Modellseite und aus dem Artificial-Analysis-Artikel; die Stufen sind im Diagramm bereits angegeben. Die Aufrufpreise der beiden Modelle finden sich in der APIYI-Preistabelle weiter unten.
Warum die Modellkarte von Gemini 4 Neon die Einzelwerte von Claude Fable 5.2 nicht ersetzen kann
Die Vergleichstabelle in der Modellkarte von DeepMinds Gemini 4 Neon hat nur drei Spalten: Gemini 4 Neon, Claude Opus 5.5 und GPT-6.2 Sol. Claude Fable 5.2 fehlt in der Tabelle. Das der Modellkarte beigefügte PDF mit den Erläuterungen zu den Evaluierungen stellt klar, dass die Ergebnisse für Nicht-Gemini-Modelle standardmäßig aus den jeweiligen Selbstauskünften der Anbieter stammen. Diese Tabelle ist also eine offizielle Zusammenfassung von Ergebnissen, die nicht von demselben Labor am selben Tag erneut gemessen wurden.
Opus 5.5 und Fable 5.2 sind zwei unterschiedliche Modelle. Auf der Modellseite von Artificial Analysis liegt der Intelligenzwert von Opus 5.5 max bei 59, der von Fable 5.2 max bei 65, und auch die Listenpreise unterscheiden sich (4.00/20.00 gegenüber 8.00/40.00). Die Prozentwerte in der Opus-Spalte der Modellkarte können daher nur Opus 5.5 repräsentieren und dürfen nicht als Einzelwerte für Fable 5.2 herangezogen werden.
Ein paar leicht zu verwechselnde Bezugsgrößen sind im Folgenden zusammengestellt:
| Aussage | Zahl | Quelle und Bezugsgröße |
|---|---|---|
| Neon high: Kosten pro Aufgabe niedriger als bei Carbon | 32% | Offizielle Selbstauskunft (Google-Blog); es wird nicht angegeben, ob für Carbon der Einführungspreis oder der Standardpreis verwendet wurde |
| Neon xhigh: pro Aufgabe weniger als bei Carbon | etwa 17% (6,44 gegenüber 7,76 US-Dollar) | Artikel von Artificial Analysis; Carbon wird zum nicht rabattierten Preis gerechnet |
| Carbon high: Kosten pro Aufgabe | 4,90 US-Dollar | Modellseite von Artificial Analysis, gerechnet zum Einführungspreis |
| Neon Coding Agent Index | 58,6 / 59 | Offizielle Selbstauskunft / Artikel von Artificial Analysis |
| Neon MKA | 56,5% / 56% | Modellkarte / Artikel von Artificial Analysis |
| Neon SWE-sweep | 12,8% / 39,0% | Offizielle Selbstauskunft, jeweils für die mini-SWE-Harness und Google Antigravity |
Die drei Kostenwerte in der obigen Tabelle stammen aus drei unterschiedlichen Berechnungsgrundlagen. Sie lassen sich weder voneinander subtrahieren noch zu einer einzigen Zahl zusammenfassen. Die Differenz beim SWE-sweep von 12,8% auf 39,0% erklärt der Google-Blog mit dem durch die Harness erzielten Gewinn; sie bedeutet nicht, dass das Modell selbst dreimal so gut abschneidet.
Szenario-Empfehlungen für Gemini 4 Neon und Claude Fable 5.2: Entscheiden Sie zuerst, welche Kennzahl zählt
Die Daten beider Modelle stehen in derselben Tabelle, doch verschiedene Lesergruppen achten auf unterschiedliche Kennzahlen. Die folgende Gruppierung richtet sich danach, welche Kennzahl Ihnen am wichtigsten ist. Jede Gruppe nennt nur die Spalte, die Sie betrachten sollten – die Schlussfolgerung überlasse ich Ihnen.
Szenarien mit Fokus auf den Intelligenzwert
- Langhorizont-Reasoning und komplexe Analysen: Achten Sie auf die Spalte mit dem Intelligenzwert und notieren Sie zugleich die Stufe (Fable max 65, Neon xhigh 61). Verwenden Sie bei der Bewertung dieselbe Stufe, um die Ergebnisse zu reproduzieren.
- Wenn Sie eine modellübergreifende Rangliste benötigen: Der Artikel von Artificial Analysis enthält eine Gesamtrangliste. Sie können sie zitieren, sollten aber angeben, auf welcher Stufe die Rangliste basiert.
Szenarien mit Fokus auf Kosten und Latenz pro Aufgabe
- Häufige Aufrufe und Batch-Aufgaben: Achten Sie auf die Kosten pro Aufgabe (6,44 USD gegenüber 26,54 USD) und die Zeit pro Aufgabe (21,5 gegenüber 41,6 Minuten).
- Interaktive Produkte: Achten Sie auf die Zeit bis zum ersten Antwort-Token (56,51 gegenüber 247,46 Sekunden). Die Ausgabegeschwindigkeit ist auf beiden Seiten gleich; für den Latenzunterschied ist die Zeit bis zum ersten Token entscheidend.
- Coding-Agenten: Betrachten Sie die Coding-Tabelle und beachten Sie, dass Neon und Fable zwar beide auf der Stufe xhigh laufen, die Ausführungsumgebungen aber Antigravity CLI bzw. Claude Code sind.
Die Leistung der einzelnen Neon-Stufen sollte man sich ebenfalls separat ansehen. Die folgenden Daten stammen aus der Übersichtstabelle auf der Modellseite von Artificial Analysis. Bei der Zeit bis zum ersten Token stammen die Werte für die letzten drei Stufen aus den FAQ derselben Seite und stehen nicht in derselben Spalte wie die Übersichtstabelle.
| Neon-Stufe | Intelligenzwert | Zeit pro Aufgabe | Ausgabegeschwindigkeit | Erstes Antwort-Token |
|---|---|---|---|---|
| xhigh | 61 | 21,5 Minuten | 110 Token/Sekunde | 56,51 Sekunden |
| high (Standard) | 60 | 14,8 Minuten | 101 Token/Sekunde | 40,64 Sekunden (FAQ) |
| medium | 55 | 8,3 Minuten | 101 Token/Sekunde | 20,14 Sekunden (FAQ) |
| low | 44 | 3,7 Minuten | 97 Token/Sekunde | 13,93 Sekunden (FAQ) |
Außerdem zeigen die Daten zu GDP.pdf im Artikel von Artificial Analysis: Neon high erreicht 33,4 %, Neon xhigh 28,0 %. Das zeigt, dass in diesem Test eine höhere Stufe nicht zwangsläufig zu einem höheren Wert führt.
Preise und Verfügbarkeit von Gemini 4 Neon und Claude Fable 5.2
Was die offizielle Preisgestaltung betrifft: Laut der Preisseite von Google AI Studio gibt es für gemini-4-neon keine kostenlose Stufe. Die bezahlten Preise lauten: 3,00 USD pro Million Token für die Eingabe, 15,00 USD pro Million Token für die Ausgabe (inklusive Denk-Token) und 0,15 USD pro Million Token für das Caching – unterstützt wird ausschließlich implizites Caching. Die auf der Modellseite von Artificial Analysis angegebene Preisangabe für Fable 5.2 beträgt 8,00/40,00 USD, der Cache-Rabatt liegt bei 98 %.
In der Übersichtstabelle von APIYI apiyi.com (laut Seitenangabe aktualisiert am 2026-11-16 09:39, UTC+8) und in der Preis-API (abgefragt am 2026-11-19, Version shell-api-modelmak-v1, insgesamt 285 Modelle) sehen die Informationen zu den relevanten Modellen wie folgt aus. Gemäß der Konvention der Preis-API entspricht ein model_ratio von 1 einem Eingabepreis von 2 USD pro Million Token, und ein completion_ratio von 5 bedeutet, dass der Ausgabepreis das Fünffache des Eingabepreises beträgt.
| Modell-ID | Eingabe | Cache-Lesen | Ausgabe (USD/Million Token) | Endpunkt | Verfügbare Plattform |
|---|---|---|---|---|---|
claude-fable-5-2 |
8 | 0,2 | 40 | chat, messages | APIYI (verfügbar) |
claude-fable-5-2-thinking |
8 | 0,2 | 40 | chat, messages | APIYI (verfügbar) |
gemini-4-carbon |
2 | 0,1 | 10 | chat, gemini | APIYI (verfügbar) |
gemini-4-hydrogen |
1,5 | 0,075 | 7,5 | chat, gemini | APIYI (verfügbar) |
gemini-4-neon |
— | — | — | — | Google AI Studio (offiziell) |
gemini-4-neon ist weder in der APIYI-Übersichtstabelle noch in der Preis-API erfasst und derzeit noch nicht verfügbar; wir werden dieses Modell so schnell wie möglich aufnehmen. Maßgeblich für Modellbezeichnung und Preis ist die Modellliste der Plattform. Die 2/10 USD für gemini-4-carbon in der Tabelle sind der aktuelle Listenpreis von APIYI; er stimmt mit dem Einführungspreis von Google bis zum 2026-11-30 überein und unterscheidet sich vom späteren Standardpreis von Google in Höhe von 4/20 USD.
Die Gruppierung von claude-fable-5-2 wird an zwei Stellen unterschiedlich geschrieben, daher sind hier beide Varianten aufgeführt: Die APIYI-Übersichtstabelle nennt ClaudeCode, Claude_Reverse, Claude_Enterprise, Default, SVIP; die Gruppen-IDs in der Preis-API lauten ClaudeCode, ClaudeCodeReverse, ClaudeOfficial, default, svip. Bei der Konfiguration der Gruppen gilt das, was die Schnittstelle zurückgibt, die du tatsächlich aufrufst.
So rufen Sie Claude Fable 5.2 über APIYI auf: Schnellstart
APIYI bietet eine OpenAI-kompatible Schnittstelle. Für den Aufruf von claude-fable-5-2 müssen Sie lediglich die base_url und den Modellnamen anpassen. Gehen Sie dabei wie folgt vor:
- Beziehen Sie bei APIYI einen API-Schlüssel und schreiben Sie ihn in eine Umgebungsvariable, z. B.
APIYI_API_KEY. Im Code sollte kein Key im Klartext auftauchen. - Setzen Sie im OpenAI SDK die base_url auf
https://api.apiyi.com/v1. Die Client-Initialisierung kann so aussehen:OpenAI(base_url="https://api.apiyi.com/v1", api_key=os.environ["APIYI_API_KEY"]). - Senden Sie die Anfrage:
client.chat.completions.create(model="claude-fable-5-2", messages=[{"role": "user", "content": "..."}]). Wenn Sie die Thinking-Version benötigen, ersetzen Sie den Modellnamen durchclaude-fable-5-2-thinking. Beide kosten gleich viel: Input 8, Cache-Lesen 0.2 und Output 40 USD pro Million Token. - Nutzt Ihr Projekt das Anfrageformat im Anthropic-Stil, können Sie den messages-Endpunkt verwenden – Modellbezeichnung und Preis bleiben unverändert.
- Die Gemini-Serie lässt sich nativ aufrufen: Die Adresse ist
https://api.apiyi.com, die API-Versionv1beta, und verfügbar sind unter anderemgemini-4-carbonundgemini-4-hydrogen.
Nach der Integration empfehlen wir, in den Anfrage-Logs für jeden Aufruf die Input-Token, Output-Token und die Gesamtdauer zu protokollieren. So können Sie anhand Ihrer eigenen Aufgaben die Kosten pro Aufgabe berechnen und mit den 26.54 USD von Artificial Analysis vergleichen. Beachten Sie dabei, dass die beiden Aufgabenstellungen nicht identisch zusammengesetzt sind.
🚀 Schnellstart: Neue Nutzer erhalten nach der Registrierung bei APIYI auf apiyi.com ein kostenloses Testguthaben. Damit können Sie zunächst mit
claude-fable-5-2ein paar echte Geschäftsproben durchlaufen lassen, den Token-Verbrauch und die Dauer notieren und anschließend Tarif und Budget festlegen.
Entscheidungsempfehlung: Gemini 4 Neon und Claude Fable 5.2 anhand des Mess-Ledgers wählen
💡 Empfehlung: Klären Sie zuerst, worauf Ihr Geschäft am meisten Wert legt – Intelligenz-Score, Kosten pro Aufgabe oder Time-to-First-Token – und suchen Sie dann in der Tabelle die passende Spalte und prüfen Sie die Stufe.
- Stufe prüfen: Der Intelligenz-Score entspricht Fable max und Neon xhigh, der Coding-Index entspricht auf beiden Seiten xhigh. Wenn Sie mit einer anderen Stufe live gehen, müssen Sie die Daten für die jeweilige Stufe neu nachschlagen.
- Messbasis prüfen: Die Angaben aus offizieller Selbstauskunft, Model Cards, Artikeln von Artificial Analysis und den Modellseiten von Artificial Analysis stammen jeweils aus ihrer eigenen Quelle – bitte nicht gegenseitig umrechnen.
- Aufrufparameter prüfen: Laut dem Google-Cloud-Entwicklerleitfaden hat Neon nur vier Denk-Stufen: low, medium, high und xhigh. Wer
thinking_budgetoderMINIMALübergibt, erhältHTTP 400zurück. Neon unterstützt kein explizites Context-Caching; implizites Caching greift automatisch für gemeinsame Präfixe ab 4096 Token. - Mit eigenen Aufgaben nachtesten: Öffentliche Daten dienen nur dazu, die Auswahl einzugrenzen. Die endgültigen Kosten und Latenzen müssen Sie an Ihren eigenen Samples messen.
Häufige Fragen (FAQ)
F1: Was ist Gemini 4 Neon?
Gemini 4 Neon ist ein Modell, das Google am 18.11.2026 veröffentlicht hat. Laut Modellkarte wurde es von Gemini 4 Carbon abgeleitet, sein Wissensstand endet im März 2026, und es unterstützt Text-, Bild-, Audio- und Videoeingaben bei einem einheitlichen Kontextfenster von bis zu einer Million Token. In Googles Produktlinie liegt Neon zwischen Hydrogen (schnelle Ausführung im Alltag) und Carbon (komplexe, langfristige Aufgaben).
F2: Können die Opus-5.5-Daten aus der Gemini-4-Neon-Modellkarte für Claude Fable 5.2 stehen?
Nein. Die Modellkarte enthält nur drei Spalten: Neon, Opus 5.5 und GPT-6.2 Sol – Fable 5.2 fehlt, und die Ergebnisse von Nicht-Gemini-Modellen stammen standardmäßig aus den Selbstauskünften der jeweiligen Anbieter. Die Daten, die für Fable 5.2 herangezogen werden können, sind der Intelligenzwert, die Kosten, die Laufzeit, die Geschwindigkeit und der Coding-Index, die auf der Artificial-Analysis-Modellseite und in den Artikeln angegeben sind.
F3: Ab wann ist Gemini 4 Neon verfügbar und in welchen Kanälen startet es?
Laut dem Beitrag von Sundar Pichai (offizielle Selbstauskunft) wird Neon ab dem 18.11.2026 in folgenden Kanälen ausgerollt: Gemini API in Google AI Studio, Gemini for business, Google Antigravity in den kostenpflichtigen Tarifen Google AI Pro und Ultra sowie die Gemini App in Pro und Ultra. Die Modell-ID im Google-Cloud-Entwicklerhandbuch lautet `gemini-4-neon`.
F4: Beide Seiten geben 110 Token/Sekunde aus – warum unterscheiden sich die Zeiten pro Aufgabe?
Die Artificial-Analysis-Modellseite zeigt aggregierte Ergebnisse: Die Zeiten betragen 21,5 Minuten bzw. 41,6 Minuten, die Time-to-First-Token 56,51 Sekunden bzw. 247,46 Sekunden. Die Seite schlüsselt nicht auf, worauf die Zeitdifferenz genau zurückzuführen ist. Sicher ist: Gleiche Ausgabegeschwindigkeit bedeutet nicht gleiche Gesamtlaufzeit, und die Wartezeit bis zum ersten Token ist ebenfalls Teil der Gesamtlaufzeit.
F5: Wie rufe ich Claude Fable 5.2 schnell über die API auf?
Nachdem Sie den Schlüssel bei APIYI apiyi.com erhalten haben, verwenden Sie als base_url die zuvor genannte OpenAI-kompatible Adresse und tragen als Modellnamen `claude-fable-5-2` oder `claude-fable-5-2-thinking` ein; sowohl der chat- als auch der messages-Endpunkt funktionieren. Die Preise betragen 8 USD für Eingabe, 0,2 USD für Cache-Lesen und 40 USD für Ausgabe pro Million Token; die Gruppennamen richten sich nach der Schreibweise in der Übersichtstabelle und in der Preisschnittstelle.
F6: Bedeutet ein niedriger Stückpreis auch niedrigere Kosten pro Aufgabe?
Das lässt sich nicht direkt gleichsetzen. Auf der Artificial-Analysis-Modellseite ist GPT-6.2 Astra mit 8,00/40,00 USD ausgewiesen, doch die Kosten pro Aufgabe in der max-Stufe betragen nur 4,00 USD, weil es beim Durchlaufen des Index deutlich weniger Token ausgibt. Die Kosten pro Aufgabe ergeben sich aus dem Stückpreis und der Token-Nutzung zusammen.
F7: Welche bekannten Einschränkungen hat Gemini 4 Neon?
– **Preis**: In AI Studio gibt es keine kostenlose Stufe, nur implizites Caching wird unterstützt.
– **Parameter**: Wird `thinking_budget` oder `MINIMAL` übergeben, gibt die API `HTTP 400` zurück; auch explizites Kontext-Caching wird nicht unterstützt.
– **Ausgabelänge**: Eine einzelne Ausgabe umfasst standardmäßig maximal 65536 Token; bei langer Dekodierung sind es maximal 1048576 minus Eingabelänge.
– **Cybersicherheitsversion**: Die Cybersicherheitsversion wird einige Tage später nur vertrauenswürdigen Verteidigern im Fairwind Program zugänglich gemacht; eine öffentliche Modell-ID gibt es nicht (offizielle Selbstauskunft).
## Gemini 4 Neon und Claude Fable 5.2: die wichtigsten Erkenntnisse
– **Intelligenzwert nur mit Stufenangabe**: Die Modellseite von Artificial Analysis zeigt für Neon xhigh 61 und für Fable max 65.
– **Kosten pro Aufgabe separat betrachtet**: Neon xhigh kostet 6,44 US-Dollar, Fable max 26,54 US-Dollar; die Laufzeiten betragen 21,5 bzw. 41,6 Minuten.
– **Latenz über die Zeit bis zum ersten Token**: Die Ausgabegeschwindigkeit liegt bei beiden bei 110 Token/s; die Zeit bis zum ersten Token beträgt 56,51 bzw. 247,46 Sekunden.
– **Coding-Index mit eigener Stufe**: Neon xhigh erreicht 59, Fable xhigh 58; die Coding-Kosten pro Aufgabe liegen bei 6,86 bzw. 15,47 US-Dollar.
– **Modellkarte ohne Fable**: Die Teilwerte für Opus 5.5 in der Modellkarte dürfen nicht als Daten für Fable 5.2 herangezogen werden.
– **Bezugsgrößen getrennt halten**: 32 %, rund 17 %, 4,90 US-Dollar, 58,6 und 59 gehören zu unterschiedlichen Bezugsrahmen.
– **Aufrufzugang**: `claude-fable-5-2` ist bei APIYI verfügbar, `gemini-4-neon` derzeit noch nicht.
—
## Zusammenfassung
Beim Vergleich von Gemini 4 Neon und Claude Fable 5.2 gibt es drei Punkte zu beachten:
1. **Intelligenz-Bilanz**: Auf der Modellseite von Artificial Analysis steht 61 gegen 65, die Stufen sind jeweils Neon xhigh und Fable max.
2. **Kosten- und Latenz-Bilanz**: Kosten pro Aufgabe 6.44 gegen 26.54 US-Dollar, Zeit pro Aufgabe 21.5 gegen 41.6 Minuten, Zeit bis zum ersten Token 56.51 gegen 247.46 Sekunden – die Ausgabegeschwindigkeit liegt bei beiden bei 110 Token/Sekunde.
3. **Coding-Bilanz**: Beide laufen auf der Stufe xhigh, der Index liegt bei 59 gegen 58, die Kosten pro Aufgabe bei 6.86 gegen 15.47 US-Dollar, die Laufzeitumgebungen sind Antigravity CLI bzw. Claude Code.
Welches Modell am Ende passt, hängt davon ab, welche Bilanz für dein Geschäft wichtiger ist. Am besten grenzt du die Auswahl zuerst mit öffentlichen Daten ein und prüfst Kosten und Latenz anschließend mit eigenen Samples nach. Bei APIYI apiyi.com kannst du `claude-fable-5-2` zunächst mit dem kostenlosen Kontingent ausprobieren; sobald `gemini-4-neon` verfügbar ist, lässt sich der Modellname in derselben Schnittstelle direkt umschalten, um die beiden zu vergleichen.
—
## 📚 Quellen
1. **Sundar Pichais Ankündigungspost**: Veröffentlichung und Auslieferungskanäle von Gemini 4 Neon (Angaben des Herstellers)
– Link: `x.com/sundarpichai/status/2123167780988125621`
2. **Google-Blog „Introducing Gemini 4 Neon“**: vom Hersteller selbst genannte Benchmarks, Preise und Positionierung
– Link: `blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon`
3. **DeepMind-Modellkarte**: dreispaltige Vergleichstabelle und Modellspezifikationen
– Link: `deepmind.google/models/model-cards/gemini-4-neon/`
4. **Google-Cloud-Entwicklerleitfaden**: Modell-IDs, Denk-Stufen und Caching-Regeln
– Link: `docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon`
5. **Google-AI-Studio-Preisseite**: Kostenpflichtige Preise für gemini-4-neon
– Link: `aistudio.google.com/docs/pricing`
6. **Artificial-Analysis-Artikel**: Intelligenzwert, Kosten und Coding-Index von Neon
– Link: `artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain`
7. **Artificial-Analysis-Modellseiten**: Stufendaten von Neon und Fable 5.2
– Link: `artificialanalysis.ai/models/gemini-4-neon`
– Link: `artificialanalysis.ai/models/claude-fable-5-2`
8. **APIYI-Übersicht und Preisschnittstelle**: verfügbare Modelle, Gruppen und Preise
– Link: `docs.apiyi.com/models.md`
– Link: `api.apiyi.com/api/pricing`
—
> **Autor**: APIYI-Technikteam
> **Technischer Austausch**: Kontaktier uns gern über die Startseite von APIYI; weitere Materialien findest du im Dokumentationszentrum docs.apiyi.com