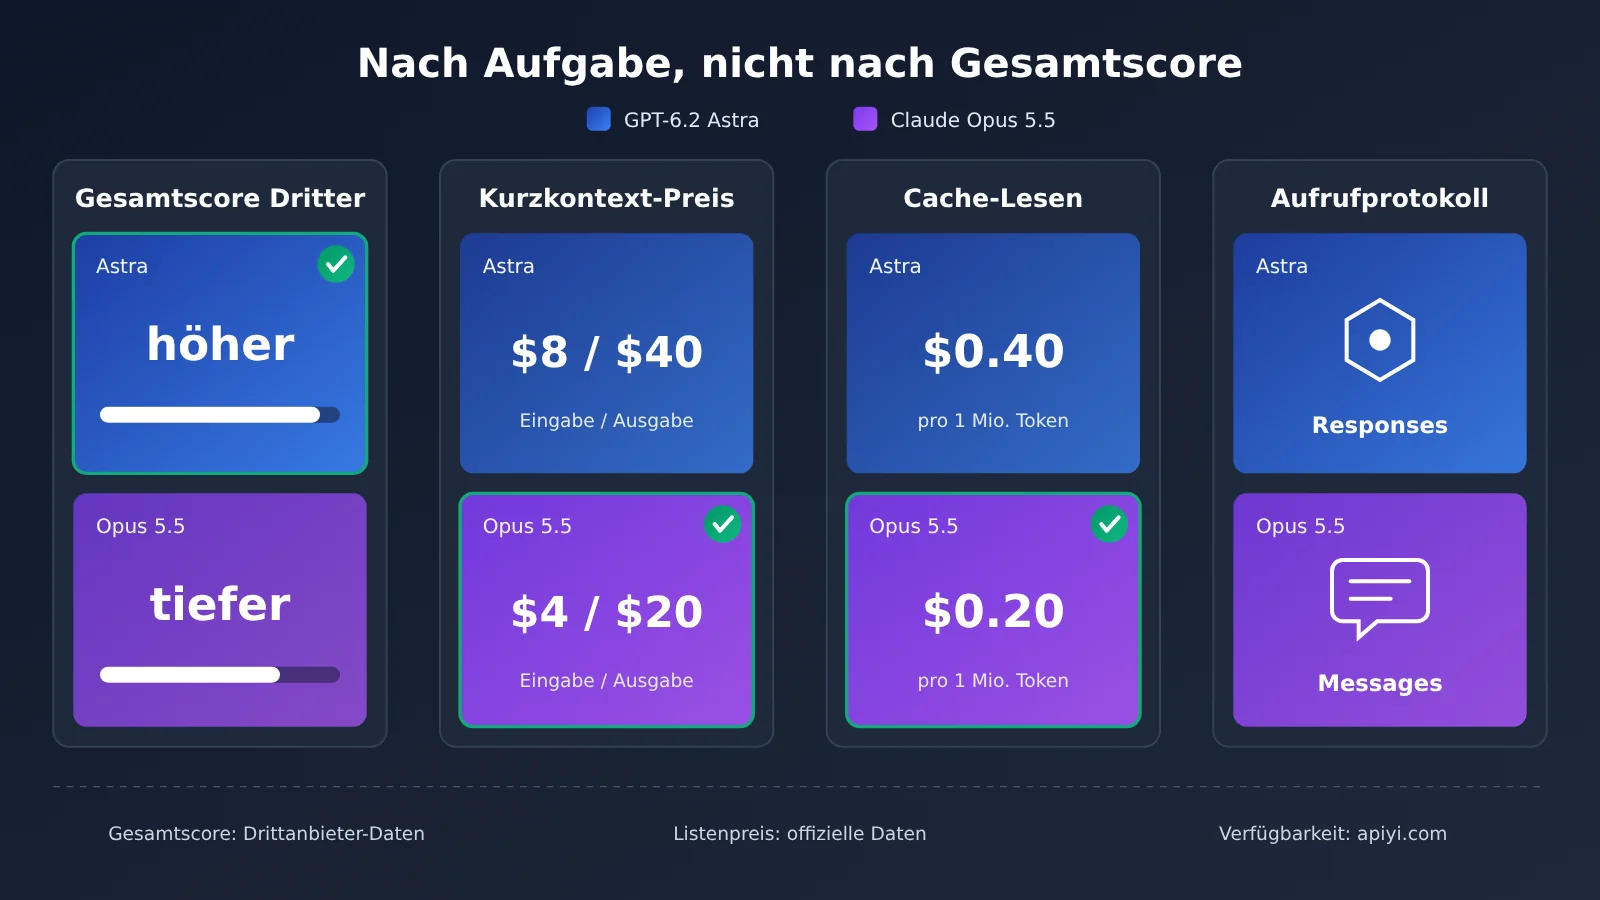
Anmerkung des Autors: Anhand von vier Spalten – Gesamtscore, Token-Preise für kurze Kontexte, Cache-Reads und Aufrufprotokoll – wird die Modellauswahl zwischen GPT-6.2 Astra und Claude Opus 5.5 nach Aufgaben aufgeschlüsselt, mit klarer Trennung zwischen offiziellen Eigenangaben und Drittanbieterdaten.
Am 17. November 2026 hat OpenAI GPT-6.2 Astra und GPT-6.2 Sol veröffentlicht. Einen Tag später legte die unabhängige Bewertungsagentur Artificial Analysis ein neues Gesamtindex-Ranking vor. Viele Teams haben Claude Opus 5.5 bereits in ihre Systeme integriert – und stehen nun vor der Frage: Wechseln oder nicht? Und wenn ja, für welche Aufgaben – und für welche nicht?
Dies ist kein „Wer ist stärker?“-Ranking-Artikel. Der Gesamtscore ist nur eine Zahl – sie verrät dir nicht, welches Modell für juristische Dokumente, wissenschaftliche Terminal-Aufgaben, den täglichen Kundenservice oder die Suche in langen Kontexten jeweils die richtige Wahl ist. Dieser Artikel gliedert die überprüfbaren Fakten in drei Ebenen: die offiziellen Fähigkeitsangaben von OpenAI, den Drittanbieter-Gesamtscore von Artificial Analysis sowie die offiziellen Preise und Aufrufprotokolle beider Anbieter. Die Zahlen dieser drei Ebenen liest du getrennt – sie werden nicht zu einem einzigen Fazit zusammengefasst.
Was du mitnimmst: Nach der Lektüre dieses Artikels hast du eine Vergleichstabelle mit vier Spalten in der Hand (Gesamtscore, Token-Preise für kurze Kontexte, Cache-Reads, Aufrufprotokoll) und kannst anhand deines Aufgabentyps entscheiden, ob du auf Astras offizielle Fähigkeiten und Preise schauen oder direkt beim Opus bleibst, das du bereits aufrufen kannst.
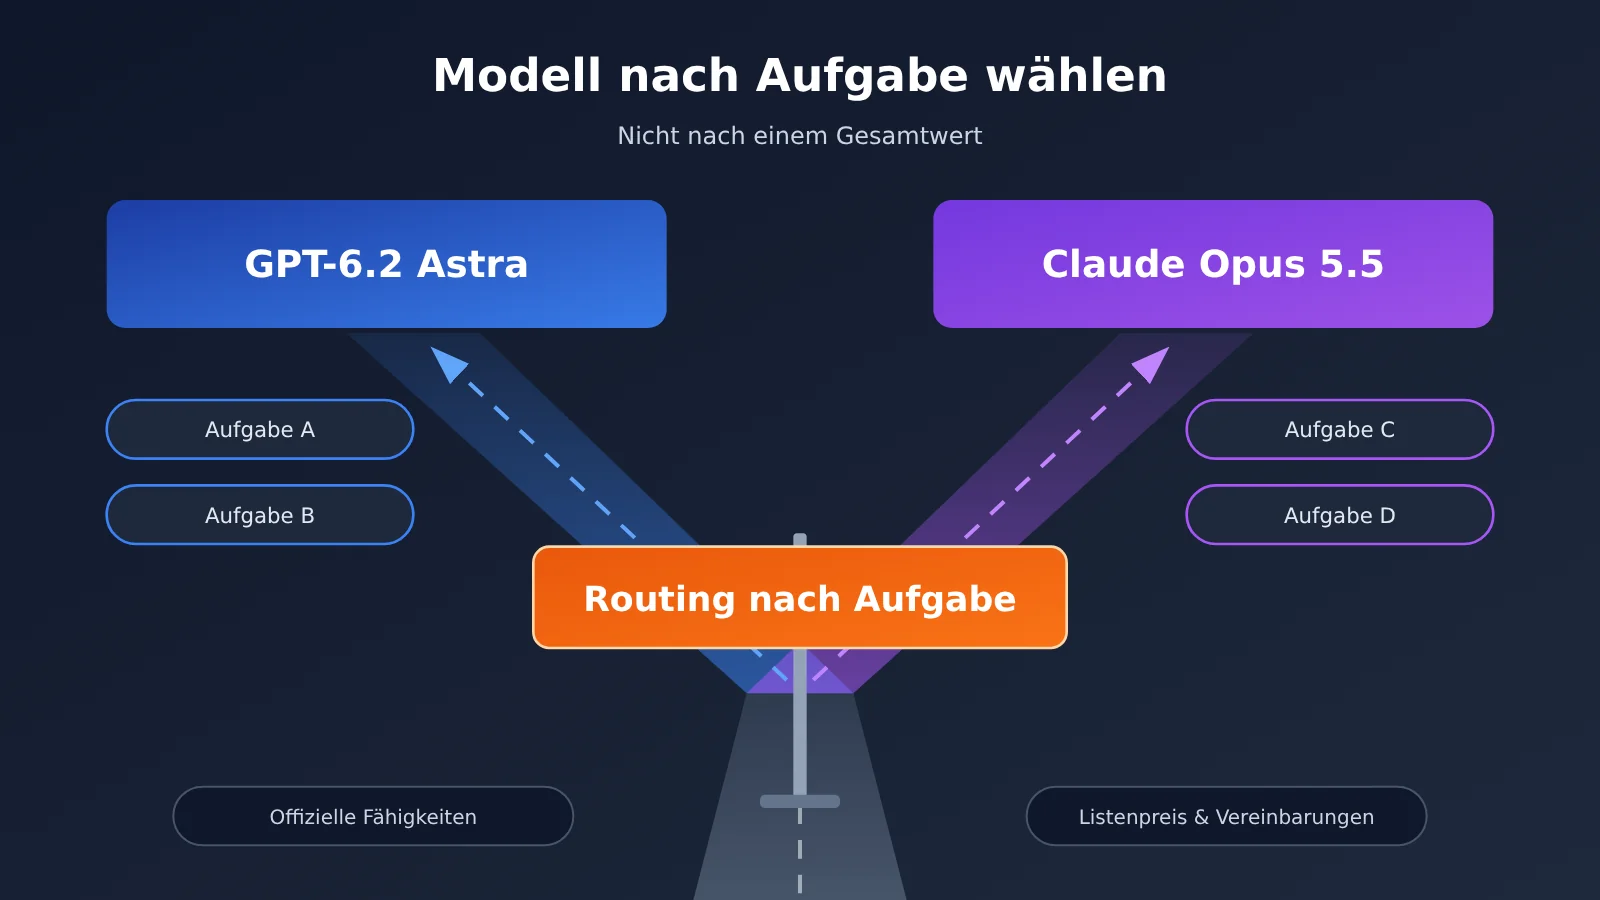
Kernunterschiede zwischen GPT-6.2 Astra und Claude Opus 5.5
Zuerst ein Blick auf die vier Spalten. Die Daten in der folgenden Tabelle stammen aus unterschiedlichen Quellen: Der Gesamtscore kommt von einem Drittanbieter, die Listenpreise von den offiziellen Seiten der jeweiligen Hersteller, und die Protokolle entstammen den offiziellen Modellseiten sowie der Gesamtübersicht der APIYI-Plattform. Achten Sie beim Lesen der Tabelle darauf, woher die Werte der jeweiligen Spalte stammen.
| Vergleichsdimension | GPT-6.2 Astra | Claude Opus 5.5 | Art der Daten |
|---|---|---|---|
| Gesamtscore | 62 (Max-Stufe, Xhigh ebenfalls 62) | 59 (höchste Reasoning-Stufe) | Drittanbieter: Artificial Analysis Intelligence Index v5.0.1 |
| Listenpreis im kurzen Kontextfenster (Eingabe / Ausgabe, pro Million Token) | 8 US-Dollar / 40 US-Dollar | 4 US-Dollar / 20 US-Dollar | Offizieller Listenpreis |
| Cache-Lesen (pro Million Token) | 0,40 US-Dollar | 0,20 US-Dollar | Offizieller Listenpreis |
| Aufrufprotokoll | Responses, Chat Completions (Reasoning-Intensität kann nicht auf none gesetzt werden) | Chat, Messages (Claude-Protokoll) | Offizielle Modellseiten; beim Opus-Protokoll gilt die APIYI-Gesamtübersicht als maßgeblich |
Wie sich der Gesamtscore von GPT-6.2 Astra und Claude Opus 5.5 richtig lesen lässt
62 gegen 59 sieht nach einem klaren Abstand aus, doch dieses Bild ruht auf zwei Voraussetzungen. Erstens handelt es sich um einen Gesamtindex eines Drittanbieters – das gewichtete Ergebnis einer festen Aufgabensammlung, das nicht darauf schließen lässt, dass Ihre eigenen Geschäftsaufgaben dieselben Unterschiede zeigen. Zweitens ist der Score an die Reasoning-Stufe gekoppelt: Astra erreicht auf der Max- und der Xhigh-Stufe 62, auf High 60, auf Medium 57 und auf Low 46. Wenn Sie Astra im Hinblick auf Latenz und Kosten auf Medium einstellen, liegt der Drittanbieter-Score bei 57 – während die 59 von Opus das Ergebnis seiner höchsten Stufe ist. Beide Werte wurden auf unterschiedlichen Stufen gemessen und lassen sich daher nicht direkt miteinander vergleichen.
Artificial Analysis gibt außerdem an, dass Astra auf der Max-Stufe Kosten von 4,00 US-Dollar pro Aufgabe verursacht, wenn der Gesamtindex vollständig durchlaufen wird. Da die Referenzquellen keine Kosten pro Aufgabe für Opus 5.5 unter demselben Index nennen, rechnet dieser Artikel die „Kosten pro Punkt“ der beiden Modelle nicht gegeneinander um. Derselbe Anbieter berichtet zudem, dass Astra auf der Max-Stufe eine AA-Omniscience-Halluzinationsrate von 59 % aufweist und beim Coding Agent Index auf dem Niveau des Vorgängermodells GPT-6 Astra liegt. All diese Zahlen stammen von Drittanbietern und eignen sich gut als Hinweis darauf, in welchen Dimensionen keine deutlichen Fortschritte erkennbar sind.
Preisstruktur-Unterschiede zwischen GPT-6.2 Astra und Claude Opus 5.5
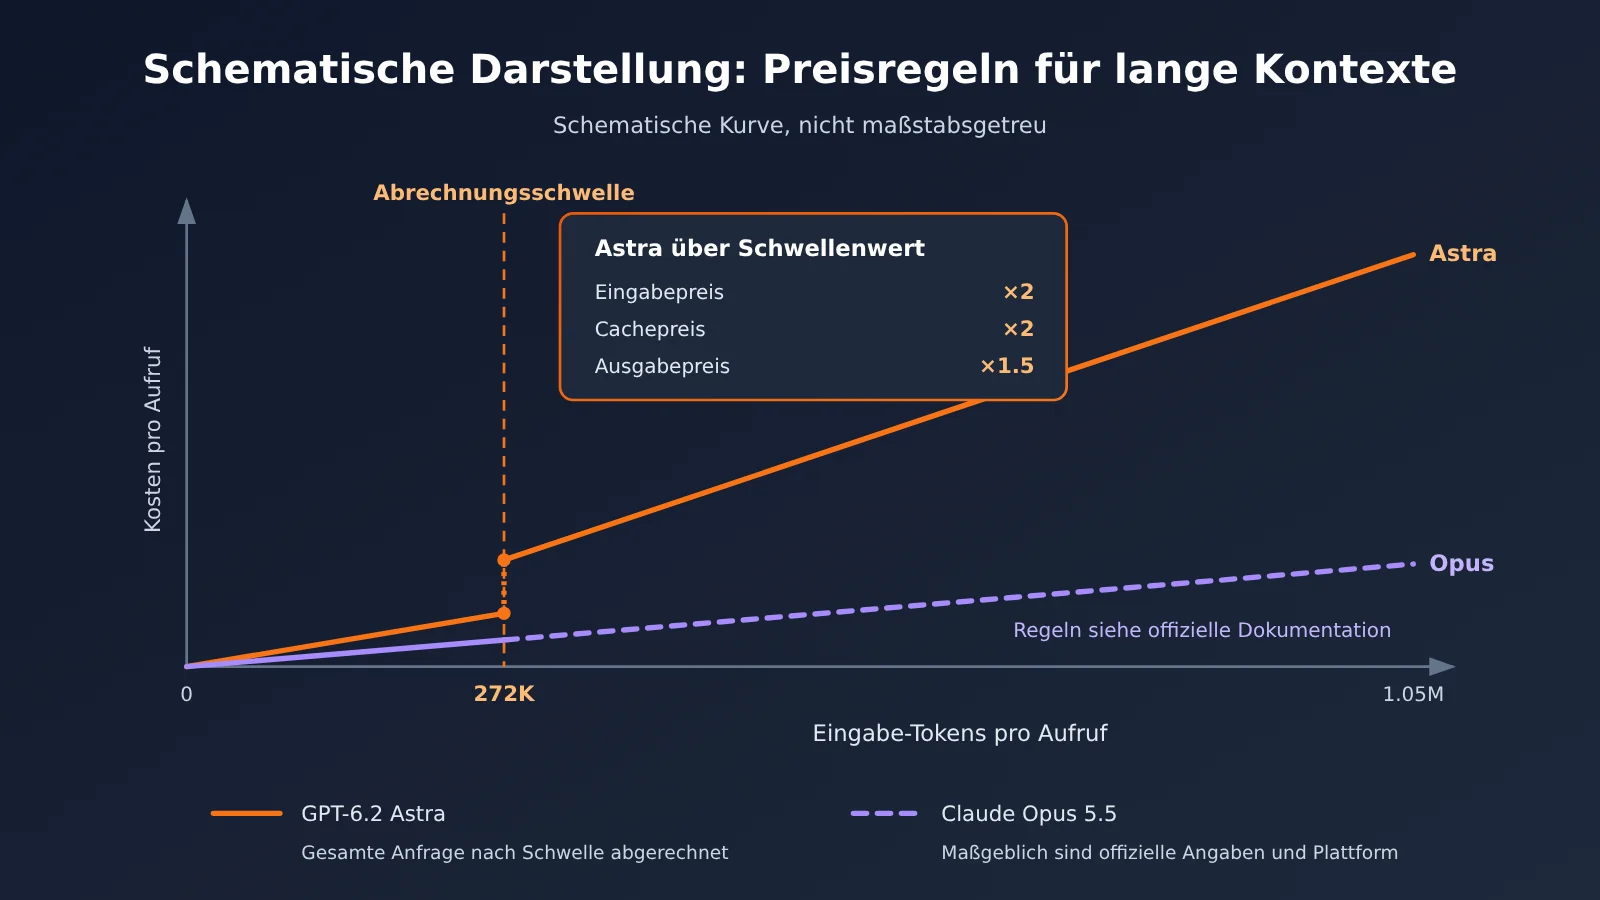
Betrachtet man nur die Listenpreise für kurze Kontexte, liegen Eingabe, Ausgabe und Cache-Lesezugriffe bei Opus 5.5 exakt bei der Hälfte von Astra. Auf der Modellseite von Astra steht jedoch eine zusätzliche Regel: Überschreitet die Eingabe einer einzelnen Anfrage 272K Token, verdoppeln sich die Einheitspreise für Eingabe und Cache, und die Ausgabe wird mit dem 1,5-Fachen des Kurzkontext-Preises berechnet – und zwar gilt dieser Preis für die gesamte Anfrage, nicht nur für den Anteil, der das Limit übersteigt. Das bedeutet: Bei einer Anfrage mit 300.000 Token Eingabe steigt der Einheitspreis für die Eingabe bei Astra auf 16 US-Dollar, der für die Ausgabe auf 60 US-Dollar. Die in den Referenzen angegebenen Listenpreise für Opus 5.5 decken nur den Kurzkontext ab; ob es für lange Kontexte eine ähnliche Staffelung gibt, entscheidet sich in der offiziellen Dokumentation und den Listen der jeweiligen Plattform.
Bei der Verfügbarkeit auf Plattformen unterscheiden sich die beiden Modelle derzeit: APIYI hat claude-opus-5-5 und claude-opus-5-5-thinking bereits gelistet, mit Listenpreisen von 4 US-Dollar für die Eingabe, 20 US-Dollar für die Ausgabe und 0,2 US-Dollar für Cache-Lesezugriffe – deckungsgleich mit den offiziellen Kurzkontext-Preisen. Der offizielle Listenpreis für GPT-6.2 Astra liegt bei 8 US-Dollar für die Eingabe, 40 US-Dollar für die Ausgabe und 0,40 US-Dollar für Cache-Lesezugriffe; auf APIYI ist das Modell noch nicht gelistet – wir werden es so bald wie möglich anbieten; maßgeblich für Modellnamen und Preise ist die Modellliste der Plattform. Stand 2026-11-17, 15:54 Uhr (UTC+8) war gpt-6.2-astra weder in der Gesamttabelle der Plattform noch über die Preis-Schnittstelle auffindbar; Sie können dies jederzeit in der Modellliste auf apiyi.com überprüfen.
GPT-6.2 Astra: Offiziell angegebene Fähigkeiten – wofür eignet sich das Modell?
In der Ankündigung nennt OpenAI eine Reihe von Zahlen auf Aufgabenebene. Wichtig vorab: Bei allen folgenden Werten handelt es sich um offizielle Selbstauskünfte. Verglichen wurde meist mit dem eigenen Vorgänger GPT-6 Astra oder mit Claude Fable 5.2 von Anthropic – einen direkten Vergleich mit Claude Opus 5.5 enthält die Ankündigung nicht. Die Zahlen zeigen also, bei welchen Aufgabentypen Astra Fortschritte gemacht hat; wie viel besser das Modell gegenüber Opus 5.5 ist, lässt sich daraus nicht direkt ableiten.
| Aufgabentyp | Offiziell angegebenes Ergebnis | Vergleichsmodell | Was das aussagt |
|---|---|---|---|
| Professionelle Dokumente (GDPval v2, intern) | 6,2 Prozentpunkte höher, 22 % weniger Output-Tokens | GPT-6 Astra | Berufliche Dokumentenerstellung verbessert und sparsamer im Output |
| Recht (Harvey LAB-AA v1.1) | Bestehensquote mehr als doppelt so hoch wie beim Vergleichsmodell, Kosten etwa ein Sechstel | Claude Fable 5.2 | Rechtliche Workflows sind ein Schwerpunkt der offiziellen Vermarktung |
| Wissenschaftliches Terminal (Terminal-Bench-Science 0.1) | 9 Prozentpunkte höher, Kosten unter einem Drittel | GPT-6 Astra | Deutliche Fortschritte bei wissenschaftlichen Terminal-Aufgaben |
| 3D (AA-3D, Elo aus menschlicher Blind-Bewertung, offiziell zitiert) | 1318 | Claude Fable 5.2: 1271 | Präferenz in der Blind-Bewertung bei 3D-Generierungsaufgaben |
| Lang andauernde professionelle Workflows (Agents‘ Last Exam) | 5,2 Punkte höher, Kosten unter einem Drittel | GPT-6 Astra | Stabilität bei mehrstufigen professionellen Abläufen |
Neben der Tabelle gibt OpenAI außerdem an, Astra habe beim Vals Science Index einen neuen Bestwert erzielt – eine absolute Punktzahl nennt die Ankündigung jedoch nicht. Beim AA-AnalystAgent sollen laut offiziellen Angaben 62,5 % der Fragen bei allen fünf unabhängigen Durchläufen korrekt beantwortet worden sein. Für den Rechtsbereich gibt es zudem eine eigene Konfiguration namens „Astra for Law“, die laut OpenAI noch besser abschneidet – auch hier fehlt eine absolute Bestehensquote.
Bekannte Einschränkungen von GPT-6.2 Astra
Auch die offizielle System Card listet Einschränkungen auf, die man vorab kennen sollte. Zur Sicherheit: Im Preparedness-Framework stuft OpenAI Astra bei der Cybersicherheit auf die Stufe „kritisch“ ein; die Schutzmechanismen fallen entsprechend strenger aus, und ein Teil legitimer Anfragen zur Schwachstellenforschung wird abgelehnt. Wenn Sicherheitsforschung zu Ihrem Geschäftsfeld gehört, sollten Sie das vorher prüfen. Beim Alignment räumt OpenAI ein, dass das Modell in zwei Tests anfälliger dafür ist, blockierende Probleme unerwähnt zu lassen – etwa fehlende Dateien oder nicht verfügbare Suchwerkzeuge. Nach zusätzlichen Anweisungen in Codex traten solche Auslassungen deutlich seltener auf. Wer Agenten entwickelt, sollte in der System-Eingabeaufforderung ausdrücklich verlangen, dass Tool-Ausfälle immer gemeldet werden.
Bei den Modalitäten nimmt Astra nur Text und Bilder entgegen und gibt ausschließlich Text aus; Audio und Video werden nicht unterstützt. Verfügbare Endpunkte sind nur Chat Completions, Responses und Batch – Realtime, Assistants, Fine-Tuning, Bilderzeugung und Sprache werden nicht unterstützt.
Die Positionierung von Claude Opus 5.5: Eine Claude-Protokoll-Lösung für den sofortigen Einsatz
Die offiziellen Spezifikationen von Claude Opus 5.5 lauten: 1M Kontextfenster, maximal 128K Ausgabe, effort standardmäßig auf medium, Wissensstand 2026-06. Sein Wert zeigt sich in drei Punkten: Der Preis beträgt etwa die Hälfte des Listenpreises von Astra für kurze Kontexte; das Modell läuft über das Messages-Protokoll von Claude, sodass bestehende Toolchains, die auf dem Claude-Ökosystem aufbauen, nicht umgebaut werden müssen; und auf APIYI lässt es sich bereits jetzt direkt aufrufen.
Beim Caching liegen die Cache-Reads von Opus 5.5 laut Abgleich mit der Anthropic-Dokumentation bei 0,20 US-Dollar. Nach der Wiedergabe der Anthropic-Preisliste kostet der 5-Minuten-Cache-Write 5 US-Dollar und der 1-Stunden-Write 8 US-Dollar; beide Angaben sind jedoch nur eine Wiedergabe der Preisliste – vor der Integration sollten Sie die offizielle Seite als maßgeblich heranziehen. Bei Astra kostet der Cache-Write (30 Minuten Aufbewahrung) 10 US-Dollar, der 12-Stunden-Cache-Write 20 US-Dollar. Bei Anwendungen mit langen System-Eingabeaufforderungen und großen Mengen wiederholter Retrieval-Kontexte wird der Preisunterschied pro Cache-Read durch das Aufrufvolumen zusätzlich vergrößert.
Objektiv muss man festhalten: In den Referenzmaterialien finden sich weder Ergebnisse von Opus 5.5 zu den konkreten Aufgaben aus der obigen Tabelle noch Drittanbieter-Kosten pro Einzelaufgabe. Dieser Artikel behauptet daher nicht, um wie viel Opus bei Rechts-, Wissenschafts- oder 3D-Aufgaben zurückliegt; festhalten lässt sich nur, dass Astra in diesen Bereichen über offiziell selbst berichtete Belege verfügt, während es für Opus keine entsprechenden öffentlichen Vergleichsdaten gibt.
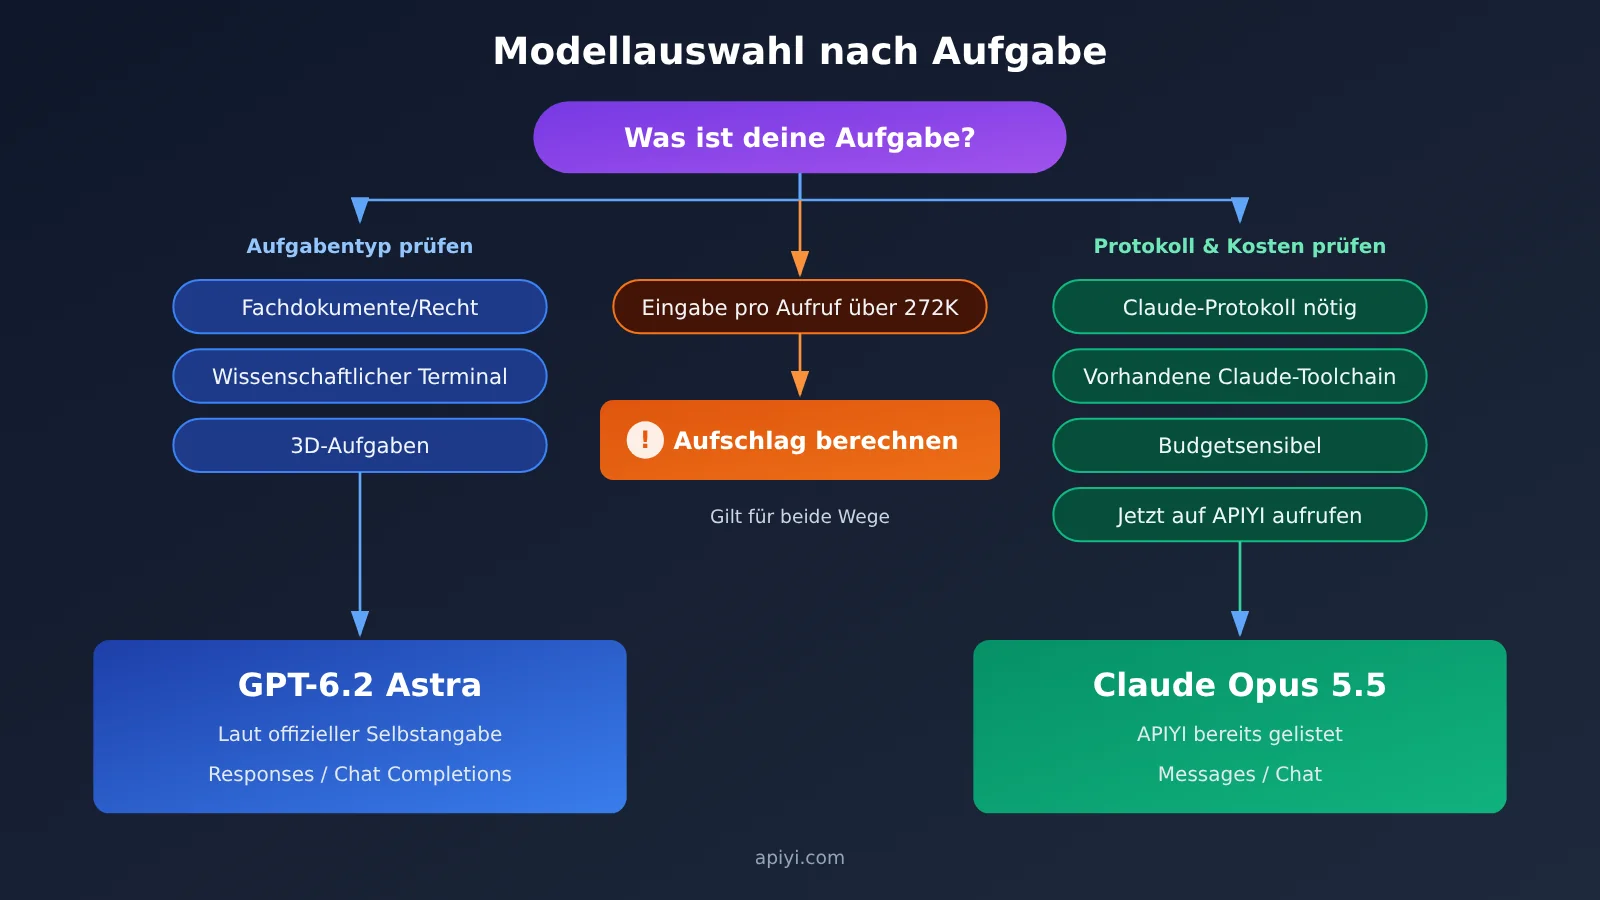
Szenario-Empfehlungen für GPT-6.2 Astra und Claude Opus 5.5
Überträgt man die oben genannten Fakten auf konkrete Aufgaben, ergibt sich die folgende Entscheidungshilfe. Die Spalte „Grundlage“ zeigt an, ob die jeweilige Empfehlung auf offiziellen Eigenangaben, auf Daten Dritter oder auf Listenpreisen und Protokollen beruht.
| Aufgabenszenario | Empfohlene erste Wahl | Grundlage |
|---|---|---|
| Prüfung juristischer Dokumente, Vertragsanalyse | GPT-6.2 Astra | Offiziell berichtete Harvey LAB-AA-Ergebnisse |
| Erstellung langer beruflicher Dokumente und Berichte | GPT-6.2 Astra | Offiziell berichtete GDPval-v2-Verbesserung und weniger Output-Tokens |
| Wissenschaftliche Berechnungen, Forschungsabläufe im Terminal | GPT-6.2 Astra | Offiziell berichtete Terminal-Bench-Science-Verbesserung |
| Aufgaben rund um 3D-Inhalte | GPT-6.2 Astra | Offiziell zitierte Elo-Werte aus dem AA-3D-Blindtest |
| Vorhandene Claude-Toolchain, Messages-Protokoll | Claude Opus 5.5 | Protokollkompatibel, kein Anpassungsaufwand |
| Allgemeine Aufgaben mit hohem Aufrufvolumen, budgetsensibel | Claude Opus 5.5 | Listenpreis für kurzes Kontextfenster und Cache-Lesezugriffe etwa halb so hoch |
| Muss heute noch auf APIYI live gehen | Claude Opus 5.5 | Auf der Plattform bereits gelistet, 6.2 vorerst noch nicht verfügbar |
| Sicherheitsforschung, Schwachstellenanalyse | Zuerst beide einzeln testen | Offizielle Astra-Hinweise besagen, dass einige legitime Anfragen abgelehnt werden |
Szenarien, in denen sich GPT-6.2 Astra eignet
- Fachdokumente und Recht: Die offiziell berichteten Fortschritte konzentrieren sich genau auf diese Art von Aufgaben; zudem soll der Output weniger Tokens umfassen, was den höheren Stückpreis teilweise ausgleicht.
- Wissenschaftliches Terminal und 3D: Terminal-Bench-Science und AA-3D sind in der Veröffentlichung die wenigen Benchmarks, die konkrete Differenzen oder Scores ausweisen.
- Bereitschaft zum nativen OpenAI-Protokoll: Wenn Sie die Inferenz-Pipeline über den Responses-Endpunkt benötigen oder bereits das OpenAI SDK einsetzen. Beachten Sie: Die Reasoning-Stärke darf nicht auf none gesetzt werden – mindestens ein gewisser Reasoning-Overhead fällt immer an.
Szenarien, in denen sich Claude Opus 5.5 eignet
- Claude-Protokoll hat Vorrang: Wer bereits auf Messages basierende Agents, Tool-Aufrufe oder Claude-Code-ähnliche Workflows nutzt, hat die geringsten Wechselkosten.
- Preissensibel: Input, Output und Cache-Lesezugriffe kosten jeweils etwa die Hälfte von Astra – ideal für Anwendungen mit großen Mengen und wiederkehrenden Kontexten.
- Sofort verfügbar: Auf APIYI lässt sich das Modell bereits mit einem einzigen API-Schlüssel aufrufen, ohne auf das Listing neuer Modelle warten zu müssen.
💡 Auswahlhinweis: Welches Modell die richtige Wahl ist, hängt vor allem von Ihrer Aufgabenart und Ihrer Protokoll-Situation ab. Ziehen Sie am besten Ihre 20 bis 50 häufigsten realen Aufgaben heraus, führen Sie beide Modelle damit einmal aus und treffen Sie dann Ihre Entscheidung. Über APIYI (apiyi.com) können Sie mit demselben API-Schlüssel Modelle von Claude, OpenAI und weiteren Anbietern aufrufen – praktisch, um innerhalb desselben Evaluierungsskripts zwischen Modellen zu wechseln.
Schnellstart mit GPT-6.2 Astra und Claude Opus 5.5
Dieser Abschnitt beschreibt die Integrationsschritte ausschließlich in Textform; Parameternamen sind als Inline-Code gekennzeichnet.
Claude Opus 5.5 über APIYI aufrufen
- Registrieren Sie sich bei APIYI und erstellen Sie einen API-Schlüssel – neue Nutzer erhalten ein kostenloses Testguthaben.
- Wenn Sie den OpenAI-kompatiblen Weg nutzen, setzen Sie bei der Initialisierung des Clients im OpenAI SDK
base_urlaufhttps://api.apiyi.com/v1und tragen Sie beiapi_keyIhren Plattform-Schlüssel ein. - Beim Aufruf von Chat Completions setzen Sie
modelaufclaude-opus-5-5; für die Thinking-Variante verwenden Sieclaude-opus-5-5-thinking. - Basieret Ihr bestehender Code auf dem Messages-Protokoll von Claude, zeigt die Gesamtübersicht der Plattform, dass dieses Modell ebenfalls den messages-Endpunkt unterstützt. Sie müssen nur Schlüssel und Dienstadresse austauschen und können Ihre bisherige Aufrufstruktur unverändert weiterverwenden.
- Testen Sie zuerst mit einer kurzen Anfrage, ob die Antworten korrekt ankommen, und binden Sie erst danach Caching- und Batch-Logik ein.
In der Gesamtübersicht von APIYI sind für diese beiden Modelle die Gruppen ClaudeCode, Claude_Reverse, Claude_Enterprise, Default und SVIP gelistet, alle mit denselben Preisen: 4 US-Dollar für die Eingabe, 20 US-Dollar für die Ausgabe und 0,2 US-Dollar für Cache-Lesezugriffe – identisch mit den offiziellen Preisen im Kurzkontext.
Hinweise zum Aufruf von GPT-6.2 Astra
Derzeit lässt sich gpt-6.2-astra direkt über die OpenAI API aufrufen, wahlweise über den Responses- oder den Chat-Completions-Endpunkt. Beim Festlegen der Reasoning-Stärke darf none nicht übergeben werden, da die Schnittstelle dies ablehnt. Was die Abrechnung angeht: Schätzen Sie vorab ein, ob eine einzelne Eingabe 272K Token überschreitet – falls ja, wird die gesamte Anfrage zum Langkontext-Preis berechnet. Batch kostet 50 % des Standardpreises; Fast das Doppelte des Standardpreises bei gleicher Kontextlänge; Ultrafast kostet bis zum 2027-02-28 (Pazifische Zeit) das Dreifache und ab dem 2027-03-01 das Sechsfache.
Bei APIYI ist gpt-6.2-astra bisher noch nicht gelistet; wir werden dieses Modell so bald wie möglich verfügbar machen. Modellname und Preis richten sich nach der Modellliste der Plattform. Nach dem Listing können Sie die Dienstadresse https://api.apiyi.com/v1 und denselben Schlüssel, die Sie bereits für Opus nutzen, theoretisch weiterverwenden – Sie müssen lediglich Endpunkt und Modellnamen gemäß der Plattformliste eintragen. Bitte schätzen Sie die Kosten für 6.2 nicht anhand der Preise von gpt-6-astra oder gpt-6.1-sol auf der Plattform ab – es handelt sich um unterschiedliche Modelle.
🚀 Schnellstart: Passt Ihre Aufgabe zu Opus, können Sie heute auf APIYI unter apiyi.com mit dem kostenlosen Guthaben Ihre erste Anfrage erfolgreich absetzen. Wenn Sie mehr Wert auf die offiziell angegebenen Fähigkeiten von Astra legen, führen Sie zunächst eine kleinere Validierung über die offizielle OpenAI API durch und behalten Sie die Modellliste der Plattform für Updates zum Listing im Auge.
Methode zur Kostenabschätzung für GPT-6.2 Astra und Claude Opus 5.5
Die Preisliste ist nur der Ausgangspunkt – die echte Rechnung hängt auch von der Ausgabelänge, der Cache-Trefferquote und der Kontextlänge ab. Das Rechenverfahren lässt sich am besten an einem hypothetischen Request zeigen: 100.000 Token Eingabe, davon 80.000 als Cache-Lesezugriff, plus 5.000 Token Ausgabe.
| Kostenposition | GPT-6.2 Astra (offizieller Listenpreis) | Claude Opus 5.5 (offizieller Listenpreis) |
|---|---|---|
| Eingabe ohne Cache-Treffer: 20.000 Token | 20.000 × 8 USD / Mio. = 0,16 USD | 20.000 × 4 USD / Mio. = 0,08 USD |
| Cache-Lesezugriff: 80.000 Token | 80.000 × 0,40 USD / Mio. = 0,032 USD | 80.000 × 0,20 USD / Mio. = 0,016 USD |
| Ausgabe: 5.000 Token | 5.000 × 40 USD / Mio. = 0,20 USD | 5.000 × 20 USD / Mio. = 0,10 USD |
| Summe pro Anfrage (ohne Cache-Schreibzugriffe und Unterschiede bei Reasoning-Token) | ca. 0,392 USD | ca. 0,196 USD |
Dieses Beispiel veranschaulicht nur das Verhältnis der Einheitspreise, nicht das Verhältnis der tatsächlichen Rechnungen. Nach offiziellen Angaben gibt Astra bei GDPval v2 rund 22 % weniger Ausgabe-Token aus als GPT-6 Astra – gemessen wurde das aber gegen den eigenen Vorgänger, nicht gegen Opus. Auch der Reasoning-Token-Verbrauch und die standardmäßig aktivierte Reasoning-Stufe unterscheiden sich zwischen den beiden Modellen (Opus nutzt standardmäßig effort „medium“, bei Astra lässt sich das Reasoning nicht abschalten). Wie hoch die Kosten am Ende wirklich ausfallen, lässt sich also nur mit deinen echten Aufgaben messen.
Häufig gestellte Fragen (FAQ)
Q1: Was sind GPT-6.2 Astra und Claude Opus 5.5?
GPT-6.2 Astra ist ein Modell von OpenAI, das am 17. November 2026 veröffentlicht wurde – Modell-ID `gpt-6.2-astra`, Kontextfenster von 1.050.000 Token, maximale Ausgabe von 128.000 Token. Claude Opus 5.5 ist ein Modell von Anthropic: Kontextfenster 1M, maximale Ausgabe 128K, standardmäßig effort medium.
Q2: Drittanbieter-Gesamtscore 62 gegenüber 59 – heißt das, dass Astra rundum besser ist?
Nein. Es handelt sich um den Drittanbieter-Gesamtindex von Artificial Analysis: Die 62 von Astra gilt für die Stufe Max, die 59 von Opus für dessen höchste Stufe. Der Gesamtindex ist das Ergebnis eines festen Aufgabensets und deckt sich nicht zwangsläufig mit Ihrer konkreten Aufgabe. Außerdem fällt der Drittanbieter-Score von Astra auf der Stufe Medium auf 57 – Werte aus unterschiedlichen Stufen sollte man nicht direkt vergleichen.
Q3: Lassen sich die offiziellen Fähigkeitswerte von OpenAI und die Drittanbieter-Scores zusammen betrachten?
Nein, sie lassen sich nicht zu einer gemeinsamen Schlussfolgerung zusammenfassen. Die offiziell selbst gemeldeten Zahlen beziehen sich meist auf GPT-6 Astra oder Claude Fable 5.2, nicht direkt auf Opus 5.5; der Drittanbieter-Gesamtscore basiert wiederum auf einem anderen Aufgabenset. Beide Zahlenreihen sagen jeweils etwas anderes aus – bei der Modellauswahl sollten Sie sie getrennt heranziehen.
Q4: Kann GPT-6.2 Astra derzeit über APIYI aufgerufen werden?
Noch nicht – wir werden das Modell so bald wie möglich verfügbar machen; maßgeblich für Modell und Preis ist die Modellliste der Plattform. Derzeit ist der Aufruf über die offizielle OpenAI-API möglich. Das auf der Plattform angebotene `gpt-6-astra` ist nicht dasselbe Modell wie 6.2 und auch anders bepreist – das eine lässt sich nicht als Ersatz oder Schätzgrundlage für das andere verwenden.
Q5: Wie ruft man Claude Opus 5.5 schnell über APIYI auf?
Registrieren Sie sich auf APIYI unter apiyi.com, um einen API-Schlüssel und kostenloses Testguthaben zu erhalten. Setzen Sie dann die `base_url` Ihres Clients auf die Plattformadresse und tragen Sie bei `model` `claude-opus-5-5` ein. Die Plattform unterstützt sowohl den chat- als auch den messages-Endpunkt: Sie können also OpenAI-kompatibel aufrufen oder Ihre bestehende Codestruktur mit dem nativen Claude-Protokoll beibehalten.
Q6: Wie groß ist der Preisunterschied beim Caching, und für welche Anwendungen macht er sich stark bemerkbar?
Laut offizieller Preisliste kostet der Cache-Lesezugriff bei Astra 0,40 USD und bei Opus 0,20 USD – genau die Hälfte. Bei Anwendungen mit langen System-Eingabeaufforderungen, festen Wissensdatenbank-Präfixen oder Dialogen, die über mehrere Runden den Kontext wiederverwenden, macht der Cache-Lesezugriff einen hohen Anteil aus – dieser Unterschied schlägt sich direkt auf der Rechnung nieder.
Q7: Welche bekannten Einschränkungen gibt es bei GPT-6.2 Astra?
Die offiziellen Angaben im Einzelnen: Die Reasoning-Stärke lässt sich nicht auf none setzen; überschreitet die Eingabe einer einzelnen Anfrage 272K Token, wird ein Aufpreis auf die gesamte Anfrage fällig; unterstützt werden nur Text- und Bildeingaben; die Sicherheitsvorkehrungen sind strenger, ein Teil der legitimen Schwachstellenforschung wird abgelehnt; in zwei Tests werden blockierende Probleme wie fehlende Dateien oder nicht verfügbare Tools häufiger nicht gemeldet. Drittanbieter berichten zudem von einer Halluzinationsrate von 59 % auf der Stufe Max.
Q8: Was ist der sicherste Weg bei der Modellauswahl?
Führen Sie den kleinen Stichprobenvergleich mit Ihren eigenen echten Aufgaben durch. Setzen Sie zunächst auf APIYI (apiyi.com) mit Opus eine Baseline auf und dokumentieren Sie Qualität, Ausgabelänge und Cache-Trefferquote; sobald Astra gelistet ist, tauschen Sie im selben Skript nur das Modell aus und lassen Sie es erneut laufen. Entscheiden Sie anhand der tatsächlichen Abrechnung und der Erfolgsquote – nicht anhand eines einzelnen Gesamtwerts.
GPT-6.2 Astra und Claude Opus 5.5: Die Kernpunkte (Key Takeaways)
- Der Gesamtwert stammt aus Drittanbieter-Daten: Artificial Analysis vergibt für die Astra-Max-Stufe 62 und für Opus in der höchsten Stufe 59 Punkte – jeweils an die Reasoning-Stufe gebunden.
- Offizielle Eigenangaben konzentrieren sich auf Fachaufgaben: Für Recht, professionelle Dokumente, wissenschaftliche Terminals und 3D gibt es konkrete Zahlen, jedoch keinen direkten Vergleich mit Opus.
- Offizieller Preis bei kurzem Kontext: rund die Hälfte: Opus kostet bei Eingabe, Ausgabe und Cache-Lesen jeweils die Hälfte der offiziellen Astra-Preise.
- Astra erhebt ab 272K einen Aufschlag auf den gesamten Auftrag: Lange Eingabeanfragen sollten Sie vorab durchrechnen – Eingabe und Cache verdoppeln sich, die Ausgabe kostet das 1,5-Fache.
- Das Protokoll bestimmt die Migrationskosten: Astra läuft über Responses und Chat Completions, Opus über Chat und Messages.
- Die Verfügbarkeit unterscheidet sich: Opus ist bereits über APIYI aufrufbar, GPT-6.2 Astra ist noch nicht gelistet – maßgeblich ist die Modellliste der jeweiligen Plattform.
Zusammenfassung
Die wichtigsten Entscheidungspunkte bei GPT-6.2 Astra und Claude Opus 5.5:
- Evidenz aufgabenspezifisch prüfen: Bei Aufgaben wie Fachdokumenten, Recht, wissenschaftlichen Terminal-Aufgaben und 3D lohnt ein Blick auf die offiziellen Selbstauskünfte von Astra; für andere Aufgaben gibt es keine direkten Vergleichsdaten – hier müssen Sie selbst messen.
- Preise anhand der Abrechnung vergleichen: Bei kurzem Kontext kostet Opus etwa halb so viel wie Astra, beim Cache-Lesen ebenfalls rund die Hälfte; bei langen Eingaben kommt bei Astra zusätzlich ein Aufschlag auf die gesamte Abrechnung hinzu.
- Protokoll und Verfügbarkeit im Kontext des Ist-Zustands bewerten: Wer bereits eine Claude-Toolchain besitzt und sofort live gehen muss, fährt mit Opus dank geringerer Migrationskosten besser; wer die nativen OpenAI-Responses-Funktionen benötigt, sollte sich Astra ansehen.
Sie müssen nicht mit einer einzigen Entscheidung für alle Aufgaben festlegen, welches Modell zum Einsatz kommt. Häufige Aufgaben in Gruppen zu unterteilen und für jede Gruppe separat ein Modell zu wählen, ist meist günstiger als eine komplette Umstellung. Empfehlung: Richten Sie zunächst über APIYI (apiyi.com) mit dem kostenlosen Guthaben eine Opus-Baseline ein, und planen Sie dann auf Basis der offiziellen Astra-Fähigkeiten und der Informationen zum späteren Listing ein Routing auf Aufgabenebene.
📚 Quellen
-
OpenAI-Ankündigung: Beschreibung der Fähigkeiten und Preise von GPT-6.2 Astra und Sol (offizielle Selbstauskunft)
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol - Hinweis: Quelle der offiziellen Zahlen zu Agents‘ Last Exam, GDPval v2, Harvey LAB-AA und weiteren Benchmarks
- Link:
-
OpenAI-Modellseite – gpt-6.2-astra: Spezifikationen, Endpunkte und Preisregeln
- Link:
platform.openai.com/docs/models/gpt-6.2-astra - Hinweis: Maßgeblich für den 272K-Gesamtaufschlag sowie die Multiplikatoren für Batch, Fast und Ultrafast
- Link:
-
OpenAI-Systemkarte: Sicherheitsstufen und Alignment-Bewertungen
- Link:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Hinweis: Erläuterungen zum Schutz im Bereich Cybersicherheit sowie zum Problem des Unterreportings
- Link:
-
Artificial Analysis – Artikel und Modellseite: Unabhängiger Gesamtindex und Punktwerte je Reasoning-Stufe
- Link:
artificialanalysis.ai/models/gpt-6-2-astra - Hinweis: Intelligence Index v5.0.1 – Punktwerte der einzelnen Reasoning-Stufen sowie Kosten pro Einzelaufgabe
- Link:
-
Anthropic-Modelldokumentation: Spezifikationen und Preisvergleich für Claude Opus 5.5
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview - Hinweis: Dieselbe Seite enthält die Preise für Ein- und Ausgabe, das Kontextfenster sowie den Standard-effort von Opus 5.5
- Link:
Autor: APIYI-Technikteam
Technischer Austausch: Besuchen Sie uns gerne auf der Startseite von APIYI; Modelle und Preise finden Sie in der Gesamtübersicht der Modelle im Dokumentationscenter unter docs.apiyi.com