Anmerkung des Autors: Dieser Beitrag trennt die Gesamt-Rangliste von Drittanbietern, die von den Anbietern selbst gemeldeten Einzelaufgaben und die Listenpreise von GPT-6.2 Astra und Claude Fable 5.2 in drei Ebenen auf und erklärt die Unterschiede beim Cache-Read sowie, welches der beiden Modelle derzeit über APIYI aufgerufen werden kann.
Am 17. November 2026 veröffentlichte OpenAI GPT-6.2 Astra und GPT-6.2 Sol. Rund eine Woche zuvor, am 9. November 2026, wurde die Dokumentation für Claude Fable 5.2 bei Anthropic veröffentlicht. Die Listenpreise für kurzen Kontext liegen bei beiden Flaggschiffen bei 8 US-Dollar für die Eingabe und 40 US-Dollar für die Ausgabe pro 1 Million Token; die Diskussion um die Auswahl konzentrierte sich daher natürlich auf GPT-6.2 Astra und Claude Fable 5.2.
Das Problem: Die beiden Arten von Ranglisten weisen in unterschiedliche Richtungen. Im Gesamtindex des Drittanbieters Artificial Analysis erzielt Fable 5.2 eine höhere Punktzahl. In mehreren spezialisierten Aufgaben, die OpenAI im eigenen Release-Beitrag selbst meldet, liegt Astra vorn – und die offiziell angegebenen Kosten pro Aufgabe sind dort niedriger. Wirft man beide Zahlenwerke zusammen, gelangt man zu einem Fazit darüber, „wer stärker ist“; doch dieses Fazit lässt sich mit den Daten beider Seiten nicht belegen.
Dies ist kein Artikel, der einen Sieger verkündet. Dieser Artikel teilt die Zahlen in drei Ebenen auf: die Gesamt-Rangliste von Drittanbietern, die von den Anbietern selbst gemeldeten Einzelaufgaben und die offiziellen Listenpreise. Jede Ebene wird separat betrachtet; zum Schluss wird erklärt, welches Modell derzeit über APIYI aufgerufen werden kann.
Der Kernnutzen: Nach dem Lesen dieses Artikels kannst du für die Aufgabe, die dich interessiert, die passende Rangliste heranziehen, den Unterschied beim Cache-Read-Preis erkennen und den aktuellen Integrationsstatus der beiden Modelle nachvollziehen.
GPT-6.2 Astra und Claude Fable 5.2: Kernpunkte – die drei Datenschichten nicht vermischen
Beim Vergleich von GPT-6.2 Astra und Claude Fable 5.2 passiert der häufigste Fehler, wenn Zahlen aus unterschiedlichen Quellen in ein und dasselbe Fazit gepackt werden. Die folgende Tabelle trennt zuerst Herkunft und Aussage der drei Informationsebenen.
| Datenebene | Art der Quelle | Wohin diese Ebene zeigt | Beim Verwenden beachten |
|---|---|---|---|
| Gesamt-Rangliste | Drittanbieter Artificial Analysis, Intelligence Index v5.0.1 | Fable 5.2 erreicht 65, Astra (Max) 62 | Die Reasoning-Stufe muss immer mit angegeben werden – die Werte unterscheiden sich je nach Stufe deutlich |
| Einzelaufgaben | Offizielle Eigenangaben im OpenAI-Release; AA-3D ist eine offiziell wiedergegebene Blindbewertung Dritter | Bei Agents‘ Last Exam, Harvey LAB-AA und AA-3D liegt Astra vorn | In der ALE-Wertung enthält Fable nicht die neun Aufgaben des Fallback-Modells |
| Listenpreise | Offizielle Modellseiten und Dokumentationen beider Anbieter | Input und Output kosten gleich viel, das Lesen aus dem Cache ist bei Fable günstiger | Cache-Schreibvorgänge werden unterschiedlich lange aufbewahrt, und die Regeln für lange Kontexte unterscheiden sich |
Warum GPT-6.2 Astra und Claude Fable 5.2 „jeweils eine Disziplin anführen“
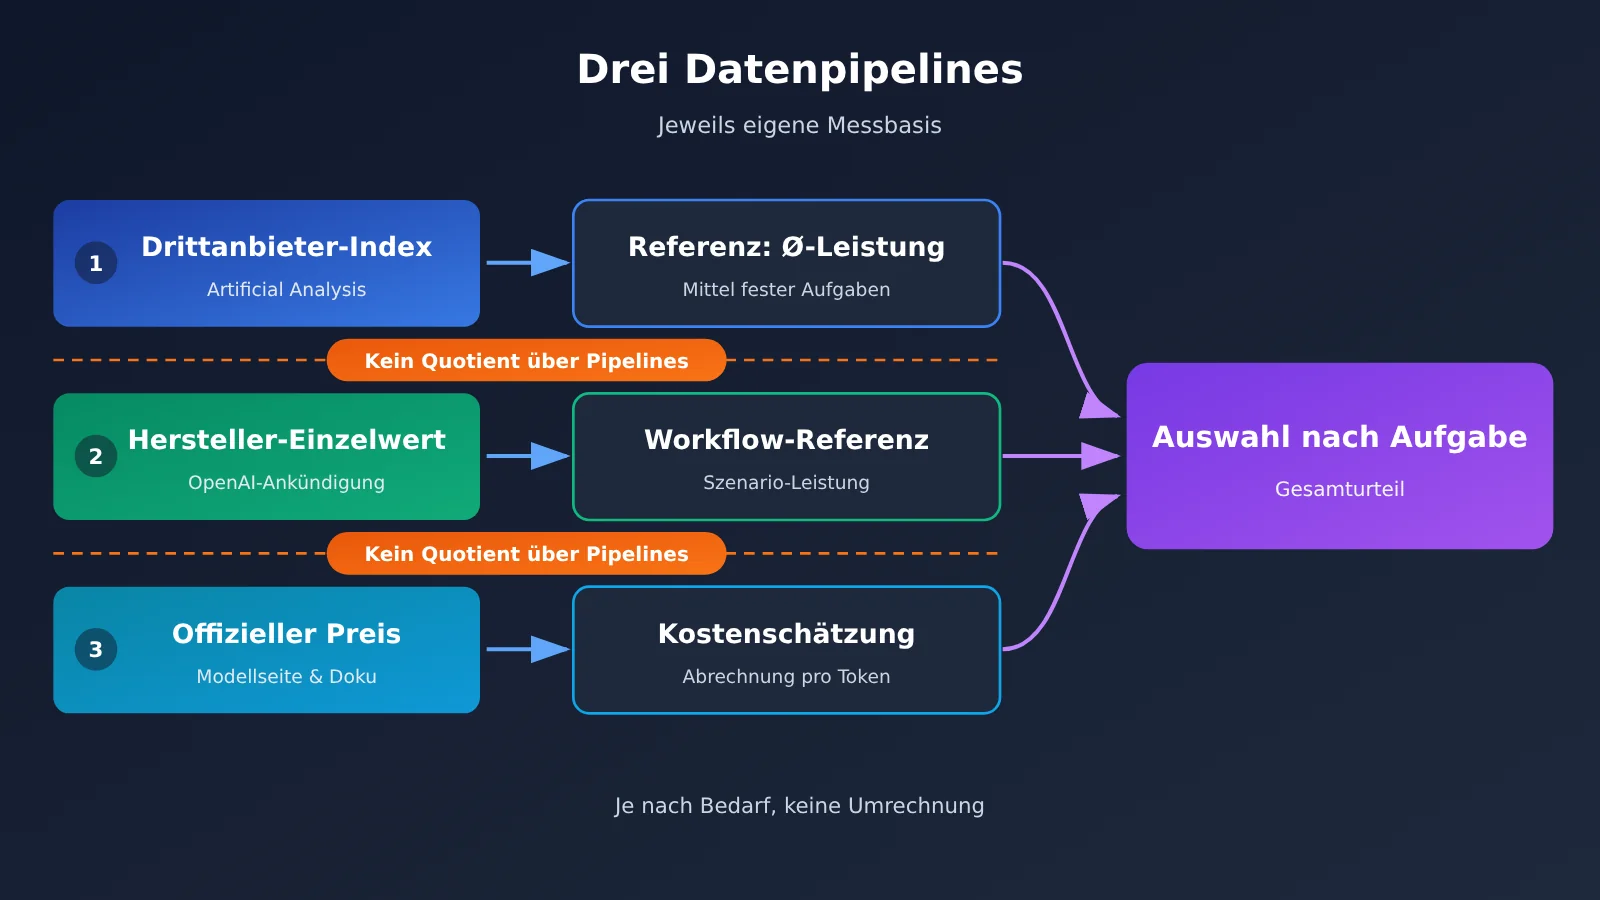
Der Gesamtindex misst die Durchschnittsleistung über einen festen Aufgabensatz, dessen Gewichtung der Drittanbieter festlegt. Das OpenAI-Release hebt dagegen konkrete Szenarien hervor – langlaufende Fach-Workflows, Recht, 3D-Generierung –, und die Testeinstellungen legt der Anbieter selbst fest. Beide beantworten von vornherein unterschiedliche Fragen: Der eine betrachtet das Durchschnittsniveau, der andere die Leistung in bestimmten Workflows. Widersprüchliche Ergebnisse bedeuten also nicht, dass eine der beiden Datenseiten fehlerhaft ist.
Bei den Kosten ist es genauso. Die von Artificial Analysis angegebenen „Kosten pro Aufgabe“ sind die Ausgaben für das Durchlaufen der Aufgaben ihres Gesamtindex. Was OpenAI mit „die ALE-Kosten liegen bei rund 5 % von Fable“ meint, bezieht sich auf einen anderen Aufgabensatz und eine andere Berechnungsgrundlage. Diese beiden Zahlen lassen sich weder durcheinander teilen noch ineinander umrechnen.
Die zentralen Unterschiede zwischen GPT-6.2 Astra und Claude Fable 5.2: Das unabhängige Gesamtranking
Artificial Analysis hat am 17. November 2026 einen Artikel veröffentlicht und die Modellseiten aktualisiert. Alle folgenden Werte stammen aus dem Intelligence Index v5.0.1. Es handelt sich um eine Bewertung durch Dritte, nicht um Selbstdarstellungen der Anbieter.
| Modell | Inferenzstufe | Intelligence Index v5.0.1 | Kosten pro Aufgabe im Gesamtindex (jeweilige Modellseite) |
|---|---|---|---|
| Claude Fable 5.2 | Höchste Inferenzstufe | 65 (Platz 1 im Ranking) | 26,54 US-Dollar |
| GPT-6.2 Astra | Max / Xhigh | 62 | 4,00 US-Dollar (Max) |
| GPT-6.2 Astra | High / Medium / Low | 60 / 57 / 46 | — |
| GPT-6.2 Sol | Max | 57 | 1,01 US-Dollar (Max) |
| Gemini 4 Carbon | Höchste Stufe | 60 | — |
| Claude Opus 5.5 | Höchste Stufe | 59 | — |
In diesem unabhängigen Ranking erzielt Fable 5.2 im Gesamtwert 3 Punkte mehr als Astra in der höchsten Inferenzstufe. Astra liegt wiederum 5 Punkte über der vorherigen Generation GPT-6 Astra und übertrifft auch die höchsten Stufen von Gemini 4 Carbon und Claude Opus 5.5. Beachten Sie außerdem: Sobald Astra auf die Low-Stufe heruntergeschaltet wird, bleiben nur noch 46 Punkte übrig. Wenn Sie in Ihrem Betrieb die Inferenzintensität senken, um Kosten zu sparen, können Sie nicht erwarten, dass die Ergebnisse den 62 Punkten entsprechen.
Der Artikel von Artificial Analysis enthält außerdem mehrere Detailergebnisse, die ebenfalls aus unabhängigen Daten stammen. In der Forschungsvorschau von AA-Robotics v0.1 erreicht Astra 79 Punkte, Fable 5.2 kommt auf 75. Bei wissenschaftlichen Aufgaben führt Astra in Terminal-Bench-Science 0.1 und liegt auf der schwierigen Teilmenge von CritPt v2 nur hinter Fable 5.2. Im Coding Agent Index (Codex-Harness, max) liegt Astra gleichauf mit GPT-6 Astra. Bei der Halluzinationsrate von AA-Omniscience (Max) kommt Astra auf 59 %.
GPT-6.2 Astra vs. Claude Fable 5.2: die wichtigsten Unterschiede bei den offiziell selbst berichteten Einzelwerten
Die folgenden Zahlen stammen aus der OpenAI-Pressemitteilung und der Modellseite und sind durchweg offiziell selbst berichtet. Bei den Punkten, für die die Pressemitteilung keine absoluten Werte nennt, gibt dieser Artikel ebenfalls nur den relativen Abstand an.
| Einzelaufgabe | Offiziell selbst berichtetes Ergebnis | Offizielle Kostenangabe | Fußnote, die man beachten sollte |
|---|---|---|---|
| Agents‘ Last Exam (langlaufende professionelle Workflows) | Astra liegt 5,5 Punkte über Fable 5.2 | Kosten entsprechen etwa 5 % von Fable | In der Rangliste fehlen bei Fable 5.2 die neun Aufgaben, für die ein Ersatzmodell verwendet wurde |
| Harvey LAB-AA v1.1 (Recht) | Astras Erfolgsquote ist mehr als doppelt so hoch wie die von Fable 5.2 | Kosten entsprechen etwa einem Sechstel | Die Pressemitteilung nennt keine absolute Erfolgsquote; die für Anwältinnen und Anwälte gedachte Konfiguration „Astra for Law“ ist höher angesetzt |
| AA-3D (menschliche Blindbewertung, Elo) | Astra 1318, Fable 5.2 1271, Sol 1259 | nicht angegeben | Blindbewertung durch Dritte, aber in der offiziellen Pressemitteilung wiedergegeben |
| Terminal-Bench-Science 0.1 | Astra liegt 9 Prozentpunkte über GPT-6 Astra | Kosten unter einem Drittel der vorherigen Generation | Für Fable gibt es zwei Zahlen aus unterschiedlichen Tests, siehe unten |
Die Fußnote zu Agents‘ Last Exam verdient eine eigene Erläuterung. OpenAI schreibt ausdrücklich, dass das Ergebnis von Fable 5.2 in der Rangliste die neun Aufgaben nicht enthält, für die ein Ersatzmodell zum Einsatz kam. Wer diese „5,5 Punkte mehr“ liest, sollte wissen, dass die Aufgabenabdeckung auf beiden Seiten nicht völlig identisch ist.
Bei Terminal-Bench-Science 0.1 gibt es für Fable 5.2 zwei Zahlen aus unterschiedlichen Quellen. Die eine stammt von Artificial Analysis und verwendet mini-swe-agent. Die andere sind die von Anthropic selbst berichteten 74,6 %, gemessen in der Umgebung Claude Code mit Max-Reasoning-Stärke. Diese beiden Zahlen sind nicht das Ergebnis desselben Tests, sie können einander nicht ersetzen und lassen sich auch nicht direkt mit Astra vergleichen.
Die 1318 und 1271 bei AA-3D sind an sich Elo-Werte aus einer menschlichen Blindbewertung durch Dritte, doch dieser Artikel zitiert die Wiedergabe aus der OpenAI-Pressemitteilung. Am besten schreibt man beim Zitieren „vom Hersteller wiedergegebene Blindbewertung durch Dritte“ – weder als rein offiziell selbst berichtet noch als unabhängig vom Autor dieses Artikels überprüft.
💡 Auswahlhinweis: Einzelwert-Ranglisten sind nur dann eine brauchbare Referenz, wenn der Aufgabentyp deinem eigenen Geschäft nahekommt. Fable 5.2 lässt sich bereits über APIYI apiyi.com aufrufen – am besten lässt du zuerst eine Runde mit deinen eigenen echten Stichproben laufen und beurteilst dann anhand der beiden Tabellen oben.
GPT-6.2 Astra und Claude Fable 5.2 im Preisvergleich: Beim Cache-Lesen sieht es anders aus
Laut offiziellen Listenpreisen sind die Standardpreise für kurzen Kontext bei beiden Modellen sowohl beim Input als auch beim Output identisch. Die Unterschiede liegen bei den cachebezogenen Posten und den Regeln für langen Kontext. Alle Preise in der folgenden Tabelle sind in US-Dollar pro 1 Million Token.
| Preisposten | GPT-6.2 Astra (offiziell bei OpenAI) | Claude Fable 5.2 (offiziell bei Anthropic) | Verfügbare Plattform (APIYI-Gesamttabelle 2026-11-17 15:54 UTC+8) |
|---|---|---|---|
| Input | 8 | 8 | Astra noch nicht gelistet; Fable 8 |
| Output | 40 | 40 | Astra noch nicht gelistet; Fable 40 |
| Cache-Lesen | 0.40 | 0.20 | Astra noch nicht gelistet; Fable 0.2 |
| Cache-Schreiben | 10 (30 Minuten Aufbewahrung), 20 (12 Stunden) | 10 (5 Minuten), 16 (1 Stunde) | Maßgeblich ist die Plattformliste |
| Kontext / max. Output | 1,050,000 / 128,000 (max. Input 922,000) | 1M / 128K | — |
| Batch | 50 % des Standardpreises | Input und Output zum halben Preis | — |
Der offizielle OpenAI-Listenpreis für GPT-6.2 Astra liegt bei 8 US-Dollar für den Input, 0.40 US-Dollar für das Cache-Lesen und 40 US-Dollar für den Output. Das Modell ist noch nicht gelistet – wir stellen es so schnell wie möglich bereit; Modellbezeichnung und Preise richten sich nach der Modellliste der Plattform. In der Modell-Gesamttabelle von APIYI (docs.apiyi.com/models.md) und in der öffentlichen Pricing-Schnittstelle war gpt-6.2-astra am 2026-11-17 nicht zu finden. Bitte schätzen Sie die Preise von 6.2 nicht anhand des bereits gelisteten gpt-6-astra (kurzer Kontext 10 / 50 / 1) – das sind zwei verschiedene Modelle.
Der Unterschied beim Cache-Lesen wirkt sich bei Agenten und langen Dialogen stark aus. Wer dieselben 100 Millionen Token aus dem Cache liest, zahlt laut Listenpreis mit Astra 40 US-Dollar, mit Fable 5.2 dagegen 20 US-Dollar. Wenn Ihr System-Prompt sehr lang ist oder Sie wiederholt auf dieselben Dokumente verweisen, schlägt sich das direkt in der Rechnung nieder. Beim Cache-Schreiben sind es nominell zwar beide 10 US-Dollar, doch Astra hält die Daten 30 Minuten vor, Fable nur 5 Minuten. Die Trefferquote hängt also vom Abstand zwischen den Anfragen ab – ein reiner Vergleich der Einheitspreise reicht nicht.
Auch die Regeln für langen Kontext unterscheiden sich. Auf der Modellseite von Astra steht: Übersteigt der Input einer einzelnen Anfrage 272K Token, verdoppeln sich die Preise für Input und Cache, und der Output kostet das 1,5-Fache des Kurzkontext-Preises – und zwar für die gesamte Anfrage. Im hier herangezogenen Preisauszug für Fable gibt es keine vergleichbare Staffelung; bitte prüfen Sie das vor der Integration selbst in der Anthropic-Dokumentation.
Auch die Beschleunigungsstufen sind unterschiedlich. Bei Astra kostet Fast das 2-Fache des Standardpreises, Ultrafast bis zum 28.02.2027 (pazifische Zeit) das 3-Fache, ab dem 01.03.2027 dann das 6-Fache. Der Fast-Modus von Fable bringt bis zu etwa 2,5-fache Geschwindigkeit zum Preis von 16 US-Dollar für den Input und 80 US-Dollar für den Output.
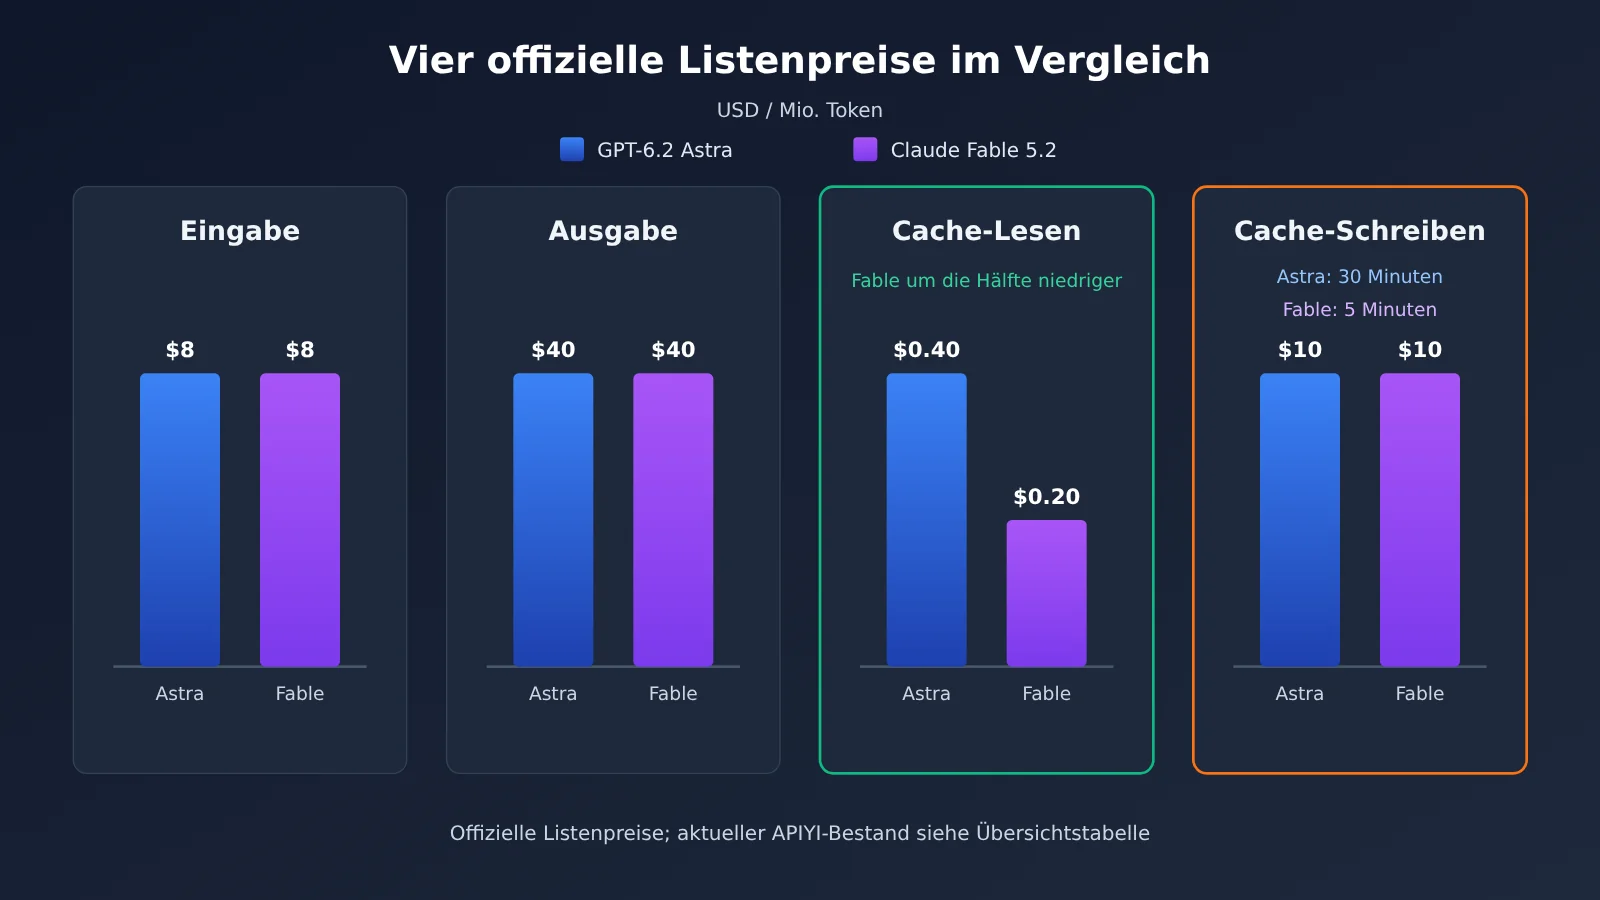
🎯 Hinweis zu den Daten: Die obige Grafik zeigt ausschließlich die offiziellen Listenpreise der beiden Anbieter. Welche Modelle und Preise auf der Plattform tatsächlich verfügbar sind, richtet sich nach der Modellliste von APIYI apiyi.com; Astra 6.2 ist dort derzeit nicht enthalten.
Szenarioempfehlungen für GPT-6.2 Astra und Claude Fable 5.2
Die folgende Zuordnung der Szenarien orientiert sich daran, „was der jeweilige Ranglisteneintrag aussagt“, und trifft keine Aussage darüber, welches Modell insgesamt stärker ist.
Szenarien, in denen vorrangig GPT-6.2 Astra zu prüfen ist
- Lang laufende professionelle Workflows: In der offiziell selbst angegebenen Agents’ Last Exam liegt Astra vorn; dabei ist die Fußnote zu berücksichtigen, dass Fable neun Aufgaben nicht abdeckt.
- Aufgaben mit juristischen Dokumenten: Die offiziell selbst angegebene Bestehensquote bei Harvey LAB-AA v1.1 liegt mehr als doppelt so hoch wie bei Fable – ein sinnvoller Schwerpunkt für Tests.
- Präferenz-Benchmarks rund um 3D-Generierung: Das offiziell zitierte AA-3D-Blindtest-Elo liegt bei 1318 gegenüber 1271.
- Kostenempfindlichkeit pro Aufgabe im Gesamtindex: Auf der Drittanbieter-Seite werden für Astra (Max) 4,00 US-Dollar angegeben, was jedoch nur für den Aufgabensatz des Gesamtindex gilt.
Szenarien, in denen vorrangig Claude Fable 5.2 zu prüfen ist
- Allgemeine Anwendungen, die eine solide Allround-Absicherung brauchen: Im Gesamtindex des Drittanbieters erreicht Fable 5.2 einen Wert von 65 und belegt damit Platz eins der Rangliste.
- Anwendungen mit hohem Cache-Read-Anteil: Der Listenpreis für Cache-Reads liegt bei 0,20 US-Dollar und damit bei der Hälfte von Astra.
- Sofortiger Einstieg nötig:
claude-fable-5-2undclaude-fable-5-2-thinkingstehen bereits in der Gesamtliste von APIYI.
| Worauf du achtest | Welche Ebene zuerst prüfen | Richtung dieser Ebene | Zusätzlicher Hinweis |
|---|---|---|---|
| Durchschnittliche Fähigkeiten | Gesamt-Rangliste von Drittanbietern | Fable 5.2 höher | Auf die Reasoning-Stufe achten |
| Professionelle Workflows / Recht | Offiziell selbst angegebene Einzelwerte | Astra führt | Selbst angegebene Daten – Fußnoten beachten |
| Cache-Kosten bei langen Dialogen | Offizieller Listenpreis | Fable mit niedrigeren Cache-Reads | Unterschiedliche Aufbewahrungsdauer für Cache-Schreibvorgänge |
| Aktuelle Verfügbarkeit | Gesamtliste von APIYI | Nur Fable gelistet | Astra 6.2 steht noch aus |
GPT-6.2 Astra und Claude Fable 5.2 im Schnelleinstieg: die Entscheidung in drei Schritten
Schritt 1: Zuerst das Ranking anschauen, das für Ihren Fall zählt
Klären Sie zuerst, zu welcher Kategorie von Aufgaben Ihr Anwendungsfall gehört. Geht es um einen Allzweck-Assistenten oder gemischte Aufgaben, orientieren Sie sich am Gesamtindex von Artificial Analysis – und notieren Sie, welche Reasoning-Stufe Sie einsetzen wollen. Bei lang laufenden Agents, Recht oder 3D orientieren Sie sich an der entsprechenden Einzeldisziplin, die OpenAI selbst ausweist, und lesen Sie die Fußnoten mit. Addieren Sie nicht die Punktedifferenzen aus dem Gesamtranking und aus den Einzelrankings zu einer „Gesamtpunktzahl“.
Schritt 2: Dann die Cache-Reads
Schätzen Sie ab, welcher Anteil einer Anfrage aus einem wiederholten Präfix besteht – etwa System-Prompts, Ausschnitte aus der Wissensdatenbank oder mehrstufiger Gesprächsverlauf. Je höher der Anteil an Cache-Reads, desto deutlicher wird der Unterschied zwischen 0.20 und 0.40. Wenn eine einzelne Eingabe regelmäßig über 272K liegt, müssen Sie außerdem die Astra-Regel für Zuschläge auf die gesamte Bestellung mitrechnen.
Schritt 3: Und dann prüfen, welches Modell APIYI gerade aufrufen kann
Derzeit lässt sich laut der APIYI-Übersichtstabelle Fable 5.2 aufrufen, Modell-ID claude-fable-5-2; brauchen Sie die Version mit explizitem Reasoning, nehmen Sie claude-fable-5-2-thinking. Der Listenpreis liegt bei 8 für Input, 40 für Output und 0.2 für Cache-Read, die Endpunkte unterstützen chat und messages. Die Beschreibungsseite zu diesem Modell liefert derzeit einen 404, maßgeblich ist der Preis in der Übersichtstabelle.
Wenn Sie die OpenAI-kompatible Anbindung nutzen, setzen Sie im SDK base_url auf https://api.apiyi.com/v1 und model auf claude-fable-5-2; die übrigen Parameter bleiben wie beim gewohnten Chat-Completions-Aufruf. Beachten Sie: Das Reasoning bei Fable 5.2 ist immer aktiv und lässt sich nicht abschalten, der Standard-effort ist high. Falls Sie später auf Astra wechseln: Dessen API akzeptiert nicht, dass reasoning effort auf none gesetzt wird.
🚀 Schnellstart: Testen Sie
claude-fable-5-2am besten zuerst bei APIYI auf apiyi.com mit dem kostenlosen Testkontingent und Ihren eigenen Beispieldaten und notieren Sie Ausgabequalität und Cache-Trefferquote. Sobaldgpt-6.2-astraverfügbar ist, testen Sie es mit denselben Beispieldaten erneut – so ist der Vergleich fairer.
Häufige Fragen (FAQ)
Q1: Was sind GPT-6.2 Astra und Claude Fable 5.2 jeweils?
GPT-6.2 Astra ist das Flaggschiffmodell, das OpenAI am 17.11.2026 veröffentlicht hat; die Modell-ID lautet `gpt-6.2-astra`. Zum selben Termin erschien das günstigere GPT-6.2 Sol. Claude Fable 5.2 stammt von Anthropic, das Dokumentationsdatum ist der 09.11.2026. Beide unterstützen ein Kontextfenster von rund 1M sowie eine maximale Ausgabe von 128K.
Q2: Wer ist nun stärker – GPT-6.2 Astra oder Claude Fable 5.2?
Die vorliegenden Daten erlauben keine eindeutige Antwort. Im aggregierten Index von Drittanbietern liegt Fable 5.2 mit 65 Punkten vor Astra (Max) mit 62 Punkten. In den offiziell selbst gemeldeten Werten zu ALE, Harvey und in der offiziell wiedergegebenen AA-3D-Blindbewertung liegt Astra vorn. Man sollte je nach Aufgabentyp die jeweils passende Datenschicht heranziehen.
Q3: Lassen sich die „5 % Kosten“ aus ALE und die Pro-Aufgabe-Kosten von Artificial Analysis gegenseitig bestätigen?
Nein. Die „rund 5 %“ sind die Selbsteinschätzung, die OpenAI für das Agents’ Last Exam angegeben hat. Die 4,00 US-Dollar und 26,54 US-Dollar sind die Kosten, die Artificial Analysis bei den Aufgaben des aggregierten Index gemessen hat. Aufgaben und Bezugsgrößen sind unterschiedlich – man kann sie weder durcheinander teilen noch gegenseitig zur Validierung heranziehen.
Q4: Sind die Daten zu GPT-6.2 Sol von Drittanbietern?
Nein. Sol ist OpenAIs eigenes Modell, die Zahlen dazu im Release-Text sind offizielle Selbstauskünfte. Artificial Analysis hat Sol zusätzlich separat getestet und kommt in der Max-Stufe auf 57 Punkte – nur dieser Teil sind Drittanbieterdaten. Der offizielle Listenpreis von Sol liegt bei 2 für den Input, 0,10 für das Lesen aus dem Cache und 10 für den Output. Das Modell ist derzeit noch nicht in der Plattform verfügbar; wir stellen es so schnell wie möglich bereit. Modellbezeichnung und Preise richten sich nach der Modellliste der Plattform.
Q5: Wie rufe ich Claude Fable 5.2 jetzt über die API auf?
Registriere dich bei APIYI apiyi.com und hole dir einen API-Schlüssel. Im OpenAI-kompatiblen SDK setzt du die Base-URL auf `https://api.apiyi.com/v1` und trägst als Modell `claude-fable-5-2` ein. Wenn du das native Anthropic-Protokoll verwendest, kannst du den Messages-Endpunkt nutzen.
Q6: Welche bekannten Einschränkungen hat GPT-6.2 Astra?
Laut offizieller Angabe erreicht Astra im Preparedness Framework die Stufe „kritisch“ im Bereich Cybersicherheit. Die Schutzmaßnahmen fallen strenger aus, und ein Teil legitimer Anfragen aus der Schwachstellenforschung wird abgelehnt. In den Alignment-Evaluierungen übersieht es bei zwei Tests eher Probleme, die im Weg stehen – etwa fehlende Dateien oder nicht verfügbare Suchwerkzeuge. Die Halluzinationsrate von Drittanbietern bei AA-Omniscience (Max) liegt bei 59 %. Außerdem unterstützt es keine Audio- und Videoeingaben, kein Realtime und kein Fine-Tuning.
Q7: Ändern sich die Listenpreise nach Dezember?
In den Referenzquellen dieses Artikels ist für beide Modelle keine Preisanpassung zum Dezember angekündigt. Was sich ändert, ist der Ultrafast-Multiplikator von Astra: Ab dem 01.03.2027 steigt er von 3x auf 6x. Die tatsächliche Abrechnung auf der Plattform richtet sich nach der Modellliste von APIYI apiyi.com.
GPT-6.2 Astra und Claude Fable 5.2: Die wichtigsten Erkenntnisse
- Bei Gesamtrankings auf Drittanbieter schauen: Im AA Intelligence Index v5.0.1 erreicht Fable 5.2 einen Wert von 65, Astra (Max) kommt auf 62.
- Bei Einzelwerten zählen die offiziellen Eigenangaben: Bei ALE, Harvey und dem offiziell wiedergegebenen AA-3D liegt Astra vorn – aber die Fußnoten sind entscheidend.
- Zwei Kostensätze lassen sich nicht einfach vermischen: Die rund 5 % bei ALE und die AA-Kosten pro Aufgabe beziehen sich auf unterschiedliche Aufgaben und unterschiedliche Messmethoden.
- Gleicher Preis für Input und Output: Beide Modelle mit kurzem Kontext kosten 8 / 40 US-Dollar, das Cache-Lesen liegt bei 0,40 bzw. 0,20.
- Astra hat bei langem Kontext Staffelpreise: Übersteigt eine einzelne Eingabe 272K, wird die gesamte Anfrage zum höheren Preis abgerechnet.
- Unterschiedlicher Integrationsstatus: Fable 5.2 ist bereits in der Übersichtstabelle von APIYI apiyi.com enthalten, Astra 6.2 steht noch aus.
Fazit
Beim Vergleich von GPT-6.2 Astra und Claude Fable 5.2 kommt es vor allem darauf an, die Quellen der Zahlen sauber auseinanderzuhalten:
- Drittanbieter-Gesamtranking: Fable 5.2 liegt höher. Beim Zitieren unbedingt die Reasoning-Stufe angeben.
- Offizielle Einzelangaben: Astra führt bei einigen Fachaufgaben, und die offiziell genannten Kosten pro Aufgabe sind niedriger – aber das sind Eigenangaben.
- Offizielle Listenpreise: Input und Output kosten gleich viel, beim Cache-Lesen ist Fable halb so teuer, und auch die Regeln für langen Kontext unterscheiden sich.
Keines der beiden Modelle gewinnt in allen Dimensionen. Am zuverlässigsten ist es, zuerst den eigenen Aufgabentyp festzulegen, dann die Cache-Kosten zu prüfen und schließlich mit echten Testdaten zu arbeiten. Aktuell lässt sich Fable 5.2 bereits über APIYI apiyi.com aufrufen; sobald Astra 6.2 verfügbar ist, kann man es mit derselben Stichprobe nachtesten. Wir werden dieses Modell so schnell wie möglich aufnehmen.
📚 Referenzen
-
OpenAI-Ankündigung: Versionshinweise und offizielle, selbst gemeldete Benchmarks zu GPT-6.2 Astra und Sol
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol - Hinweis: Einzeldaten zu ALE, Harvey, AA-3D und weiteren sowie die zugehörigen Fußnotenquellen
- Link:
-
OpenAI-Modellseite: Spezifikationen und Listenpreise von GPT-6.2 Astra
- Link:
platform.openai.com/docs/models/gpt-6.2-astra - Hinweis: Cache-Schreibpreis und die 272K-Abrechnungsregel richten sich nach dieser Quelle
- Link:
-
Artificial-Analysis-Artikel: Bewertung von GPT-6.2 Astra und Sol durch Dritte
- Link:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Hinweis: Punktzahlen je Reasoning-Stufe im Intelligence Index v5.0.1
- Link:
-
Artificial-Analysis-Modellseite: Claude Fable 5.2
- Link:
artificialanalysis.ai/models/claude-fable-5-2 - Hinweis: Gesamtwertung und Kosten pro Aufgabe im Gesamtindex
- Link:
-
Anthropic-Dokumentation: Überblick zu Claude Fable 5.2
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview - Hinweis: Listenpreise, Cache-Lesen und -Schreiben, effort- und Thinking-Einstellungen
- Link:
Autor: APIYI-Technikteam
Technischer Austausch: Sie erreichen uns gerne über die Startseite der APIYI-Website. Bei Modellbezeichnungen und Preisen ist die Modellliste der Plattform maßgeblich.