Autorenhinweis: Dieser Artikel vergleicht Gemini 4 Carbon und Claude Opus 5.5 in sieben Dimensionen: Spezifikationen, Preis, Denkmechanismus, Protokoll und die Werte aus den offiziellen Modellkarten. Am Ende steht eine Empfehlung, welche Art von Aufgabe zu welchem Modell passt.
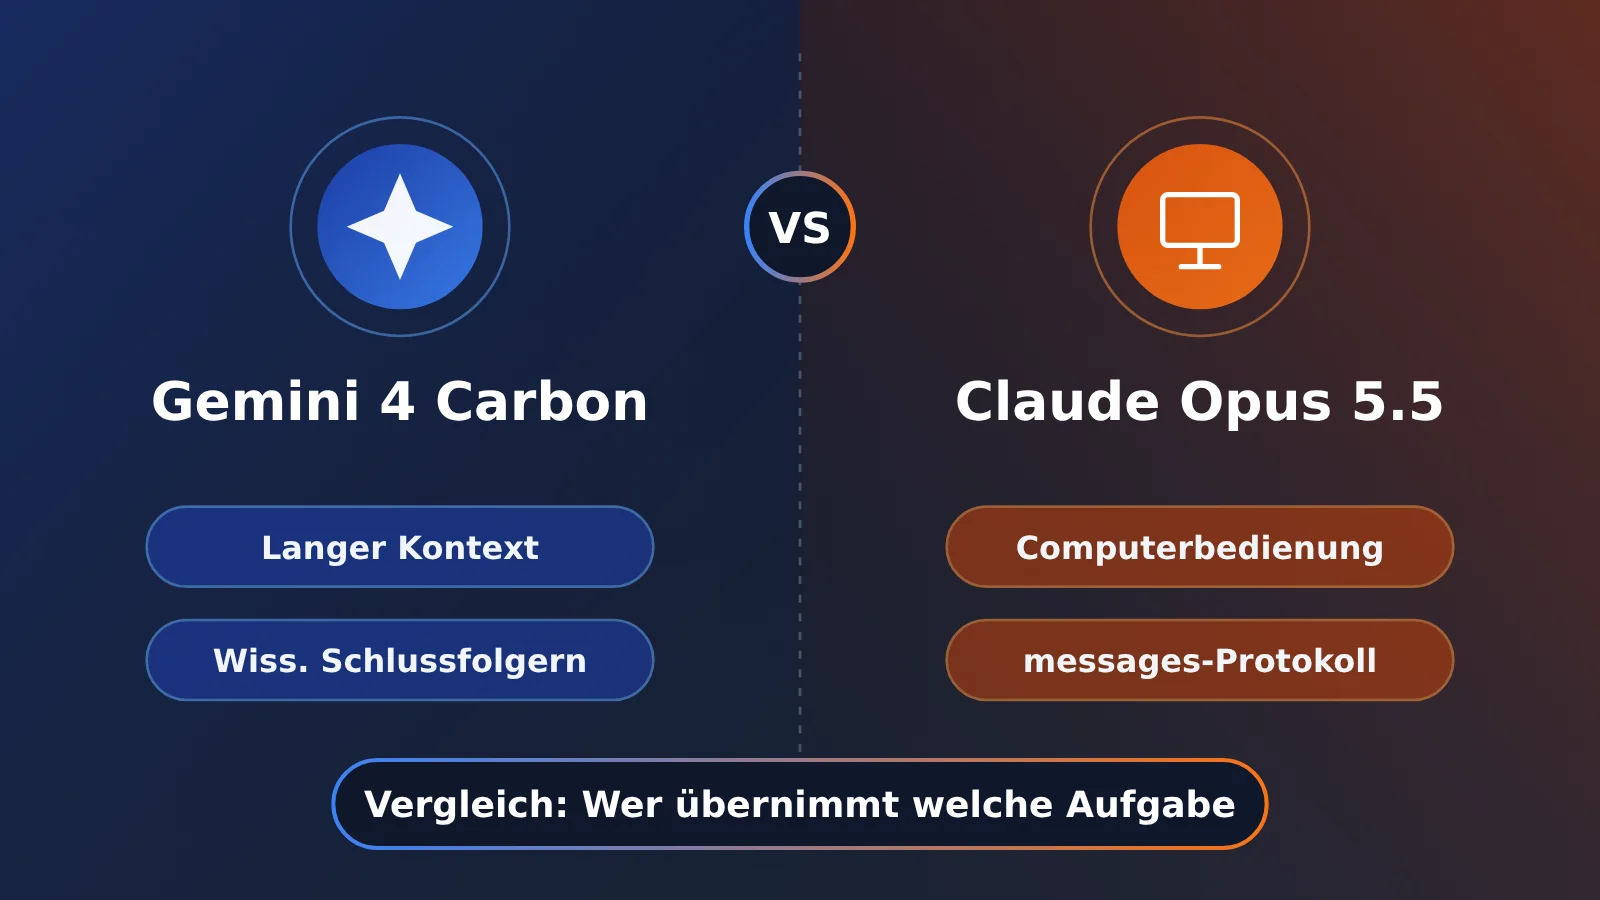
Vorab das Ergebnis: Langkontext-Retrieval, wissenschaftliches Schlussfolgern und langfristige, mehrstufige Engineering-Aufgaben übergeben Sie am besten an Gemini 4 Carbon. Computersteuerung, Desktop-Automatisierung und Workflows, die bereits am Anthropic-messages-Protokoll hängen, gehören zu Claude Opus 5.5. Ein Modell, das insgesamt überlegen ist, gibt es nicht. Es kommt darauf an, welche Aufgabe zu welchem Modell passt.
Das ist keine Analyse nach dem Muster „beide haben ihre Stärken“. Alle Werte in diesem Artikel stammen aus den offiziellen Modellkarten und der Herstellerdokumentation und sind als offizielle Eigenangaben gekennzeichnet. Beim Preis nennen wir sowohl den offiziellen Listenpreis als auch den APIYI-Listenpreis vom 11.11.2026, damit Sie beides direkt vergleichen können.
Kernnutzen: Nach der Lektüre dieses Vergleichs von Gemini 4 Carbon und Claude Opus 5.5 haben Sie eine Tabelle, die Sie direkt für Ihre Modellauswahl nutzen können. Außerdem verstehen Sie, warum Carbon zwar den niedrigeren Einzelpreis hat, Ihre Rechnung aber nicht unbedingt niedriger ausfällt.
Gemini 4 Carbon vs. Claude Opus 5.5: die wichtigsten Unterschiede
Beide Modelle sind Flaggschiffe aus der zweiten Jahreshälfte 2026. Claude Opus 5.5 hat Anthropic am 22.09.2026 veröffentlicht. Gemini 4 Carbon wurde am 28.10.2026 erstmals vorgestellt und stand zunächst nur Cybersecurity-Verteidigern offen, die über das Fairwind Program verifiziert waren. Erst am 10.11.2026 folgte die allgemeine Verfügbarkeit (GA) für zahlungspflichtige Entwickler und Unternehmen.
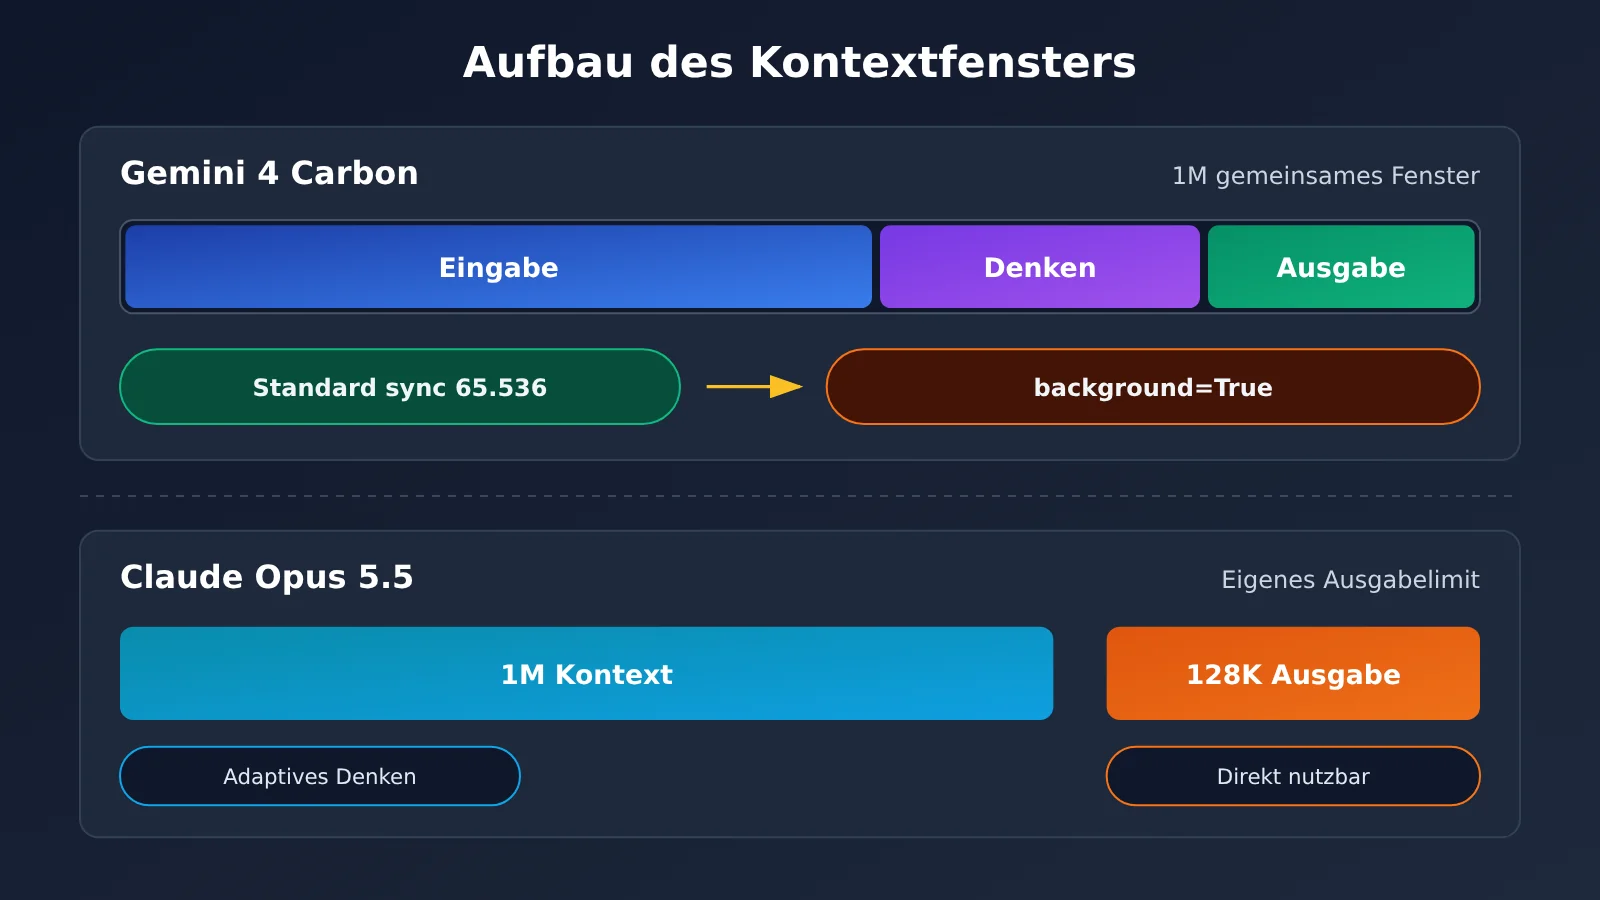
Google positioniert Carbon klar: Das Modell baut auf Gemini 4 Argon auf und ist für Aufgaben gedacht, die an die Grenze der Denkleistung gehen, etwa komplexes mehrstufiges Coding und Debugging oder offene wissenschaftliche Forschung. Es verbraucht mehr Thinking-Tokens als Argon, prüft Hypothesen eine nach der anderen durch und fährt längere Verifikationsschleifen. Opus 5.5 punktet dagegen mit adaptivem Denken, 128K Ausgabelänge und der Fähigkeit zur Computerbedienung. Beide Modelle sind inzwischen bei APIYI (apiyi.com) verfügbar, und Sie können mit demselben API-Schlüssel zwischen ihnen wechseln.
Gemini 4 Carbon und Claude Opus 5.5 im Spezifikationsvergleich
| Vergleichspunkt | Gemini 4 Carbon | Claude Opus 5.5 |
|---|---|---|
| Modell-ID | gemini-4-carbon |
claude-opus-5-5 |
| Veröffentlichung | Vorgestellt am 28.10.2026, GA am 10.11.2026 | 22.09.2026 |
| Kontext | 1M, Eingabe, Denken und Ausgabe teilen sich ein Fenster | 1M |
| Ausgabelimit | Synchron standardmäßig 65.536; im Hintergrundmodus erweiterbar, geteilt mit der Eingabe im 1M-Fenster | 128K |
| Denkschalter | thinking_level: low / medium / high, Standard ist medium |
Adaptives Denken, nicht abschaltbar, Standard-Effort ist medium |
| Wissensstand | March 2026 (in einzelnen Bereichen eventuell früher) | Verlässlicher Wissensstand June 2026 |
| Eingabemodalitäten | Text, Bild, Audio, Video | Siehe offizielle Dokumentation |
| Ausgabemodalitäten | Text (keine Bild- und keine Videoerzeugung) | Text |
In dieser Tabelle stecken zwei typische Stolperfallen. Die erste ist das Ausgabelimit: Das 1M-Fenster von Carbon wird gemeinsam genutzt, und synchrone Anfragen liefern standardmäßig höchstens 65.536 Tokens. Brauchen Sie längere Ausgaben, müssen Sie in der Interactions API background=True setzen und max_output_tokens auf mehr als 65536 hochstellen. Dabei sollten Sie Reserven für das Denken einplanen, sonst wird die Antwort möglicherweise abgeschnitten. Die 128K von Opus 5.5 sind dagegen direkt als Obergrenze nutzbar.
Die zweite Stolperfalle ist der Denkmechanismus. Bei Carbon lassen sich drei Stufen je nach Aufgabe wählen: low passt zu Klassifikation, Routing und gezielter Extraktion. medium ist der Standard und balanciert Geschwindigkeit, Kosten und die Chance auf eine auf Anhieb richtige Lösung aus. high eignet sich für Ursachenanalysen über mehrere Dateien, formale Mathematik und frühe Architekturentwürfe. Das adaptive Denken von Opus 5.5 lässt sich nicht abschalten, Sie können nur den Effort anpassen. Wenn Ihr Anwendungsfall einen Modus „komplett ohne Denken“ mit niedriger Latenz braucht, ist keines dieser beiden Flaggschiffe die beste Wahl.
Gemini 4 Carbon vs. Claude Opus 5.5: Preise und Abrechnung
Beim reinen Stückpreis ist Carbon deutlich günstiger. Allerdings ist der niedrige Preis im offiziellen Kanal ein Aktionspreis, und Carbon verbraucht außerdem mehr „Denk-Tokens“. Der Unterschied beim Stückpreis lässt sich deshalb nicht einfach 1:1 auf die Rechnung übertragen.
Offizielle Preise im Vergleich zu den APIYI-Listenpreisen
Alle Angaben in US-Dollar pro 1 Mio. Tokens. Die APIYI-Listenpreise entsprechen dem Preis der Standardgruppe (default) am 11.11.2026, also nicht dem rabattierten Preis.
| Preisposition | Carbon offiziell (bis 30.11., global) | Carbon offiziell (ab 01.12., global) | Opus 5.5 offiziell | APIYI gemini-4-carbon |
APIYI claude-opus-5-5 |
|---|---|---|---|---|---|
| Eingabe | 2 | 4,00 | 4 | 2 | 4 |
| Ausgabe (inkl. Reasoning) | 10 | 20,00 | 20 | 10 | 20 |
| Cache lesen | 0,10 | 0,20 | 0,20 | 0,10 | 0,20 |
| Cache schreiben | Impliziter Cache, keine separate Abrechnung | wie links | 5 Minuten: 5 / 1 Stunde: 8 | kein separater Faktor für Cache-Schreibvorgänge | entspricht 5 (Faktor 1,25) |
| Verfügbare Gruppen | — | — | — | default, svip | ClaudeCode, ClaudeCodeReverse, ClaudeOfficial, default, svip |
Noch ein paar Details zu den offiziellen Preisen: Für Carbon-Endpunkte außerhalb der globalen Region gilt im Aktionszeitraum 2,20 / 0,11 / 11. Gemini 4 Carbon Cyber Permissive ist von der Aktion ausgenommen und wird direkt mit 4 / 0,20 / 20 abgerechnet. Der Fast-Modus von Opus 5.5 kostet 8 für die Eingabe und 40 für die Ausgabe; bei Inferenz ausschließlich in den USA kommt zusätzlich der Faktor 1,1 dazu.
Die Faktoren der einzelnen APIYI-Gruppen kommen noch obendrauf: Bei Opus liegt die Gruppe ClaudeCode bei 0,95, ClaudeCodeReverse bei 0,5 und ClaudeOfficial bei 1,2; default und svip haben den Faktor 1. Carbon gibt es nur in den beiden Gruppen default und svip, beide mit dem Faktor 1. Aufladungen laufen mit einem festen Wechselkurs von 1:7 und lassen sich mit Aufladebonus und Gruppenrabatten kombinieren. Maßgeblich für die tatsächliche Abbuchung ist die Konsole. Modelle und Preise richten sich nach der Modellliste auf apiyi.com. Falls die Gesamttabelle in der Dokumentation die Carbon-Zeile noch nicht anzeigt, gelten die Angaben in der Konsole und der Preis-Schnittstelle.
Warum ein niedrigerer Stückpreis nicht automatisch eine niedrigere Rechnung bedeutet
Die Kosten einer Anfrage ergeben sich ungefähr so: Eingabe-Tokens × Eingabepreis + (Denk-Tokens + Antwort-Tokens) × Ausgabepreis. Carbon verlangt für die Ausgabe nur halb so viel wie Opus. Google sagt allerdings ausdrücklich, dass Carbon mehr Denk-Tokens als Argon verbraucht, weil es Verifizierungsschleifen durchläuft. Rechnet man denselben Task durch, gilt: Sobald die Gesamtmenge aus „Denken + Antwort“ bei Carbon mehr als doppelt so hoch ausfällt wie bei Opus, liegt Carbon allein beim Ausgabeanteil vorne – und zwar bei den Kosten.
Über die offiziellen Kanäle sind die Stückpreise von Carbon und Opus ab dem 1. Dezember identisch. Dann hat die niedrigere Rechnung, wer weniger Tokens verbraucht. Auch Anthropic hat ein eigenes Spar-Argument: Laut Eigenangabe liegt die Token-Rechnung von Opus 5.5 für dieselbe Arbeit rund 40 % unter der von Opus 5. Das ist eine Herstellerangabe und kein direkter Vergleichstest der beiden Modelle. Am sichersten gehen Sie, wenn Sie mit Ihren eigenen, realen Aufgaben jeweils eine Reihe von Durchläufen starten und in der Konsole nachsehen, was tatsächlich abgebucht wird.
Auch beim Caching unterscheiden sich die beiden Modelle. Carbon aktiviert implizites Caching standardmäßig, gecachte Eingaben erhalten 95 % Rabatt. Im Entwicklerleitfaden steht ausdrücklich, dass man kein explizites cached_content mehr anlegen oder übergeben soll. Bei Opus muss der Cache erst beschrieben werden: Das Schreiben mit 5 Minuten Laufzeit kostet 5 US-Dollar und lohnt sich vor allem bei wiederholten Aufrufen mit einem festen, langen System-Prompt.
Gemini 4 Carbon im Vergleich zu Claude Opus 5.5: Werte aus der offiziellen Modellkarte
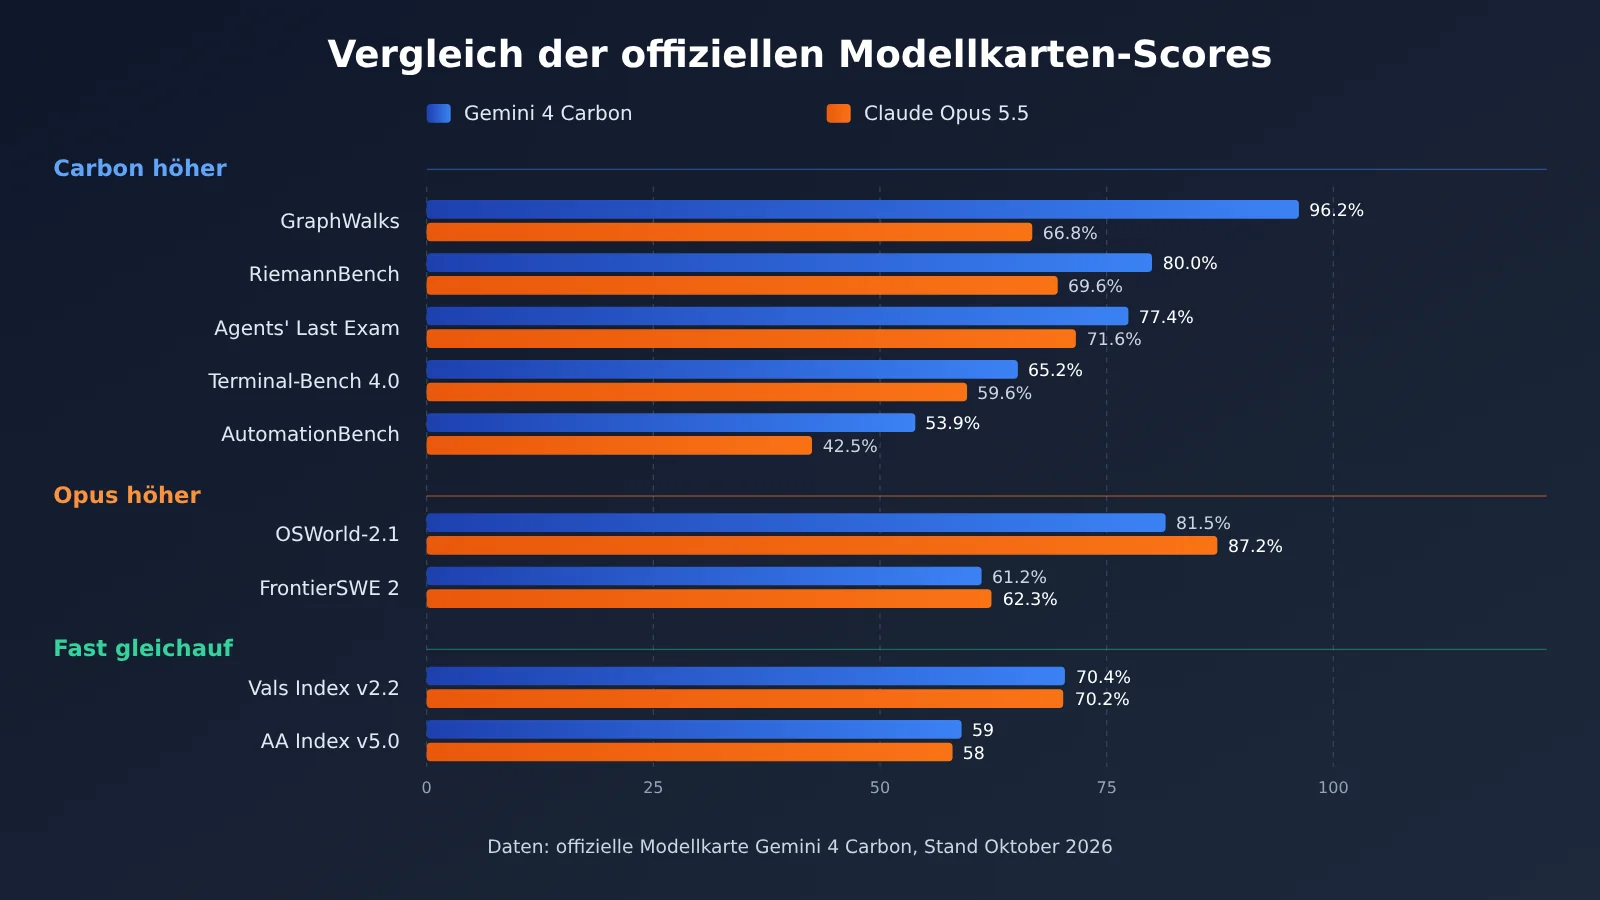
Alle Daten in der folgenden Tabelle stammen aus der offiziellen Modellkarte von Google zu Gemini 4 Carbon (Stand: Oktober 2026) und sind Herstellerangaben. Auch die Zahlen für Opus 5.5 sind dieser Modellkarte entnommen. Es handelt sich also nicht um unabhängige Tests von Anthropic.
| Benchmark (offizielle Modellkarte) | Gemini 4 Carbon | Claude Opus 5.5 | Fazit |
|---|---|---|---|
| OSWorld-2.1 Offline-Teilmenge (Computerbedienung) | 81,5 % | 87,2 % | Opus höher, zugleich der Höchstwert in der Tabelle |
| FrontierSWE 2 | 61,2 % | 62,3 % | Opus leicht vorn; beide liegen unter den 65,5 % von GPT-6 Astra |
| Vals Index v2.2 | 70,4 % | 70,2 % | Nahezu gleichauf |
| AA Index v5.0 | 59 | 58 | Nahezu gleichauf |
| SWE-sweep | 9,6 % | 3,6 % | Carbon höher |
| Terminal-Bench 4.0 (AA) | 65,2 % | 59,6 % | Carbon höher |
| Agents‘ Last Exam v1.1 | 77,4 % | 71,6 % | Carbon höher |
| AutomationBench (Zapier) | 53,9 % | 42,5 % | Carbon höher |
| GraphWalks 256k–1M BFS (F1) | 96,2 % | 66,8 % | Carbon deutlich höher (langer Kontext) |
| RiemannBench | 80,0 % | 69,6 % | Carbon höher (wissenschaftliches Schlussfolgern) |
| Terminal-Bench-Science 0.1 (AA) | 64,8 % | 59,0 % | Carbon höher |
| Chartography | 72,5 % | 66,3 % | Carbon höher |
Die Tabelle zeigt drei Dinge. Erstens: Bei langem Kontext und wissenschaftlichem Schlussfolgern setzt sich Carbon am stärksten ab, bei GraphWalks beträgt der Abstand fast 30 Prozentpunkte. Wenn Ihre Aufgabe darin besteht, in Material mit mehreren Hunderttausend Token mehrstufig zu recherchieren, ist dieser Wert für Sie am aussagekräftigsten.
Zweitens: Computerbedienung ist das Heimspiel von Opus 5.5. In der OSWorld-2.1-Offline-Teilmenge liegt Opus rund 6 Prozentpunkte vor Carbon. Für Desktop-Agenten, Browsersteuerung oder GUI-Automatisierung ist Carbon hier nicht die erste Wahl.
Drittens: Bei Softwareentwicklungsaufgaben in öffentlichen Repositories liegt keines der beiden Modelle vorn. Bei FrontierSWE 2 steht GPT-6 Astra an der Spitze, Opus ist Zweiter und Carbon Dritter, die Abstände sind allerdings klein. Bei SWE-sweep liegt Carbon mit 9,6 % vor Opus mit 3,6 %. Der absolute Wert ist aber sehr niedrig und praktisch gleichauf mit den 9,5 % von Astra. Als Vorsprung um eine Größenordnung sollte man das nicht deuten.
Die Modellkarte enthält außerdem drei Cybersicherheits-Ergebnisse (CWE-bench, ExploitGym, SEC-bench Pro). Sie entstanden jedoch im Rahmen des Fairwind Program, und laut der Veröffentlichung vom 28. Oktober wurde dabei ohne Schutzmechanismen getestet. Über die kostenpflichtige API ist diese Leistung standardmäßig nicht verfügbar. Diese drei Werte taugen deshalb nicht als Entscheidungsgrundlage für die Modellwahl im Programmieralltag.
Gemini 4 Carbon und Claude Opus 5.5: Wann passt welches Modell?
Wann Gemini 4 Carbon die richtige Wahl ist
- Recherche und Synthese bei sehr langen Materialien: Für Multi-Hop-Fragen über Regelwerke, komplette Code-Repositories oder umfangreiche Forschungsunterlagen kannst du das gemeinsame 1M-Fenster und die Stärken bei GraphWalks voll ausspielen.
- Wissenschaftliches Schlussfolgern und formale Mathematik: Bei RiemannBench und Terminal-Bench-Science liegt Carbon vorn. Setze
thinking_levelauf high, damit das Modell seine Ergebnisse gründlich überprüft. - Langfristige, mehrstufige Engineering-Aufgaben und Architektur-Audits: Google empfiehlt, in Antigravity unter /swarm Carbon die Rollen zu übertragen, die das tiefste Schlussfolgern erfordern, also Architektur, Koordination und Audit. Die parallel umgesetzten Teilaufgaben gehen dann an
gemini-4-argonodergemini-3.8-flash. - Multimodale Dokumente: Als Eingabe werden Text, Bilder, Audio und Video unterstützt. Carbon erzielt bei Chartography höhere Werte und eignet sich daher gut für die Auswertung diagrammlastiger Berichte.
Wann Claude Opus 5.5 die richtige Wahl ist
- Computerbedienung und Desktop-Agenten: In der OSWorld-2.1-Tabelle erzielt Opus 5.5 den höchsten Wert, daher ist es die erste Wahl für GUI-Automatisierung.
- Bestehende Workflows mit Claude Code bzw. dem messages-Protokoll: Du musst am Protokoll nichts ändern, es genügt, die Modell-ID auszutauschen.
- Sehr lange Ausgaben in einem Durchgang: Das Limit von 128K Ausgabe-Tokens kannst du direkt nutzen. Anders als bei Carbon musst du dafür nicht in den Hintergrundmodus wechseln.
- Aktuelleres Wissen: Der verlässliche Wissensstand reicht bis June 2026 und liegt damit drei Monate nach dem von Carbon (March 2026).
Wenn keines der beiden Modelle optimal ist
Für die alltägliche Funktionsentwicklung und interaktives Coding empfiehlt Google weiterhin Gemini 4 Argon. Es kostet pro Token genauso viel wie Carbon, verbraucht aber weniger Tokens und reagiert in der Interaktion schneller. Wenn du bereits die Responses API nutzt und ein Kontextfenster von 1.05M sowie die Reasoning-Stufe max brauchst, kommt GPT-6 Astra infrage. Allerdings liegt der Listenpreis rund fünfmal so hoch wie der Aktionspreis von Carbon (10/50 gegenüber 2/10), und oberhalb von 272K Eingabe-Tokens kommt zusätzlich ein gestaffelter Aufpreis hinzu.
Gemini 4 Carbon vs. Claude Opus 5.5: So binden Sie die Modelle an
Unterschiede im Protokoll verursachen oft mehr Aufwand als Unterschiede bei den Benchmark-Werten. Opus 5.5 läuft nativ über das Anthropic-Messages-Protokoll. Carbon nutzt dagegen das native Gemini-Protokoll oder die OpenAI-kompatiblen Chat Completions – nicht aber Anthropic Messages.
| Anbindung | Gemini 4 Carbon | Claude Opus 5.5 |
|---|---|---|
| Natives Protokoll | Gemini nativ (/v1beta) | Anthropic Messages |
| APIYI-Endpunkt | gemini, openai (/v1/chat/completions) | anthropic (messages), openai (chat) |
| Denkparameter | thinking_level; thinking_budget ist veraltet |
effort, Denken lässt sich nicht abschalten |
| Sampling-Parameter | Eigene Werte für temperature, top_p und top_k werden ignoriert und lösen eine Warnung aus | Einstellung gemäß Anthropic-Dokumentation |
| Timeout-Empfehlung | Schwierige Aufgaben können mehrere Minuten dauern. Setzen Sie den Client-Timeout auf mindestens 15–20 Minuten oder nutzen Sie background=True |
Wie bei üblichen langlaufenden Aufgaben |
Schnell wechseln über die OpenAI-kompatible Schnittstelle
Wenn Sie beide Modelle mit demselben Code testen möchten, geht das am einfachsten über die OpenAI-kompatible Schnittstelle. So gehen Sie vor:
- Erstellen Sie in der Konsole einen API-Schlüssel und wählen Sie als Gruppe default oder svip (beide Gruppen decken beide Modelle ab).
- Setzen Sie im OpenAI-SDK
base_urlaufhttps://api.apiyi.com/v1und tragen Sie beiapi_keyIhren Schlüssel ein. - Setzen Sie beim Aufruf von Chat Completions
modeljeweils aufgemini-4-carbonoderclaude-opus-5-5. Die Struktur von messages bleibt unverändert. - Lassen Sie beim Test von Carbon Sampling-Parameter wie temperature weg und erhöhen Sie den Client-Timeout auf mehr als 15 Minuten.
- Vergleichen Sie in der Konsole den Token-Verbrauch und die tatsächlich abgerechneten Kosten beider Modelle, statt nur auf den Einzelpreis zu schauen.
Wenn Ihr Projekt bereits Claude Code oder das Anthropic-SDK verwendet, können Sie Opus 5.5 einfach weiter über den messages-Endpunkt ansprechen. Falls Sie eine spezielle Gruppe für Claude Code brauchen, wählen Sie ClaudeCode oder ClaudeOfficial.
🚀 Tipp für den schnellen Einstieg: Nutzen Sie zunächst die OpenAI-kompatible Schnittstelle von APIYI (apiyi.com) und schicken Sie dieselben realen Aufgaben an beide Modelle. Vergleichen Sie dann Ausgabequalität und Abrechnung in der Konsole. Sobald die Aufgabenverteilung feststeht, können Sie entscheiden, ob Opus wieder auf das native Messages-Protokoll zurückwechselt.
Entscheidungshilfe: Gemini 4 Carbon oder Claude Opus 5.5?
Hier die bisherigen Inhalte als Entscheidungstabelle:
| Ihre Hauptaufgabe | Empfehlung | Entscheidende Grundlage |
|---|---|---|
| Retrieval über Long-Context im 1M-Bereich, Multi-Hop-Synthese | Gemini 4 Carbon | GraphWalks 96,2 % gegenüber 66,8 % (offizielle Model Card) |
| Wissenschaftliches Schlussfolgern, formale Mathematik | Gemini 4 Carbon | Vorn bei RiemannBench und Terminal-Bench-Science |
| Computersteuerung, Desktop-/Browser-Agenten | Claude Opus 5.5 | OSWorld-2.1: 87,2 % gegenüber 81,5 % |
| Bestehende messages- bzw. Claude-Code-Workflows | Claude Opus 5.5 | Natives Protokoll, 128K Ausgabe |
| Softwareentwicklung auf öffentlichen Repositories | Beide liegen dicht beieinander, Astra ist eine Überlegung wert | Bei FrontierSWE 2 liegt Astra vorn, Opus leicht vor Carbon |
| Alltägliche Entwicklung, interaktives Coding | Gemini 4 Argon | Gleicher Preis wie Carbon, sparsamer bei Token, schneller |
| Allgemeine Wissensarbeit | Beide geeignet, nach Kosten wählen | Vals Index 70,4 % gegenüber 70,2 %, praktisch Gleichstand |
💡 Empfehlung: Die meisten Teams müssen sich gar nicht für eines der beiden Modelle entscheiden. Sie können Anfragen nach Aufgabentyp routen: Long-Context- und Forschungsanfragen gehen an Carbon, GUI-Steuerung und messages-Workflows an Opus. Beide Modelle sind bei APIYI (apiyi.com) in den Gruppen default und svip verfügbar, sodass Sie beim Routing nur das Feld
modeländern müssen.
Noch ein wichtiger Hinweis: Spezielle Fähigkeiten für defensive Cybersicherheit laufen über das Fairwind Program. Wenn Sie den Modellnamen einfach auf gemini-4-carbon ändern, erhalten Sie damit noch nicht die Cyber-Permissive-Version. Außerdem gilt der Aktionspreis von 2 US-Dollar für Cyber Permissive über den offiziellen Kanal nicht.
Häufige Fragen (FAQ)
Q1: Gemini 4 Carbon oder Claude Opus 5.5 – welches Modell ist stärker?
Eine Seite, die in allem vorne liegt, gibt es nicht. Laut den offiziellen Modellkarten (Stand Oktober 2026) schneidet Carbon bei langem Kontext, wissenschaftlichem Schlussfolgern und Terminal-Aufgaben besser ab. Opus 5.5 liegt dagegen bei der Computerbedienung (OSWorld) und bei FrontierSWE 2 vorn. Beim Vals Index und beim AA Index liegen beide fast gleichauf.
Q2: Carbon kostet nur halb so viel wie Opus – spart man damit automatisch Geld?
Nicht unbedingt. Carbon verbraucht mehr Denk-Token, und diese werden zum Ausgabepreis abgerechnet. Außerdem gilt der Aktionspreis von 2 US-Dollar im offiziellen Kanal nur bis zum 30.11.2026. Ab dem 1. Dezember kostet Carbon genauso viel wie Opus. Maßgeblich ist am Ende die tatsächliche Abrechnung für dieselbe Aufgabe.
Q3: Ab wann sind die beiden Modelle per API nutzbar?
Opus 5.5 erschien am 22.09.2026. Carbon wurde erstmals am 28.10.2026 vorgestellt und stand zunächst nur Fairwind-Verteidigern zur Verfügung. Seit dem 10.11.2026 ist die Gemini API allgemein verfügbar (GA) – für zahlende Entwickler und Unternehmen. Wann kostenlose oder günstige Verbraucherstufen folgen, hat der Anbieter nicht angekündigt.
Q4: Kann man Carbon über das Anthropic-messages-Protokoll aufrufen?
Nein. Carbon läuft über das native Gemini-Protokoll oder über OpenAI-kompatible Chat Completions. Wenn Ihr Code auf dem Anthropic-SDK basiert, müssen Sie für Carbon auf das OpenAI-SDK oder das Gemini-SDK umsteigen. Opus 5.5 unterstützt dagegen beide Endpunkte, messages und chat.
Q5: Wie vergleiche ich beide Modelle schnell an meinem eigenen Anwendungsfall?
Registrieren Sie sich bei APIYI (apiyi.com) und erstellen Sie einen Key in der Gruppe „default“. Richten Sie das OpenAI-SDK auf den `/v1`-Endpunkt und setzen Sie `model` nacheinander auf `gemini-4-carbon` und `claude-opus-5-5`, um dieselben Aufgaben durchlaufen zu lassen. Neue Nutzer erhalten ein kostenloses Testkontingent, das für einen kleinen Vergleich ausreicht.
Q6: Warum wird die Ausgabe von Carbon abgeschnitten?
Standardmäßig liegt das Ausgabelimit synchroner Anfragen bei 65.536 Token, und die Denk-Token zählen zu diesem Budget. Für längere Ausgaben setzen Sie in der Interactions API `background=True` und erhöhen `max_output_tokens`. Planen Sie dabei genug Reserve für das Denken ein.
Q7: Welche bekannten Einschränkungen haben die beiden Modelle?
In der Modellkarte von Carbon werden unter anderem Halluzinationen genannt. Hinzu kommen eine noch zu verbessernde Widerstandsfähigkeit gegen Jailbreaks, gelegentliche Verlangsamungen oder Timeouts und ein höherer Token-Verbrauch bei hoher Denkstufe. Der Wissensstand reicht zudem nur bis März 2026. Bei Opus 5.5 lässt sich das Denken nicht abschalten, was für Szenarien mit niedriger Latenz unpraktisch ist. Bei den Benchmarks der Modellkarte zu langem Kontext und zu wissenschaftlichen Aufgaben liegt es außerdem hinter Carbon.
Gemini 4 Carbon vs. Claude Opus 5.5: Die wichtigsten Erkenntnisse
- Für langen Kontext und wissenschaftliches Schlussfolgern: Carbon. Bei Benchmarks aus den offiziellen Modellkarten wie GraphWalks und RiemannBench liegt es deutlich vorn.
- Für Computersteuerung: Opus 5.5. Im OSWorld-2.1-Offline-Subset erreicht es 87,2 %, der höchste Wert in der Tabelle.
- Beim Software Engineering liegen beide nah beieinander. Bei FrontierSWE 2 liegt Opus leicht vorn, Astra erzielt dort den Höchstwert. Bei SWE-sweep schneidet Carbon besser ab.
- Der Einzelpreis ist nicht die Rechnung. Carbon verbraucht mehr Denk-Token, und der offizielle Aktionspreis gilt nur bis zum 30. November.
- Das Protokoll bestimmt den Umstellungsaufwand. Opus nutzt die Messages-Schnittstelle, Carbon die native Gemini-Schnittstelle oder eine OpenAI-kompatible Schnittstelle.
- Ausgabe und Denkmechanismus unterscheiden sich. Opus bietet 128K Ausgabe-Token, und das Denken lässt sich nicht abschalten. Carbon gibt standardmäßig 65.536 Token aus und hat drei Stufen für
thinking_level.
Fazit
Beim Vergleich von Gemini 4 Carbon und Claude Opus 5.5 geht es weniger darum, wer gewinnt, sondern darum, wer welche Aufgaben übernimmt:
- Carbon ist für das „tiefste Denken“ zuständig: langer Kontext, wissenschaftliches Schlussfolgern, Architektur und Audits. Dafür zahlen Sie mit mehr Denk-Token.
- Opus 5.5 ist für „Anpacken und Kompatibilität“ zuständig: Computersteuerung, Messages-Workflows und große Ausgaben mit 128K.
- Bei der Rechnung zählt der tatsächliche Verbrauch: In der Aktionsphase ist Carbon beim Einzelpreis im Vorteil, aber die endgültige Abrechnung hängt von der Gesamtzahl der Token ab.
Wir empfehlen, zuerst einen kleinen Routing-Test nach Aufgabentyp durchzuführen und erst danach das Hauptmodell festzulegen. Über APIYI (apiyi.com) können Sie beide Modelle mit einem einzigen API-Schlüssel aufrufen. Die Abrechnung erfolgt nutzungsbasiert, was Vergleich und Wechsel erleichtert.
📚 Referenzen
- Google-Blog – Gemini 4 Carbon Freigabe-Ankündigung: Seit dem 10.11.2026 für zahlende Entwickler:innen verfügbar
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available -
Hinweis: Umfang der Freigabe und die im November neu hinzugekommenen, von Google selbst gemeldeten Evaluierungen
-
Offizielle Modellkarte von Gemini 4 Carbon: Benchmark-Ergebnisse mit Stand Oktober 2026
- Link:
deepmind.google/models/model-cards/gemini-4-carbon/ -
Hinweis: Quelle aller Werte in diesem Artikel, inklusive bekannter Einschränkungen
-
Gemini 4 Carbon Entwicklerhandbuch: thinking_level, 1M-Shared-Kontextfenster und Hinweise zur Migration
- Link:
aistudio.google.com/learn/gemini-4-carbon-developer-guide -
Hinweis: Background-Modus, Timeouts und Konfiguration des impliziten Cachings
-
Google Cloud Modellpreise: Carbon-Aktionspreis und Standardpreis ab dem 1. Dezember
- Link:
cloud.google.com/model-garden/pricing -
Hinweis: Preise für globale und nicht-globale Endpunkte
-
Offizielle Dokumentation zu Claude Opus 5.5: Spezifikationen, Denkmechanismus und Preise
- Link:
platform.claude.com/docs/en/models/opus-5-5/overview -
Hinweis: 128K Output, Wissensstichtag und Preise für Cache-Schreibzugriffe
-
APIYI-Modellübersicht: Modelle der Plattform und Standardpreise
- Link:
docs.apiyi.com/models -
Hinweis: Falls noch nicht aktualisiert, gilt die Anzeige in der Konsole
-
APIYI-Preisschnittstelle: Aktuelle Multiplikatoren und Gruppeninformationen
- Link:
api.apiyi.com/api/pricing - Hinweis: Datenquelle für die in diesem Artikel genannten Preise vom 11.11.2026
Autor: APIYI-Technikteam
Austausch: Schreiben Sie uns gern über die Startseite von APIYI. Weitere Materialien finden Sie im Dokumentationszentrum unter docs.apiyi.com