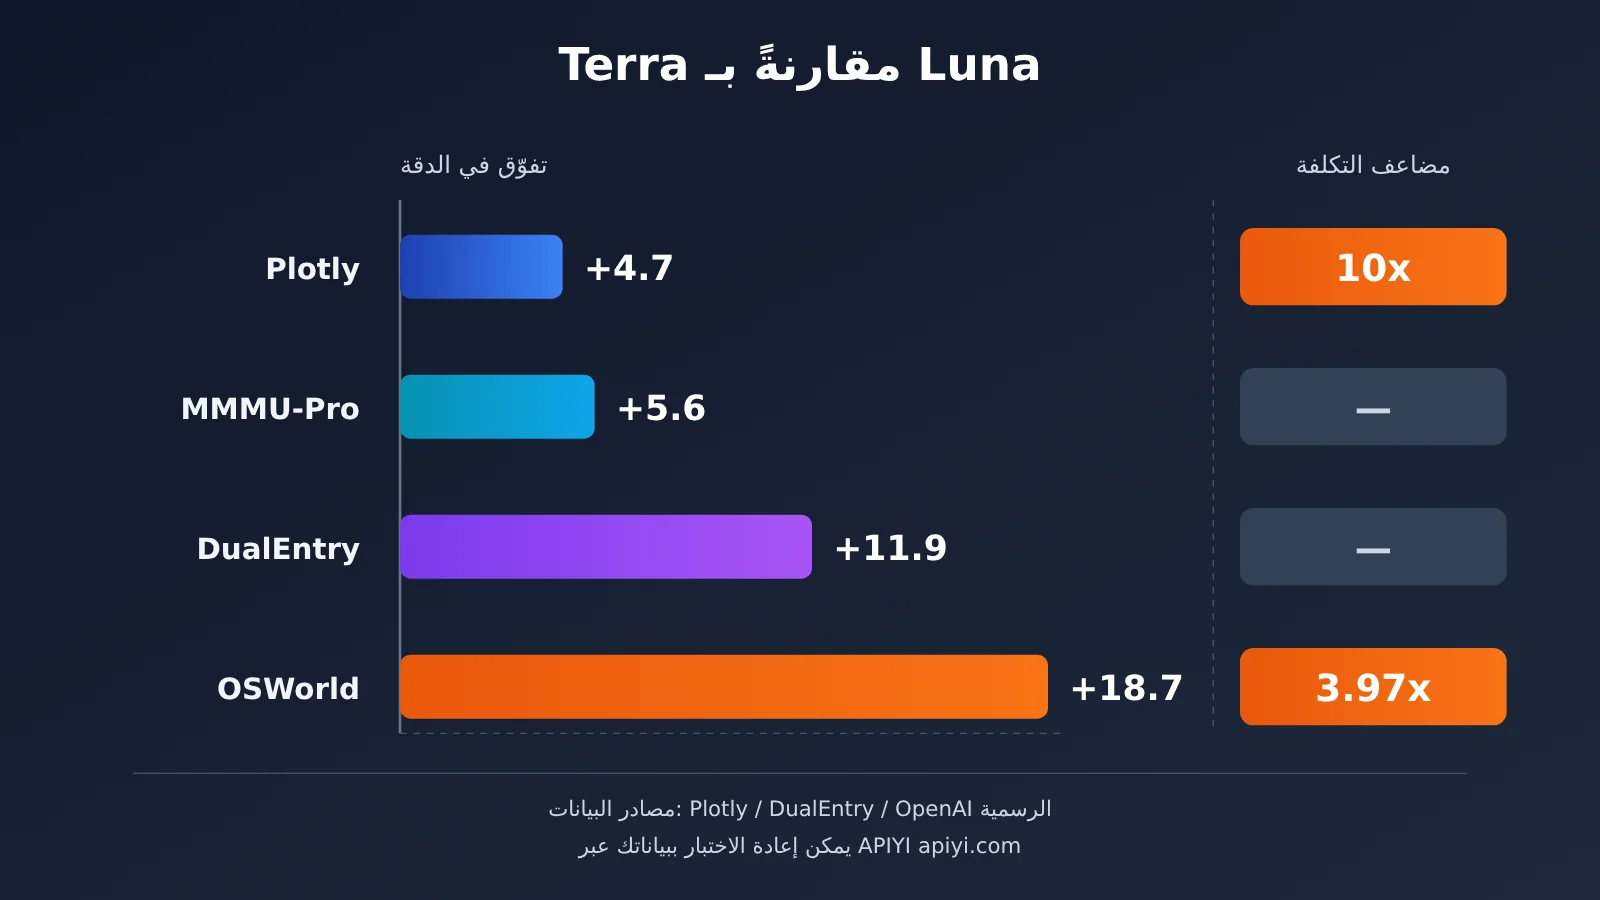
ملاحظة الكاتب: سعر التوكن في Terra يعادل 10 أضعاف سعره في Luna، لكن الفارق في الدقة يتراوح بين 4.7 و18.7 نقطة مئوية. يستند هذا المقال إلى نتائج اختبارات فعلية من Plotly وDualEntry وOSWorld لحساب التكلفة الحقيقية «لكل نتيجة صحيحة» في مهام الأتمتة المجمّعة.
أطلقت OpenAI نموذج GPT-6.1 Terra في 26 أكتوبر 2026، بعد أكثر من شهر بقليل على إطلاق GPT-6 Luna. ويبلغ الفرق بين أسعار النموذجين عبر API 10 أضعاف كاملة، لكن تفوق Terra في الدقة، وفق اختبارات مستقلة أُجريت في الظروف نفسها، تراوح بين أقل من 5 نقاط مئوية وما يقارب 19 نقطة مئوية. وفي مهام الأتمتة المجمّعة، أصبح السؤال الأكثر تداولًا بين المطورين: هل يستحق هذا الفارق في السعر؟
هذا ليس تقييمًا للنموذجين قائمًا على الانطباعات. فقد نشرت Plotly وDualEntry وArtificial Analysis نتائج اختباراتها في يوم إطلاق Terra، وقدمت OpenAI أيضًا بيانات رسمية عن OSWorld 2.1 وMMMU-Pro ومعدل الأخطاء الواقعية. يجمع هذا المقال هذه البيانات للإجابة عن سؤال محدد: كم نتيجة صحيحة ومفيدة نحصل عليها فعلًا مقابل المبلغ الإضافي؟
ما الذي ستستفيده؟ ستعرف بعد قراءة هذا المقال أنواع المهام المجمّعة التي يظهر فيها فارق كبير بين GPT-6.1 Terra وGPT-6 Luna، والمهام التي يكاد الفارق فيها يختفي. وستحصل أيضًا على شيفرة لحل هجين يجمع بين «الفرز الأولي باستخدام Luna + التحقق بالقواعد + الاستعانة بـ Terra عند الحاجة».
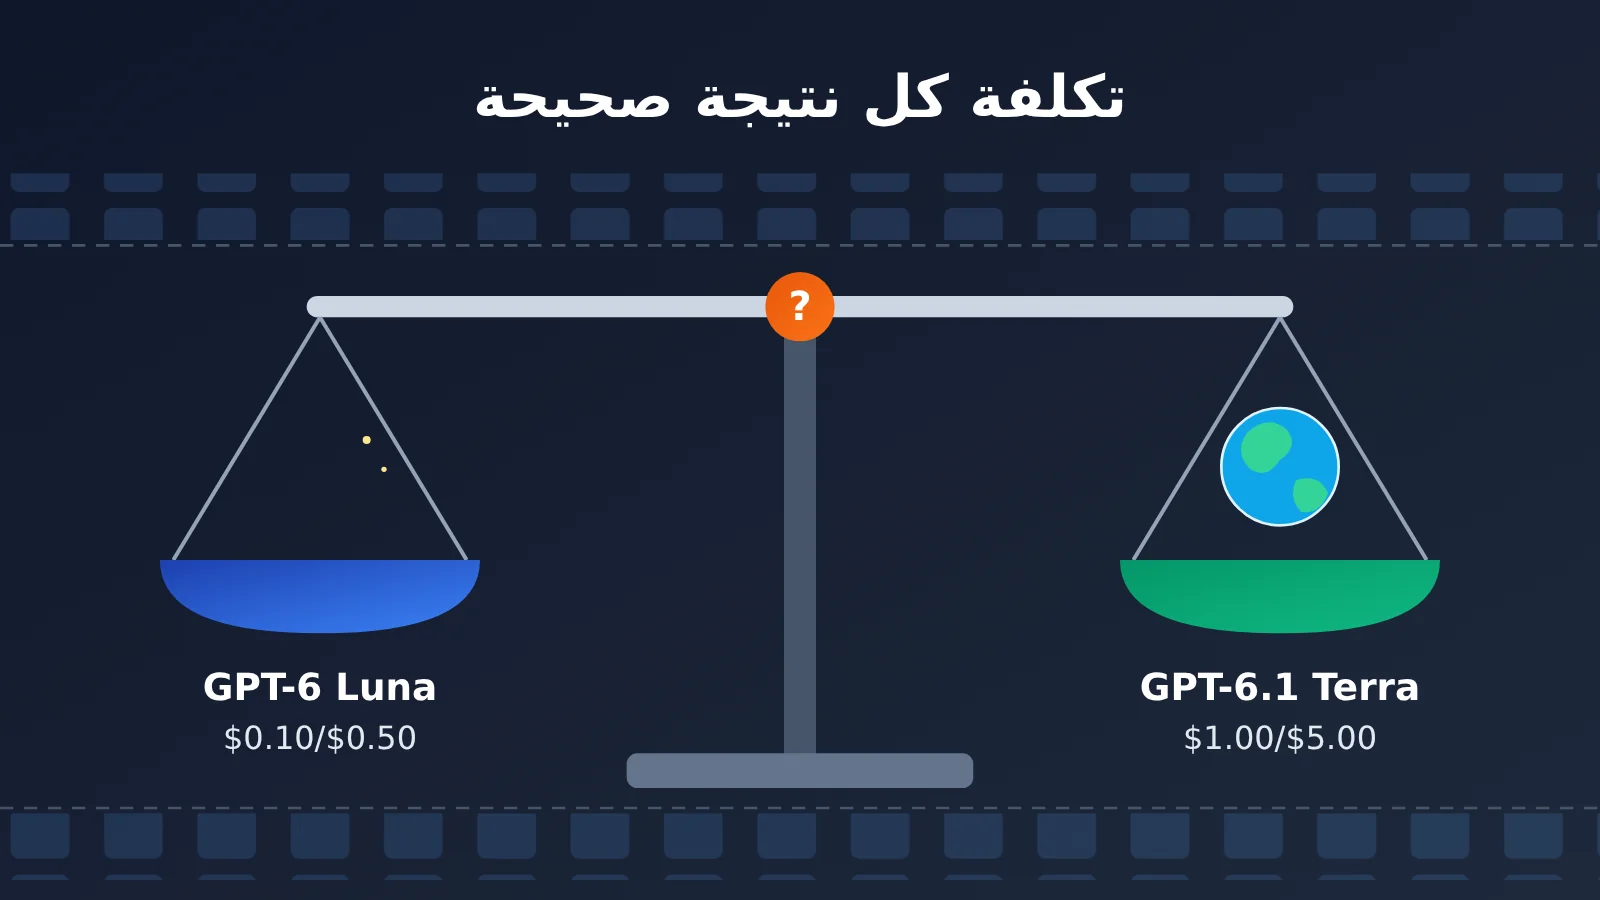
نظرة سريعة على GPT-6.1 Terra وGPT-6 Luna
ينتمي النموذجان إلى عائلة GPT-6، لكن لكل منهما دور مختلف. تصف OpenAI نموذج Luna بأنه عالي الكفاءة للمهام المحددة والمتكررة والمنفّذة بأحجام كبيرة، بينما يركز Terra على الاستدلال البصري، والتحكم الدقيق بالحاسوب، والكتابة الطبيعية، ليشغل موقعًا متوسطًا بين Luna وSol.
| البند | GPT-6 Luna | GPT-6.1 Terra |
|---|---|---|
| تاريخ الإطلاق | 22 سبتمبر 2026 | 26 أكتوبر 2026 |
| معرّف API | gpt-6-luna |
gpt-6.1-terra |
| الاستخدام المقصود رسميًا | المهام المتكررة، ذات الأحجام الكبيرة والقواعد الواضحة | الاستدلال البصري، والتحكم بالحاسوب، والمهام متعددة الخطوات |
| نافذة السياق / الحد الأقصى للمخرجات | 1,050,000 / 128,000 رمز | 1,050,000 / 128,000 رمز |
| مستوى الاستدلال | 6 مستويات من none إلى max، والافتراضي medium | 6 مستويات من none إلى max، والافتراضي medium |
| الاستخدامات المعتادة | تصنيف الوسوم، وتوجيه رسائل البريد، واستخراج الحقول | إدخال بيانات الفواتير، ومطابقة صور المنتجات، والتعامل مع الواجهات |
من حيث المواصفات، يكاد النموذجان يتطابقان: فكلاهما يدعم إدخال النصوص والصور، والمخرجات المنظمة (Structured Outputs)، واستدعاء الدوال (Function Calling)، وResponses API، وBatch API، إلى جانب أدوات مثل البحث على الويب (Web Search)، والبحث في الملفات (File Search)، والتحكم بالحاسوب (Computer Use). ويكمن الفرق الحقيقي في جانبين: السعر والقدرة على إنجاز المهام المعقدة.
ومن الجدير بالذكر أن دليل OpenAI لاختيار النموذج لا يقول: «استخدم Luna للمهام المجمّعة» أو «استخدم Terra عندما تحتاج إلى الدقة». بل يوصي باختبار النموذجين على المجموعة نفسها من المدخلات الحقيقية، ثم اختيار الإعداد الأقل تكلفة الذي يلبي متطلبات الجودة. وهذه هي الفكرة الأساسية التي ينبغي وضعها في الحسبان عند قراءة بيانات هذا المقال.
فرق أسعار API بين GPT-6.1 Terra وGPT-6 Luna
وفقًا للأسعار الرسمية من OpenAI لواجهة Standard API عند استخدام سياق قصير، بالدولار لكل مليون رمز:
| بند التكلفة | GPT-6 Luna | GPT-6.1 Terra | Terra / Luna |
|---|---|---|---|
| رموز الإدخال | $0.10 | $1.00 | 10 أضعاف |
| الإدخال المخزّن مؤقتًا | $0.01 | $0.05 | 5 أضعاف |
| رموز الإخراج | $0.50 | $5.00 | 10 أضعاف |
| الكتابة في ذاكرة التخزين المؤقت لمدة 30 دقيقة | $0.125 | $1.25 | 10 أضعاف |
| إدخال / إخراج Batch | نحو $0.05 / $0.25 | نحو $0.50 / $2.50 | 10 أضعاف |
تبلغ أسعار وضعي Batch وFlex نحو نصف أسعار Standard، بينما تبلغ أسعار وضع Fast نحو الضعف. وهناك تكلفتان يسهل إغفالهما. أولًا، عندما يتجاوز إدخال الطلب الواحد 272,000 رمز، تُحسب تكلفة الإدخال والبيانات المخزّنة مؤقتًا للطلب بأكمله بضعف السعر، وتكلفة الإخراج بـ1.5 ضعف السعر. ثانيًا، قد تُفرض رسوم إضافية على أدوات مثل البحث في الويب والتحكم في الحاسوب، كما تؤثر رموز الاستدلال وإعادة المحاولة واستدعاءات الوكيل متعددة الجولات في الاستهلاك الفعلي.
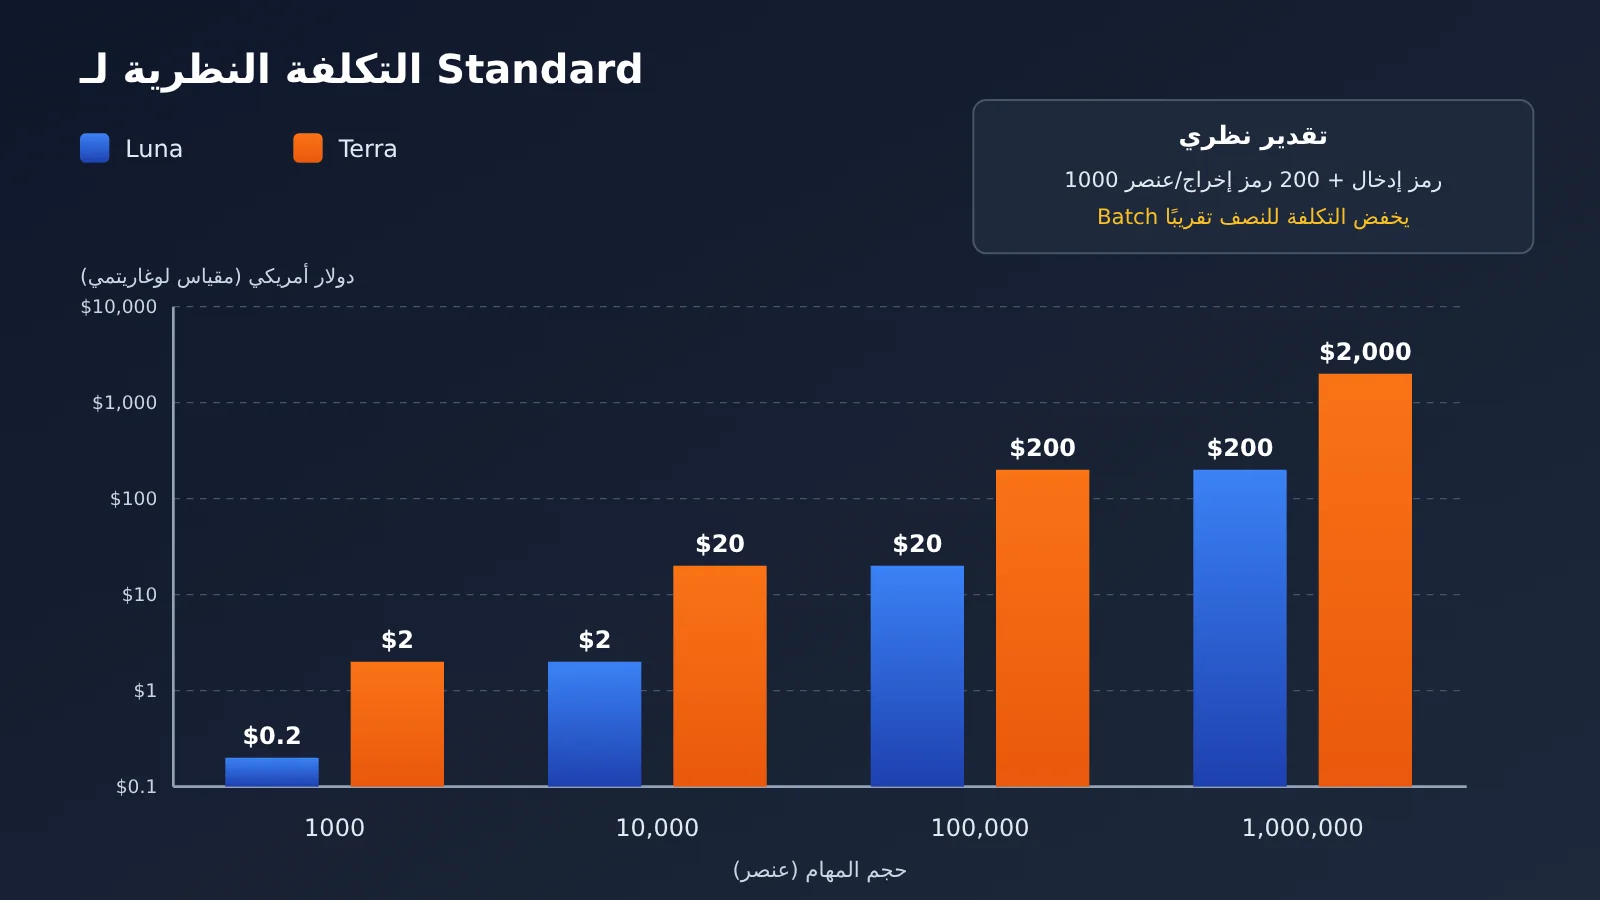
لذلك، تعني عبارة «أغلى بعشرة أضعاف» سعر الرمز الواحد في ظل شروط فوترة متساوية، ولا تعني أن تكلفة كل مهمة أعلى بعشرة أضعاف. لنجرِ حسابًا نظريًا: بافتراض أن كل سجل يتطلب 1000 رمز إدخال و200 رمز إخراج، دون تخزين مؤقت أو إعادة محاولة، فإن معالجة 100 ألف سجل في وضع Standard تكلّف نحو $20 باستخدام Luna ونحو $200 باستخدام Terra؛ وفي وضع Batch تنخفض التكلفة إلى نحو $10 و$100 على التوالي. هذه قيم نظرية محسوبة وفق الأسعار المعلنة، وليست فواتير فعلية.
مقارنة GPT-6.1 Terra وGPT-6 Luna: بيانات من 4 اختبارات فعلية
لا يخبرنا سعر الوحدة إلا «كم سندفع»، أما السؤال التالي فهو: «ماذا سنحصل في المقابل؟». تأتي مجموعات البيانات الأربع التالية من مؤسسات مختلفة، وتغطي أنواعًا مختلفة من المهام، ما يوضح كيف يتسع فارق الدقة مع ازدياد صعوبة المهمة.
43 سؤالًا في تحليل البيانات من Plotly: تكلفة أعلى بعشرة أضعاف مقابل إجابتين صحيحتين إضافيتين
طوّر باحثون من Plotly وMila معيار DataAnalyticsBench لمحاكاة مستودع بيانات لشركة تعمل في مجال طاقة الرياح، ويضم نحو 20 مليون صف من البيانات الاصطناعية. أجاب النموذجان عن 43 سؤالًا باستخدام مجموعة الأدوات نفسها، وكانت النتائج كالتالي:
| المؤشر | GPT-6 Luna | GPT-6.1 Terra |
|---|---|---|
| الإجابات الصحيحة | 38/43 (88.4%) | 40/43 (93.0%) |
| تكلفة الاختبار بالكامل | $0.13 | $1.31 |
| الزمن الوسيط لكل سؤال | 18 ثانية | 15 ثانية |
| التحليل العادي / الأسئلة الغامضة / الطلبات المستحيلة / جودة البيانات | الدرجة الكاملة في جميعها | الدرجة الكاملة في جميعها |
| الفخاخ الإحصائية | 3/5 | 4/5 |
| اكتشاف الأنماط المخفية | 2/5 | 3/5 |
تظهر النتيجة الأهم في تفاصيل الدرجات. فقد تطابق أداء النموذجين في التحليل العادي، والتعرف على المتطلبات الغامضة، ورفض الطلبات التي يتعذر تنفيذها، واكتشاف مشكلات جودة البيانات الأساسية. ولم يظهر الفرق إلا في فئتين تتطلبان تحليلًا أعمق: الفخاخ الإحصائية واكتشاف الأنماط المخفية، حيث أجاب Terra إجابة صحيحة إضافية في كل منهما.
بحساب تقريبي للنتائج الإجمالية، أنفق Terra مبلغًا إضافيًا قدره $1.18 مقابل إجابتين صحيحتين إضافيتين، أي نحو $0.59 لكل إجابة صحيحة إضافية. وهذه تكلفة هامشية محسوبة من إجمالي الاختبار، وليست سعرًا ثابتًا لتصحيح الأخطاء في بيئة الإنتاج. إذا كان السؤال يؤثر في قرار تجاري، فقد يكون مبلغ $0.59 زهيدًا؛ أما إذا كانت النتيجة مجرد اكتشاف نمط غير مهم في تقرير داخلي، فلا داعي لدفع تكلفة أعلى بعشرة أضعاف.
وهناك تفصيل آخر: كان Terra أسرع في الإجابة عن كل سؤال، لكن السبب هو أن إجاباته أقصر ويجري استدعاءات أقل للنموذج (بمتوسط نحو 4.5 استدعاءات وحوالي 1460 رمزًا من رموز المخرجات)، وليس أن سرعة التوليد لديه أعلى. وتبلغ سرعة إنتاجه نحو 64 رمزًا في الثانية. وتجدر الإشارة إلى أن العينة اقتصرت على 43 سؤالًا، وأن Terra شُغّل عبر OpenRouter بإعدادات الاستدلال الافتراضية؛ لذلك لا يمكن استنتاج أنه يحقق دقة تبلغ 93% في جميع مهام تحليل بيانات المؤسسات.
اختبار DualEntry لـ101 مهمة محاسبية: الفارق يتسع إلى 11.9 نقطة مئوية
يحاكي معيار Accounting AI Benchmark من DualEntry العمليات التجارية الفعلية بدرجة أكبر. تشمل مهامه الـ101 ثماني فئات: تصنيف المعاملات، والقيود المحاسبية، والحسابات الدائنة والمدينة، والتسوية البنكية، والتقارير المالية، والإقفال الشهري، والمعرفة المحاسبية. يُختبر كل نموذج ثلاث مرات، ولا يُعدّ ناجحًا في المهمة إلا إذا اجتازها مرتين على الأقل.
حقق Luna نسبة 66.3%، مقابل 78.2% لـTerra و81.2% لـGPT-6.1 Sol، الذي استُخدم للمقارنة. وفي النتائج التفصيلية لـTerra، سجل 13/13 في تصنيف المعاملات، و12/13 في القيود المحاسبية، و10/12 في التسوية البنكية. لكنه سجل 7/13 فقط في الحسابات الدائنة، و7/12 في كل من الحسابات المدينة والإقفال الشهري. وأشارت DualEntry أيضًا إلى تعادل Terra وLuna في المركز الأخير ضمن مهام الحسابات الدائنة.
في الأتمتة على نطاق واسع، يكتسب ثبات الأداء أهمية أكبر من الدقة في محاولة واحدة. نجح Terra في الجولات الثلاث كلها في 65.3% من المهام، مقابل 68.3% لـSol، بينما كانت نسبة Luna أقل، دون أن يذكر المصدر رقمًا محددًا. فإذا أنجز النموذج مهمة محاسبية بصورة صحيحة اليوم وأخطأ فيها غدًا، سترتفع تكلفة المراجعة البشرية سريعًا. وفي هذا الاختبار، استغرق Terra في المتوسط 16.1 ثانية لكل مهمة، بتكلفة رموز تقارب $0.042، وبلغ إجمالي تكلفة الجولات الثلاث نحو $12.73. أما تكلفة Luna المقابلة فلم يفصح عنها المصدر بوضوح، لذا لا نقدّرها هنا.
OSWorld 2.1 ومعدل الأخطاء الواقعية: أكبر فجوة في المهام المعقدة
يختبر معيار OSWorld 2.1 لأداء المهام على سطح المكتب، الذي عرضته OpenAI في إعلان إطلاق Terra، قدرة النموذج على فهم الواجهات والنقر على الأزرار الصحيحة وتنفيذ عمليات متعددة الخطوات. في أعلى مستوى للاستدلال، حقق Luna نسبة 55.5% مقابل 74.2% لـ Terra، بفارق 18.7 نقطة مئوية. وبلغت التكلفة المقدّرة لكل مهمة $0.30 و$1.19 على التوالي، أي نحو 3.97 أضعاف فقط، لا 10 أضعاف. ويعود ذلك إلى اختلاف عدد الرموز التي تستهلكها النماذج لإكمال المهمة نفسها.
نتائج اختبار الأخطاء الواقعية أكثر لفتًا للانتباه. ففي مجموعة من الأسئلة الصعبة المصممة خصيصًا لاختبار الحقائق، بلغت معدلات الخطأ لدى Luna في مستويات Low وMedium وMax على التوالي 44.3% و31.2% و18.4%، مقابل 16.7% و10.1% و4.3% لدى Terra. كان معدل خطأ Terra في مستوى Low أقل من معدل خطأ Luna حتى عند ضبطه على Max. أما في فهم الصور، فقد حقق Luna نسبة 79.9% في اختبار MMMU-Pro عند أعلى مستوى للاستدلال، مقابل 85.5% لـ Terra.
تأتي هذه البيانات جميعها من الرسوم البيانية الرسمية لـ OpenAI، وليست من اختبارات مستقلة أجراها طرف ثالث. وأسئلة الحقائق الصعبة مصممة خصيصًا لاستدراج النماذج إلى الخطأ، لذا لا تعني أن معدل أخطاء Luna في الكتابة اليومية يبلغ 44.3%. كذلك، تنطبق درجات OSWorld على ظروف الاختبار الخاصة به فقط.
المؤشر المركّب من Artificial Analysis: اضبط مستوى الاستدلال أيضًا
يقدّم التقييم المستقل من Artificial Analysis زاوية أخرى للمقارنة. عند مستوى الاستدلال Max، يبلغ مؤشر الذكاء المركّب نحو 38 لنموذج Luna و48 لنموذج Terra، بتكلفة اختبار معيارية مركّبة تبلغ نحو $0.07 و$0.40 على التوالي، أي بفارق يقارب 5.7 أضعاف. والفجوة أكبر في مؤشر وكلاء البرمجة: 31 لـLuna مقابل 48 لـTerra.
لكن اختبار AA-LCR لفهم المستندات الطويلة يقدّم مثالًا معاكسًا: فكلا النموذجين يحقق نحو 83% عند أعلى مستوى للاستدلال. كذلك يقع Terra، عند مستويَي Low وMedium، على جبهة باريتو لـ«التكلفة مقابل القدرة» ضمن نطاق اختبارات المؤسسة، لكنه ليس بالضرورة الخيار الأمثل عند مستوى Max. بعبارة أخرى، عند أتمتة المهام على نطاق واسع، لا يكفي اختيار النموذج المناسب؛ بل يجب ضبط مستوى الاستدلال أيضًا.
البدء السريع بأتمتة المهام الدفعية باستخدام GPT-6.1 Terra وGPT-6 Luna
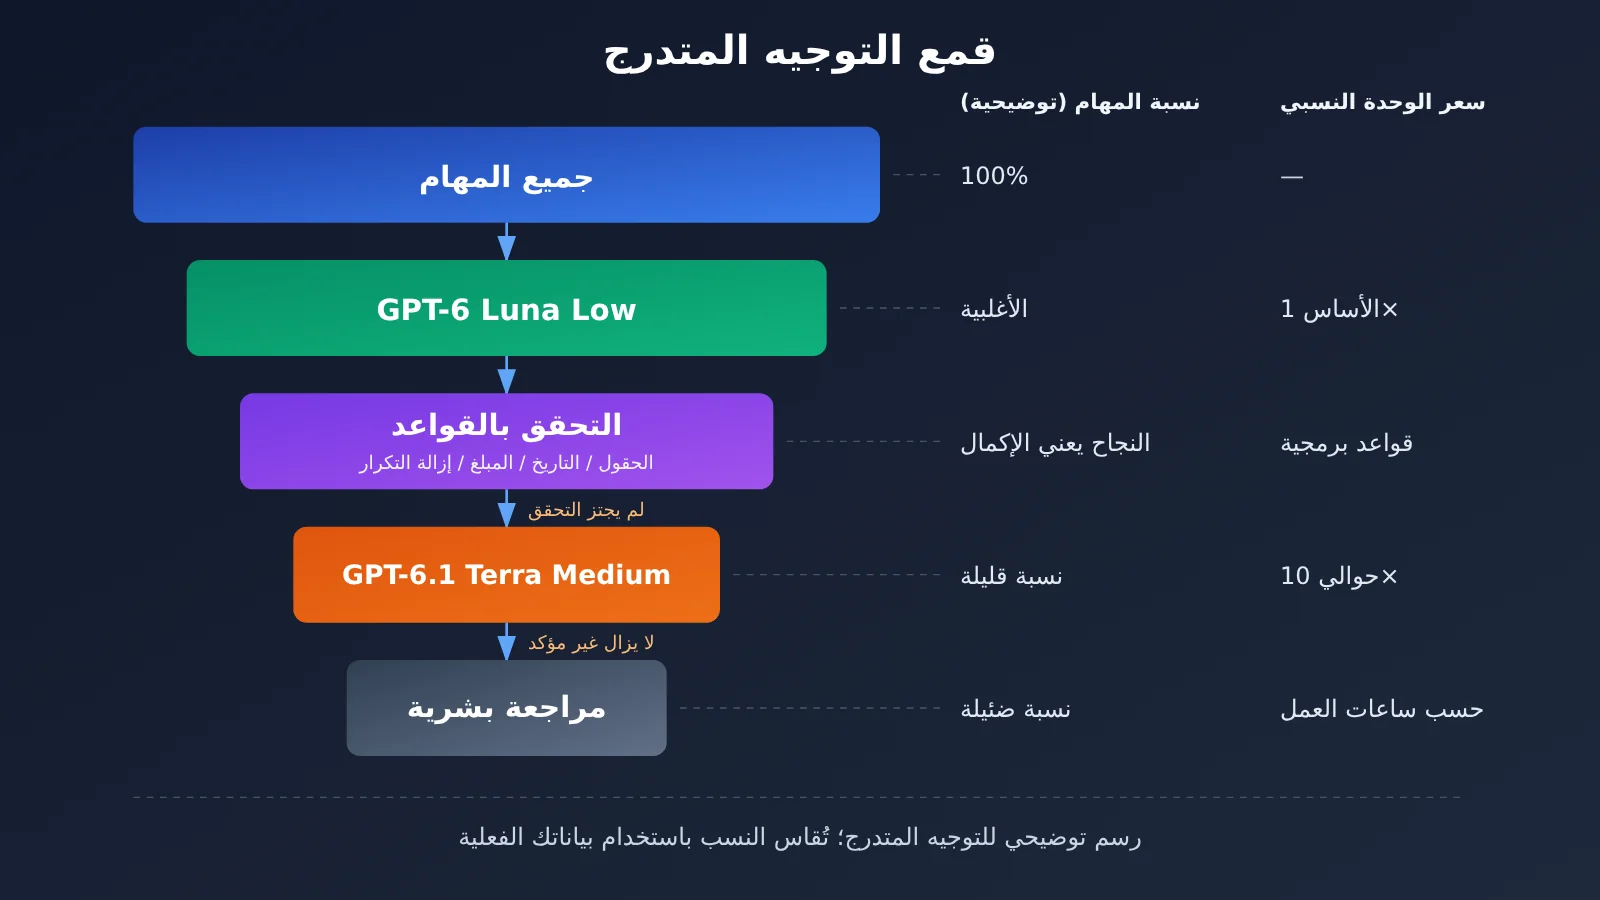
عند جمع البيانات السابقة، نصل إلى نتيجة عملية: أسند معظم المهام ذات القواعد الواضحة إلى Luna، وصعّد المهام المعقدة أو عالية المخاطر أو التي لم تجتز التحقق إلى Terra. يوضح المثال التالي أبسط تطبيق قابل للتشغيل: يستخرج Luna حقول الفاتورة أولًا، ثم يتحقق منها البرنامج وفق قواعد محددة، ولا يرسلها إلى Terra إلا إذا فشلت في التحقق.
import json, openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

def extract(model, text, effort="low"):
    r = client.chat.completions.create(
        model=model, reasoning_effort=effort,
        response_format={"type": "json_object"},
        messages=[{"role": "user", "content": f"抽取 JSON:amount, tax, total, date\n{text}"}])
    return json.loads(r.choices[0].message.content)

def valid(d):
    return all(k in d for k in ("amount", "tax", "total", "date")) and \
        abs(float(d["amount"]) + float(d["tax"]) - float(d["total"])) < 0.01

result = extract("gpt-6-luna", "发票:金额 100.00,税额 6.00,合计 106.00,日期 2026-10-20")
if not valid(result):
    result = extract("gpt-6.1-terra", "...", effort="medium")
print(result)
عرض الشفرة الكاملة لتنفيذ التوجيه متعدد المستويات
import json
import re
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

PROMPT = "从以下文本抽取 JSON,字段:amount, tax, total, date(YYYY-MM-DD)。缺失填 null。\n"

def call_model(model: str, text: str, effort: str = "low") -> Optional[dict]:
    try:
        resp = client.chat.completions.create(
            model=model,
            reasoning_effort=effort,
            response_format={"type": "json_object"},
            messages=[{"role": "user", "content": PROMPT + text}],
        )
        return json.loads(resp.choices[0].message.content)
    except Exception as e:
        print(f"[{model}] 调用失败: {e}")
        return None

def rule_check(d: Optional[dict]) -> list:
    """程序化规则校验:结构化输出只保证格式,不保证事实,所以必须二次校验"""
    if not d:
        return ["empty"]
    errors = []
    for k in ("amount", "tax", "total", "date"):
        if d.get(k) is None:
            errors.append(f"missing:{k}")
    if not errors:
        if abs(float(d["amount"]) + float(d["tax"]) - float(d["total"])) > 0.01:
            errors.append("sum_mismatch")
        if not re.match(r"^\d{4}-\d{2}-\d{2}$", str(d["date"])):
            errors.append("bad_date")
    return errors

def route(text: str) -> dict:
    # 第一层:Luna Low 处理全部输入
    d = call_model("gpt-6-luna", text, "low")
    if not rule_check(d):
        return {"data": d, "tier": "luna"}
    # 第二层:未通过校验的升级到 Terra Medium
    d = call_model("gpt-6.1-terra", text, "medium")
    errs = rule_check(d)
    if not errs:
        return {"data": d, "tier": "terra"}
    # 第三层:仍不确定的进入人工审核队列
    return {"data": d, "tier": "human_review", "errors": errs}

if __name__ == "__main__":
    samples = [
        "发票号 A001,金额 100.00 元,税额 6.00 元,价税合计 106.00 元,开票日期 2026-10-20",
        "收据:总计一百零六元整,含税,十月二十日",
    ]
    for s in samples:
        print(route(s))
🚀 البدء السريع: توصي الجهة المطوّرة بالبدء باستخدام مفتاح API واحد للتأكد من عمل النموذجين، ثم اختبارهُما على عيناتك الخاصة. توفر APIYI عبر apiyi.com واجهة متوافقة مع OpenAI؛ وللتبديل بين
gpt-6-lunaوgpt-6.1-terra، يكفي تغيير المعاملmodel. يحصل المستخدمون الجدد على رصيد مجاني للتجربة، وهو مناسب لإجراء مقارنة أولية على نطاق صغير.
تكمن أهمية هذا الأسلوب في الخطوة الثانية. لا تعتبر تأكيد Luna أنه واثق من إجابته دليلًا على صحتها؛ فالثقة التي يصرّح بها النموذج ليست موثوقة بالضرورة. أعطِ الأولوية لقواعد يمكن التحقق منها: هل توجد حقول مفقودة؟ هل التاريخ صحيح؟ هل تتطابق المبالغ؟ هل تتوافق الحقول المهمة مع النص الأصلي؟ وهل توجد سجلات مكررة؟
تحليل تأثير GPT-6.1 Terra وGPT-6 Luna
التأثير على المطورين: الاختيار حسب نوع المهمة
استنادًا إلى الاستخدامات التي حددتها الشركة والتقييمات المذكورة أعلاه، يمكن تقديم توصيات أولية للمهام الشائعة التي تُنفّذ على دفعات. هذه التوصيات مبنية على تقييمات منشورة، ولا تعني أن جميع هذه السيناريوهات قد اختُبرت عمليًا؛ لذا يجب التحقق منها باستخدام بياناتك قبل الإطلاق.
| سيناريو العمل | التوصية الأولية | السبب | المنصات المتاحة |
|---|---|---|---|
| وضع وسوم لمئة ألف مقال | GPT-6 Luna | القواعد واضحة، ويمكن التحقق منها بأخذ عينات؛ وقد حقق النموذجان العلامة الكاملة في تحليل Plotly العادي | APIYI apiyi.com، OpenAI الرسمية |
| إدخال بيانات الفواتير ولقطات شاشة الطلبات | GPT-6.1 Terra | يتفوق في القدرات البصرية والتشغيلية، لكن لا يزال التحقق من المبالغ برمجيًا ضروريًا | APIYI apiyi.com، OpenAI الرسمية |
| تلخيص أخبار الذكاء الاصطناعي يوميًا | Luna للفرز الأولي + Terra للقراءة المتعمقة | يتولى Luna إزالة التكرارات ووضع الوسوم، بينما يقيّم Terra أهمية الأخبار | APIYI، OpenAI الرسمية |
| تصنيف رسائل خدمة العملاء وإعداد مسودات الردود | Luna أساسًا | تُصعَّد الطلبات عالية المخاطر، مثل الشكاوى واسترداد الأموال، أو تُحال إلى موظف بشري | APIYI، OpenAI الرسمية |
| تعديل صفحات الويب والشفرة على دفعات | Terra أو Sol | سجل Terra نتيجة 48 على مؤشر الوكيل البرمجي، مقابل 31 لـ Luna | APIYI، OpenAI الرسمية |
ومن النقاط الأخرى التي قد يغفل عنها المطورون معدل المعالجة. في فئة Build التي أعلنتها الشركة، يبلغ حد Luna مليوني رمز (Token) في الدقيقة، والحد الأقصى لقائمة انتظار Batch هو 20 مليون رمز، مقابل مليون و3 ملايين لـ Terra على التوالي. أما في فئة Launch، فتبلغ حدود Luna عشرة ملايين ومليار رمز، مقابل 4 ملايين و200 مليون لـ Terra. وفي المهام التي تتجاوز مئة ألف سجل، يمكن إدراج كمية أكبر بكثير في قائمة انتظار Luna. لكن هذه حدود للحصص وليست سرعة التوليد، وقد تختلف أيضًا من حساب إلى آخر.
التأثير على القطاع: من مقارنة سعر الاستدعاء إلى مقارنة تكلفة النتيجة المقبولة
في يوم إطلاق Terra، ظهرت وجهتا نظر في مجتمع Reddit. رأى البعض أن موقع Terra بين النموذجين غير واضح: فـ Luna رخيص بما يكفي، وSol أقوى منه. في المقابل، أشار آخرون إلى أن معدل الأخطاء الواقعية في Terra Low أصبح أقل منه في Luna Max، وأن المقارنة لا ينبغي أن تقتصر على سعر الاستدعاء. كما أفاد بعض مستخدمي Codex بأن Terra عند مستوى الاستدلال المرتفع لا يستهلك بالضرورة حصة أقل من Sol عند المستوى المتوسط، بينما وجد مستخدمو Luna أن إعادة العمل في مهام التطوير المعقدة ألغت ميزة توفير الحصة. هذه كلها تجارب فردية، كما أن حصة اشتراك Codex تختلف عن فوترة رموز API، ولا يمكن استخدامها لتقدير تكاليف API.
لكن هذه التجارب تشير إلى اتجاه واحد: يتغير معيار قياس تكلفة الأتمتة واسعة النطاق من «كم تكلف المكالمة الواحدة؟» إلى «كم تكلف كل نتيجة مقبولة؟». ويمكن فهم ذلك بمعادلة بسيطة:
التكلفة الإجمالية = تكلفة استدعاءات API + تكلفة الأدوات + تكلفة إعادة المحاولة + تكلفة المراجعة البشرية + خسائر الأخطاء
يتفوق Luna بوضوح في البندين الأولين، بينما يخفض Terra تكاليف البنود الثلاثة الأخيرة بفضل معدل أخطاء أقل. ويعتمد الخيار الأكثر توفيرًا على تكلفة الخطأ الواحد في نشاطك. وتؤيد ملاحظات MultiAI على عينة صغيرة ذلك أيضًا: فعند إيقاف الاستدلال في Terra، ظهرت أخطاء في بعض المهام المنطقية والحسابية، ثم تحسن الأداء بوضوح عند الانتقال إلى مستوى Medium. أما Luna فأداؤه جيد في المهام البسيطة، لكنه يرتكب أخطاء أكثر في المهام المنطقية متعددة الخطوات.
كيف تجري تجربة مقارنة بنفسك؟
لا تزال البيانات المنشورة تترك عدة أسئلة مهمة بلا إجابة: ما معدل الخطأ لكل من النموذجين عند تصنيف 100 ألف مقال صيني حقيقي؟ وما مدى استقرارهما على المدى الطويل؟ وكم يمكن أن يوفر النهج المختلط فعليًا؟ وهل تعوّض تكلفة المراجعة البشرية السعر الأعلى لـ Terra؟ لا يمكن الإجابة عن هذه الأسئلة إلا بالتجربة.
يمكنك إعداد 200 إلى 500 عينة من بيانات عمل حقيقية، مرفقة بالإجابات الصحيحة. على سبيل المثال، اختر 100 عينة لكل من التصنيف البسيط، واستخراج المعلومات الأساسية، والتعرّف على المحتوى المعقد، و50 عينة لكل من التحقق من الحقائق وتنفيذ العمليات متعددة الخطوات باستخدام الأدوات. بعد ذلك، شغّل أربعة إعدادات: Luna Low وLuna Medium وTerra Low وTerra Medium، باستخدام المدخلات والموجهات والأدوات ومعايير التقييم نفسها. وكرّر بعض المهام عدة مرات لملاحظة مدى الاستقرار.
أخيرًا، ركّز على خمسة مؤشرات: الدقة، وتكلفة API لكل 1000 عنصر، ومتوسط زمن التنفيذ وزمن التنفيذ عند المئين 95 (P95)، وعدد مرات المراجعة البشرية وإعادة العمل، والتكلفة الإجمالية لكل 1000 نتيجة مستوفية للمعايير. وإذا كنت تستخدم منصة خارجية للنشر، فاعتمد على قواعد الفوترة الفعلية لديها، وتحقق من شروط معالجة البيانات ومتطلبات الامتثال.
الأسئلة الشائعة FAQ
س1: ما الفرق الأساسي بين GPT-6.1 Terra وGPT-6 Luna؟
مواصفات النموذجين متطابقة تقريبًا: نافذة السياق لدى كل منهما 1,050,000 توكن، ويدعمان الأدوات نفسها. الفرق أن سعر الوحدة في Luna أقل بعشرة أضعاف، ما يجعله مناسبًا للمهام المتكررة ذات القواعد الواضحة. أما Terra فيتفوق بوضوح في الفهم البصري، واستخدام الحاسوب، والتحليل المعقد، والدقة في المعلومات، لذا يناسب المهام متعددة الخطوات التي تكون تكلفة الخطأ فيها مرتفعة.
س2: هل تتفوق دقة Terra بفارق بسيط فقط رغم أنه أغلى بعشرة أضعاف؟
يعتمد ذلك على نوع المهمة. ففي اختبار تحليل البيانات Plotly، تقدم Terra بنحو 4.7 نقاط مئوية فقط، وفي مهمة المحاسبة DualEntry تقدم بـ11.9 نقطة مئوية، وفي تشغيل سطح المكتب OSWorld تقدم بـ18.7 نقطة مئوية. كذلك كانت تكلفة المهمة في OSWorld أعلى بنحو 3.97 أضعاف فقط، وليس بعشرة أضعاف ثابتة.
س3: هل يمكن لـLuna أن يحل محل Terra عند ضبط مستوى الاستدلال على max؟
قد يتحسن أداؤه في بعض الجوانب، لكنه لن يتجاوز الفجوة بين قدرات النموذجين. ففي اختبار OpenAI الرسمي للأسئلة الصعبة المتعلقة بالحقائق، بلغ معدل الخطأ لدى Luna Max نسبة 18.4%، وظل أعلى من نسبة 16.7% لدى Terra Low. كما أن رفع مستوى الاستدلال يزيد استهلاك التوكنات، ما قد يفقد Luna ميزته من حيث التكلفة.
س4: كيف أقارن النموذجين بسرعة عبر API؟
يُنصح باستخدام الشفرة نفسها مع تبديل اسم النموذج للمقارنة:
1. تفضل بزيارة APIYI على apiyi.com للتسجيل والحصول على مفتاح API ورصيد اختبار مجاني
2. اضبط `base_url` على `https://api.apiyi.com/v1`
3. شغّل مجموعة العينات نفسها باستخدام `gpt-6-luna` و`gpt-6.1-terra` كلًا على حدة، وسجّل الدقة واستهلاك التوكنات
س5: كيف يمكن خفض تكلفة المهام كبيرة الحجم أكثر؟
بالنسبة إلى المهام التي لا تحتاج إلى استجابة فورية، استخدم Batch API أولًا؛ إذ تبلغ تكلفتها نحو نصف تكلفة Standard، مع نافذة معالجة رسمية مدتها 24 ساعة. واحرص أيضًا على ألا يتجاوز الإدخال في الطلب الواحد 272,000 توكن، لتجنب الرسوم الإضافية للسياق الطويل. وتتيح APIYI على apiyi.com الدفع حسب الاستخدام، ما يسهل البدء بدفعة صغيرة لمعرفة استهلاك التوكنات الفعلي لكل مهمة قبل زيادة الحجم.
س6: ما حدود نتائج هذه الاختبارات؟
يضم اختبار Plotly 43 سؤالًا فقط ويستخدم بيانات اصطناعية. أما نتائج OSWorld وMMMU-Pro ومعدل الأخطاء في المعلومات فتأتي من OpenAI رسميًا، ولم يُعَد اختبارها بشكل مستقل. كذلك لا تستخدم نتيجتا MultiAI البالغتان 24/24 و18/18 مجموعة الأسئلة نفسها، لذا لا يمكن مقارنتهما مباشرةً. إضافةً إلى ذلك، تضمن Structured Outputs صحة التنسيق فقط، وليس صحة محتوى الحقول. ولا يمكن اعتبار أي نتيجة معيارية مماثلة للدقة الفعلية في أعمالك.
أبرز النقاط حول GPT-6.1 Terra وGPT-6 Luna
- فرق السعر 10 أضعاف: تبلغ تكلفة الإدخال في Luna $0.10 والإخراج $0.50، مقابل $1.00 و$5.00 في Terra.
- الفارق صغير في المهام البسيطة: حصل النموذجان على الدرجة الكاملة في مهام مثل التحليل العادي باستخدام Plotly والتعرف على الأسئلة الغامضة.
- الفارق كبير في المهام المعقدة: يتقدم Terra بمقدار 11.9 نقطة في مهام المحاسبة، و18.7 نقطة في تشغيل سطح المكتب.
- تفاوت في دقة المعلومات: بلغ معدل أخطاء Terra Low 16.7%، وهو أقل من معدل Luna Max البالغ 18.4%.
- اضبط مستوى الاستدلال أيضًا: يتفوق Terra Low وTerra Medium على وضع Max من حيث كفاءة التكلفة.
- التوجيه المتدرج هو الأكثر جدوى: يبدأ Luna بالفرز الأولي، ثم تُطبّق قواعد التحقق، ويتولى Terra الحالات المتبقية، تلي ذلك مراجعة بشرية.
- اختبر قبل الإطلاق: استخدم من 200 إلى 500 عينة من بياناتك لمقارنة أربعة إعدادات على APIYI، عبر apiyi.com.
الخلاصة
بالعودة إلى السؤال: أيهما أنسب للأتمتة على نطاق واسع، GPT-6.1 Terra أم GPT-6 Luna؟ تعتمد الإجابة على صعوبة المهمة وتكلفة الخطأ:
- المهام ذات القواعد الواضحة والقابلة للتحقق الآلي: يُعد Luna نقطة انطلاق منخفضة التكلفة، وقد حقق النموذجان أداءً متساويًا في التحليلات العادية ضمن اختبار Plotly.
- المهام عالية المخاطر، مثل التعرف البصري والعمليات متعددة الخطوات والمهام المالية: قد تكون التكلفة الإضافية لـ Terra مبررة، إذ يصل تفوقه في الدقة إلى 18.7 نقطة مئوية.
- هدف التحسين الحقيقي: ليس سعر استدعاء API الواحد، بل التكلفة الإجمالية لكل نتيجة مقبولة، بما فيها إعادة المحاولة والمراجعة والخسائر الناجمة عن الأخطاء.
بالنسبة إلى معظم الفرق، لا يتطلب الأمر الاختيار بين النموذجين. الأفضل أن يتولى Luna معظم المهام البسيطة، بينما يعالج Terra المهام الأكثر صعوبة. يُنصح أولًا بإجراء مقارنة محدودة باستخدام عينات من أعمالك، ثم تحديد نسبة توزيع المهام.
يمكنك استخدام APIYI عبر apiyi.com للتحقق سريعًا من أداء النموذجين في أعمالك. يتيح لك مفتاح واحد التبديل بينهما، مع الدفع حسب الاستخدام، ما يسهل حساب تكلفة كل ألف مهمة بدقة.
📚 المراجع
- OpenAI: Introducing GPT-6.1 Terra: إعلان الإطلاق، ويتضمن رسومًا بيانية لنتائج OSWorld وMMMU-Pro ومعدل الأخطاء الواقعية
- الرابط:
openai.com/index/introducing-gpt-6-1-terra -
التوضيح: مصدر التصنيف الرسمي لنموذج Terra وبيانات الاختبارات المعيارية
-
أسعار OpenAI API وصفحات النماذج: أسعار Luna وTerra وقدراتهما وحدود معدلات الاستخدام
- الرابط:
developers.openai.com/api/docs/pricing -
التوضيح: مصدر أسعار Standard وBatch وFlex وFast
-
وثائق OpenAI Batch API: تكلفة المعالجة الدفعية والمهلة الزمنية للتنفيذ
- الرابط:
developers.openai.com/api/docs/guides/batch -
التوضيح: طريقة لخفض تكلفة المهام غير المتزامنة كبيرة الحجم
-
Plotly: GPT-6.1 Terra Benchmark Results for Data Analysis: اختبار لتحليل البيانات يتضمن 43 مهمة في ظروف موحدة
- الرابط:
plotly.com/blog/gpt-6-1-terra-plotly-data-analytics-bench -
التوضيح: الدقة والتكلفة والوقت المستغرق ونتائج الاختبارات الفرعية
-
DualEntry: GPT-6.1 Terra Accounting Benchmark: اختبار يشمل 101 مهمة محاسبية
- الرابط:
dualentry.com/blog/gpt-6-1-terra-accounting-benchmark -
التوضيح: الدقة وتصنيفات المهام وثبات النتائج عبر ثلاث جولات
-
Artificial Analysis: تقييم GPT-6.1 Terra: مؤشر الذكاء الشامل وكفاءة التكلفة
- الرابط:
artificialanalysis.ai/models/releases/gpt-6-1-terra - التوضيح: سجلات اختبارات مستقلة بمستويات مختلفة من جهد الاستدلال
المؤلف: الفريق التقني في APIYI
التواصل التقني: يمكنكم التواصل معنا عبر الصفحة الرئيسية لموقع APIYI، وزيارة مركز الوثائق على docs.apiyi.com للاطلاع على المزيد من موارد الوصول إلى النماذج.