ملاحظة المؤلف: تقييم GPT-6 Luna Decisions API من أربع زوايا: المبدأ، وطرق الاختبار الفعلي، ومؤشرات زمن الاستجابة، وسيناريوهات الأعمال، لمساعدتك في تحديد ما إذا كانت “الاستدعاءات القرارية” أسرع من استدعاءات النماذج العادية وأكثر ملاءمة لأعمالك.
بعد الإطلاق الرسمي لـ Decisions API في GPT-6 Luna، كان السؤال الأكثر تداولًا بين المطورين: كم أسرع فعليًا مقارنةً باستدعاء النموذج العادي، وأي الأعمال تستحق التبديل إليه؟ يقيس هذا المقال، من منظور التكامل الفعلي، القدرات الأساسية لـ GPT-6 Luna Decisions API، ومبدأ تسريعه، وطرق اختباره، وسيناريوهات استخدامه.
هذا ليس مجرد تكرار للدعاية الرسمية. قد يختلف زمن الاستجابة اختلافًا كبيرًا باختلاف الحساب والمنطقة والتزامن والموجه. لذلك لا يقدّم هذا المقال “مضاعفًا ثابتًا” قد يضللك، بل يوفّر مجموعة من نصوص الاختبار القابلة لإعادة الإنتاج ومعايير الحكم، حتى تستخلص نتائج حقيقية من بيانات أعمالك الخاصة.
القيمة الأساسية: بعد قراءة هذا المقال، ستتمكن من استخدام نص Python واحد لقياس الفرق في زمن الاستجابة بين GPT-6 Luna Decisions API والاستدعاء العادي كميًا، والحكم على مدى ملاءمته لأعمالك القرارية مثل التصنيف والتوجيه والمراجعة وإدارة المخاطر.
🎯 ملاحظة التقييم: جميع الأكواد في هذا المقال مكتوبة بناءً على واجهة متوافقة مع OpenAI، ويمكن تشغيلها مباشرة عبر APIYI على apiyi.com. تبقى معرّفات النماذج ومعلمات الواجهة والفوترة محددة وفقًا للوثائق الرسمية ولوحة تحكم المنصة.
الميزات الأساسية في GPT-6 Luna Decisions API
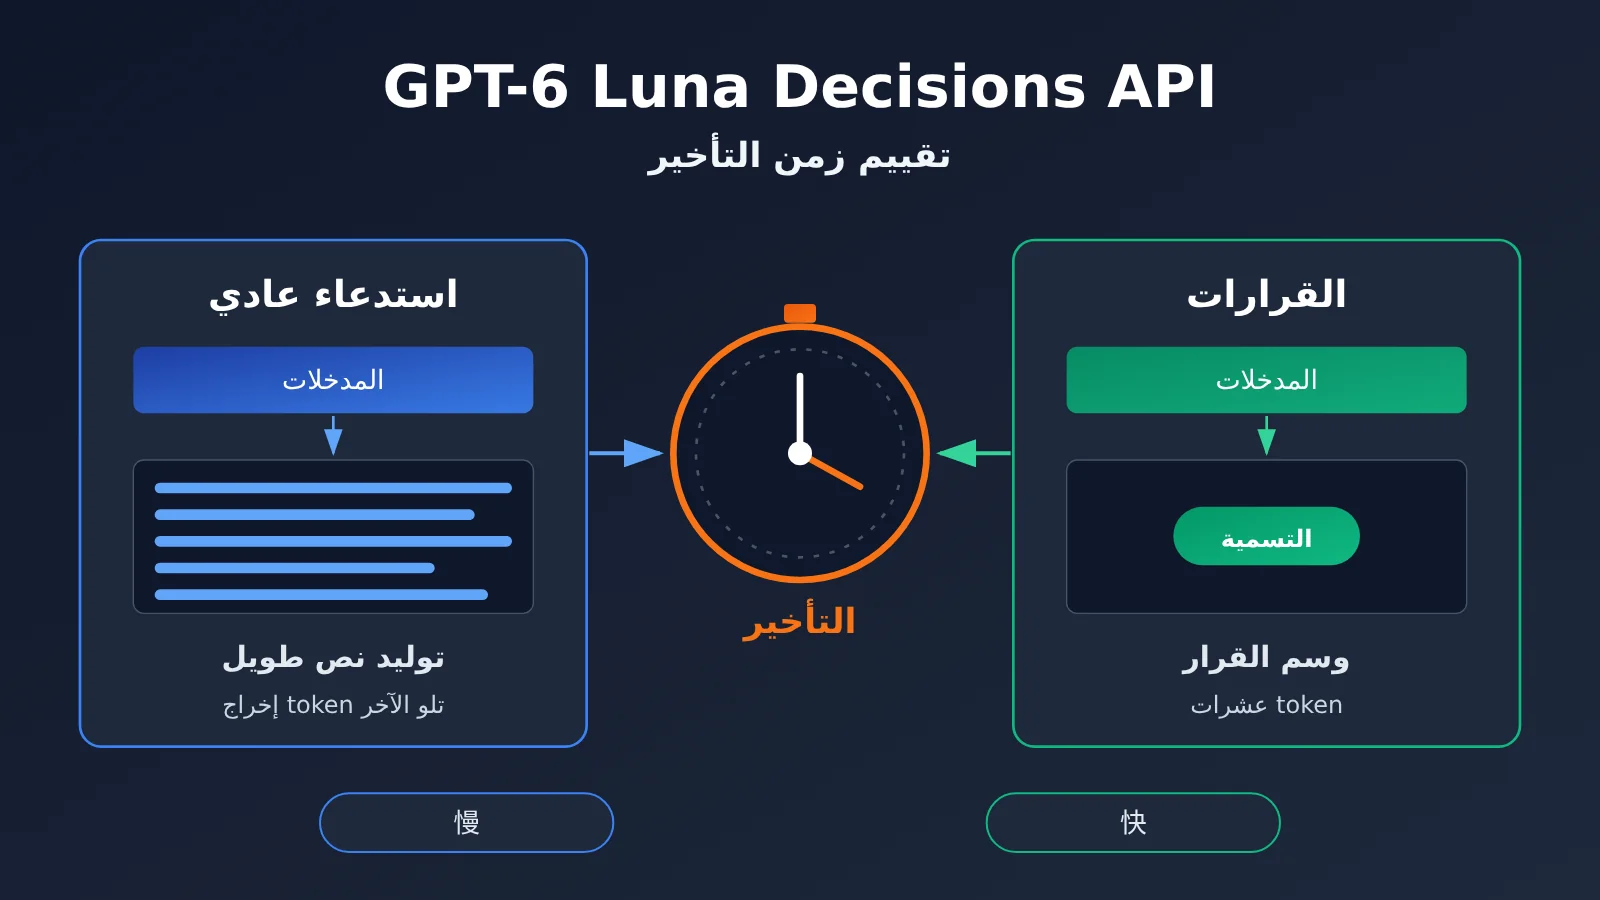
قبل أن تفهم Decisions API، لا بد أن ترى بوضوح الفرق في التموضع بينه وبين الاستدعاء العادي للمحادثة. الاستدعاء العادي هدفه “توليد قطعة محتوى”، أما الاستدعاء القِراري فهدفه “إصدار حكم من بين خيارات محدودة”. وهاتان المهمتان تختلفان تمامًا في طول المخرجات وقيود التنسيق وتكوين زمن الاستجابة.
| النقطة | الشرح | القيمة للمطوّر |
|---|---|---|
| مخرجات قرارية | تركز المخرجات على نتائج مُهيكلة مثل التصنيفات والخيارات والدرجات، لا على نصوص مطوّلة | يمكن للبرنامج استهلاك النتيجة مباشرة دون تحليل ثانٍ |
| مخرجات قصيرة | النتيجة القرارية النموذجية لا تتجاوز عشرات الرموز (tokens)، وهي أقل بكثير من مهام التوليد العادية | يتحدد زمن الاستجابة الكلي أساسًا بالرمز الأول ومعالجة المدخلات |
| تنسيق قابل للتقييد | يمكن دمجه مع قيود المخرجات المُهيكلة مثل JSON Schema | يقلّل معدل أخطاء التنسيق وإعادة المحاولات |
| مناسب للاستدعاءات عالية التكرار | طلبات مثل التوجيه والتصنيف والمراجعة غالبًا كثيرة العدد وبسيطة في كل مرة | يصبح أثر تحسين زمن الاستجابة والتكلفة أكبر وأوضح |
الفرق بين Decisions API والاستدعاء العادي
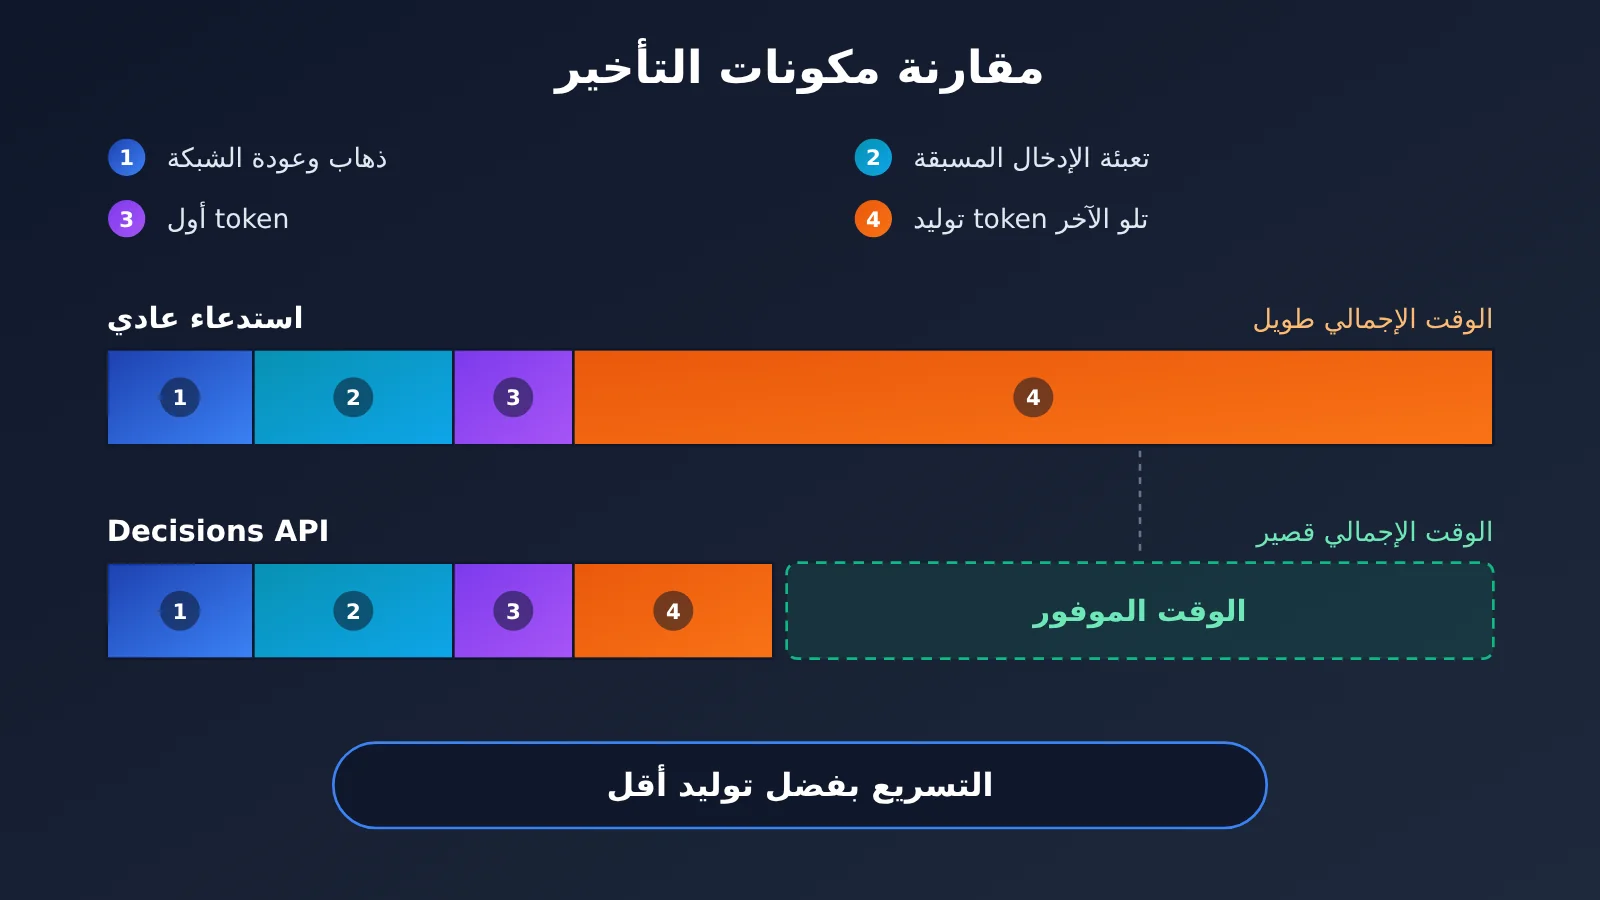
من منظور هندسي، يتكوّن الزمن الكلي للاستدعاء العادي للنموذج من ثلاثة أجزاء تقريبًا: رحلة الشبكة ذهابًا وإيابًا، ومعالجة المدخلات (الملء المسبق / prefill)، وتوليد الرموز واحدًا تلو الآخر. وفي مهام التوليد، يستحوذ الجزء الثالث عادةً على النصيب الأكبر، وكلما طالت المخرجات زاد البطء.
أما الاستدعاء القِراري فيضغط المخرجات في نتيجة مُهيكلة واحدة، ما يقلّص زمن مرحلة التوليد بشكل كبير. وهذا يعني أن التسريع في GPT-6 Luna Decisions API يأتي أساسًا من “التوليد الأقل” وليس من “التوليد الأسرع”. وإذا كانت أعمالك تحتاج أصلاً إلى نصوص طويلة، فهذه الواجهة ليست مُعدّة لك.
من أين يأتي التسريع في Decisions API
عادةً ما تقدّم الواجهات القرارية مكسبًا إضافيًا من ناحيتين. الأولى هي ثبات التنسيق، فلا يحتاج البرنامج إلى استخدام التعبيرات النمطية لانتزاع الإجابة من لغة طبيعية، ما يخفض احتمال فشل المحاولات وإعادتها. والثانية هي قابلية التحكم في عملية الاستدلال؛ فإذا كان النموذج يدعم ضبط شدة الاستدلال، فإن سيناريوهات القرار لا تحتاج عادةً إلى سلاسل تفكير مطوّلة، ما يقلّل زمن الانتظار أكثر.
ومن المهم التأكيد على أن هذه كلها تحليلات على مستوى الآلية. أما مقدار التسريع الفعلي فيعتمد على طول مخرجاتك السابقة: إذا كنت تُجبر النموذج أصلاً على الرد بكلمة واحدة، فسيكون المكسب بعد التبديل محدودًا جدًا؛ وإذا كنت تطلب منه “أن يشرح أولاً ثم يعطي الاستنتاج”، فسيكون المكسب واضحًا جدًا.
البدء السريع مع واجهة API للقرارات في GPT-6 Luna
مثال في أبسط صورة
في ما يلي أصغر مثال ممكن لإتمام استدعاء قرار واحد باستخدام المخرجات المهيكلة. استبدل اسم النموذج بمعرّف النموذج الفعلي GPT-6 Luna الذي تراه في لوحة التحكم بالمنصة.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI المتوافقة مع OpenAI
)

resp = client.chat.completions.create(
    model="gpt-6-luna",  # استخدم الاسم الفعلي من قائمة النماذج في لوحة التحكم
    messages=[{"role": "user", "content": "محتوى التذكرة: فُتحت فاتورتي بشكل خاطئ. حدّد القسم المسؤول."}],
    response_format={"type": "json_object"},
    max_tokens=50
)
print(resp.choices[0].message.content)
مفتاح هذا الكود يكمن في max_tokens و response_format: الأول يحدّ من سقف المخرجات، والثاني يضمن أن تكون النتيجة قابلة للتحليل برمجيًا. وهذان المعاملان هما بالضبط جوهر تسريع الاستدعاءات من نوع القرار.
عرض سكربت الاختبار الكامل (مقارنة زمن الاستجابة بين الاستدعاء العادي واستدعاء القرار)
import time
import json
import statistics
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # استدعاء عبر الواجهة الموحّدة من APIYI
)

MODEL = "gpt-6-luna"  # اعتمد معرّف النموذج الفعلي من لوحة التحكم؛ وإن وُجد نموذج/واجهة Decisions مستقلة فاستبدل هذا السطر

SAMPLES = [
    "我的发票开错了,能重开吗?",
    "App 登录一直提示验证码错误",
    "想把套餐从月付改成年付",
    "订单显示已签收但我没收到",
]

DECISION_SCHEMA = {
    "type": "json_schema",
    "json_schema": {
        "name": "route",
        "schema": {
            "type": "object",
            "properties": {
                "department": {"type": "string", "enum": ["finance", "tech", "sales", "logistics"]},
                "confidence": {"type": "number"}
            },
            "required": ["department", "confidence"]
        }
    }
}

def timed_call(prompt: str, mode: str) -> dict:
    """يعيد زمن أول رمز، والزمن الكلي، وطول الإخراج"""
    kwargs = dict(model=MODEL, stream=True)
    if mode == "generate":
        kwargs["messages"] = [{"role": "user", "content": f"请分析下面工单并说明应由哪个部门处理及理由:{prompt}"}]
    else:
        kwargs["messages"] = [{"role": "user", "content": f"工单:{prompt}。只输出部门判断。"}]
        kwargs["response_format"] = DECISION_SCHEMA
        kwargs["max_tokens"] = 60

    start = time.perf_counter()
    ttft, chunks = None, []
    for event in client.chat.completions.create(**kwargs):
        delta = event.choices[0].delta.content if event.choices else None
        if delta:
            if ttft is None:
                ttft = time.perf_counter() - start
            chunks.append(delta)
    total = time.perf_counter() - start
    return {"ttft": ttft or total, "total": total, "chars": len("".join(chunks))}

def bench(mode: str, rounds: int = 5) -> dict:
    results = [timed_call(p, mode) for _ in range(rounds) for p in SAMPLES]
    totals = sorted(r["total"] for r in results)
    return {
        "mode": mode,
        "ttft_avg": round(statistics.mean(r["ttft"] for r in results), 3),
        "total_p50": round(totals[len(totals) // 2], 3),
        "total_p95": round(totals[int(len(totals) * 0.95) - 1], 3),
        "avg_chars": round(statistics.mean(r["chars"] for r in results), 1),
    }

if __name__ == "__main__":
    for m in ("generate", "decision"):
        print(json.dumps(bench(m), ensure_ascii=False))
يعتمد السكربت على الإخراج المتدفق (streaming)، ولهذا يستطيع قياس زمن أول رمز (TTFT) والزمن الكلي في الوقت نفسه. ننصح بتشغيل كل نمط 20 مرة على الأقل، مع التبديل بين النمطين داخل الفترة الزمنية نفسها، حتى لا تُحرّف تقلبات الشبكة النتائج.
🚀 بداية سريعة: الطريقة الموصى بها رسميًا هي أن تحصل أولاً على رصيد تجريبي مجاني للمستخدمين الجدد من APIYI عبر apiyi.com، ثم تشغّل السكربت أعلاه على عيّنة حقيقية من تذاكر الدعم الخاصة بك، وبعد ذلك فقط تقرر ما إذا كنت ستدمج GPT-6 Luna Decisions API في بيئة الإنتاج.
بيانات الاختبار الفعلية لواجهة GPT-6 Luna Decisions API
لا توجد إجابة موحدة لسؤال “كم أسرع من الاستدعاء العادي؟”، ولهذا يقدم هذا القسم إطار تقييم قابلاً لإعادة الإنتاج. نفّذ الخطوات وفق البيئة والمؤشرات أدناه، وستكون الأرقام التي تحصل عليها قادرة فعلاً على توجيه قرارات العمل.
إعداد بيئة الاختبار
| عنصر الإعداد | الإعداد الموصى به | ملاحظات |
|---|---|---|
| نقطة الدخول للاستدعاء | واجهة متوافقة مع OpenAI (يشير base_url إلى بوابة موحدة) | يضمن أن كلا الوضعين يمران عبر نفس مسار الشبكة |
| بيانات العينة | 20-100 طلب عمل حقيقي | غالبًا ما تكون أزمنة الاستجابة المقاسة بالبيانات الاصطناعية متفائلة أكثر من الواقع |
| طريقة الاستدعاء | stream=True |
لا يمكن قياس زمن أول token إلا بهذه الطريقة |
| التزامن | ابدأ بتزامن فردي ثم ارفعه تدريجيًا حتى ذروة العمل | لمراقبة تذبذب زمن الاستجابة تحت التزامن العالي |
| الفترة الزمنية | جولة في ذروة أيام العمل وجولة في فترة الهدوء | لاستبعاد فروق التحميل المرتبطة بالوقت |
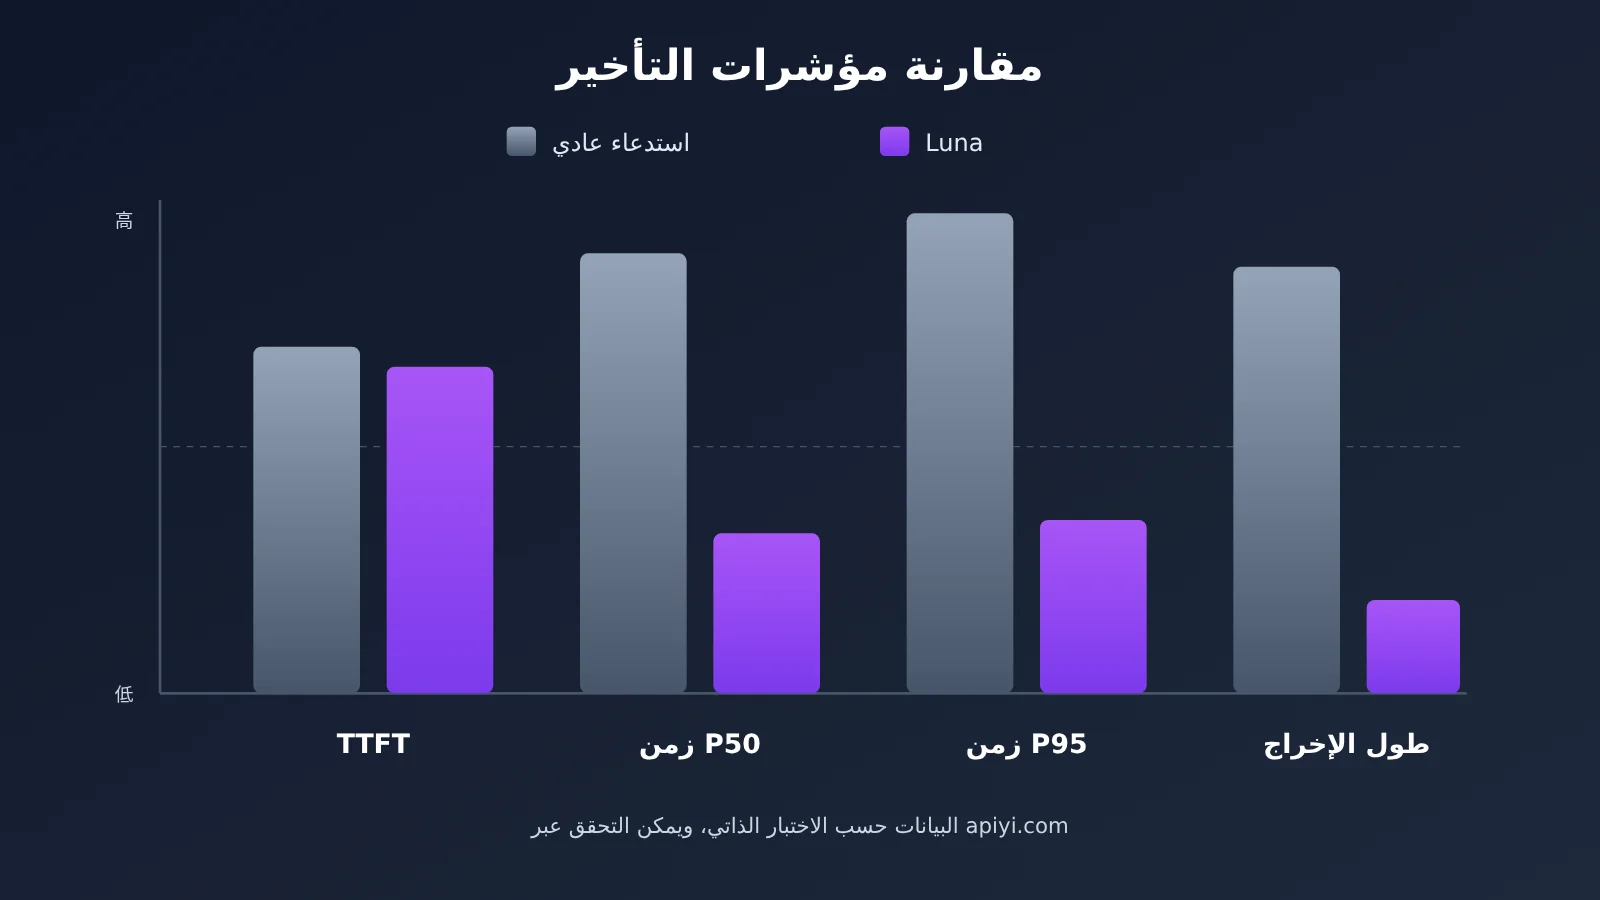
مؤشرات التأخير الأساسية
| المؤشر | المعنى | معيار التقييم |
|---|---|---|
| TTFT زمن أول رمز | المدة من إرسال الطلب حتى استلام أول حرف | الوضعان متقاربان عادةً، ويتأثران أساسًا بطول الإدخال |
| P50 إجمالي الزمن المستغرق | المدة التي تُنجَز خلالها نصف الطلبات | المؤشر الجوهري لميزة وضع القرار، وكلما اتسع الفارق كان التبديل أنفع |
| P95 إجمالي الزمن المستغرق | زمن الطلبات ذات الذيل الطويل | يحدّد الحد الأدنى لتجربة المستخدم، فلا بد من متابعته في الخدمات المتصلة بالإنترنت |
| متوسط طول الإخراج | عدد الأحرف أو الرموز (tokens) في كل استجابة | يفسّر سبب التسريع، ويرتبط مباشرة بالتكلفة |
| نسبة نجاح التنسيق | نسبة النتائج القابلة للتحليل المباشر | إعادة المحاولة بعد الفشل تلتهم الوقت الموفَّر |
كيف تقرأ نتائج تقييم Decisions API
إذا لاحظت أن زمن أول رمز (TTFT) شبه متطابق في الوضعين، بينما الفارق في P50 واضح، فهذا يعني أن التسريع ناتج فعلاً عن «توليد أقل»، وهو النتيجة الأكثر توافقًا مع التوقعات. عندها يمكنك أن تنتقل لمقارنة متوسط طول الإخراج، فكلما اتسع الفارق بينهما كان الوقت الموفَّر وتكلفة الإخراج أوفر.
أما إذا كان فارق P50 ضئيلاً بينما فارق P95 واضح، فهذا يعني أن الذيل الطويل في الاستدعاء العادي سببه الأساسي مخرجات طويلة عارضة. وفي هذه الحالة، حتى لو لم يكن متوسط الأداء مبهرًا، فإن الانتقال إلى GPT-6 Luna Decisions API يظل قادرًا على تحسين استقرار الخدمات المتصلة بالإنترنت بشكل ملحوظ.
وهناك حالة أخرى: ألا يكاد يوجد فرق بين الوضعين، وهذا يعني عادةً أن الموجهات (prompts) التي تستخدمها أصلًا مقتضبة ومضبوطة. وهنا تكمن قيمة التبديل أساسًا في موثوقية التنسيق، لا في السرعة.
💡 اقتراح للتحقق: يُستحسن اختبار العينة نفسها بالتبادل عبر البوابة نفسها. ونحن ننصح بتشغيل المقارنة مباشرةً عبر الواجهة الموحدة لـ APIYI على apiyi.com، تجنّبًا لتشويه النتائج الناتج عن اختلاف منافذ الشبكة.
ما هي الأعمال التي تناسبها واجهة GPT-6 Luna Decisions API
قيمة واجهات اتخاذ القرار لا تكمن في أن الاستدعاء الواحد أسرع بمئات المللي ثانية، بل في أن هذه المللي ثوانٍ تتضاعف عبر آلاف وملايين الطلبات في السيناريوهات عالية التكرار والبسيطة التي تحتاج إلى برامج تستهلك النتائج. يوضح الجدول التالي مدى ملاءمة خمسة أنواع من الأعمال النموذجية.
| سيناريو العمل | المخرجات النموذجية | درجة الملاءمة | ملاحظات |
|---|---|---|---|
| توجيه تذاكر خدمة العملاء | وسم القسم + درجة الثقة | عالية | حجم الطلبات كبير والخيارات ثابتة، لذا تتحقق مكاسب واضحة من السرعة والتنسيق |
| مراجعة أمان المحتوى | قبول / رفض / مراجعة بشرية | عالية | حساسة لزمن استجابة P95، ويجب أن تقود النتيجة العملية مباشرة |
| اختيار أدوات الوكيل | أي أداة تُستدعى ومع أي معاملات | عالية | في وكيل متعدد الخطوات يتم توفير الوقت في كل خطوة، فتتراكم المكاسب الإجمالية |
| الفحص الأولي للمخاطر ومكافحة الاحتيال | مستوى المخاطر | متوسطة | مناسب كأول مرحلة فرز، أما القرارات الحرجة فتحتاج إلى قواعد أو مراجعة بشرية كشبكة أمان |
| كتابة النصوص الطويلة / إنشاء التقارير | فقرات طويلة من اللغة الطبيعية | منخفضة | يتطلب مخرجات طويلة بطبيعته، لذا ليس السيناريو المستهدف لواجهات اتخاذ القرار |
مقارنة الحلول: Decisions API وحلول القرار الأخرى
لا يقتصر أداء مهام القرار على نماذج اللغة الكبيرة وحدها. يضع الجدول التالي GPT-6 Luna Decisions API إلى جانب عدة حلول شائعة للمقارنة.
| الحل | السمات الأساسية | السيناريوهات المناسبة | مستوى التأخير | المنصات المتاحة |
|---|---|---|---|---|
| GPT-6 Luna Decisions API | فهم نموذج لغة كبير + مخرجات قصيرة منظمة | قرارات ذات دلالات معقدة وخيارات واضحة | منخفض (حسب الاختبار الذاتي) | APIYI apiyi.com، وAPI الرسمي |
| استدعاء توليدي عادي | مرن، ويمكن أن يرفق تفسيرًا | قرارات منخفضة التكرار تحتاج إلى تبرير | متوسط إلى مرتفع، ويزيد بطول المخرجات | منصات نماذج اللغة الكبيرة الشائعة |
| تصنيف بنموذج صغير خفيف | رخيص وسريع، لكن فهمه محدود | تصنيفات بسيطة دلاليًا وبيانات موسومة كافية | منخفض | منصات نماذج اللغة الكبيرة الشائعة أو نشر ذاتي |
| محرك قواعد | استجابة بمستوى المللي ثانية وتحكم كامل | قواعد واضحة الشروط وشبه ثابتة | منخفض جدًا | بناء داخلي |
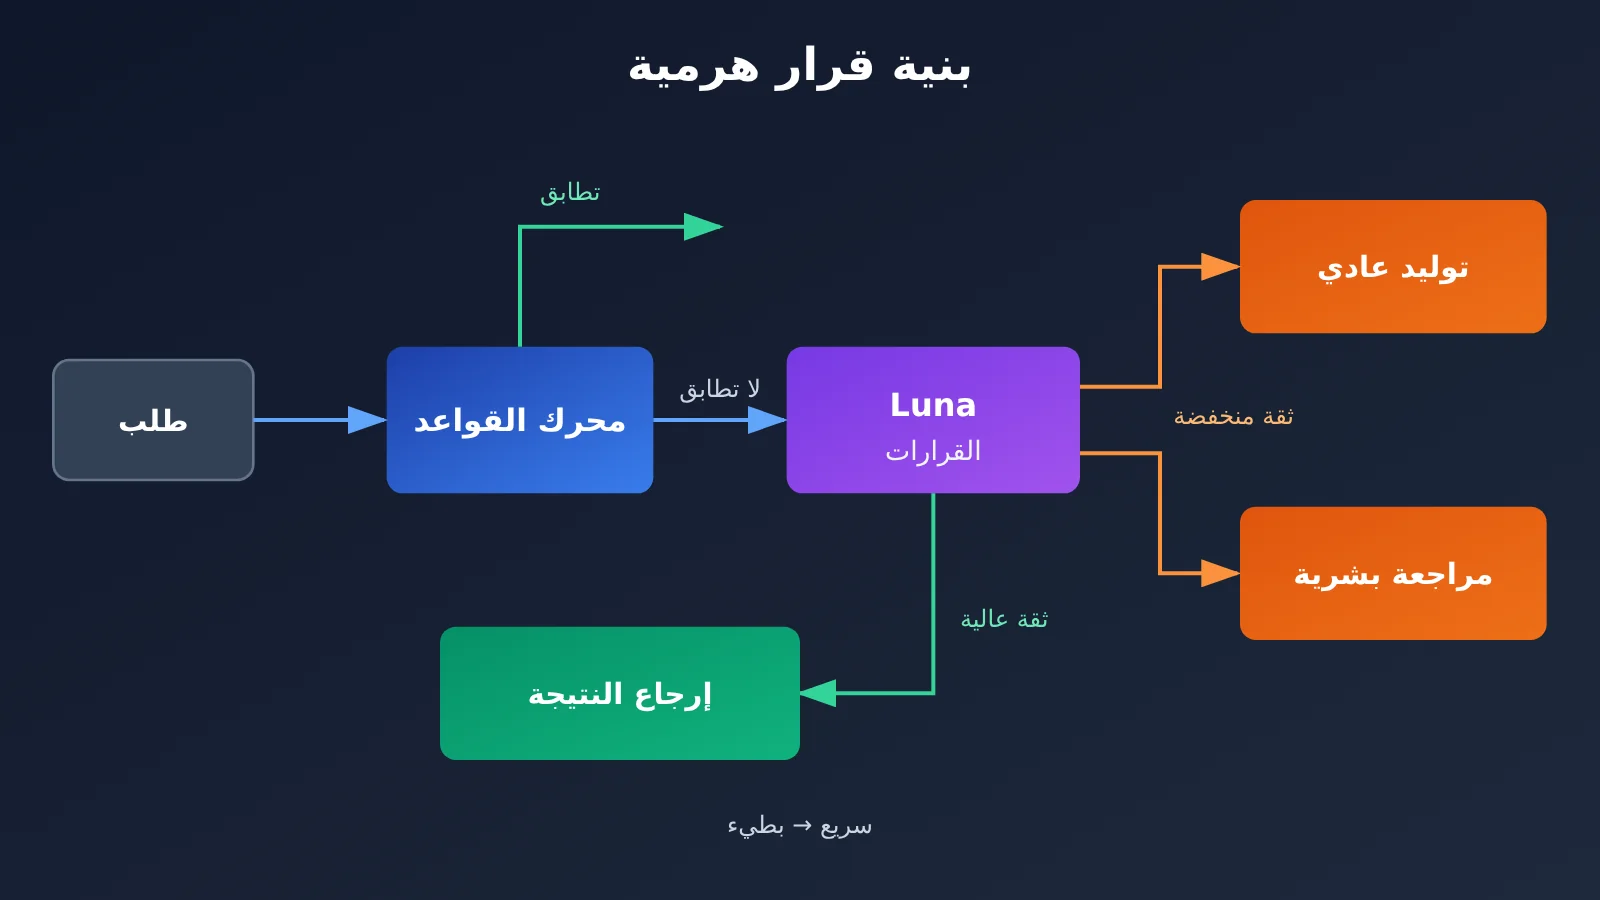
تحليل المقارنة: يحافظ محرك القواعد على تقدمه في السرعة والتحكم، لكن عندما تكون المدخلات عامية ومتغيرة الصياغة، ترتفع تكلفة صيانة القواعد بسرعة. ويتمتع النموذج الصغير الخفيف بميزة تكلفة واضحة، لكن فهمه للدلالات الغامضة والسياقات الطويلة غير كافٍ. وبالمقارنة، يناسب GPT-6 Luna Decisions API السيناريوهات التي تكون فيها “الدلالات معقدة لكن مساحة الإجابات محدودة”، وهو حل وسط بين القواعد والاستدعاء العادي لنموذج لغة كبير.
وفي الممارسة، الأكثر شيوعًا هو البنية الطبقية: يتولى محرك القواعد الشروط الواضحة، ويتولى GPT-6 Luna Decisions API الطلبات الغامضة، ولا نعود إلى الاستدعاء التوليدي العادي إلا عندما نحتاج إلى تفسير.
تحليل مزايا وعيوب واجهة GPT-6 Luna Decisions API
المزايا
- تحكم أفضل في إجمالي زمن التنفيذ: يتم ضغط المخرجات إلى نتيجة منظمة، ما يقلّص زمن مرحلة التوليد بشكل ملحوظ، ويجعل زمن الاستجابة في الحالات المتأخرة أكثر استقرارًا.
- نتائج قابلة للاستخدام مباشرة: بالاعتماد على JSON Schema، يمكن تمرير القيم المُعادة إلى سير العمل مباشرة، ما يقلل من كود التحليل وإعادة المحاولة عند الفشل.
- بنية تكلفة أكثر ملاءمة: تقليل رموز المخرجات يعني انخفاض تكلفة الإخراج بالتوازي، وهو أمر واضح خصوصًا في السيناريوهات عالية التكرار.
- حاجز دخول منخفض: يعتمد على بروتوكول متوافق مع OpenAI، لذا يكفي في الغالب تعديل اسم النموذج وقيود المخرجات في الكود الحالي للتبديل.
القيود
- لا يبرع في التفسير: نتيجة القرار نفسها لا تأتي مرفقة بالأسباب. وعند الحاجة إلى التدقيق، يمكن توجيه استدعاء عادي إضافي إلى العينات ذات الثقة المنخفضة للحصول على توضيح.
- نسبة التسريع تختلف حسب السيناريو: إذا كان الاستدعاء الأصلي ينتج تسمية واحدة فقط، فإن فائدة التبديل محدودة. يُنصح أولًا بقياس الأثر عبر سكربت تقييم قبل الانتقال.
- طول المدخلات لا يزال عقبة: الواجهة من نوع القرار تحسّن جانب المخرجات، أما الزمن المستغرق في التعبئة المسبقة للسياق الطويل جدًا فلن يختفي بفضلها، وعند الضرورة ينبغي تقليص المدخلات أو ضغطها عبر الاسترجاع.
- الاعتماد على جودة تصميم الخيارات: تعريف قيم التعداد بشكل غير واضح يجعل النموذج يتردد بين خيارات متقاربة، لذا يجب تقديم خيارات واضحة ومتنافية في الـ Schema.
الأسئلة الشائعة
س1: ما هو GPT-6 Luna Decisions API؟
هو أسلوب استدعاء مخصص للمهام القائمة على القرار، وجوهره أن يجعل النموذج يُخرج نتيجة حكم قصيرة ومنظمة من بين خيارات محددة، بدلاً من توليد نص طويل. يناسب هذا الأسلوب حالات التصنيف والتوجيه والمراجعة واختيار الأدوات وغيرها. وتُعتمد المعاملات الدقيقة وفقًا للتوثيق الرسمي.
س2: كم أسرع يكون Decisions API مقارنةً باستدعاء النموذج العادي؟
لا يوجد مُعامل تسريع موحّد. فالتسريع يأتي أساسًا من تقصير طول المخرجات، وكلما كان النص الأصلي أطول كان الاستفادة بعد التبديل أكبر. ننصح باستخدام سكربت القياس المرفق في هذا المقال لمقارنة إجمالي زمن التنفيذ عند P50 وP95 على عيّناتك الحقيقية، للوصول إلى نتيجة تناسب عملك.
س3: ما الفرق بين GPT-6 Luna Decisions API والاستدعاء العادي مع إخراج JSON؟
يمكن للاستدعاء العادي مع قيود JSON تحقيق تأثير مشابه، والفارق بينهما يعتمد على ما إذا كانت الجهة الرسمية قد أجرت تحسينات مخصصة لسيناريوهات القرار، مثل قوة الاستدلال وقيود المخرجات وجدولة الخدمة. ويبقى الاختبار الفعلي في ظروف متساوية هو الطريقة الأكثر موثوقية للحكم.
س4: ما الأعمال التي يُفضّل تبديلها أولاً؟
يُفضّل البدء بالأعمال ذات حجم الطلبات الكبير والفضاء الثابت للإجابات والحساسة لزمن التأخير، مثل توجيه تذاكر خدمة العملاء ومراجعة المحتوى واختيار أدوات الوكيل (Agent). أما الأعمال التي تتطلب مخرجات طويلة بطبيعتها مثل الكتابة الطويلة وتوليد التقارير فلا يُنصح بتبديلها.
س5: كيف أستدعي GPT-6 Luna Decisions API عبر API بسرعة؟
ننصح باتباع الخطوات التالية:
1. توجّه إلى APIYI على apiyi.com للتسجيل وإنشاء مفتاح API
2. تحقق من معرّف النموذج الفعلي لـ GPT-6 Luna في قائمة النماذج داخل لوحة التحكم
3. اضبط `base_url` في كود هذا المقال على `https://api.apiyi.com/v1` واستبدل اسم النموذج ثم شغّل الكود
تستخدم المنصة واجهة متوافقة مع OpenAI، فيكفي مفتاح واحد لاستدعاء بقية النماذج الشائعة في اختبارات المقارنة.
س6: كيف أتحكم في تكلفة استدعاء Decisions API؟
مخرجات نمط القرار توفّر رموز الإخراج (tokens) بطبيعتها، ويمكن تحسينها أكثر من ثلاثة جوانب: تقليص السياق غير الضروري، واستخدام محرك قواعد لاعتراض الطلبات الواضحة، وإجراء استدعاء ثانٍ فقط للعيّنات منخفضة الثقة. ويمكنك في لوحة تحكم APIYI على apiyi.com عرض تفاصيل الاستخدام حسب النموذج، لتحديد أكبر مصادر التكلفة بسهولة.
س7: ما القيود المعروفة لـ GPT-6 Luna Decisions API؟
القيود الأساسية هي أنه لا يقدّم أسبابًا للقرار، وأن التسريع يعتمد على طول المخرجات الأصلية، وأن زمن التعبئة المسبقة (prefill) للمدخلات الطويلة جدًا لا يمكن إزالته. وفي القرارات عالية المخاطر مثل المالية والطبية، يُنصح باستخدامه كوسيلة مساعدة للحكم مع الإبقاء على مرحلة مراجعة بشرية.
GPT-6 Luna Decisions API: النقاط الأساسية
- تموضع واضح: تُعالج Decisions API مهمة “اتخاذ قرار سريع من بين خيارات محدودة”، وليس توليد النصوص الطويلة.
- مصدر التسريع: يأتي أساسًا من تقصير المخرجات؛ فكلما كانت مخرجاتك الأصلية أطول، كان العائد من التبديل أوضح.
- المؤشرات الرئيسية: ركّز على إجمالي زمن التنفيذ P50 وP95؛ إذ يكون TTFT متقاربًا عادةً في الوضعين.
- أفضل السيناريوهات: مهام القرار عالية التكرار مثل توجيه تذاكر الدعم، ومراجعة المحتوى، واختيار أدوات الوكيل (Agent).
- البنية الموصى بها: محرك قواعد + Decisions API + الاستدعاء العادي، ضمن حل احتياطي متعدد الطبقات.
- طريقة البدء: شغّل سكربت مقارنة عبر واجهة موحّدة متوافقة مع OpenAI، ثم انتقل بناءً على بيانات اختبارك الخاصة.
الخلاصة
النقاط الأساسية في GPT-6 Luna Decisions API:
- السرعة من قلة التوليد: ميزة السرعة لديها تأتي أساسًا من المخرجات القصيرة المنظمة، وليس من تحسين سرعة توليد الرمز الواحد (token).
- القيمة تعتمد على السيناريو: الأعمال عالية التكرار وذات الخيارات الثابتة والحساسة لزمن الاستجابة هي الأكثر استفادة، أما سيناريوهات النصوص الطويلة فلا تناسبها.
- الاستنتاج يعتمد على القياس الفعلي: تتفاوت نسب التسريع بشكل كبير حسب الموجهات والعينات، لذا احرص على استخراج P50 وP95 من بيانات حقيقية.
إذا كنت تعمل على توجيه خدمة العملاء أو مراجعة المحتوى أو تنسيق الوكلاء (Agent)، فإن GPT-6 Luna Decisions API تستحق تقييمًا جديًا. ننصح بالإبقاء على الاستدعاء الأصلي كمجموعة تحكم، ثم تحويل جزء من حركة المرور بشكل تدريجي، وبعد ذلك تقرر ما إذا كنت ستنتقل بالكامل بناءً على زمن الاستجابة ومعدل نجاح التنسيق.
نوصي بالحصول على حصة مجانية عبر APIYI على apiyi.com، واستخدام سكربت هذا المقال للتحقق سريعًا من تأثير التسريع الحقيقي في سيناريو أعمالك.
📚 المراجع
- وثائق OpenAI API الرسمية: شرح استدعاء النماذج، والإخراج المتدفق، والإخراج المنظم
- الرابط:
platform.openai.com/docs -
الوصف: المصدر الموثوق للتأكد من المعاملات المتعلقة بـ GPT-6 Luna وDecisions
-
OpenAI Python SDK: العميل الرسمي للغة Python
- الرابط:
github.com/openai/openai-python -
الوصف: حزمة SDK المستخدمة في سكربت الاختبار لهذا المقال، وتتضمن أمثلة على الاستدعاء المتدفق
-
معيار JSON Schema: المعيار المعتمد لتعريف قيود الإخراج المنظم
- الرابط:
json-schema.org - الوصف: المرجع المعياري عند تصميم خيارات القرارات وقيم التعداد
الكاتب: فريق APIYI التقني
التواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI، ولمزيد من مواد التكامل يمكنكم زيارة مركز التوثيق docs.apiyi.com