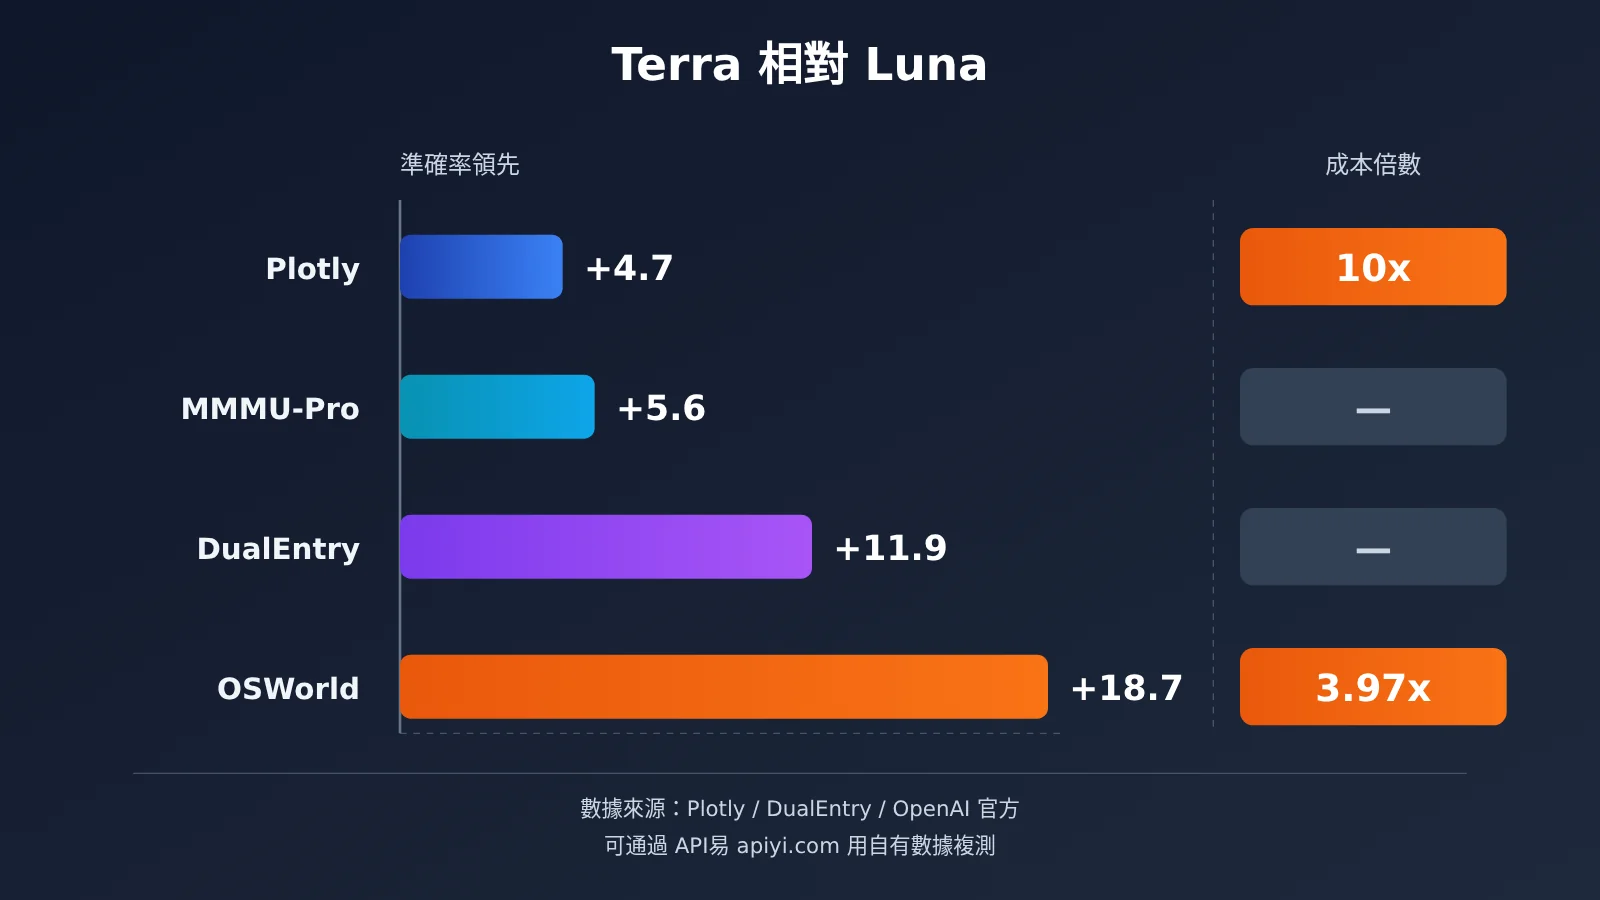
作者注:Terra 的 Token 單價是 Luna 的 10 倍,準確率差距卻從 4.7 到 18.7 個百分點不等。本文用 Plotly、DualEntry、OSWorld 等真實測試數據,算清批量自動化中“每個正確結果”的真實成本。
OpenAI 於 2026 年 10 月 26 日發佈 GPT-6.1 Terra。距離 GPT-6 Luna 上線,只隔了一個多月。兩款模型的 API 定價差了 整整 10 倍,但在第三方同場測試裏,Terra 的準確率領先幅度卻從不足 5 個百分點到接近 19 個百分點不等。批量自動化場景裏,這個差價到底值不值,成了開發者討論最多的問題。
這不是憑印象寫的模型點評。Plotly、DualEntry、Artificial Analysis 在 Terra 發佈當天就公開了測試結果,OpenAI 官方也給出了 OSWorld 2.1、MMMU-Pro 和事實錯誤率數據。本文把這些數據放在一起,回答一個具體問題:多花的錢,到底換來了多少真正有用的正確結果。
核心價值:讀完本文,你會知道 GPT-6.1 Terra 和 GPT-6 Luna 在哪類批量任務上差距大、在哪類任務上幾乎沒差距,還會拿到一套“Luna 初篩 + 規則校驗 + Terra 兜底”的混合方案代碼。
GPT-6.1 Terra 和 GPT-6 Luna 核心信息速覽
兩款模型同屬 GPT-6 家族,但定位明顯不同。OpenAI 官方對 Luna 的描述是面向明確、高頻、大批量任務的高效率模型;Terra 則主打視覺推理、準確的電腦操作和自然的寫作,用來填補 Luna 和 Sol 之間的中間檔位。
| 信息項 | GPT-6 Luna | GPT-6.1 Terra |
|---|---|---|
| 發佈時間 | 2026 年 9 月 22 日 | 2026 年 10 月 26 日 |
| API ID | gpt-6-luna |
gpt-6.1-terra |
| 官方定位 | 高頻、大批量、規則清晰的任務 | 視覺推理、電腦操作、多步驟任務 |
| 上下文 / 最大輸出 | 1,050,000 / 128,000 Token | 1,050,000 / 128,000 Token |
| 推理強度 | none 到 max 共 6 檔,默認 medium | none 到 max 共 6 檔,默認 medium |
| 典型場景 | 標籤分類、郵件分流、字段抽取 | 發票錄入、商品圖匹配、界面操作 |
從規格上看,兩者幾乎“長得一樣”:都支持文本和圖片輸入、Structured Outputs、Function Calling、Responses API、Batch API,以及 Web Search、File Search、Computer Use 等工具。真正的區別在兩處,一是價格,二是複雜任務上的能力。
值得一提的是,OpenAI 的模型選擇指南並沒有說“批量任務就用 Luna”或者“要準確率就用 Terra”。官方的建議是:拿同一批真實輸入去測,選能滿足質量要求的最低成本配置。這句話也是理解本文所有數據的前提。
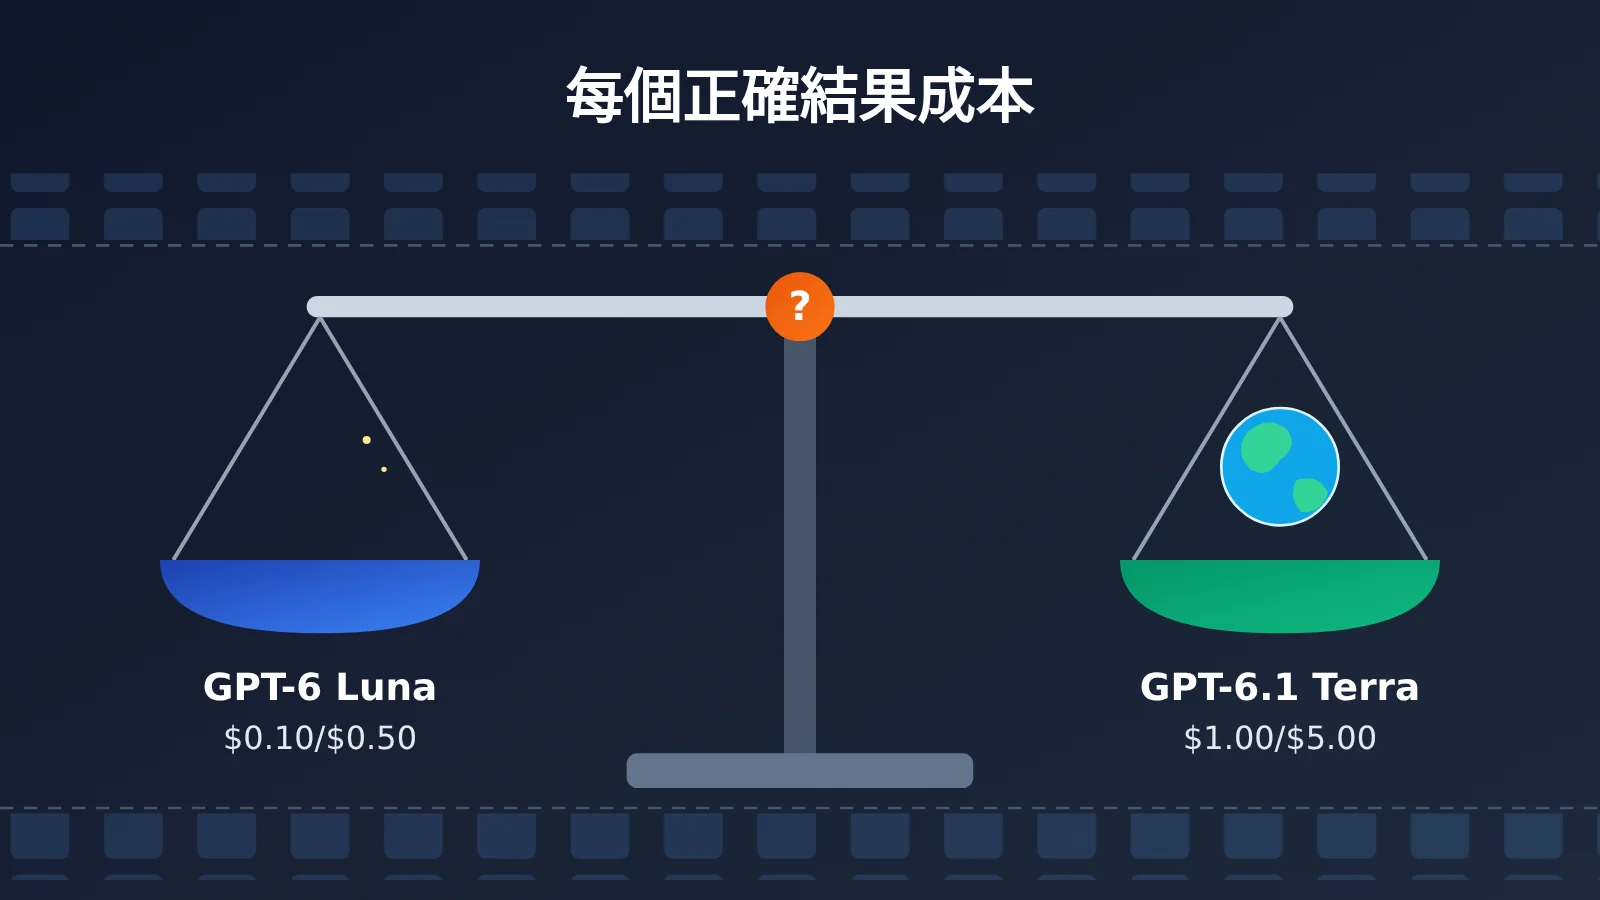
GPT-6.1 Terra 與 GPT-6 Luna 的 API 價格差距
按 OpenAI 官方 Standard API 短上下文價格,單位爲美元 / 每百萬 Token:
| 費用項目 | GPT-6 Luna | GPT-6.1 Terra | Terra / Luna |
|---|---|---|---|
| 輸入 Token | $0.10 | $1.00 | 10 倍 |
| 緩存輸入 | $0.01 | $0.05 | 5 倍 |
| 輸出 Token | $0.50 | $5.00 | 10 倍 |
| 30 分鐘緩存寫入 | $0.125 | $1.25 | 10 倍 |
| Batch 輸入 / 輸出 | 約 $0.05 / $0.25 | 約 $0.50 / $2.50 | 10 倍 |
Batch 和 Flex 模式的費率約爲 Standard 的一半,Fast 模式約爲兩倍。有兩個費用容易被忽略。第一,單次請求輸入超過 272,000 Token 時,整次請求的輸入和緩存按兩倍計費,輸出按 1.5 倍計費。第二,網頁搜索、電腦操作等工具可能另外收費,推理 Token、重試和多輪 Agent 調用也會改變實際消耗。
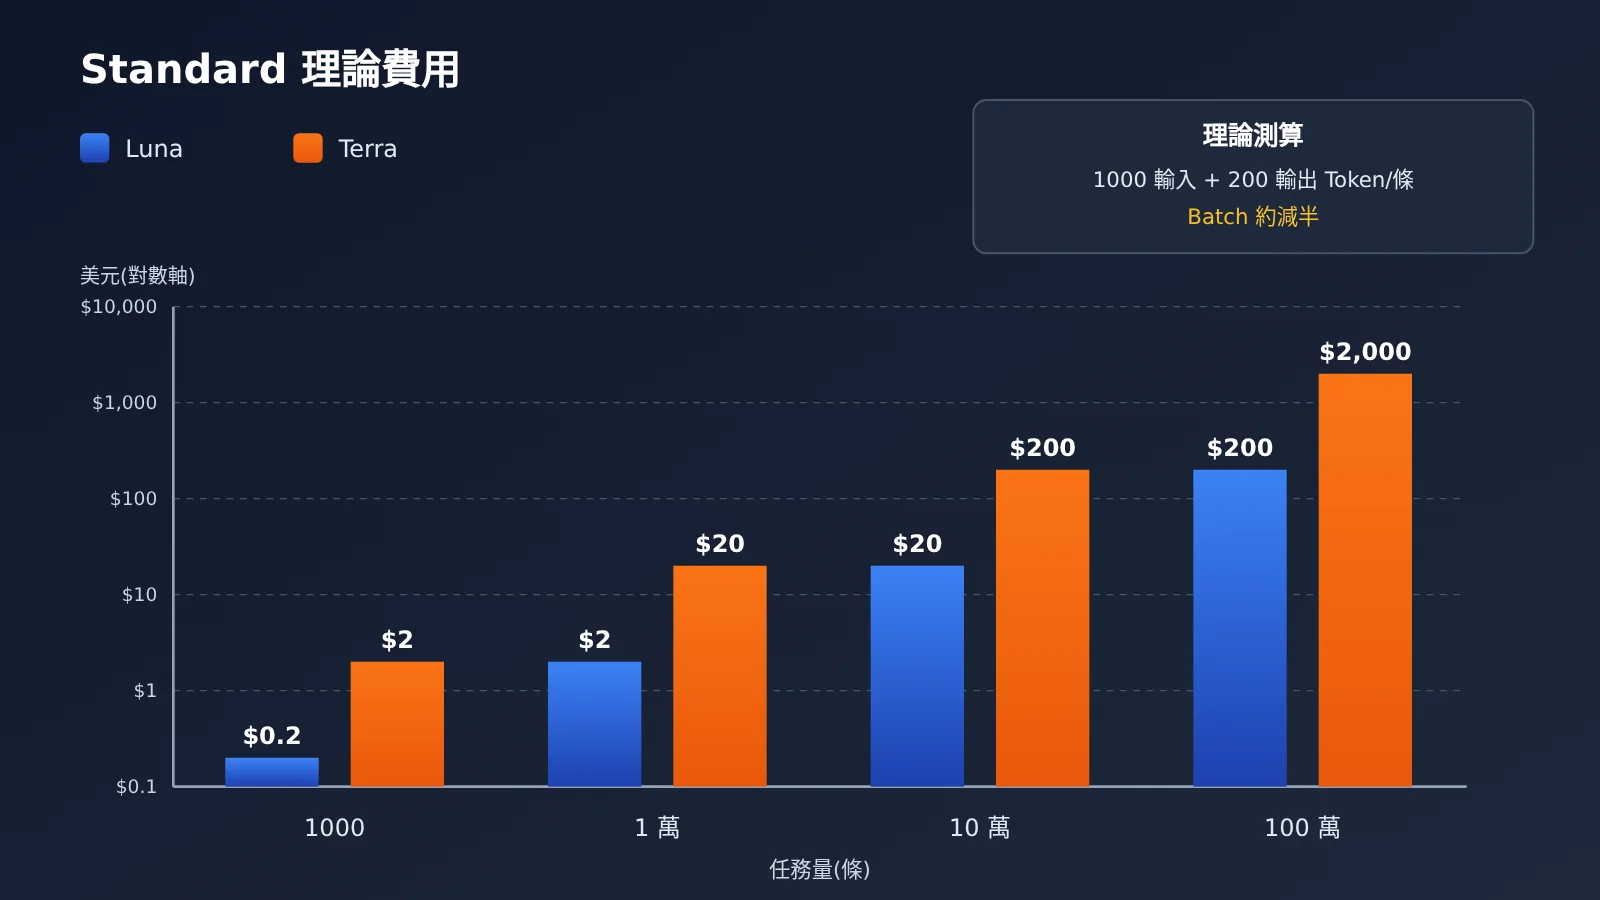
所以“貴 10 倍”指的是同等計費條件下的 Token 單價,不代表每項工作都貴 10 倍。做個理論測算:假設每條記錄輸入 1000 Token、輸出 200 Token,不用緩存、不重試,處理 10 萬條在 Standard 模式下 Luna 約 $20,Terra 約 $200;換成 Batch 約爲 $10 和 $100。這只是按公開單價算出來的理論值,不是實測賬單。
GPT-6.1 Terra 對比 GPT-6 Luna:4 組真實測試數據
單價只能說明“花多少”,接下來要看“換來什麼”。下面四組數據來自不同機構,測試的任務類型也不同,正好能看出準確率差距是怎麼隨任務難度拉開的。
Plotly 43 道數據分析題:多花 10 倍,多對 2 題
Plotly 和 Mila 研究人員開發的 DataAnalyticsBench,模擬一家風力發電運營企業的數據倉庫,約 2000 萬行數據,底層是合成數據。兩款模型用同一套工具回答 43 道問題,結果如下:
| 指標 | GPT-6 Luna | GPT-6.1 Terra |
|---|---|---|
| 正確題數 | 38/43(88.4%) | 40/43(93.0%) |
| 全部測試費用 | $0.13 | $1.31 |
| 每題中位耗時 | 18 秒 | 15 秒 |
| 普通分析 / 模糊問題 / 不可能請求 / 數據質量 | 全部滿分 | 全部滿分 |
| 統計陷阱 | 3/5 | 4/5 |
| 隱藏模式發現 | 2/5 | 3/5 |
最有價值的發現在分項成績裏。普通分析、識別模糊需求、拒絕無法完成的請求、發現基礎數據質量問題,兩者表現完全一致。差距只出現在統計陷阱和隱藏模式發現這兩類深層分析上,Terra 各多做對一題。
按整體結果粗算,Terra 多花 $1.18,多對 2 題,相當於每淨增一道正確答案額外支付約 $0.59。這是從測試總賬推出的邊際成本,不是生產環境的穩定糾錯價格。如果這道題關係到經營判斷,$0.59 很便宜;如果只是內部報表裏多發現一個無關緊要的模式,10 倍成本就沒必要。
另外一個細節:Terra 每題更快,但原因是回答更短、調用更少(平均約 4.5 次模型調用、約 1460 個輸出 Token),而不是生成速度更快。它的輸出速度約爲每秒 64 Token。需要注意,樣本只有 43 題,Terra 通過 OpenRouter 默認推理配置運行,不能推出它在所有企業數據分析中都有 93% 的準確率。
DualEntry 101 項會計任務:差距擴大到 11.9 個百分點
DualEntry 的 Accounting AI Benchmark 更接近真實業務操作。101 個任務覆蓋交易分類、會計分錄、應付應收、銀行對賬、財務報告、月末結賬和會計知識八類,每個模型跑三輪,三次中至少兩次通過纔算通過。
結果是 Luna 66.3%,Terra 78.2%,作爲參照的 GPT-6.1 Sol 爲 81.2%。Terra 的細分成績裏,交易分類 13/13,會計分錄 12/13,銀行對賬 10/12,但應付賬款只有 7/13,應收賬款和月末結賬都是 7/12。DualEntry 還提到,在應付賬款項目上 Terra 和 Luna 並列末位。
對批量自動化來說,比單次準確率更關鍵的是穩定性。Terra 三輪全部做對的比例是 65.3%,Sol 是 68.3%,Luna 更低(原文未給出具體數值)。如果同一種會計任務今天對、明天錯,人工排查的成本會迅速上升。Terra 在該測試中平均每項任務耗時 16.1 秒、Token 成本約 $0.042,三輪合計約 $12.73;Luna 的對應成本原文沒有清楚披露,這裏不做推算。
OSWorld 2.1 與事實錯誤率:複雜任務差距最大
OpenAI 在 Terra 發佈公告中給出的桌面操作基準 OSWorld 2.1,考察模型能否看懂界面、點對按鈕、完成多步驟操作。最高推理檔下,Luna 55.5%,Terra 74.2%,差距 18.7 個百分點;每任務估算成本分別爲 $0.30 和 $1.19,只差約 3.97 倍,而不是 10 倍。原因是不同模型完成同一任務消耗的 Token 不同。
事實錯誤率測試的結果更有衝擊力。在官方專門設計的困難事實題上,Luna 在 Low / Medium / Max 三檔的錯誤率分別是 44.3%、31.2%、18.4%,Terra 是 16.7%、10.1%、4.3%。Terra 在 Low 檔的錯誤率,仍低於 Luna 開到 Max 的錯誤率。 視覺理解方面,MMMU-Pro 最高推理檔下 Luna 79.9%,Terra 85.5%。
這些數據都來自 OpenAI 官方圖表,不是第三方獨立複測。困難事實題是專門誘導出錯的題目,不代表 Luna 日常寫作有 44.3% 的錯誤率;OSWorld 的分數也只適用於其測試條件。
Artificial Analysis 綜合指數:推理強度同樣要優化
Artificial Analysis 的獨立評測給出另一個視角。Max 檔下綜合智能指數 Luna 約 38,Terra 約 48,對應綜合基準成本約 $0.07 和 $0.40,約 5.7 倍。編程代理指數差距更大,Luna 31,Terra 48。
但長文檔理解 AA-LCR 是個反例,兩者在最高推理設置下都約 83%。另外,Terra 在 Low 和 Medium 檔位處於該機構測試範圍內的“成本—能力”帕累託前沿,到了 Max 檔反而未必最優。換句話說,批量自動化要調的不只是模型,還有推理強度。
GPT-6.1 Terra 和 GPT-6 Luna 批量自動化快速上手
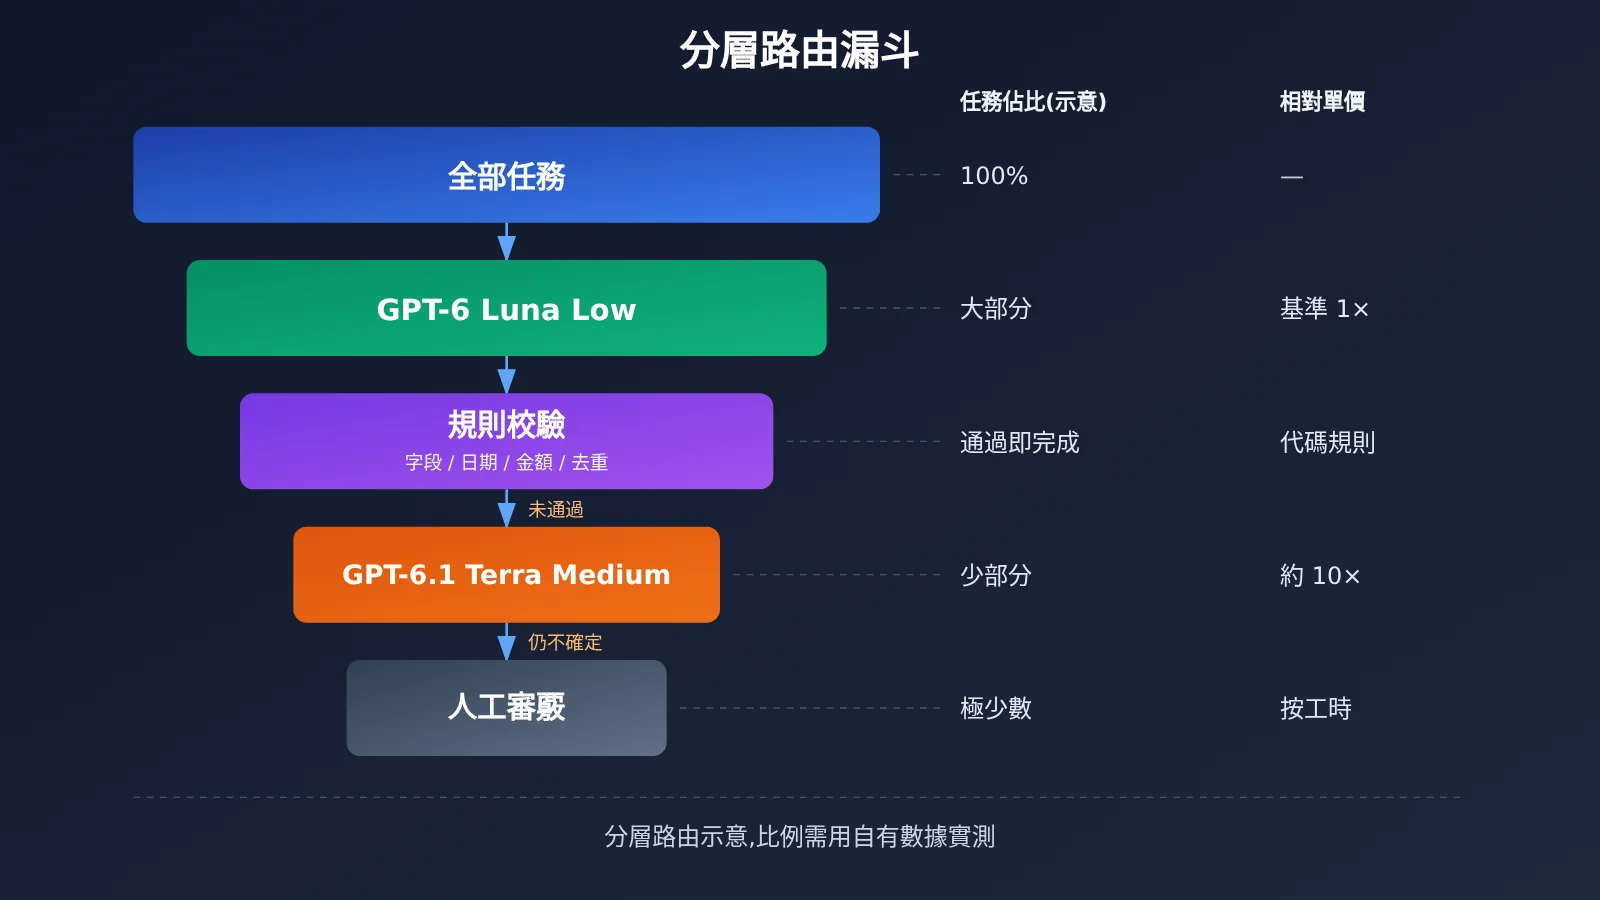
把上面的數據放在一起,會得到一個很實際的結論:大部分規則清晰的任務交給 Luna,少數複雜、高風險或未通過校驗的任務再升級到 Terra。下面是一個最小可運行示例,先讓 Luna 抽取發票字段,再用程序規則校驗,不合格才交給 Terra。
import json, openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

def extract(model, text, effort="low"):
    r = client.chat.completions.create(
        model=model, reasoning_effort=effort,
        response_format={"type": "json_object"},
        messages=[{"role": "user", "content": f"抽取 JSON:amount, tax, total, date\n{text}"}])
    return json.loads(r.choices[0].message.content)

def valid(d):
    return all(k in d for k in ("amount", "tax", "total", "date")) and \
        abs(float(d["amount"]) + float(d["tax"]) - float(d["total"])) < 0.01

result = extract("gpt-6-luna", "發票:金額 100.00,稅額 6.00,合計 106.00,日期 2026-10-20")
if not valid(result):
    result = extract("gpt-6.1-terra", "...", effort="medium")
print(result)
查看完整分層路由實現代碼
import json
import re
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

PROMPT = "從以下文本抽取 JSON,字段:amount, tax, total, date(YYYY-MM-DD)。缺失填 null。\n"

def call_model(model: str, text: str, effort: str = "low") -> Optional[dict]:
    try:
        resp = client.chat.completions.create(
            model=model,
            reasoning_effort=effort,
            response_format={"type": "json_object"},
            messages=[{"role": "user", "content": PROMPT + text}],
        )
        return json.loads(resp.choices[0].message.content)
    except Exception as e:
        print(f"[{model}] 調用失敗: {e}")
        return None

def rule_check(d: Optional[dict]) -> list:
    """程序化規則校驗:結構化輸出只保證格式,不保證事實,所以必須二次校驗"""
    if not d:
        return ["empty"]
    errors = []
    for k in ("amount", "tax", "total", "date"):
        if d.get(k) is None:
            errors.append(f"missing:{k}")
    if not errors:
        if abs(float(d["amount"]) + float(d["tax"]) - float(d["total"])) > 0.01:
            errors.append("sum_mismatch")
        if not re.match(r"^\d{4}-\d{2}-\d{2}$", str(d["date"])):
            errors.append("bad_date")
    return errors

def route(text: str) -> dict:
    # 第一層:Luna Low 處理全部輸入
    d = call_model("gpt-6-luna", text, "low")
    if not rule_check(d):
        return {"data": d, "tier": "luna"}
    # 第二層:未通過校驗的升級到 Terra Medium
    d = call_model("gpt-6.1-terra", text, "medium")
    errs = rule_check(d)
    if not errs:
        return {"data": d, "tier": "terra"}
    # 第三層:仍不確定的進入人工審覈隊列
    return {"data": d, "tier": "human_review", "errors": errs}

if __name__ == "__main__":
    samples = [
        "發票號 A001,金額 100.00 元,稅額 6.00 元,價稅合計 106.00 元,開票日期 2026-10-20",
        "收據:總計一百零六元整,含稅,十月二十日",
    ]
    for s in samples:
        print(route(s))
🚀 快速開始:官方推薦先用一個 API Key 同時調通兩款模型,再跑自己的樣本。API易 apiyi.com 提供 OpenAI 兼容接口,
gpt-6-luna和gpt-6.1-terra只需切換model參數,新用戶有免費測試額度,適合先做小規模對照實驗。
這個結構的關鍵在第二步。不要把“Luna 說自己很有把握”當成正確依據,模型自報的置信度未必可靠。優先用可驗證的規則:字段是否缺失、日期是否合法、金額能否對上、關鍵字段是否與原文一致、是否有重複記錄。
GPT-6.1 Terra 與 GPT-6 Luna 的影響分析
對開發者的影響:按任務類型分流
結合官方定位和上述測試,可以給常見批量任務一個初始選擇。注意這是基於公開評測給出的建議,不是這些場景都已有實測證明,上線前仍需用自己的數據驗證。
| 業務場景 | 初始推薦 | 理由 | 可用平臺 |
|---|---|---|---|
| 十萬篇文章打標籤 | GPT-6 Luna | 規則清楚、可抽樣檢驗,Plotly 普通分析兩者滿分 | API易 apiyi.com、OpenAI 官方 |
| 發票 / 訂單截圖錄入 | GPT-6.1 Terra | 視覺與操作能力領先,金額仍需程序覈驗 | API易 apiyi.com、OpenAI 官方 |
| 每日 AI 新聞彙總 | Luna 初篩 + Terra 精讀 | 去重和打標籤交給 Luna,判斷重要性交給 Terra | API易、OpenAI 官方 |
| 客服郵件分流與草稿 | Luna 爲主 | 投訴、退款等高風險工單升級或轉人工 | API易、OpenAI 官方 |
| 批量改網頁與代碼 | Terra 或 Sol | 編程代理指數 Terra 48、Luna 31 | API易、OpenAI 官方 |
另一個開發者容易忽略的點是吞吐量。在官方列出的 Build 檔位,Luna 的每分鐘 Token 限額是 200 萬、Batch 隊列上限 2000 萬,而 Terra 分別是 100 萬和 300 萬;Launch 檔位 Luna 爲 1000 萬和 10 億,Terra 爲 400 萬和 2 億。十萬條以上的批量任務,Luna 能排進隊列的量明顯更大。不過這是額度上限,不是生成速度,具體賬戶的限制也可能不同。
對行業的影響:從“比單價”轉向“比合格結果成本”
Terra 發佈當天,Reddit 社區出現了兩種聲音。一部分人認爲 Terra 定位尷尬,Luna 已經足夠便宜,Sol 又更強;另一部分人指出,Terra Low 的事實錯誤率已經低於 Luna Max,不能只看單價。也有 Codex 用戶反饋,高推理強度的 Terra 額度消耗不一定比中等強度的 Sol 更低,而 Luna 用戶在複雜開發任務中被返工抵消了額度優勢。這些都是個案,而且 Codex 訂閱額度和 API Token 計費不是一回事,不能用來推算 API 費用。
但它們指向同一個趨勢:衡量批量自動化的指標,正在從“一次調用多少錢”變成“每個合格結果多少錢”。可以用一個簡單的公式來理解:
總成本 = API 調用成本 + 工具成本 + 重試成本 + 人工審覈成本 + 錯誤損失
Luna 在前兩項上有絕對優勢,Terra 則通過更低的錯誤率壓縮後三項。哪一邊划算,取決於你的業務裏一次錯誤值多少錢。MultiAI 的小樣本觀察也印證了這一點:Terra 關閉推理時部分邏輯和計算任務會出錯,切到 Medium 後明顯改善;Luna 在簡單任務上表現好,在多步驟邏輯上錯誤更多。
自己做一輪對照實驗的方法
公開數據還沒有回答幾個關鍵問題:兩款模型在十萬條真實中文文章分類上的錯誤率、長期運行的穩定性、混合方案到底能省多少錢、人工複覈成本能否抵消 Terra 的溢價。這些只能靠自己測。
比較可行的做法是準備 200 到 500 條帶標準答案的真實業務樣本,例如簡單分類、關鍵信息抽取、複雜內容識別各 100 條,事實覈查和多步驟工具操作各 50 條。然後在相同輸入、相同提示詞、相同工具和相同判定標準下,分別跑 Luna Low、Luna Medium、Terra Low、Terra Medium 四個配置,部分任務重複多次以觀察穩定性。
最後重點看五個結果:準確率、每 1000 條的 API 成本、平均耗時與 P95 耗時、人工複覈與返工次數,以及每 1000 項合格結果的綜合成本。如果通過第三方平臺部署,還要以該平臺的實際結算規則爲準,並確認數據處理條款和合規要求。
常見問題 FAQ
Q1:GPT-6.1 Terra 和 GPT-6 Luna 的核心區別是什麼?
兩者規格幾乎相同,上下文都是 1,050,000 Token,工具支持也一致。區別在於 Luna 單價低 10 倍,適合規則清晰的高頻任務;Terra 在視覺理解、電腦操作、複雜分析和事實準確性上明顯更強,適合多步驟、高錯誤代價的任務。
Q2:Terra 貴 10 倍,準確率是不是隻高一點點?
要看任務類型。Plotly 數據分析測試中只領先約 4.7 個百分點,DualEntry 會計任務中領先 11.9 個百分點,OSWorld 桌面操作中領先 18.7 個百分點。而且 OSWorld 中每任務成本只差約 3.97 倍,並不是固定的 10 倍。
Q3:把 Luna 的推理強度開到 max,能代替 Terra 嗎?
能改善部分表現,但跨不過模型能力差距。官方困難事實題中,Luna Max 錯誤率 18.4%,仍高於 Terra Low 的 16.7%。同時,提高推理強度會增加 Token 消耗,可能讓 Luna 失去成本優勢。
Q4:如何通過 API 快速對比兩款模型?
建議用同一套代碼切換模型名做對照:
1. 訪問 API易 apiyi.com 註冊並獲取 API Key 和免費測試額度
2. 將 base_url 設爲 `https://api.apiyi.com/v1`
3. 分別以 `gpt-6-luna` 和 `gpt-6.1-terra` 跑同一批樣本,記錄準確率和 Token 消耗
Q5:大批量任務怎樣進一步降低成本?
不需要實時返回的任務優先用 Batch API,費率約爲 Standard 的一半,官方提供 24 小時處理窗口;同時控制單次輸入在 272,000 Token 以內,避免觸發長上下文加價。在 API易 apiyi.com 上按量計費,也便於先用小批量摸清每條任務的真實 Token 消耗再放量。
Q6:這些測試結果有哪些侷限?
Plotly 只有 43 題且使用合成數據;OSWorld、MMMU-Pro 和事實錯誤率來自 OpenAI 官方,不是獨立複測;MultiAI 的 24/24 和 18/18 使用的不是同一套題,不能直接比較。另外,Structured Outputs 只保證格式正確,不保證字段內容屬實,任何基準分數都不能等同於你業務中的真實準確率。
GPT-6.1 Terra 和 GPT-6 Luna 核心要點 Key Takeaways
- 單價差 10 倍:Luna 輸入 $0.10、輸出 $0.50,Terra 爲 $1.00 和 $5.00
- 簡單任務差距小:Plotly 普通分析、模糊問題識別等項目兩者均爲滿分
- 複雜任務差距大:會計任務領先 11.9 點,桌面操作領先 18.7 點
- 事實準確性分化:Terra Low 錯誤率 16.7%,低於 Luna Max 的 18.4%
- 推理強度也要調:Terra Low / Medium 在成本效率上優於其 Max 檔
- 分層路由最划算:Luna 初篩、規則校驗、Terra 兜底、人工複覈
- 先測再上線:用 200 到 500 條自有樣本,在 API易 apiyi.com 上跑四種配置對照
總結
回到標題的問題,GPT-6.1 Terra 和 GPT-6 Luna 誰更適合批量自動化,答案取決於任務難度和錯誤代價:
- 規則清晰、可自動校驗的任務:Luna 是低成本起點,Plotly 測試中兩者在常規分析上表現一致。
- 視覺識別、多步驟操作、財務等高風險任務:Terra 的額外成本有合理性,準確率領先最多可達 18.7 個百分點。
- 真正的優化目標:不是單次 API 價格,而是每個合格結果的綜合成本,包括重試、審覈和錯誤損失。
對多數團隊來說,更好的做法不是二選一,而是讓 Luna 處理大多數簡單工作,讓 Terra 解決真正困難的那部分。建議先用自己的業務樣本做一輪小規模對照,再決定分流比例。
推薦通過 API易 apiyi.com 快速驗證兩款模型在你業務上的表現,一個 Key 即可切換模型,按量計費,便於精確覈算每千條任務的成本。
📚 參考資料
- OpenAI:Introducing GPT-6.1 Terra:發佈公告,含 OSWorld、MMMU-Pro、事實錯誤率圖表
- 鏈接:
openai.com/index/introducing-gpt-6-1-terra -
說明: Terra 官方定位和基準數據來源
-
OpenAI API Pricing 與模型頁:Luna、Terra 的價格、能力和速率限制
- 鏈接:
developers.openai.com/api/docs/pricing -
說明: Standard、Batch、Flex、Fast 定價依據
-
OpenAI Batch API 文檔:批處理成本與處理窗口
- 鏈接:
developers.openai.com/api/docs/guides/batch -
說明: 大批量異步任務的降本方式
-
Plotly:GPT-6.1 Terra Benchmark Results for Data Analysis:43 道同場數據分析測試
- 鏈接:
plotly.com/blog/gpt-6-1-terra-plotly-data-analytics-bench -
說明: 準確率、費用、耗時和分項成績
-
DualEntry:GPT-6.1 Terra Accounting Benchmark:101 項會計任務測試
- 鏈接:
dualentry.com/blog/gpt-6-1-terra-accounting-benchmark -
說明: 準確率、任務分類與三輪穩定性
-
Artificial Analysis:GPT-6.1 Terra 評測:綜合智能指數與成本效率
- 鏈接:
artificialanalysis.ai/models/releases/gpt-6-1-terra - 說明: 不同推理強度下的獨立測試記錄
作者: APIYI 技術團隊
技術交流: 歡迎在 API易 官網首頁聯繫我們,更多模型接入資料可訪問 docs.apiyi.com 文檔中心