Nota del autor: el precio por token de Terra es 10 veces mayor que el de Luna, pero la diferencia de precisión oscila entre 4,7 y 18,7 puntos porcentuales. En este artículo usamos datos de pruebas reales de Plotly, DualEntry y OSWorld para calcular el coste real de «cada resultado correcto» en la automatización por lotes.
OpenAI lanzó GPT-6.1 Terra el 26 de octubre de 2026, poco más de un mes después de la llegada de GPT-6 Luna. El precio de sus API difiere nada menos que 10 veces, pero en pruebas comparativas de terceros la ventaja de Terra en precisión va desde menos de 5 hasta casi 19 puntos porcentuales. En la automatización por lotes, la gran pregunta entre los desarrolladores es si esa diferencia de precio realmente merece la pena.
Esta no es una reseña de modelos basada en impresiones. Plotly, DualEntry y Artificial Analysis publicaron sus resultados el mismo día del lanzamiento de Terra, y OpenAI también compartió datos oficiales de OSWorld 2.1, MMMU-Pro y la tasa de errores factuales. Aquí reunimos todos esos datos para responder a una pregunta concreta: ¿cuántos resultados correctos y realmente útiles obtenemos a cambio de pagar más?
Qué te llevarás: al terminar el artículo, sabrás en qué tareas por lotes hay una gran diferencia entre GPT-6.1 Terra y GPT-6 Luna, y en cuáles apenas la hay. También tendrás el código de una solución híbrida: «filtrado inicial con Luna + validación mediante reglas + Terra como respaldo».
GPT-6.1 Terra y GPT-6 Luna: datos clave de un vistazo
Los dos modelos pertenecen a la familia GPT-6, pero están orientados a usos claramente distintos. OpenAI describe Luna como un modelo de alta eficiencia para tareas bien definidas, frecuentes y de gran volumen. Terra, por su parte, destaca en razonamiento visual, manejo preciso de computadoras y escritura natural, y ocupa el espacio intermedio entre Luna y Sol.
| Dato | GPT-6 Luna | GPT-6.1 Terra |
|---|---|---|
| Fecha de lanzamiento | 22 de septiembre de 2026 | 26 de octubre de 2026 |
| ID de API | gpt-6-luna |
gpt-6.1-terra |
| Enfoque oficial | Tareas frecuentes, de gran volumen y con reglas claras | Razonamiento visual, manejo de computadoras y tareas de varios pasos |
| Contexto / salida máxima | 1.050.000 / 128.000 tokens | 1.050.000 / 128.000 tokens |
| Nivel de razonamiento | 6 niveles, de none a max; medium por defecto | 6 niveles, de none a max; medium por defecto |
| Casos de uso habituales | Clasificación por etiquetas, distribución de correos y extracción de campos | Registro de facturas, cotejo de imágenes de productos y manejo de interfaces |
En cuanto a especificaciones, son casi idénticos: ambos admiten entradas de texto e imágenes, Structured Outputs, Function Calling, Responses API y Batch API, además de herramientas como Web Search, File Search y Computer Use. Las diferencias de verdad están en dos aspectos: el precio y la capacidad para resolver tareas complejas.
Vale la pena señalar que la guía de selección de modelos de OpenAI no dice «usa Luna para tareas por lotes» ni «usa Terra si necesitas precisión». La recomendación oficial es probarlos con el mismo conjunto de datos reales y elegir la configuración de menor costo que cumpla los requisitos de calidad. Esa idea es también el punto de partida para interpretar todos los datos de este artículo.
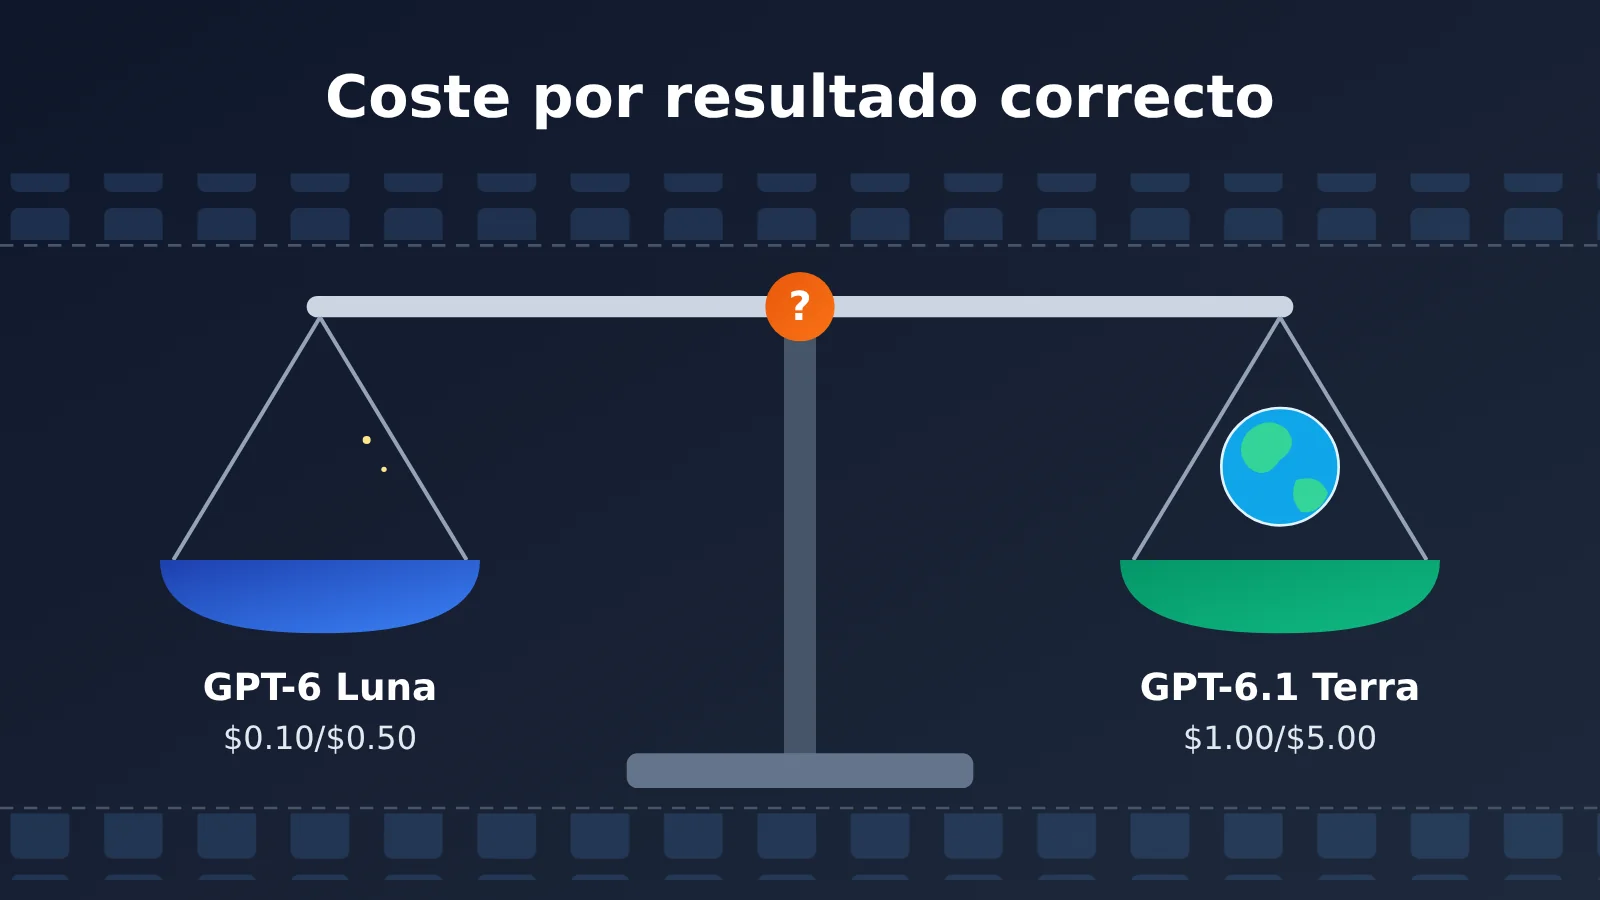
Diferencia de precios de API entre GPT-6.1 Terra y GPT-6 Luna
Según los precios oficiales de OpenAI para la API Standard con contexto corto, en dólares por millón de tokens:
| Concepto | GPT-6 Luna | GPT-6.1 Terra | Terra / Luna |
|---|---|---|---|
| Tokens de entrada | $0.10 | $1.00 | 10 veces |
| Entrada en caché | $0.01 | $0.05 | 5 veces |
| Tokens de salida | $0.50 | $5.00 | 10 veces |
| Escritura en caché de 30 minutos | $0.125 | $1.25 | 10 veces |
| Entrada / salida Batch | Aprox. $0.05 / $0.25 | Aprox. $0.50 / $2.50 | 10 veces |
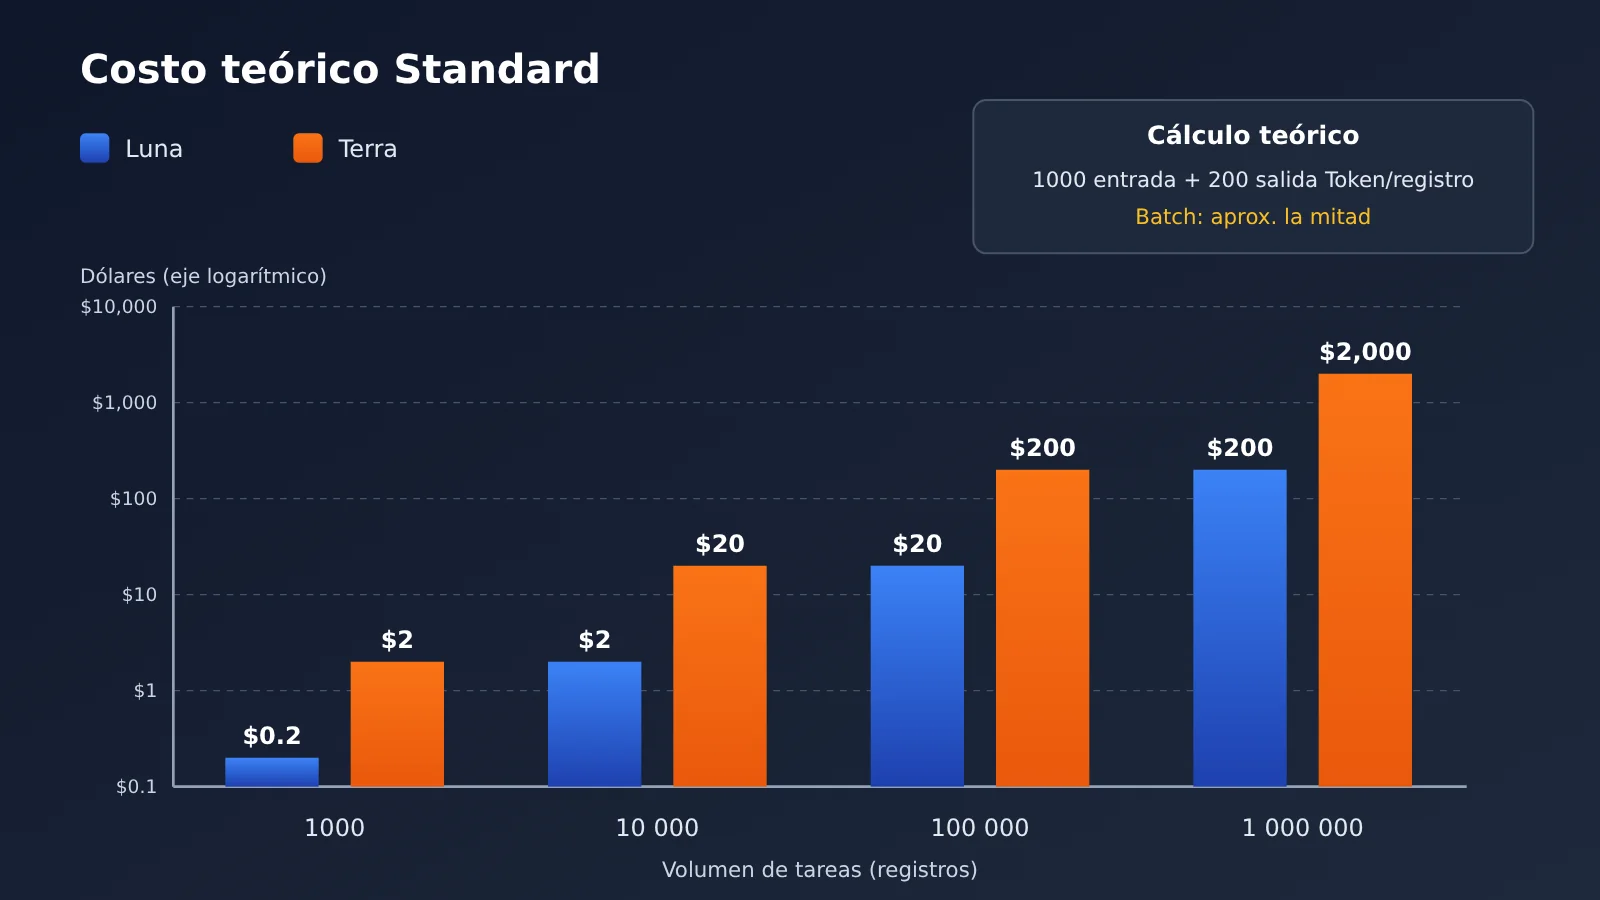
Las tarifas de los modos Batch y Flex son aproximadamente la mitad de las de Standard, mientras que las del modo Fast son aproximadamente el doble. Hay dos factores de coste que se pasan por alto con facilidad. Primero, cuando la entrada de una solicitud supera los 272.000 tokens, la entrada y la caché de toda la solicitud se cobran al doble, y la salida, a 1,5 veces la tarifa. Segundo, las herramientas como la búsqueda web o el control del ordenador pueden tener cargos adicionales. Los tokens de razonamiento, los reintentos y las invocaciones de agentes en varias rondas también modifican el consumo real.
Por eso, «10 veces más caro» se refiere al precio unitario de los tokens en las mismas condiciones de facturación, no significa que cada tarea cueste 10 veces más. Hagamos un cálculo teórico: si cada registro consume 1.000 tokens de entrada y 200 de salida, sin usar caché ni reintentos, procesar 100.000 registros en modo Standard costaría unos $20 con Luna y $200 con Terra. En Batch, serían aproximadamente $10 y $100. Son solo cifras teóricas calculadas a partir de los precios publicados, no facturas reales.
GPT-6.1 Terra frente a GPT-6 Luna: datos reales de 4 pruebas
El precio unitario solo dice «cuánto cuesta»; ahora toca ver «qué se obtiene a cambio». Los siguientes cuatro conjuntos de datos proceden de distintas instituciones y cubren diferentes tipos de tareas. Juntos muestran cómo cambia la diferencia de precisión según la dificultad.
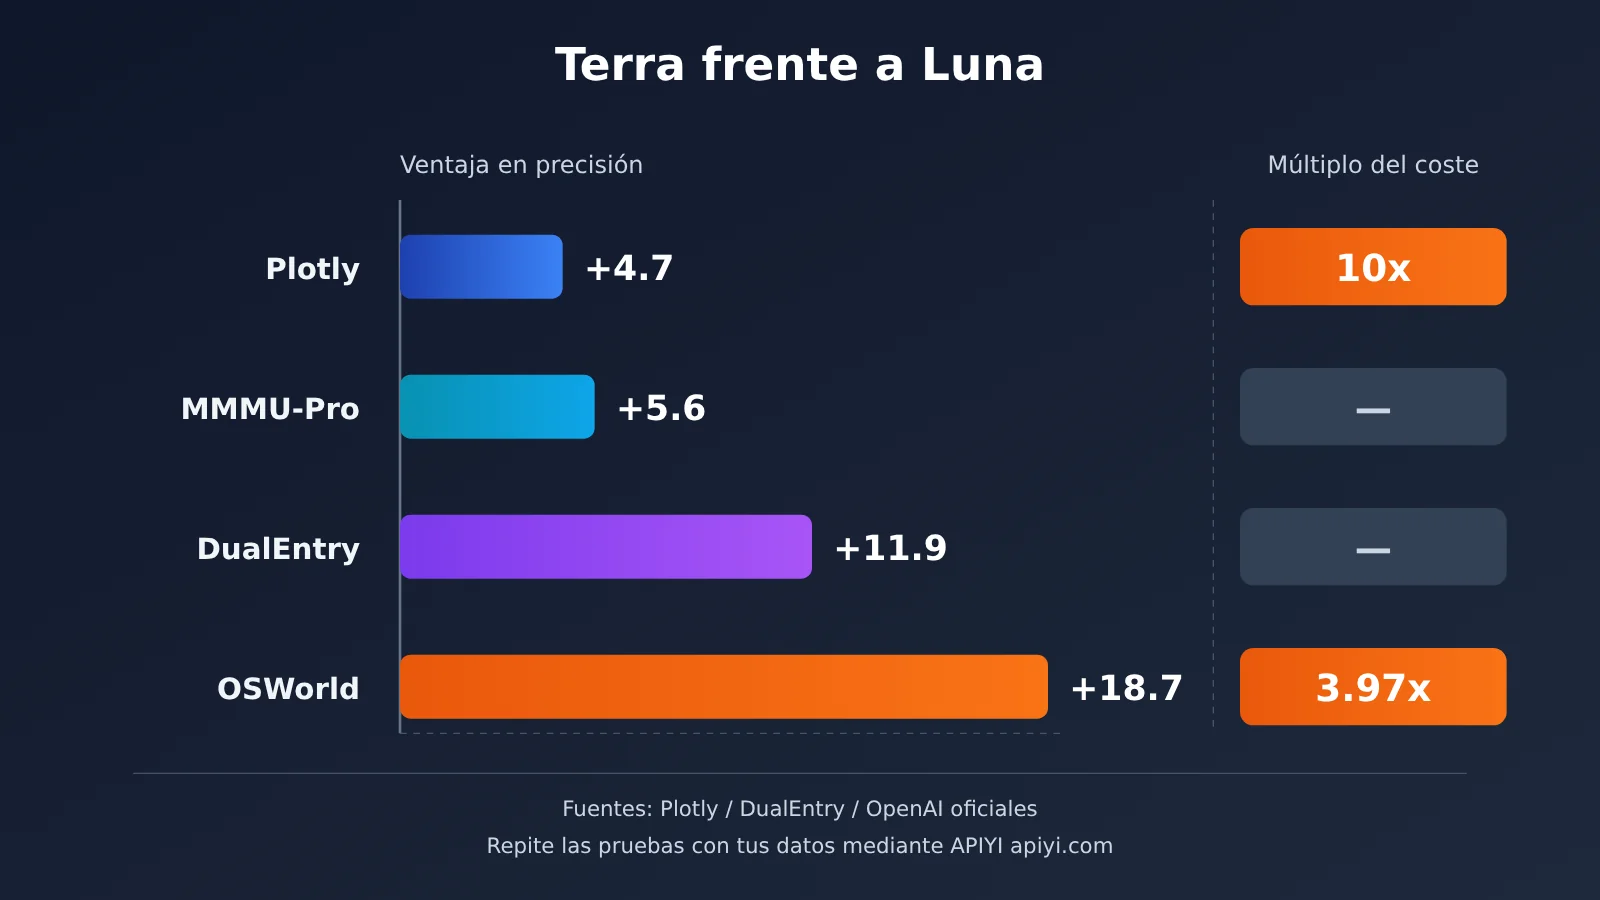
43 preguntas de análisis de datos de Plotly: 10 veces más gasto, 2 respuestas correctas más
DataAnalyticsBench, desarrollado por investigadores de Plotly y Mila, simula el almacén de datos de una empresa operadora de parques eólicos, con unos 20 millones de filas de datos sintéticos. Ambos modelos respondieron las mismas 43 preguntas con el mismo conjunto de herramientas:
| Métrica | GPT-6 Luna | GPT-6.1 Terra |
|---|---|---|
| Respuestas correctas | 38/43 (88.4%) | 40/43 (93.0%) |
| Coste total de la prueba | $0.13 | $1.31 |
| Tiempo mediano por pregunta | 18 segundos | 15 segundos |
| Análisis convencional / preguntas ambiguas / solicitudes imposibles / calidad de datos | Puntuación máxima en todas | Puntuación máxima en todas |
| Trampas estadísticas | 3/5 | 4/5 |
| Descubrimiento de patrones ocultos | 2/5 | 3/5 |
Lo más interesante aparece al desglosar los resultados. Ambos modelos rindieron igual en análisis convencional, identificación de solicitudes ambiguas, rechazo de peticiones imposibles y detección de problemas básicos de calidad de datos. La diferencia solo apareció en dos tipos de análisis más profundo: trampas estadísticas y descubrimiento de patrones ocultos. Terra acertó una pregunta más en cada categoría.
Si hacemos un cálculo aproximado con el resultado global, Terra costó $1.18 más y acertó 2 preguntas adicionales: unos $0.59 extra por cada respuesta correcta adicional. Es un coste marginal calculado a partir del total de la prueba, no un precio fijo por corregir errores en producción. Si la pregunta afecta a una decisión de negocio, $0.59 es barato; si solo sirve para encontrar un patrón poco relevante en un informe interno, pagar 10 veces más no parece necesario.
Otro detalle: Terra tardó menos por pregunta, pero porque sus respuestas fueron más cortas y necesitó menos llamadas —una media de unas 4.5 invocaciones del modelo y unos 1460 tokens de salida—, no porque generara texto más rápido. Su velocidad de salida fue de unos 64 tokens por segundo. Además, la muestra se limita a 43 preguntas y Terra se ejecutó a través de OpenRouter con la configuración de razonamiento predeterminada, así que no se puede concluir que tenga una precisión del 93% en todos los análisis de datos empresariales.
Las 101 tareas contables de DualEntry: la brecha se amplía a 11,9 puntos porcentuales
El Accounting AI Benchmark de DualEntry se acerca más a las operaciones reales de una empresa. Sus 101 tareas abarcan ocho categorías: clasificación de transacciones, asientos contables, cuentas por pagar, cuentas por cobrar, conciliación bancaria, informes financieros, cierre de mes y conocimientos contables. Cada modelo pasa por tres rondas y, para superar una tarea, debe acertarla al menos dos veces.
Los resultados fueron del 66,3 % para Luna y del 78,2 % para Terra. Como referencia, GPT-6.1 Sol alcanzó el 81,2 %. En el desglose de Terra, obtuvo 13/13 en clasificación de transacciones, 12/13 en asientos contables y 10/12 en conciliación bancaria, pero solo 7/13 en cuentas por pagar y 7/12 tanto en cuentas por cobrar como en cierre de mes. DualEntry también señala que Terra y Luna empataron en el último lugar en cuentas por pagar.
Para la automatización a gran escala, la estabilidad importa más que la precisión en una sola ejecución. Terra acertó las tres rondas en el 65,3 % de las tareas, frente al 68,3 % de Sol; el porcentaje de Luna fue menor, aunque el texto original no proporciona la cifra exacta. Si un modelo resuelve bien una tarea contable hoy y falla mañana, el coste de la revisión manual aumenta rápidamente. En esta prueba, Terra tardó una media de 16,1 segundos por tarea, con un coste de tokens de unos $0,042; el total de las tres rondas fue de aproximadamente $12,73. El texto original no especifica con claridad el coste equivalente de Luna, así que no lo estimamos.
OSWorld 2.1 y tasa de errores factuales: la mayor brecha está en las tareas complejas
OSWorld 2.1 es una prueba de manejo de escritorio que OpenAI incluyó en el anuncio de Terra. Evalúa si un modelo puede entender la interfaz, pulsar los botones correctos y completar operaciones de varios pasos. Con el nivel de razonamiento más alto, Luna obtuvo un 55,5% y Terra un 74,2%: una diferencia de 18,7 puntos porcentuales. El coste estimado por tarea fue de $0.30 y $1.19, respectivamente: unas 3,97 veces más, no 10. Esto se debe a que cada modelo consume una cantidad distinta de tokens para completar la misma tarea.
Los resultados de la prueba de errores factuales son aún más llamativos. En las preguntas factuales difíciles diseñadas por OpenAI, Luna registró tasas de error del 44,3%, 31,2% y 18,4% en los niveles Low / Medium / Max, respectivamente; Terra obtuvo un 16,7%, 10,1% y 4,3%. La tasa de error de Terra en Low sigue siendo menor que la de Luna en Max. En comprensión visual, con el nivel de razonamiento más alto, Luna obtuvo un 79,9% en MMMU-Pro y Terra un 85,5%.
Todos estos datos proceden de gráficos oficiales de OpenAI, no de pruebas independientes realizadas por terceros. Las preguntas factuales difíciles están diseñadas específicamente para provocar errores, por lo que no significa que Luna cometa un 44,3% de errores al escribir textos cotidianos. Del mismo modo, las puntuaciones de OSWorld solo son aplicables a sus condiciones de prueba.
Índice global de Artificial Analysis: también hay que optimizar la intensidad de razonamiento
La evaluación independiente de Artificial Analysis ofrece otra perspectiva. Con el nivel Max, Luna obtiene aproximadamente 38 puntos en el índice global de inteligencia y Terra, unos 48. Sus costos respectivos en el benchmark global son de aproximadamente $0,07 y $0,40: una diferencia de unas 5,7 veces. La brecha es aún mayor en el índice de agentes de programación: Luna obtiene 31 y Terra, 48.
Pero la prueba de comprensión de documentos largos AA-LCR muestra lo contrario: ambos alcanzan cerca del 83 % con la configuración de razonamiento más alta. Además, en los niveles Low y Medium, Terra se sitúa en la frontera de Pareto entre costo y capacidad dentro de las pruebas de esta entidad; en Max, en cambio, no siempre es la opción óptima. En otras palabras, para la automatización a gran escala no basta con ajustar el modelo: también hay que ajustar la intensidad de razonamiento.
Guía rápida de automatización por lotes con GPT-6.1 Terra y GPT-6 Luna
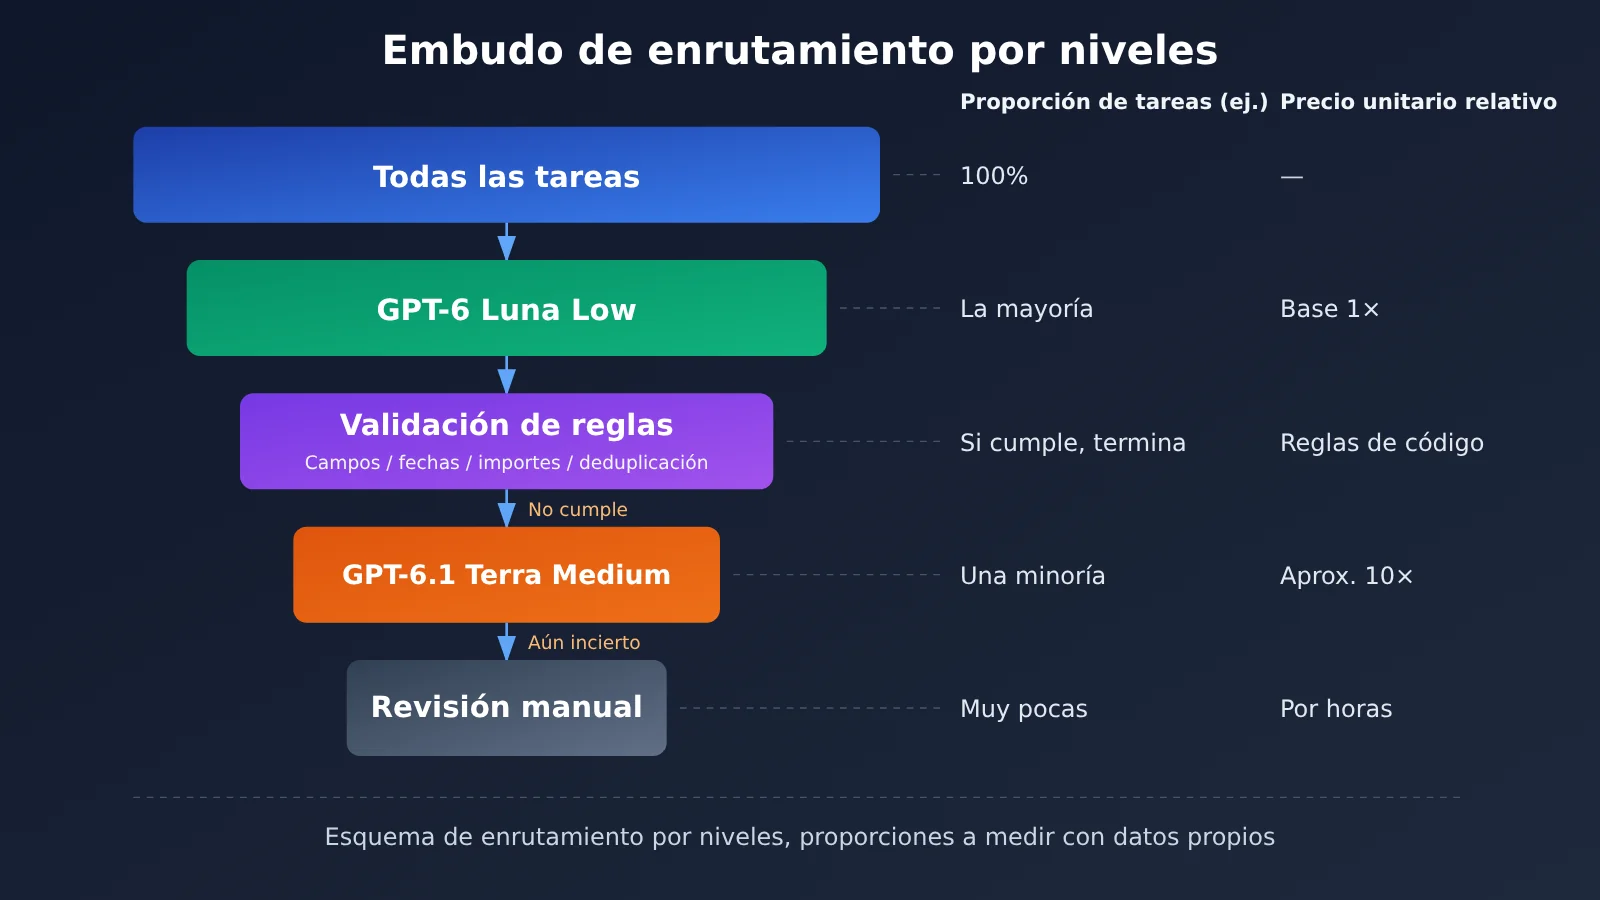
Al combinar los datos anteriores, llegamos a una conclusión práctica: delega en Luna la mayoría de las tareas con reglas claras y reserva Terra para las pocas que sean complejas, de alto riesgo o no superen la validación. El siguiente ejemplo mínimo y ejecutable usa primero Luna para extraer los campos de una factura y luego los valida mediante reglas programadas. Solo si no pasan la validación, recurre a Terra.
import json, openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

def extract(model, text, effort="low"):
    r = client.chat.completions.create(
        model=model, reasoning_effort=effort,
        response_format={"type": "json_object"},
        messages=[{"role": "user", "content": f"抽取 JSON:amount, tax, total, date\n{text}"}])
    return json.loads(r.choices[0].message.content)

def valid(d):
    return all(k in d for k in ("amount", "tax", "total", "date")) and \
        abs(float(d["amount"]) + float(d["tax"]) - float(d["total"])) < 0.01

result = extract("gpt-6-luna", "发票:金额 100.00,税额 6.00,合计 106.00,日期 2026-10-20")
if not valid(result):
    result = extract("gpt-6.1-terra", "...", effort="medium")
print(result)
Ver el código completo de implementación del enrutamiento por niveles
import json
import re
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

PROMPT = "从以下文本抽取 JSON,字段:amount, tax, total, date(YYYY-MM-DD)。缺失填 null。\n"

def call_model(model: str, text: str, effort: str = "low") -> Optional[dict]:
    try:
        resp = client.chat.completions.create(
            model=model,
            reasoning_effort=effort,
            response_format={"type": "json_object"},
            messages=[{"role": "user", "content": PROMPT + text}],
        )
        return json.loads(resp.choices[0].message.content)
    except Exception as e:
        print(f"[{model}] 调用失败: {e}")
        return None

def rule_check(d: Optional[dict]) -> list:
    """程序化规则校验:结构化输出只保证格式,不保证事实,所以必须二次校验"""
    if not d:
        return ["empty"]
    errors = []
    for k in ("amount", "tax", "total", "date"):
        if d.get(k) is None:
            errors.append(f"missing:{k}")
    if not errors:
        if abs(float(d["amount"]) + float(d["tax"]) - float(d["total"])) > 0.01:
            errors.append("sum_mismatch")
        if not re.match(r"^\d{4}-\d{2}-\d{2}$", str(d["date"])):
            errors.append("bad_date")
    return errors

def route(text: str) -> dict:
    # 第一层:Luna Low 处理全部输入
    d = call_model("gpt-6-luna", text, "low")
    if not rule_check(d):
        return {"data": d, "tier": "luna"}
    # 第二层:未通过校验的升级到 Terra Medium
    d = call_model("gpt-6.1-terra", text, "medium")
    errs = rule_check(d)
    if not errs:
        return {"data": d, "tier": "terra"}
    # 第三层:仍不确定的进入人工审核队列
    return {"data": d, "tier": "human_review", "errors": errs}

if __name__ == "__main__":
    samples = [
        "发票号 A001,金额 100.00 元,税额 6.00 元,价税合计 106.00 元,开票日期 2026-10-20",
        "收据:总计一百零六元整,含税,十月二十日",
    ]
    for s in samples:
        print(route(s))
🚀 Inicio rápido: la recomendación oficial es usar primero una misma clave API para probar ambos modelos y después ejecutar tus propias muestras. APIYI apiyi.com ofrece una interfaz compatible con OpenAI: para cambiar entre
gpt-6-lunaygpt-6.1-terra, solo tienes que modificar el parámetromodel. Los nuevos usuarios reciben crédito gratuito para pruebas, ideal para empezar con comparaciones a pequeña escala.
La clave de esta estructura está en el segundo paso. No des por correcta una respuesta solo porque «Luna dice estar muy segura»: la confianza que declara el propio modelo no siempre es fiable. Prioriza reglas verificables: si faltan campos, si las fechas son válidas, si los importes cuadran, si los campos clave coinciden con el texto original y si hay registros duplicados.
Análisis del impacto de GPT-6.1 Terra y GPT-6 Luna
Impacto para desarrolladores: elegir según el tipo de tarea
La orientación oficial y las pruebas anteriores sirven como punto de partida para elegir un modelo para tareas habituales por lotes. Son recomendaciones basadas en evaluaciones públicas, no pruebas directas de todos estos escenarios. Antes de llevarlas a producción, conviene validarlas con tus propios datos.
| Escenario | Recomendación inicial | Motivo | Plataformas disponibles |
|---|---|---|---|
| Etiquetar cien mil artículos | GPT-6 Luna | Las reglas son claras y los resultados pueden verificarse mediante muestreo; ambos obtuvieron la puntuación máxima en el análisis estándar de Plotly | APIYI apiyi.com, OpenAI oficial |
| Registrar datos de facturas o capturas de pedidos | GPT-6.1 Terra | Destaca en capacidades visuales y operativas, aunque los importes deben verificarse mediante programación | APIYI apiyi.com, OpenAI oficial |
| Resumen diario de noticias de IA | Luna para el filtrado inicial + Terra para la lectura detallada | Luna se encarga de eliminar duplicados y etiquetar; Terra evalúa la importancia | APIYI, OpenAI oficial |
| Clasificación y borradores de correos de atención al cliente | Principalmente Luna | Los casos de alto riesgo, como quejas y reembolsos, se escalan o derivan a una persona | APIYI, OpenAI oficial |
| Modificar páginas web y código por lotes | Terra o Sol | En el índice de agentes de programación, Terra obtuvo 48 puntos y Luna 31 | APIYI, OpenAI oficial |
Otro aspecto que los desarrolladores suelen pasar por alto es la capacidad de procesamiento. En el nivel Build de la oferta oficial, Luna tiene un límite de 2 millones de tokens por minuto y una cola Batch de hasta 20 millones, mientras que Terra permite 1 millón y 3 millones, respectivamente. En el nivel Launch, los límites de Luna son 10 millones y 1.000 millones, frente a los 4 millones y 200 millones de Terra. Para tareas por lotes de más de cien mil registros, Luna permite poner en cola un volumen claramente mayor. Eso sí, son límites de cuota, no velocidades de generación, y pueden variar según la cuenta.
Impacto en el sector: de comparar el precio por llamada a comparar el costo por resultado válido
El día del lanzamiento de Terra, surgieron dos posturas en la comunidad de Reddit. Algunos consideraban que Terra ocupaba un lugar difícil de justificar: Luna ya era suficientemente económico y Sol era más potente. Otros señalaban que la tasa de errores factuales de Terra Low ya era inferior a la de Luna Max, por lo que no bastaba con mirar el precio por llamada.
Algunos usuarios de Codex también comentaron que Terra con una intensidad de razonamiento alta no siempre consume menos cuota que Sol con una intensidad media. Por su parte, usuarios de Luna señalaron que, en tareas de desarrollo complejas, el trabajo que había que repetir anulaba su ventaja en consumo de cuota. Son casos individuales y, además, la cuota de una suscripción de Codex no equivale a la facturación por tokens de la API, por lo que no sirven para calcular los costos de la API.
Aun así, todos apuntan a una misma tendencia: la métrica para evaluar la automatización a gran escala está pasando de «cuánto cuesta cada llamada» a «cuánto cuesta cada resultado válido». Una fórmula sencilla ayuda a entenderlo:
Costo total = costo de llamadas a la API + costo de herramientas + costo de reintentos + costo de revisión humana + pérdidas por errores
Luna tiene una ventaja clara en los dos primeros componentes, mientras que Terra reduce los tres últimos gracias a su menor tasa de errores. Cuál conviene más depende de cuánto cueste un error en tu negocio. Una observación de MultiAI con una muestra pequeña también apunta en esa dirección: con el razonamiento desactivado, Terra comete errores en algunas tareas de lógica y cálculo, pero mejora claramente al cambiar a Medium. Luna funciona bien en tareas sencillas, aunque comete más errores en tareas de lógica de varios pasos.
Cómo hacer tu propio experimento comparativo
Los datos públicos aún no responden a varias preguntas clave: la tasa de error de los dos modelos al clasificar 100.000 artículos reales en chino, su estabilidad a largo plazo, cuánto puede ahorrar realmente una estrategia combinada y si el coste de la revisión humana puede compensar el sobreprecio de Terra. Para responderlas, tendrás que hacer tus propias pruebas.
Una opción práctica es preparar entre 200 y 500 muestras reales de tu actividad, cada una con su respuesta correcta. Por ejemplo, puedes incluir 100 casos de clasificación sencilla, 100 de extracción de información clave y 100 de identificación de contenido complejo, además de 50 de verificación de hechos y 50 de operaciones con herramientas de varios pasos. Después, ejecuta las cuatro configuraciones —Luna Low, Luna Medium, Terra Low y Terra Medium— con las mismas entradas, indicaciones, herramientas y criterios de evaluación. Repite algunas tareas varias veces para observar la estabilidad.
Por último, céntrate en cinco resultados: precisión, coste de API por cada 1.000 registros, tiempo medio y tiempo P95, número de revisiones humanas y de trabajos rehechos, y coste total por cada 1.000 resultados que cumplen los criterios de calidad. Si usas una plataforma de terceros, ten en cuenta sus reglas de facturación reales y comprueba las condiciones de tratamiento de datos y los requisitos de cumplimiento.
Preguntas frecuentes FAQ
Q1: ¿Cuál es la diferencia principal entre GPT-6.1 Terra y GPT-6 Luna?
Sus especificaciones son casi idénticas: ambos tienen una ventana de contexto de 1.050.000 tokens y admiten las mismas herramientas. La diferencia es que el precio unitario de Luna es diez veces menor, por lo que resulta adecuado para tareas frecuentes con reglas claras. Terra es notablemente mejor en comprensión visual, manejo de computadoras, análisis complejo y precisión factual, así que conviene para tareas de varios pasos en las que los errores salen caros.
Q2: Terra cuesta diez veces más, ¿pero su precisión solo es un poco mayor?
Depende del tipo de tarea. En la prueba de análisis de datos con Plotly, Terra supera a Luna por unos 4,7 puntos porcentuales; en la tarea de contabilidad DualEntry, por 11,9 puntos; y en el manejo de escritorio con OSWorld, por 18,7 puntos. Además, en OSWorld el costo por tarea es unas 3,97 veces mayor, no diez veces de forma fija.
Q3: ¿Se puede sustituir Terra por Luna con la intensidad de razonamiento en max?
Eso puede mejorar parte de su rendimiento, pero no elimina la diferencia de capacidad entre los modelos. En las preguntas factuales difíciles de la prueba oficial, Luna Max registra una tasa de error del 18,4 %, todavía mayor que el 16,7 % de Terra Low. Además, aumentar la intensidad de razonamiento consume más tokens, lo que puede hacer que Luna pierda su ventaja en costos.
Q4: ¿Cómo puedo comparar rápidamente los dos modelos mediante la API?
Lo recomendable es usar el mismo código y cambiar el nombre del modelo para hacer la comparación:
1. Visita APIYI apiyi.com, regístrate y obtén una clave API y crédito gratuito para pruebas
2. Configura base_url como `https://api.apiyi.com/v1`
3. Ejecuta el mismo conjunto de muestras con `gpt-6-luna` y `gpt-6.1-terra`, y registra la precisión y el consumo de tokens
Q5: ¿Cómo puedo reducir aún más los costos en tareas de gran volumen?
Para las tareas que no necesitan una respuesta en tiempo real, prioriza Batch API: su tarifa es aproximadamente la mitad de la de Standard y ofrece una ventana de procesamiento de 24 horas. También conviene mantener cada entrada por debajo de 272.000 tokens para evitar el recargo por contexto largo. APIYI apiyi.com ofrece pago por uso, lo que facilita empezar con lotes pequeños, medir el consumo real de tokens por tarea y luego aumentar el volumen.
Q6: ¿Qué limitaciones tienen estos resultados?
Plotly solo incluye 43 preguntas y utiliza datos sintéticos; los resultados de OSWorld, MMMU-Pro y la tasa de errores factuales proceden de OpenAI y no se han verificado de forma independiente; y las puntuaciones de 24/24 y 18/18 de MultiAI no corresponden al mismo conjunto de preguntas, por lo que no se pueden comparar directamente. Además, Structured Outputs solo garantiza que el formato sea correcto, no que el contenido de los campos sea veraz. Ninguna puntuación de referencia equivale necesariamente a la precisión real en tu caso de uso.
GPT-6.1 Terra y GPT-6 Luna: puntos clave
- Una diferencia de precio de 10 veces: Luna cuesta $0.10 por entrada y $0.50 por salida; Terra, $1.00 y $5.00
- Poca diferencia en tareas sencillas: ambos obtienen la puntuación máxima en pruebas como análisis convencionales de Plotly e identificación de preguntas ambiguas
- Gran diferencia en tareas complejas: Terra supera a Luna por 11.9 puntos en tareas contables y por 18.7 puntos en operaciones de escritorio
- Diferencias en precisión factual: Terra Low tiene una tasa de error del 16.7%, inferior al 18.4% de Luna Max
- También conviene ajustar la intensidad del razonamiento: Terra Low y Medium ofrecen una mejor relación entre costo y rendimiento que Max
- El enrutamiento por niveles es la opción más rentable: selección inicial con Luna, validación mediante reglas, Terra como respaldo y revisión humana
- Prueba antes de implementar: compara cuatro configuraciones con entre 200 y 500 muestras propias en APIYI apiyi.com
Conclusión
Volviendo a la pregunta del título, elegir entre GPT-6.1 Terra y GPT-6 Luna para la automatización a gran escala depende de la dificultad de las tareas y del costo de los errores:
- Tareas con reglas claras y validación automática: Luna es un punto de partida económico. En las pruebas de Plotly, ambos modelos rindieron igual en los análisis convencionales.
- Tareas de alto riesgo, como reconocimiento visual, operaciones de varios pasos o finanzas: el costo adicional de Terra puede estar justificado, ya que su ventaja en precisión alcanza hasta 18.7 puntos porcentuales.
- El verdadero objetivo de optimización: no es el precio de una sola llamada a la API, sino el costo total por cada resultado que cumple los requisitos, incluidos los reintentos, la revisión y las pérdidas por errores.
Para la mayoría de los equipos, la mejor opción no es elegir uno u otro, sino dejar que Luna se encargue de la mayoría de las tareas sencillas y que Terra resuelva las realmente difíciles. Conviene empezar con una comparación a pequeña escala usando muestras de tu propio negocio y después decidir cómo repartir las tareas.
Puedes usar APIYI apiyi.com para comprobar rápidamente cómo rinden ambos modelos en tu negocio. Una sola clave API permite cambiar de modelo y el pago por uso facilita calcular con precisión el costo por cada mil tareas.
📚 Referencias
- OpenAI: Introducing GPT-6.1 Terra: anuncio de lanzamiento con gráficos de OSWorld, MMMU-Pro y tasa de errores factuales
- Enlace:
openai.com/index/introducing-gpt-6-1-terra -
Descripción: fuente del posicionamiento oficial de Terra y sus resultados en pruebas de referencia
-
Precios de la API de OpenAI y páginas de modelos: precios, capacidades y límites de velocidad de Luna y Terra
- Enlace:
developers.openai.com/api/docs/pricing -
Descripción: fuente de los precios de Standard, Batch, Flex y Fast
-
Documentación de OpenAI Batch API: costos y ventana de procesamiento por lotes
- Enlace:
developers.openai.com/api/docs/guides/batch -
Descripción: cómo reducir costos en tareas asíncronas de gran volumen
-
Plotly: GPT-6.1 Terra Benchmark Results for Data Analysis: 43 pruebas de análisis de datos realizadas en las mismas condiciones
- Enlace:
plotly.com/blog/gpt-6-1-terra-plotly-data-analytics-bench -
Descripción: precisión, costos, tiempo empleado y resultados por categoría
-
DualEntry: GPT-6.1 Terra Accounting Benchmark: prueba con 101 tareas contables
- Enlace:
dualentry.com/blog/gpt-6-1-terra-accounting-benchmark -
Descripción: precisión, categorías de tareas y estabilidad a lo largo de tres rondas
-
Artificial Analysis: evaluación de GPT-6.1 Terra: índice de inteligencia general y eficiencia de costos
- Enlace:
artificialanalysis.ai/models/releases/gpt-6-1-terra - Descripción: resultados de pruebas independientes con distintos niveles de razonamiento
Autor: Equipo técnico de APIYI
Consultas técnicas: Puedes contactarnos desde la página principal del sitio oficial de APIYI. Para más información sobre la integración de modelos, visita el centro de documentación en docs.apiyi.com