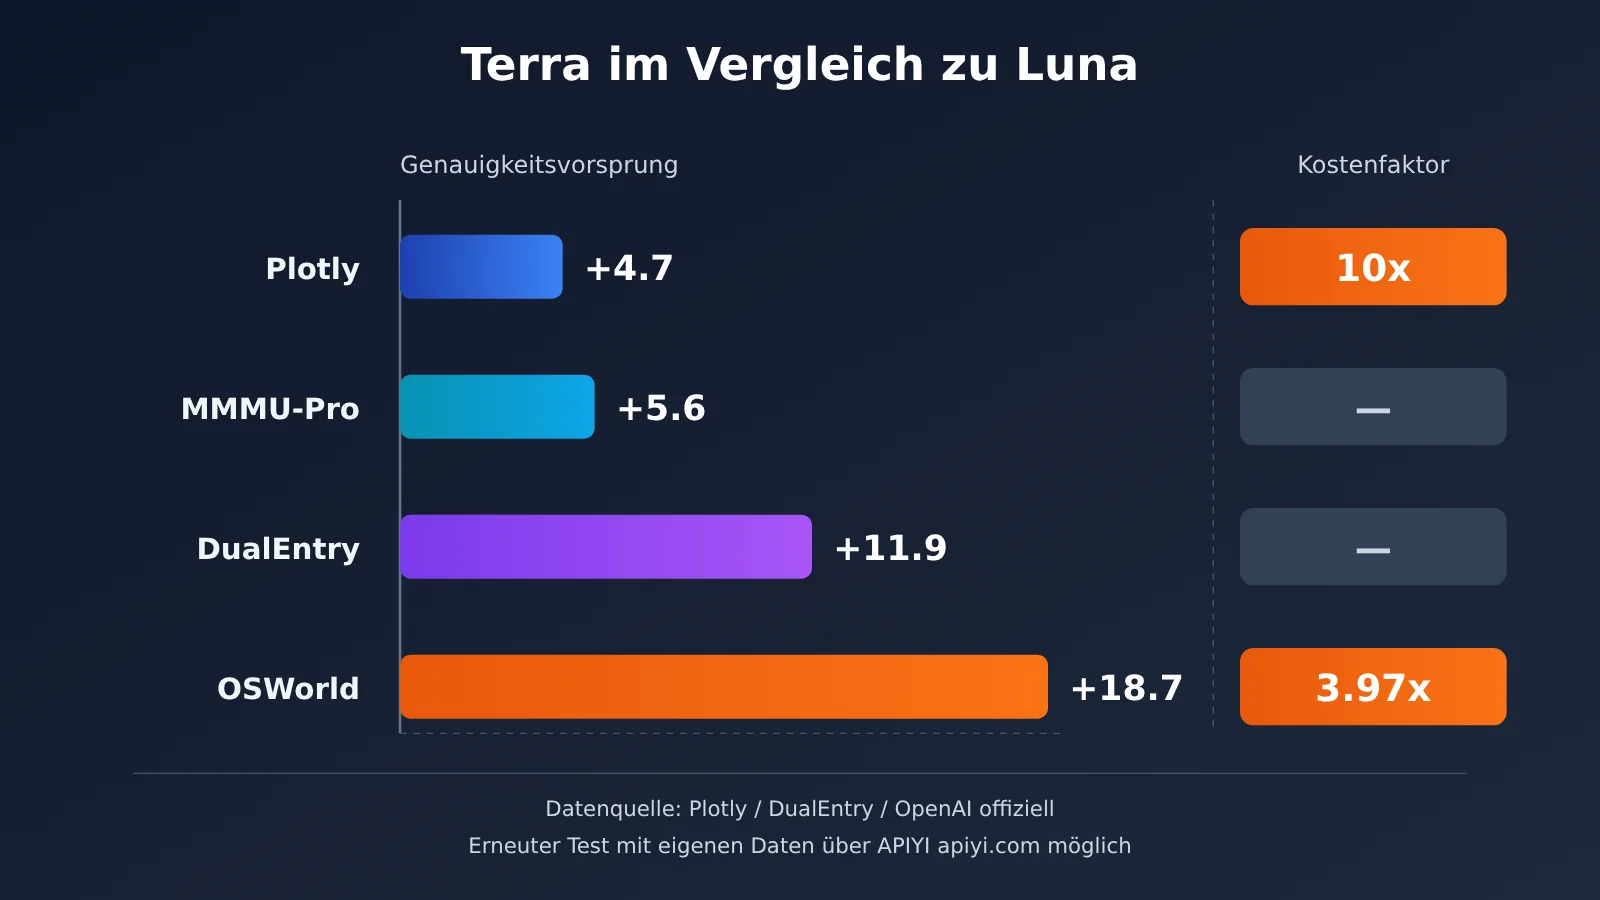
Anmerkung des Autors: Terra kostet pro Token zehnmal so viel wie Luna. Der Vorsprung bei der Genauigkeit liegt jedoch je nach Test zwischen 4,7 und 18,7 Prozentpunkten. Dieser Artikel berechnet anhand realer Testergebnisse von Plotly, DualEntry und OSWorld die tatsächlichen Kosten „pro korrektem Ergebnis“ in der Batch-Automatisierung.
OpenAI hat GPT-6.1 Terra am 26. Oktober 2026 veröffentlicht, nur etwas mehr als einen Monat nach GPT-6 Luna. Die API-Preise der beiden Modelle unterscheiden sich um den Faktor 10. In unabhängigen Vergleichstests lag Terras Vorsprung bei der Genauigkeit jedoch zwischen weniger als 5 und fast 19 Prozentpunkten. Für Entwickler stellt sich deshalb vor allem eine Frage: Lohnt sich der Aufpreis bei automatisierten Batch-Aufgaben?
Dieser Modellvergleich beruht nicht auf Bauchgefühl. Plotly, DualEntry und Artificial Analysis veröffentlichten ihre Testergebnisse noch am Tag von Terras Veröffentlichung. OpenAI selbst legte außerdem Daten zu OSWorld 2.1, MMMU-Pro und zur Rate sachlicher Fehler vor. Dieser Artikel führt die Ergebnisse zusammen und beantwortet eine konkrete Frage: Wie viele wirklich brauchbare, korrekte Ergebnisse bekommt man für das zusätzliche Geld?
Das nehmen Sie mit: Sie erfahren, bei welchen Batch-Aufgaben sich GPT-6.1 Terra und GPT-6 Luna deutlich unterscheiden und wo es kaum einen Unterschied gibt. Außerdem erhalten Sie Code für einen hybriden Ansatz: „Vorauswahl durch Luna + regelbasierte Prüfung + Terra als Fallback“.
GPT-6.1 Terra und GPT-6 Luna im Überblick
Beide Modelle gehören zur GPT-6-Familie, sind aber unterschiedlich ausgerichtet. OpenAI beschreibt Luna als effizientes Modell für klar definierte, häufig anfallende Aufgaben mit hohem Volumen. Terra konzentriert sich dagegen auf visuelles Schlussfolgern, präzise Computerbedienung und natürliches Schreiben. Es besetzt damit die mittlere Stufe zwischen Luna und Sol.
| Information | GPT-6 Luna | GPT-6.1 Terra |
|---|---|---|
| Veröffentlichung | 22. September 2026 | 26. Oktober 2026 |
| API-ID | gpt-6-luna |
gpt-6.1-terra |
| Offizielle Ausrichtung | Häufige Aufgaben mit hohem Volumen und klaren Regeln | Visuelles Schlussfolgern, Computerbedienung, mehrstufige Aufgaben |
| Kontextfenster / maximale Ausgabe | 1.050.000 / 128.000 Token | 1.050.000 / 128.000 Token |
| Reasoning-Stärke | 6 Stufen von none bis max, Standard: medium | 6 Stufen von none bis max, Standard: medium |
| Typische Einsatzszenarien | Klassifizierung von Labels, Weiterleitung von E-Mails, Extraktion von Feldern | Rechnungserfassung, Zuordnung von Produktbildern, Bedienung von Benutzeroberflächen |
Bei den technischen Daten sind sich die Modelle sehr ähnlich: Beide unterstützen Text- und Bildeingaben, Structured Outputs, Function Calling, Responses API und Batch API sowie Tools wie Web Search, File Search und Computer Use. Die eigentlichen Unterschiede liegen an zwei Stellen: beim Preis und bei den Fähigkeiten für komplexe Aufgaben.
Bemerkenswert ist, dass OpenAI in seinem Leitfaden zur Modellauswahl weder „Luna für Stapelverarbeitung“ noch „Terra für höhere Genauigkeit“ empfiehlt. Stattdessen lautet der Rat: Dieselben echten Eingaben mit verschiedenen Konfigurationen testen und die günstigste wählen, die die Qualitätsanforderungen erfüllt. Dieser Grundsatz ist auch wichtig, um die Daten in diesem Artikel richtig einzuordnen.
API-Preisvergleich: GPT-6.1 Terra und GPT-6 Luna
Laut den offiziellen OpenAI-Preisen für die Standard-API bei kurzen Kontexten, in US-Dollar pro Million Token:
| Kostenpunkt | GPT-6 Luna | GPT-6.1 Terra | Terra / Luna |
|---|---|---|---|
| Eingabe-Token | $0,10 | $1,00 | 10-fach |
| Zwischengespeicherte Eingabe | $0,01 | $0,05 | 5-fach |
| Ausgabe-Token | $0,50 | $5,00 | 10-fach |
| Cache-Schreibvorgang für 30 Minuten | $0,125 | $1,25 | 10-fach |
| Batch-Eingabe / -Ausgabe | ca. $0,05 / $0,25 | ca. $0,50 / $2,50 | 10-fach |
Die Tarife für Batch und Flex liegen bei etwa der Hälfte des Standardtarifs, der Fast-Tarif ist etwa doppelt so hoch. Zwei Kostenfaktoren werden leicht übersehen: Erstens werden bei einer Anfrage mit mehr als 272.000 Eingabe-Token die Eingabe und der Cache für die gesamte Anfrage zum doppelten Preis abgerechnet, die Ausgabe zum 1,5-Fachen. Zweitens können für Tools wie Websuche oder Computersteuerung zusätzliche Gebühren anfallen. Auch Reasoning-Token, erneute Versuche und Agent-Aufrufe über mehrere Runden beeinflussen den tatsächlichen Verbrauch.
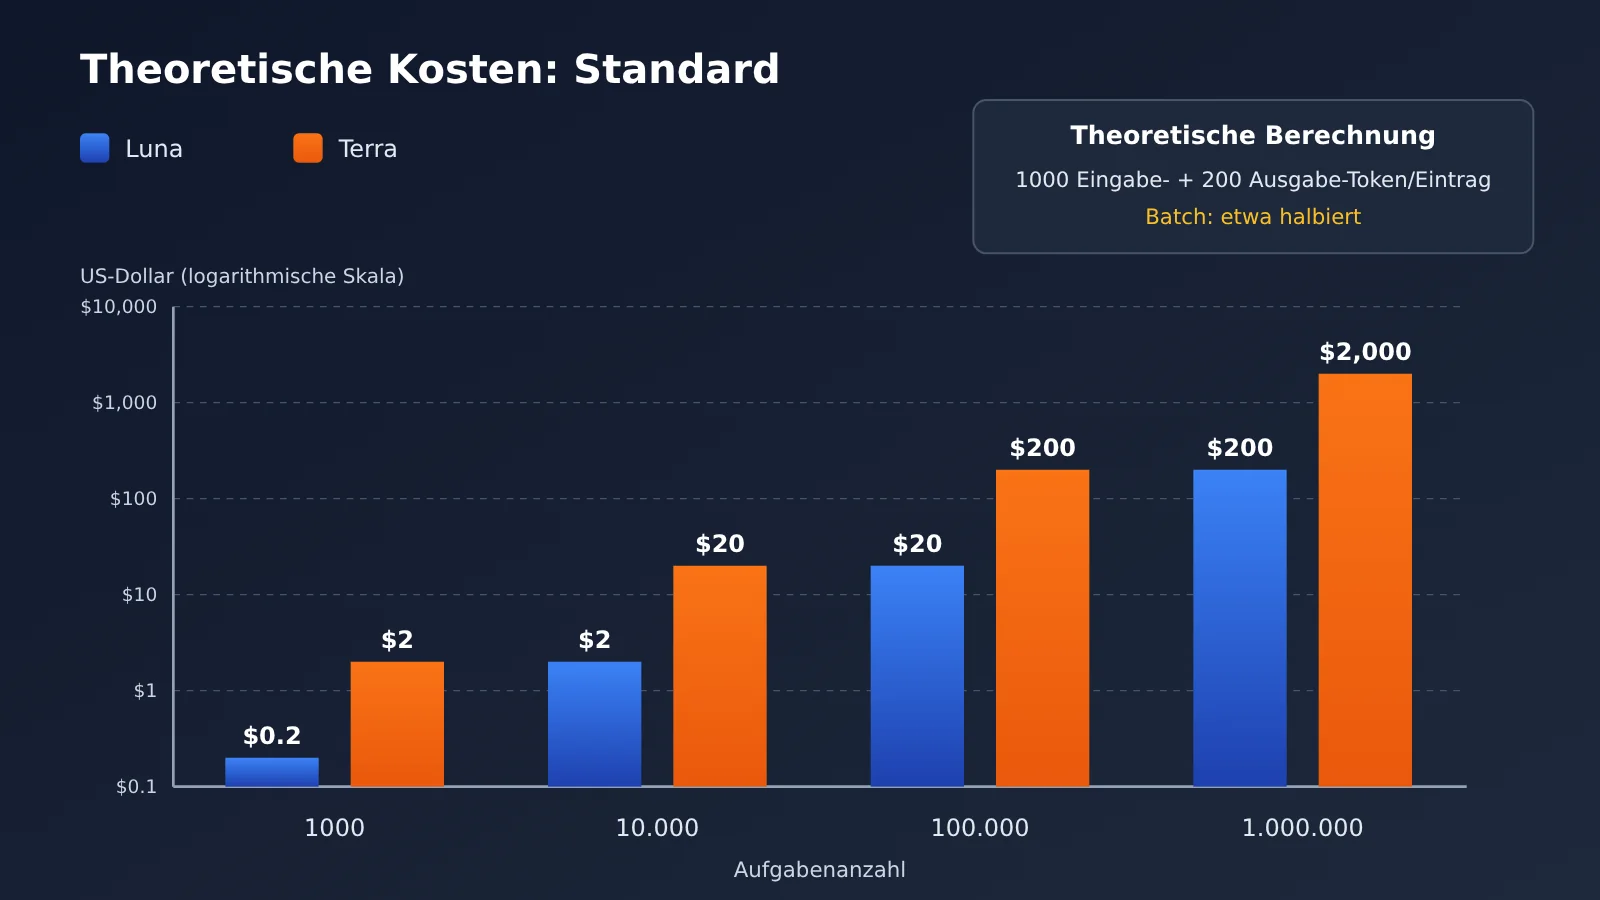
„Zehnmal teurer“ bezieht sich also auf den Token-Preis unter gleichen Abrechnungsbedingungen. Das bedeutet nicht, dass jede Aufgabe zehnmal so viel kostet. Eine theoretische Beispielrechnung: Bei 1.000 Eingabe-Token und 200 Ausgabe-Token pro Datensatz, ohne Cache und erneute Versuche, kostet die Verarbeitung von 100.000 Datensätzen im Standardmodus mit Luna etwa $20 und mit Terra etwa $200. Im Batch-Modus sind es rund $10 beziehungsweise $100. Das sind theoretische Werte auf Basis der veröffentlichten Stückpreise, keine tatsächlich gemessenen Rechnungsbeträge.
GPT-6.1 Terra im Vergleich zu GPT-6 Luna: vier Gruppen realer Testergebnisse
Der Stückpreis zeigt nur, wie viel man ausgibt. Entscheidend ist, was man dafür bekommt. Die folgenden vier Datensätze stammen von verschiedenen Institutionen und decken unterschiedliche Aufgabentypen ab. Sie zeigen, wie sich der Unterschied in der Genauigkeit mit zunehmender Schwierigkeit verändert.
43 Datenanalysefragen von Plotly: zehnmal so teuer, zwei Antworten mehr richtig
Der von Forschenden von Plotly und Mila entwickelte DataAnalyticsBench simuliert das Data Warehouse eines Windparkbetreibers mit rund 20 Millionen Zeilen synthetischer Daten. Beide Modelle beantworteten 43 Fragen mit denselben Tools. Die Ergebnisse:
| Kennzahl | GPT-6 Luna | GPT-6.1 Terra |
|---|---|---|
| Richtige Antworten | 38/43 (88,4 %) | 40/43 (93,0 %) |
| Kosten für den gesamten Test | $0.13 | $1.31 |
| Medianzeit pro Frage | 18 Sekunden | 15 Sekunden |
| Standardanalysen / unklare Fragen / unmögliche Anfragen / Datenqualität | Überall volle Punktzahl | Überall volle Punktzahl |
| Statistische Fallen | 3/5 | 4/5 |
| Versteckte Muster erkennen | 2/5 | 3/5 |
Der interessanteste Befund steckt in den Einzelergebnissen. Bei Standardanalysen, dem Erkennen unklarer Anforderungen, dem Ablehnen nicht lösbarer Anfragen und dem Aufdecken grundlegender Datenqualitätsprobleme schnitten beide Modelle gleich ab. Unterschiede gab es nur bei den anspruchsvolleren Analysen: statistischen Fallen und versteckten Mustern. Terra löste in beiden Kategorien jeweils eine Aufgabe mehr.
Grob gerechnet kostete Terra insgesamt $1.18 mehr und lieferte dafür zwei zusätzliche richtige Antworten. Das entspricht Mehrkosten von etwa $0.59 pro zusätzlich richtiger Antwort. Diese Grenzkosten ergeben sich aus den Gesamtkosten des Tests und sind kein verlässlicher Preis für die Fehlerkorrektur im Produktivbetrieb. Hängt von einer Frage eine Geschäftsentscheidung ab, sind $0.59 günstig. Geht es nur darum, in einem internen Bericht ein weiteres, unwichtiges Muster zu entdecken, sind die zehnfachen Kosten kaum nötig.
Ein weiteres Detail: Terra war pro Frage schneller, weil es kürzer antwortete und weniger Aufrufe benötigte – durchschnittlich etwa 4,5 Modellaufrufe und rund 1.460 Ausgabe-Token –, nicht weil es schneller generierte. Seine Ausgabegeschwindigkeit lag bei etwa 64 Token pro Sekunde. Zu beachten ist auch: Die Stichprobe umfasst nur 43 Fragen, und Terra lief über OpenRouter mit der standardmässigen Inferenzkonfiguration. Daraus lässt sich nicht ableiten, dass das Modell bei allen Unternehmensdatenanalysen eine Genauigkeit von 93 % erreicht.
DualEntry mit 101 Buchhaltungsaufgaben: Abstand wächst auf 11,9 Prozentpunkte
Der Accounting AI Benchmark von DualEntry bildet reale Geschäftsabläufe vergleichsweise gut ab. Die 101 Aufgaben verteilen sich auf acht Kategorien: Transaktionsklassifizierung, Buchungssätze, Kreditoren- und Debitorenbuchhaltung, Bankabstimmung, Finanzberichterstattung, Monatsabschluss und Buchhaltungswissen. Jedes Modell durchläuft drei Runden; eine Aufgabe gilt nur dann als bestanden, wenn sie in mindestens zwei davon korrekt gelöst wird.
Luna erreicht 66,3 %, Terra 78,2 % und das als Vergleich herangezogene GPT-6.1 Sol 81,2 %. Bei Terra zeigt der Blick auf die einzelnen Kategorien: Transaktionsklassifizierung 13/13, Buchungssätze 12/13 und Bankabstimmung 10/12. In der Kreditorenbuchhaltung sind es dagegen nur 7/13, in der Debitorenbuchhaltung und beim Monatsabschluss jeweils 7/12. DualEntry weist außerdem darauf hin, dass Terra und Luna in der Kreditorenbuchhaltung gemeinsam den letzten Platz belegen.
Für die Automatisierung großer Mengen ist die Zuverlässigkeit wichtiger als die Trefferquote bei einem einzelnen Durchlauf. Terra löst 65,3 % der Aufgaben in allen drei Runden korrekt, Sol 68,3 %. Luna liegt darunter; der Originaltext nennt keinen konkreten Wert. Wenn dieselbe Buchhaltungsaufgabe heute korrekt und morgen falsch gelöst wird, steigen die Kosten für die manuelle Prüfung schnell. Terra benötigt in diesem Test durchschnittlich 16,1 Sekunden pro Aufgabe, bei Token-Kosten von rund 0,042 US-Dollar. Für alle drei Runden zusammen ergeben sich etwa 12,73 US-Dollar. Die entsprechenden Kosten für Luna werden im Originaltext nicht eindeutig angegeben und daher hier nicht geschätzt.
OSWorld 2.1 und Fehlerrate bei Faktenfragen: Größter Abstand bei komplexen Aufgaben
Der Desktop-Benchmark OSWorld 2.1, den OpenAI in der Ankündigung von Terra vorstellt, prüft, ob ein Modell Benutzeroberflächen versteht, die richtigen Schaltflächen anklickt und mehrstufige Aufgaben erledigt. Auf der höchsten Reasoning-Stufe erreicht Luna 55,5 %, Terra 74,2 % – ein Abstand von 18,7 Prozentpunkten. Die geschätzten Kosten pro Aufgabe liegen bei 0,30 US-Dollar beziehungsweise 1,19 US-Dollar. Das ist nur etwa das 3,97-Fache, nicht das Zehnfache. Der Grund: Die Modelle verbrauchen für dieselbe Aufgabe unterschiedlich viele Token.
Noch deutlicher fällt das Ergebnis beim Test auf sachliche Fehler aus. Bei speziell entwickelten schwierigen Faktenfragen liegt Lunas Fehlerrate auf den drei Stufen Low / Medium / Max bei 44,3 %, 31,2 % und 18,4 %. Bei Terra sind es 16,7 %, 10,1 % und 4,3 %. Terras Fehlerrate auf Low ist damit niedriger als Lunas Fehlerrate auf Max. Beim visuellen Verständnis erreicht Luna auf der höchsten Reasoning-Stufe im MMMU-Pro-Benchmark 79,9 %, Terra 85,5 %.
Diese Zahlen stammen aus offiziellen Grafiken von OpenAI und nicht aus einer unabhängigen Überprüfung durch Dritte. Die schwierigen Faktenfragen sind gezielt darauf ausgelegt, Fehler zu provozieren. Das bedeutet nicht, dass Luna beim Schreiben im Alltag eine Fehlerrate von 44,3 % hat. Auch die OSWorld-Ergebnisse gelten nur unter den jeweiligen Testbedingungen.
Artificial-Analysis-Gesamtindex: Auch die Schlussfolgerungsintensität lässt sich optimieren
Die unabhängigen Tests von Artificial Analysis bieten eine weitere Perspektive. Auf der Stufe Max erreicht Luna im Gesamtintelligenzindex etwa 38 Punkte, Terra etwa 48. Die entsprechenden Kosten im Gesamtbenchmark liegen bei rund 0,07 und 0,40 US-Dollar – das ist etwa das 5,7-Fache. Beim Programmieragenten-Index ist der Abstand noch größer: Luna erreicht 31, Terra 48 Punkte.
Das Verständnis langer Dokumente im Benchmark AA-LCR bildet allerdings eine Ausnahme: Beide Modelle erreichen bei der höchsten Schlussfolgerungseinstellung rund 83 %. Zudem liegt Terra auf den Stufen Low und Medium innerhalb des getesteten Bereichs auf der Pareto-Grenze zwischen Kosten und Leistungsfähigkeit. Auf Max ist es dagegen nicht unbedingt die beste Wahl. Anders gesagt: Für die Automatisierung in großem Umfang gilt es, nicht nur das Modell, sondern auch die Schlussfolgerungsintensität abzustimmen.
Schnelleinstieg in die Stapelautomatisierung mit GPT-6.1 Terra und GPT-6 Luna
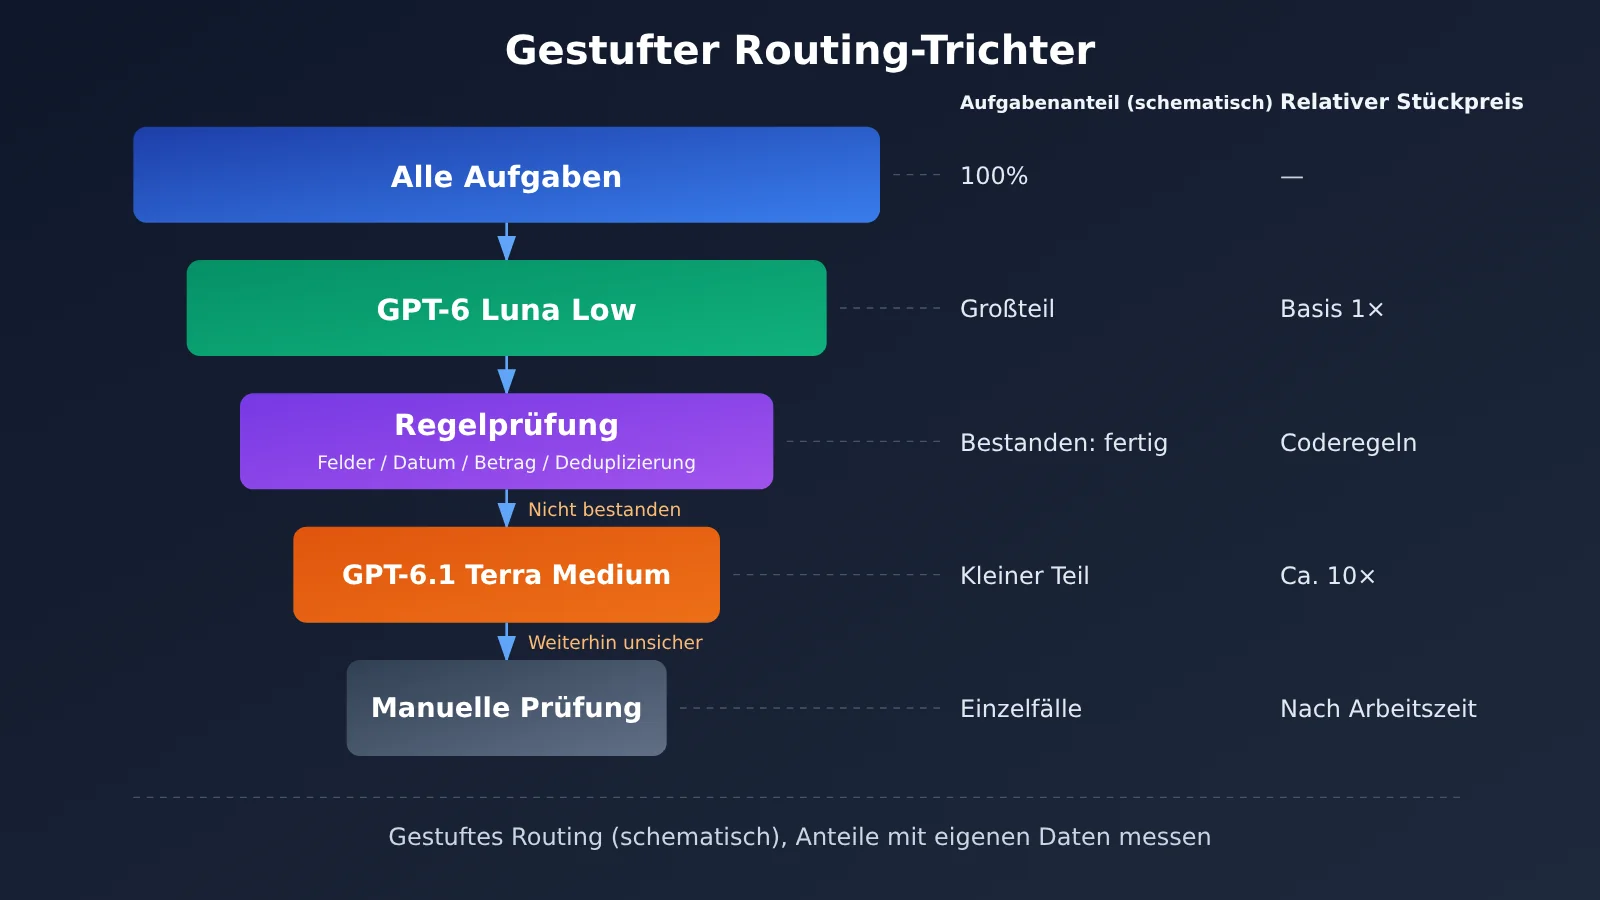
Aus den bisherigen Daten ergibt sich eine praktische Strategie: Die meisten Aufgaben mit klaren Regeln übernimmt Luna. Nur komplexe, risikoreiche oder nicht erfolgreich validierte Aufgaben werden an Terra weitergeleitet. Das folgende Minimalbeispiel lässt zunächst Luna Rechnungsfelder extrahieren und prüft sie anschließend anhand programmierter Regeln. Nur wenn die Prüfung fehlschlägt, kommt Terra zum Einsatz.
import json, openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

def extract(model, text, effort="low"):
    r = client.chat.completions.create(
        model=model, reasoning_effort=effort,
        response_format={"type": "json_object"},
        messages=[{"role": "user", "content": f"抽取 JSON:amount, tax, total, date\n{text}"}])
    return json.loads(r.choices[0].message.content)

def valid(d):
    return all(k in d for k in ("amount", "tax", "total", "date")) and \
        abs(float(d["amount"]) + float(d["tax"]) - float(d["total"])) < 0.01

result = extract("gpt-6-luna", "发票:金额 100.00,税额 6.00,合计 106.00,日期 2026-10-20")
if not valid(result):
    result = extract("gpt-6.1-terra", "...", effort="medium")
print(result)
Vollständigen Code für das mehrstufige Routing anzeigen
import json
import re
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

PROMPT = "从以下文本抽取 JSON,字段:amount, tax, total, date(YYYY-MM-DD)。缺失填 null。\n"

def call_model(model: str, text: str, effort: str = "low") -> Optional[dict]:
    try:
        resp = client.chat.completions.create(
            model=model,
            reasoning_effort=effort,
            response_format={"type": "json_object"},
            messages=[{"role": "user", "content": PROMPT + text}],
        )
        return json.loads(resp.choices[0].message.content)
    except Exception as e:
        print(f"[{model}] 调用失败: {e}")
        return None

def rule_check(d: Optional[dict]) -> list:
    """程序化规则校验:结构化输出只保证格式,不保证事实,所以必须二次校验"""
    if not d:
        return ["empty"]
    errors = []
    for k in ("amount", "tax", "total", "date"):
        if d.get(k) is None:
            errors.append(f"missing:{k}")
    if not errors:
        if abs(float(d["amount"]) + float(d["tax"]) - float(d["total"])) > 0.01:
            errors.append("sum_mismatch")
        if not re.match(r"^\d{4}-\d{2}-\d{2}$", str(d["date"])):
            errors.append("bad_date")
    return errors

def route(text: str) -> dict:
    # 第一层:Luna Low 处理全部输入
    d = call_model("gpt-6-luna", text, "low")
    if not rule_check(d):
        return {"data": d, "tier": "luna"}
    # 第二层:未通过校验的升级到 Terra Medium
    d = call_model("gpt-6.1-terra", text, "medium")
    errs = rule_check(d)
    if not errs:
        return {"data": d, "tier": "terra"}
    # 第三层:仍不确定的进入人工审核队列
    return {"data": d, "tier": "human_review", "errors": errs}

if __name__ == "__main__":
    samples = [
        "发票号 A001,金额 100.00 元,税额 6.00 元,价税合计 106.00 元,开票日期 2026-10-20",
        "收据:总计一百零六元整,含税,十月二十日",
    ]
    for s in samples:
        print(route(s))
🚀 Schnellstart: Offiziell wird empfohlen, zunächst beide Modelle mit einem API-Schlüssel zum Laufen zu bringen und dann eigene Beispiele zu testen. APIYI auf apiyi.com bietet eine OpenAI-kompatible Schnittstelle. Um zwischen
gpt-6-lunaundgpt-6.1-terrazu wechseln, muss nur der Parametermodelangepasst werden. Neue Nutzer erhalten ein kostenloses Testguthaben – ideal für erste kleine Vergleichstests.
Der zweite Schritt ist bei diesem Vorgehen entscheidend. Nur weil Luna angibt, sich sehr sicher zu sein, ist das Ergebnis nicht automatisch richtig. Die vom Modell selbst angegebene Konfidenz ist nicht unbedingt zuverlässig. Nutzen Sie stattdessen überprüfbare Regeln: Fehlen Felder? Sind die Datumsangaben gültig? Stimmen die Beträge überein? Entsprechen die wichtigsten Felder dem Originaltext? Gibt es doppelte Einträge?
Analyse der Auswirkungen von GPT-6.1 Terra und GPT-6 Luna
Auswirkungen für Entwickler: Aufgaben nach Typ aufteilen
Ausgehend von der offiziellen Positionierung und den oben genannten Tests lassen sich erste Empfehlungen für häufige Batch-Aufgaben ableiten. Sie basieren auf öffentlich verfügbaren Benchmarks – nicht alle Szenarien wurden bereits praktisch getestet. Vor dem produktiven Einsatz sollten Sie sie daher mit eigenen Daten überprüfen.
| Einsatzszenario | Erste Empfehlung | Begründung | Verfügbare Plattformen |
|---|---|---|---|
| 100.000 Artikel verschlagworten | GPT-6 Luna | Klare Regeln, stichprobenartig überprüfbar; beide erreichen bei gewöhnlichen Plotly-Analysen die volle Punktzahl | APIYI apiyi.com, OpenAI direkt |
| Rechnungs- und Bestelldaten aus Screenshots erfassen | GPT-6.1 Terra | Führend bei visuellen und operativen Fähigkeiten; Geldbeträge müssen weiterhin programmatisch geprüft werden | APIYI apiyi.com, OpenAI direkt |
| Tägliche Zusammenfassung von KI-Nachrichten | Luna für die Vorauswahl + Terra für die Detailanalyse | Luna übernimmt Deduplizierung und Verschlagwortung, Terra bewertet die Relevanz | APIYI, OpenAI direkt |
| Kundenservice-E-Mails sortieren und Antwortentwürfe erstellen | Hauptsächlich Luna | Risikoreiche Fälle wie Beschwerden und Rückerstattungen eskalieren oder an Mitarbeitende weiterleiten | APIYI, OpenAI direkt |
| Webseiten und Code stapelweise ändern | Terra oder Sol | Im Coding-Agent-Index erreicht Terra 48 Punkte, Luna 31 | APIYI, OpenAI direkt |
Ein weiterer Punkt, den Entwickler leicht übersehen, ist der Durchsatz. In der offiziellen Build-Stufe liegt Lunas Limit bei 2 Millionen Token pro Minute und 20 Millionen Token in der Batch-Warteschlange. Bei Terra sind es 1 Million beziehungsweise 3 Millionen. In der Launch-Stufe liegen Lunas Limits bei 10 Millionen beziehungsweise 1 Milliarde, Terras bei 4 Millionen beziehungsweise 200 Millionen. Bei Batch-Aufgaben mit mehr als 100.000 Einträgen kann Luna also deutlich mehr in die Warteschlange aufnehmen. Das sind allerdings Obergrenzen, keine Angaben zur Generierungsgeschwindigkeit. Die Limits können je nach Konto zudem abweichen.
Auswirkungen auf die Branche: Vom Stückpreis zu den Kosten pro brauchbarem Ergebnis
Am Tag der Veröffentlichung von Terra gab es in der Reddit-Community zwei Sichtweisen. Die einen fanden, Terra habe eine schwierige Positionierung: Luna sei bereits günstig genug, Sol dagegen leistungsfähiger. Die anderen wiesen darauf hin, dass Terra Low bereits eine niedrigere Faktenfehlerrate als Luna Max habe und man deshalb nicht nur auf den Stückpreis schauen dürfe. Einige Codex-Nutzer berichteten zudem, dass Terra mit hoher Reasoning-Intensität nicht unbedingt weniger Kontingent verbrauche als Sol mit mittlerer Intensität. Bei Luna wiederum werde der Kontingentvorteil bei komplexen Entwicklungsaufgaben durch Nacharbeit aufgezehrt. Das sind Einzelfälle. Ausserdem sind Codex-Abonnementkontingente und die Abrechnung von API-Tokens nicht dasselbe und lassen keine Rückschlüsse auf API-Kosten zu.
Dennoch weisen diese Beobachtungen auf denselben Trend hin: Bei der Bewertung von Massenautomatisierung geht es zunehmend nicht mehr darum, was ein einzelner Aufruf kostet, sondern was ein brauchbares Ergebnis kostet. Eine einfache Formel veranschaulicht das:
Gesamtkosten = Kosten für API-Aufrufe + Tool-Kosten + Kosten für Wiederholungsversuche + Kosten für manuelle Prüfung + Schäden durch Fehler
Bei den ersten beiden Posten hat Luna einen klaren Vorteil. Terra senkt dagegen durch seine niedrigere Fehlerquote die letzten drei. Welche Variante günstiger ist, hängt davon ab, was ein Fehler in Ihrem Unternehmen kostet. Auch Beobachtungen von MultiAI anhand einer kleinen Stichprobe stützen das: Ohne Reasoning machte Terra bei einigen Logik- und Rechenaufgaben Fehler; nach dem Wechsel auf Medium verbesserte sich die Leistung deutlich. Luna schnitt bei einfachen Aufgaben gut ab, machte aber bei mehrstufigen Logikaufgaben mehr Fehler.
So führen Sie einen eigenen Vergleichstest durch
Öffentlich verfügbare Daten lassen einige wichtige Fragen offen: Wie hoch ist die Fehlerquote der beiden Modelle bei der Klassifizierung von 100.000 realen chinesischsprachigen Artikeln? Wie stabil laufen sie über längere Zeit? Wie viel spart ein gemischter Ansatz tatsächlich? Und können geringere Kosten für die manuelle Prüfung den Aufpreis für Terra ausgleichen? Das lässt sich nur durch eigene Tests herausfinden.
Ein praktikabler Ansatz sind 200 bis 500 reale Beispiele aus dem eigenen Geschäftsbetrieb, für die das korrekte Ergebnis bereits feststeht. Das könnten zum Beispiel jeweils 100 Beispiele für einfache Klassifizierung, Extraktion von Schlüsselinformationen und Erkennung komplexer Inhalte sein sowie jeweils 50 für Faktenchecks und mehrstufige Tool-Operationen. Testen Sie dann vier Konfigurationen: Luna Low, Luna Medium, Terra Low und Terra Medium – jeweils mit denselben Eingaben, Eingabeaufforderungen, Tools und Bewertungskriterien. Wiederholen Sie einen Teil der Aufgaben mehrfach, um die Stabilität zu prüfen.
Konzentrieren Sie sich bei der Auswertung auf fünf Ergebnisse: Genauigkeit, API-Kosten pro 1.000 Aufgaben, durchschnittliche Bearbeitungszeit und P95-Bearbeitungszeit, Anzahl der manuellen Prüfungen und Nacharbeiten sowie Gesamtkosten pro 1.000 akzeptierten Ergebnissen. Wenn Sie die Modelle über eine Drittanbieterplattform bereitstellen, beachten Sie außerdem deren tatsächliche Abrechnungsregeln und prüfen Sie die Bedingungen zur Datenverarbeitung sowie die Compliance-Anforderungen.
Häufige Fragen (FAQ)
F1: Was ist der wichtigste Unterschied zwischen GPT-6.1 Terra und GPT-6 Luna?
Die technischen Daten sind nahezu identisch: Beide Modelle haben ein Kontextfenster von 1.050.000 Token und unterstützen dieselben Tools. Luna ist pro Token zehnmal günstiger und eignet sich für häufige Aufgaben mit klaren Regeln. Terra ist beim visuellen Verständnis, bei der Computerbedienung, komplexen Analysen und der faktischen Genauigkeit deutlich stärker. Es eignet sich daher für mehrstufige Aufgaben, bei denen Fehler hohe Kosten verursachen.
F2: Terra ist zehnmal teurer – ist es nur geringfügig genauer?
Das hängt von der Aufgabe ab. Im Plotly-Test zur Datenanalyse lag Terra nur rund 4,7 Prozentpunkte vorn, bei der Buchhaltungsaufgabe DualEntry waren es 11,9 und bei der Desktop-Bedienung in OSWorld 18,7 Prozentpunkte. In OSWorld lagen die Kosten pro Aufgabe zudem nur um etwa den Faktor 3,97 auseinander – nicht pauschal um den Faktor 10.
F3: Kann Luna mit der Reasoning-Stufe „max“ Terra ersetzen?
Das kann die Leistung in manchen Bereichen verbessern, gleicht den Unterschied zwischen den Modellen aber nicht aus. Bei den offiziellen schwierigen Faktenfragen lag die Fehlerrate von Luna Max bei 18,4 % und damit immer noch über den 16,7 % von Terra Low. Außerdem erhöht eine höhere Reasoning-Stufe den Token-Verbrauch, wodurch Luna seinen Kostenvorteil verlieren kann.
F4: Wie lassen sich die beiden Modelle schnell per API vergleichen?
Am besten verwenden Sie denselben Code und wechseln für den Vergleich nur den Modellnamen:
1. Registrieren Sie sich bei APIYI auf apiyi.com und holen Sie sich einen API-Schlüssel sowie kostenloses Testguthaben
2. Setzen Sie `base_url` auf `https://api.apiyi.com/v1`
3. Führen Sie dieselben Testfälle mit `gpt-6-luna` und `gpt-6.1-terra` aus und erfassen Sie Genauigkeit und Token-Verbrauch
F5: Wie lassen sich die Kosten bei großen Aufgabenmengen weiter senken?
Für Aufgaben, die keine Antwort in Echtzeit benötigen, bietet sich die Batch API an. Sie kostet ungefähr die Hälfte des Standardtarifs; der Anbieter sieht dafür ein Bearbeitungsfenster von 24 Stunden vor. Begrenzen Sie außerdem jede Eingabe auf höchstens 272.000 Token, um Zuschläge für lange Kontexte zu vermeiden. Bei APIYI auf apiyi.com zahlen Sie nach Verbrauch. So können Sie zunächst mit kleinen Mengen den tatsächlichen Token-Verbrauch pro Aufgabe ermitteln und erst danach hochskalieren.
F6: Welche Einschränkungen haben diese Testergebnisse?
Der Plotly-Test umfasst nur 43 Aufgaben und verwendet synthetische Daten. Die Ergebnisse zu OSWorld, MMMU-Pro und zur Fehlerrate bei Fakten stammen von OpenAI selbst und wurden nicht unabhängig überprüft. Die Ergebnisse von MultiAI mit 24/24 und 18/18 basieren nicht auf denselben Fragen und sind deshalb nicht direkt vergleichbar. Außerdem garantiert Structured Outputs nur das korrekte Format, nicht aber die Richtigkeit der Feldinhalte. Kein Benchmark-Ergebnis lässt sich mit der tatsächlichen Genauigkeit in Ihrem Anwendungsfall gleichsetzen.
GPT-6.1 Terra und GPT-6 Luna: Die wichtigsten Punkte
- Zehnfacher Preisunterschied: Luna kostet $0.10 für Eingabe und $0.50 für Ausgabe, Terra $1.00 beziehungsweise $5.00
- Geringer Abstand bei einfachen Aufgaben: Bei der regulären Plotly-Analyse und dem Erkennen unklarer Fragen erreichen beide die volle Punktzahl
- Grosser Abstand bei komplexen Aufgaben: Terra liegt bei Buchhaltungsaufgaben 11,9 Punkte und bei Desktop-Bedienung 18,7 Punkte vorn
- Unterschiede bei der faktischen Genauigkeit: Terra Low hat eine Fehlerquote von 16,7 % und liegt damit unter Luna Max mit 18,4 %
- Auch die Reasoning-Stufe zählt: Terra Low und Medium sind kosteneffizienter als die Max-Stufe
- Gestaffeltes Routing lohnt sich am meisten: Luna für die erste Prüfung, Regelprüfung, Terra als Auffangstufe und anschliessende menschliche Kontrolle
- Erst testen, dann einsetzen: Vier Konfigurationen mit 200 bis 500 eigenen Beispielen auf APIYI apiyi.com vergleichen
Fazit
Zurück zur Frage im Titel: Ob GPT-6.1 Terra oder GPT-6 Luna besser für die Automatisierung grosser Mengen geeignet ist, hängt von der Schwierigkeit der Aufgaben und den Kosten von Fehlern ab:
- Aufgaben mit klaren Regeln und automatischer Prüfung: Luna ist ein kostengünstiger Einstieg. Im Plotly-Test schnitten beide bei regulären Analysen gleich ab.
- Aufgaben mit hohem Risiko wie Bilderkennung, mehrstufige Bedienung und Finanzaufgaben: Die Mehrkosten von Terra können sich lohnen. Der Genauigkeitsvorsprung beträgt bis zu 18,7 Prozentpunkte.
- Das eigentliche Optimierungsziel: Entscheidend ist nicht der Preis eines einzelnen API-Aufrufs, sondern die Gesamtkosten pro brauchbarem Ergebnis – einschliesslich erneuter Versuche, Prüfung und Fehlerfolgen.
Für die meisten Teams ist eine Kombination besser als die Entscheidung für nur ein Modell: Luna übernimmt den Grossteil der einfachen Arbeit, Terra die wirklich schwierigen Aufgaben. Am besten vergleichen Sie die Modelle zunächst in einem kleinen Test mit eigenen Geschäftsbeispielen und entscheiden danach, wie Sie die Aufgaben verteilen.
Über APIYI apiyi.com können Sie schnell prüfen, wie sich beide Modelle für Ihren Anwendungsfall eignen. Mit einem einzigen API-Schlüssel wechseln Sie zwischen den Modellen; die nutzungsabhängige Abrechnung erleichtert die genaue Kalkulation der Kosten pro 1.000 Aufgaben.
📚 Quellen
- OpenAI: Introducing GPT-6.1 Terra: Ankündigung mit Diagrammen zu OSWorld, MMMU-Pro und der Rate sachlicher Fehler
- Link:
openai.com/index/introducing-gpt-6-1-terra -
Hinweis: Quelle für die offizielle Positionierung von Terra und die Benchmark-Daten
-
OpenAI API Pricing und Modellseiten: Preise, Fähigkeiten und Ratenlimits von Luna und Terra
- Link:
developers.openai.com/api/docs/pricing -
Hinweis: Grundlage für die Preise von Standard, Batch, Flex und Fast
-
OpenAI Batch API-Dokumentation: Kosten und Bearbeitungsfenster für die Stapelverarbeitung
- Link:
developers.openai.com/api/docs/guides/batch -
Hinweis: Möglichkeiten zur Kostensenkung bei umfangreichen asynchronen Aufgaben
-
Plotly: GPT-6.1 Terra Benchmark Results for Data Analysis: 43 Datenanalyseaufgaben im direkten Vergleich
- Link:
plotly.com/blog/gpt-6-1-terra-plotly-data-analytics-bench -
Hinweis: Genauigkeit, Kosten, Dauer und Ergebnisse der einzelnen Aufgaben
-
DualEntry: GPT-6.1 Terra Accounting Benchmark: Test mit 101 Buchhaltungsaufgaben
- Link:
dualentry.com/blog/gpt-6-1-terra-accounting-benchmark -
Hinweis: Genauigkeit, Aufgabenkategorien und Stabilität über drei Durchläufe
-
Artificial Analysis: Test von GPT-6.1 Terra: Gesamtwert im Intelligenzindex und Kosteneffizienz
- Link:
artificialanalysis.ai/models/releases/gpt-6-1-terra - Hinweis: Unabhängige Testergebnisse bei unterschiedlichen Stufen der Schlussfolgerungstiefe
Autor: Technikteam von APIYI
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI. Weitere Informationen zur Modellintegration finden Sie im Dokumentationszentrum unter docs.apiyi.com.