في أواخر سبتمبر ومطلع أكتوبر، شهدت النماذج اللغوية الكبيرة المتقدمة تحديثات متلاحقة: أطلقت Anthropic نموذج Claude Opus 5.5 في 22 سبتمبر، وبعد 8 أيام فقط أطلقت Google نموذج Gemini 4 Argon. يتقاطع توجه النموذجين إلى حد كبير؛ فكلاهما يركّز على الاستدلال متعدد الخطوات، والبرمجة باستخدام الوكلاء، وإنجاز مهام المعرفة في المؤسسات. كما أن السعر الرسمي لكليهما متطابق: 4 دولارات للإدخال و20 دولارًا للإخراج لكل مليون token. لذلك أصبح السؤال عن Gemini 4 Argon مقابل Claude Opus 5.5 من أكثر الأسئلة شيوعًا بين المطورين عند اختيار النموذج.
المعلومات المتاحة علنًا قليلة حاليًا. وأكثر البيانات الأولية اكتمالًا هي جدول المقارنة الذي يضم 19 معيارًا، ونشرته Google في وثائق تقييم Argon، ويتضمن Claude Opus 5.5. سنعتمد على هذا الجدول في تحليل كل معيار على حدة، مع الاستعانة بتقييمات مستقلة من جهات خارجية، مثل Artificial Analysis وVals، ومراعاة عوامل هندسية أخرى كالسعر والحد الأقصى للإخراج ومدى التوافر، لمساعدتك على تحديد الحالات الأنسب لكل نموذج.
الفائدة الأساسية: بعد قراءة المقال، ستتمكن من فهم الأرقام الموثوقة في جدول تقييم Google وتلك التي ينبغي التعامل معها بتحفّظ، كما ستتمكن من الاختيار بين Gemini 4 Argon وClaude Opus 5.5 بناءً على احتياجاتك الفعلية.
مقارنة المواصفات الأساسية بين Gemini 4 Argon وClaude Opus 5.5
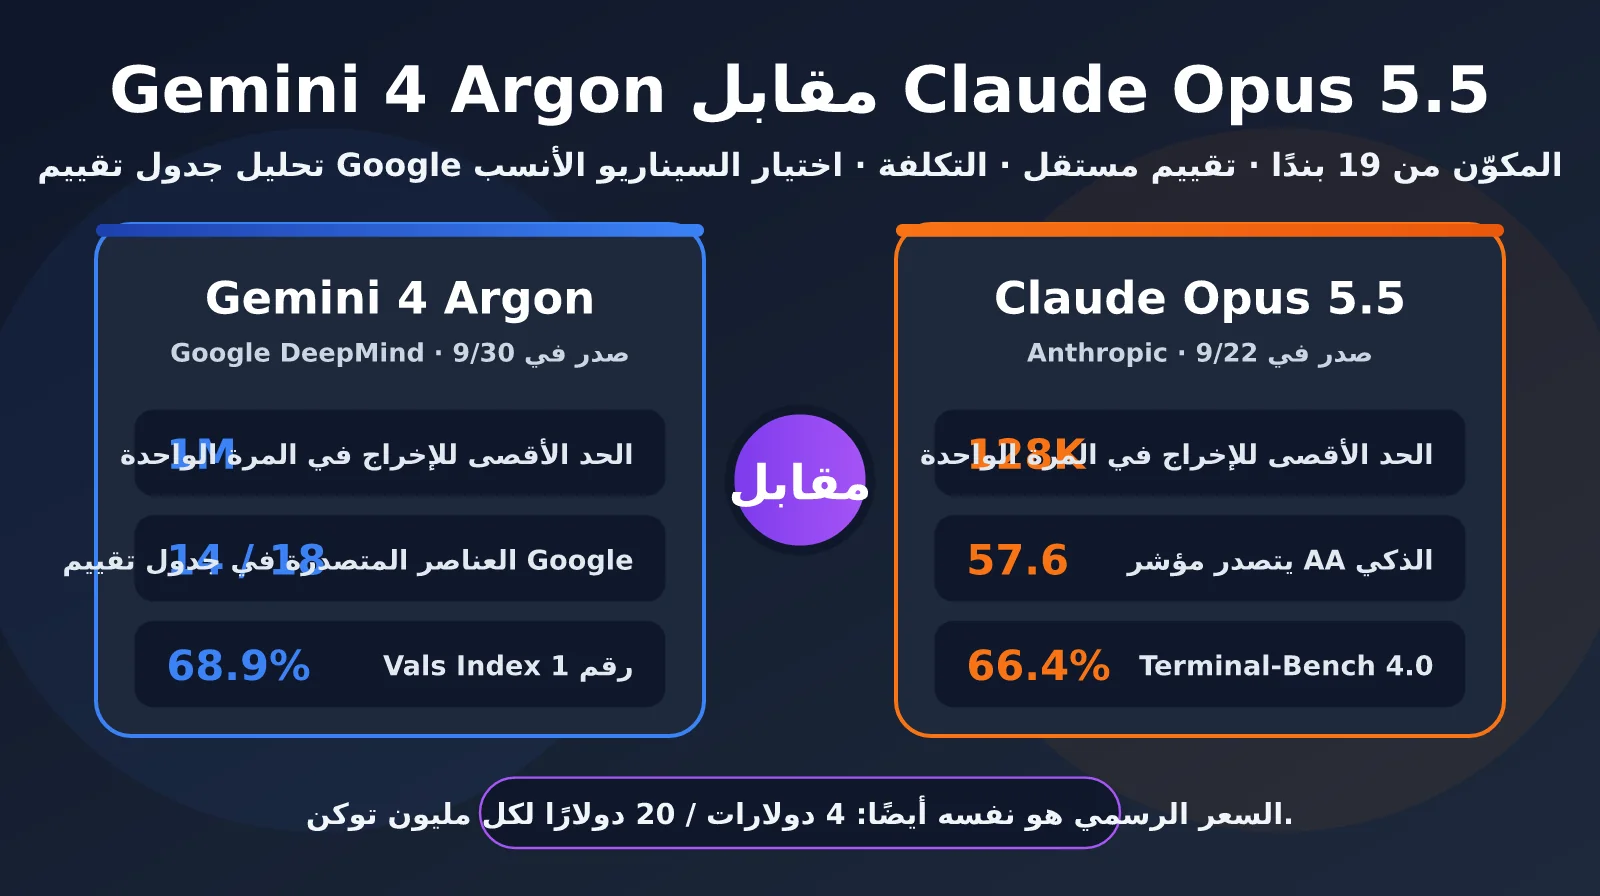
قبل الاطلاع على نتائج التقييم، لنقارن المواصفات الأساسية للنموذجين. السعر الرسمي متطابق تمامًا، أما الفروق الحقيقية فتتركز في الحد الأقصى للإخراج، ومدى التوافر، والسعر التمهيدي.
| بند المقارنة | Gemini 4 Argon | Claude Opus 5.5 |
|---|---|---|
| تاريخ الإصدار | 30 سبتمبر 2026 | 22 سبتمبر 2026 |
| التوافر حاليًا | إتاحة تدريجية عبر برنامج Fairwind وVertex AI؛ واجهة API المدفوعة غير متاحة للجميع بعد | متاح بالكامل عبر Claude API وBedrock وVertex AI وFoundry |
| معرّف النموذج | لم تعلنه Google رسميًا بعد | claude-opus-5-5 |
| السعر (الإدخال/الإخراج) | سعر تمهيدي: $2/$10؛ السعر الرسمي: $4/$20 | $4/$20 |
| قراءة البيانات المخزّنة مؤقتًا | خصم 95% على سعر الإدخال (ابتداءً من $0.10) | $0.20 |
| سعر المعالجة المجمّعة (Batch) | لم يُعلن بعد | $2/$10 |
| نافذة السياق | لم تُعلن رسميًا (تذكر جهات خارجية أنها 1M) | 1M، بلا رسوم إضافية للسياق الطويل |
| الحد الأقصى للإخراج في الطلب الواحد | 1M token | 128K token |
| التحكم في الاستدلال | مستويات استدلال مثل High | خمسة مستويات effort من low إلى max، مع التفكير التكيفي |
يتضح من الجدول أن أبرز ميزة عملية في Argon هي الحد الأقصى للإخراج البالغ 1M، أي نحو 8 أضعاف ما يقدمه Opus 5.5. وهذا يجعله مناسبًا لتوليد كميات كبيرة من الشيفرة وإجراء عمليات ترحيل واسعة النطاق. أما الميزة الأهم في Opus 5.5 فهي إمكانية استخدامه المستقر الآن: فمعرّف النموذج واضح، وهو متاح على جميع منصات السحابة الرئيسية، كما يوفر معالجة Batch بنصف السعر وخمسة مستويات للتحكم في effort، ما يجعله أكثر نضجًا من الناحية الهندسية.
🎯 نصيحة للاختيار: السعر الرسمي للنموذجين واحد، لذا يعتمد الاختيار أساسًا على نوع المهمة. ننصحك باستخدام منصة APIYI apiyi.com لاستدعاء Claude Opus 5.5 ونماذج Gemini عبر الواجهة نفسها، ثم اختبارهما جنبًا إلى جنب على مهامك الفعلية؛ فذلك أوثق من الاكتفاء بمقارنة النتائج على لوحات التقييم.
Gemini 4 Argon مقابل Claude Opus 5.5: تفصيل جدول تقييم Google بندًا بندًا
فيما يلي بيانات المقارنة التي نشرتها Google في وثيقة تقييم Argon. أبقينا هنا على عمودي Argon وOpus 5.5 فقط، ورتبنا النتائج حسب الفئة. تجدر الإشارة إلى أن هذا جدول صادر عن الشركة المطوّرة: أجرت Google اختبارات Argon بنفسها، بينما جاءت نتائج Opus 5.5 في معظمها من قوائم التقييم العامة أو بطاقة النظام الصادرة عن Anthropic، مع إعادة Google تشغيل بعض الاختبارات المعيارية بنفسها.
| الفئة | الاختبار المعياري | Gemini 4 Argon | Claude Opus 5.5 | النموذج المتقدم |
|---|---|---|---|---|
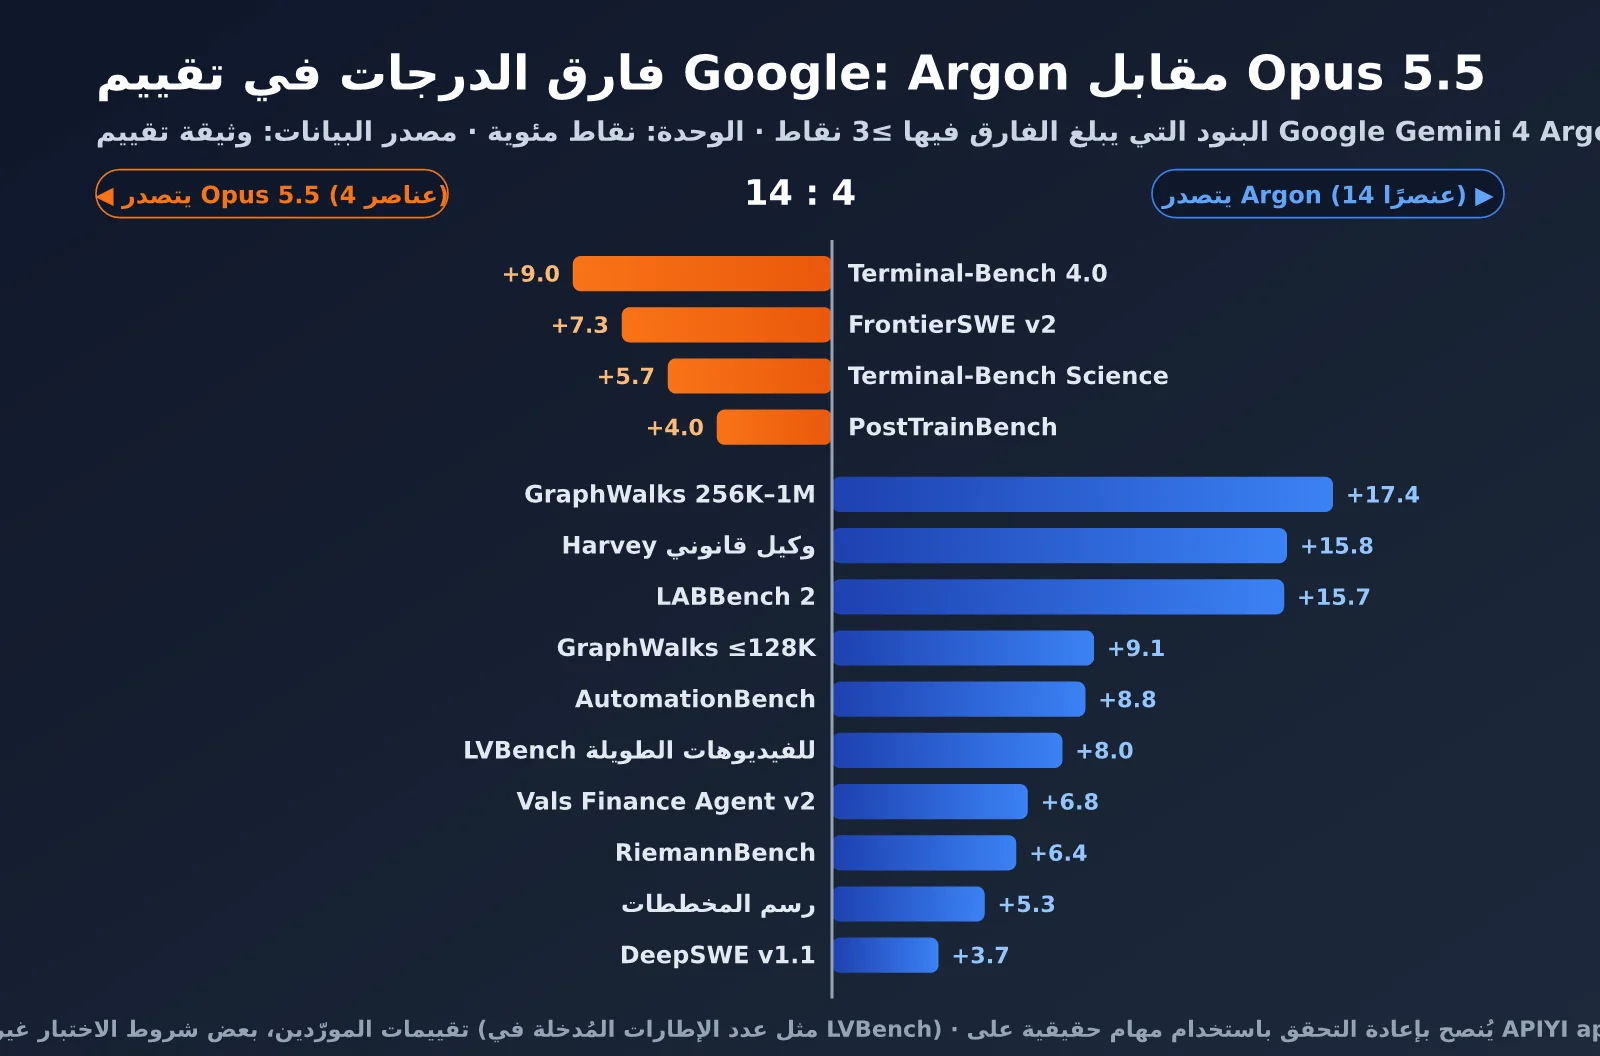
| العمل المعرفي | Vals Index | 68.9% | 67.0% | Argon +1.9 |
| العمل المعرفي | AutomationBench | 51.3% | 42.5% | Argon +8.8 |
| العمل المعرفي | Vals Finance Agent v2 | 65.4% | 58.6% | Argon +6.8 |
| العمل المعرفي | Harvey Legal Agent | 19.6% | 3.8% | Argon +15.8 |
| البرمجة باستخدام الوكلاء | DeepSWE v1.1 | 77.9% | 74.2% | Argon +3.7 |
| البرمجة باستخدام الوكلاء | FrontierSWE v2 | 55.0% | 62.3% | Opus +7.3 |
| البرمجة باستخدام الوكلاء | Vibe Code Bench | 91.9% | 90.3% | Argon +1.6 |
| البرمجة باستخدام الوكلاء | Terminal-Bench 4.0 | 57.4% | 66.4% | Opus +9.0 |
| هندسة تعلّم الآلة | PostTrainBench | 45.3% | 49.3% | Opus +4.0 |
| العلوم والرياضيات | Terminal-Bench Science 0.1 | 57.6% | 63.3% | Opus +5.7 |
| العلوم والرياضيات | LABBench 2 | 88.8% | 73.1% | Argon +15.7 |
| العلوم والرياضيات | RiemannBench | 76.0% | 69.6% | Argon +6.4 |
| السياق الطويل | GraphWalks ≤128K | 99.7% | 90.6% | Argon +9.1 |
| السياق الطويل | GraphWalks 256K–1M | 84.2% | 66.8% | Argon +17.4 |
| استخدام الحاسوب | Agent’s Last Exam | 39.5% | 38.2% | Argon +1.3 |
| متعدد الوسائط | Chartography | 71.6% | 66.3% | Argon +5.3 |
| متعدد الوسائط | LVBench للفيديو الطويل | 91.7% | 83.7% | Argon +8.0 |
| الأمن السيبراني | CWE-bench v1 | 68.0% | 67.0% | Argon +1.0 |
من بين الاختبارات المعيارية الـ18 التي تتوفر فيها نتائج لكلا النموذجين، تقدّم Argon في 14 اختبارًا، بينما تقدّم Opus 5.5 في 4 اختبارات. وتتشابه الاختبارات الأربعة التي تفوّق فيها Opus 5.5: FrontierSWE v2 وTerminal-Bench 4.0 وPostTrainBench وTerminal-Bench Science. وكلها مهام تتطلب العمل لفترة طويلة في بيئة طرفية حقيقية وتنفيذ الأوامر مرارًا. أما أكبر الفوارق لصالح Argon فتتركز في السياق الطويل، حيث يتقدم بـ17.4 نقطة في GraphWalks 256K–1M، إضافة إلى وكيل المهام القانونية وعلوم الحياة (LABBench 2).
نقاط تستدعي التحفظ في جدول تقييم Google
من الطبيعي أن تميل جداول التقييم الصادرة عن الشركات إلى إظهار نماذجها بصورة أفضل، وتضم حواشي هذا الجدول بعض التفاصيل التي تستحق الانتباه. ويساعد فهمها على تفسير الفارق بين Gemini 4 Argon وClaude Opus 5.5 بدقة:
- اختلاف عدد الإطارات المدخلة في LVBench: عالج Argon الفيديو كاملًا بمعدل إطار واحد في الثانية، بينما لم يتمكن Opus 5.5 من إدخال أكثر من 600 إطار بسبب قيود API. لذا يرجع جزء من الفارق في نتائج الفيديو الطويل إلى اختلاف شروط الإدخال.
- تخفيف المهلة الزمنية في Terminal-Bench Science: ضُبطت مهلة التحقق الخاصة بـArgon على ستة أضعاف القيمة الافتراضية. ومع ذلك، ظل Argon متأخرًا عن Opus 5.5 بمقدار 5.7 نقاط.
- اختلاف إطار اختبار DeepSWE: اختبرت Google Argon باستخدام إطار mini-swe agent، بينما استندت نتيجة Claude إلى بطاقة النظام الصادرة عن Anthropic؛ أي إن إطارَي الاختبار غير متطابقين.
- اختلاف النتائج عن البيانات التي أعلنتها Anthropic بنفسها: وفقًا للنتائج التي نشرتها Anthropic لـOpus 5.5، سجّل AutomationBench نسبة 40.0%، وبلغت نتيجة Chartography مع استخدام الأدوات 89.0%، بينما بلغت نتيجة OSWorld 2.0 نسبة 81.8%. أما جدول Google فيورد 66.3% فقط لـChartography، ويترك خانة OSWorld فارغة.
بعبارة أخرى، عند توحيد شروط الاختبار، يصبح الفارق بين النموذجين أقل مما يوحي به الجدول. ويبدو تقدم Argon في السياق الطويل والمهام القانونية وعلوم الحياة كبيرًا بما يكفي ليكون موثوقًا نسبيًا. أما الاختبارات التي لا يتجاوز الفارق فيها نقطة أو نقطتين، مثل Vals Index وVibe Code وCWE-bench، فيمكن اعتبارها متعادلة عمليًا.
نتائج التقييم المستقل لـ Gemini 4 Argon وClaude Opus 5.5
تختلف نتائج التقييم المستقل الذي أجرته جهات خارجية عن جدول تقييم Google، بل إنها تعكس اتجاهًا معاكسًا في مؤشر الذكاء الإجمالي. يلخص الجدول أدناه البيانات المنشورة من Artificial Analysis (AA) وVals.
| بند التقييم المستقل | Gemini 4 Argon | Claude Opus 5.5 | المتصدر |
|---|---|---|---|
| مؤشر الذكاء AA v4.3 | 52.6 | 57.6 | Opus بفارق 5.0 |
| ترتيب Vals Index | 68.90% (المركز الأول) | 66.97% (المركز الثالث) | Argon بفارق 1.9 |
| AA Terminal-Bench 4.0 | 57.1% | 59.6% | Opus بفارق 2.5 |
| AA Humanity’s Last Exam | 57.1% | 61.4% | Opus بفارق 4.3 |
| AA SciCode | 61.8% | 66.9% | Opus بفارق 5.1 |
| استدلال السياق الطويل لدى AA | 79.7% | 84.7% | Opus بفارق 5.0 |
| AA GDPval (Elo) | 1611 | 1846 | Opus بفارق 235 |
| AA AutomationBench | 77.5% | 69.5% | Argon بفارق 8.0 |
| سرعة الإخراج لدى AA | 48.9 رمزًا/ثانية | 92.2 رمزًا/ثانية | Opus أسرع بنحو 1.9 مرة |
في اختبارات AA، يتفوق Opus 5.5 في الاستدلال والبرمجة العلمية واستدلال السياق الطويل والمهام المهنية في GDPval، بينما يحقق Argon تفوقًا واضحًا فقط في أتمتة الأعمال ضمن AutomationBench. لكن المقارنة التي أجرتها AA ليست عادلة تمامًا: فقد اختُبر Argon على مستوى High فقط، بينما استخدم Opus 5.5 مستوى Max مع الاستدلال التكيفي. لذا قد يعود بعض الفارق إلى اختلاف إعدادات شدة الاستدلال، لا إلى تفاوت القدرات وحدها.
أما Vals Index، فيضع Argon في المركز الأول بين 41 نموذجًا، وOpus 5.5 في المركز الثالث. لكن الفارق بينهما يبلغ نحو 1.5 من الخطأ المعياري، ما يعني أن Argon يتقدم بفارق طفيف، من دون أن يكون تفوقه مؤكدًا. وبشكل عام، يقع Gemini 4 Argon وClaude Opus 5.5 في الفئة نفسها من حيث القدرات الإجمالية، ولا يتفوق أحدهما على الآخر بفارق ساحق.
💡 ملاحظة حول التقييم: قد تختلف نتائج جهات التقييم وتتجه في مسارات متعاكسة؛ لذا يبقى الاختبار ببياناتك هو الفيصل. تتيح منصة APIYI apiyi.com التبديل بين نماذج Claude وGemini وGPT وغيرها عبر واجهة موحدة، ما يسهل إعداد مجموعة تقييم صغيرة خاصة بك.
قراءة الفروقات الأساسية بين Gemini 4 Argon وClaude Opus 5.5
إذا وضعنا الدرجات جانبًا، فاختلاف نهج التصميم بين النموذجين قد يكون أقدر على توجيه اختيارك من الفوارق في نتائج الاختبارات الفردية.
نهجان مختلفان للمهام طويلة المسار
يركز Gemini 4 Argon على توسيع مساحة الإخراج في الطلب الواحد. فحد الإخراج البالغ مليونًا يتيح له توليد مئات الآلاف من أسطر الشيفرة أو تقارير طويلة جدًا في طلب واحد. وقد استخدمته Google داخليًا لإنجاز مهام مثل نقل أكثر من 800 ألف سطر من شيفرة C/C++ في نواة Fuchsia Zircon إلى Rust، واستبدال 32 ألف سطر من شيفرة SIMD في libgav1. يقلل هذا النهج الحاجة إلى تقسيم المهمة ودمج السياقات، ويناسب خصوصًا الحالات التي تتطلب «إنتاج كمية كبيرة من المحتوى دفعة واحدة».
أما Claude Opus 5.5، فيركز على جعل عملية الاستدلال أكثر قابلية للتحكم. فهو لا يسعى إلى إخراج كميات هائلة من المحتوى، بل يوفر خمسة مستويات للجهد، من low إلى max، إلى جانب التفكير التكيفي المفعّل دائمًا، ما يتيح للمطورين ضبط عمق الاستدلال وتكلفته بحسب صعوبة المهمة. وعند استخدامه مع أطر الوكلاء الذكيين مثل Claude Code، يكون Opus 5.5 أفضل في تنفيذ استدعاءات الأدوات على مدى جولات متعددة، وملاحظة النتائج، ثم تصحيح المسار. وهذا يفسر تفوقه الواضح في مهام التفاعل مع الطرفية مثل Terminal-Bench.
السرعة وزمن الاستجابة والاستقرار
تُظهر اختبارات Artificial Analysis أن سرعة إخراج Opus 5.5 تبلغ نحو 92 رمزًا في الثانية، أي ما يقارب ضعف سرعة Argon البالغة 48.9 رمزًا في الثانية. ويظهر هذا الفارق مباشرةً في تجربة المستخدم عند استخدام مساعد برمجي تفاعلي أو وكيل لخدمة العملاء. أما ميزة Argon، فهي قدرته على إنجاز عمل أكبر في الطلب الواحد، ما يجعله مناسبًا للمهام الخلفية التي لا تتطلب استجابة فورية، لكنها كبيرة الحجم.
إضافة إلى ذلك، يعمل Opus 5.5 باستقرار على عدة منصات سحابية منذ أسابيع، مع وثائق ناضجة للحصص وحدود الاستخدام ومعالجة الأخطاء. أما Argon، فلا يزال في المراحل الأولى من التوسع، ولم تتضح بعد سياسات الحصص وحدود الاستخدام لديه. لذلك، ينبغي ألا يقل وزن هذا العامل عن وزن نتائج الاختبارات المعيارية عند بناء أنظمة إنتاج تتطلب مستوى مرتفعًا من اتفاقية مستوى الخدمة (SLA).
الأمان والحماية من حقن الموجهات
تضع الشركتان أمان الوكلاء الذكيين في صدارة أولوياتهما. وتقول Google إن Argon هو أكثر نماذجها مقاومةً لحقن الموجهات غير المباشر حتى الآن، وإنه يتصدر معيار Gray Swan IPI، لكنها لم تنشر نتائج رقمية محددة. في المقابل، يشير تحليل صادر عن شركة أمنية مستقلة إلى أن Opus 5.5 يتعادل مع Claude Fable 5.1 في تسجيل أدنى معدل لنجاح هجمات الحقن على المعيار نفسه. بعبارة أخرى، يقع كلا النموذجين ضمن الفئة الأولى في الحماية من حقن الموجهات، ويمكن لكل منهما الادعاء بأنه متصدر. وإذا كان وكيلك يحتاج إلى قراءة صفحات الويب أو رسائل البريد الإلكتروني أو المستندات الخارجية، فستظل بحاجة، أيًا كان النموذج الذي تختاره، إلى عزل صلاحيات الأدوات عن النموذج وإضافة آلية للمراجعة والتأكيد البشري.
مقارنة التكلفة بين Gemini 4 Argon وClaude Opus 5.5
السعر الرسمي لكليهما متطابق، لكنهما يستهلكان كميات مختلفة من الرموز لإنجاز المهمة نفسها، ما يؤدي إلى تفاوت كبير في التكلفة الفعلية. يوضح الجدول التالي تكلفة المهمة الواحدة، وفقًا لاختبارات أجرتها جهة خارجية.
| معيار التكلفة | Gemini 4 Argon | Claude Opus 5.5 | الفارق |
|---|---|---|---|
| متوسط تكلفة المهمة الواحدة في AA | $1.99 (سعر ترويجي) | $5.98 | تكلفة Argon نحو الثلث |
| التكلفة الإجمالية لتشغيل مؤشر AA بالكامل | $2,407 | $8,708 | تكلفة Argon نحو 28% |
| تكلفة الاختبار الواحد في Vals | $15.68 | $32.14 | تكلفة Argon نحو 49% |
| تكلفة المهمة الواحدة في AA بعد احتساب السعر الرسمي | نحو $3.98 | $5.98 | لا يزال Argon أرخص بنحو الثلث |
| المهام المجمّعة عبر Batch | لم يُعلن عنها | نصف السعر: $2/$10 | يتوفر لـOpus خصم مؤكد للمهام المجمّعة |
حتى عند احتساب السعر الرسمي البالغ $4/$20، تظل تكلفة المهمة الواحدة لـArgon في اختبار AA أقل بنحو الثلث من Opus 5.5. ويرجع ذلك جزئيًا إلى أن عملية الاستدلال في Opus 5.5 تكون أطول عند استخدام فئة Max. وإذا خُفّض مستوى effort في Opus 5.5 إلى medium أو high، فستنخفض التكلفة بوضوح؛ وهذه إحدى الفوائد العملية للتحكم في مستويات effort الخمسة في Opus 5.5. كذلك، بالنسبة إلى مهام المعالجة المجمّعة غير المتصلة بالإنترنت، فإن خصم Batch المؤكد والمتاح في Opus 5.5 أكثر وضوحًا حاليًا من أسعار المهام المجمّعة التي لم يُعلن عنها بعد لـArgon.
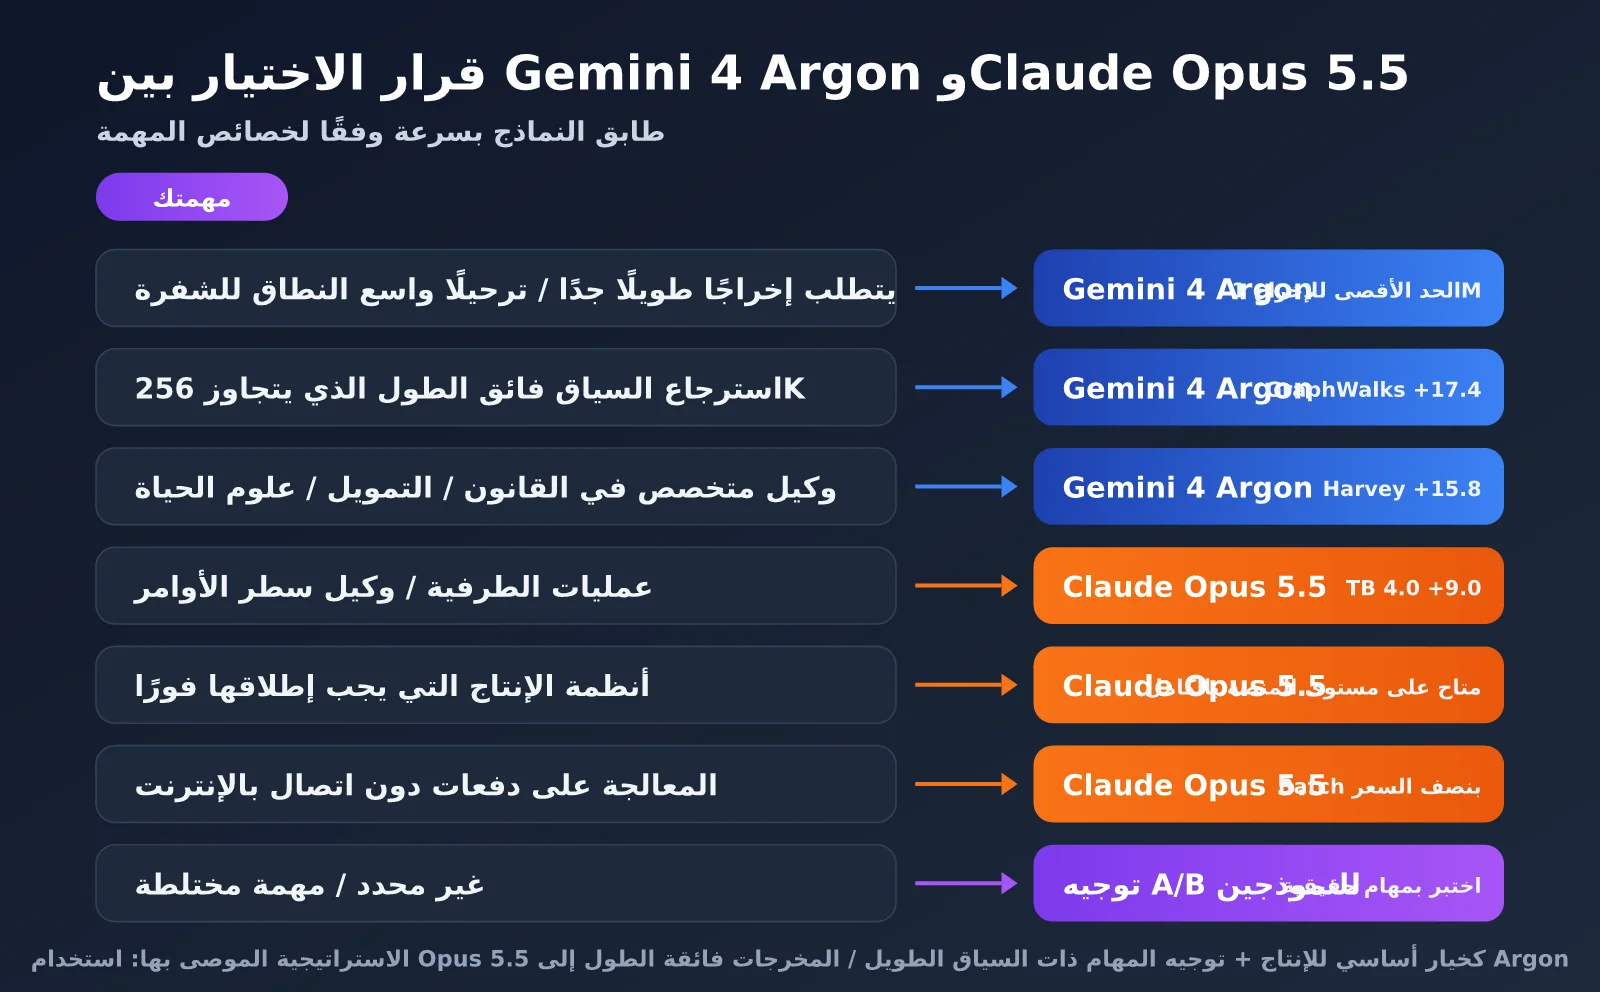
Gemini 4 Argon مقابل Claude Opus 5.5: توصيات حسب السيناريو ونصائح لاتخاذ القرار
استنادًا إلى جدول تقييمات Google والتقييمات المستقلة والتكلفة ومدى التوفر، يمكن تقديم توصيات واضحة نسبيًا بحسب سيناريو الاستخدام:
| سيناريو الاستخدام | النموذج الموصى به | السبب الرئيسي |
|---|---|---|
| ترحيل واسع النطاق للبرمجيات / توليد شيفرات طويلة جدًا | Gemini 4 Argon | حد أقصى للإخراج يبلغ 1M، وتقدّم بـ3.7 نقاط في DeepSWE |
| استرجاع المعلومات من سياق طويل جدًا يتجاوز 256K | Gemini 4 Argon | يتقدّم بـ17.4 نقطة في GraphWalks ضمن نطاق 256K–1M |
| الوكلاء المتخصصون في القانون والتمويل | Gemini 4 Argon | يتقدّم بـ15.8 نقطة في Harvey و6.8 نقاط في Finance Agent |
| فهم الفيديوهات الطويلة والمخططات البيانية | Gemini 4 Argon | يتقدّم في كل من LVBench وChartography |
| التعامل مع الطرفية ووكلاء سطر الأوامر | Claude Opus 5.5 | يتقدّم بـ9 نقاط في Terminal-Bench 4.0 |
| البرمجة العلمية والاستدلال المعقد | Claude Opus 5.5 | يتقدّم في اختبارات SciCode وHLE وCritPt من Artificial Analysis |
| أنظمة الإنتاج التي يلزم تشغيلها فورًا | Claude Opus 5.5 | متاح على جميع المنصات، مع معرّف نموذج وحصص استخدام واضحة |
| المعالجة الدفعية دون اتصال | Claude Opus 5.5 | سعر Batch بنصف التكلفة، $2/$10، مؤكّد |
تطبيق توجيه المهام بين Gemini 4 Argon وClaude Opus 5.5
بالنسبة إلى معظم الفرق، تتمثل الاستراتيجية الأكثر عملية في استخدام النموذجين معًا بدلًا من اختيار أحدهما فقط: استخدموا Opus 5.5 كنموذج أساسي في الإنتاج، ثم وجّهوا إليه تدريجيًا المهام التي يتفوّق فيها Argon، مثل المهام ذات السياق الطويل أو الإخراج بالغ الطول. فيما يلي مثال مبسّط جدًا يعتمد على واجهة متوافقة مع OpenAI.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口
)

OPUS = "claude-opus-5-5"
ARGON = os.getenv("ARGON_MODEL", "gemini-4-argon")  # 以平台实际上线 ID 为准

def pick_model(prompt_tokens: int, need_long_output: bool) -> str:
    # 超长上下文或超长输出走 Argon,其余默认 Opus 5.5
    return ARGON if prompt_tokens > 256_000 or need_long_output else OPUS

model = pick_model(prompt_tokens=12_000, need_long_output=False)
resp = client.chat.completions.create(
    model=model,
    messages=[{"role": "user", "content": "排查这个 CI 流水线失败的原因"}],
)
print(model, resp.choices[0].message.content)
عرض الشيفرة الكاملة: مقارنة A/B بين نموذجين للمهمة نفسها
import os
import time
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

MODELS = {
    "claude-opus-5-5": (4.0, 20.0),
    os.getenv("ARGON_MODEL", "gemini-4-argon"): (
        float(os.getenv("ARGON_PRICE_IN", "2")),
        float(os.getenv("ARGON_PRICE_OUT", "10")),
    ),
}

TASKS = [
    "阅读以下合同条款,列出对乙方不利的 5 处风险并给出修改建议:...",
    "把这段 Python 2 代码迁移到 Python 3.12 并补充类型注解:...",
    "根据以下日志定位服务超时的根因:...",
]


def run(model: str, task: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        max_tokens=16000,
        messages=[{"role": "user", "content": task}],
    )
    u = resp.usage
    price_in, price_out = MODELS[model]
    cost = (u.prompt_tokens * price_in + u.completion_tokens * price_out) / 1_000_000
    return {
        "model": model,
        "latency": round(time.time() - start, 1),
        "out_tokens": u.completion_tokens,
        "cost": round(cost, 4),
        "answer": resp.choices[0].message.content,
    }


if __name__ == "__main__":
    for task in TASKS:
        print("=" * 60, "\n任务:", task[:30])
        for model in MODELS:
            r = run(model, task)
            print(f"[{r['model']}] {r['latency']}s, 输出 {r['out_tokens']} token, ${r['cost']}")
يسجّل هذا البرنامج النصي لمقارنة A/B زمن الاستجابة وعدد رموز الإخراج والتكلفة لكل نموذج عند تنفيذ المهمة نفسها. يُنصح بإعداد 30–50 مهمة حقيقية تمثّل عملك، ثم تقييم النتائج يدويًا أو باستخدام نموذج تقييم قبل تحديد نسبة توجيه المهام إلى كل نموذج.
🚀 للبدء سريعًا: يمكنك التسجيل أولًا في APIYI على apiyi.com للحصول على رصيد تجريبي، ثم اختبار Claude Opus 5.5 باستخدام برنامج مقارنة A/B أعلاه. وبعد الإطلاق الرسمي لـArgon على المنصة، لن تحتاج إلا إلى تعديل اسم النموذج في متغيرات البيئة لإجراء المقارنة.
الأسئلة الشائعة
س1: أيهما أقوى، Gemini 4 Argon أم Claude Opus 5.5؟
لا توجد إجابة مطلقة. يتقدّم Argon في 14 اختبارًا ضمن جدول تقييمات Google، مقابل 4 اختبارات يتقدّم فيها Opus 5.5. لكن في مؤشر الذكاء العام من Artificial Analysis، يتقدّم Opus 5.5 بنتيجة 57.6 مقابل 52.6. ينتمي النموذجان إلى الفئة نفسها تقريبًا: يتفوّق Argon في السياقات الطويلة والإخراج بالغ الطول والوكلاء المتخصصين، بينما يتفوّق Opus 5.5 في التعامل مع الطرفية والاستدلال المعقد والنضج الهندسي.
س2: هل يمكن الوثوق ببيانات جدول تقييمات Google؟
يمكن الاستفادة منها كمرجع، لكن ينبغي التعامل معها بتحفّظ. فهذا جدول نشرته Google، وظروف الاختبار في بعض المعايير ليست متكافئة؛ فعلى سبيل المثال، يختلف عدد إطارات الإدخال في LVBench وإعداد المهلة الزمنية في Terminal-Bench Science. كما أن بعض نتائج Opus 5.5 أقل من البيانات التي نشرتها Anthropic بنفسها. يُنصح بالتركيز على الاختبارات التي يتجاوز فيها فارق التقدّم 5 نقاط، أما الفروق بمقدار نقطة أو نقطتين فيمكن اعتبارها تعادلًا.
س3: هل يمكنني استدعاء النموذجين معًا الآن؟
يتوفر Claude Opus 5.5 بالكامل عبر Claude API وBedrock وVertex AI وFoundry. أما Gemini 4 Argon، فما زال يُتاح تدريجيًا؛ إذ أصبح بالإمكان الوصول إليه عبر Vertex AI، لكن واجهة API المدفوعة لم تُفتح بالكامل بعد. يُنصح بالبدء عبر APIYI على apiyi.com، حيث يمكنك استخدام Opus 5.5 ونماذج Gemini، ثم مقارنة Argon بالنماذج الأخرى بمجرد إطلاقه رسميًا، وذلك بتغيير معامل `model` مباشرةً.
س4: سعر النموذجين متساوٍ؛ فأيهما أقل تكلفة فعليًا؟
بحسب اختبارات الجهات الخارجية، تتراوح تكلفة المهمة الواحدة باستخدام Argon بين ثلث ونصف تكلفة المهمة باستخدام Opus 5.5، وتكون ميزته أوضح خلال فترة التجربة الأولية. لكن يمكن خفض تكلفة Opus 5.5 كثيرًا عبر اختيار مستوى `effort` أقل واستخدام Batch بنصف السعر. وأدق طريقة هي تسجيل بيانات `usage` أثناء تنفيذ مهام حقيقية ثم حساب التكلفة. كما تسهّل الفاتورة الموحدة في منصة APIYI على apiyi.com المقارنة المباشرة بين التكلفة الفعلية للنموذجين.
الخلاصة
المنافسة بين Gemini 4 Argon وClaude Opus 5.5 متقاربة جدًا. فبحسب جدول تقييمات Google، يتفوق Argon بوضوح في التعامل مع السياقات الطويلة، ووكلاء القانون والتمويل، وعلوم الحياة، والمهام متعددة الوسائط. كما أن حدّه الأقصى البالغ مليون وحدة إخراج يمنحه قدرة لا يضاهيه فيها أي نموذج آخر. أما التقييمات المستقلة، فتُظهر تفوق Opus 5.5 في الاستدلال والبرمجة للأبحاث والعمل عبر الطرفية. وقد أصبح متاحًا بالفعل على جميع المنصات، مع نضج أكبر في الجوانب الهندسية.
النهج الذي نوصي به حاليًا هو اعتماد Claude Opus 5.5 نموذجًا أساسيًا في بيئة الإنتاج، وإدخال Gemini 4 Argon تدريجيًا كنموذج مخصص للمهام ذات السياق الطويل أو التي تتطلب مخرجات فائقة الطول، مع مواصلة إجراء اختبارات A/B باستخدام مجموعة المهام الفعلية لديكم. وبعد إتاحة واجهة API المدفوعة لـArgon بالكامل وصدور مزيد من التقييمات المستقلة، يمكن تعديل نسب توجيه الطلبات استنادًا إلى البيانات.
نوصي باستخدام منصة APIYI apiyi.com لدمج نماذج Claude وGemini من خلال واجهة موحدة وفاتورة واحدة، ومقارنة النماذج المتعددة وتوجيه الطلبات بينها، بحيث تستند قرارات اختيار النماذج إلى بيانات فعلية.
المراجع:
- مقالة Google الرسمية عن إطلاق Gemini 4 Argon: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- إعلان Anthropic عن Claude Opus 5.5: anthropic.com/news
- مؤشر الذكاء ومقارنات النماذج من Artificial Analysis: artificialanalysis.ai
- قائمة تقييمات النماذج من Vals AI: vals.ai
- تجميع شامل لنتائج تقييم Gemini 4 Argon (ToolScout): toolscout.ai/news/gemini-4-argon-benchmarks
الكاتب: فريق APIYI | نتابع باستمرار أحدث تقييمات نماذج اللغة الكبيرة وسبل اختيارها. لمزيد من المعلومات حول دمج النماذج، تفضلوا بزيارة APIYI apiyi.com.