작성자 주: Terra의 토큰 단가는 Luna의 10배지만, 정확도 차이는 4.7~18.7%포인트에 그쳐요. 이 글에서는 Plotly, DualEntry, OSWorld 등의 실제 테스트 데이터를 바탕으로 대량 자동화에서 ‘정답 하나당 비용’을 계산해 봅니다.
OpenAI는 2026년 10월 26일 GPT-6.1 Terra를 출시했어요. GPT-6 Luna가 출시된 지 불과 한 달여 만이었죠. 두 모델의 API 가격은 무려 10배 차이가 나지만, 제3자가 같은 조건에서 진행한 테스트에서 Terra의 정확도 우위는 5%포인트 미만부터 약 19%포인트까지 다양했어요. 대량 자동화 환경에서 이 가격 차이를 감수할 가치가 있는지는 개발자들 사이에서 가장 많이 논의된 질문이 됐어요.
이 글은 인상만으로 작성한 모델 평가가 아니에요. Plotly, DualEntry, Artificial Analysis는 Terra 출시 당일 테스트 결과를 공개했고, OpenAI도 OSWorld 2.1, MMMU-Pro와 사실 오류율 데이터를 제공했어요. 이 글에서는 이 데이터를 함께 살펴보며 한 가지 구체적인 질문에 답합니다. 추가로 지불한 비용이 실제로 유용한 정답을 얼마나 더 가져다줄까요?
핵심 내용: 이 글을 읽으면 GPT-6.1 Terra와 GPT-6 Luna가 어떤 대량 작업에서 큰 차이를 보이고 어떤 작업에서는 차이가 거의 없는지 알 수 있어요. ‘Luna로 1차 선별 + 규칙 검증 + Terra로 보완’하는 혼합 방식의 코드도 확인할 수 있어요.
GPT-6.1 Terra와 GPT-6 Luna 핵심 정보 한눈에 보기
두 모델은 모두 GPT-6 계열이지만 용도는 뚜렷하게 달라요. OpenAI는 Luna를 작업 내용이 명확하고 빈도가 높으며 대량으로 처리해야 하는 작업에 적합한 고효율 모델로 소개합니다. Terra는 시각적 추론, 정확한 컴퓨터 조작, 자연스러운 글쓰기를 내세우며 Luna와 Sol 사이의 중간급 모델로 자리 잡고 있어요.
| 항목 | GPT-6 Luna | GPT-6.1 Terra |
|---|---|---|
| 출시일 | 2026년 9월 22일 | 2026년 10월 26일 |
| API ID | gpt-6-luna |
gpt-6.1-terra |
| 공식 포지셔닝 | 빈도가 높고 규칙이 명확한 대량 작업 | 시각적 추론, 컴퓨터 조작, 다단계 작업 |
| 컨텍스트 / 최대 출력 | 1,050,000 / 128,000 토큰 | 1,050,000 / 128,000 토큰 |
| 추론 강도 | none부터 max까지 6단계, 기본값 medium | none부터 max까지 6단계, 기본값 medium |
| 대표 활용 사례 | 태그 분류, 이메일 분류, 필드 추출 | 송장 입력, 상품 이미지 매칭, 인터페이스 조작 |
사양만 보면 두 모델은 거의 같아요. 모두 텍스트와 이미지 입력, Structured Outputs, Function Calling, Responses API, Batch API를 지원하며 Web Search, File Search, Computer Use 등의 도구도 사용할 수 있어요. 실질적인 차이는 가격과 복잡한 작업을 처리하는 능력에 있습니다.
주목할 점은 OpenAI의 모델 선택 가이드가 “대량 작업에는 Luna를 쓰세요” 또는 “정확도가 중요하면 Terra를 쓰세요”라고 말하지 않는다는 거예요. 공식 권장 사항은 동일한 실제 입력으로 테스트한 뒤, 품질 요구사항을 충족하는 가장 저렴한 구성을 선택하는 것입니다. 이 원칙을 염두에 두고 아래 데이터를 살펴보세요.
GPT-6.1 Terra와 GPT-6 Luna의 API 가격 차이
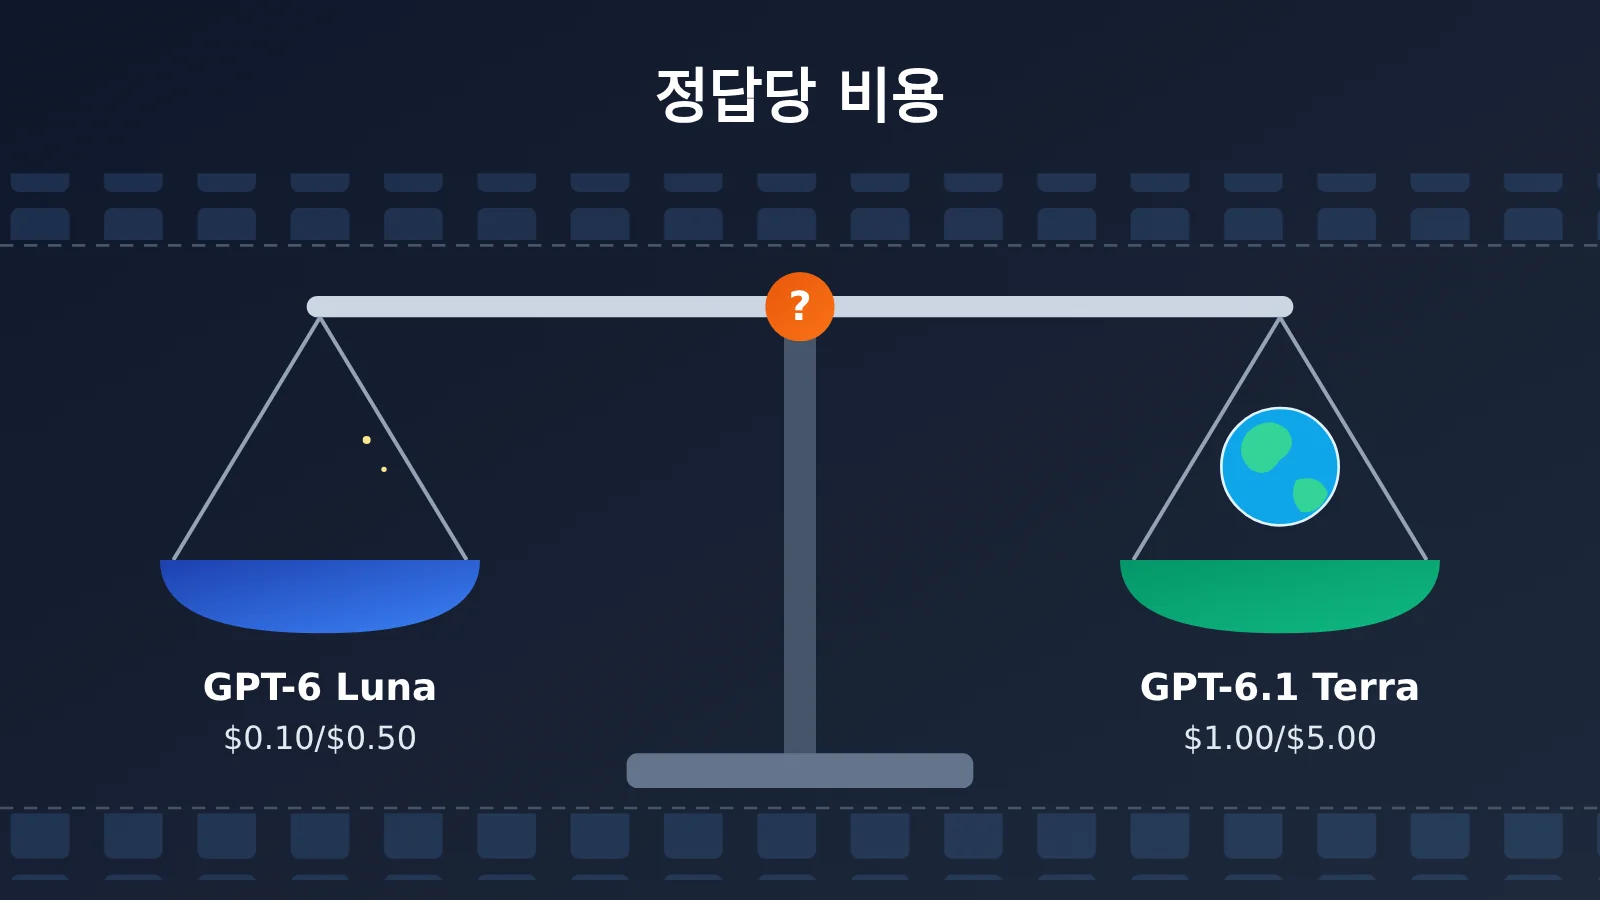
OpenAI의 공식 Standard API 단기 컨텍스트 가격은 다음과 같아요. 단위는 토큰 100만 개당 미국 달러입니다.
| 비용 항목 | GPT-6 Luna | GPT-6.1 Terra | Terra / Luna |
|---|---|---|---|
| 입력 토큰 | $0.10 | $1.00 | 10배 |
| 캐시된 입력 | $0.01 | $0.05 | 5배 |
| 출력 토큰 | $0.50 | $5.00 | 10배 |
| 30분 캐시 쓰기 | $0.125 | $1.25 | 10배 |
| Batch 입력 / 출력 | 약 $0.05 / $0.25 | 약 $0.50 / $2.50 | 10배 |
Batch와 Flex 모드의 요금은 Standard의 약 절반이고, Fast 모드는 약 두 배예요. 놓치기 쉬운 비용도 두 가지 있습니다. 첫째, 단일 요청의 입력이 272,000토큰을 넘으면 해당 요청 전체의 입력과 캐시는 두 배, 출력은 1.5배로 과금됩니다. 둘째, 웹 검색이나 컴퓨터 조작 같은 도구에는 별도 요금이 부과될 수 있으며, 추론 토큰과 재시도, 여러 차례의 에이전트 호출도 실제 비용에 영향을 줍니다.
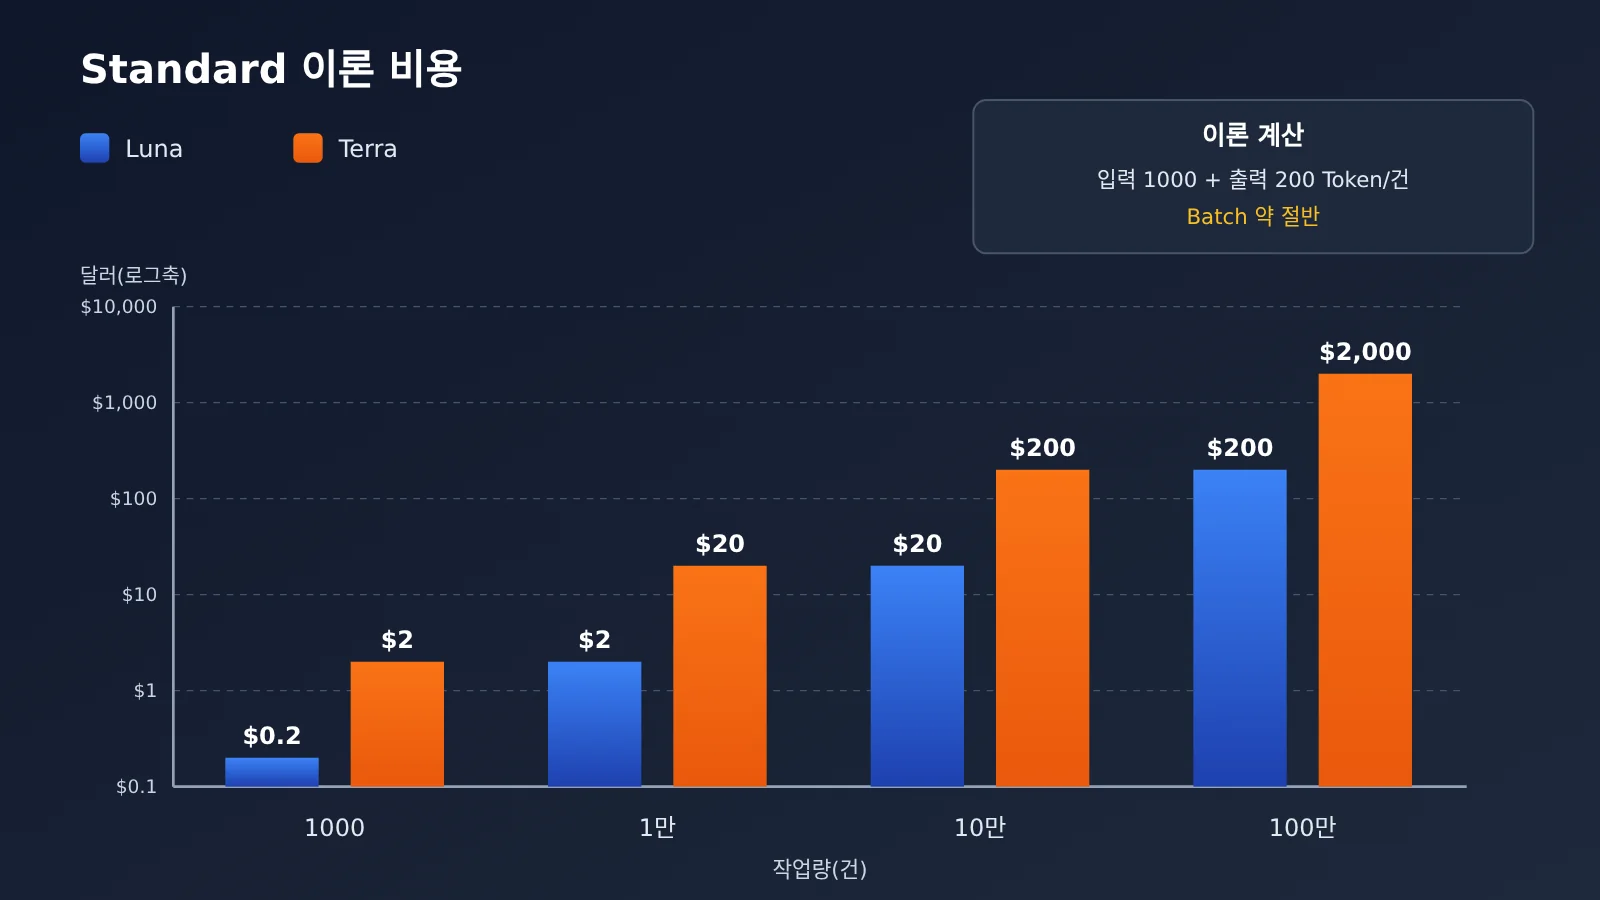
따라서 “10배 비싸다”는 말은 동일한 과금 조건에서 토큰 단가가 10배라는 뜻이지, 모든 작업의 비용이 10배라는 뜻은 아니에요. 이론적으로 계산해 볼게요. 레코드당 입력 1,000토큰, 출력 200토큰을 사용하고 캐시와 재시도 없이 10만 건을 처리한다면, Standard 모드에서 Luna는 약 $20, Terra는 약 $200입니다. Batch로 바꾸면 각각 약 $10과 $100이에요. 이는 공개 단가로 계산한 이론값일 뿐, 실제 청구 금액은 아닙니다.
GPT-6.1 Terra와 GPT-6 Luna 비교: 실제 테스트 데이터 4가지
단가는 ‘얼마를 쓰는지’만 알려줘요. 이제 그 비용으로 ‘무엇을 얻는지’ 살펴볼 차례예요. 아래 네 가지 데이터는 서로 다른 기관에서 다양한 유형의 작업을 테스트한 결과로, 작업 난도에 따라 정확도 차이가 어떻게 벌어지는지 보여줘요.
Plotly 데이터 분석 문제 43개: 비용은 10배, 정답은 2개 더
Plotly와 Mila 연구진이 개발한 DataAnalyticsBench는 풍력 발전 운영 기업의 데이터 웨어하우스를 모사한 벤치마크예요. 합성 데이터 약 2,000만 행을 기반으로 해요. 두 모델이 동일한 도구를 사용해 43개 문제에 답한 결과는 다음과 같아요.
| 지표 | GPT-6 Luna | GPT-6.1 Terra |
|---|---|---|
| 정답 수 | 38/43(88.4%) | 40/43(93.0%) |
| 전체 테스트 비용 | $0.13 | $1.31 |
| 문제당 소요 시간 중앙값 | 18초 | 15초 |
| 일반 분석 / 모호한 질문 / 불가능한 요청 / 데이터 품질 | 모두 만점 | 모두 만점 |
| 통계적 함정 | 3/5 | 4/5 |
| 숨겨진 패턴 발견 | 2/5 | 3/5 |
가장 주목할 만한 차이는 세부 점수에 있어요. 일반 분석, 모호한 요구 파악, 수행할 수 없는 요청 거절, 기본적인 데이터 품질 문제 발견에서는 두 모델의 성능이 같았어요. 차이는 통계적 함정과 숨겨진 패턴 발견이라는 심층 분석 항목에서만 나타났고, Terra가 각각 한 문제씩 더 맞혔어요.
전체 결과를 바탕으로 단순 계산하면, Terra는 $1.18을 더 쓰고 두 문제를 더 맞혔어요. 정답을 하나 추가하는 데 약 $0.59를 더 지불한 셈이에요. 이는 전체 테스트 비용으로 계산한 한계 비용이지, 실제 운영 환경에서 안정적으로 적용할 수 있는 오류 수정 비용은 아니에요. 해당 문제가 경영 판단에 영향을 준다면 $0.59는 저렴할 수 있어요. 반면 내부 보고서에서 중요하지 않은 패턴 하나를 더 발견하는 정도라면 10배의 비용을 들일 필요는 없겠죠.
또 다른 특징도 있어요. Terra의 문제당 소요 시간은 더 짧았지만, 생성 속도가 빠르기 때문은 아니에요. 답변이 더 짧고 모델 호출 횟수도 적었기 때문이에요. 평균 모델 호출 횟수는 약 4.5회, 출력 토큰은 약 1,460개였어요. 출력 속도는 초당 약 64토큰이었어요. 다만 표본이 43문제에 불과하고 Terra는 OpenRouter의 기본 추론 설정으로 실행됐다는 점에 주의해야 해요. 이 결과만으로 모든 기업 데이터 분석에서 정확도가 93%라고 단정할 수는 없어요.
DualEntry 회계 작업 101개: 격차가 11.9%포인트로 확대
DualEntry의 Accounting AI Benchmark는 실제 업무 환경에 더 가까운 평가예요. 거래 분류, 회계 분개, 매입채무, 매출채권, 은행 계좌 대사, 재무 보고, 월말 결산, 회계 지식 등 8개 분야의 작업 101개로 구성돼 있어요. 각 모델이 세 차례 수행하고, 최소 두 번 통과해야 해당 작업을 통과한 것으로 인정해요.
결과는 Luna 66.3%, Terra 78.2%, 비교 기준인 GPT-6.1 Sol 81.2%였어요. Terra의 세부 성적을 보면 거래 분류 13/13, 회계 분개 12/13, 은행 계좌 대사 10/12였어요. 반면 매입채무는 7/13에 그쳤고, 매출채권과 월말 결산은 모두 7/12였어요. DualEntry는 매입채무 항목에서 Terra와 Luna가 공동 최하위였다고도 밝혔어요.
대량 자동화에서는 한 번의 정확도보다 안정성이 더 중요해요. 세 차례 모두 정답을 낸 비율은 Terra가 65.3%, Sol이 68.3%였고, Luna는 더 낮았어요(원문에 구체적인 수치는 공개되지 않았어요). 같은 회계 작업을 오늘은 맞히고 내일은 틀린다면 사람이 원인을 확인하는 비용이 빠르게 늘어나요. 이 테스트에서 Terra는 작업당 평균 16.1초가 걸렸고, 토큰 비용은 약 $0.042였어요. 세 차례를 합친 비용은 약 $12.73이었어요. Luna의 해당 비용은 원문에 명확히 공개되지 않아 추정하지 않았어요.
OSWorld 2.1과 사실 오류율: 복잡한 작업에서 가장 큰 격차
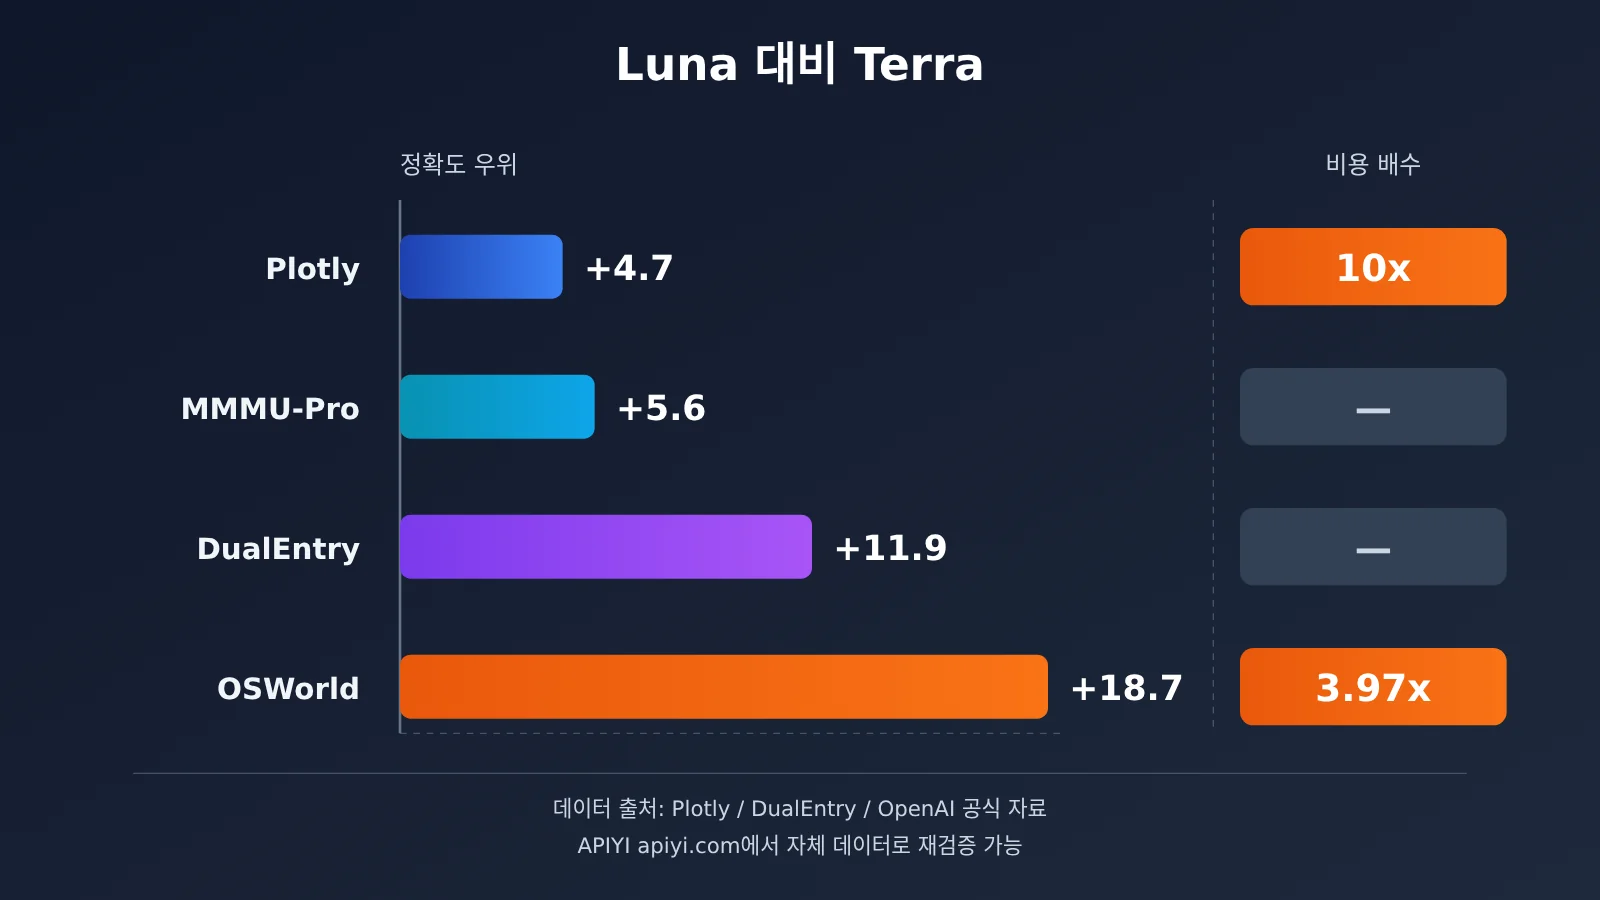
OpenAI가 Terra 출시 발표에서 공개한 데스크톱 조작 벤치마크 OSWorld 2.1은 모델이 인터페이스를 이해하고, 올바른 버튼을 누르고, 여러 단계의 작업을 완료할 수 있는지 평가해요. 최고 추론 단계에서 Luna는 55.5%, Terra는 74.2%로 18.7%포인트 차이가 났어요. 작업당 예상 비용은 각각 0.30달러와 1.19달러로, 10배가 아닌 약 3.97배 차이예요. 모델마다 같은 작업을 완료하는 데 소비하는 토큰 수가 다르기 때문이에요.
사실 오류율 테스트 결과는 더 놀라워요. 공식적으로 설계한 어려운 사실 확인 문제에서 Luna의 Low / Medium / Max 단계별 오류율은 각각 44.3%, 31.2%, 18.4%였고, Terra는 16.7%, 10.1%, 4.3%였어요. Terra의 Low 단계 오류율이 Luna의 Max 단계 오류율보다도 낮았어요. 시각 이해 능력을 평가하는 MMMU-Pro에서는 최고 추론 단계 기준 Luna가 79.9%, Terra가 85.5%를 기록했어요.
이 수치는 모두 OpenAI의 공식 차트에서 가져온 것으로, 제3자가 독립적으로 재검증한 결과는 아니에요. 어려운 사실 확인 문제는 오류를 유도하도록 설계됐으므로 Luna가 일상적인 글쓰기에서 44.3%의 오류율을 보인다는 뜻은 아니에요. OSWorld 점수 역시 해당 테스트 조건에서만 유효해요.
Artificial Analysis 종합 지수: 추론 강도도 최적화해야 해요
Artificial Analysis의 독립 평가는 또 다른 관점을 보여줘요. Max 단계에서 종합 지능 지수는 Luna가 약 38, Terra가 약 48이었어요. 이에 대응하는 종합 벤치마크 비용은 각각 약 0.07달러와 0.40달러로, 약 5.7배 차이예요. 코딩 에이전트 지수는 Luna 31, Terra 48로 격차가 더 컸어요.
하지만 장문 문서 이해를 평가하는 AA-LCR은 예외예요. 두 모델 모두 최고 추론 설정에서 약 83%를 기록했어요. 또 Terra는 Low와 Medium 단계에서 이 기관의 테스트 범위 내 ‘비용 대비 성능’ 파레토 프런티어에 속했지만, Max 단계에서는 최적이 아닐 수도 있어요. 다시 말해 대규모 자동화에서는 모델뿐 아니라 추론 강도도 조정해야 해요.
GPT-6.1 Terra와 GPT-6 Luna로 배치 자동화 빠르게 시작하기
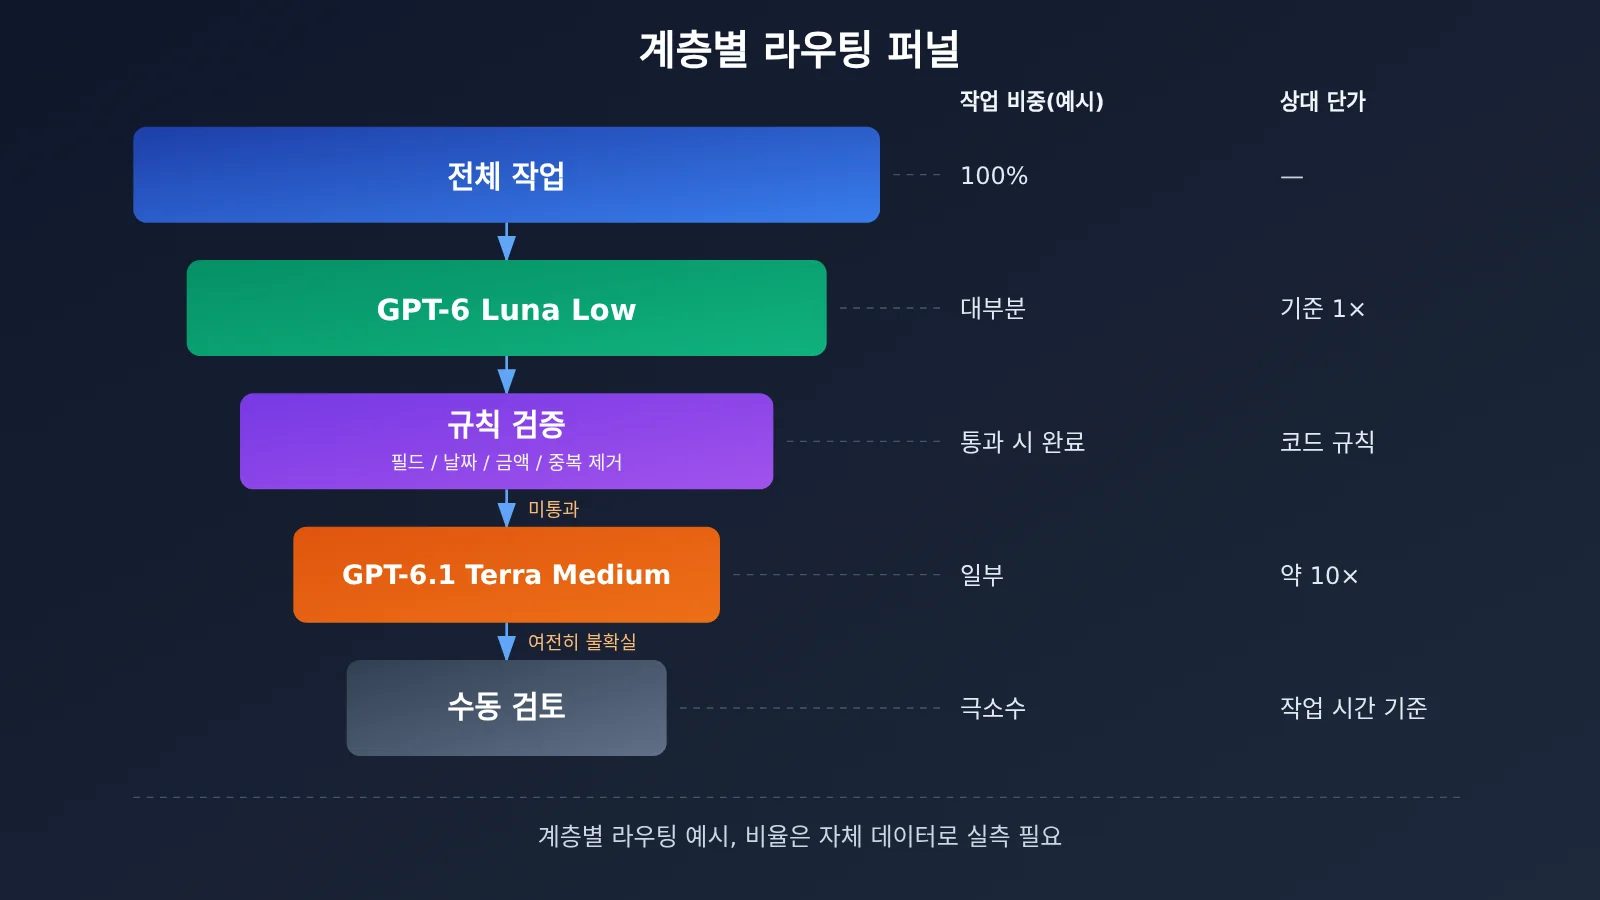
앞의 데이터를 종합하면 실용적인 결론을 얻을 수 있어요. 규칙이 명확한 작업은 대부분 Luna에 맡기고, 복잡하거나 위험도가 높거나 검증을 통과하지 못한 작업만 Terra로 넘기는 거예요. 아래는 바로 실행할 수 있는 최소 예제입니다. Luna가 먼저 송장 필드를 추출하고, 프로그램 규칙으로 검증한 뒤 통과하지 못한 경우에만 Terra에 넘겨요.
import json, openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

def extract(model, text, effort="low"):
    r = client.chat.completions.create(
        model=model, reasoning_effort=effort,
        response_format={"type": "json_object"},
        messages=[{"role": "user", "content": f"抽取 JSON:amount, tax, total, date\n{text}"}])
    return json.loads(r.choices[0].message.content)

def valid(d):
    return all(k in d for k in ("amount", "tax", "total", "date")) and \
        abs(float(d["amount"]) + float(d["tax"]) - float(d["total"])) < 0.01

result = extract("gpt-6-luna", "发票:金额 100.00,税额 6.00,合计 106.00,日期 2026-10-20")
if not valid(result):
    result = extract("gpt-6.1-terra", "...", effort="medium")
print(result)
전체 계층별 라우팅 구현 코드 보기
import json
import re
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

PROMPT = "从以下文本抽取 JSON,字段:amount, tax, total, date(YYYY-MM-DD)。缺失填 null。\n"

def call_model(model: str, text: str, effort: str = "low") -> Optional[dict]:
    try:
        resp = client.chat.completions.create(
            model=model,
            reasoning_effort=effort,
            response_format={"type": "json_object"},
            messages=[{"role": "user", "content": PROMPT + text}],
        )
        return json.loads(resp.choices[0].message.content)
    except Exception as e:
        print(f"[{model}] 调用失败: {e}")
        return None

def rule_check(d: Optional[dict]) -> list:
    """程序化规则校验:结构化输出只保证格式,不保证事实,所以必须二次校验"""
    if not d:
        return ["empty"]
    errors = []
    for k in ("amount", "tax", "total", "date"):
        if d.get(k) is None:
            errors.append(f"missing:{k}")
    if not errors:
        if abs(float(d["amount"]) + float(d["tax"]) - float(d["total"])) > 0.01:
            errors.append("sum_mismatch")
        if not re.match(r"^\d{4}-\d{2}-\d{2}$", str(d["date"])):
            errors.append("bad_date")
    return errors

def route(text: str) -> dict:
    # 第一层:Luna Low 处理全部输入
    d = call_model("gpt-6-luna", text, "low")
    if not rule_check(d):
        return {"data": d, "tier": "luna"}
    # 第二层:未通过校验的升级到 Terra Medium
    d = call_model("gpt-6.1-terra", text, "medium")
    errs = rule_check(d)
    if not errs:
        return {"data": d, "tier": "terra"}
    # 第三层:仍不确定的进入人工审核队列
    return {"data": d, "tier": "human_review", "errors": errs}

if __name__ == "__main__":
    samples = [
        "发票号 A001,金额 100.00 元,税额 6.00 元,价税合计 106.00 元,开票日期 2026-10-20",
        "收据:总计一百零六元整,含税,十月二十日",
    ]
    for s in samples:
        print(route(s))
🚀 빠르게 시작하기: 공식적으로는 먼저 API 키 하나로 두 모델의 호출을 확인한 뒤, 직접 준비한 샘플을 실행해 볼 것을 권장해요. APIYI apiyi.com은 OpenAI 호환 인터페이스를 제공하므로
model매개변수만 바꿔gpt-6-luna와gpt-6.1-terra를 사용할 수 있어요. 신규 사용자에게는 무료 테스트 크레딧이 제공되어 소규모 비교 실험을 시작하기에 좋아요.
이 구조에서 핵심은 두 번째 단계예요. “Luna가 확신한다고 말했다”는 것을 정답의 근거로 삼지 마세요. 모델이 스스로 밝힌 확신도는 신뢰하기 어려울 수 있어요. 대신 필드 누락 여부, 날짜의 유효성, 금액 일치 여부, 핵심 필드와 원문의 일치 여부, 중복 기록 여부처럼 검증할 수 있는 규칙을 우선하세요.
GPT-6.1 Terra와 GPT-6 Luna의 영향 분석
개발자에게 미치는 영향: 작업 유형별로 모델 선택하기
공식 포지셔닝과 앞서 살펴본 테스트를 바탕으로, 일반적인 대량 작업에 적합한 모델을 제안할 수 있어요. 다만 이는 공개 평가를 바탕으로 한 권장 사항이지, 모든 시나리오에서 실측으로 검증된 결과는 아니에요. 운영 환경에 적용하기 전에는 자체 데이터로 검증해야 해요.
| 업무 시나리오 | 초기 추천 | 이유 | 이용 가능한 플랫폼 |
|---|---|---|---|
| 기사 10만 건에 태그 달기 | GPT-6 Luna | 규칙이 명확하고 표본 검증이 가능하며, Plotly 일반 분석에서 두 모델 모두 만점을 받음 | APIYI apiyi.com, OpenAI 공식 |
| 청구서 / 주문 스크린샷 데이터 입력 | GPT-6.1 Terra | 시각 및 조작 능력이 앞서지만, 금액은 여전히 프로그램으로 검증해야 함 | APIYI apiyi.com, OpenAI 공식 |
| 매일 AI 뉴스 요약 | Luna 1차 선별 + Terra 정밀 분석 | 중복 제거와 태그 지정은 Luna에, 중요도 판단은 Terra에 맡김 | APIYI, OpenAI 공식 |
| 고객 지원 이메일 분류 및 초안 작성 | Luna 중심 | 불만이나 환불 등 위험도가 높은 문의는 상위 단계로 넘기거나 상담원이 직접 처리 | APIYI, OpenAI 공식 |
| 웹페이지와 코드 일괄 수정 | Terra 또는 Sol | 코딩 에이전트 지수는 Terra 48점, Luna 31점 | APIYI, OpenAI 공식 |
개발자가 놓치기 쉬운 또 다른 요소는 처리량이에요. 공식 Build 등급에서 Luna의 분당 토큰 한도는 200만, Batch 대기열 상한은 2,000만인 반면, Terra는 각각 100만과 300만이에요. Launch 등급에서는 Luna가 각각 1,000만과 10억, Terra는 400만과 2억이에요. 10만 건 이상의 대량 작업에서는 Luna가 대기열에 넣을 수 있는 양이 훨씬 많아요. 다만 이는 한도이지 생성 속도가 아니며, 계정별 제한도 다를 수 있어요.
업계에 미치는 영향: ‘단가 비교’에서 ‘합격 결과당 비용 비교’로
Terra가 출시된 날 Reddit 커뮤니티에서는 두 가지 반응이 나왔어요. 한쪽에서는 Luna가 이미 충분히 저렴하고 Sol은 더 강력하기 때문에 Terra의 위치가 애매하다고 봤어요. 반면 Terra Low의 사실 오류율이 Luna Max보다 낮아 단가만 비교해서는 안 된다는 의견도 있었어요.
Codex 사용자들 사이에서는 추론 강도를 높인 Terra가 중간 강도의 Sol보다 사용량을 적게 소모하는 것은 아니라는 피드백도 나왔어요. Luna 사용자는 복잡한 개발 작업에서 재작업이 발생해 사용량 측면의 이점이 상쇄됐다고 전했어요. 다만 이는 개별 사례일 뿐이에요. Codex 구독 사용량과 API 토큰 과금은 별개이므로 이를 바탕으로 API 비용을 추산할 수는 없어요.
하지만 이 사례들은 하나의 흐름을 보여줘요. 대량 자동화의 평가 기준이 ‘호출 한 번에 얼마인가’에서 ‘기준을 충족한 결과 하나에 얼마가 드는가’로 바뀌고 있다는 점이에요. 다음과 같은 간단한 공식으로 이해할 수 있어요.
총비용 = API 호출 비용 + 도구 비용 + 재시도 비용 + 인력 검토 비용 + 오류로 인한 손실
Luna는 앞의 두 항목에서 확실한 이점이 있고, Terra는 더 낮은 오류율로 뒤의 세 항목을 줄여줘요. 어느 쪽이 경제적인지는 비즈니스에서 오류 한 번이 얼마나 큰 손실로 이어지는지에 달려 있어요. MultiAI의 소규모 표본 관찰 결과도 이를 뒷받침해요. Terra는 추론을 끄면 일부 논리·계산 작업에서 오류가 발생했지만, Medium으로 전환하면 눈에 띄게 개선됐어요. Luna는 단순 작업에서는 좋은 성능을 보였지만, 여러 단계를 거치는 논리 작업에서는 오류가 더 많았어요.
직접 비교 실험을 진행하는 방법
공개된 데이터만으로는 아직 답을 알 수 없는 핵심 질문이 있어요. 두 모델이 실제 중국어 기사 10만 건을 분류할 때 오류율은 어느 정도인지, 장기 운영 시 안정적인지, 혼합 운영으로 비용을 얼마나 절약할 수 있는지, Terra의 추가 비용을 수동 검토 비용 절감으로 상쇄할 수 있는지 등이에요. 이런 부분은 직접 테스트해야 해요.
현실적인 방법은 정답이 표시된 실제 업무 샘플 200~500건을 준비하는 거예요. 예를 들어 단순 분류, 핵심 정보 추출, 복잡한 콘텐츠 식별에 각각 100건, 사실 확인과 여러 단계의 도구 작업에 각각 50건을 배정할 수 있어요. 그런 다음 입력, 프롬프트, 도구, 판정 기준을 동일하게 맞추고 Luna Low, Luna Medium, Terra Low, Terra Medium의 네 가지 설정을 각각 실행해요. 일부 작업은 여러 번 반복해 안정성도 확인하세요.
마지막으로 다섯 가지 결과를 중점적으로 살펴보세요. 정확도, 1,000건당 API 비용, 평균 소요 시간과 P95 소요 시간, 수동 검토 및 재작업 횟수, 기준을 충족한 결과 1,000건당 총비용이에요. 서드파티 플랫폼을 통해 배포한다면 해당 플랫폼의 실제 정산 기준을 적용하고, 데이터 처리 약관과 규정 준수 요건도 확인해야 해요.
자주 묻는 질문 FAQ
Q1: GPT-6.1 Terra와 GPT-6 Luna의 핵심 차이는 무엇인가요?
두 모델의 사양은 거의 같아요. 컨텍스트 윈도우는 모두 1,050,000토큰이며, 지원하는 도구도 동일해요. Luna는 단가가 10분의 1이라 규칙이 명확한 고빈도 작업에 적합해요. Terra는 시각 이해, 컴퓨터 조작, 복잡한 분석, 사실 정확도에서 더 뛰어나 여러 단계를 거치거나 오류 비용이 큰 작업에 적합해요.
Q2: Terra는 10배 비싼데, 정확도는 조금만 더 높은 건가요?
작업 유형에 따라 달라요. Plotly 데이터 분석 테스트에서는 약 4.7%포인트, DualEntry 회계 작업에서는 11.9%포인트, OSWorld 데스크톱 조작에서는 18.7%포인트 앞섰어요. OSWorld의 작업당 비용 차이는 약 3.97배로, 항상 10배인 것은 아니에요.
Q3: Luna의 추론 강도를 max로 설정하면 Terra를 대체할 수 있나요?
일부 성능은 개선할 수 있지만, 모델 자체의 능력 차이를 극복하지는 못해요. 공식 고난도 사실 확인 문제에서 Luna Max의 오류율은 18.4%로, Terra Low의 16.7%보다 여전히 높았어요. 추론 강도를 높이면 토큰 소비도 늘어나 Luna의 비용 이점이 사라질 수 있어요.
Q4: API로 두 모델을 빠르게 비교하려면 어떻게 해야 하나요?
동일한 코드에서 모델 이름만 바꿔 비교해 보세요.
1. APIYI apiyi.com에 가입하고 API 키와 무료 테스트 크레딧을 받으세요.
2. base_url을 `https://api.apiyi.com/v1`로 설정하세요.
3. `gpt-6-luna`와 `gpt-6.1-terra`로 동일한 샘플을 실행하고 정확도와 토큰 소비량을 기록하세요.
Q5: 대량 작업의 비용을 더 줄이려면 어떻게 해야 하나요?
실시간 응답이 필요 없는 작업은 Batch API를 우선 사용해 보세요. 요금은 Standard의 약 절반이며, 공식 처리 시간은 24시간 이내예요. 단일 입력을 272,000토큰 이내로 유지하면 긴 컨텍스트 추가 요금도 피할 수 있어요. APIYI apiyi.com은 사용량에 따라 과금하므로, 소량으로 작업당 실제 토큰 소비량을 파악한 뒤 규모를 늘리기에도 편리해요.
Q6: 이 테스트 결과에는 어떤 한계가 있나요?
Plotly 테스트는 43문항뿐이고 합성 데이터를 사용했어요. OSWorld, MMMU-Pro, 사실 오류율은 OpenAI의 공식 결과로, 독립적으로 재검증한 수치가 아니에요. MultiAI의 24/24와 18/18은 서로 다른 문제 세트를 사용해 직접 비교할 수 없어요. 또한 Structured Outputs는 형식만 보장할 뿐 필드 내용의 사실 여부는 보장하지 않아요. 어떤 벤치마크 점수도 실제 업무의 정확도와 동일하다고 볼 수는 없어요.
GPT-6.1 Terra와 GPT-6 Luna 핵심 요약
- 단가 차이 10배: Luna의 입력 가격은 $0.10, 출력 가격은 $0.50이며, Terra는 각각 $1.00과 $5.00이에요.
- 간단한 작업에서는 차이가 작아요: 일반적인 Plotly 분석, 모호한 질문 식별 등의 항목에서 두 모델 모두 만점을 받았어요.
- 복잡한 작업에서는 차이가 커요: Terra가 회계 작업에서 11.9점, 데스크톱 조작에서 18.7점 앞섰어요.
- 사실 정확도에도 차이가 있어요: Terra Low의 오류율은 16.7%로, Luna Max의 18.4%보다 낮아요.
- 추론 강도도 조절해야 해요: Terra Low와 Medium은 Max 설정보다 비용 효율이 높아요.
- 단계별 라우팅이 가장 경제적이에요: Luna로 1차 분류하고, 규칙으로 검증한 뒤 Terra로 보완하고 사람이 최종 검토해요.
- 출시 전에 먼저 테스트하세요: 자체 샘플 200~500개로 APIYI apiyi.com에서 네 가지 설정을 비교해 보세요.
결론
GPT-6.1 Terra와 GPT-6 Luna 중 대량 자동화에 더 적합한 모델은 작업 난이도와 오류로 인한 손실에 따라 달라져요.
- 규칙이 명확하고 자동 검증이 가능한 작업: Luna가 저비용 출발점이에요. Plotly 테스트에서 두 모델은 일반적인 분석 작업에 동일한 성능을 보였어요.
- 시각 인식, 다단계 조작, 재무 등 위험 부담이 큰 작업: Terra의 추가 비용을 고려할 만해요. 정확도 차이가 최대 18.7%포인트에 달했어요.
- 진짜 최적화 목표: API 호출 한 번의 가격이 아니라 재시도, 검토, 오류로 인한 손실을 포함한 적합한 결과 한 건당 총비용이에요.
대부분의 팀에는 한 모델만 선택하기보다 Luna가 간단한 작업 대부분을 처리하고, Terra가 정말 어려운 작업을 맡는 방식이 더 좋아요. 먼저 자체 업무 샘플로 소규모 비교 테스트를 진행한 뒤 분배 비율을 결정해 보세요.
APIYI apiyi.com에서 두 모델이 여러분의 업무에 얼마나 잘 맞는지 빠르게 확인해 볼 수 있어요. API 키 하나로 모델을 전환할 수 있고 사용량에 따라 과금되므로 작업 1,000건당 비용을 정확하게 계산하기도 편해요.
📚 참고 자료
- OpenAI: Introducing GPT-6.1 Terra: OSWorld, MMMU-Pro, 사실 오류율 차트가 포함된 출시 공지
- 링크:
openai.com/index/introducing-gpt-6-1-terra -
설명: Terra의 공식 포지셔닝과 벤치마크 데이터 출처
-
OpenAI API Pricing 및 모델 페이지: Luna와 Terra의 가격, 기능, 속도 제한
- 링크:
developers.openai.com/api/docs/pricing -
설명: Standard, Batch, Flex, Fast 요금의 근거
-
OpenAI Batch API 문서: 배치 처리 비용과 처리 시간
- 링크:
developers.openai.com/api/docs/guides/batch -
설명: 대규모 비동기 작업의 비용 절감 방법
-
Plotly: GPT-6.1 Terra Benchmark Results for Data Analysis: 동일한 환경에서 진행한 데이터 분석 테스트 43개
- 링크:
plotly.com/blog/gpt-6-1-terra-plotly-data-analytics-bench -
설명: 정확도, 비용, 소요 시간 및 항목별 성적
-
DualEntry: GPT-6.1 Terra Accounting Benchmark: 회계 작업 101개 테스트
- 링크:
dualentry.com/blog/gpt-6-1-terra-accounting-benchmark -
설명: 정확도, 작업 분류 및 3회 테스트의 안정성
-
Artificial Analysis: GPT-6.1 Terra 평가: 종합 지능 지수와 비용 효율성
- 링크:
artificialanalysis.ai/models/releases/gpt-6-1-terra - 설명: 추론 강도별 독립 테스트 기록
작성자: APIYI 기술팀
기술 문의: APIYI 공식 홈페이지에서 문의해 주세요. 더 많은 모델 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.