Примечание автора: цена токенов Terra в 10 раз выше, чем у Luna, а разница в точности составляет от 4,7 до 18,7 процентного пункта. На основе реальных тестов Plotly, DualEntry и OSWorld разбираемся, сколько на самом деле стоит каждый правильный результат при пакетной автоматизации.
26 октября 2026 года OpenAI выпустила GPT-6.1 Terra — чуть больше месяца спустя после выхода GPT-6 Luna. Цены на API двух моделей различаются ровно в 10 раз, но в сторонних сравнительных тестах преимущество Terra в точности варьируется от менее чем 5 до почти 19 процентных пунктов. Оправдана ли такая разница в цене при пакетной автоматизации — один из самых обсуждаемых вопросов среди разработчиков.
Это не обзор моделей, основанный на впечатлениях. Plotly, DualEntry и Artificial Analysis опубликовали результаты тестов уже в день выхода Terra, а сама OpenAI привела данные по OSWorld 2.1, MMMU-Pro и частоте фактических ошибок. Мы собрали эти данные вместе, чтобы ответить на конкретный вопрос: сколько действительно полезных правильных результатов дают дополнительные расходы?
Что вы узнаете: прочитав статью, вы поймёте, в каких пакетных задачах разница между GPT-6.1 Terra и GPT-6 Luna велика, а в каких её почти нет. А ещё получите код гибридного решения: «первичная обработка через Luna + проверка по правилам + Terra для сложных случаев».
GPT-6.1 Terra и GPT-6 Luna: главное
Обе модели входят в семейство GPT-6, но предназначены для разных задач. OpenAI описывает Luna как эффективную модель для чётко определённых, частых и массовых задач. Сильные стороны Terra — визуальное рассуждение, точная работа с компьютером и естественный стиль письма. Она занимает промежуточное положение между Luna и Sol.
| Характеристика | GPT-6 Luna | GPT-6.1 Terra |
|---|---|---|
| Дата выпуска | 22 сентября 2026 года | 26 октября 2026 года |
| API ID | gpt-6-luna |
gpt-6.1-terra |
| Официальное позиционирование | Частые, массовые задачи с чёткими правилами | Визуальное рассуждение, работа с компьютером, многоэтапные задачи |
| Контекстное окно / максимальный объём вывода | 1 050 000 / 128 000 токенов | 1 050 000 / 128 000 токенов |
| Уровень рассуждения | 6 уровней от none до max, по умолчанию medium | 6 уровней от none до max, по умолчанию medium |
| Типичные сценарии | Классификация по меткам, распределение писем, извлечение полей | Ввод данных из счетов, сопоставление изображений товаров, работа с интерфейсом |
По характеристикам модели почти идентичны: обе принимают текст и изображения, поддерживают Structured Outputs, Function Calling, Responses API, Batch API, а также инструменты Web Search, File Search и Computer Use. Главное различие — в цене и возможностях при решении сложных задач.
Стоит отметить, что в руководстве OpenAI по выбору модели нет советов вроде «для массовых задач используйте Luna» или «если нужна точность, выбирайте Terra». Официальная рекомендация — протестировать модели на одном и том же наборе реальных входных данных и выбрать самую дешёвую конфигурацию, которая отвечает требованиям к качеству. Это важно учитывать при изучении всех данных в статье.
Разница в стоимости API GPT-6.1 Terra и GPT-6 Luna
Официальные цены OpenAI для Standard API при коротком контексте, в долларах за миллион токенов:
| Статья расходов | GPT-6 Luna | GPT-6.1 Terra | Terra / Luna |
|---|---|---|---|
| Входные токены | $0.10 | $1.00 | В 10 раз |
| Кэшированные входные токены | $0.01 | $0.05 | В 5 раз |
| Выходные токены | $0.50 | $5.00 | В 10 раз |
| Запись в кэш на 30 минут | $0.125 | $1.25 | В 10 раз |
| Входные / выходные токены в Batch | Около $0.05 / $0.25 | Около $0.50 / $2.50 | В 10 раз |
Тарифы в режимах Batch и Flex примерно вдвое ниже Standard, а в режиме Fast — примерно вдвое выше. Есть два вида расходов, которые легко упустить. Во-первых, если входные данные одного запроса превышают 272 000 токенов, все входные и кэшированные токены этого запроса тарифицируются по двойной ставке, а выходные — по ставке в 1,5 раза выше. Во-вторых, инструменты вроде веб-поиска и управления компьютером могут оплачиваться отдельно. Токены рассуждений, повторные попытки и многошаговые вызовы агента тоже влияют на фактические расходы.
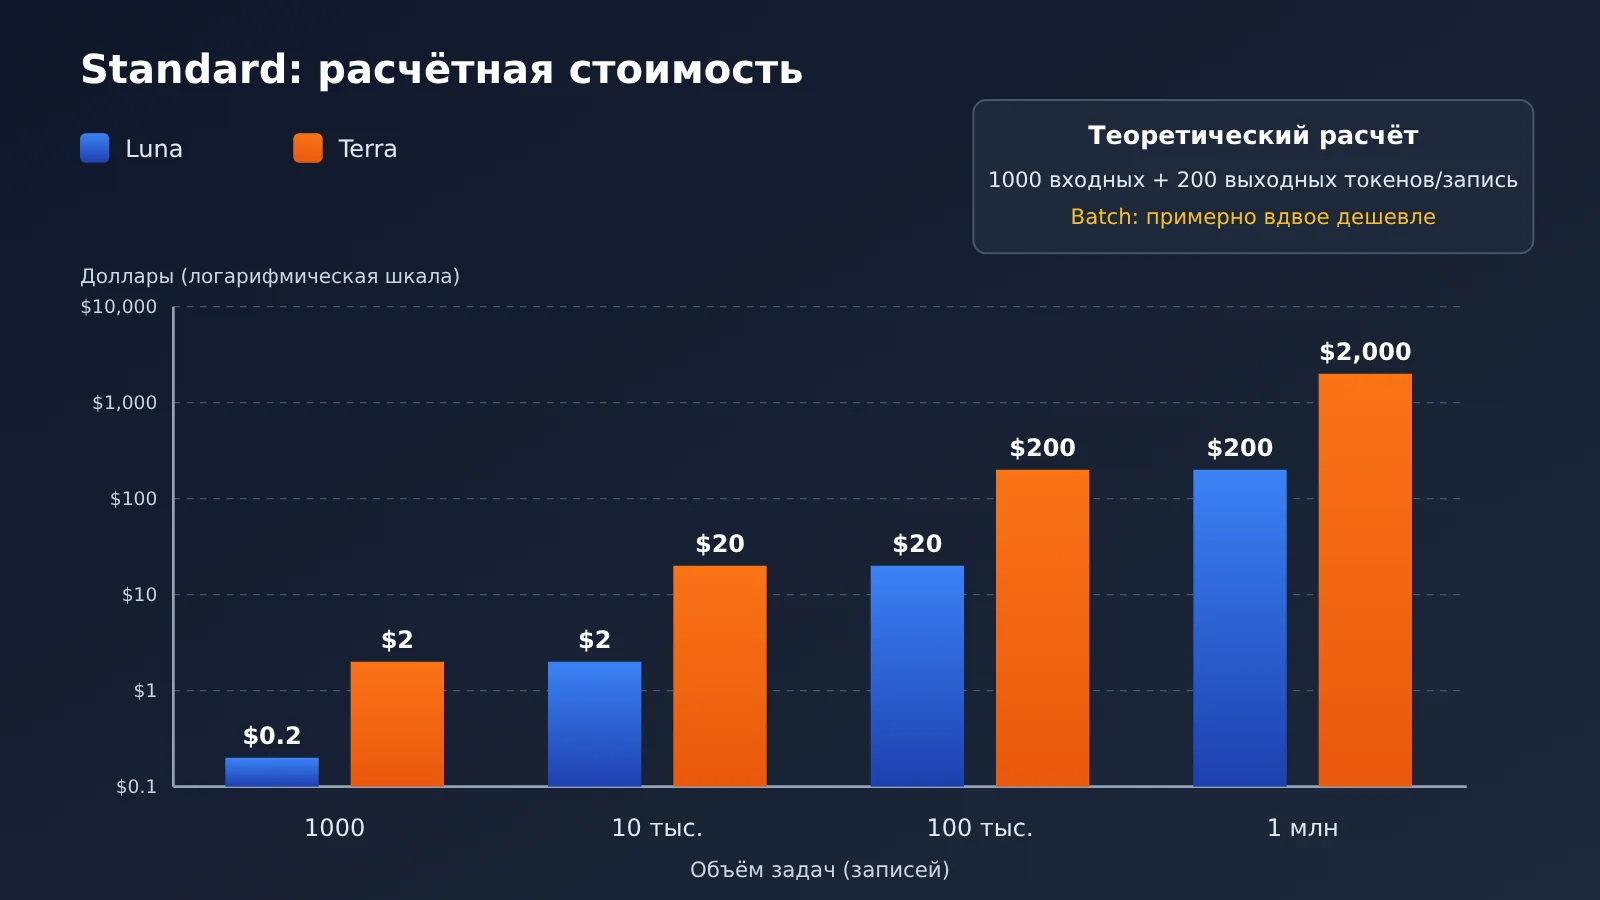
Поэтому «в 10 раз дороже» означает разницу в цене за токен при одинаковых условиях тарификации, а не то, что любая задача обойдётся в 10 раз дороже. Посчитаем теоретическую стоимость: если на каждую запись приходится 1000 входных и 200 выходных токенов, без кэширования и повторных попыток, то обработка 100 000 записей в режиме Standard обойдётся примерно в $20 для Luna и $200 для Terra. В режиме Batch — примерно в $10 и $100 соответственно. Это лишь расчёт по опубликованным тарифам, а не реальный счёт.
GPT-6.1 Terra против GPT-6 Luna: результаты четырёх реальных тестов
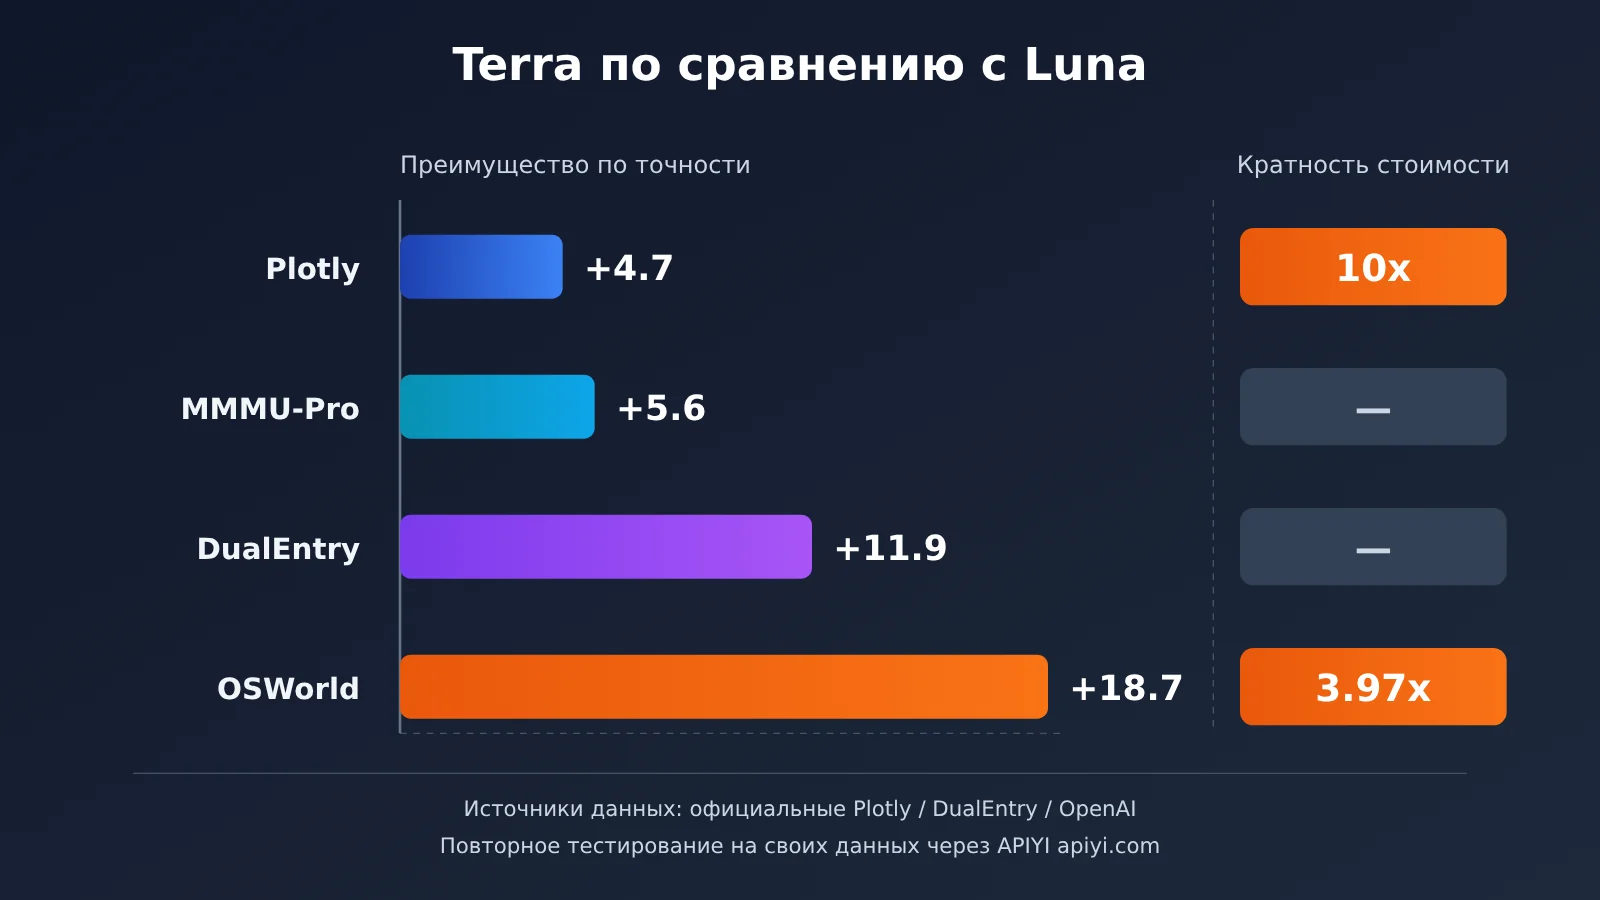
Цена показывает только то, сколько мы платим. Теперь посмотрим, что получаем взамен. Данные четырёх тестов собраны разными организациями, а типы задач в них различаются. Они показывают, как разрыв в точности растёт с повышением сложности задач.
43 задачи на анализ данных от Plotly: в 10 раз дороже, на 2 правильных ответа больше
Исследователи из Plotly и Mila разработали DataAnalyticsBench — тест, который имитирует хранилище данных компании, эксплуатирующей ветряные электростанции. Оно содержит около 20 миллионов строк синтетических данных. Обе модели отвечали на 43 вопроса с помощью одного и того же набора инструментов. Результаты:
| Показатель | GPT-6 Luna | GPT-6.1 Terra |
|---|---|---|
| Правильных ответов | 38/43 (88,4%) | 40/43 (93,0%) |
| Стоимость всего теста | $0.13 | $1.31 |
| Медианное время на вопрос | 18 секунд | 15 секунд |
| Обычный анализ / неоднозначные вопросы / невыполнимые запросы / качество данных | Максимальный балл по всем категориям | Максимальный балл по всем категориям |
| Статистические ловушки | 3/5 | 4/5 |
| Поиск скрытых закономерностей | 2/5 | 3/5 |
Самое интересное видно в результатах по отдельным категориям. Модели одинаково справились с обычным анализом, распознаванием неоднозначных запросов, отказом от невыполнимых задач и обнаружением базовых проблем с качеством данных. Разница появилась только в двух категориях, требующих более глубокого анализа: статистических ловушках и поиске скрытых закономерностей. В каждой из них Terra решила на одну задачу больше.
Если грубо посчитать по общим результатам, Terra стоила на $1.18 больше и дала на 2 правильных ответа больше. Получается около $0.59 доплаты за каждый дополнительный правильный ответ. Это предельная стоимость, рассчитанная по итогам теста, а не стабильная цена исправления ошибки в реальных условиях. Если от ответа зависит бизнес-решение, $0.59 — небольшая цена. Но если речь лишь о ещё одной несущественной закономерности во внутреннем отчёте, десятикратная переплата ни к чему.
Ещё одна деталь: Terra отвечала быстрее, но не потому, что быстрее генерировала текст. Её ответы были короче, а вызовов модели было меньше — в среднем около 4,5 вызова и примерно 1460 выходных токенов. Скорость генерации составляла около 64 токенов в секунду. Стоит учитывать, что выборка состояла всего из 43 вопросов, а Terra запускалась через OpenRouter с настройками рассуждения по умолчанию. Из этих результатов нельзя заключить, что её точность при анализе любых корпоративных данных составляет 93%.
101 бухгалтерская задача DualEntry: разрыв вырос до 11,9 процентного пункта
Accounting AI Benchmark от DualEntry ближе к реальным рабочим процессам. В нём 101 задача из восьми категорий: классификация транзакций, бухгалтерские проводки, кредиторская и дебиторская задолженность, банковская сверка, финансовая отчётность, закрытие месяца и знания в области бухгалтерского учёта. Каждая модель выполняла задачи три раза. Задача считалась пройденной, если модель справилась с ней как минимум в двух попытках.
Результаты: Luna — 66,3%, Terra — 78,2%, а GPT-6.1 Sol, взятая для сравнения, — 81,2%. Terra правильно выполнила 13 из 13 задач по классификации транзакций, 12 из 13 — по бухгалтерским проводкам и 10 из 12 — по банковской сверке. При этом в работе с кредиторской задолженностью её результат составил лишь 7 из 13, с дебиторской задолженностью и закрытием месяца — по 7 из 12. DualEntry также отмечает, что в категории кредиторской задолженности Terra и Luna разделили последнее место.
Для массовой автоматизации стабильность важнее точности в одной попытке. Terra правильно выполнила 65,3% задач во всех трёх раундах, Sol — 68,3%, а показатель Luna был ниже (конкретное значение в источнике не указано). Если сегодня модель правильно выполняет бухгалтерскую задачу, а завтра ошибается на аналогичной, затраты на ручную проверку быстро растут. В этом тесте Terra тратила на задачу в среднем 16,1 секунды, а стоимость токенов составляла около $0,042. Все три раунда обошлись примерно в $12,73. Для Luna соответствующие расходы в источнике чётко не указаны, поэтому оценивать их здесь не будем.
OSWorld 2.1 и частота фактических ошибок: самый большой разрыв — в сложных задачах
В анонсе Terra компания OpenAI привела результаты OSWorld 2.1 — теста на работу с интерфейсом компьютера. Он проверяет, умеет ли модель понимать интерфейс, нажимать нужные кнопки и выполнять многошаговые операции. На максимальном уровне рассуждения Luna набрала 55,5%, а Terra — 74,2%: разница составила 18,7 процентного пункта. Расчётная стоимость выполнения одной задачи — $0,30 и $1,19 соответственно, то есть отличается примерно в 3,97 раза, а не в 10 раз. Дело в том, что разные модели расходуют разное количество токенов на одну и ту же задачу.
Результаты теста на фактические ошибки впечатляют ещё больше. На сложных вопросах, специально подготовленных OpenAI, частота ошибок Luna на уровнях Low / Medium / Max составила 44,3%, 31,2% и 18,4% соответственно, а у Terra — 16,7%, 10,1% и 4,3%. Даже на уровне Low Terra ошибается реже, чем Luna на максимальном уровне Max. В тесте на понимание изображений MMMU-Pro при максимальном уровне рассуждения Luna набрала 79,9%, а Terra — 85,5%.
Все эти данные взяты из официальных графиков OpenAI, а не из независимой проверки третьей стороны. Сложные вопросы были специально составлены так, чтобы спровоцировать ошибки, поэтому результат не означает, что Luna допускает фактические ошибки в 44,3% случаев при повседневной работе с текстом. Результаты OSWorld тоже действительны только для условий этого теста.
Сводный индекс Artificial Analysis: уровень рассуждений тоже стоит оптимизировать
Независимая оценка Artificial Analysis даёт ещё один взгляд на ситуацию. При уровне рассуждений Max сводный индекс интеллекта Luna составляет около 38, а Terra — около 48. Стоимость выполнения набора тестов — примерно $0,07 и $0,40 соответственно, то есть разница составляет около 5,7 раза. В индексе программирования с использованием агентов разрыв ещё больше: 31 у Luna против 48 у Terra.
Но тест на понимание длинных документов AA-LCR показывает обратную картину: при максимальном уровне рассуждений обе модели набирают около 83%. Кроме того, на уровнях Low и Medium Terra находится на границе Парето по соотношению стоимости и возможностей среди моделей, протестированных организацией. На уровне Max она уже не обязательно оптимальна. Другими словами, для массовой автоматизации нужно подбирать не только модель, но и уровень рассуждений.
GPT-6.1 Terra и GPT-6 Luna: быстрый старт с пакетной автоматизацией
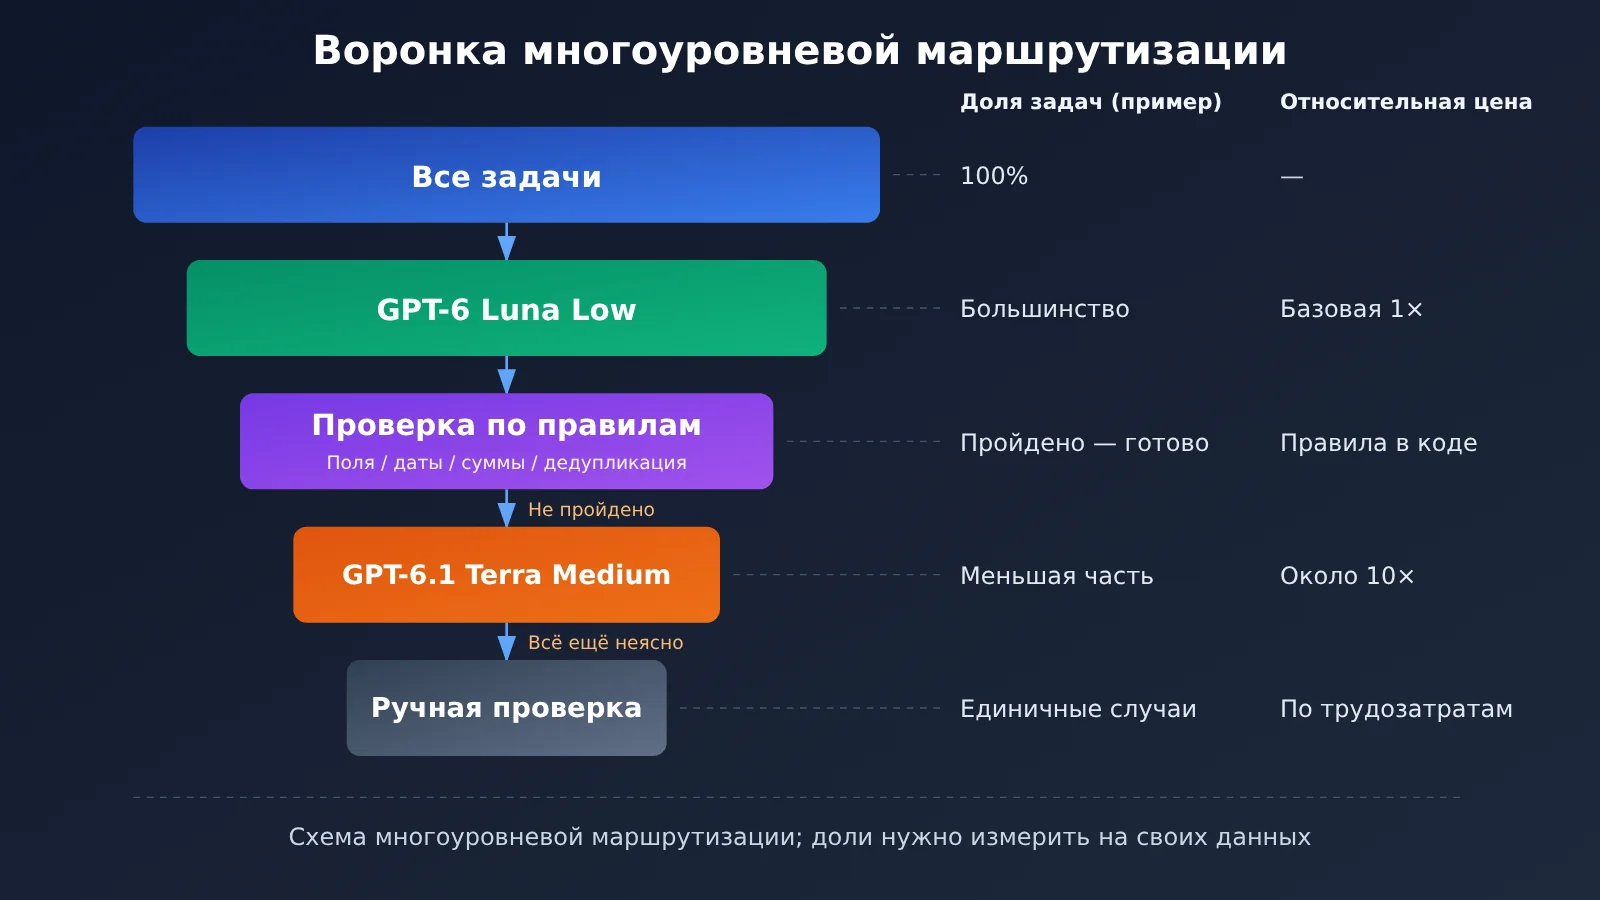
Из приведённых выше данных следует практический вывод: большинство задач с чёткими правилами стоит поручать Luna, а сложные, рискованные или не прошедшие проверку — передавать Terra. Ниже приведён минимальный рабочий пример: сначала Luna извлекает поля счёта, затем программа проверяет результат по заданным правилам. Если проверка не пройдена, задача передаётся Terra.
import json, openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

def extract(model, text, effort="low"):
    r = client.chat.completions.create(
        model=model, reasoning_effort=effort,
        response_format={"type": "json_object"},
        messages=[{"role": "user", "content": f"抽取 JSON:amount, tax, total, date\n{text}"}])
    return json.loads(r.choices[0].message.content)

def valid(d):
    return all(k in d for k in ("amount", "tax", "total", "date")) and \
        abs(float(d["amount"]) + float(d["tax"]) - float(d["total"])) < 0.01

result = extract("gpt-6-luna", "发票:金额 100.00,税额 6.00,合计 106.00,日期 2026-10-20")
if not valid(result):
    result = extract("gpt-6.1-terra", "...", effort="medium")
print(result)
Посмотреть полный код многоуровневой маршрутизации
import json
import re
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

PROMPT = "从以下文本抽取 JSON,字段:amount, tax, total, date(YYYY-MM-DD)。缺失填 null。\n"

def call_model(model: str, text: str, effort: str = "low") -> Optional[dict]:
    try:
        resp = client.chat.completions.create(
            model=model,
            reasoning_effort=effort,
            response_format={"type": "json_object"},
            messages=[{"role": "user", "content": PROMPT + text}],
        )
        return json.loads(resp.choices[0].message.content)
    except Exception as e:
        print(f"[{model}] 调用失败: {e}")
        return None

def rule_check(d: Optional[dict]) -> list:
    """程序化规则校验:结构化输出只保证格式,不保证事实,所以必须二次校验"""
    if not d:
        return ["empty"]
    errors = []
    for k in ("amount", "tax", "total", "date"):
        if d.get(k) is None:
            errors.append(f"missing:{k}")
    if not errors:
        if abs(float(d["amount"]) + float(d["tax"]) - float(d["total"])) > 0.01:
            errors.append("sum_mismatch")
        if not re.match(r"^\d{4}-\d{2}-\d{2}$", str(d["date"])):
            errors.append("bad_date")
    return errors

def route(text: str) -> dict:
    # 第一层:Luna Low 处理全部输入
    d = call_model("gpt-6-luna", text, "low")
    if not rule_check(d):
        return {"data": d, "tier": "luna"}
    # 第二层:未通过校验的升级到 Terra Medium
    d = call_model("gpt-6.1-terra", text, "medium")
    errs = rule_check(d)
    if not errs:
        return {"data": d, "tier": "terra"}
    # 第三层:仍不确定的进入人工审核队列
    return {"data": d, "tier": "human_review", "errors": errs}

if __name__ == "__main__":
    samples = [
        "发票号 A001,金额 100.00 元,税额 6.00 元,价税合计 106.00 元,开票日期 2026-10-20",
        "收据:总计一百零六元整,含税,十月二十日",
    ]
    for s in samples:
        print(route(s))
🚀 Быстрый старт: разработчики рекомендуют сначала проверить работу обеих моделей с одним API-ключом, а затем протестировать их на собственных примерах. APIYI apiyi.com предлагает совместимый с OpenAI интерфейс: чтобы переключиться между
gpt-6-lunaиgpt-6.1-terra, достаточно изменить параметрmodel. Новым пользователям доступен бесплатный лимит для тестирования — удобно для небольшого сравнительного эксперимента.
Ключевой момент в этой схеме — второй этап. Не стоит считать ответ правильным только потому, что «Luna уверена в нём»: оценка уверенности самой моделью может быть ненадёжной. Лучше использовать проверяемые правила: все ли поля заполнены, корректна ли дата, сходятся ли суммы, соответствуют ли ключевые поля исходному тексту и нет ли дубликатов.
Анализ влияния GPT-6.1 Terra и GPT-6 Luna
Для разработчиков: выбор модели по типу задачи
С учётом официального позиционирования и тестов, описанных выше, можно предложить отправные точки для выбора модели под распространённые пакетные задачи. Это рекомендации на основе публичных тестов, а не подтверждение того, что модели проверены во всех перечисленных сценариях. Перед запуском их всё равно нужно проверить на собственных данных.
| Бизнес-сценарий | Первоначальная рекомендация | Причина | Доступные платформы |
|---|---|---|---|
| Разметка ста тысяч статей | GPT-6 Luna | Правила ясны, результаты можно проверить выборочно; обе модели получили максимальный балл в тесте Plotly на обычный анализ | APIYI apiyi.com, OpenAI |
| Ввод данных со скриншотов счетов и заказов | GPT-6.1 Terra | Лидирует по возможностям работы с изображениями и выполнения действий; суммы всё равно нужно проверять программно | APIYI apiyi.com, OpenAI |
| Ежедневная сводка новостей об ИИ | Первичный отбор — Luna, подробный анализ — Terra | Удаление дубликатов и разметку можно поручить Luna, оценку важности — Terra | APIYI, OpenAI |
| Маршрутизация писем в поддержку и подготовка черновиков | Преимущественно Luna | Обращения с высоким риском, например жалобы и запросы на возврат, нужно передавать на следующий уровень поддержки или сотруднику | APIYI, OpenAI |
| Пакетное изменение веб-страниц и кода | Terra или Sol | В индексе программирующих агентов у Terra 48 баллов, у Luna — 31 | APIYI, OpenAI |
Ещё один момент, о котором разработчики часто забывают, — пропускная способность. На указанном OpenAI уровне Build лимит Luna составляет 2 млн токенов в минуту, а максимальный объём очереди Batch — 20 млн токенов. У Terra эти показатели равны 1 млн и 3 млн соответственно. На уровне Launch у Luna лимиты составляют 10 млн и 1 млрд, у Terra — 4 млн и 200 млн. Для пакетных задач объёмом свыше ста тысяч записей Luna позволяет поставить в очередь заметно больше данных. Но речь идёт именно о лимитах, а не о скорости генерации; ограничения конкретного аккаунта тоже могут отличаться.
Влияние на отрасль: от «цены за вызов» к «стоимости качественного результата»
В день выхода Terra в сообществе Reddit появились два мнения. Одни считали, что Terra занимает не слишком понятное место в линейке: Luna уже достаточно дешёвая, а Sol мощнее. Другие отмечали, что Terra Low допускает меньше фактических ошибок, чем Luna Max, поэтому смотреть только на цену за вызов нельзя. Некоторые пользователи Codex также сообщали, что Terra с высокой интенсивностью рассуждений не всегда расходует меньше лимита, чем Sol со средней интенсивностью. А у пользователей Luna преимущество по лимиту в сложных задачах разработки сводилось на нет необходимостью переделывать работу. Всё это отдельные случаи, к тому же лимиты подписки Codex и оплата API-токенов — не одно и то же. Рассчитать на их основе расходы на API нельзя.
Тем не менее все эти примеры указывают на одну тенденцию: эффективность массовой автоматизации всё чаще оценивают не по «цене одного вызова», а по «стоимости одного качественного результата». Понять это поможет простая формула:
Общая стоимость = стоимость вызовов API + стоимость инструментов + стоимость повторных попыток + стоимость ручной проверки + потери из-за ошибок
У Luna безусловное преимущество по первым двум пунктам, а Terra благодаря меньшему числу ошибок помогает сократить расходы по трём последним. Что выгоднее, зависит от того, во сколько вашему бизнесу обходится одна ошибка. Наблюдения MultiAI на небольшой выборке тоже это подтверждают: с отключёнными рассуждениями Terra ошибалась в некоторых логических и вычислительных задачах, но при переключении на Medium результаты заметно улучшились. Luna хорошо справлялась с простыми задачами, но чаще ошибалась в многошаговых логических рассуждениях.
Как самостоятельно провести сравнительный эксперимент
Публичные данные пока не дают ответа на несколько ключевых вопросов: какова доля ошибок каждой модели при классификации 100 тысяч реальных статей на китайском языке, насколько стабильно они работают в течение длительного времени, сколько на самом деле можно сэкономить с помощью смешанной схемы и способна ли экономия на ручной проверке компенсировать более высокую стоимость Terra. Это можно выяснить только на собственных тестах.
Практичный вариант — подготовить от 200 до 500 реальных рабочих примеров с правильными ответами. Например, по 100 примеров на простую классификацию, извлечение ключевой информации и распознавание сложного контента, а также по 50 — на проверку фактов и многошаговую работу с инструментами. Затем протестируйте четыре конфигурации — Luna Low, Luna Medium, Terra Low и Terra Medium — с одинаковыми входными данными, промптами, инструментами и критериями оценки. Часть задач выполните несколько раз, чтобы проверить стабильность результатов.
В итоге стоит обратить внимание на пять показателей: точность, стоимость API на 1000 задач, среднее время выполнения и P95, количество ручных проверок и доработок, а также совокупную стоимость получения 1000 результатов, соответствующих требованиям. Если используете стороннюю платформу, учитывайте её фактические правила тарификации и проверьте условия обработки данных и требования к соблюдению нормативов.
Частые вопросы FAQ
Q1: В чём главное отличие GPT-6.1 Terra от GPT-6 Luna?
Характеристики моделей почти одинаковы: у обеих контекстное окно составляет 1 050 000 токенов, а поддержка инструментов совпадает. При этом Luna в 10 раз дешевле и подходит для частых задач с чёткими правилами. Terra заметно сильнее в понимании изображений, работе с компьютером, сложном анализе и точности фактов — её стоит выбирать для многоэтапных задач, где цена ошибки высока.
Q2: Terra стоит в 10 раз дороже, а точность выше лишь ненамного?
Всё зависит от типа задачи. В тесте анализа данных Plotly Terra опередила Luna примерно на 4,7 процентного пункта, в бухгалтерских задачах DualEntry — на 11,9, а в работе с компьютером в OSWorld — на 18,7 процентного пункта. При этом в OSWorld стоимость выполнения одной задачи различалась примерно в 3,97 раза, а не в 10 раз.
Q3: Можно ли заменить Terra моделью Luna с интенсивностью рассуждений max?
Это поможет улучшить некоторые результаты, но не устранит разницу в возможностях моделей. В официальном тесте на сложные вопросы о фактах частота ошибок Luna Max составила 18,4% — всё ещё выше, чем 16,7% у Terra Low. Кроме того, повышение интенсивности рассуждений увеличивает расход токенов, из-за чего Luna может потерять ценовое преимущество.
Q4: Как быстро сравнить две модели через API?
Рекомендуем использовать один и тот же код, меняя только название модели:
1. Зарегистрируйтесь на APIYI apiyi.com и получите API-ключ и бесплатный лимит для тестирования
2. Установите для base_url значение `https://api.apiyi.com/v1`
3. Запустите одну и ту же подборку примеров с моделями `gpt-6-luna` и `gpt-6.1-terra`, затем сравните точность и расход токенов
Q5: Как ещё снизить расходы при большом объёме задач?
Для задач, которым не нужен ответ в реальном времени, используйте Batch API: тариф примерно вдвое ниже Standard, а официальный срок обработки составляет до 24 часов. Также держите объём каждого запроса в пределах 272 000 токенов, чтобы избежать доплаты за длинный контекст. На APIYI apiyi.com действует оплата по факту использования, поэтому можно сначала запустить небольшую партию, выяснить реальный расход токенов на задачу, а затем увеличить объём.
Q6: Какие ограничения есть у этих результатов тестирования?
Тест Plotly содержит всего 43 задания и использует синтетические данные. Результаты OSWorld, MMMU-Pro и данные о частоте фактических ошибок опубликованы самой OpenAI и не были независимо проверены. В тестах MultiAI с результатами 24/24 и 18/18 использовались разные наборы заданий, поэтому напрямую сравнивать их нельзя. Кроме того, Structured Outputs гарантирует только правильный формат, но не достоверность содержимого полей. Ни один результат бенчмарка не равнозначен реальной точности в ваших бизнес-задачах.
GPT-6.1 Terra и GPT-6 Luna: главное
- Разница в цене — в 10 раз: у Luna входные токены стоят $0.10, выходные — $0.50; у Terra — $1.00 и $5.00 соответственно
- В простых задачах разница невелика: обе модели получили максимальный балл за обычный анализ в Plotly и распознавание неоднозначных вопросов
- В сложных задачах разрыв заметнее: Terra опережает Luna на 11,9 п. п. в бухгалтерских задачах и на 18,7 п. п. при работе с рабочим столом
- Фактическая точность различается: доля ошибок Terra Low — 16,7%, что ниже 18,4% у Luna Max
- Уровень рассуждений тоже важен: Terra Low и Medium выгоднее по соотношению стоимости и качества, чем Max
- Поэтапная маршрутизация выгоднее всего: первичная обработка в Luna, проверка по правилам, передача сложных случаев Terra и проверка человеком
- Сначала тест, потом запуск: сравните четыре конфигурации на 200–500 собственных примерах через APIYI apiyi.com
Итоги
Ответ на вопрос, какая модель лучше подходит для массовой автоматизации — GPT-6.1 Terra или GPT-6 Luna, — зависит от сложности задач и цены ошибки:
- Задачи с понятными правилами, которые можно проверить автоматически: Luna — недорогой вариант для начала. В тесте Plotly обе модели одинаково справились с обычным анализом.
- Распознавание изображений, многоэтапные операции, финансовые и другие задачи с высоким риском: дополнительные расходы на Terra оправданны — её преимущество в точности достигает 18,7 процентного пункта.
- Настоящая цель оптимизации: не цена отдельного вызова API, а полная стоимость каждого результата, соответствующего требованиям, с учётом повторных попыток, проверки и потерь от ошибок.
Для большинства команд лучше не выбирать что-то одно, а поручить Luna основную массу простых задач, оставив Terra действительно сложные случаи. Сначала проведите небольшое сравнительное тестирование на собственных рабочих данных, а затем определите, как распределять задачи между моделями.
Проверить, как обе модели справляются с вашими задачами, можно через APIYI apiyi.com: один API-ключ позволяет переключаться между моделями, а оплата по факту использования помогает точно рассчитать стоимость тысячи задач.
📚 Источники
- OpenAI: Introducing GPT-6.1 Terra: анонс модели с графиками результатов OSWorld, MMMU-Pro и частоты фактических ошибок
- Ссылка:
openai.com/index/introducing-gpt-6-1-terra -
Описание: официальное позиционирование Terra и результаты тестов
-
OpenAI API Pricing и страницы моделей: цены, возможности и ограничения частоты запросов для Luna и Terra
- Ссылка:
developers.openai.com/api/docs/pricing -
Описание: источник цен для режимов Standard, Batch, Flex и Fast
-
Документация OpenAI Batch API: стоимость и сроки пакетной обработки
- Ссылка:
developers.openai.com/api/docs/guides/batch -
Описание: способ снизить расходы на большие объёмы асинхронных задач
-
Plotly: GPT-6.1 Terra Benchmark Results for Data Analysis: 43 теста по анализу данных в одинаковых условиях
- Ссылка:
plotly.com/blog/gpt-6-1-terra-plotly-data-analytics-bench -
Описание: точность, стоимость, время выполнения и результаты по отдельным категориям
-
DualEntry: GPT-6.1 Terra Accounting Benchmark: тест из 101 бухгалтерской задачи
- Ссылка:
dualentry.com/blog/gpt-6-1-terra-accounting-benchmark -
Описание: точность, категории задач и стабильность результатов в трёх раундах
-
Artificial Analysis: обзор GPT-6.1 Terra: сводный индекс интеллекта и экономическая эффективность
- Ссылка:
artificialanalysis.ai/models/releases/gpt-6-1-terra - Описание: результаты независимых тестов при разных уровнях интенсивности рассуждений
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами через главную страницу официального сайта APIYI. Больше материалов о подключении моделей — в центре документации docs.apiyi.com.