ملاحظة المؤلف: يواصل GPT-6.2 Sol اعتماد سعر توكنز Standard نفسه الخاص بالجيل السابق، وقد رفع نتائجه أو خفّض تكلفة المهمة الواحدة في عدد من الاختبارات العامة. وقبل ترقية الأنظمة القائمة، يبقى من الضروري اختبار الأسئلة حول قاعدة الشيفرة والتحليل المعقد والمحادثات متعددة الجولات، كلٌّ منها على حدة.
نبدأ بالخلاصة: سعر توكنز Standard للسياق القصير في GPT-6.2 Sol مطابق تمامًا لنظيره في GPT-6.1 Sol، وهو يحقق درجات أعلى وتكلفة أقل للمهمة الواحدة في التقييمات الشاملة؛ لكنه سجّل خسارة واضحة في الأسئلة حول قاعدة الشيفرة وفي عدد قليل من المسائل الصعبة. فكلاهما يسعّر الإدخال العادي وقراءة الذاكرة المؤقتة والإخراج لكل مليون توكن عند $2 و$0.10 و$10 على التوالي. وارتفع التقييم الشامل في فئة Max لدى Artificial Analysis من 55 إلى 57، وانخفض متوسط تكلفة المهمة من $1.27 إلى $1.01. غير أن البند الفرعي الخاص بالأسئلة حول قاعدة الشيفرة في اختبار الوكيل البرمجي لدى المؤسسة نفسها هبط من 60 إلى 46، كما انخفض اختبار تحليل البيانات Plotly من الدرجة الكاملة 43/43 إلى 40/43.
لذلك، تناسب هذه الترقيةَ طريقةُ الانتقال التدريجي حسب نوع المهمة، ولا يُنصح بالاستبدال الشامل المباشر. يمكن تجربة تعديلات الشيفرة القابلة للتحقق وعمليات الطرفية والتحليل الروتيني أولاً. أما الأسئلة حول قاعدة الشيفرة ومسائل الأنماط الخفية والمعالجة الدفعية المعتمدة على Flex، فتحتاج أولاً إلى استكمال اختبارات الانحدار. يُضاف إلى ذلك أن Responses API في GPT-6.2 يطرأ تغيّر على سلوكه في المحادثات متعددة الجولات وفي موضع التعليمات، لذا لا يكفي تغيير معرّف النموذج وحده في التطبيقات متعددة الجولات التي تستخدم الإصدار القديم.
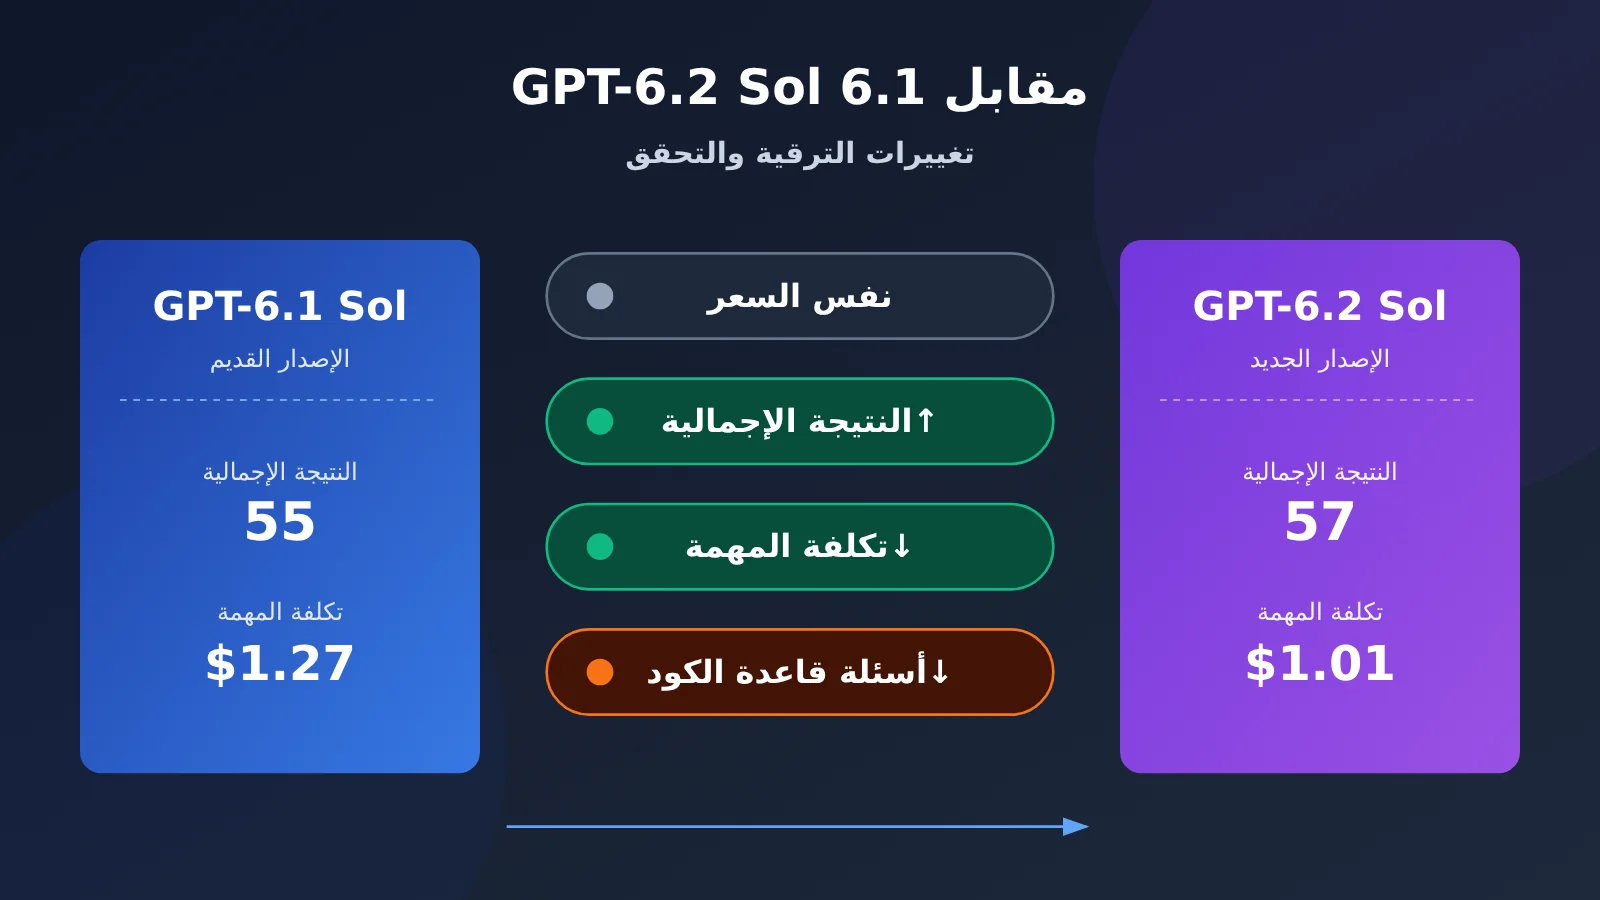
نظرة سريعة على مقارنة GPT-6.2 Sol بـ GPT-6.1 Sol
يسرد الجدول التالي فقط الأبعاد المفيدة لقرار الترقية. المواصفات والأسعار مأخوذة من بطاقة النموذج الرسمية من OpenAI وصفحة التسعير وسجل التحديثات، ووحدة الأسعار جميعها USD / مليون token.
| بُعد المقارنة | GPT-6.1 Sol | GPT-6.2 Sol | ماذا يعني الاختلاف |
|---|---|---|---|
| معرّف النموذج / تاريخ الإطلاق | gpt-6.1-sol / 2026-09-29 |
gpt-6.2-sol / 2026-11-17 |
النموذج الجديد أُطلق حديثًا ويحتاج إلى فترة مراقبة |
| السياق / الحد الأقصى للإخراج | 1,050,000 / 128,000 | 1,050,000 / 128,000 | السعة دون تغيير |
| الحد الأقصى للإدخال | لم يُدرَج منفصلًا في بطاقة النموذج | 922,000 | مهام الإدخال فائقة الطول تحتاج إلى التحقق وفق الحد الجديد |
| نهاية المعرفة | 2026-04-30 | 2026-06-01 | تأخر بنحو شهر واحد |
| سعر Standard للسياق القصير | الإدخال $2 / قراءة الذاكرة المؤقتة $0.10 / الإخراج $10 | متطابق | الفاتورة متطابقة عند تطابق تركيبة token |
| معالجة Flex | مدعومة | غير مدعومة | مستخدمو Flex القديم عليهم التحول إلى طريقة معالجة أخرى |
| نافذة خصم الخلفية | لم تتطرق إليها هذه المادة | نافذة ساعتين -30%، نافذة 8 ساعات -40% | المهام التي تتحمل التأخير لديها خيارات توفير جديدة |
| الدرجة الإجمالية (AA، فئة Max) | 55 | 57 | أقوى قليلًا بشكل عام |
| سؤال وجواب حول قاعدة الشيفرة (AA، Codex + Max) | 60 | 46 | تراجع واضح، ويحتاج إلى اختبار قبول مخصص |
🚀 مقارنة سريعة: يمكن تبديل الجيلين من النماذج ومقارنتهما ضمن مجموعة الواجهات نفسها. لقد أدرج جدول النماذج العام في APIYI apiyi.com النموذج
gpt-6.2-sol، وحدد مدخلي responses و chat، ما يجعله مناسبًا لتشغيل مقارنة انحدار بين النسختين القديمة والجديدة باستخدام مفتاح واحد.
ترتيب القراءة المقترح: يتأكد القسم 1 من المتن أولًا من الأسعار وخيارات المعالجة، لأنه يحدد أساس الفاتورة. يقارن القسم 2 التقدم والخسائر في الاختبارات العامة لتحديد المهام التي تستحق الترقية. يفحص القسم 3 تغييرات سلوك API لتحديد ما إذا كانت الخدمات الحالية قادرة على التحول بسلاسة. يقدم القسم 4 خطة قبول مقسمة حسب المهام. إذا كنت مهتمًا فقط بوكيل البرمجة، يمكنك الانتقال مباشرة إلى 2.2 والقسم 4.
مصطلحات يجب معرفتها قبل مقارنة GPT-6.2 Sol
| المصطلح | شرح موجز |
|---|---|
| سعر token القياسي | التسعير العلني لفئة Standard من OpenAI لكل مليون token من الإدخال والإخراج وكميات التخزين المؤقت المختلفة |
| تكلفة المهمة | رسوم النموذج والأدوات الناتجة عن إنجاز مهمة واحدة، ويمكن عند قبول العمل إضافة تكاليف إعادة التشغيل والمراجعة البشرية |
| مستوى الاستدلال | إعداد يتحكم في ميزانية استدلال النموذج، والقيم الشائعة هي Low وMedium وHigh وXhigh وMax، وينبغي توحيد المستوى عند الاختبار المقارن |
| GDPval v2 | تقييم داخلي في OpenAI للعمل المعرفي المعقد، ويركز على التسليمات ذات العمليات الطويلة المستمدة من أنواع مشاريع واقعية |
| Coding Agent Index | مؤشر شامل للوكلاء تستنده Artificial Analysis إلى عناصر فرعية مثل تعديل الشيفرة وعمليات الطرفية والأسئلة والأجوبة حول قاعدة الشيفرة |
| SWE-Atlas-QnA-AA | العنصر الفرعي للأسئلة والأجوبة حول قاعدة الشيفرة ضمن المؤشر السابق، ويتحقق من اكتمال الحقائق اللازمة للإجابة |
| بادئة الجلسة / قراءة التخزين المؤقت | المحتوى الذي يبقى متسلسلاً في بداية الطلبات متعددة الجولات؛ وبعد أن تتعرف الخدمة على البادئة القابلة لإعادة الاستخدام، تُحتسب الأجزاء المطابقة وفق سعر القراءة |
1. GPT-6.2 Sol مقابل GPT-6.1 Sol: المواصفات الأساسية والأسعار
1.1 مواصفات GPT-6.2 Sol تستمر أساسًا كما في الجيل السابق
يمكن استدعاء كلا الجيلين عبر Responses وChat Completions، أما استدعاء الدوال والأدوات المدمجة فيمر عبر مسار Responses. يقبل النموذجان إدخال النص والصور، ويُخرجان النص أصلاً، ونافذة السياق فيهما متطابقة عند 1,050,000 token، وأقصى إخراج متطابق عند 128,000 token. وتسرد بطاقة النموذج الخاصة بـ 6.2 Sol على حدة أقصى إدخال يبلغ 922,000 token.
ثمة فرق دقيق في التموضع. تؤكد صفحة نموذج 6.1 Sol على إنجاز مهام البرمجة المعقدة وتشغيل الحاسوب والمهام المهنية بتكلفة أقل من Astra؛ بينما تميل صفحة نموذج 6.2 Sol نحو البرمجة اليومية وأعمال الوكلاء على نطاق واسع. بعبارة أخرى، يستهدف 6.2 Sol بشكل أوضح السيناريوهات عالية التكرار وبكميات كبيرة.
1.2 سعر Standard لـ GPT-6.2 Sol مطابق للجيل السابق
التسعير الرسمي لفئة Standard كما يلي. يعتمد الجيلان حدًا عند 272K token من الإدخال في الطلب الواحد: بعد تجاوزه، تُحتسب أسعار الإدخال والذاكرة المؤقتة للطلب بأكمله بمعامل 2، ويُحتسب الإخراج بمعامل 1.5.
| فئة تسعير Standard | سياق قصير (≤272K) | سياق طويل (>272K) |
|---|---|---|
| إدخال عادي | $2.00 | $4.00 |
| قراءة من الذاكرة المؤقتة | $0.10 | $0.20 |
| كتابة في الذاكرة المؤقتة لمدة 30 دقيقة | $2.50 | $5.00 |
| كتابة في الذاكرة المؤقتة لمدة 12 ساعة | $5.00 | $10.00 |
| الإخراج (يشمل token الاستدلال) | $10.00 | $15.00 |
تطابق سعر الوحدة لا يعني تطابق الفاتورة. عند إنجاز المهمة نفسها، قد تتغير كمية token الناتجة في 6.2 Sol وعدد استدعاءات الأدوات ومعدلات إصابة الذاكرة المؤقتة، لذا يجب حساب التكلفة الفعلية حسب المهمة. تُحتسب كتابة الذاكرة المؤقتة وفق معدل كل فئة بالكامل، ولا يُضاف إليها سعر الإدخال العادي لنفس دفعة token. يمكن قراءة إجمالي الإخراج من usage.output_tokens في Responses، بينما يظهر استخدام الاستدلال عادةً ضمن الحقل الفرعي output_tokens_details.reasoning_tokens.
بخصوص الاستدعاء المحلي: حتى 2026-11-20، كانت أسعار gpt-6.2-sol في الفئة القصيرة ضمن واجهة التسعير العامة لـ APIYI apiyi.com مطابقة للأسعار الرسمية، أما في الفئة الطويلة فكانت أسعار الإدخال العادي وقراءة الذاكرة المؤقتة وكتابة الذاكرة المؤقتة والإخراج على التوالي: $3 و$0.15 و$3.75 و$11.25. هذا تعبير تسعير معلن علنًا، وتُحتسب الفاتورة الفعلية وفق مجموعة الحساب وإعدادات المنصة الحالية.
1.3 الاختيار بين Flex ونوافذ الخصم الخلفية
خيارات المعالجة هي التغيير الأكثر عرضة للتجاهل. لا يزال GPT-6.1 Sol ضمن قائمة النماذج المؤهلة لـ Flex، بينما لا يدعم GPT-6.2 Sol فئة Flex. وبدلاً من ذلك، يمكن لـ GPT-6.2 Sol استخدام نوافذ الخصم الخلفية في Responses: بالنسبة للطلبات المؤهلة، تكون أسعار token للنموذج أقل بنسبة 30% من Standard في نافذة الساعتين، وأقل بنسبة 40% في نافذة 8 ساعات.
إذا كان النظام القديم يعتمد على Flex لمعالجة الدُفعات دون اتصال، فستحتاج عند الترحيل إلى إعادة الاختيار وفق مهلة التسليم وشروط الوصول. يمكن تقييم نوافذ الخلفية للمهام التي تقبل التسليم خلال بضع ساعات؛ أما المهام التي تتطلب استجابة فورية فلا خيار لها سوى التسعير وفق Standard.
2. GPT-6.2 Sol مقابل GPT-6.1 Sol: أوجه التقدم ونقاط التراجع في الاختبارات العامة
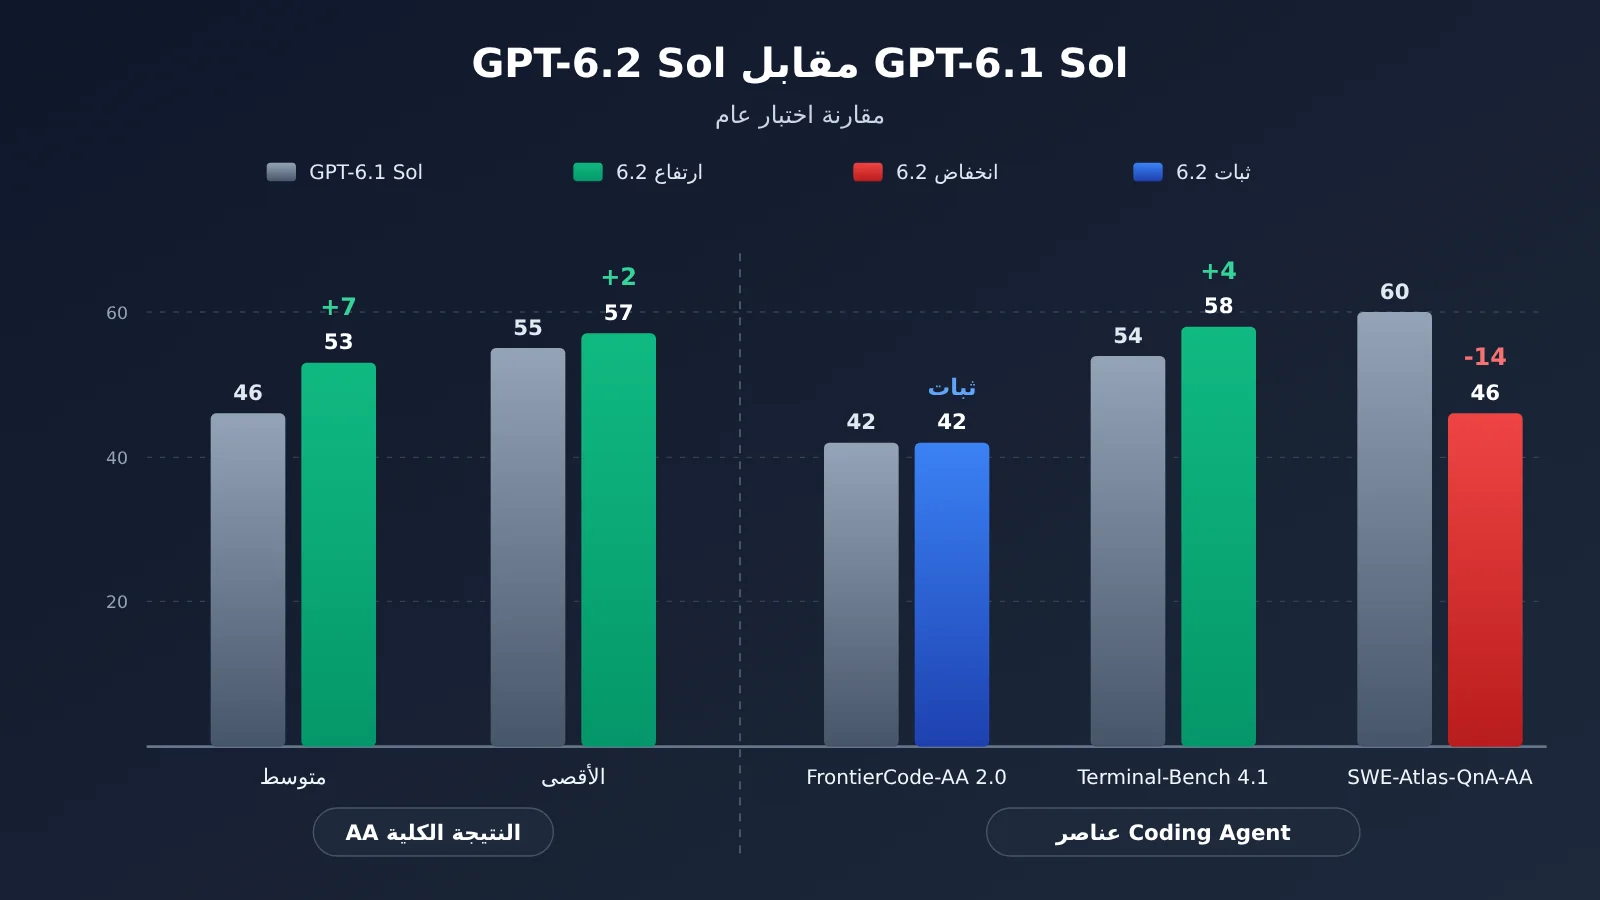
يجمع الشكل أعلاه بيانات عامة من أطراف ثالثة؛ اللون الأخضر يعني تحسّنًا في 6.2 Sol، والأحمر يعني تراجعًا. هذه الأرقام تأتي من مؤسسات وأطر اختبار مختلفة، ولا تناسب المقارنة إلا ضمن ظروف كل منها. وإذا أردت إعادة إنتاجها على مهامك الخاصة، يمكنك استدعاء الجيلين عبر APIYI على apiyi.com من القناة نفسها وبالمستوى نفسه.
2.1 العمل المعرفي والقدرات الشاملة: تحسّن تدريجي في GPT-6.2 Sol
ما تعلنه الشركة رسميًا: ذكرت OpenAI في بيان الإصدار بتاريخ 2026-11-17 أن 6.2 Sol يتفوق على 6.1 Sol بـ 5.3 نقطة مئوية في التقييم الداخلي GDPval v2. يقيس GDPval v2 العمل المعرفي متعدد الخطوات في مجالات الاستشارات والمالية والتصميم، وهذه النتيجة تنطبق فقط على الاختبارات الداخلية التي تنشرها OpenAI. ويضم البيان أيضًا بندًا يقول «انخفاض رموز الإخراج بنسبة 22%»، لكن المقارنة فيه بين GPT-6.2 Astra وGPT-6 Astra، ولا يمكن تطبيقها على جيلي Sol.
القياس الفعلي من طرف ثالث: تغطي الدرجة الشاملة من Artificial Analysis العمل المعرفي والبرمجة والعلوم والمعرفة العامة. ومن 6.1 Sol إلى 6.2 Sol، ارتفع مستوى Medium من 46 إلى 53، وارتفع مستوى Max من 55 إلى 57. كما انخفض متوسط تكلفة المهمة في مستوى Max من $1.27 إلى $1.01، أي بنحو 20% بحسب الأرقام العامة المقرّبة.
اتجاهات المجموعتين متطابقة؛ فـ 6.2 Sol أقوى في المهام الشاملة وأكثر اقتصادية في المهمة الواحدة. والجدير بالملاحظة أن ارتفاع مستوى Medium (+7) أكبر بوضوح من ارتفاع Max (+2). وبالنسبة للفرق التي تستخدم مستوى الاستدلال المتوسط في عملها اليومي، قد يكون أثر هذه الترقية ملموسًا أكثر.
2.2 تعديل الكود والطرفية والأسئلة والأجوبة حول قاعدة الكود: GPT-6.2 Sol بين الصعود والهبوط
في Coding Agent Index v2.1 من Artificial Analysis، استُخدم لكلا الجيلين إطار اختبار Codex ومستوى الاستدلال Max، وبالمنهجية نفسها:
| المؤشر (Codex + Max) | GPT-6.1 Sol | GPT-6.2 Sol | التغير |
|---|---|---|---|
| مؤشر Coding Agent Index الإجمالي | 52 | 49 | -3 |
| FrontierCode-AA 2.0 | 42 | 42 | دون تغيير |
| Terminal-Bench 4.1 | 54 | 58 | +4 |
| SWE-Atlas-QnA-AA (أسئلة وأجوبة قاعدة الكود) | 60 | 46 | -14 |
| متوسط تكلفة API للمهمة الواحدة | $1.51 | $1.22 | نحو -19% |
| متوسط زمن تشغيل الوكيل | 21.9 دقيقة | 17.5 دقيقة | -4.4 دقيقة |
انخفض المؤشر الإجمالي أساسًا لأن بند الأسئلة والأجوبة حول قاعدة الكود هبط 14 نقطة، ما ألغى ارتفاع بند الطرفية 4 نقاط، بينما بقي بند تعديل الكود دون تغيير. ولا يشمل بند زمن التشغيل تكاليف بدء البيئة والمراجعة والتحقق؛ بل يعكس فقط مدة تنفيذ الوكيل نفسه. كذلك فإن FrontierCode-AA 2.0 هنا هو إصدار Artificial Analysis، ولا ينبغي الخلط بينه وبين لوحات تحمل الاسم نفسه صادرة عن جهات أخرى.
توفر المقارنة ذات الجولة الواحدة التي نشرتها Plotly في 2026-11-17 حول DataAnalyticsBench مرجعًا لنوع آخر من المهام المستقلة. انتقل إجمالي النقاط من 43/43 إلى 40/43 بين 6.1 Sol و6.2 Sol، وانخفضت تكلفة الجولة كاملة من $2.61 إلى $1.22، وتراجع الزمن الوسيط لكل سؤال من 17.6 ثانية إلى 10.5 ثانية. كما انخفض عدد استدعاءات الأدوات من 258 إلى 158، ونزل حجم المخرجات من نحو 70,000 token إلى 45,000 token. وتركز الأسئلة الثلاثة التي أخطأ فيها 6.2 Sol في مسائل الأنماط الخفية.
لهذه النتائج قيدان. أولًا، جرى الاختبار عبر OpenRouter وإطار Plotly الثابت، والتكلفة تعكس سعر القناة في ذلك الوقت. ثانيًا، خضع كل نموذج لجولة واحدة فقط، وقد لاحظت Plotly عند إعادة تشغيل نماذج أخرى تذبذبًا يصل إلى ثلاثة أسئلة. لذلك فهي أنسب لتوضيح قاعدة عامة: خطوات 6.2 Sol أقل وأسرع وأوفر، لكنه قد “يتوقف مبكرًا جدًا” في المسائل الصعبة التي تتطلب تعمقًا.
3. كيف يؤثر سلوك API الخاص بـ GPT-6.2 Sol على الخدمات القائمة
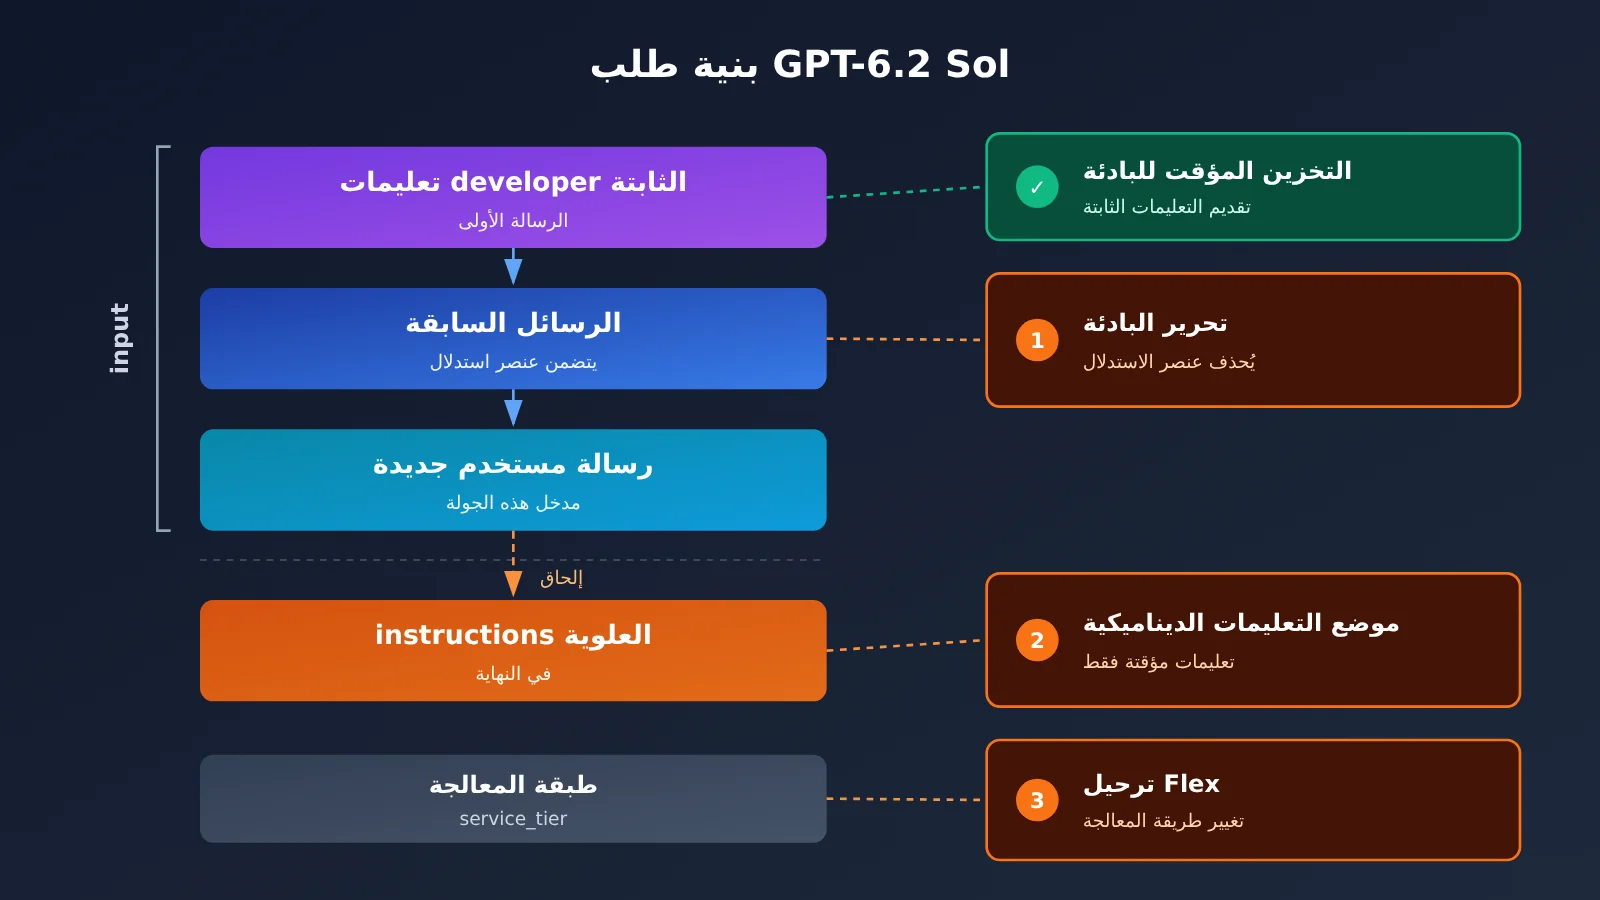
بالنسبة للتطبيقات متعددة الأدوار التي تشغّل 6.1 Sol بالفعل، تتمركز المخاطر أساسًا في ثلاثة جوانب. يُظهر الرسم أعلاه البنية الموصى بها لطلب GPT-6.2 Responses، ويمكن التحقق منها مباشرةً عبر مدخل responses في APIYI apiyi.com بهذه البنية.
- إعادة كتابة بادئة الجلسة: عندما يقوم Responses API في GPT-6.2 بتعديل بادئة جلسة موجودة، أو عند تبديل بعض النماذج، أو عند تبديل المستخدم النهائي أو المؤسسة، فإنه يُسقط عناصر الاستدلال السابقة. وإذا كان نظامك يحتوي على منطق «إعادة صياغة السجل ثم متابعة الحوار»، فتحقق من جودة المتابعة ومن تأثر إصابة التخزين المؤقت (cache hit).
- موضع التعليمات: تُضاف
instructionsفي المستوى الأعلى لدى GPT-6.2 إلى ما بعدinput. والتعليمات الثابتة التي تريد إعادة استخدامها وإصابتها في التخزين المؤقت، يجب وضعها في أول رسالةdeveloperداخلinput؛ أما التعليمات المؤقتة التي تتغير في كل مرة فيمكن أن تبقى فيinstructionsبالمستوى الأعلى. - الانتقال من Flex: انظر القسم 1.3، فالطلبات التي كانت تسلك مسار Flex تحتاج إلى اختيار طريقة معالجة بديلة.
كما أن كلا نقطتي النهاية (endpoints) لا يقبلان مستوى الاستدلال none. وعند استبدال معرّف النموذج، ينبغي أيضًا — وفقًا لدليل الترحيل الرسمي — التحقق من إعادة كتابة السجل، ومعاملات أخذ العينات، ومستوى الاستدلال، وطبقة المعالجة، وبيانات التخزين المؤقت.
3.1 مثال استدعاء بسيط جدًا لـ GPT-6.2 Sol
نستخدم فيما يلي Chat Completions لإجراء اختبار تحقق بسيط:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI الموحدة
)

resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "用三句话说明什么是会话前缀缓存"}]
)
print(resp.choices[0].message.content)
عرض كود المقارنة بين الإصدارين القديم والجديد من Responses API (تثبيت التعليمات في المقدمة + تسجيل الاستخدام)
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # يعبر الإصداران القديم والجديد عبر القناة نفسها لضمان عدالة المقارنة
)

STABLE_RULES = "你是代码库助手。回答必须列出涉及的文件路径、调用方和配置开关。"

def run(model: str, question: str, effort: str = "medium"):
    resp = client.responses.create(
        model=model,
        reasoning={"effort": effort},   # لا تقبل نقطتا النهاية القيمة none
        input=[
            # توضع التعليمات الثابتة في أول رسالة developer داخل input، ما يساعد على التخزين المؤقت للبادئة
            {"role": "developer", "content": STABLE_RULES},
            {"role": "user", "content": question},
        ],
        # يمكن وضع التعليمات المؤقتة في instructions على المستوى الأعلى، إذ تُلحق بعد input
        instructions="本轮只回答与鉴权模块相关的部分。",
    )
    usage = resp.usage
    details = getattr(usage, "output_tokens_details", None)
    return {
        "model": model,
        "text": resp.output_text,
        "output_tokens": usage.output_tokens,
        "reasoning_tokens": getattr(details, "reasoning_tokens", None),
    }

for m in ["gpt-6.1-sol", "gpt-6.2-sol"]:
    r = run(m, "登录失败后的重试逻辑在哪里实现?受哪些配置影响?")
    print(r["model"], r["output_tokens"], r["reasoning_tokens"])
    print(r["text"][:300], "\n---")
🎯 نصيحة تقنية: عند ترحيل تطبيق متعدد الأدوار، يُنصح بالاحتفاظ بمجموعة من الطلبات الحقيقية ذات «بادئة ثابتة، ورسائل مضافة فقط»، وإرسالها إلى الجيلين القديم والجديد كل على حدة، ثم مقارنة الإجابات وحجم قراءة الذاكرة المؤقتة. يدعم APIYI apiyi.com استدعاء الجيلين في الوقت نفسه، ما يسهل إدماج اختبارات المقارنة في CI.
4. التحقق حسب نوع المهمة قبل الانتقال إلى GPT-6.2 Sol
الخطة التالية هي تصميم اختباري مستند إلى الأدلة العلنية المذكورة أعلاه، وليست متطلبًا رسميًا. المبدأ الأساسي هو تثبيت كل العوامل عدا النموذج، بما في ذلك نفس قناة API، ومستوى الاستدلال، ومواد الإدخال، وقائمة الأدوات، وإعدادات المهلة، وقواعد التقييم، مع الاحتفاظ بـ 6.1 Sol كمجموعة مرجعية.
| نوع المهمة | أولوية التشغيل التجريبي | الدليل الأساسي | شرط القبول |
|---|---|---|---|
| تعديل الشيفرة | تشغيل تجريبي أولًا | تعادل مع FrontierCode-AA 2.0 مع انخفاض التكلفة والمدة | معدل نجاح الاختبارات لا يقل عن الإصدار القديم، وتنخفض تكلفة الوحدة المقبولة |
| عمليات الطرفية / الحاسوب | تشغيل تجريبي أولًا | Terminal-Bench 4.1 +4 | معدل النجاح والوقت المستغرق من طرف إلى طرف P50 وP95 |
| التحليل الاعتيادي | تشغيل تجريبي أولًا | ارتفاع الدرجة الإجمالية وانخفاض وقت Plotly وتكلفته | معدل القبول في الجولة الأولى وعدد البنود المفقودة |
| الأسئلة والأجوبة حول قاعدة الشيفرة | تحقق مخصص | SWE-Atlas-QnA-AA -14 | نسبة تغطية الحقائق الإلزامية الموسومة مسبقًا |
| تحليل معقد منخفض التكرار / حالات صعبة | تحقق مخصص | فقدان نقاط في أسئلة الأنماط المخفية في Plotly | تكلفة التسليم المقبول بعد إعادة المراجعة |
| التدفقات متعددة الجولات | تحقق مخصص | فقدان بنود الاستدلال وتغيّر موضع التعليمات | اتساق النتائج بعد إعادة التشغيل وإعادة كتابة السجل والتعافي من الفشل |
يمكن المتابعة وفق القائمة التالية أثناء التنفيذ:
- الأسئلة والأجوبة حول قاعدة الشيفرة: وسم مسبقًا لكل سؤال جهات الاستدعاء التي يجب تغطيتها، ومفاتيح تبديل الإعدادات، وشروط التفرع، ومسارات الملفات؛ ثم فحص اكتمال الأدلة بندًا بندًا، لا مجرد النظر إلى ما إذا كانت الإجابة «تبدو صحيحة».
- تسجيل المؤشرات: سجّل حسب نوع المهمة معدل القبول في الجولة الأولى، والبنود المفقودة، وعدد مرات إعادة العمل، والوقت من طرف إلى طرف، واستهلاك النموذج والأدوات؛ وعندما تكون العينة كافية، انظر إلى P50 وP95 معًا.
- احتساب التكلفة: قدّر تكلفة كل تسليم مقبول باستخدام «إجمالي التكلفة خلال فترة التقييم ÷ عدد المهام المقبولة». ويجب أن تدخل تكاليف إعادة المراجعة وإعادة التشغيل في التكلفة الإجمالية. قد تكون تكلفة تشغيل 6.2 Sol أقل، لكن إذا زادت إعادة العمل في المهام الصعبة، فقد ترتفع تكلفة التسليم المقبول بدلًا من أن تنخفض.
- تحديد التوسع: لا تزد حجم الطلبات إلا لأنواع المهام التي تستوفي الشروط الثلاثة: عتبة الجودة، وتكلفة التسليم المقبول، وزمن الاستجابة. أما الأنواع غير المستوفية فتبقى على 6.1 Sol حتى جولة إعادة الاختبار التالية.
💰 تلميح لاحتساب التكلفة: عندما يكون سعر الوحدة موحدًا في القناة نفسها، تصبح نتيجة المقارنة ذات معنى. ومن خلال APIYI apiyi.com، يمكن تشغيل جيلين من النماذج بمفتاح واحد، وتُسجّل الفواتير لكل نموذج على حدة، وهو ما يمكن استخدامه مباشرة لحساب تكلفة كل تسليم مقبول.
GPT-6.2 Sol مقابل GPT-6.1 Sol: كيف تختار؟
إذا كانت أحمالك تتكون أساسًا من تعديل الشيفرة، ووكلاء الطرفية، والتحليل الروتيني، فإن 6.2 Sol خيار أسرع وأقل تكلفة ضمن الفئة السعرية نفسها، ويمكنك الانتقال إليه أولًا. أما إذا كانت نسبة الأسئلة والأجوبة حول قاعدة الشيفرة، والمسائل الصعبة ذات الأنماط الخفية، مرتفعة، أو إذا كان عملك يعتمد على Flex، فأنهِ أولًا التحقق الخاص المذكور في القسم 4؛ وإلى أن تتحقق المؤشرات المعنية، يمكن أن يواصل 6.1 Sol تولي هذه الحصة من حركة المرور. المتغير الحاسم في هذا الاختيار هو تركيب المهام: فكلما ارتفعت نسبة الحالات الصعبة، زاد احتمال أن تُلغي إعادة العمل ميزة 6.2 Sol في سعر الوحدة والسرعة.
نوصي أولًا باستخدام رصيد الاختبار المجاني المخصص للمستخدمين الجدد على APIYI عبر apiyi.com، واختيار عينات تمثيلية من كل نوع مهمة وتشغيل جولة مقارنة، ثم تحديد نطاق الانتقال بناءً على النتائج.
مراجع
- إعلان إصدار OpenAI: ملاحظات إصدار GPT-6.2 Astra وSol ونتائج GDPval v2
- الرابط:
openai.com/index/introducing-gpt-6-2-astra-sol
- الرابط:
- بطاقة نموذج OpenAI API والتسعير: مواصفات الجيلين من Sol، والأسعار، وخيارات المعالجة
- الرابط:
developers.openai.com/api/docs/models/gpt-6.2-sol - الرابط:
developers.openai.com/api/docs/pricing
- الرابط:
- دليل استخدام GPT-6.2: تغييرات سلوك Responses وعناصر فحص الترحيل
- الرابط:
developers.openai.com/api/docs/guides/latest-model
- الرابط:
- Artificial Analysis: الدرجة الإجمالية وبيانات المؤشر الفرعي Coding Agent Index
- الرابط:
artificialanalysis.ai/agents/coding-agents/codex
- الرابط:
- Plotly DataAnalyticsBench: مقارنة الجولة الواحدة لـ 6.2 Sol وتوضيح الأسئلة المخطئة
- الرابط:
plotly.com/blog/gpt-6-2-sol-plotly-data-analytics-bench
- الرابط:
المؤلف: فريق APIYI التقني
التواصل التقني: يسعدنا تواصلك معنا من الصفحة الرئيسية لـ APIYI على apiyi.com؛ ولمزيد من مواد التكامل، يمكنك زيارة مركز وثائق docs.apiyi.com