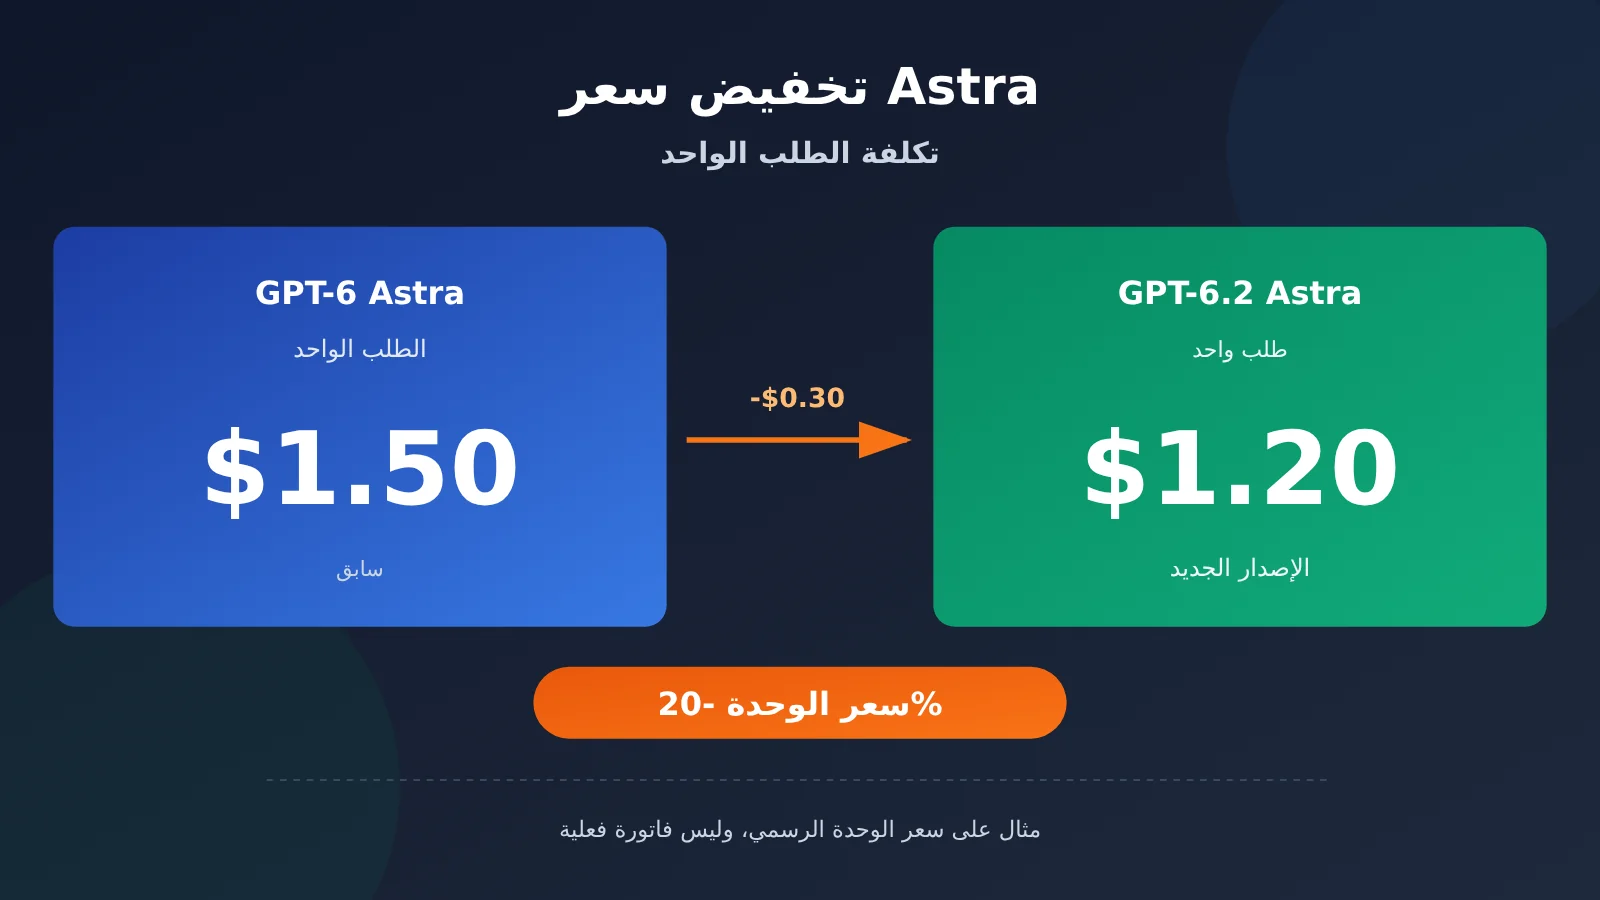
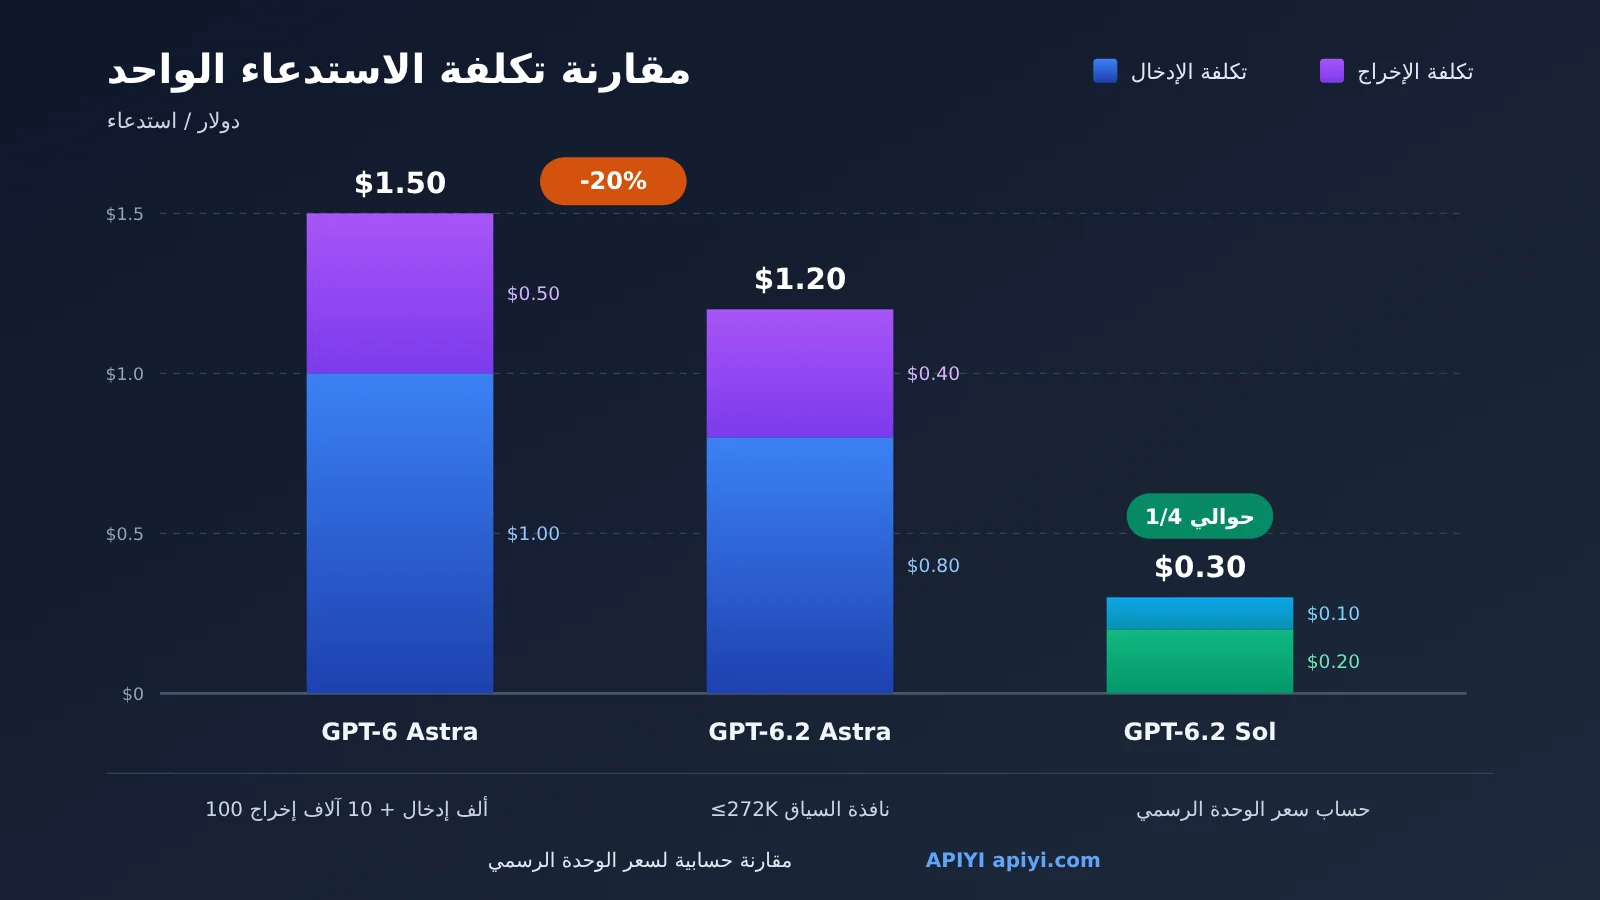
لنأخذ مثالاً على طلب قياسي «بدون ذاكرة تخزين مؤقت، 100 ألف رمز إدخال + 10 آلاف رمز إخراج، مع إدخال لا يتجاوز 272K»: وفقًا لسعر الوحدة الرسمي القياسي، يحتاج GPT-6 Astra إلى نحو $1.50، ويحتاج GPT-6.2 Astra إلى نحو $1.20، أي $0.30 أقل في كل مرة، وهو 20% بالضبط. وإذا استُخدمت الكمية نفسها من الرموز مع GPT-6.2 Sol فلن تكلف سوى نحو $0.30. يجب الانتباه إلى أن هذا «انخفاض بنسبة 20% في سعر الوحدة». تؤثر عوامل مثل ذاكرة التخزين المؤقت وشرائح السياق الطويل وحجم مخرجات الاستدلال واستدعاءات الأدوات في التكلفة النهائية، وقد لا تنخفض الفاتورة الفعلية بالنسبة نفسها البالغة 20%.
ماذا ستتعلم بعد قراءة هذا المقال؟
- ما هي الأسعار الرسمية القياسية لكل من GPT-6.2 Astra وSol، اللذين أطلقتهما OpenAI في 17 نوفمبر 2026.
- كيف تُحسب تكلفة طلب API واحد: كل خطوة ضرب، ووحدات التحويل، والافتراضات المسبقة.
- إلى أي مدى يمكن لقراءات ذاكرة التخزين المؤقت، أو السياق الطويل الذي يتجاوز 272K، أو تغيّر رموز الإخراج أن تُبعد التكلفة الفعلية عن «خفض السعر بنسبة 20%».
- كيف ينبغي للمطورين ومسؤولي الميزانية إعادة تقدير تكلفة الاستدعاءات الخاصة بهم.
الفهرس: يبدأ هذا المقال بجدول مفاهيمي ونظرة سريعة على التأثيرات لتوضيح الخلفية؛ ثم يرتب الجزء الأول «الحقائق الموضوعية» معلومات الإصدار الرسمية وجدول الأسعار والتقييمات الرسمية، ويعرض ثلاث مجموعات من الأمثلة المحسوبة ذاتيًا استنادًا إلى أسعار الوحدة الرسمية؛ ويوضح الجزء الثاني «التحليل والحكم» الفجوة بين انخفاض سعر الوحدة وانخفاض الفاتورة، ويقدّم توصيات للتعامل معها حسب الأدوار المختلفة، مع مقتطف برمجي لتقدير التكلفة قابل للتشغيل مباشرة.
مفاهيم يجب معرفتها حول خفض سعر GPT-6.2 Astra
| المفهوم | شرح موجز |
|---|---|
| Token | الوحدة الأساسية لفوترة النموذج ومعالجة النصوص، ويُسعَّر الـ API على أساس «كل مليون token» |
| الإدخال غير المخزَّن مؤقتًا | يُقصد به في هذا المقال الجزء العادي من الإدخال الذي لم يُحتسب لا ضمن قراءة التخزين المؤقت ولا ضمن كتابة التخزين المؤقت |
| قراءة التخزين المؤقت | الجزء من الطلب الذي يطابق التخزين المؤقت للموجّهات، وسعره للوحدة أقل بكثير من الإدخال غير المخزَّن مؤقتًا |
| كتابة التخزين المؤقت | تستخدم وحدات الـ token المكتوبة سعرًا إجماليًا مستقلًا؛ ولا تُضاف على الـ token نفسه رسوم الإدخال العادية مرة أخرى |
| شرائح السياق الطويل | عندما يتجاوز الإدخال 272K token، تتضاعف أسعار الإدخال والتخزين المؤقت للطلب بأكمله (مرتين)، ويصبح سعر الإخراج 1.5 ضعف |
| مستوى الاستدلال | شدة الاستدلال التي يبذلها النموذج قبل الإجابة؛ وكلما ارتفع المستوى، زادت عادةً كمية الـ token المستهلكة |
| GDPval v2 / ALE / FrontierCode 2.0 | ثلاثة تقييمات استشهدت بها OpenAI في إعلان الإصدار، ولكل منها موضوعه ومعاييره الخاصة، ولا يمكن تحويل نتائجها إلى بعضها البعض |
نظرة سريعة على تأثير خفض سعر GPT-6.2 Astra بنسبة 20%
| الفئة | التأثير الرئيسي |
|---|---|
| مطورو API | بالنسبة للطلبات ذات الطول المعتاد، ينخفض سعر الوحدة لكل من الإدخال والإخراج في Astra بنسبة 20%، وبالتالي تنخفض تكلفة نفس حجم الاستدعاءات؛ أما طلبات السياق فائقة الطول فتُحسب بشكل منفصل |
| مسؤولو الميزانية | يمكن إعادة تقييم ميزانية سعر الوحدة لـ Astra على أساس نسبة 20%، لكن الانخفاض الفعلي يجب أن يُحتسب مع نسبة إصابة التخزين المؤقت وطول السياق وحجم الإخراج، ويُتحقق منه باستخدام بيانات الفاتورة |
| الفرق التي تقيّم خياراتها | السعر القياسي لـ Sol يبلغ نحو ربع سعر Astra، ما يضيف خيارًا يستحق التقييم للمهام الحساسة للتكلفة |
| مستخدمو ChatGPT العاديون | تُطرح هذه الجولة بشكل تدريجي وبشكل أساسي لـ ChatGPT Work وCodex وAPI، ولا يشمل نطاق الإطلاق في هذه الجولة ChatGPT العادي |
أولاً: الحقائق الموضوعية وراء خفض سعر GPT-6.2 Astra بنسبة 20%
المحتوى التالي مستند إلى صفحة الإصدار الرسمية من OpenAI ووثائق النموذج وصفحة التسعير، وكان تاريخ التحقق 18 نوفمبر 2026. جميع بيانات التقييم هي تقارير رسمية، وليست نتائج قياس فعلية من فريقنا.
1.1 معلومات أساسية عن إصدار GPT-6.2 Astra وSol
أعلنت OpenAI في 17 نوفمبر 2026 عن إصدار GPT-6.2 Astra وGPT-6.2 Sol. يدعم النموذجان المدخلات النصية والصورية، بينما تكون المخرجات نصية، ولا يستطيعان توليد الفيديو بشكل أصلي.
وفيما يخص نطاق الإطلاق، أوضحت OpenAI أن النموذجين الجديدين سيُفتحان تدريجيًا لمستخدمي ChatGPT Work وCodex وAPI، ولا يشمل هذا الدور مستخدمي Chat العاديين. ويعتمد الجدول الزمني الدقيق للإتاحة على وثائق مساعدة OpenAI.
1.2 السعر القياسي الرسمي لواجهة API لنموذج GPT-6.2 Astra
يوضح الجدول التالي أسعار OpenAI الرسمية ضمن الفئة القياسية (Standard) عندما لا يتجاوز الإدخال 272K token، بوحدة دولار لكل مليون token، وهي ليست أسعار APIYI. وتُحسب كمية الإخراج وفق إجمالي الإخراج القابل للفوترة في usage، بما في ذلك token الاستدلال، ولا تساوي طول النص المرئي.
| النموذج | إدخال غير مخزّن مؤقتًا | قراءة من الذاكرة المؤقتة | الإخراج | مصدر البيانات |
|---|---|---|---|---|
| GPT-6 Astra (الجيل السابق) | $10 | $1.00 | $50 | صفحة النموذج على OpenAI |
| GPT-6.2 Astra | $8 | $0.4 | $40 | صفحة النموذج / صفحة التسعير على OpenAI |
| GPT-6.2 Sol | $2 | $0.1 | $10 | صفحة النموذج / صفحة التسعير على OpenAI |
وهناك قاعدتان رسميتان للفوترة ينبغي الانتباه إليهما:
- تُحسب الكتابة إلى الذاكرة المؤقتة بسعر إجمالي مستقل: رسوم الكتابة إلى الذاكرة المؤقتة لـ Astra في السياق القصير ضمن الفئة القياسية هي 10 دولارات لكل مليون token لمدة 30 دقيقة، و20 دولارًا لكل مليون token لمدة 12 ساعة، وليست مبلغًا يُضاف إلى سعر الإدخال العادي البالغ 8 دولارات. وينبغي أن يُصنّف token الإدخال الواحد ضمن الإدخال العادي أو القراءة من الذاكرة المؤقتة أو الكتابة إليها وفق عمرها المقابل، ولا يجوز فوترته أكثر من مرة.
- عند تجاوز الإدخال 272K token، تُحسب أسعار الإدخال وأسعار الذاكرة المؤقتة للطلب بأكمله بمعامل ضعفين، ويُحسب سعر الإخراج بمعامل 1.5.
وبالمقارنة مع الجيل السابق، انخفض سعر الإدخال غير المخزّن مؤقتًا في Astra من 10 دولارات إلى 8 دولارات، وانخفض سعر الإخراج من 50 دولارًا إلى 40 دولارًا، أي بنسبة 20% في البندين. وهذا هو المعنى الدقيق لعبارة «خفض السعر بنسبة 20%»: انخفاض سعر الوحدة القياسي بنسبة 20%.
1.3 بيانات التقييم الرسمية لـ GPT-6.2 Astra (ليست قياسات من فريقنا)
قدّمت OpenAI في إعلان الإصدار عدة نتائج تقييم. لكل تقييم منهجيته ومعياره الخاص، لذلك لا يمكن خلطها وتفسيرها معًا:
- GDPval v2: يتقدّم GPT-6.2 Astra على GPT-6 Astra بمقدار 6.2 نقطة مئوية، مع إخراج رموز (tokens) أقل بنسبة 22%؛ ويتقدّم GPT-6.2 Sol على GPT-6.1 Sol بمقدار 5.3 نقطة مئوية.
- ALE: يحقّق GPT-6.2 Astra تحسنًا بمقدار 5.2 نقطة. هذا تقييم مختلف، ولا يمكن جمع نقاطه المئوية مع GDPval أو مقارنتها به.
- FrontierCode 2.0: عند مستوى الاستدلال max، تكون نتيجة Sol أقل من Astra بمقدار 0.5 نقطة، فيما تبلغ تكلفة المهمة نحو 1/5 من تكلفة Astra. وهذا ينطبق فقط على هذا الاختبار وهذا المستوى، ولا يصح اعتباره استنتاجًا عامًا بشأن التكلفة.
1.4 مثال على الحساب الذاتي لتكلفة طلب واحد من GPT-6.2 Astra
الأمثلة الحسابية الثلاثة التالية هي حسابات رياضية أجريناها بناءً على أسعار الوحدة القياسية المعلنة على الموقع الرسمي، وليست قياسات فعلية عبر API، ولا تمثل أي فاتورة حقيقية لأي حساب. صيغة الحساب هي:
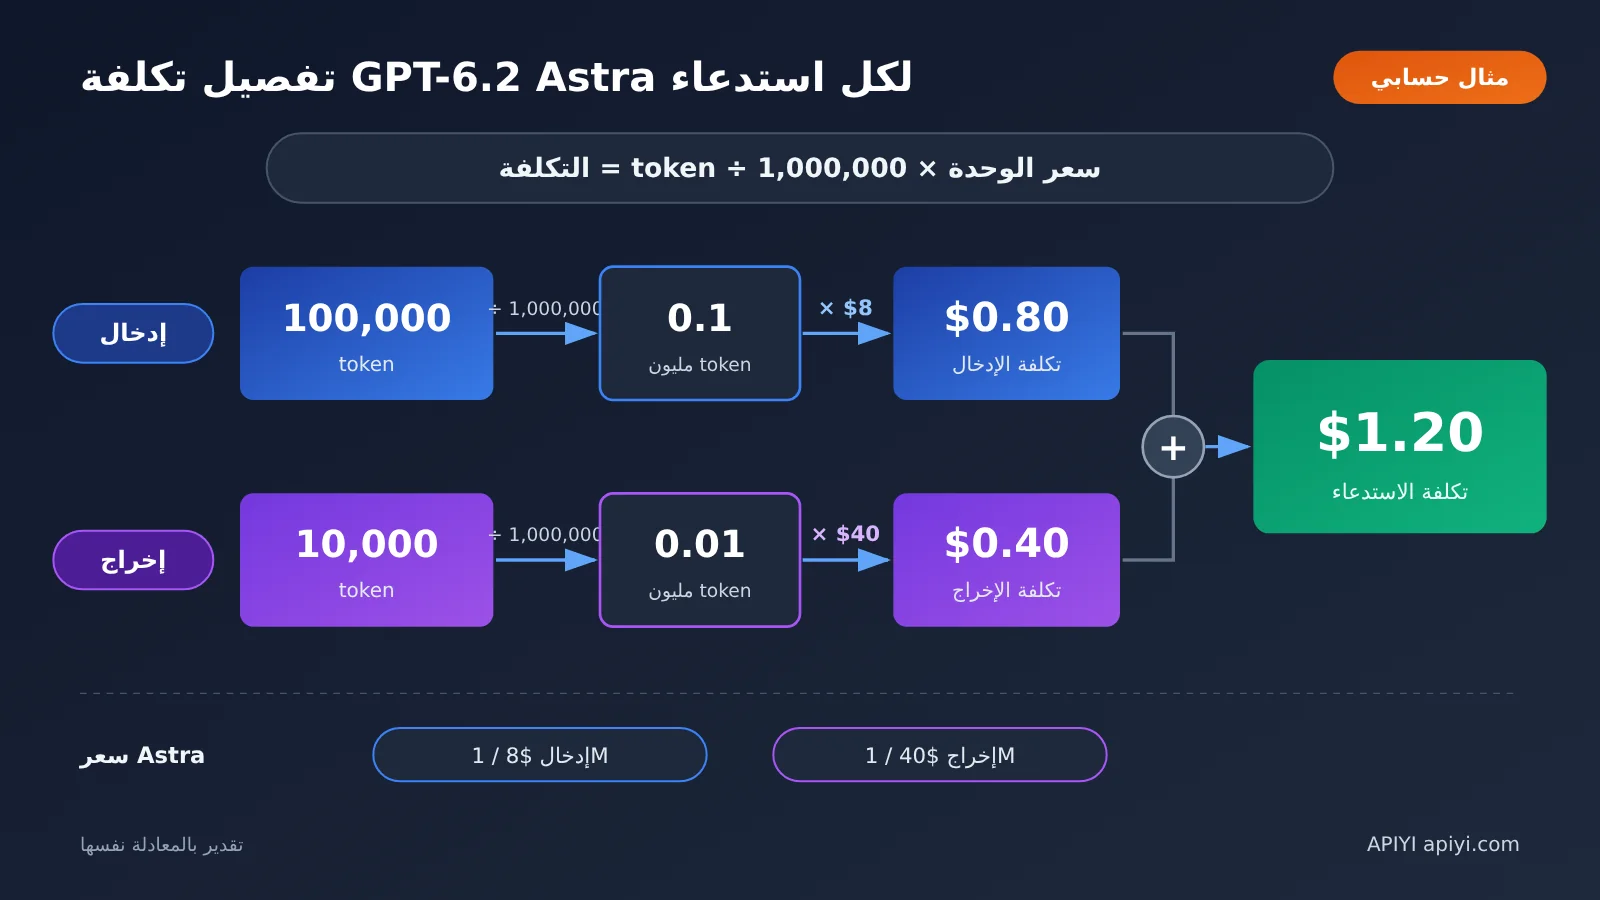
التكلفة = عدد tokens ÷ 1,000,000 × سعر الوحدة لكل مليون token
المثال الحسابي الأول: طلب قياسي، مقارنة بين Astra القديم والجديد وSol
الافتراضات المسبقة: مدخلات غير مخزنة مؤقتًا 100,000 token، ومخرجات 10,000 token، والمدخلات لا تتجاوز 272K، دون قراءة أو كتابة في التخزين المؤقت، ودون استدعاء أدوات، مع الحساب بالسعر القياسي.
| البند | GPT-6 Astra | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|---|
| تكلفة الإدخال | 0.1 × $10 = $1.00 | 0.1 × $8 = $0.80 | 0.1 × $2 = $0.20 |
| تكلفة الإخراج | 0.01 × $50 = $0.50 | 0.01 × $40 = $0.40 | 0.01 × $10 = $0.10 |
| الإجمالي للطلب الواحد | $1.50 | $1.20 | $0.30 |
| مقارنةً بـ GPT-6 Astra | الأساس | أقل بـ $0.30 (-20%) | أقل بـ $1.20 (-80%) |
يشير “0.1” في الجدول إلى 100,000 ÷ 1,000,000، و”0.01″ إلى 10,000 ÷ 1,000,000. إذا أرسلت 10,000 طلب مماثل شهريًا، ووفقًا لهذه المجموعة من الافتراضات، فإن GPT-6 Astra سيكلف نحو $15,000، وGPT-6.2 Astra نحو $12,000. هذه النتيجة مجرد إسقاط خطي، ولا تشكل أي التزام بشأن التكاليف.
المثال الحسابي الثاني: طلب GPT-6.2 Astra يصيب التخزين المؤقت
الافتراضات المسبقة: إجمالي المدخلات 100,000 token، منها 80,000 token تصيب التخزين المؤقت بالقراءة، و20,000 token مدخلات عادية لا تُكتب في التخزين المؤقت، والمخرجات 10,000 token؛ ويُفترض أن حجم الكتابة في التخزين المؤقت هذه المرة صفر، ولا تُحتسب تكلفة إنشاء التخزين المؤقت التاريخي في هذا المثال.
- الإدخال غير المخزن مؤقتًا: 0.02 × $8 = $0.16
- القراءة من التخزين المؤقت: 0.08 × $0.4 = $0.032
- الإخراج: 0.01 × $40 = $0.40
- الإجمالي: نحو $0.592
سعر القراءة من التخزين المؤقت في الجيل السابق GPT-6 Astra هو $1.00/مليون token، بينما في النسخة الجديدة $0.40، أي انخفاض بنسبة 60%. وبنفس مجموعة أعداد tokens، كانت تكلفة الجيل السابق $0.20 + $0.08 + $0.50 = $0.78؛ والنسخة الجديدة $0.592، أي أقل بـ $0.188، بانخفاض نحو 24.1%. ولم يُحتسب في كليهما الكتابة في التخزين المؤقت ولا الأدوات ولا غيرها من التكاليف، فلا يمكن اعتبارهما فاتورة كاملة.
المثال الحسابي الثالث: طلب GPT-6.2 Astra بسياق طويل يتجاوز 272K
الافتراضات المسبقة: إدخال عادي 300,000 توكن (أكثر من 272K)، وإخراج 10,000 توكن، وحجم القراءة والكتابة في ذاكرة التخزين المؤقت صفر.
- الإدخال: 0.3 × ($8 × 2) = $4.80
- الإخراج: 0.01 × ($40 × 1.5) = $0.60
- المجموع: $5.40
يرجى ملاحظة أن الشرائح السعرية تُحتسب على أساس الطلب بأكمله. بمجرد أن يتجاوز الإدخال 272K، تُحتسب جميع مدخلات هذا الطلب بضعف السعر، وليس فقط الجزء الذي تجاوز الحد.
يُضبط عمر ذاكرة التخزين المؤقت باستخدام prompt_cache_options.ttl في Responses API: القيمة الافتراضية "30m"، ويمكن اختيار "12h"، ويمكن تعيين قيمة مختلفة لنقطة توقف صريحة واحدة عبر prompt_cache_breakpoint.ttl. وهي تعني الحد الأدنى لعمر ذاكرة التخزين المؤقت، وليست مهلة حذف البيانات، ولا ينبغي الخلط بينها وبين معامل prompt_cache_retention الخاص بالنماذج القديمة.
عندما يتجاوز الإدخال 272K، تكون أسعار الإدخال العادي، وقراءة ذاكرة التخزين المؤقت، والكتابة لمدة 30 دقيقة، والكتابة لمدة 12 ساعة، والإخراج في فئة Standard لنموذج Astra على التوالي: $16، و$0.80، و$20، و$40، و$60 لكل مليون توكن؛ ويُطبّق المضاعف على الطلب بأكمله، وليس على الجزء الزائد فقط.
1.5 المصادر الرسمية لـ GPT-6.2 Astra
-
إعلان OpenAI: openai.com/index/introducing-gpt-6-2-astra-sol/
- وثائق نموذج GPT-6 Astra: أسعار النموذج القديم الرسمية
- وثائق نموذج GPT-6.2 Astra: أسعار النموذج الجديد الرسمية وشروط التسعير
- وثائق نموذج GPT-6.2 Sol: developers.openai.com/api/docs/models/gpt-6.2-sol
- صفحة أسعار OpenAI API: developers.openai.com/api/docs/pricing
- وثائق المساعدة لـ ChatGPT Work وCodex: help.openai.com/en/articles/20001275-chatgpt-work-and-codex
ثانيًا: تحليل وتقييم خفض سعر GPT-6.2 Astra بنسبة 20%
ما يلي قراءة تحريرية مبنية على الحقائق المذكورة أعلاه، وهي تحليل وتقييم وليست نتيجة رسمية.
2.1 انخفاض سعر الوحدة بنسبة 20%: لماذا لا تنخفض الفاتورة بالضرورة بنسبة 20%؟
لماذا يعطي المثال الحسابي الأول نسبة 20% بالضبط؟ لأنه لا يتضمن سوى بندين: الإدخال غير المخزّن في الذاكرة المؤقتة والإخراج القياسي، وكلاهما انخفض بنسبة 20% بالضبط. أما فاتورة الأعمال الحقيقية فتتكوّن عادةً من عدة أنواع من التكاليف، وأي تغيّر في نسبة أحد البنود قد يجعل نسبة الانخفاض الإجمالية تنحرف عن 20%.
| عامل التكلفة | التأثير المحتمل على الفاتورة الفعلية | أساس الحكم |
|---|---|---|
| قراءة الذاكرة المؤقتة وكتابتها | ينخفض سعر قراءة الذاكرة المؤقتة بنسبة 60%، وهو يختلف عن انخفاض الإدخال غير المخزّن مؤقتًا البالغ 20%؛ يجب الحساب وفق عدد token لكلٍّ منهما، ولا يمكن افتراض نسبة انخفاض إجمالية مسبقًا؛ تُحسب كتابة الذاكرة المؤقتة بمعدل إجمالي مستقل، ولا تُضاف إلى رسوم الإدخال العادية | جدول الأسعار الرسمي |
| شرائح السياق الطويل | عند تجاوز 272K ترتفع تسعيرة الطلب بأكمله، وقد تكون تكلفة الطلب الواحد في سيناريو المستندات الطويلة أعلى بكثير من المثال الحسابي الأول | قواعد الفوترة الرسمية |
| عدد token الإخراج / الاستدلال | أفادت الجهة الرسمية في GDPval v2 بأن token الإخراج أقل بنسبة 22%؛ إذا شهدت مهمتك تغيّرًا مشابهًا فقد يتجاوز التوفير 20%؛ وإذا كان مستوى الاستدلال أعلى فقد تصبح التكلفة أكبر أيضًا | تقييم رسمي (مهمة محددة) |
| استدعاء الأدوات ومستوى السرعة | وضع Fast في GPT-6.2 Astra يعادل ضعف تسعيرة Standard للسياق نفسه، بينما Batch يعادل 50%؛ وتُحسب رسوم الأدوات بشكل منفصل وفق الأداة المستخدمة | صفحة النموذج الرسمية وصفحة التسعير |
| قناة الاستدعاء | عند الاستدعاء عبر منصات طرف ثالث مثل APIYI apiyi.com، تُعتمد الفوترة الفعلية المعلنة من المنصة، ولا يمكن تطبيق السعر الرسمي مباشرة | اختلاف القنوات |
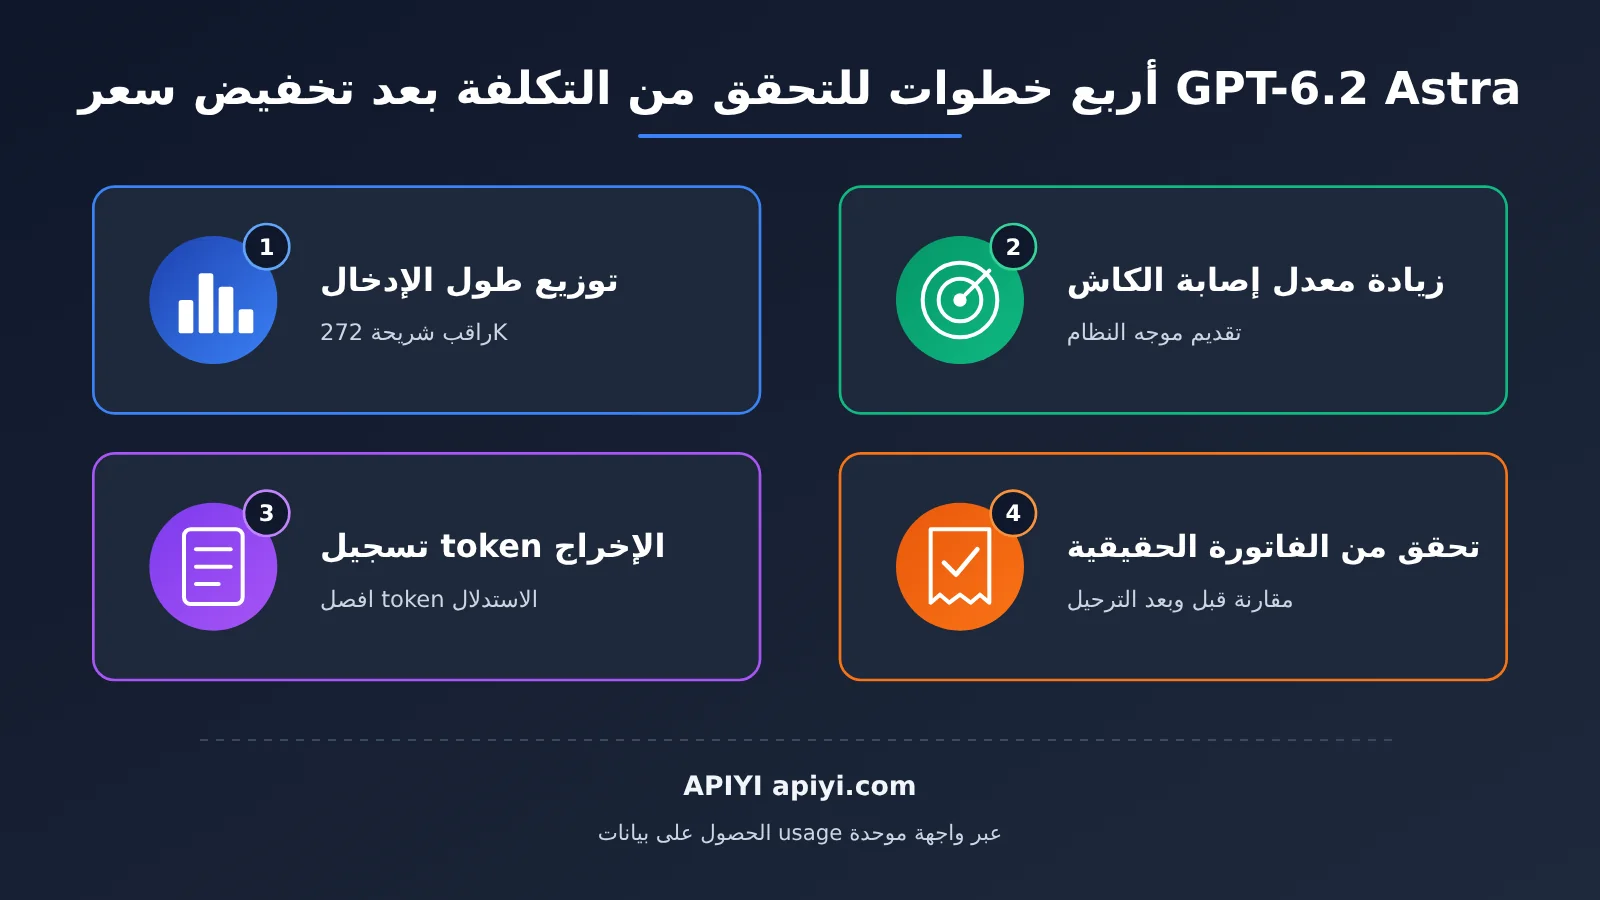
ثمة تفصيل يسهل إغفاله هو «الإخراج أقل بنسبة 22%». هذا الرقم مستند إلى تقييم GDPval v2 وحده؛ وإذا طبّقته مباشرةً على كل الأعمال واستنتجت منه «توفير فعلي يتجاوز 30%»، فأنت تحوّل نتيجة رسمية من تقييم محدد إلى قاعدة عامة. والطريقة الأكثر أمانًا هي إجراء اختبار على عينة صغيرة باستخدام طلباتك الحقيقية، وتسجيل عدد token في حقل usage، ثم اتخاذ القرار.
2.2 تقييم اختيار Astra مقابل Sol في GPT-6.2
من حيث سعر الوحدة القياسي، نجد أن كل بند من بنود تسعير Sol يبلغ نحو ربع سعر Astra. وفي المثال الحسابي الأول، كانت تكلفة الاستدعاء الواحد على Sol ربع تكلفة Astra فقط. وتشير نتائج FrontierCode 2.0 إلى أن الفارق بين Sol عند أعلى مستوى استدلال وAstra ضئيل، لكن الجهة الرسمية لم توضح ما إذا كان هذا الاستنتاج ينطبق على مهام أخرى.
لذلك فإن تقييمنا هو: في السيناريوهات الحساسة للتكلفة والمتوسطة الصعوبة، يستحق Sol أن يُقيَّم أولاً؛ أما في السيناريوهات التي تتطلب جودة عالية أو مهام معقدة، فقد خفّض انخفاض سعر Astra من عتبة الدخول إليها أيضاً. وأي الخيارين ستختار في النهاية، فالأفضل أن تحسمه بمقارنة A/B على مجموعة مهامك الخاصة.
💡 توصية للاختيار: إذا كنت بحاجة إلى مقارنة استهلاك الـ tokens وجودة المخرجات بين عدة نماذج داخل الشفرة نفسها، فيمكنك التفكير في تبديل النماذج عبر واجهات تجميع متوافقة مع OpenAI مثل APIYI apiyi.com. أما هل سلسلة GPT-6.2 متاحة بالفعل على المنصة وما سعرها، فيُرجى الرجوع إلى قائمة النماذج وصفحة الفوترة على المنصة.
2.3 كود تقدير تكلفة GPT-6.2 Astra
السكربت التالي يقوم بحسابات محلية فقط، ولا يستدعي أي واجهة برمجية. وهو يقسّم المدخلات إلى أربع فئات غير متداخلة: المدخلات العادية، والقراءة من ذاكرة التخزين المؤقت، والكتابة لمدة 30 دقيقة، والكتابة لمدة 12 ساعة؛ ويُستخدم إجمالي حجم المدخلات لتحديد شريحة 272K. وسعر الكتابة هنا سعر إجمالي، فلا تُضاف رسوم المدخلات العادية مرة أخرى فوق رموز الكتابة.
# أسعار OpenAI القياسية، بالدولار لكل مليون رمز؛ لا تشمل الأدوات والضرائب ورسوم الشرائح الأخرى
PRICES = {
    "gpt-6-astra":   {"input": 10.0, "cached": 1.0, "output": 50.0},
    "gpt-6.2-astra": {"input": 8.0, "cached": 0.4, "output": 40.0},
    "gpt-6.2-sol":   {"input": 2.0, "cached": 0.1, "output": 10.0},
}

def estimate_cost(model, ordinary_input, output_tokens, cached_read=0,
                  write_30m=0, write_12h=0):
    counts = (ordinary_input, output_tokens, cached_read, write_30m, write_12h)
    if any(n < 0 for n in counts):
        raise ValueError("token 数不得为负")
    p = PRICES[model]
    total_input = ordinary_input + cached_read + write_30m + write_12h
    im, om = (2.0, 1.5) if total_input > 272_000 else (1.0, 1.0)
    input_cost = (ordinary_input * p["input"] + cached_read * p["cached"]
                  + write_30m * p["input"] * 1.25
                  + write_12h * p["input"] * 2.5) * im
    return round((input_cost + output_tokens * p["output"] * om) / 1e6, 6)

print(estimate_cost("gpt-6-astra", 100_000, 10_000))  # 1.5
print(estimate_cost("gpt-6.2-astra", 100_000, 10_000))  # 1.2
print(estimate_cost("gpt-6.2-sol", 100_000, 10_000))  # 0.3
print(estimate_cost("gpt-6.2-astra", 20_000, 10_000, cached_read=80_000))  # 0.592
# نفس المدخلات البالغة 100 ألف محسوبة بالكامل ككتابة لمدة 30 دقيقة: ليست 1.2 مضافًا إليها 1.0
print(estimate_cost("gpt-6.2-astra", 0, 10_000, write_30m=100_000))  # 1.4
أما بالنسبة إلى usage في Responses، فينبغي أولاً تحديد كمية القراءة من ذاكرة التخزين المؤقت وكمية الكتابة، ثم طرحهما من إجمالي المدخلات للحصول على المدخلات العادية. وعند مزج عمر 30 دقيقة مع عمر 12 ساعة، يجب أيضًا توزيع كمية الكتابة وفق تفاصيل الفوترة الفعلية؛ فلا يصح تطبيق سعر واحد على كل عمليات الكتابة. وإذا كانت القناة تفتقر إلى تفاصيل الكتابة أو كانت طريقة الفوترة لديها مختلفة، فتحقّق من فاتورة تلك القناة، ولا تفترض أن كمية الكتابة صفر. وعندما يتضمن ناتج الفوترة رموز الاستدلال، لا تُضِف كمية الاستدلال مرة أخرى. لم تتضمن هذه المقالة أي استدعاء فعلي لواجهة API؛ وأما دعم المنصات الخارجية لهذه الإعدادات وطريقة تسعيرها، فالمرجع هو وثائقها.
2.4 توصيات ما بعد تخفيض سعر GPT-6.2 Astra
للمطورين: ابدأ بإحصاء توزيع أطوال المدخلات في طلباتك الحالية، لمعرفة عدد الطلبات التي تقترب من 272K أو تتجاوزها. وإذا كانت نسبة طلبات السياق الطويل مرتفعة، فيمكنك تقليص المدخلات إلى داخل شرائح التسعير عبر تقسيم الاسترجاع إلى شرائح أو التلخيص والضغط؛ وقد تكون هذه الوفورات أكبر من الـ20% التي يوفرها التخفيض. وفي الوقت نفسه، ضع موجه النظام الثابت في مقدمة الطلب لرفع معدل إصابة ذاكرة التخزين المؤقت.
لمسؤول الميزانية: يمكنك اعتبار «انخفاض سعر الوحدة القياسي في Astra بنسبة 20%» مرجعًا أساسيًا للميزانية عند تساوي حجم المدخلات والمخرجات غير المخزنة مؤقتًا، وليس حدًا أعلى للتخفيض الفعلي أو مبلغ توفير مؤكدًا. نوصي بمقارنة الفواتير الحقيقية لفترة قبل الترحيل وفترة بعده، وسرد التغيرات في ذاكرة التخزين المؤقت والسياق الطويل وتوكنات المخرجات كلًا على حدة. وبالنسبة للفرق التي تستدعي النماذج عبر منصات مثل APIYI apiyi.com، يجب أيضًا الاعتماد على أساس الفوترة المعتمد في فاتورة المنصة.
التغيرات اللاحقة التي لا تزال تستدعي الانتباه: تحديثات الأسعار الرسمية، وتقدم فتح القنوات، وما إذا كانت التقييمات المستقلة من طرف ثالث قادرة على إعادة إنتاج البيانات الرسمية. أعلنت الجهة الرسمية بالفعل عن أسعار كتابة ذاكرة التخزين المؤقت وفئات السرعة، لذا ينبغي عند التقدير التحقق من الفئة المختارة بدلًا من اعتبارها غير معلنة. في Astra الجديدة، ضمن سياق Standard القصير، تكون كتابة ذاكرة التخزين المؤقت لمدة احتفاظ 30 دقيقة بسعر 10 دولارات لكل مليون توكن، ولمدة 12 ساعة بسعر 20 دولارًا لكل مليون توكن. وتفترض أمثلة الحساب الرئيسية الثلاثة في هذا المقال أن حجم كتابة ذاكرة التخزين المؤقت صفر في هذه المرة، وهذا لا يعني بالضرورة أن طلبات API الافتراضية بلا كتابة.
إذا كنت تريد أولًا اختبار عملية التحقق من الفوترة من البداية إلى النهاية، فيمكنك على APIYI apiyi.com استخدام نفس الشيفرة لمقارنة بيانات usage لنماذج مختلفة. وبعد إطلاق سلسلة GPT-6.2 على القناة التي تستخدمها، ستتمكن من إدخال عدد التوكنات الفعلي مباشرة في دالة التقدير أعلاه.
تخفيض السعر بنسبة 20% إشارة واضحة، لكن الرقم على الفاتورة يعتمد على طول المدخلات في كل طلب، ومقدار إصابة ذاكرة التخزين المؤقت، وحجم المخرجات. إن حساب كل عملية ضرب بوضوح أكثر فائدة من حفظ نسبة مئوية.
“Beware of little expenses; a small leak will sink a great ship.”
— بنجامين فرانكلين، «تقويم ريتشارد المسكين»
(احذر النفقات الصغيرة؛ فثغرة صغيرة قد تغرق سفينة عظيمة.)