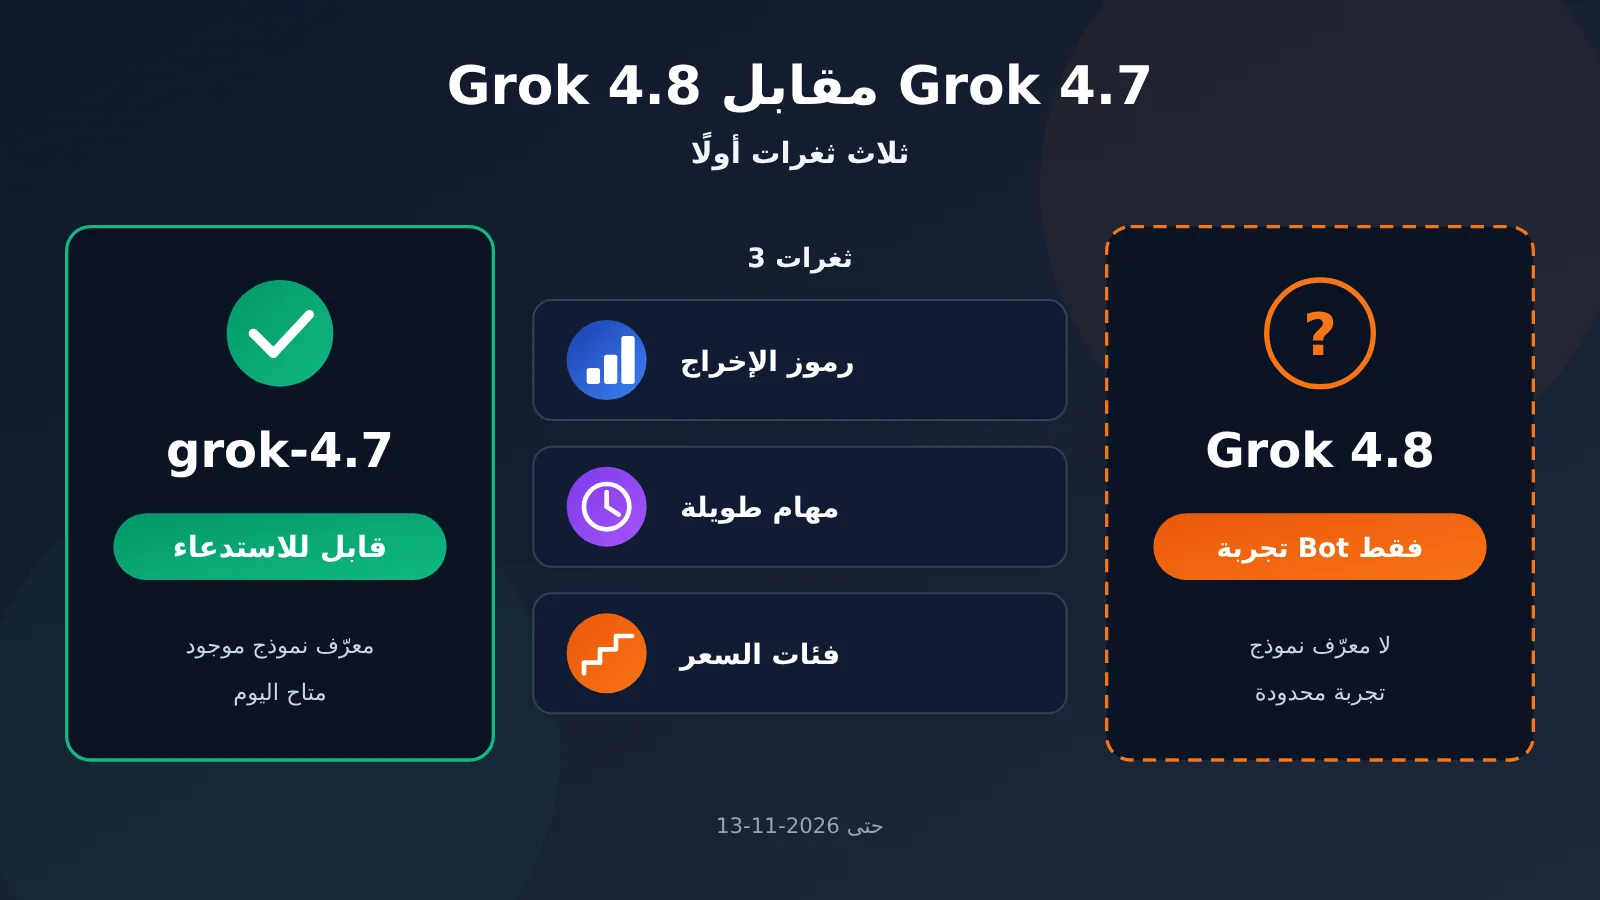
ملاحظة الكاتب: اليوم لدينا استدعاء للواجهة البرمجية، ونواصل استخدام grok-4.7. وحتى تاريخ 2026-11-13 لا يزال Grok 4.8 بلا معرّف نموذج، لذا تتحقق هذه المقالة من 3 نقاط ضعف في Grok 4.7 وفق المصادر، لترى هل توجد أدلة تكفي لسدّها في 4.8.
إذا كنت تستدعي grok-4.7 في بيئة الإنتاج، فربما يراودك مؤخرًا تساؤل واحد: هل أتوقف وأنتظر Grok 4.8؟ الخلاصة أولًا: إذا كان لديك استدعاء واجهة اليوم، فاستخدم grok-4.7. حتى تاريخ 2026-11-13، لا يملك Grok 4.8 معرّف نموذج، ولا بطاقة نموذج، ولا درجات على لوحات التصنيف، ولا سعرًا. وما ذكره ماسك عن «هذا الأسبوع» هو مجرد تجربة محدودة النطاق (soft rollout) لمستخدمي Grok Bot، وليس إطلاقًا لواجهة API.
هذه ليست مقالة تشويقية من نوع «النسخة الجديدة أقوى بالضرورة». تقارن هذه المقالة ثلاث نقاط ضعف فقط يمكن مطابقتها مع البيانات المنشورة عن Grok 4.7. وكل نقطة منها مُعلَّم عليها مصدرها: هل هو إفصاح رسمي، أم لوحة تصنيف من طرف ثالث، أم كلام ماسك نفسه. ثم ننظر بعد ذلك: هل توجد اليوم أدلة على أن Grok 4.8 سدّها.
القيمة الأساسية: بعد قراءة هذا المقال، ستعرف أين تكمن نقاط ضعف Grok 4.7 بالتحديد، ومن أي مصدر جاءت بياناتها، وكيف تتحكم في التكلفة عبر شرائح الـ 200 ألف توكن قبل أن يصدر Grok 4.8.
Grok 4.8 مقابل Grok 4.7: كيف تختار اليوم
هذه المقارنة تختلف عن المقارنات المعتادة بين الإصدارات القديمة والجديدة. فـ Grok 4.8 لا يمتلك في الوقت الحاضر سوى بضع جمل من ماسك على منصة X، دون أي نتائج قابلة للتحقق. لذلك فإن المعنى الفعلي لكلمة “مقارنة” هنا هو: ما هي نقاط الضعف في Grok 4.7 التي وثّقتها البيانات المنشورة، وهل التغييرات المعروفة في Grok 4.8 قادرة على معالجة هذه النقاط.
| حالتك | التوصية | السبب |
|---|---|---|
| عليك الإطلاق أو تعديل الواجهة هذا الأسبوع | استخدم grok-4.7 | قائمة النماذج في المنصة لا تحتوي إلا على grok-4.7 |
| أنت بصدد تقييم اختيار طويل الأمد | شغّل خط الأساس باستخدام grok-4.7 أولاً | لا توجد لوحة تصنيف لـ 4.8، لذا لا يمكن المقارنة الأفقية |
| ترغب في تجربة 4.8 في أسرع وقت | راقب قائمة النماذج في المنصة | الإطلاق الناعم لـ Bot لا يعني أن API متاح |
| لديك متطلبات عالية جداً للمهام الطويلة | لا تُعلّق آمالك على 4.8 | لا يوجد دليل على أن الفجوة في المهام الطويلة قد ضاقت |
يجدر التوضيح أن “Bot users” تعني مستخدمي Grok Bot، وليس روبوتات الأجهزة. أما “soft rollout” فهي إطلاق محدود النطاق، وليست واجهة متاحة للمطورين. والتعامل معها على أنها “معرّف نموذج جاهز للتبديل إليه” سيؤدي مباشرة إلى خطأ في الاستدعاء.
الفروقات الجوهرية بين Grok 4.8 وGrok 4.7: مصادر ثلاث نقاط ضعف
يسرد الجدول التالي أولاً نوع مصدر كل نقطة ضعف. وسيأتي التفصيل لاحقًا بهذا الترتيب نفسه تمامًا.
| نقطة الضعف | نوع المصدر | تاريخ المصدر | هل لدى Grok 4.8 أدلة تعوّضها؟ |
|---|---|---|---|
| إخراج رموز أكثر من اللازم | لوحة ترتيب طرف ثالث (Artificial Analysis) | 2026-09-21 | لا |
| تخلّف عن Fable في المهام الطويلة التي تستغرق ساعات عدة | إبلاغ ذاتي رسمي (جدول مدونة xAI) | 2026-09-21 | لا |
| ارتفاع تسعير السياق الطويل حسب الشرائح + ماسك لا يقرّ بالأساس | قائمة أسعار المنصة + تصريح ماسك المباشر | 2026-11-13 / 2026-11-10 | لا |
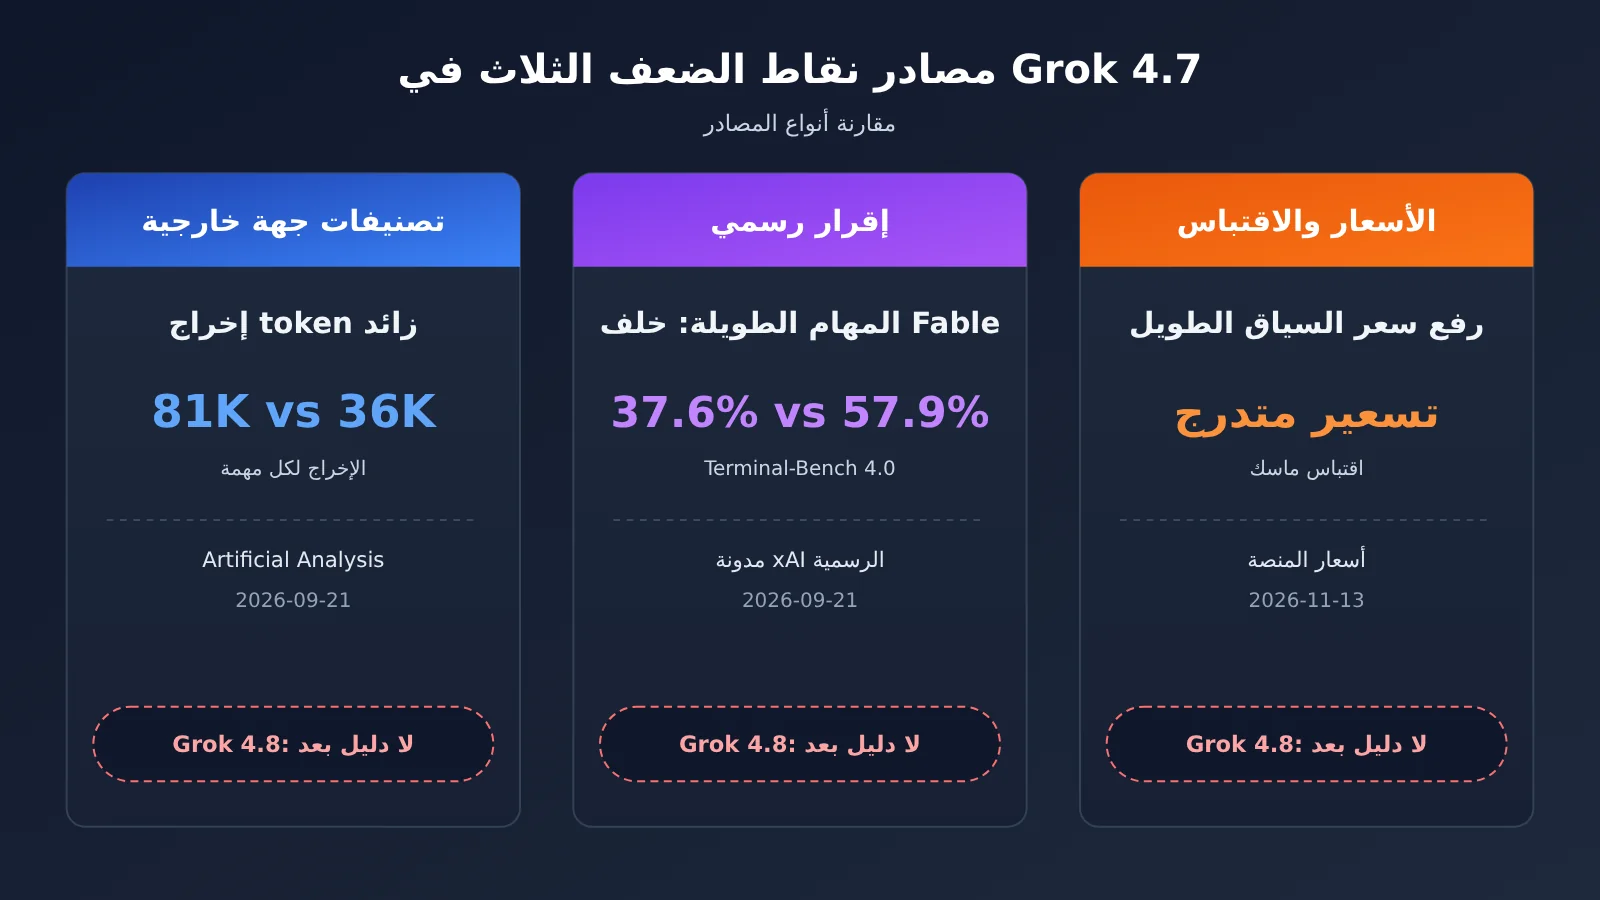
نقطة الضعف الأولى: Grok 4.7 يُخرج رموزًا أكثر من اللازم (لوحة ترتيب طرف ثالث)
مصدر هذه النقطة هو تقييم Artificial Analysis لـ Grok 4.7 المنشور في 2026-09-21، وهو تصنيف من طرف ثالث، وليس بيانات رسمية ولا اختبارًا أجراه كاتب هذا المقال. اختبروا النموذج على إعداد xhigh، وحصل Grok 4.7 على مؤشر ذكاء قدره 46، أعلى بنقطتين من Grok 4.6. ارتفع الدرجة، لكن الثمن كان زيادة واضحة في رموز الإخراج.
وفي التقييم نفسه جاءت مقارنة حجم الإخراج على النحو التالي. انتبه إلى أن رقمي Grok 4.6 يعودان إلى إعدادين مختلفين، ولا يصح دمجهما في رقم واحد:
- Grok 4.7 (xhigh): نحو
81,000رمز إخراج لكل مهمة من مهام مؤشر الذكاء - Grok 4.6 (high): نحو
36,000رمز إخراج - Grok 4.6 (xhigh): نحو
38,000رمز إخراج، ويقول التقييم إن 4.7 يزيد عن ضعفه - GPT-6 Astra (max): نحو
27,000رمز إخراج
لاستشعار الحجم، يمكن الحساب التقريبي بسعر الإخراج الرسمي $6 / 1M tokens: 81 ألف رمز إخراج تساوي نحو $0.49، و36 ألفًا نحو $0.22. هذه مجرد طريقة تحويل خاصة بمهام لوحة الترتيب، لتوضيح «المسألة نفسها، أين تُصرف التكلفة»، وليست فاتورة فعلية لأي منصة.
كما يوضح Artificial Analysis أن سياق Grok 4.7 يبلغ 500K، والسعر المعلن $2 / $6، وسعر إصابة ذاكرة التخزين المؤقت $0.50، وكلها مماثلة لـ 4.6. أي أن سعر الوحدة لم يرتفع، لكن عدد الرموز التي يخرجها كل مهمة زاد، وبالتالي ارتفعت تكلفة المهمة الواحدة فعليًا.
نقطة الضعف الثانية: المهام الطويلة متعددة الساعات في Grok 4.7 لا تزال متأخرة عن Fable (إقرار رسمي)
مصدر هذه النقطة هو جدول المقارنة في مدونة xAI الرسمية بتاريخ 2026-09-21، وهي بيانات معلنة من الشركة نفسها. رؤوس الجدول الأربعة بالترتيب هي: Grok 4.7 xHigh، وGrok 4.6 High، وGPT-5.6 Sol Max، وFable 5.1 Max. وأوضح بندين يكشفان الفجوة في المهام الطويلة هما التاليان:
- Terminal-Bench 4.0: Grok 4.7 بنسبة
37.6%، وFable 5.1 Max بنسبة57.9%(أما Grok 4.6 فبنسبة20.3%، وGPT-5.6 Sol بنسبة37.3%) - CursorBench 4.0: Grok 4.7 بنسبة
46.3%، وFable 5.1 Max بنسبة51.8%(أما Grok 4.6 فبنسبة40.4%، وGPT-5.6 Sol بنسبة41.7%)
لكن الجدول الرسمي لا يعني «تأخرًا شاملًا». فالتحسن الذي حققه Grok 4.7 مقارنةً بـ 4.6 تحسن حقيقي، كما أنه يتصدر معيارين متخصصين:
- EEBench: Grok 4.7 بنسبة
64.0%، وهي أعلى من53.0%لـ 4.6، و39.4%لـ GPT-5.6 Sol، و56.4%لـ Fable 5.1 - Harvey Legal Agent Benchmark: Grok 4.7 بنسبة
19.6%، وهي أعلى من15.8%/2.5%/6.7% - DeepSWE v1.1: Grok 4.7 بنسبة
71.0%، وتشير الشركة إلى أنه بـ high effort وليس xhigh، وهو أقل قليلًا من72.7%لـ GPT-5.6 Sol - AA Briefcase v1.1: Grok 4.7 عند
1657، وهو أقل قليلًا من1678لـ Fable - HealthBench Professional: Grok 4.7 بنسبة
56.7%، وهي أقل من60.5%لـ GPT-5.6 Sol و62.1%لـ Fable
| المعيار في الجدول الرسمي | مقارنةً بـ Grok 4.6 | مقارنةً بـ GPT-5.6 Sol | مقارنةً بـ Fable 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0 | أعلى بوضوح | متساوٍ تقريبًا مع ارتفاع طفيف | فجوة واضحة |
| CursorBench 4.0 | أعلى | أعلى | أقل |
| DeepSWE v1.1 | أعلى | أقل قليلًا | أعلى قليلًا |
| EEBench | أعلى | أعلى | أعلى |
| Harvey Legal Agent | أعلى | أعلى | أعلى |
| HealthBench Professional | أعلى | أقل | أقل |
وثمة مجموعة بيانات أخرى من لوحة تقييم طرف ثالث، ينبغي الإشارة إليها بشكل منفصل. تُظهر تقييمات Artificial Analysis أن Grok 4.7، مقارنةً بـ Grok 4.6، أعلى بـ 4.5 نقاط في Terminal-Bench 4.0، وأعلى بـ 3.0 نقاط في GDP.pdf؛ لكنه أقل بـ 3.7 نقاط في AA-LCR، وأقل بـ 1.1 نقاط في AutomationBench-AA. وهنا لا تمثل عبارة «+4.5 نقاط» و37.6% مقابل 20.3% في الجدول الرسمي المجموعة نفسها من الدرجات المطلقة، ولا يجوز الخلط بينهما.
النقطة الضعيفة الثالثة: تسعير Grok 4.7 المتدرج وتصريحات ماسك الحرفية (الأسعار + التصريحات)
هناك جزأان في هذه النقطة الثالثة: الأول هو سعر السياق الطويل، والثاني هو موقف ماسك نفسه من 4.7. لنبدأ بالأسعار. الجدول الإجمالي للمنصة وواجهة الأسعار لا يتطابقان تمامًا في التسجيل الخاص بما يزيد على 200 ألف token:
| بند السعر | الجدول الإجمالي لطرازات المنصة | واجهة الأسعار billing_expr |
|---|---|---|
| إدخال / إخراج / قراءة من الذاكرة المؤقتة عند ≤ 200 ألف token | مذكور | مذكور، ومطابق للجدول الإجمالي |
| إدخال يزيد على 200 ألف | مذكور | مذكور، ومطابق للجدول الإجمالي |
| إخراج يزيد على 200 ألف | غير مذكور بشكل منفصل | مذكور |
| قراءة من الذاكرة المؤقتة فوق 200 ألف | غير مذكور بشكل منفصل | مذكور |
الأرقام التفصيلية كما يلي، وتاريخ بيانات الأسعار هو 2026-11-13، والوحدات جميعًا لكل 1M tokens:
- الفئة المنخفضة (0–200,000 tokens): الإدخال
$2، الإخراج$6، قراءة الذاكرة المؤقتة$0.5، والجدول الإجمالي وتعبير الأسعار متطابقان - إدخال الفئة المرتفعة (200,001–500,000 tokens):
$4، والجدول الإجمالي وتعبير الأسعار متطابقان - إخراج الفئة المرتفعة: تعبير الأسعار هو
$12، والشرائح في الجدول الإجمالي غير مذكورة - قراءة الذاكرة المؤقتة للفئة المرتفعة: تعبير الأسعار هو
$1، والشرائح في الجدول الإجمالي غير مذكورة
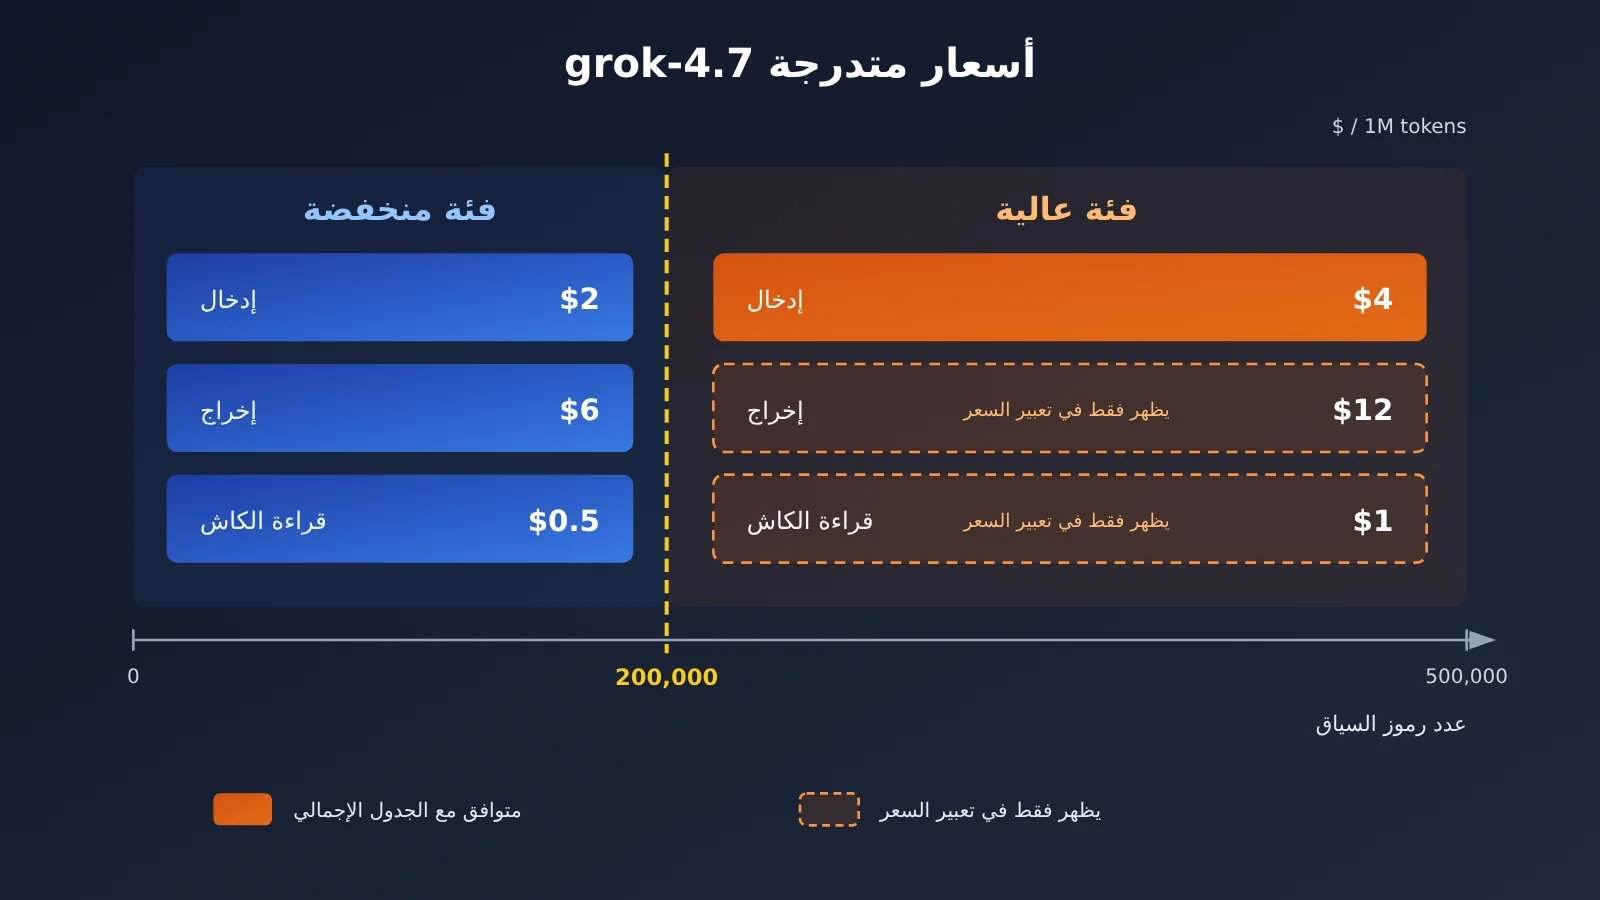
معلومات الأسعار في الشكل أعلاه مصدرها واجهة الأسعار والجدول الإجمالي للطرازات في APIYI apiyi.com، بتاريخ تحقق 2026-11-13، والمرجع هو قائمة الطرازات على المنصة.
لننتقل الآن إلى التصريحات. في 2026-11-10 الساعة 17:35، قال ماسك على X إن Grok 4.8 “will bear no resemblance to 4.7 (thankfully). It is not yet incredible”. وفي الساعة 18:22 من اليوم نفسه قال في ردّه أيضًا “Not as good. Opus 5.5 is a masterpiece.”، أي إن 4.8 ليس أفضل من Opus 5.5. وفي الوقت نفسه يتوقع أن يتمكن Grok 5 من تجاوز Opus 5.5 خلال شهرين أو ثلاثة.
هذه مواقف، وليست درجات Grok 4.8. عندما يقول أحد المؤسسين إن النسخة الجديدة “لا تشبه 4.7، وهذا جيد”، فهذا يعني فقط أنه لا يعترف بأساس 4.7، ولا يمكن استنتاج أن 4.8 قد تحسّن في النقاط الضعيفة الثلاث أعلاه.
هل يستطيع Grok 4.8 سد نقاط الضعف الثلاث هذه؟
لا يمكن الاعتماد إلا على ما ورد في منشور ماسك الأصلي. ذكر فيه أنه تخلّى عن JAX/SGLang وأعاد كتابة مكدس التعلم المعزز (RL) والاستدلال من الصفر باستخدام C/C++، وأن التدريب المسبق اكتمل، وأن بيانات SFT خضعت لتنظيف مكثف، وأن 4.8 ما زال في مرحلة RL حاليًا، وأن «التقييمات بدأت تتحسن». لم يذكر المنشور أي أسماء لوحات صدارة أو درجات، ولا عدد المعاملات.
وبمقارنة هذه المعلومات بنقاط الضعف الثلاث، يبقى الاستنتاج حذرًا:
- إفراط في إنتاج tokens: قد تؤثر مرحلة RL فعلًا في طول المخرجات، لكنه لم يذكر كفاءة استخدام tokens.
- تأخر المهام الطويلة عن Fable: لم يُذكر Terminal-Bench أو CursorBench، ولا توجد أي بيانات عن المهام الطويلة.
- سعر أكثر من 200 ألف token: لا توجد أي معلومات عن السعر، ولم تُدرج 4.8 في أي قائمة أسعار.
لذا يبقى التخمين عند حد «إعادة كتابة RL ومكدس الاستدلال، وتنظيف بيانات SFT». لا توجد حاليًا أدلة تثبت أن نقاط الضعف الثلاث السابقة قد عُوّضت. وعندما تتوفر لـ 4.8 بطاقة نموذج ولوحات صدارة من طرف ثالث، ستكون المقارنة بندًا ببندًا ذات معنى.
كيف نوزع فئات تسعير grok-4.7 الآن مع 200 ألف token
قبل إطلاق 4.8، الطريقة العملية هي ضبط تكلفة grok-4.7 جيدًا. النقطة الحساسة هنا هي خط الـ 200 ألف token: بمجرد تجاوز المدخلات هذا الخط، يتضاعف سعر الوحدة مباشرة، ويتضاعف كذلك الإخراج وقراءة الذاكرة المؤقتة وفق تعبير التسعير. فيما يلي معلومات الوصول القابلة للتطبيق الفعلي وتوصيات توزيع الفئات:
- معرّف النموذج:
grok-4.7، ونقطة النهاية هي chat، والمجموعات تشملCodexResponsesوDefaultوSVIP - عنوان الواجهة: تنسيق متوافق مع OpenAI، ضع base_url على
https://api.apiyi.com/v1، واضبط model علىgrok-4.7فقط - ضبط الفئة المنخفضة: حاول إبقاء سياق الطلب الواحد داخل
200,000tokens، ويمكنك استخدام الملخصات أو شرائح الاسترجاع بدلًا من حشو المستند كاملًا - ميزانية الفئة العالية: إذا احتجت فعلًا إلى سياق طويل، قدّر المدخلات بـ
$4والإخراج بـ$12وقراءة الذاكرة المؤقتة بـ$1، وانتبه إلى عدم الاتساق في الجدول الإجمالي حيث لم يُذكر إخراج الفئة العالية - طول الإخراج: بالاستناد إلى النقطة الضعف الأولى، اضبط max_tokens للمهام التي تحتاج إليها، لتجنب انفلات الإخراج في مستويات الاستدلال العالية
الطرازات والأسعار تُعتمد حسب قائمة الطرازات في المنصة، ويمكنك الاطلاع على أحدث المعلومات في docs.apiyi.com/models. كما ذكرت المدونة الرسمية أن Grok 4.7 له نسخة fast، بسرعة إخراج تبلغ نحو الضعف وسعر يقارب الضعف، لكن الجدول الإجمالي للمنصة لا يحتوي على معرّف نموذج fast منفصل، لذلك لا تكتبه من عندك عند الاستدعاء.
🚀 البدء السريع: بعد إطلاق grok-4.8، ستطرح APIYI apiyi.com هذا النموذج في أقرب وقت. وقبل ذلك، شغّل خط الأساس لـ grok-4.7 بنفس مفتاح API، وعندما يصبح 4.8 متاحًا يكفي تغيير معامل model واحد للمقارنة.
توصيات الاستخدام حسب السيناريو: Grok 4.8 مقابل Grok 4.7
سيناريوهات يُفضّل فيها الاستمرار على Grok 4.7
- المهام المتخصصة في القانون والهندسة: في الجدول الرسمي، يحتل Grok 4.7 المرتبة الأولى في كل من EEBench وHarvey Legal Agent، فلا يوجد سبب للانتظار في هذا النوع من المهام.
- الأعمال التي يمكن ضبط سياقها في حدود 200 ألف: يمكن البقاء بثبات في الفئة السعرية المنخفضة، وسعر الوحدة مطابق لسعر 4.6.
- المشاريع التي تحتاج إلى إطلاق فوري: grok-4.7 هو النسخة الوحيدة القابلة للاستدعاء حاليًا.
سيناريوهات يستحق فيها مراقبة Grok 4.8 باستمرار
- الوكلاء الذين يعملون لعدة ساعات / المهام الطويلة في الطرفية: الفرق في Terminal-Bench 4.0 وFable 5.1 واضح، ويمكن في الوقت نفسه تقييم نماذج أخرى كخيارات بديلة.
- المهام الدفعية الحساسة لتكلفة رموز الإخراج (output tokens): تشير لوحات التصنيف من طرف ثالث إلى أن إخراج 4.7 يميل إلى الإطالة، وإذا تحسّن هذا الجانب في 4.8 فسيؤدي ذلك إلى خفض التكلفة مباشرة، لكن لا توجد أدلة على ذلك حاليًا.
- التطبيقات التي تعتمد كثيرًا على سياق يتجاوز 200 ألف: سعر الفئة العالية يتضاعف، ويستحق الأمر متابعة طريقة التسعير بعد إطلاق 4.8.
توصيات قرار Grok 4.8 مقابل Grok 4.7
| مجال التركيز | الإجراء الحالي | متى تُعيد التقييم |
|---|---|---|
| استقرار الإطلاق | استخدم grok-4.7 | عندما يظهر 4.8 في قائمة النماذج على المنصة |
| تكلفة المهمة الواحدة | تحكم في السياق وطول الإخراج | عندما تتوفر بيانات استخدام token من طرف ثالث عن 4.8 |
| قدرة المهام الطويلة | قيّم نماذج بديلة بالتوازي | عندما تُنشر درجات مثل Terminal-Bench لـ 4.8 |
| شفافية الأسعار | ضع الميزانية بناءً على واجهة قائمة الأسعار | عندما تُكمل جداول المنصة سعر الإخراج للفئة العالية |
💡 توصية الاختيار: يعتمد اختيار الإصدار على ما إذا كانت مهمتك من المهام الطويلة، وما إذا كنت تتجاوز 200 ألف token بشكل متكرر. ننصح بتشغيل عيناتك الخاصة عبر نفس مجموعة الواجهات باستخدام APIYI apiyi.com، ثم تقرر ما إذا كنت ستحوّل المهام الطويلة إلى نموذج آخر.
الأسئلة الشائعة FAQ
س1: هل يمكن استدعاء Grok 4.8 عبر API الآن؟
لا. حتى تاريخ 2026-11-13، لا يملك Grok 4.8 معرّف نموذج، وجدول النماذج الكامل للمنصة وواجهة قائمة الأسعار يحتويان فقط على grok-4.7. الإطلاق الناعم الذي قال ماسك إنه سيكون هذا الأسبوع مخصص فقط لمستخدمي Grok Bot.
س2: من الأقوى حقًا عند مقارنة Grok 4.8 بـ Grok 4.7؟
لا يمكن الحكم حاليًا. لا توجد أي لوحات تصنيف أو درجات منشورة لـ Grok 4.8، وقال ماسك فقط إن «التقييمات في تحسن» و«لا يزال غير مبهر» و«أقل من Opus 5.5». هذه مواقف، وليست بيانات قابلة للمقارنة.
س3: من أين جاء القول بأن Grok 4.7 يُخرج رموزًا أكثر؟
جاء من تقييم طرف ثالث من Artificial Analysis بتاريخ 2026-09-21، بإعداد اختبار xhigh. نحو 81 ألف رمز إخراج لكل مهمة، مقابل 36 ألفًا لـ 4.6 high و38 ألفًا لـ 4.6 xhigh. هذه ليست بيانات رسمية.
س4: هل أصبح Grok 4.7 أسوأ بشكل شامل من Grok 4.6؟
لا. في الجدول الرسمي يتفوق Grok 4.7 على 4.6 في عدة بنود مثل Terminal-Bench وCursorBench وEEBench. وتُظهر لوحات التصنيف من طرف ثالث أن AA-LCR أقل بـ 3.7 نقطة وAutomationBench-AA أقل بـ 1.1 نقطة، أي انخفاض في بنود معدودة.
س5: كيف يمكن استدعاء grok-4.7 الآن؟
سجّل في APIYI عبر apiyi.com واحصل على مفتاح API، فالمستخدمون الجدد لديهم حصة اختبار مجانية. استخدم SDK متوافقًا مع OpenAI، واضبط base_url على عنوان واجهة المنصة، وmodel على grok-4.7.
س6: كيف تُحتسب تكلفة الإخراج الذي يتجاوز 200 ألف token بالضبط؟
صيغة التسعير تنص على الإخراج بـ $12 وقراءة التخزين المؤقت بـ $1؛ أما شرائح الجدول الكامل فلم تذكر سوى المدخلات من الفئة العالية بـ $4، دون كتابة الإخراج من الفئة العالية بشكل منفصل. السجلان غير متطابقين تمامًا، لذا يُنصح عند وضع الميزانية بالتقدير المتحفظ وفق صيغة التسعير، واتخاذ قائمة نماذج المنصة كمرجع.
س7: كيف يتم الانتقال بعد إدراج Grok 4.8؟
لا يوجد بعد سجل لإدراج Grok 4.8 في التحديثات الفورية للمنصة. بعد الإدراج عادةً يكفي استبدال معامل model، ويُنصح أولًا بمقارنة رموز الإخراج ومعدل نجاح المهام الطويلة والتكلفة حسب الفئة باستخدام نفس مجموعة العينات، ثم نقل الترافيك.
أبرز نقاط المقارنة بين Grok 4.8 وGrok 4.7 Key Takeaways
- خيار اليوم: إن أردت استدعاء الواجهة فاستخدم grok-4.7، أما Grok 4.8 فلا يوجد له معرّف نموذج بعد.
- نقطة الضعف الأولى (لوحات التقييم الخارجية): عند إعداد xhigh يبلغ الناتج نحو 81 ألف token لكل مهمة، وهو أطول من اللازم.
- نقطة الضعف الثانية (إقرار رسمي): لا يزال Terminal-Bench وCursorBench متأخرين عن Fable 5.1.
- ليس متأخرًا في كل شيء: Grok 4.7 يحتل المرتبة الأولى في EEBench وHarvey.
- نقطة الضعف الثالثة (الأسعار + التصريح الحرفي): المدخلات التي تتجاوز 200 ألف token يتضاعف سعرها، وإيلون ماسك لا يعترف بأن 4.7 هو الأساس.
- التغييرات المعروفة في 4.8: إعادة كتابة RL ومكدّس الاستدلال، وتنظيف SFT، دون أي دليل على معالجة نقاط الضعف الثلاث.
- طريقة البدء: شغّل خط أساس grok-4.7 عبر APIYI apiyi.com أولاً، ثم قارن مباشرةً بعد إتاحة 4.8.
الخلاصة
النقاط الأساسية في مقارنة Grok 4.8 بـ Grok 4.7:
- التوفّر: حتى 2026-11-13، لا يمكن استدعاء سوى grok-4.7؛ فالإطلاق التجريبي للبوت لا يعني فتح الـ API.
- ثلاث نقاط ضعف، لكل منها مصدر مختلف: زيادة رموز الناتج (لوحة تقييم خارجية)، والتأخر في المهام الطويلة عن Fable (إقرار رسمي)، وارتفاع سعر السياق الطويل مع تصريح المؤسس (الأسعار والتصريح).
- أدلة 4.8: لا يوجد حاليًا سوى الحديث عن إعادة كتابة RL ومكدّس الاستدلال وتنظيف SFT، دون درجات أو أسعار أو بطاقة نموذج.
بدلًا من التوقف والانتظار، الأفضل أن تضبط أولاً تقسيم السياق وطول الناتج في grok-4.7، ثم تقارن بندًا بندًا حين تتوفر بيانات قابلة للتحقق عن 4.8. نوصي باستخدام APIYI apiyi.com وواجهته الموحّدة للتحقق أولاً من أداء grok-4.7 في أعمالك، بما يترك لك خط أساس جاهزًا للتبديل لاحقًا.
📚 المراجع
- مدونة xAI الرسمية – إصدار Grok 4.7: جدول مقارنة المعايير والتسعير المعلنان رسميًا من الشركة
- الرابط:
x.ai/news/grok-4-7 -
الوصف: مصدر بيانات Terminal-Bench 4.0 وCursorBench 4.0 وEEBench وغيرها
-
Artificial Analysis – تقييم Grok 4.7: لوحة تصنيف من طرف ثالث، وتشمل استهلاك رموز الإخراج
- الرابط:
artificialanalysis.ai/articles/benchmarking-grok-4-7 -
الوصف: مؤشر الذكاء، ومقارنة رموز الإخراج، والتغيرات في AA-LCR وغيرها
-
منشور ماسك على X (2026-11-10): نص تصريحه عن تقدم Grok 4.8
- الرابط:
x.com/elonmusk/status/2120088070443655190 -
الوصف: إعادة كتابة RL ومكدس الاستدلال، وتنظيف SFT، والإطلاق التجريبي لـ Bot
-
رد ماسك على X (2026-11-10): تصريحه حول مقارنة 4.8 بـ Opus 5.5
- الرابط:
x.com/elonmusk/status/2120099798078656909 -
الوصف: مصدر عبارة “Not as good”
-
جدول نماذج APIYI: نماذج grok-4.7 والمجموعات والتسعير المتدرج
- الرابط:
docs.apiyi.com/models - الوصف: النماذج والأسعار وفق هذا الجدول، بتاريخ التحقق 2026-11-13
المؤلف: فريق APIYI التقني
للتواصل التقني: مرحبًا بكم للتواصل معنا عبر الصفحة الرئيسية لموقع APIYI، ولمزيد من المواد يمكن زيارة مركز توثيق docs.apiyi.com