Anmerkung des Autors: GPT-6.2 Sol übernimmt den Standard-Token-Preis der Vorgängerversion und erzielt in mehreren öffentlichen Tests bessere Ergebnisse bzw. senkt die Kosten pro Aufgabe. Vor einem Upgrade bestehender Systeme müssen Fragen zur Codebasis, komplexe Analysen und Mehrrunden-Sitzungen jedoch weiterhin separat geprüft werden.
Kurz gesagt: Der Standard-Preis pro Token bei kurzem Kontext ist bei GPT-6.2 Sol exakt derselbe wie bei GPT-6.1 Sol; in umfassenden Benchmarks erzielt es höhere Werte und niedrigere Kosten pro Aufgabe – bei Fragen zur Codebasis und einigen schwierigen Aufgaben verliert es jedoch klar Punkte. Beide kosten pro Million Token für normale Eingabe, Cache-Lesen und Ausgabe 2 US-Dollar, 0,10 US-Dollar und 10 US-Dollar. Der Gesamtwert von Artificial Analysis in der Max-Kategorie stieg von 55 auf 57, die durchschnittlichen Kosten pro Aufgabe sanken von 1,27 US-Dollar auf 1,01 US-Dollar. Im Code-Agent-Test derselben Organisation fiel die Unterkategorie Fragen zur Codebasis jedoch von 60 auf 46, und auch der Plotly-Datenanalyse-Test sank von der vollen Punktzahl 43/43 auf 40/43.
Deshalb eignet sich dieses Upgrade für eine schrittweise Einführung nach Aufgabentyp; ein kompletter direkter Austausch ist nicht empfehlenswert. Verifizierbare Codeänderungen, Terminal-Arbeiten und Routineanalysen können zuerst testweise laufen. Fragen zur Codebasis, schwierige Aufgaben mit verborgenen Mustern und von Flex abhängige Batch-Verarbeitung benötigen vorher zusätzliche Regressionstests. Außerdem gibt es bei der Responses API von GPT-6.2 Verhaltensänderungen bei Mehrrunden-Sitzungen und der Position von Anweisungen; ältere Multi-Turn-Anwendungen dürfen daher nicht nur die Modell-ID ändern.
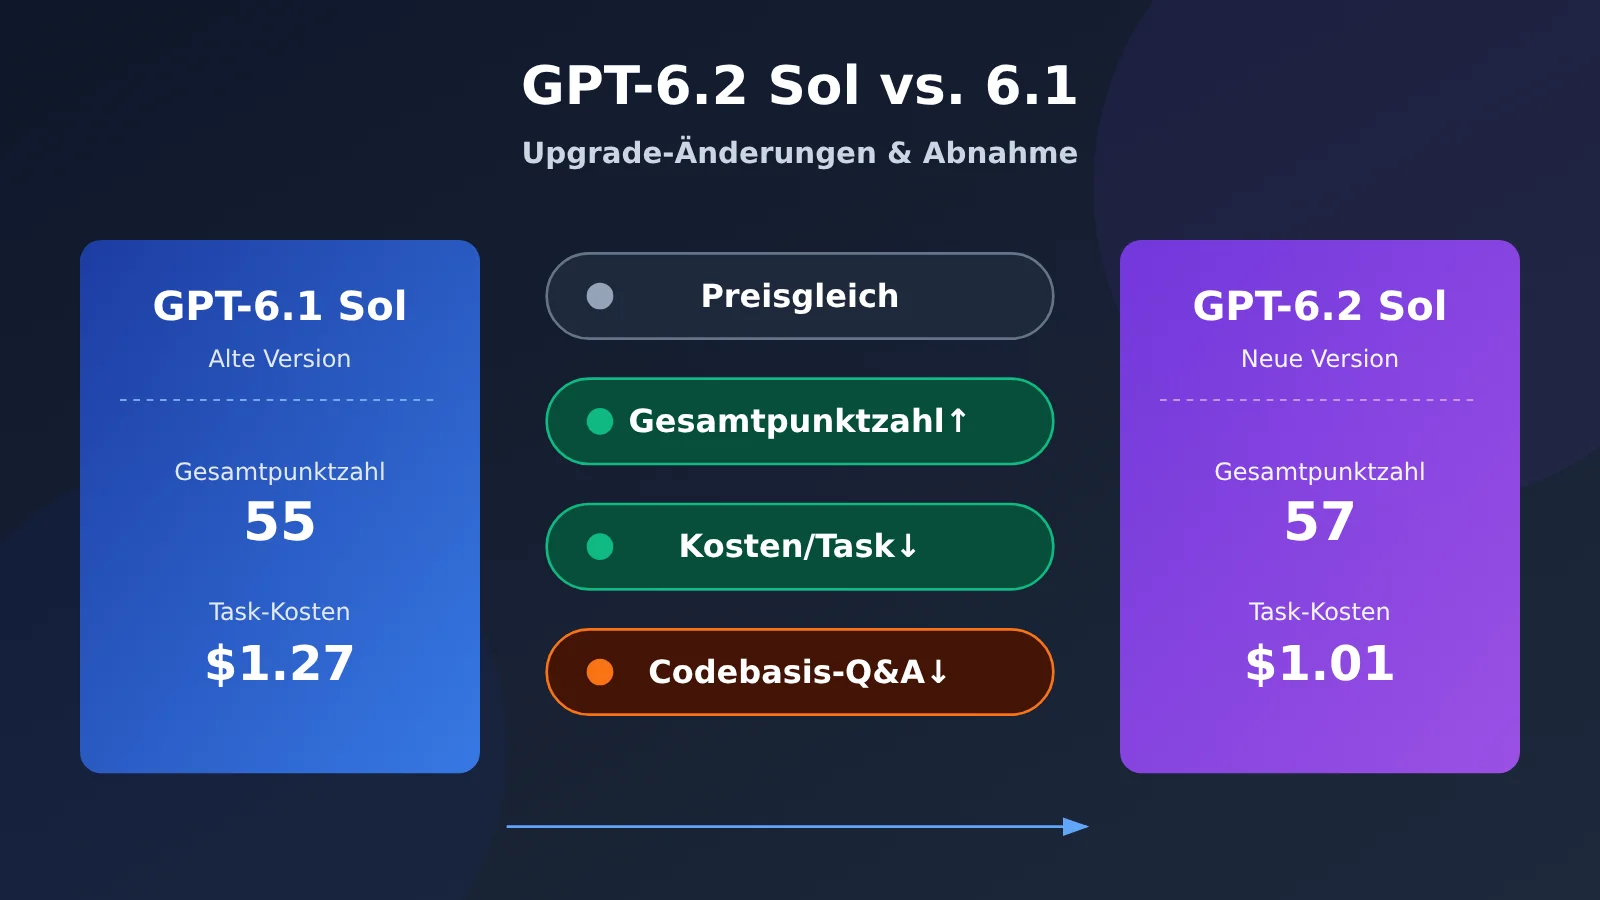
GPT-6.2 Sol vs. GPT-6.1 Sol: Schnellüberblick
Die folgende Tabelle listet nur die Dimensionen auf, die für eine Upgrade-Entscheidung relevant sind. Spezifikationen und Preise stammen aus den offiziellen Modellkarten, der Preisseite und dem Änderungsprotokoll von OpenAI; alle Preise sind in USD pro Million Token angegeben.
| Vergleichsdimension | GPT-6.1 Sol | GPT-6.2 Sol | Was die Unterschiede bedeuten |
|---|---|---|---|
| Modell-ID / Veröffentlichungsdatum | gpt-6.1-sol / 2026-09-29 |
gpt-6.2-sol / 2026-11-17 |
Das neue Modell ist gerade erst erschienen und sollte eine Zeit lang beobachtet werden |
| Kontext / maximale Ausgabe | 1.050.000 / 128.000 | 1.050.000 / 128.000 | Kapazität unverändert |
| Maximale Eingabe | In der Modellkarte nicht separat ausgewiesen | 922.000 | Bei Aufgaben mit sehr langen Eingaben muss das neue Limit geprüft werden |
| Wissens-Cutoff | 2026-04-30 | 2026-06-01 | Etwa einen Monat später |
| Standardpreis bei kurzem Kontext | Eingabe $2 / Cache-Lesen $0.10 / Ausgabe $10 | identisch | Bei gleicher Token-Kombination bleibt die Rechnung gleich |
| Flex-Verarbeitung | Unterstützt | Nicht unterstützt | Nutzer der bisherigen Flex-Verarbeitung müssen auf eine andere Verarbeitungsart umsteigen |
| Rabattfenster für Hintergrundverarbeitung | In den vorliegenden Materialien nicht behandelt | 2-Stunden-Fenster −30 %, 8-Stunden-Fenster −40 % | Für Aufgaben, bei denen Verzögerungen akzeptabel sind, gibt es eine neue Sparoption |
| Gesamtwertung (AA, Max-Stufe) | 55 | 57 | Insgesamt etwas stärker |
| Fragen zur Codebasis (AA, Codex + Max) | 60 | 46 | Deutlicher Rückschritt; das erfordert eine gesonderte Prüfung |
🚀 Schnellvergleich: Beide Modellgenerationen lassen sich über dieselbe Schnittstelle umschalten und vergleichen. Die öffentliche Modellübersicht von APIYI apiyi.com enthält bereits
gpt-6.2-solund weist sowohl den responses- als auch den chat-Zugang aus. Damit lassen sich mit demselben Key Regressionsvergleiche zwischen alter und neuer Version durchführen.
Empfohlene Reihenfolge beim Lesen: In Abschnitt 1 des Haupttexts geht es zuerst um Preise und Verarbeitungsoptionen, weil sie die Abrechnungslogik bestimmen. Abschnitt 2 vergleicht Verbesserungen und Punkteverluste in öffentlichen Tests und hilft einzuschätzen, für welche Aufgaben sich ein Upgrade lohnt. Abschnitt 3 prüft Änderungen am API-Verhalten und beantwortet, ob bestehende Dienste reibungslos umstellen können. Abschnitt 4 enthält einen Abnahmeplan nach Aufgabentyp. Wenn Sie sich nur für Programmieragenten interessieren, können Sie direkt zu 2.2 und Abschnitt 4 springen.
Begriffe, die Sie vor dem Vergleich mit GPT-6.2 Sol kennen sollten
| Begriff | Kurze Erklärung |
|---|---|
| Standard-Token-Preis | Die öffentliche Preisgestaltung von OpenAI in der Standard-Stufe für jede Million Eingabe-, Ausgabe- und verschiedene Cache-Nutzungsmengen |
| Aufgabenkosten | Modell- und Toolkosten für die Erledigung einer Aufgabe; bei der fachlichen Abnahme können zusätzlich Wiederholungsläufe und manuelle Prüfung eingerechnet werden |
| Inferenzstufe | Einstellung zur Steuerung des Inferenzbudgets des Modells; übliche Werte sind Low, Medium, High, Xhigh und Max. Bei Vergleichstests sollten die Stufen übereinstimmen |
| GDPval v2 | Eine interne Bewertung von OpenAI für komplexe Wissensarbeit, bei der lange Arbeitsabläufe aus realen Projekttypen im Mittelpunkt stehen |
| Coding Agent Index | Ein von Artificial Analysis aus Unterpunkten wie Codeänderungen, Terminalbedienung und Fragen zur Codebasis abgeleiteter Gesamtindikator für Agenten |
| SWE-Atlas-QnA-AA | Der Unterpunkt „Fragen zur Codebasis“ im genannten Indikator; geprüft wird, ob die für eine Antwort nötigen Fakten vollständig vorliegen |
| Sitzungspräfix / Cache-Lesen | Inhalte, die am Anfang von Anfragen über mehrere Runden in gleichbleibender Reihenfolge stehen; erkennt der Dienst ein wiederverwendbares Präfix, wird der Trefferanteil zum Lesetarif abgerechnet |
1. GPT-6.2 Sol im Vergleich zu GPT-6.1 Sol: Grundlegende Spezifikationen und Preise
1.1 Die Spezifikationen von GPT-6.2 Sol führen die Vorgängergeneration weitgehend fort
Beide Modellgenerationen lassen sich über Responses und Chat Completions aufrufen; Funktionsaufrufe und integrierte Tools laufen über den Responses-Pfad. Beide akzeptieren Text- und Bildeingaben, geben nativ Text aus, haben ein identisches Kontextfenster von 1.050.000 Token und eine identische maximale Ausgabe von 128.000 Token. Die Modellkarte von 6.2 Sol weist separat eine maximale Eingabe von 922.000 Token aus.
Bei der Positionierung gibt es feine Unterschiede. Die Modellseite von 6.1 Sol betont, komplexe Codearbeiten, Computerbedienung und professionelle Aufgaben zu geringeren Kosten als Astra zu erledigen; die Modellseite von 6.2 Sol legt den Schwerpunkt eher auf alltägliche Codearbeit und skalierte Agentenarbeit. Das heißt, 6.2 Sol ist deutlicher auf häufige Batch-Szenarien ausgerichtet.
1.2 Der Standard-Preis von GPT-6.2 Sol entspricht dem der Vorgängergeneration
Die offizielle Standard-Abrechnung sieht wie folgt aus. Beide Generationen ziehen die Grenze bei 272K Token Eingabe pro Anfrage: Wird sie überschritten, werden Eingabe- und Cache-Sätze für die gesamte Anfrage doppelt berechnet, die Ausgabe mit dem 1,5-fachen.
| Standard-Abrechnungskategorie | Kurzer Kontext (≤272K) | Langer Kontext (>272K) |
|---|---|---|
| Normale Eingabe | $2.00 | $4.00 |
| Cache-Lesen | $0.10 | $0.20 |
| Cache-Schreiben (30 Minuten) | $2.50 | $5.00 |
| Cache-Schreiben (12 Stunden) | $5.00 | $10.00 |
| Ausgabe (inkl. Reasoning-Token) | $10.00 | $15.00 |
Identische Stückpreise bedeuten nicht automatisch identische Rechnungen. Bei derselben Aufgabe können sich Ausgabe-Token, Anzahl der Tool-Aufrufe und Cache-Treffer von 6.2 Sol ändern; die tatsächlichen Kosten müssen daher pro Aufgabe berechnet werden. Cache-Schreibvorgänge sind jeweils mit dem vollständigen Satz zu berechnen; der normale Eingabepreis für dieselben Token wird nicht zusätzlich aufgeschlagen. Die gesamte Ausgabemenge lässt sich in Responses aus usage.output_tokens ablesen; der Reasoning-Verbrauch ist normalerweise im Unterfeld output_tokens_details.reasoning_tokens aufgeführt.
Zu Aufrufen aus China: Stand 2026-11-20 stimmen in der öffentlichen Preis-Schnittstelle von APIYI apiyi.com die Preise für gpt-6.2-sol in der kurzen Kontextstufe mit den offiziellen Preisen überein; in der langen Kontextstufe liegen normale Eingabe, Cache-Lesen, Cache-Schreiben und Ausgabe bei $3, $0.15, $3.75 bzw. $11.25. Dabei handelt es sich um öffentlich gelistete Preisformeln; die tatsächliche Abrechnung richtet sich nach der Kontogruppe und der aktuellen Konfiguration der Plattform.
1.3 Die Wahl zwischen Flex und Hintergrund-Rabattfenstern
Änderungen bei den Verarbeitungsoptionen werden am leichtesten übersehen. 6.1 Sol steht weiterhin auf der Liste der Modelle, die Flex unterstützen; 6.2 Sol unterstützt Flex nicht. Als Alternative kann 6.2 Sol das Hintergrund-Rabattfenster von Responses nutzen: Bei berechtigten Anfragen liegen die Modell-Token-Sätze im 2-Stunden-Fenster um 30 % unter dem Standard-Satz und im 8-Stunden-Fenster um 40 %.
Wenn ein Altsystem für die Offline-Batchverarbeitung auf Flex angewiesen ist, muss bei der Migration anhand der Lieferfristen und Zugriffsbedingungen neu entschieden werden. Aufgaben, bei denen eine Lieferung innerhalb weniger Stunden akzeptabel ist, können das Hintergrundfenster in Betracht ziehen; Aufgaben, die eine sofortige Rückgabe erfordern, können nur nach Standard abgerechnet werden.
2. GPT-6.2 Sol im Vergleich zu GPT-6.1 Sol: Fortschritte und Rückschritte in öffentlichen Tests
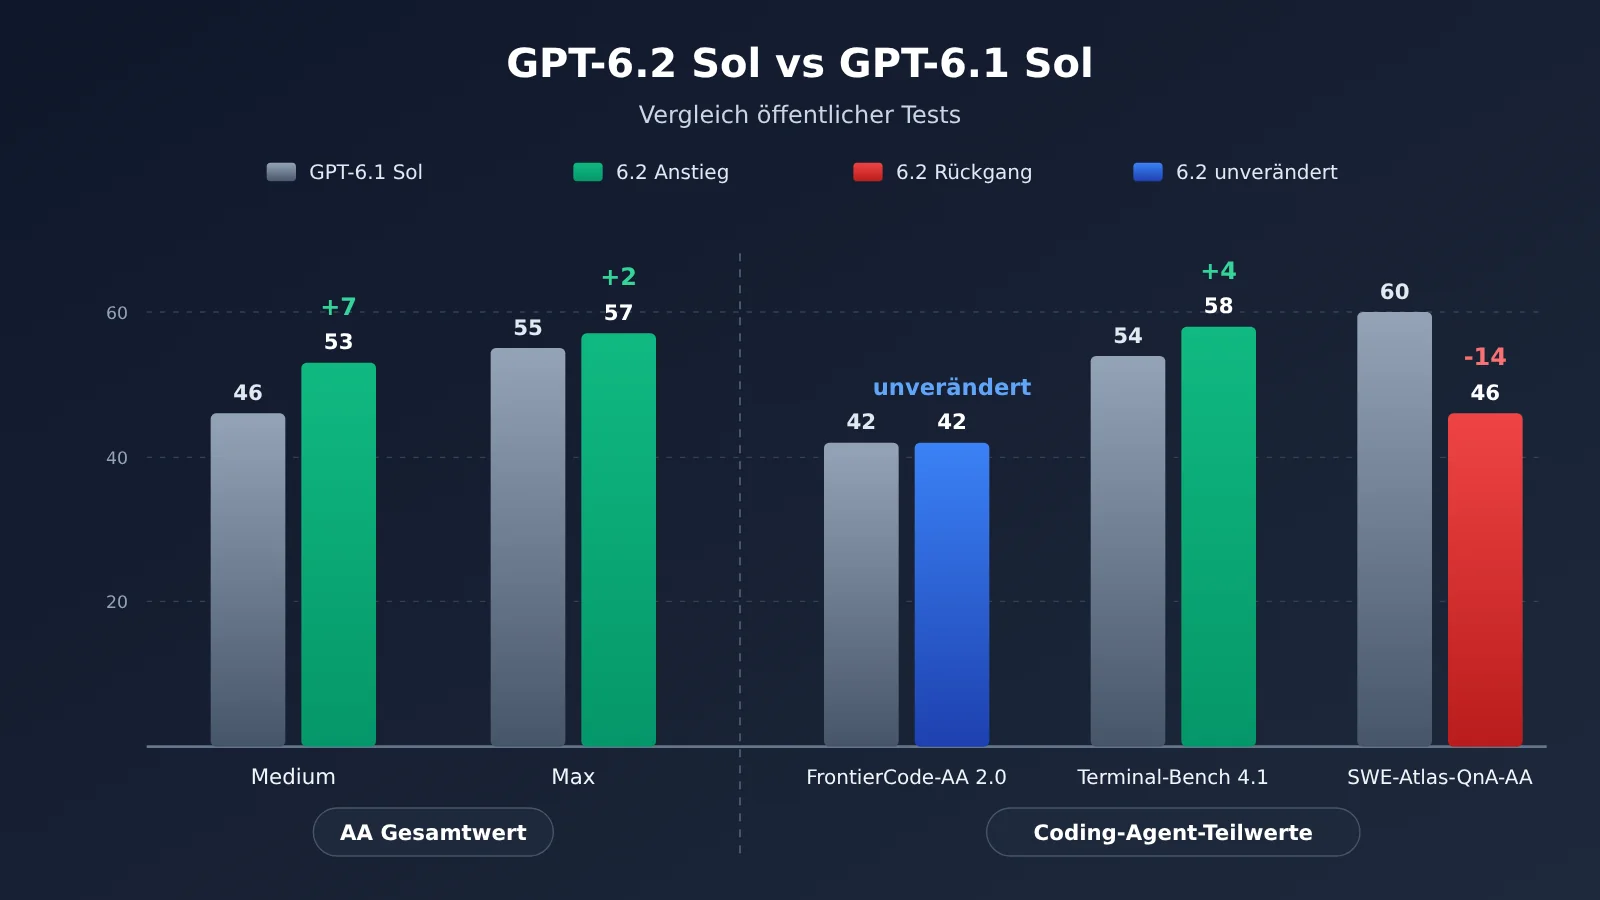
Das obige Diagramm fasst öffentliche Daten Dritter zusammen: Grün steht für Verbesserungen von 6.2 Sol, Rot für Rückgänge. Diese Zahlen stammen von unterschiedlichen Organisationen und Testframeworks und lassen sich nur innerhalb ihrer jeweiligen Bedingungen vergleichen. Wenn Sie sie mit Ihren eigenen Aufgaben reproduzieren möchten, können Sie über APIYI apiyi.com beide Modellgenerationen über denselben Kanal und dieselbe Stufe aufrufen.
2.1 Wissensarbeit und allgemeine Fähigkeiten: GPT-6.2 Sol legt stetig zu
Offizielle Angaben: OpenAI gibt in der Ankündigung vom 17. November 2026 an, dass 6.2 Sol bei der internen Evaluierung GDPval v2 um 5,3 Prozentpunkte besser als 6.1 Sol abschneidet. GDPval v2 prüft mehrstufige Wissensarbeit in Bereichen wie Beratung, Finanzen und Design; diese Aussage gilt nur für die von OpenAI veröffentlichten internen Tests. In der Ankündigung steht außerdem „22 % weniger Ausgabe-Token“, wobei sich der Vergleich auf GPT-6.2 Astra und GPT-6 Astra bezieht und nicht auf die beiden Sol-Generationen übertragen werden darf.
Messungen Dritter: Der Gesamtwert von Artificial Analysis deckt Wissensarbeit, Programmierung, Wissenschaft und Allgemeinwissen ab. Von 6.1 Sol auf 6.2 Sol steigt die Medium-Stufe von 46 auf 53, die Max-Stufe von 55 auf 57. Die durchschnittlichen Kosten pro Aufgabe in der Max-Stufe sinken von $1.27 auf $1.01, was auf Basis der veröffentlichten gerundeten Werte einer Reduktion von etwa 20 % entspricht.
Beide Datensätze zeigen in dieselbe Richtung: 6.2 Sol ist bei allgemeinen Aufgaben stärker und spart pro Aufgabe mehr. Bemerkenswert ist, dass der Zuwachs in der Medium-Stufe (+7) deutlich größer ausfällt als in der Max-Stufe (+2). Für Teams, die im Alltag die mittlere Inferenzstufe nutzen, dürfte sich dieses Upgrade spürbarer anfühlen.
2.2 Codeänderungen, Terminal und Codebasis-Q&A: GPT-6.2 Sol mit Höhen und Tiefen
Im Coding Agent Index v2.1 von Artificial Analysis wurden beide Modellgenerationen mit dem Codex-Testframework und der Max-Reasoning-Stufe getestet – also unter gleichen Rahmenbedingungen:
| Kennzahl (Codex + Max) | GPT-6.1 Sol | GPT-6.2 Sol | Veränderung |
|---|---|---|---|
| Coding Agent Index – Gesamtwert | 52 | 49 | -3 |
| FrontierCode-AA 2.0 | 42 | 42 | unverändert |
| Terminal-Bench 4.1 | 54 | 58 | +4 |
| SWE-Atlas-QnA-AA (Codebasis-Q&A) | 60 | 46 | -14 |
| Durchschnittliche API-Kosten pro Aufgabe | $1.51 | $1.22 | ca. -19% |
| Durchschnittliche Agentenlaufzeit | 21.9 Minuten | 17.5 Minuten | -4.4 Minuten |
Der Gesamtwert sinkt vor allem deshalb, weil der Unterpunkt Codebasis-Q&A um 14 Punkte fällt und damit den Anstieg des Terminal-Unterpunkts um 4 Punkte aufwiegt, während der Unterpunkt Codeänderungen unverändert bleibt. Die Laufzeitkennzahl schließt den Aufwand für Umgebungsstart, Review und Validierung aus und spiegelt nur die Ausführungszeit des Agenten selbst wider. Außerdem ist FrontierCode-AA 2.0 hier die Version von Artificial Analysis und darf nicht mit gleichnamigen Ranglisten anderer Anbieter vermischt werden.
Der am 17. November 2026 von Plotly veröffentlichte Ein-Runden-Vergleich bei DataAnalyticsBench liefert eine Referenz für eine andere Art unabhängiger Aufgaben. Die Gesamtpunktzahl von 6.1 Sol → 6.2 Sol ging von 43/43 auf 40/43 zurück, die Kosten pro Runde sanken von $2.61 auf $1.22, und die mediane Bearbeitungszeit pro Aufgabe fiel von 17.6 Sekunden auf 10.5 Sekunden. Die Anzahl der Tool-Aufrufe sank von 258 auf 158, die Ausgabemenge etwa von 70,000 Token auf 45,000 Token. Die drei Aufgaben, die 6.2 Sol falsch beantwortete, konzentrierten sich auf Aufgaben zu verborgenen Mustern.
Diese Ergebnisse haben zwei Einschränkungen. Erstens laufen die Tests über die festen Frameworks von OpenRouter und Plotly; die Kosten sind nach dem damaligen Kanal-Preisniveau angegeben. Zweitens wurde jedes Modell nur in einer Runde getestet; bei Wiederholungsläufen mit anderen Modellen beobachtete Plotly Schwankungen von bis zu drei Aufgaben. Es eignet sich daher besser dazu, ein Muster zu illustrieren: 6.2 Sol agiert mit weniger Aktionen, schneller und sparsamer, könnte bei schwierigen Aufgaben, die mehr Tiefe erfordern, aber „zu früh aufgeben“.
3. Wie sich das API-Verhalten von GPT-6.2 Sol auf bestehende Dienste auswirkt
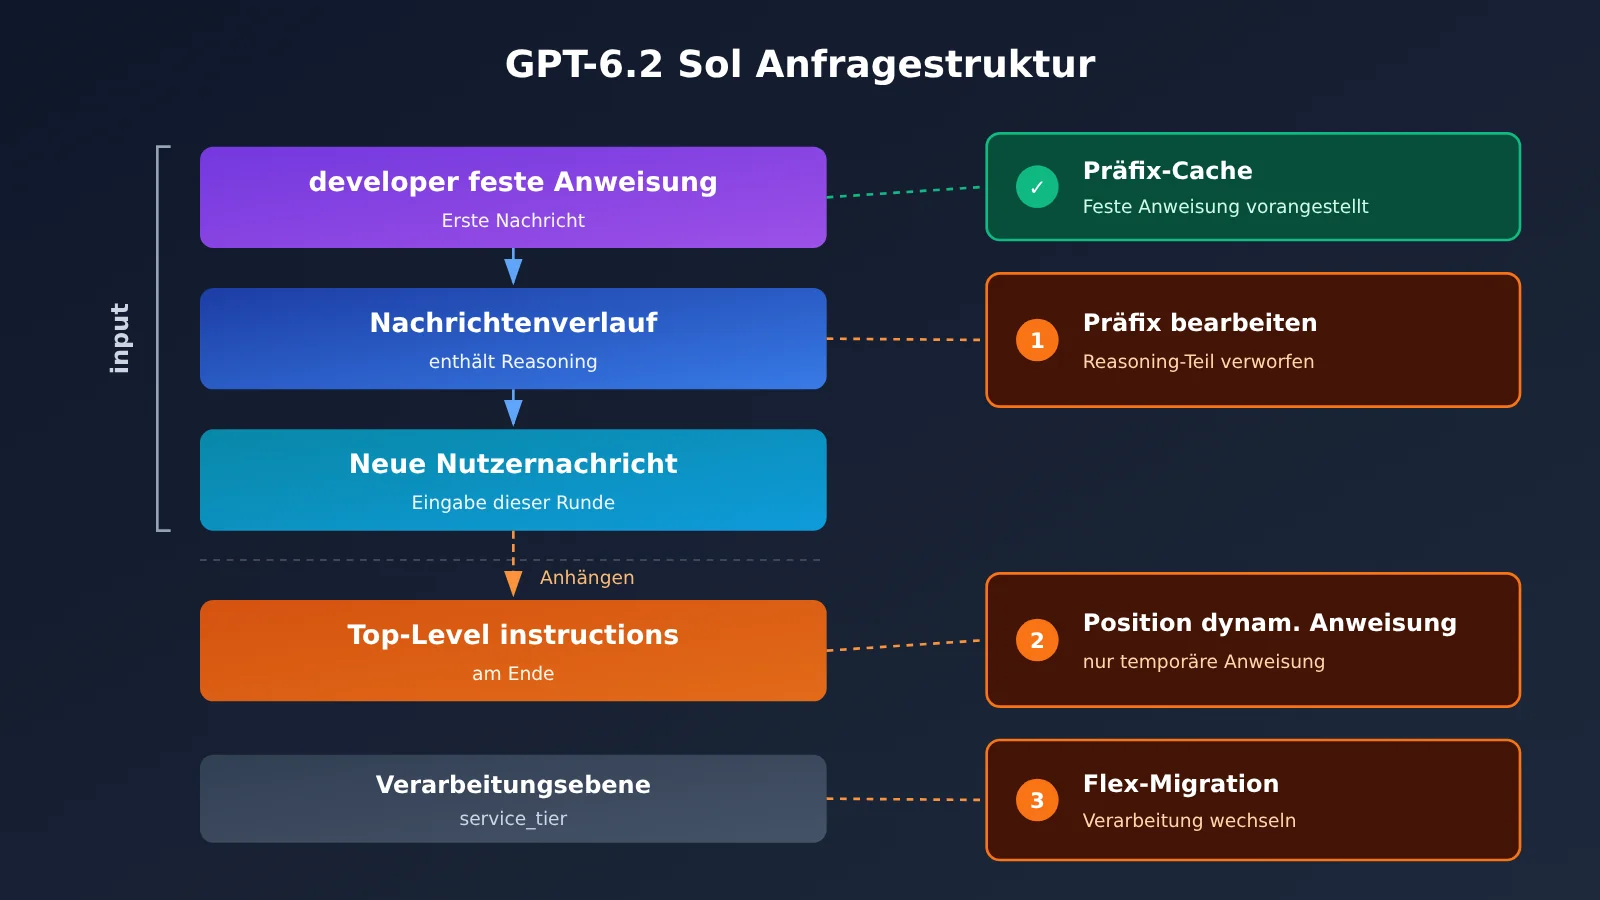
Für mehrrundige Anwendungen, die bereits mit 6.1 Sol laufen, konzentrieren sich die Risiken auf drei Bereiche. Die obige Abbildung zeigt die empfohlene Struktur einer GPT-6.2-Responses-Anfrage; Sie können sie direkt über den responses-Endpunkt von APIYI apiyi.com in genau dieser Struktur verifizieren.
- Umschreiben des Sitzungspräfixes: Die Responses API von GPT-6.2 verwirft frühere Reasoning-Elemente, wenn ein bestehendes Sitzungspräfix bearbeitet wird, bei einigen Modellwechseln sowie beim Wechsel des Endbenutzers oder der Organisation. Wenn Ihr System eine Logik hat, die „Verlauf umschreiben und dann weiterreden“ macht, sollten Sie prüfen, ob die Qualität der Fortsetzung und die Cache-Trefferquote darunter leiden.
- Position der Anweisungen: Die Top-Level-
instructionsvon GPT-6.2 werden aninputangehängt. Feste Anweisungen, die wiederverwendet werden sollen und Cache-Treffer erzielen sollen, gehören in die erstedeveloper-Nachricht innerhalb voninput; temporäre Anweisungen, die sich bei jedem Aufruf ändern, können weiterhin über die Top-Level-instructionslaufen. - Flex-Migration: siehe Abschnitt 1.3 – Anfragen, die ursprünglich über Flex liefen, müssen auf eine andere Verarbeitungsart umgestellt werden.
Außerdem akzeptieren beide Endpunkte keine none-Reasoning-Stufe. Beim Ersetzen der Modell-ID sollten Sie gemäß dem offiziellen Migrationsleitfaden zusätzlich Umschreibe-Verlauf, Sampling-Parameter, Reasoning-Stufe, Verarbeitungsebene und Cache-Daten prüfen.
3.1 Minimalbeispiel für den Aufruf von GPT-6.2 Sol
Im Folgenden ein Minimaltest mit Chat Completions:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche APIYI-Schnittstelle
)

resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "用三句话说明什么是会话前缀缓存"}]
)
print(resp.choices[0].message.content)
Vergleichscode für die alte und neue Version der Responses API anzeigen (feste Anweisungen vorangestellt + Nutzungsprotokollierung)
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Alte und neue Version nutzen denselben Kanal, um einen fairen Vergleich zu gewährleisten
)

STABLE_RULES = "你是代码库助手。回答必须列出涉及的文件路径、调用方和配置开关。"

def run(model: str, question: str, effort: str = "medium"):
    resp = client.responses.create(
        model=model,
        reasoning={"effort": effort},   # Beide Endpunkte akzeptieren none nicht
        input=[
            # Feste Anweisungen als erste developer-Nachricht in input platzieren, das hilft dem Präfix-Caching
            {"role": "developer", "content": STABLE_RULES},
            {"role": "user", "content": question},
        ],
        # Temporäre Anweisungen können in den top-level instructions stehen; sie werden nach input angehängt
        instructions="本轮只回答与鉴权模块相关的部分。",
    )
    usage = resp.usage
    details = getattr(usage, "output_tokens_details", None)
    return {
        "model": model,
        "text": resp.output_text,
        "output_tokens": usage.output_tokens,
        "reasoning_tokens": getattr(details, "reasoning_tokens", None),
    }

for m in ["gpt-6.1-sol", "gpt-6.2-sol"]:
    r = run(m, "登录失败后的重试逻辑在哪里实现?受哪些配置影响?")
    print(r["model"], r["output_tokens"], r["reasoning_tokens"])
    print(r["text"][:300], "\n---")
🎯 Technischer Hinweis: Bei der Migration mehrstufiger Anwendungen empfiehlt es sich, einen Satz echter Anfragen beizubehalten, bei denen „der Präfix unverändert bleibt und nur Nachrichten angehängt werden“, und diese sowohl an die alte als auch an die neue Generation zu senden, um Antworten und den Verbrauch beim Cache-Lesen zu vergleichen. APIYI apiyi.com unterstützt den gleichzeitigen Aufruf beider Modellgenerationen, sodass sich Vergleichstests gut in CI integrieren lassen.
4. Abnahmeprüfung pro Aufgabe vor dem Wechsel zu GPT-6.2 Sol
Der folgende Plan ist ein Testdesign, das sich auf die oben genannten öffentlichen Belege stützt – es handelt sich nicht um eine offizielle Vorgabe. Das Kernprinzip: Außer dem Modell bleiben alle Bedingungen konstant, einschließlich desselben API-Kanals, derselben Inferenzstufe, derselben Eingangsmaterialien, derselben Tool-Liste, derselben Timeout-Einstellungen und derselben Bewertungsregeln. 6.1 Sol bleibt als Kontrollgruppe erhalten.
| Aufgabentyp | Testlauf-Priorität | Hauptbelege | Abnahmebedingung |
|---|---|---|---|
| Codeänderung | Bevorzugt testen | FrontierCode-AA 2.0 gleichauf, Kosten und Dauer sinken | Testdurchlaufrate nicht schlechter als bei der alten Version, Kosten pro qualifizierter Lieferung sinken |
| Terminal-/Computerbedienung | Bevorzugt testen | Terminal-Bench 4.1 +4 | Erfolgsrate sowie End-to-End-Dauer P50, P95 |
| Routineanalyse | Bevorzugt testen | Gesamtwertung steigt, Plotly-Dauer und -Kosten sinken | Abnahmequote im ersten Durchlauf, Anzahl fehlender Punkte |
| Fragen zur Codebasis | Gezielte Abnahme | SWE-Atlas-QnA-AA -14 | Abdeckung der vorab markierten Pflichtfakten |
| Seltene komplexe Analysen / schwierige Fälle | Gezielte Abnahme | Punktverlust bei versteckten Musteraufgaben in Plotly | Kosten pro qualifizierter Lieferung nach erneuter Prüfung |
| Mehrstufige Abläufe | Gezielte Abnahme | Verworfene Inferenzpunkte, verschobene Instruktionspositionen | Konsistenz der Ergebnisse nach Replay, Nachtragen von Verlauf und Wiederherstellung nach Fehlern |
Bei der Umsetzung kann man sich an der folgenden Checkliste orientieren:
- Fragen zur Codebasis: Vorab für jede Aufgabe die Caller, Konfigurationsschalter, Verzweigungsbedingungen und Dateipfade markieren, die abgedeckt sein müssen, und Punkt für Punkt prüfen, ob die Belege vollständig sind – nicht nur, ob die Antwort „richtig klingt“.
- Kennzahlen erfassen: Pro Aufgabentyp die Abnahmequote im ersten Durchlauf, fehlende Punkte, Nacharbeitsrunden, End-to-End-Dauer sowie Modell- und Tool-Nutzung festhalten; bei ausreichender Stichprobe zugleich P50 und P95 betrachten.
- Kosten berechnen: Die Kosten pro qualifizierter Lieferung schätzen als „Gesamtkosten während der Evaluierung ÷ Anzahl der abgenommenen Aufgaben“. Kosten für erneute Prüfung und erneutes Ausführen zählen zu den Gesamtkosten. Ein einzelner Lauf mit 6.2 Sol ist billiger – doch wenn bei schwierigen Aufgaben mehr Nacharbeit anfällt, können die qualifizierten Kosten entgegen der Erwartung steigen.
- Entscheidung über Skalierung: Nur Aufgabentypen, die alle drei Kriterien erfüllen – Qualitätsschwelle, Kosten pro qualifizierter Lieferung und Latenz –, erhalten mehr Traffic; die übrigen bleiben bei 6.1 Sol und warten auf die nächste Testrunde.
💰 Hinweis zur Kostenberechnung: Nur wenn der Stückpreis im selben Kanal identisch ist, sind die Vergleichsergebnisse aussagekräftig. Über APIYI apiyi.com lässt sich mit einem einzigen Key beide Modellgenerationen gleichzeitig ausführen; die Abrechnung wird pro Modell getrennt erfasst und kann direkt zur Berechnung der Kosten pro qualifizierter Lieferung verwendet werden.
GPT-6.2 Sol im Vergleich zu GPT-6.1 Sol: So treffen Sie die richtige Wahl
Wenn Ihre Workload überwiegend aus Codeänderungen, Terminal-Agenten und Routineanalysen besteht, ist 6.2 Sol zum selben Preis die schnellere und günstigere Wahl – ein Umstieg bietet sich dann zuerst an. Wenn Fragen zur Codebasis und knifflige Aufgaben mit versteckten Mustern einen hohen Anteil haben oder Ihr Geschäft von Flex abhängt, sollten Sie zunächst die gezielte Abnahme in Abschnitt 4 abschließen; solange die entsprechenden Kennzahlen noch nicht erreicht sind, kann 6.1 Sol diesen Traffic weiter übernehmen. Die entscheidende Variable für diese Entscheidung ist die Zusammensetzung der Aufgaben: Je höher der Anteil schwieriger Fälle, desto eher können Rework und Nacharbeit den Vorteil von 6.2 Sol beim Stückpreis und bei der Geschwindigkeit wieder aufheben.
Es empfiehlt sich, zunächst bei APIYI apiyi.com das kostenlose Testkontingent für neue Nutzer zu verwenden, für jeden Aufgabentyp repräsentative Beispiele auszuwählen und einen Vergleichslauf durchzuführen, und dann anhand der Ergebnisse den Umfang des Wechsels festzulegen.
Referenzen
- OpenAI-Ankündigung: Release-Hinweise zu GPT-6.2 Astra und Sol sowie die Ergebnisse von GDPval v2
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol
- Link:
- OpenAI-API-Modellkarte und Preisgestaltung: Spezifikationen, Preise und Verarbeitungsoptionen der beiden Sol-Generationen
- Link:
developers.openai.com/api/docs/models/gpt-6.2-sol - Link:
developers.openai.com/api/docs/pricing
- Link:
- GPT-6.2 Leitfaden: Verhaltensänderungen bei Responses und Punkte zur Migrationsprüfung
- Link:
developers.openai.com/api/docs/guides/latest-model
- Link:
- Artificial Analysis: Gesamtwertung und aufgeschlüsselte Daten zum Coding Agent Index
- Link:
artificialanalysis.ai/agents/coding-agents/codex
- Link:
- Plotly DataAnalyticsBench: Einzelrunden-Vergleich von 6.2 Sol und Erläuterung der Fehlerfälle
- Link:
plotly.com/blog/gpt-6-2-sol-plotly-data-analytics-bench
- Link:
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI apiyi.com; weitere Integrationsunterlagen finden Sie im Dokumentationszentrum unter docs.apiyi.com