Nota del autor: GPT-6.2 Sol mantiene el precio por token Standard de la generación anterior y, en varias pruebas públicas, ha mejorado sus resultados o ha reducido el coste por tarea. Antes de actualizar sistemas ya existentes, sigue siendo necesario evaluar por separado las preguntas y respuestas sobre repositorios de código, el análisis complejo y las conversaciones de múltiples turnos.
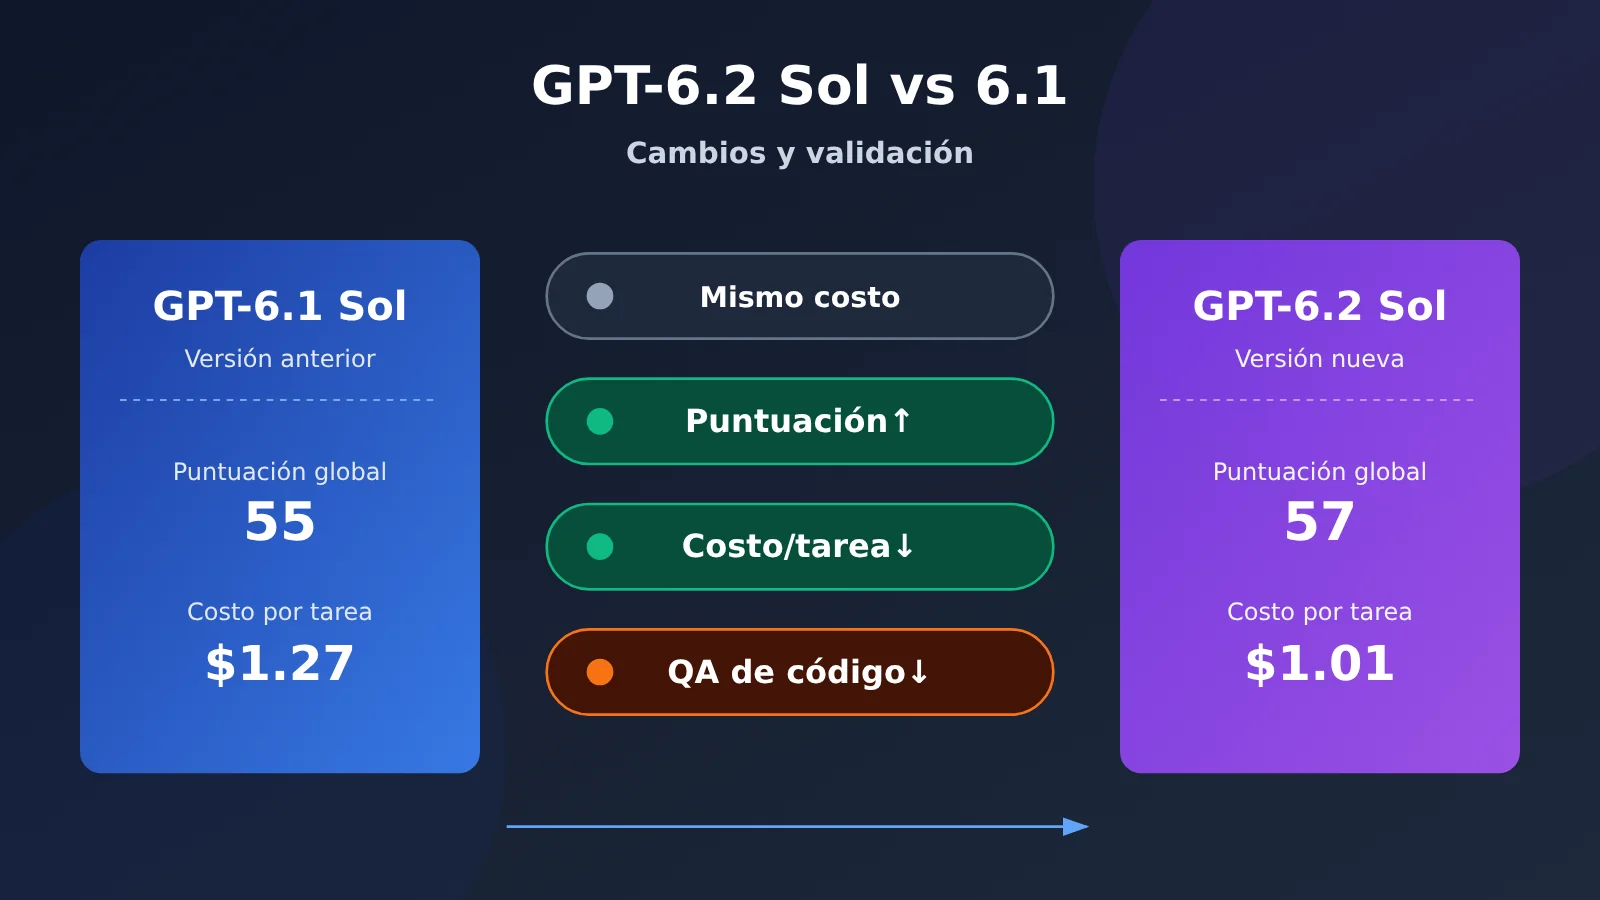
Primero, la conclusión: el precio unitario en contexto corto Standard de GPT-6.2 Sol es idéntico al de GPT-6.1 Sol; en la evaluación integral obtiene mejores puntuaciones y un coste por tarea menor, pero pierde puntos de forma clara en preguntas y respuestas sobre repositorios de código y en unos pocos problemas difíciles. En ambos casos, los precios por millón de tokens para entrada normal, lectura de caché y salida son $2, $0.10 y $10. La puntuación global de Artificial Analysis en el nivel Max subió de 55 a 57, y el coste medio por tarea bajó de $1.27 a $1.01. En la prueba de agente de código de esa misma organización, la subprueba de preguntas y respuestas sobre repositorios de código cayó de 60 a 46, y la prueba de análisis de datos con Plotly también bajó de la puntuación perfecta de 43/43 a 40/43.
Por tanto, conviene adoptar esta actualización de forma gradual según el tipo de tarea; no se recomienda sustituir todo de golpe. Las modificaciones de código verificables, las operaciones de terminal y los análisis rutinarios pueden probarse primero. Las preguntas y respuestas sobre repositorios de código, los problemas difíciles de patrones ocultos y el procesamiento por lotes que depende de Flex necesitan primero pruebas de regresión adicionales. Además, la Responses API de GPT-6.2 cambia su comportamiento en conversaciones de múltiples turnos y en la posición de las instrucciones; las aplicaciones de múltiples turnos que usan la versión anterior no pueden limitarse a cambiar el ID del modelo.
GPT-6.2 Sol frente a GPT-6.1 Sol: resumen rápido
La siguiente tabla solo incluye las dimensiones útiles para decidir una actualización. Las especificaciones y los precios provienen de las fichas oficiales de modelo, la página de precios y el changelog de OpenAI; todas las unidades de precio son USD / millón de tokens.
| Dimensión de comparación | GPT-6.1 Sol | GPT-6.2 Sol | Qué implica la diferencia |
|---|---|---|---|
| ID del modelo / fecha de lanzamiento | gpt-6.1-sol / 2026-09-29 |
gpt-6.2-sol / 2026-11-17 |
El modelo nuevo acaba de lanzarse; conviene observarlo durante un tiempo |
| Contexto / salida máxima | 1,050,000 / 128,000 | 1,050,000 / 128,000 | Capacidad sin cambios |
| Entrada máxima | La ficha del modelo no lo desglosa | 922,000 | Las tareas con entradas muy largas deben comprobarse con el nuevo límite |
| Fecha de corte de conocimiento | 2026-04-30 | 2026-06-01 | Se retrasa cerca de un mes |
| Precio Standard para contexto corto | Entrada $2 / lectura de caché $0.10 / salida $10 | Igual | Con la misma combinación de tokens, la factura es igual |
| Procesamiento Flex | Compatible | No compatible | Quienes usaban Flex en la versión anterior deben cambiar a otro modo de procesamiento |
| Ventanas de descuento para procesamiento en segundo plano | No se mencionan en este material | Ventana de 2 horas -30%, ventana de 8 horas -40% | Las tareas que toleran latencia tienen nuevas opciones para ahorrar |
| Puntuación global (AA, nivel Max) | 55 | 57 | Algo mejor en general |
| Preguntas y respuestas sobre el repositorio de código (AA, Codex + Max) | 60 | 46 | Retroceso claro; requiere validación específica |
🚀 Comparación rápida: las dos generaciones se pueden comparar cambiando entre ambas dentro del mismo conjunto de endpoints. La tabla pública de modelos de APIYI apiyi.com ya incluye
gpt-6.2-soly marca las dos entradas, responses y chat, ideal para ejecutar una comparación de regresión entre la versión nueva y la anterior con la misma clave.
Orden de lectura recomendado: la sección 1 del cuerpo confirma primero el precio y las opciones de procesamiento, porque determinan el criterio de facturación. La sección 2 compara mejoras y puntos débiles en las pruebas públicas para decidir qué tareas merecen una actualización. La sección 3 revisa cambios en el comportamiento de la API para determinar si los servicios existentes pueden migrar sin fricción. La sección 4 ofrece un plan de validación por tareas. Si solo te interesan los agentes de programación, puedes ir directamente a 2.2 y a la sección 4.
Términos que conviene conocer antes de comparar GPT-6.2 Sol
| Término | Explicación breve |
|---|---|
| Precio estándar por token | Tarifa pública de OpenAI en el nivel Standard por cada millón de tokens de entrada, de salida y de distintos usos de caché |
| Costo de la tarea | Gastos de modelo y herramientas generados al completar una tarea; en la validación de negocio también se pueden sumar reejecuciones y revisión manual |
| Nivel de razonamiento | Ajuste que controla el presupuesto de razonamiento del modelo; los valores habituales son Low, Medium, High, Xhigh y Max. En pruebas comparativas, hay que igualar el nivel |
| GDPval v2 | Evaluación interna de OpenAI de trabajo de conocimiento complejo; se centra en entregables de procesos largos procedentes de tipos de proyecto reales |
| Coding Agent Index | Métrica integral de agentes que calcula Artificial Analysis a partir de subapartados como modificación de código, operaciones de terminal y preguntas y respuestas sobre el repositorio de código |
| SWE-Atlas-QnA-AA | Subapartado de preguntas y respuestas sobre el repositorio de código dentro de la métrica anterior; evalúa si están completos los hechos necesarios para responder |
| Prefijo de conversación / lectura de caché | Contenido que se mantiene en el mismo orden al inicio de solicitudes multiturno; cuando el servicio identifica un prefijo reutilizable, la parte que coincide se factura según la tarifa de lectura |
1. GPT-6.2 Sol frente a GPT-6.1 Sol: especificaciones básicas y precios
1.1 Las especificaciones de GPT-6.2 Sol continúan en gran medida las de la generación anterior
Ambos modelos se pueden invocar mediante Responses y Chat Completions; las llamadas a funciones y las herramientas integradas van por la ruta de Responses. Los dos aceptan entrada de texto e imágenes, generan texto de forma nativa, comparten una ventana de contexto de 1,050,000 tokens y un máximo de salida de 128,000 tokens. La ficha del modelo 6.2 Sol detalla aparte un máximo de 922,000 tokens de entrada.
Hay matices en el posicionamiento. La página del modelo 6.1 Sol pone el acento en completar tareas complejas de código, operación de computadoras y trabajo profesional a un costo menor que Astra; la del 6.2 Sol se orienta más hacia código cotidiano y trabajo de agentes a escala. Dicho de otro modo, el 6.2 Sol apunta con más claridad a escenarios de alta frecuencia y por lotes.
1.2 El precio Standard de GPT-6.2 Sol es igual al de la generación anterior
La facturación oficial Standard es la siguiente. Ambas generaciones usan como umbral 272K tokens de entrada por solicitud: al superarlo, las tarifas de entrada y de caché de toda la solicitud se calculan al doble, y la salida a 1.5 veces.
| Categoría de facturación Standard | Contexto corto (≤272K) | Contexto largo (>272K) |
|---|---|---|
| Entrada normal | $2.00 | $4.00 |
| Lectura de caché | $0.10 | $0.20 |
| Escritura de caché de 30 minutos | $2.50 | $5.00 |
| Escritura de caché de 12 horas | $5.00 | $10.00 |
| Salida (incluye tokens de razonamiento) | $10.00 | $15.00 |
Que el precio unitario sea el mismo no significa que la factura sea la misma. Al completar una misma tarea, los tokens de salida, el número de llamadas a herramientas y los aciertos de caché del 6.2 Sol pueden variar, así que el costo real debe calcularse tarea por tarea. La escritura de caché debe calcularse con su tarifa completa correspondiente, sin sumarle además el precio de entrada normal de esos mismos tokens. El total de salida se puede leer desde usage.output_tokens en Responses, y el consumo de razonamiento suele aparecer en la subpartida output_tokens_details.reasoning_tokens.
Sobre las llamadas desde China: a fecha de 2026-11-20, en la interfaz de precios públicos de APIYI apiyi.com, el precio de tramo corto de gpt-6.2-sol coincide con el oficial; en el tramo largo, la entrada normal, la lectura de caché, la escritura de caché y la salida son $3, $0.15, $3.75 y $11.25 respectivamente. Se trata de la expresión de precios publicada públicamente; la facturación real depende del grupo de la cuenta y de la configuración vigente de la plataforma.
1.3 Flex frente a la ventana de descuento en segundo plano
El cambio en las opciones de procesamiento es lo que más fácilmente pasa desapercibido. El 6.1 Sol sigue en la lista de modelos aptos para Flex; el 6.2 Sol no admite Flex. Como alternativa, el 6.2 Sol puede usar la ventana de descuento en segundo plano de Responses: en solicitudes que cumplan los requisitos, la tarifa de tokens del modelo es un 30% menor que Standard en la ventana de 2 horas y un 40% menor en la de 8 horas.
Si un sistema antiguo depende de Flex para procesamiento por lotes offline, al migrar hay que volver a elegir según los plazos de entrega y las condiciones de acceso. Las tareas que toleran entregas en varias horas pueden evaluarse con la ventana en segundo plano; las que exigen respuesta inmediata solo pueden facturarse a tarifa Standard.
2. GPT-6.2 Sol frente a GPT-6.1 Sol: avances y retrocesos en las pruebas públicas
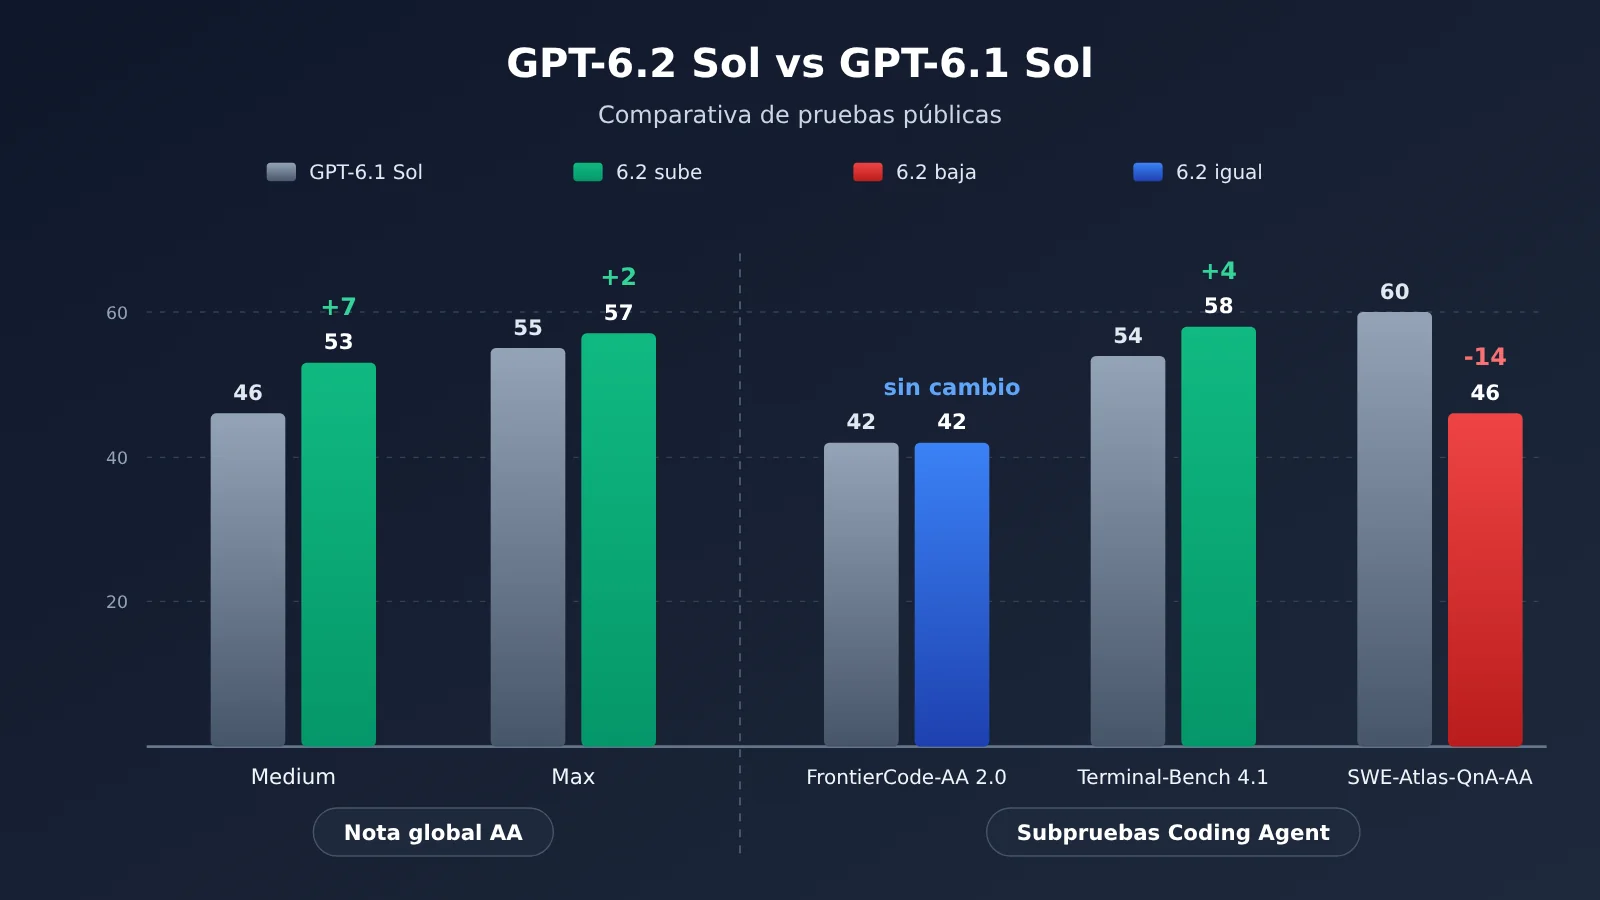
La imagen anterior resume datos públicos de terceros: en verde, las mejoras de 6.2 Sol; en rojo, los retrocesos. Estas cifras provienen de distintas instituciones y frameworks de prueba, por lo que solo son comparables dentro de sus respectivas condiciones. Si quieres reproducirlas en tus propias tareas, puedes invocar las dos generaciones de modelo por el mismo canal y con el mismo nivel a través de APIYI (apiyi.com).
2.1 Trabajo de conocimiento y capacidades generales: GPT-6.2 Sol mejora de forma constante
Según la propia OpenAI: en el anuncio de lanzamiento del 2026-11-17, OpenAI afirma que 6.2 Sol supera a 6.1 Sol en 5.3 puntos porcentuales en su evaluación interna GDPval v2. GDPval v2 mide trabajo de conocimiento de varios pasos en áreas como consultoría, finanzas y diseño; esta conclusión solo aplica a las pruebas internas publicadas por OpenAI. El anuncio incluye además una frase sobre «22% menos tokens de salida», pero la comparación es entre GPT-6.2 Astra y GPT-6 Astra, no entre las dos generaciones de Sol.
Mediciones de terceros: la puntuación compuesta de Artificial Analysis abarca trabajo de conocimiento, programación, ciencia y conocimiento general. De 6.1 Sol a 6.2 Sol, el nivel Medium pasa de 46 a 53, y el Max de 55 a 57. El costo promedio por tarea en Max baja de $1.27 a $1.01, aproximadamente un 20% menos según los valores redondeados publicados.
Ambos conjuntos de datos apuntan en la misma dirección: 6.2 Sol es más fuerte en tareas generales y, además, cuesta menos por tarea. Llama la atención que el aumento en Medium (+7) sea claramente mayor que en Max (+2). Para los equipos que usan a diario un nivel de razonamiento medio, esta actualización podría notarse más.
2.2 Modificación de código, terminal y preguntas y respuestas sobre el repositorio: GPT-6.2 Sol con altibajos
En el Coding Agent Index v2.1 de Artificial Analysis, ambas generaciones de modelos usan el marco de pruebas Codex y el nivel de razonamiento Max, con el mismo criterio:
| Métrica (Codex + Max) | GPT-6.1 Sol | GPT-6.2 Sol | Cambio |
|---|---|---|---|
| Coding Agent Index global | 52 | 49 | -3 |
| FrontierCode-AA 2.0 | 42 | 42 | sin cambios |
| Terminal-Bench 4.1 | 54 | 58 | +4 |
| SWE-Atlas-QnA-AA (preguntas y respuestas sobre el repositorio de código) | 60 | 46 | -14 |
| Costo promedio de API por tarea | $1.51 | $1.22 | aprox. -19% |
| Tiempo promedio de ejecución del agente | 21.9 minutos | 17.5 minutos | -4.4 minutos |
La puntuación global bajó principalmente porque la subprueba de preguntas y respuestas sobre el repositorio de código cayó 14 puntos, lo que compensó la subida de 4 puntos en terminal, mientras que la subprueba de modificación de código se mantuvo igual. La métrica de tiempo de ejecución excluye los gastos de inicio del entorno, revisión y validación, y solo refleja la duración de ejecución del propio agente. Además, FrontierCode-AA 2.0 aquí es la versión de Artificial Analysis, no debe mezclarse con rankings homónimos de otras organizaciones.
La comparación de una sola ronda de DataAnalyticsBench que Plotly publicó el 2026-11-17 ofrece una referencia para otro tipo de tareas independientes. La puntuación total de 6.1 Sol → 6.2 Sol pasó de 43/43 a 40/43, el costo total de la ronda bajó de $2.61 a $1.22 y el tiempo mediano por pregunta bajó de 17.6 segundos a 10.5 segundos. El número de llamadas a herramientas bajó de 258 a 158, y el volumen de salida pasó de aproximadamente 70,000 tokens a 45,000 tokens. Las tres preguntas que 6.2 Sol respondió incorrectamente se concentraron en problemas de patrones ocultos.
Estos resultados tienen dos limitaciones. Primero, las pruebas se ejecutaron con el marco fijo de OpenRouter y Plotly, y los costos se midieron según el canal utilizado en ese momento. Segundo, cada modelo solo se ejecutó durante una ronda; cuando Plotly volvió a ejecutar otros modelos, observó variaciones de hasta tres preguntas. Por eso, estos datos sirven mejor para ilustrar una tendencia: 6.2 Sol realiza menos acciones, es más rápido y consume menos, pero en problemas difíciles que requieren profundizar puede “retirarse demasiado pronto”.
3. Cómo el comportamiento de la API de GPT-6.2 Sol afecta a los servicios existentes
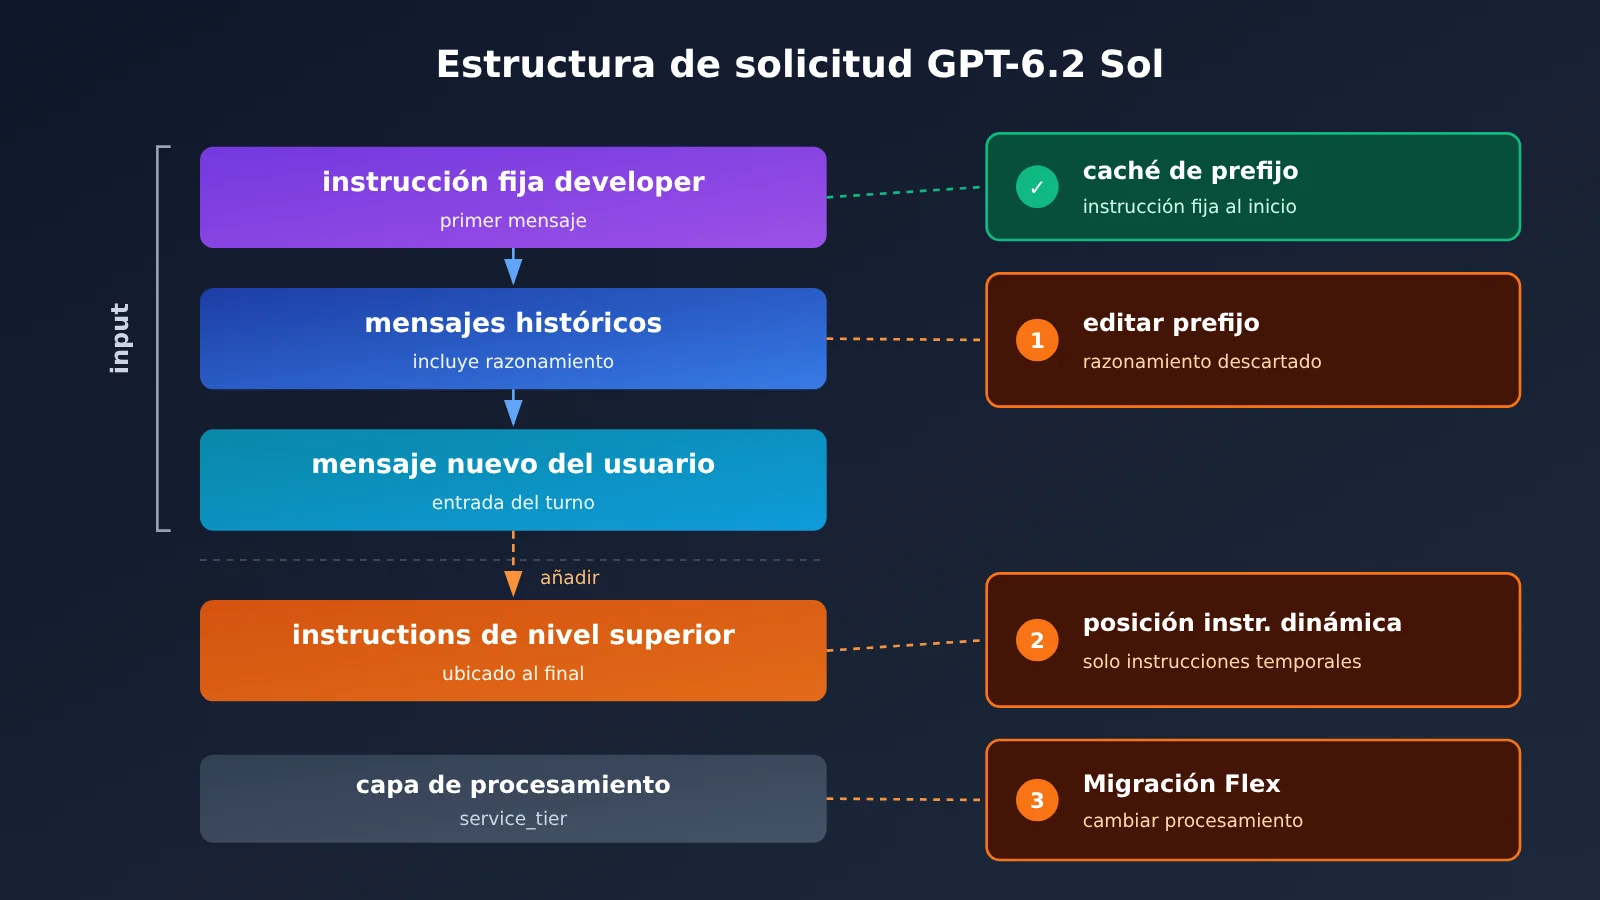
Para las aplicaciones multiturno que ya ejecutan 6.1 Sol, el riesgo se concentra principalmente en tres aspectos. El diagrama anterior muestra la estructura recomendada de las solicitudes de GPT-6.2 Responses, y puedes verificarla directamente siguiendo esta estructura a través del endpoint responses de APIYI apiyi.com.
- Reescritura del prefijo de conversación: La API Responses de GPT-6.2 descarta los elementos de razonamiento previos al editar el prefijo de una conversación existente, al realizar un cambio parcial de modelo, o al cambiar de usuario final u organización. Si el sistema tiene lógica de «reescribir el historial y continuar la conversación», es necesario verificar si la calidad de la continuación y el acierto de caché se ven afectados.
- Posición de las instrucciones: Las
instructionsde nivel superior de GPT-6.2 se añaden después delinput. Las instrucciones fijas que se desean reutilizar y que se espera que acierten en la caché deben colocarse en el primer mensajedeveloperdelinput; las instrucciones temporales que cambian cada vez pueden seguir usando lasinstructionsde nivel superior. - Migración de Flex: Consulta la sección 1.3; las solicitudes que originalmente usaban Flex deben cambiar su forma de procesamiento.
Además, ninguno de los dos endpoints acepta el nivel de razonamiento none. Al reemplazar el ID del modelo, también conviene revisar, según la guía oficial de migración, la reescritura del historial, los parámetros de muestreo, el nivel de razonamiento, la capa de procesamiento y los datos de caché.
3.1 Ejemplo mínimo de invocación de GPT-6.2 Sol
Aquí tienes una validación mínima con Chat Completions:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI
)

resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "用三句话说明什么是会话前缀缓存"}]
)
print(resp.choices[0].message.content)
Ver el código comparativo de la API Responses entre la versión nueva y la antigua (instrucciones fijas al principio + registro de uso)
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Ambas versiones usan el mismo canal, para que la comparación sea justa
)

STABLE_RULES = "你是代码库助手。回答必须列出涉及的文件路径、调用方和配置开关。"

def run(model: str, question: str, effort: str = "medium"):
    resp = client.responses.create(
        model=model,
        reasoning={"effort": effort},   # Ninguno de los dos endpoints acepta none
        input=[
            # Las instrucciones fijas van en el primer mensaje developer del input, lo que favorece el caché de prefijos
            {"role": "developer", "content": STABLE_RULES},
            {"role": "user", "content": question},
        ],
        # Las instrucciones temporales pueden ir en el campo instructions de nivel superior; se añaden después del input
        instructions="本轮只回答与鉴权模块相关的部分。",
    )
    usage = resp.usage
    details = getattr(usage, "output_tokens_details", None)
    return {
        "model": model,
        "text": resp.output_text,
        "output_tokens": usage.output_tokens,
        "reasoning_tokens": getattr(details, "reasoning_tokens", None),
    }

for m in ["gpt-6.1-sol", "gpt-6.2-sol"]:
    r = run(m, "登录失败后的重试逻辑在哪里实现?受哪些配置影响?")
    print(r["model"], r["output_tokens"], r["reasoning_tokens"])
    print(r["text"][:300], "\n---")
🎯 Recomendación técnica: cuando migras aplicaciones con múltiples turnos, conviene conservar un lote de peticiones reales en las que «el prefijo no cambia y solo se añaden mensajes» y enviarlas tanto a la generación nueva como a la antigua, para comparar las respuestas y el consumo de lectura de caché. APIYI apiyi.com permite invocar los dos modelos a la vez, lo que facilita incorporar estas pruebas comparativas en CI.
4. Validación por tareas antes de cambiar a GPT-6.2 Sol
El siguiente plan es un diseño de pruebas basado en la evidencia pública mencionada; no se trata de un requisito oficial. El principio central es que, salvo el modelo, todas las demás condiciones permanezcan fijas: el mismo canal de API, nivel de razonamiento, materiales de entrada, lista de herramientas, configuración de tiempos de espera y reglas de puntuación. Además, se conserva 6.1 Sol como grupo de control.
| Tipo de tarea | Prioridad de prueba | Evidencia principal | Criterios de aceptación |
|---|---|---|---|
| Modificación de código | Probar primero | FrontierCode-AA 2.0 se mantiene; bajan coste y duración | Tasa de pruebas superadas no inferior a la versión anterior; coste por entrega aceptada a la baja |
| Operación de terminal / computadora | Probar primero | Terminal-Bench 4.1 +4 | Tasa de éxito y tiempo de extremo a extremo P50, P95 |
| Análisis habitual | Probar primero | Puntuación global sube; bajan tiempo y coste de Plotly | Tasa de aceptación en la primera ronda, número de omisiones |
| Preguntas y respuestas sobre el repositorio de código | Validación específica | SWE-Atlas-QnA-AA -14 | Cobertura de los hechos obligatorios anotados de antemano |
| Análisis complejo de baja frecuencia / casos difíciles | Validación específica | Pérdida de puntos en las preguntas de patrones ocultos de Plotly | Coste por entrega aceptada tras revisión |
| Flujos de múltiples turnos | Validación específica | Descarte de elementos de razonamiento, cambios en la posición de las instrucciones | Consistencia de resultados tras repetición, reescritura del historial y recuperación de fallos |
Durante la ejecución, puedes avanzar con la siguiente lista:
- Preguntas y respuestas sobre el repositorio de código: antes de cada pregunta, anota los llamadores, flags de configuración, condiciones de ramificación y rutas de archivo que deben cubrirse, y revisa punto por punto si la evidencia está completa; no te limites a comprobar si la respuesta «parece correcta».
- Registra las métricas: por tipo de tarea, registra la tasa de aceptación en primera ronda, omisiones, número de retrabajos, tiempo de extremo a extremo y consumo de modelos y herramientas; cuando haya suficientes muestras, mira también P50 y P95.
- Calcula el coste: usa «coste total durante la evaluación ÷ número de tareas aceptadas» para estimar el coste por entrega aceptada; incluye en el coste total los gastos de revisión y de nuevas ejecuciones. Una ejecución individual de 6.2 Sol puede ser más barata, pero si aumentan los retrabajos en casos difíciles, el coste por entrega aceptada podría subir.
- Decisión de ampliar volumen: solo amplía el tráfico en los tipos de tarea que cumplan los tres criterios: umbral de calidad, coste por entrega aceptada y latencia; los que no los cumplan se quedan en 6.1 Sol hasta la siguiente ronda de reevaluación.
💰 Consejo para calcular el coste: el precio unitario debe ser el mismo en el mismo canal para que la comparación tenga sentido. Con APIYI apiyi.com, ejecuta ambos modelos con una única clave API; la factura se registra por modelo, así que puedes usarla directamente para calcular el coste por entrega aceptada.
GPT-6.2 Sol frente a GPT-6.1 Sol: cómo elegir
Si tu carga de trabajo se centra sobre todo en modificación de código, agentes de terminal y análisis habitual, 6.2 Sol es la opción más rápida y económica dentro del mismo rango de precio, así que puedes cambiar a ella de forma prioritaria. Si las preguntas y respuestas sobre bases de código y los problemas difíciles de patrones ocultos representan una proporción alta, o si tu negocio depende de Flex, primero deberías completar la validación específica de la sección 4; antes de que los indicadores correspondientes cumplan, puedes seguir dejando que 6.1 Sol se encargue de esa parte del tráfico. La variable clave que decide esta elección es la composición de tareas: cuanto mayor sea la proporción de casos difíciles, más probable es que la ventaja de 6.2 Sol en precio unitario y velocidad se vea compensada por el retrabajo.
Te recomendamos empezar usando la cuota de prueba gratuita para nuevos usuarios en APIYI apiyi.com, seleccionar muestras representativas de cada tipo de tarea y hacer una ronda de comparación, y después decidir el alcance del cambio según los resultados.
Referencias
- Anuncio de OpenAI: notas de publicación de GPT-6.2 Astra y Sol y conclusiones de GDPval v2
- Enlace:
openai.com/index/introducing-gpt-6-2-astra-sol
- Enlace:
- Tarjeta de modelo y precios de OpenAI API: especificaciones, precios y opciones de procesamiento de las dos generaciones de Sol
- Enlace:
developers.openai.com/api/docs/models/gpt-6.2-sol - Enlace:
developers.openai.com/api/docs/pricing
- Enlace:
- Guía de uso de GPT-6.2: cambios de comportamiento de Responses y puntos de verificación de la migración
- Enlace:
developers.openai.com/api/docs/guides/latest-model
- Enlace:
- Artificial Analysis: datos de puntuación global y desglose del Coding Agent Index
- Enlace:
artificialanalysis.ai/agents/coding-agents/codex
- Enlace:
- Plotly DataAnalyticsBench: comparación de una sola ronda de 6.2 Sol y explicación de los errores
- Enlace:
plotly.com/blog/gpt-6-2-sol-plotly-data-analytics-bench
- Enlace:
Autor: Equipo técnico de APIYI
Contacto técnico: puedes escribirnos desde la página principal de APIYI apiyi.com; para más material de integración, visita el centro de documentación docs.apiyi.com