ملاحظة المؤلف: يستعرض هذا المقال بشكل منفصل النتيجة المركّبة من طرف ثالث، والأسعار المعلَنة رسميًا، وقراءة الكاش، والمقارنات الفردية بين GPT-6.2 Sol و Claude Fable 5.2، ويوضّح أيّ الأرقام صالح للمقارنة المباشرة، وأيّها لا يمكن اختصاره في سؤال واحد: «من الأقوى؟».
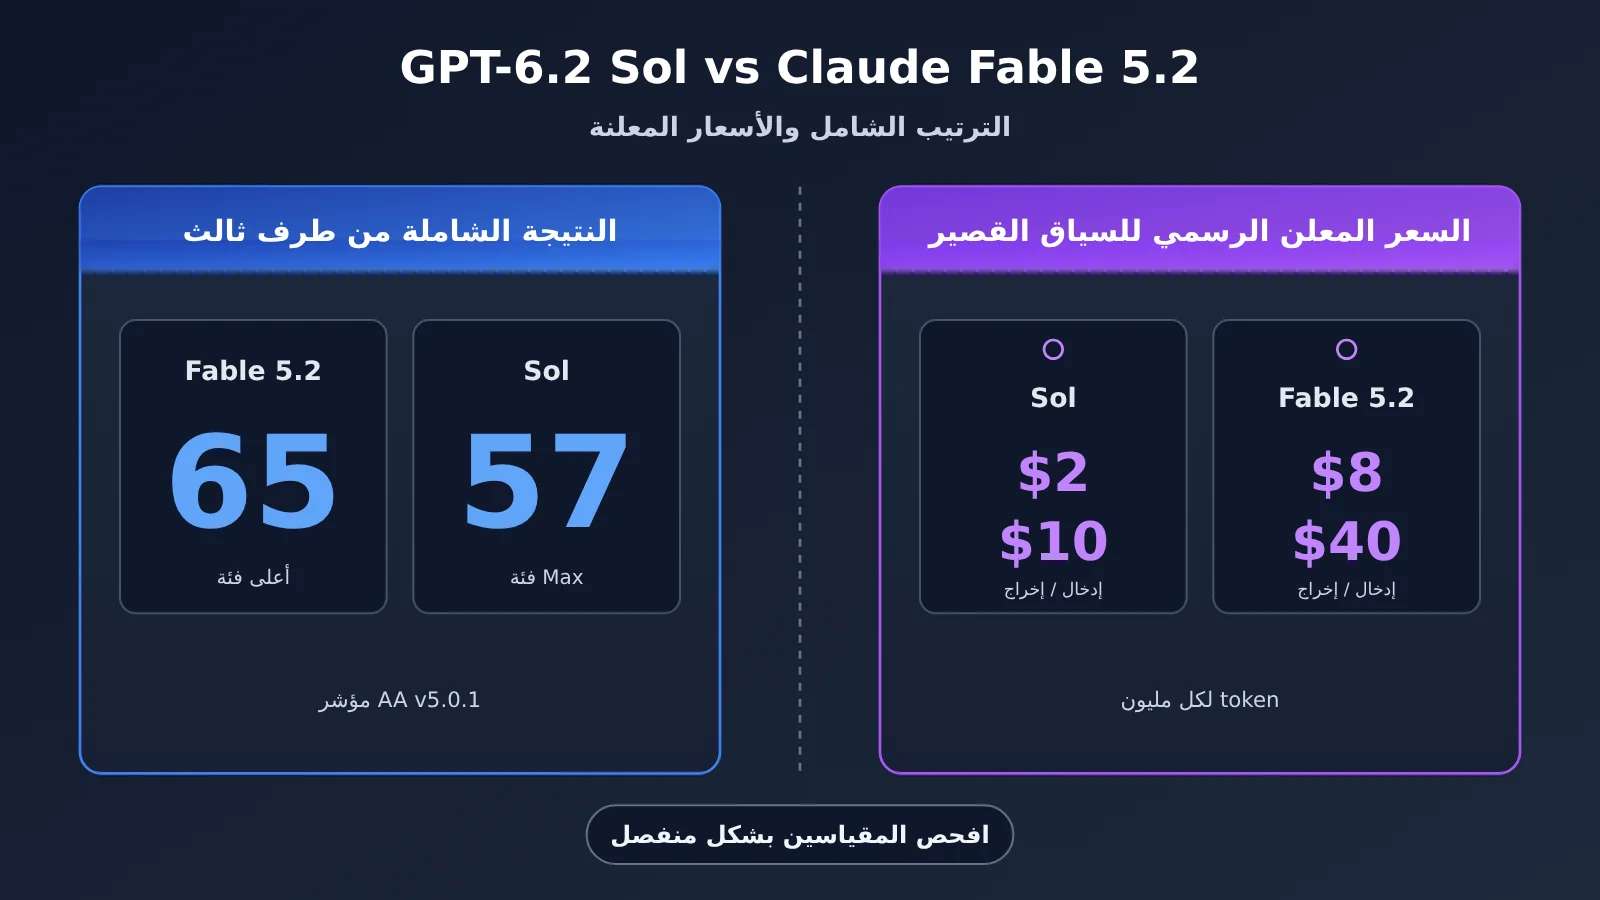
عند وضع GPT-6.2 Sol و Claude Fable 5.2 جنبًا إلى جنب، أكثر الأخطاء شيوعًا هو أن تغطّي عبارة واحدة من نوع «من الأقوى؟» كل الأرقام دفعة واحدة. في 17 نوفمبر 2026 أطلقت OpenAI نموذجَي GPT-6.2 Astra و GPT-6.2 Sol، وفي اليوم نفسه حدّثت الجهة المستقلة Artificial Analysis لوحة الترتيب المركّبة لديها: حقّق Claude Fable 5.2 في أعلى مستوى للاستدلال 65 نقطة، بينما حصل GPT-6.2 Sol على 57 نقطة في المستوى Max. وفي المقابل، وفقًا للأسعار المعلَنة رسميًا من الشركتين للسياق القصير، تبلغ أسعار الوحدة للمدخلات والمخرجات في Sol ربع ما هي عليه في Fable.
الفارق في النتائج كبير، والفارق في الأسعار كبير أيضًا؛ كلا الأمرين حقيقي، لكن أحدهما لا يلغي الآخر، ولا يمكن دمجهما في استنتاج واحد. هذه ليست مقالة تختار جانبًا نيابةً عنك. فالتقييم الذي تنشره الشركات عن نفسها، ولوحات الترتيب من طرف ثالث، والأسعار المعلَنة من الشركات المصنّعة، ثلاثة معايير قياس منفصلة؛ سنفكّكها في هذا المقال طبقةً تلو الأخرى، وسنفرد قائمة بالبنود الفردية التي لا تتوفر لها في الواقع مقارنة رسمية مباشرة بين Sol و Fable.
القيمة الأساسية: بعد قراءة هذا المقال ستكون بحوزتك ثلاث مجموعات من الأرقام يمكن التحقق منها — النتيجة المركّبة، والأسعار المعلَنة، وقراءة الكاش — وستعرف أيّ بنود المقارنة الفردية لا يصح استخدامها في مقارنة بين Sol و Fable، وستتمكّن من تحديد أيّ جهة من البيانات تفحص أولًا بحسب مهمتك.
النقاط الجوهرية للنموذجين GPT-6.2 Sol و Claude Fable 5.2
يقدّم الجدول أدناه الأرقام على مستوى الخلاصات أولًا، مع توضيح منهجية القياس في كل سطر. أما الأقسام اللاحقة فستتناول كل سطر بالتفصيل.
| النقطة | الرقم | المنهجية وطريقة القراءة |
|---|---|---|
| الدرجة الإجمالية | Fable 5.2 يسجل 65، وSol (Max) يسجل 57 | مؤشر Artificial Analysis Intelligence Index v5.0.1 من طرف ثالث، وبأعلى مستوى استدلال لدى كل منهما |
| سعر الإدخال/الإخراج المعلن للسياق القصير | Sol بـ $2 / $10، وFable بـ $8 / $40 (لكل مليون توكن) | الأسعار الرسمية المعلنة من الشركتين، وسعر Sol يعادل ربع سعر Fable، وينطبق ذلك على هذين البندين فقط |
| سعر قراءة الذاكرة المؤقتة المعلن | Sol بـ $0.10، وFable بـ $0.20 | أسعار رسمية، وسعر Sol يعادل نصف سعر Fable وليس ربعه |
| المقارنة المباشرة في المواد الرسمية | تصنيف Elo في التقييم الأعمى البشري AA-3D: 1259 لـ Sol و1271 لـ Fable | منقولة بصياغة رسمية؛ أما بقية البنود الرسمية فأغلبها يقارن Astra بـ Fable، أو Sol بالنماذج القديمة من العائلة نفسها |
| التوفر على منصة APIYI | claude-fable-5-2 متوفر؛ gpt-6.2-sol غير متوفر |
المرجع هو قائمة النماذج على المنصة |
بخصوص السعر المعلن لـ GPT-6.2 Sol الوارد في الجدول: ما سبق هو الأسعار الرسمية المعلنة من OpenAI، والنموذج غير متوفر على المنصة حتى الآن، وسنحرص على إتاحته في أقرب وقت ممكن؛ وتظل أسماء النماذج والأسعار خاضعة لقائمة النماذج على المنصة.
لماذا يجب أن تكون مقارنة GPT-6.2 Sol مع Claude Fable 5.2 متعددة المستويات
يختزل المؤشر الإجمالي عشرات المهام في درجة واحدة، وهو مناسب للإجابة عن سؤال «في أي مستوى يقع الأداء العام تقريبًا»، لكنه لا يجيب عن سؤال «أيّ النموذجين أنسب لمهمتي». أما السعر المعلن فيحدد كم يكلف المليون توكن، وهذا لا يعني التكلفة الفعلية لإنجاز مهمة معينة، لأن مستوى الاستدلال وعدد توكنات التفكير ونسبة إصابة الذاكرة المؤقتة لدى كل طرف تؤثر جميعها في الفاتورة الحقيقية.
والمهام الفردية تمثل المستوى الثالث. ففي مقال الإطلاق الصادر عن OpenAI، فإن البنود الفردية المذكورة لـ Fable تكون المقارنة فيها في أغلبها مع GPT-6.2 Astra وليس Sol. ونسب نتائج Astra إلى Sol هو أكثر أخطاء القراءة شيوعًا في هذا النوع من المقارنات، وسيخصص هذا المقال جزءًا للفصل بينهما على وجه الخصوص.
مقارنة GPT-6.2 Sol مع Claude Fable 5.2: أبرز الفروق الجوهرية
الدرجات الشاملة من طرف ثالث لـ GPT-6.2 Sol وClaude Fable 5.2
Artificial Analysis مؤسسة تقييم مستقلة من طرف ثالث، والأرقام الواردة أدناه ليست إعلانات ذاتية من OpenAI أو Anthropic. تمنح هذه المؤسسة كل نموذج درجاته على مؤشر Intelligence Index v5.0.1 بحسب مستوى الاستدلال المستخدم، ولذلك يجب عند المقارنة توضيح أيّ مستوى تم الاعتماد عليه.
| النموذج | مستوى الاستدلال | Intelligence Index v5.0.1 | تكلفة المهمة الواحدة في المؤشر الشامل (حسب صفحة كل نموذج) |
|---|---|---|---|
| Claude Fable 5.2 | أعلى مستوى استدلال | 65 (الأول على القائمة) | $26.54 |
| GPT-6.2 Astra | Max / Xhigh | 62 | $4.00 (Max) |
| Gemini 4 Carbon | أعلى مستوى | 60 | — |
| Claude Opus 5.5 | أعلى مستوى | 59 | — |
| GPT-6.2 Sol | Max | 57 | $1.01 |
| GPT-6.2 Sol | Xhigh / High / Medium / Low | 56 / 55 / 53 / 41 | — |
بحسب ما ذكرته Artificial Analysis، يتفوق Sol على GPT-6.1 Sol بدرجتين ليصل إلى 57 درجة، موازنًا بذلك GPT-6 Astra، بينما تبلغ تكلفة المهمة الواحدة عنده نحو 15% فقط من تكلفة الأخير. أما «تكلفة المهمة الواحدة» الواردة في الجدول فهي ما أنفقته المؤسسة فعليًا عند تشغيل هذا المؤشر، وهو رقم يعكس الأثر المشترك لمستوى الاستدلال وطول التفكير والسعر المعلن، وليس السعر الرسمي لواجهة API.
تجدر الإشارة إلى أن OpenAI صرّحت رسميًا بأن تكلفة Astra في اختبار Agents’ Last Exam تبلغ نحو 5% من تكلفة Fable، لكن ذلك يخص مجموعة مهام مختلفة تمامًا. فلا يمكن التحويل بين رقم $26.54 ونسبة الـ«5%» الرسمية ولا العكس، ولا يجوز تطبيق هذه النسبة على Sol.
الأسعار الرسمية والتخزين المؤقت لـ GPT-6.2 Sol و Claude Fable 5.2
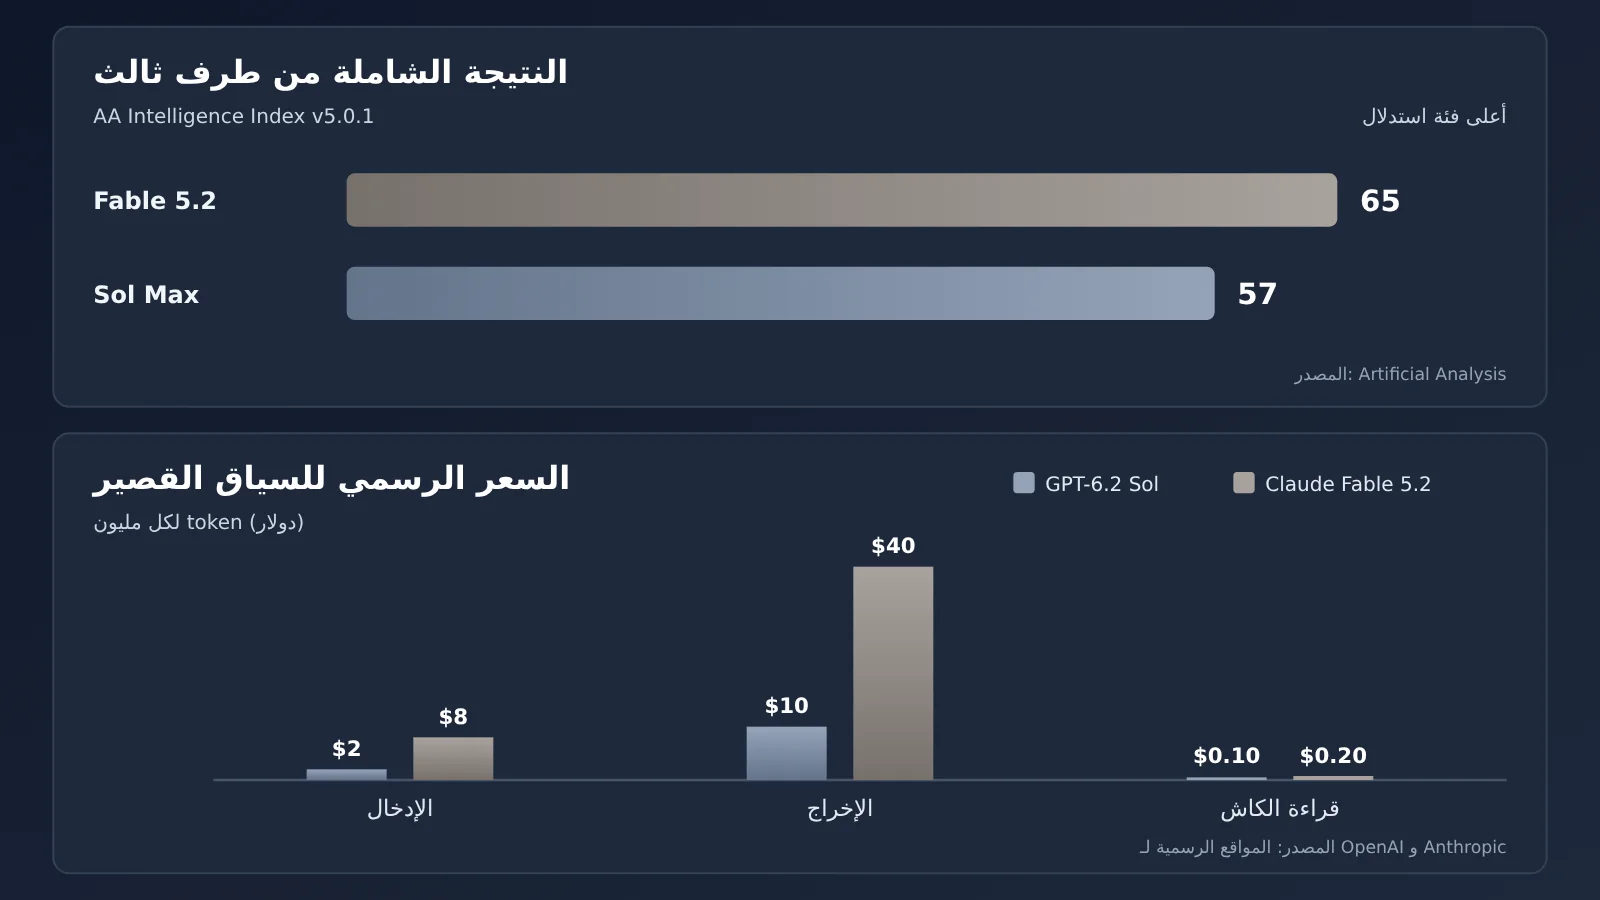
لنبدأ أولًا بـ GPT-6.2 Sol. الأسعار المعلنة في صفحة نماذج OpenAI للفئة القياسية بالسياق القصير هي: الإدخال $2، وقراءة التخزين المؤقت $0.10، وكتابة التخزين المؤقت (مع الاحتفاظ لمدة 30 دقيقة) $2.50، وكتابة التخزين المؤقت لمدة 12 ساعة $5، والإخراج $10. النموذج غير مدرج بعد على المنصة، وسنعمل على إضافته في أقرب وقت ممكن؛ يُعتمد اسم النموذج والسعر وفقًا لقائمة النماذج على المنصة. وقد أوضح إعلان الإطلاق أن Sol يحتفظ بنفس أسعار token عبر API المطبقة على GPT-6.1 Sol.
أما Claude Fable 5.2، فوثائق Anthropic تعلن الأسعار التالية: الإدخال $8، والإخراج $40، وكتابة التخزين المؤقت لمدة 5 دقائق $10، وكتابة التخزين المؤقت لمدة ساعة واحدة $16، وقراءة التخزين المؤقت $0.20. وفي الجدول الشامل للنماذج على APIYI (apiyi.com)، يظهر النموذجان claude-fable-5-2 و claude-fable-5-2-thinking بأسعار إدخال وإخراج وقراءة تخزين مؤقت قدرها $8 / $40 / $0.2، بما يطابق الأسعار الرسمية؛ غير أن صفحتي التفاصيل الخاصتين بالنموذجين تُعيدان حاليًا خطأ 404، لذا تُعتمد الأسعار وفق الجدول الشامل.
| بند التسعير (لكل مليون token) | GPT-6.2 Sol (الرسمي من OpenAI) | Claude Fable 5.2 (الرسمي من Anthropic) | العلاقة بينهما |
|---|---|---|---|
| الإدخال (السياق القصير) | $2 | $8 | الربع |
| الإخراج (السياق القصير) | $10 | $40 | الربع |
| قراءة التخزين المؤقت | $0.10 | $0.20 | النصف |
| كتابة التخزين المؤقت | 30 دقيقة: $2.50؛ 12 ساعة: $5 | 5 دقائق: $10؛ ساعة واحدة: $16 | مدد الاحتفاظ مختلفة، فلا يصح القسمة المباشرة |
| Batch | 50% من السعر القياسي | خصم 50% على الإدخال والإخراج | القاعدتان متقاربتان |
| الفئة المسرّعة | Fast يعادل ضعف السعر القياسي؛ Ultrafast بسعر 3 أضعاف حتى 2027-02-28، و6 أضعاف اعتبارًا من 2027-03-01 | وضع Fast: إدخال $16 وإخراج $80، بسرعة قصوى تبلغ نحو 2.5 ضعف | آليتا العمل مختلفتان |
جميع بنود GPT-6.2 Sol الواردة في الجدول أعلاه تمثل الأسعار الرسمية المعلنة من OpenAI. النموذج غير مدرج بعد على المنصة، وسنعمل على إضافته في أقرب وقت ممكن؛ يُعتمد اسم النموذج والسعر وفقًا لقائمة النماذج على المنصة.
عبارة «Sol يعادل ربع Fable» صحيحة فقط فيما يخص الإدخال والإخراج بالسياق القصير. وتنص صفحة نماذج OpenAI على قاعدة أخرى: عندما يتجاوز إدخال الطلب الواحد 272K token، تتضاعف أسعار الإدخال والتخزين المؤقت للوحدة الواحدة، ويُحتسب الإخراج بمقدار 1.5 ضعف سعر السياق القصير، مع تطبيق التسعير على الطلب بأكمله. عندها لن يبقى سعر إخراج Sol للوحدة الواحدة عند $10، وسيؤدي التقدير بقاعدة الربع إلى نتائج خاطئة؛ أما فيما يخص تسعير السياق الطويل على جانب Fable، فاعتمد وثائق Anthropic كمرجع رسمي.
مواصفات وواجهات GPT-6.2 Sol وClaude Fable 5.2
تقع نافذة السياق في كلا النموذجين ضمن مستوى المليون، وأقصى مخرجات لهما 128K على حد سواء. أما الفروق فتنحصر في وسائط الإدخال، وإعدادات الاستدلال، والواجهات — وهي عوامل ستحدد طريقة دمجها في مشروعك.
| البند | GPT-6.2 Sol | Claude Fable 5.2 |
|---|---|---|
| نافذة السياق / أقصى مخرجات | 1,050,000 (أقصى إدخال 922,000) / 128,000 | 1M / 128K |
| الإدخال / الإخراج | نصوص وصور / نصوص | يُعتمد على توثيق Anthropic |
| حد المعرفة | 2026-06-01 | 2026-06 |
| إعدادات الاستدلال | لا تسمح واجهة API بضبط reasoning effort على none | القيمة الافتراضية لـ effort هي high، والتفكير مُفعَّل ولا يمكن إيقافه |
| نقاط النهاية الرسمية | Chat Completions وResponses وBatch | Anthropic API |
| APIYI | غير متوفر على المنصة | claude-fable-5-2 وclaude-fable-5-2-thinking، مع نقاط النهاية chat وmessages |
عند استدعاء Fable المتوفر على APIYI، يكون base URL في وضع التوافق مع OpenAI هو https://api.apiyi.com/v1، مع إدخال claude-fable-5-2 كاسم النموذج؛ وإذا كان مشروعك يعتمد بروتوكول Anthropic Messages أصلاً، يمكنك أيضًا استخدام نقطة نهاية messages على المنصة. أما فيما يخص المجموعات، فيسرد الجدول العام: ClaudeCode وClaude_Reverse وClaude_Enterprise وDefault وSVIP.
GPT-6.2 Sol و Claude Fable 5.2: نظرة منفصلة على كل مهمة على حدة
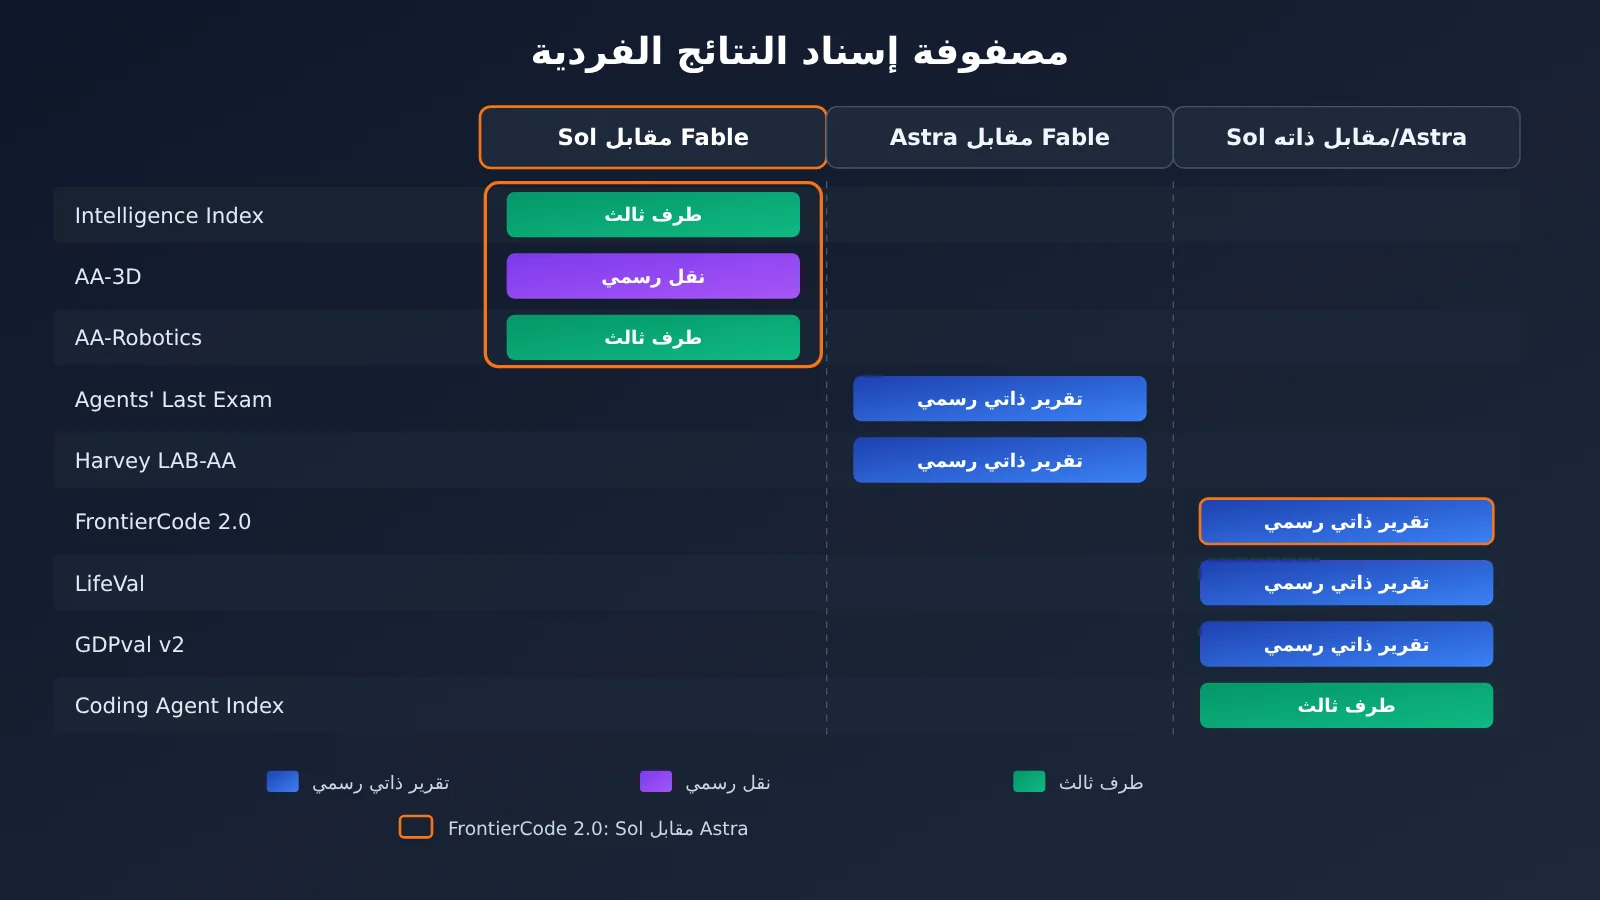
هذا القسم هو الأهم في المقال بأكمله. يتضمن بيان إطلاق OpenAI عددًا لا بأس به من النتائج على المهام الفردية، لكن المقارنات المباشرة بين «Sol و Fable» فيه قليلة جدًا. يسرد الجدول التالي كل بند على حدة حسب المصدر وطرفي المقارنة.
| البند | المصدر | طرفا المقارنة والنتيجة | هل هي مقارنة مباشرة بين Sol و Fable؟ |
|---|---|---|---|
| Intelligence Index v5.0.1 | طرف ثالث AA، أعلى فئة استدلال | Fable 65، Sol (Max) 57 | نعم (الدرجة الإجمالية من طرف ثالث) |
| AA-3D (تقييم أعمى بشري بمقياس Elo) | نقلاً عن المصادر الرسمية | Sol 1259، Fable 1271 | نعم (البند الوحيد في المواد الرسمية) |
| AA-Robotics v0.1 | طرف ثالث AA، معاينة بحثية | Sol 78، Fable 75 | نعم (معاينة من طرف ثالث، ويُعتمد في فئة الاستدلال على صفحة AA) |
| Agents’ Last Exam | تقرير ذاتي رسمي | Astra أعلى من Fable بمقدار 5.5 نقطة، وبكلفة نحو 5% | لا، بل Astra مقابل Fable |
| Harvey LAB-AA v1.1 | تقرير ذاتي رسمي | معدل نجاح Astra يفوق ضعف معدل نجاح Fable، وبكلفة نحو السدس | لا، بل Astra مقابل Fable |
| FrontierCode 2.0 | تقرير ذاتي رسمي | الفارق بين Sol و Astra أقل من 0.5 نقطة، وبكلفة نحو الخمس، وكلاهما بفئة Max | لا، بل Sol مقابل Astra |
| LifeVal | تقرير ذاتي رسمي | Sol أعلى من GPT-6 Astra، وبكلفة نحو السبع | لا |
| GDPval v2 | تقرير ذاتي رسمي | Sol أعلى من GPT-6.1 Sol بمقدار 5.3 نقطة | لا |
| Coding Agent Index | طرف ثالث AA، فئة max | Sol أدنى من GPT-6.1 Sol بمقدار 3 نقاط | لا |
نتائج GPT-6.2 Sol في FrontierCode 2.0 لا يجوز نقلها إلى Fable في المقارنة
صمّمت Cognition اختبار FrontierCode 2.0 لفحص ما إذا كانت التعديلات المطروحة على مستودعات أكواد حقيقية يمكن أن يقبلها المشرفون على الصيانة ويدمجوها. ووفق الأرقام المعلنة ذاتيًا، فإن الفارق بين Sol وAstra لا يتجاوز 0.5 نقطة، فيما تبلغ التكلفة نحو خُمس تكلفة Astra، وكلاهما في الفئة Max. لا وجود لـ Fable في هذه المقارنة أصلًا، لذا لا يجوز صياغة النتيجة على أنها «الفارق بين Sol وFable في FrontierCode لا يتجاوز 0.5 نقطة».
وبالمثل، في اختبارَي Agents’ Last Exam وHarvey LAB-AA، من يتقدم على Fable هو Astra. أما كيف يقارن أداء Sol بأداء Fable في هذين البندين، فلم يتضمن ذلك في منشور الإطلاق، ولا يصح الاستنتاج فيه من تلقاء أنفسنا.
بنود العلوم والبرمجة لدى GPT-6.2 Sol وClaude Fable 5.2
يجب توخي الحذر نفسه مع Terminal-Bench-Science 0.1. فالأرقام المعلنة ذاتيًا تُظهر تقدم Astra بفارق 9 نقاط مئوية عن GPT-6 Astra؛ وفي الحواشي يرد لـ Fable 5.2 رقمَان: الأول مأخوذ من اختبار أجرته Artificial Analysis باستخدام mini-swe-agent، والثاني هو نسبة 74.6% التي أبلغت عنها Anthropic عبر Claude Code عند قوة استدلال Max. مصدر هذين الرقمين الخاصين بـ Fable اختبار مختلف لكل منهما، فلا يمكن التعامل معهما بوصفهما مقارنة واحدة، وكلاهما ليس من نتائج Sol أصلًا.
أما في ما يخص الأطراف الثالثة، فقد أشارت Artificial Analysis إلى أن Sol سجّل في مؤشر Coding Agent Index (بيئة Codex harness، المستوى max) نتيجة أقل بفارق 3 نقاط من GPT-6.1 Sol، ويعود السبب الرئيس إلى انخفاض نتيجته في SWE-Atlas-QnA-AA بمقدار 14 نقطة، ما يجعله أكثر عرضة لإغفال الحقائق الأساسية. وأما معدل الهلوسة الذي قاسته في AA-Omniscience (المستوى Max) فقد بلغ 55% لـ Sol. وليس لهذه الأرقام نظير لدى Fable، فلا تصلح سوى لفهم نقاط ضعف Sol بحد ذاته.
توصيات السيناريوهات لكل من GPT-6.2 Sol و Claude Fable 5.2
لا يقرر هذا القسم عنك أيهما تستخدم، بل يشرح فقط مجموعة البيانات التي ينبغي أن تبدأ بمراجعتها وفقًا لطبيعة كل مهمة.
المهام التي تبدأ فيها بمراجعة بيانات Claude Fable 5.2
- المهام المركّبة طويلة المدى عالية الصعوبة ومتعددة الخطوات: ابدأ بالاطلاع على النتيجة المركّبة من طرف ثالث. سجلت Fable نتيجة 65 في أعلى فئة استدلال ضمن Intelligence Index v5.0.1 لتحتل صدارة الترتيب، وهذه هي البيانات المركّبة المتاحة حاليًا للمقارنة المباشرة مع Sol.
- المشاريع التي تحتاج إلى الربط فورًا: نموذج
claude-fable-5-2متوفر بالفعل على APIYI، ويمكنك اختباره فورًا بعيناتك الخاصة. - المشاريع التي يلزم فيها مراعاة تكلفة التفكير: ميزة التفكير في Fable مُفعّلة افتراضيًا ولا يمكن إيقافها، ومستوى الجهد الافتراضي (effort) هو high، لذا ضع رموز التفكير (thinking tokens) ضمن حسابات ميزانيتك.
المهام التي تبدأ فيها بمراجعة بيانات GPT-6.2 Sol
- المهام اليومية والمهام الدفعية الحساسة للتسعير: ابدأ بالتسعير الرسمي للسياق القصير وقواعد Batch، ثم راجع نتائج المهام اليومية المعلَنة ذاتيًا من الشركة مثل LifeVal وGDPval v2.
- الطلبات التي تبقى في معظمها ضمن 272K: الفرق السعري بين مدخلات Sol ومخرجاته بنسبة الربع يظهر أساسًا في هذا النطاق.
- الفرق التي تستخدم ChatGPT Work أو Codex بالفعل: وفقًا للإعلان الرسمي، أصبحت الميزة متاحة اعتبارًا من اليوم لخطط Plus وPro وEnterprise وEdu، وتحصل خطة Pro 200 لأول مرة على وضع Ultrafast، متاحًا بدءًا من Sol.
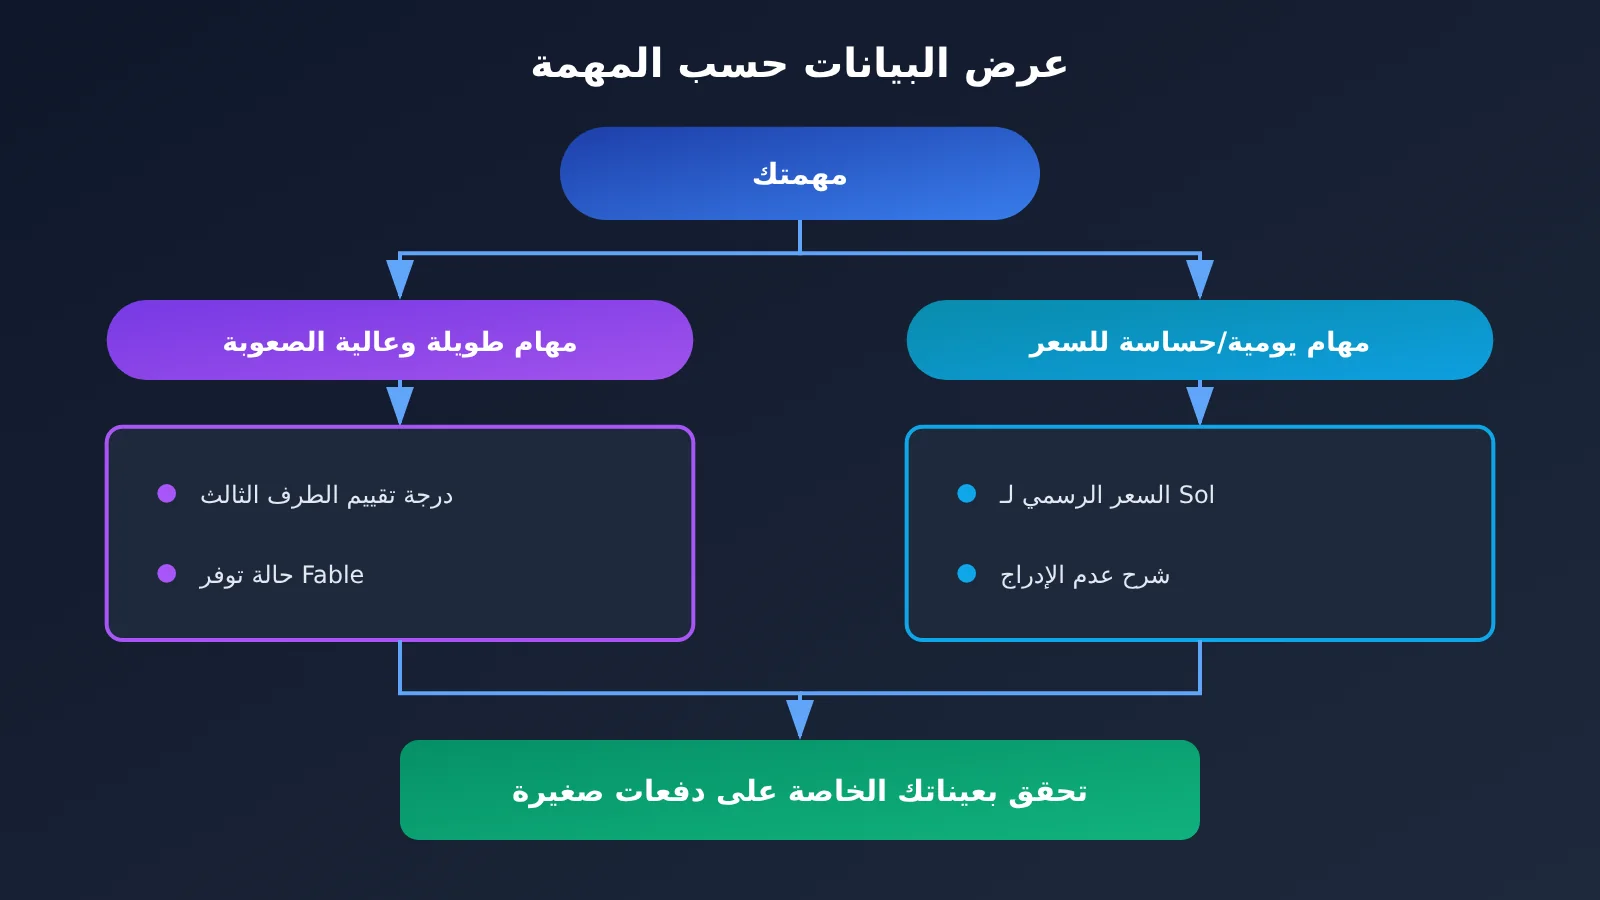
البدء السريع مع GPT-6.2 Sol وClaude Fable 5.2
يقدّم هذا القسم خطوات التنفيذ مرتّبة حسب نوع المهمة. لن تجد في المقال كله أي شيفرة برمجية؛ فأسماء النماذج والعناوين مذكورة داخل الجمل مباشرة.
المهام الطويلة عالية الصعوبة: ابدأ بمراجعة النتيجة الإجمالية لـ Fable ومدى توفره على المنصة. أنشئ مفتاح API من لوحة تحكم APIYI، ثم غيّر base URL في أي SDK متوافق مع OpenAI إلى https://api.apiyi.com/v1، واكتب في حقل model اسم النموذج claude-fable-5-2؛ وإذا كنت تفضّل اسمًا يشير صراحة إلى وضع التفكير، فيمكنك استخدام claude-fable-5-2-thinking. الأسعار المعلنة في الجدول الشامل هي $8 للإدخال و$40 للإخراج و$0.2 لقراءة الذاكرة المؤقتة، وهي مطابقة للأسعار الرسمية من Anthropic. ننصحك أن تبدأ بتشغيل 20 إلى 50 مهمة حقيقية من مهامك الخاصة لتسجيل معدل الإنجاز واستهلاك token، ثم تحكم بنفسك إن كانت الدرجة 65 ستنعكس فعلًا في حالة استخدامك.
المهام اليومية والحساسة للسعر: راجع الأسعار الرسمية المعلنة لـ Sol وإيضاح عدم طرحه بعد. الأسعار الرسمية المعلنة من OpenAI لنموذج GPT-6.2 Sol هي $2 للإدخال و$0.10 لقراءة الذاكرة المؤقتة و$10 للإخراج. النموذج لم يُطرح على المنصة حتى الآن، وسنوفره في أقرب وقت ممكن؛ واسم النموذج وسعره يُعتمدان وفق قائمة النماذج على المنصة. وقبل طرحه، تفقّد قائمة النماذج على apiyi.com بشكل دوري، ولا تستخدم النموذجين gpt-6.1-sol أو gpt-6-sol المتوفرين على المنصة بديلًا أثناء الاختبار، فهما ليسا الإصدار 6.2، كما أن سعر قراءة الذاكرة المؤقتة لـ gpt-6-sol مختلف أيضًا.
بعد طرح Sol، هناك ثلاث نقاط يجدر الانتباه إليها: لا يمكن ضبط reasoning effort على none؛ فعندما يتجاوز الإدخال 272K تُطبَّق زيادة سعرية على الطلب بأكمله؛ والنقاط النهائية الرسمية تدعم Chat Completions وResponses، أما نقاط النهاية على المنصة فاعتمد فيها على قائمة النماذج.
🚀 ابدأ بسرعة: يستطيع مفتاح API نفسه استدعاء نماذج من شركات متعددة على المنصة. ننصحك أولًا بتشغيل Fable على APIYI عبر موقع apiyi.com مستفيدًا من رصيد الاختبار المجاني، وتجهيز سكربتات التقييم والعينات مسبقًا، فبمجرد طرح Sol تستطيع استبدال اسم النموذج مباشرة وإجراء المقارنة على العينات نفسها.
توصيات لاتخاذ القرار بشأن GPT-6.2 Sol و Claude Fable 5.2
فيما يلي قائمة تحقق تساعدك على إعادة وضع هذه الأرقام في سياق مهامك الخاصة.
- تأكد أولاً من معيار القياس: هل الأرقام المُقتبسة هي درجات شاملة من أطراف ثالثة، أم نتائج فردية تعلنها الشركة الرسمية بنفسها، أم أسعار رسمية معلنة؟ لا تجمع الثلاثة معًا، ولا تحوّل بينها.
- تحقق من مستوى الاستدلال: درجة Sol البالغة 57 تعود إلى المستوى Max، أما مستوى High فيسجل 55، ولا يتجاوز مستوى Low الـ 41. اعتمد على درجة المستوى الذي ستستخدمه فعليًا.
- احسب التكلفة وفقًا لطول الطلب: في حدود 272K، يمكنك تقدير المدخلات والمخرجات وفق نسبة الربع؛ وبعد تجاوز 272K يجب إعادة الاحتساب وفق قواعد OpenAI لاحتساب الطلب بالكامل.
- احسب الذاكرة المؤقتة على حدة: القراءة من الذاكرة المؤقتة تكلّف $0.10 مقابل $0.20، أي أن الفرق بينهما يبلغ الضعف؛ كما تختلف مدة الاحتفاظ عند الكتابة فيها، لذا قدّر كلًّا منهما على حدة وفقًا لاستراتيجيتك الخاصة في التخزين المؤقت.
- تأكد من وجود مقارنة مباشرة: إذا كانت البيانات المتاحة للبند الذي يهمك تقتصر على Astra مقابل Fable أو Sol مقابل Astra، فلا يصح اعتبارها استنتاجًا عن Sol مقابل Fable.
- ضع سياسات الأمان في الحسبان: تقول الجهات الرسمية إن كلا الإصدارين 6.2 قد بلغ مستوى “الحرج” في الأمن السيبراني وفق إطار الاستعداد، والحماية فيهما أكثر صرامة، ما يعني أن بعض طلبات أبحاث الثغرات المشروعة قد تُرفض.
💡 توصية الاختيار: يعتمد اختيار النموذج على طول المهمة ومستوى الاستدلال ومعدل إصابة الذاكرة المؤقتة. يمكنك استدعاء النموذجين على منصة APIYI باستخدام نفس مجموعة العينات، ودع الفواتير ومعدلات الإتمام هي من يتحدث، دون الاعتماد على قائمة ترتيب واحدة.
الأسئلة الشائعة (FAQ)
س1: ما هما GPT-6.2 Sol و Claude Fable 5.2؟
GPT-6.2 Sol هو نموذج أصدرته OpenAI في 17 نوفمبر 2026 إلى جانب GPT-6.2 Astra، ومعرّف النموذج الخاص به هو `gpt-6.2-sol`، يقبل النصوص والصور كمدخلات وينتج نصوصًا كمخرجات، وتبلغ نافذة سياقه 1,050,000. أما Claude Fable 5.2 فهو نموذج أصدرته Anthropic في 9 نوفمبر 2026، بنافذة سياق تبلغ 1M وبحد أقصى للمخرجات قدره 128K، ويكون وضع التفكير فيه مفعّلًا افتراضيًا ولا يمكن إيقافه.
س2: هل تُثبت نتيجة 65 مقابل 57 في الترتيب الشامل أن Claude Fable 5.2 يتفوق على GPT-6.2 Sol في جميع الجوانب؟
لا. فنتيجة 65 مقابل 57 هي نتيجة مسجَّلة على مؤشر Artificial Analysis Intelligence Index v5.0.1 من طرف ثالث، حيث استخدم Fable أعلى مستوى استدلال بينما استخدم Sol مستوى Max. وتعكس هذه النتيجة المستوى الإجمالي لهذا المؤشر، ولا تعني بالضرورة أن كل بند فردي يُظهر هذا الفارق. أما في تقييم AA-3D البشري الأعمى بنظام Elo المنقول من المصادر الرسمية، فقد حصل Sol على 1259 وFable على 1271، والفارق هنا أصغر بشكل ملحوظ؛ وفي المعاينة البحثية AA-Robotics v0.1 من طرف ثالث، حصل Sol على 78 وFable على 75.
س3: هل سعر GPT-6.2 Sol هو حقًا ربع سعر Claude Fable 5.2؟
هذا صحيح فقط في حالة المدخلات والمخرجات ذات السياق القصير. وفقًا للأسعار المعلنة رسميًا، يبلغ سعر Sol مبلغ $2 للمدخلات و$10 للمخرجات، بينما يبلغ سعر Fable مبلغ $8 للمدخلات و$40 للمخرجات. لم يُدرَج النموذج بعد على المنصة، وسنعمل على إدراجه في أقرب وقت ممكن؛ ويكون معرّف النموذج والسعر خاضعَين لقائمة النماذج على المنصة. أما قراءة الذاكرة المؤقتة فتكلّف $0.10 مقابل $0.20، أي النصف؛ وعند تجاوز المدخلات حد 272K، تُفرض على Sol زيادة سعرية على الطلب بأكمله، وترتفع تكلفة المخرجات إلى 1.5 ضعف سعرها في السياق القصير، وعندها لم يعد ممكنًا الاعتماد على تقدير الربع.
س4: ما حجم الفرق بين GPT-6.2 Sol و Claude Fable 5.2 في FrontierCode 2.0؟
المواد الرسمية لا تتضمن هذه المقارنة أصلًا. فما يُقصد بعبارة «فرق أقل من 0.5 نقطة» في FrontierCode 2.0 هو المقارنة بين GPT-6.2 Sol و GPT-6.2 Astra، وكلاهما على مستوى Max، وتبلغ تكلفة Sol نحو الخُمس. أما Fable فلم يشارك في هذه المقارنة.
س5: كيف يمكن استدعاء GPT-6.2 Sol و Claude Fable 5.2 عبر API؟
الخطوات كالتالي:
1. سجّل في APIYI عبر apiyi.com واحصل على مفتاح API ورصيد اختبار مجاني.
2. اضبط قيمة base URL في أي SDK متوافق مع OpenAI على عنوان المنصة، واكتب في حقل model القيمة `claude-fable-5-2`، وبهذا تستطيع استدعاء Fable.
3. النموذج `gpt-6.2-sol` غير مدرَج حاليًا على المنصة، وبعد إدراجه يُعتمد في تحديد معرّف النموذج والسعر على قائمة النماذج في المنصة، ثم أجرِ الاختبار باستخدام نفس مجموعة العينات.
س6: ما القيود المعروفة لكل من GPT-6.2 Sol و Claude Fable 5.2؟
فيما يخص Sol: قاست الجهة المستقلة AA معدل الهلوسة عند المستوى Max بنسبة 55%، كما جاء مؤشر Coding Agent Index الخاص به أقل بـ 3 نقاط من GPT-6.1 Sol، ويرجع ذلك أساسًا إلى أنه أكثر عرضة لإغفال الحقائق الأساسية؛ ولا يمكن ضبط reasoning effort على none؛ وإجراءات الحماية السيبرانية أكثر صرامة، إذ قد تُرفض بعض أبحاث الثغرات المشروعة. وفيما يخص Fable: لا يمكن إيقاف التفكير، وقيمة effort الافتراضية هي high، وتُحتسب توكنات التفكير ضمن التكلفة؛ أما سعر الوحدة لوضع Fast mode فهو $16 للمدخلات و$80 للمخرجات.
Q7: تقول الجهة الرسمية إن تكلفة Astra لا تتجاوز 5% فقط من تكلفة Fable، فهل يمكن موازنة ذلك مع $26.54 التي وردت من الجهة المستقلة؟
لا. نسبة «نحو 5%» هي تكلفة اختبار Agents’ Last Exam كما أعلنتها الشركة رسميًا، والمقارنة فيها بين Astra وFable؛ أما $26.54 فهي تكلفة المهمة الواحدة لـ Fable عند تشغيل Artificial Analysis للمؤشر الشامل. المهمتان مختلفتان والمصدران مختلفان، فلا يمكن القسمة بينهما، ولا استخدامهما لاستنتاج تكلفة Sol. وإذا كنت تريد فقط معرفة الحجم التقريبي للتكلفة، فمن الأكثر موثوقية تسجيل الفواتير الفعلية بعيناتك الخاصة على منصة APIYI.
GPT-6.2 Sol وClaude Fable 5.2: النقاط الأساسية (Key Takeaways)
- النتيجة الإجمالية: في مؤشر الجهة المستقلة AA، سجّل Fable في أعلى مستوى استدلال 65 نقطة، مقابل 57 نقطة لـ Sol عند المستوى Max، وهما مقارنة مباشرة على قائمة الترتيب نفسها.
- السعر المعلن: في المدخلات والمخرجات قصيرة السياق، يعادل سعر Sol ربع سعر Fable ($2 مقابل $8، و$10 مقابل $40).
- قراءة الكاش: $0.10 مقابل $0.20، أي فرق النصف فقط، فلا يمكن تطبيق قاعدة الربع هنا.
- السياق الطويل: عندما تتجاوز مدخلات Sol 272K، يُطبَّق سعر إضافي على الطلب كاملًا، ولم تعد النسبة الأصلية صالحة.
- المقارنات المباشرة قليلة: في المواد الرسمية يوجد بند واحد فقط لمقارنة Sol بـ Fable، وهو AA-3D بنتيجة 1259 مقابل 1271.
- لا تنسب النتائج خطأً: FrontierCode 2.0 تقارن Sol بـ Astra، بينما ALE وHarvey تقارنان Astra بـ Fable.
- التوفر: يمكن استدعاء Fable مباشرة عبر APIYI على apiyi.com، أما Sol فلم يُدرَج بعد، وقائمة النماذج هي المرجع المعتمد.
الخلاصة
عند المقارنة بين GPT-6.2 Sol و Claude Fable 5.2، المهم هو الفصل بين الأرقام في طبقاتها الثلاث:
- الدرجة الإجمالية من جهة خارجية: حصل Fable على 65، وSol (Max) على 57، وتُستخدم لتحديد الفئة العامة التي يقع فيها كل نموذج.
- الأسعار الرسمية المعلنة: في السياق القصير، يختلف سعر الإدخال والإخراج بنحو الربع، وسعر قراءة الذاكرة المؤقتة يختلف بنحو النصف، أما السياق الطويل فيُحتسب على حدة وفق قواعد كل نموذج.
- المهام الفردية: معظم النتائج الرسمية الفردية ليست مقارنة مباشرة بين Sol وFable، فتأكد قبل الاستشهاد بأي رقم مَن الطرفان المُقارَنان فعليًا.
لا يمكن دمج فرق الدرجات وفرق الأسعار في جملة واحدة من نوع «أيهما يستحق أكثر». والأسلوب الأكثر أمانًا هو استخدام عيناتك الخاصة، وتثبيت مستوى الاستدلال نفسه، وتسجيل معدل الإنجاز والفاتورة لكل نموذج على حدة. يمكنك اختبار Fable الآن على APIYI عبر apiyi.com؛ أما GPT-6.2 Sol فلم يُطرح بعد على المنصة، وسنعمل على إتاحته في أقرب وقت ممكن، ويُعتمد في تحديد الإصدارات والأسعار على قائمة النماذج في المنصة.
📚 المراجع
-
بيان إصدار OpenAI: ملاحظات إصدار GPT-6.2 Astra وSol والنتائج الفردية المبلّغ عنها رسميًا
- الرابط:
openai.com/index/introducing-gpt-6-2-astra-sol - الوصف: ملخص النتائج الفردية التي أبلغ عنها المطور رسميًا، ونطاق التوفر، والأسعار المعلنة
- الرابط:
-
صفحة نموذج OpenAI – GPT-6.2 Sol: المواصفات والأسعار وقواعد تسعير 272K
- الرابط:
platform.openai.com/docs/models/gpt-6.2-sol - الوصف: تُعتمد هذه الصفحة مرجعًا لسعر الكتابة في الذاكرة المؤقتة، والرسوم الإضافية للسياق الطويل، ومضاعفات الفئة المسرّعة
- الرابط:
-
بطاقة نظام OpenAI: تقييم أمان GPT-6.2 Astra وSol
- الرابط:
deploymentsafety.openai.com/gpt-6-2-astra-sol - الوصف: تصنيف إطار الجاهزية وتقييمات المواءمة
- الرابط:
-
مقالة Artificial Analysis وصفحة النموذج: مؤشر الذكاء Intelligence Index v5.0.1 من جهة خارجية
- الرابط:
artificialanalysis.ai/models/claude-fable-5-2 - الوصف: الدرجات الإجمالية بفئاتها، وتكلفة المهمة الواحدة، ومؤشر Coding Agent Index
- الرابط:
-
وثائق Anthropic – Claude Fable 5.2: الأسعار الرسمية والمواصفات
- الرابط:
platform.claude.com/docs/en/models/fable-5-2/overview - الوصف: الكتابة في الذاكرة المؤقتة وقراءتها، وإعدادات Fast mode ومستوى effort
- الرابط:
-
الجدول الكامل لنماذج APIYI: الإصدارات والأسعار المتوفرة على المنصة
- الرابط:
docs.apiyi.com/models.md - الوصف: وقت البيانات 2026-11-17 15:54 (UTC+8)، ويُعتمد في تحديد الإصدارات والأسعار على قائمة النماذج في المنصة
- الرابط:
المؤلف: الفريق التقني في APIYI
للتواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI، ولمزيد من الإصدارات وشرح الواجهات البرمجية، يمكنكم الرجوع إلى مركز التوثيق على docs.apiyi.com