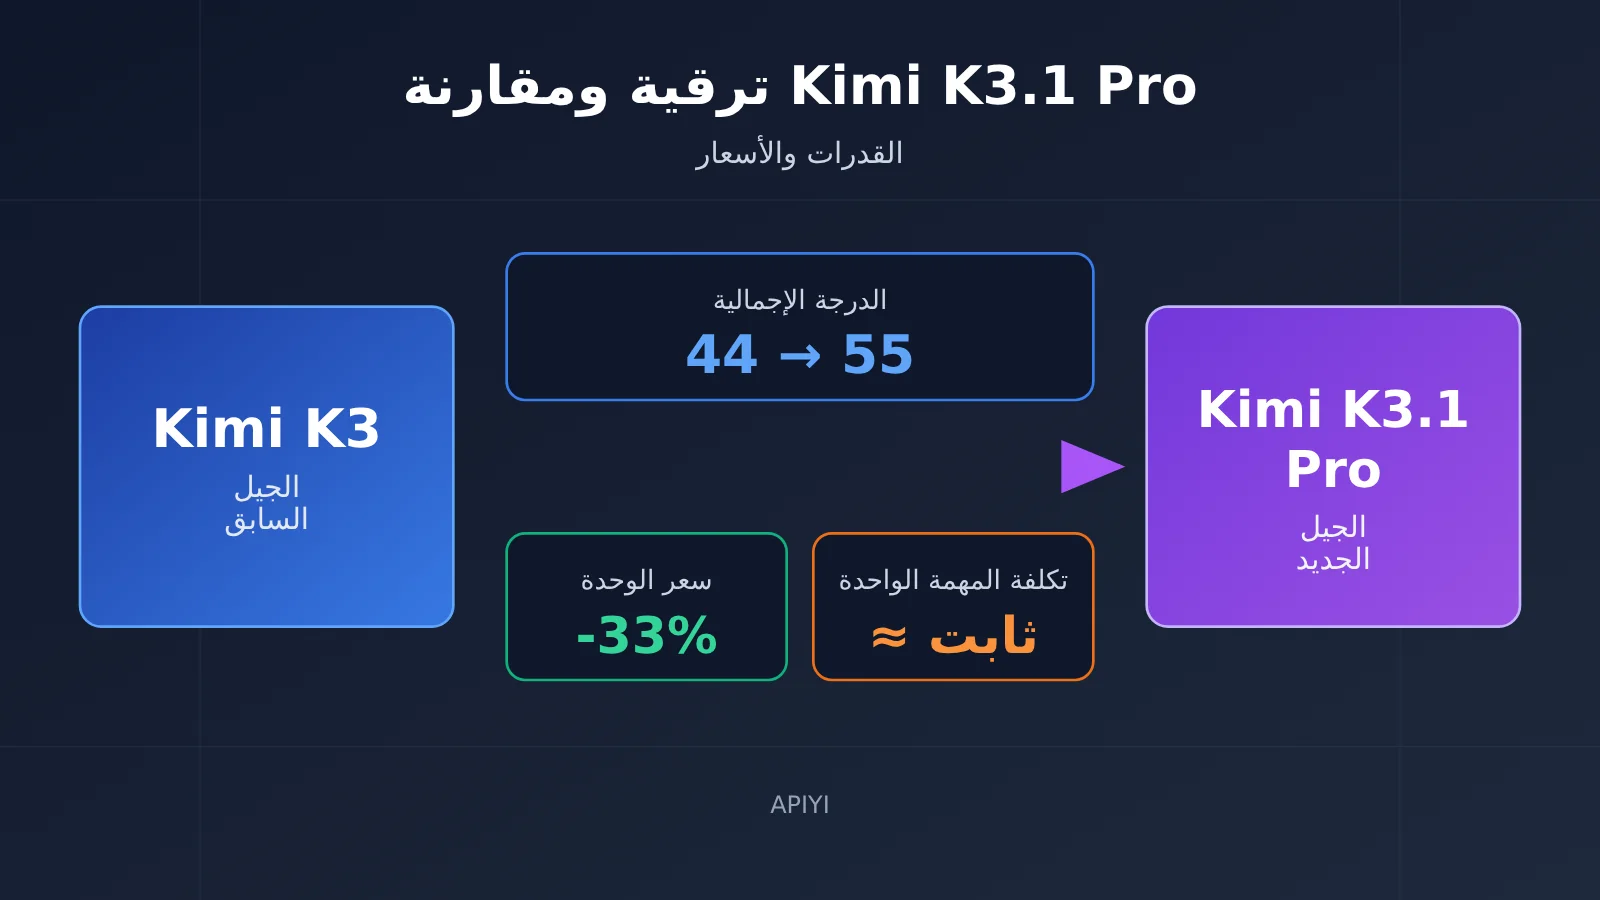
من حيث القدرات، يحقق Kimi K3.1 Pro تحسنًا ملحوظًا مقارنةً بـ K3: فقد ارتفعت درجته الإجمالية، وفقًا لجهة التقييم المستقلة Artificial Analysis، من 44 إلى 55، كما قفزت نتيجته في Terminal-Bench 4.0، وهو معيار تقييم لوكلاء البرمجة الذين يستخدمون الطرفية، من 13% إلى 67%. وفي المقابل، انخفضت الأسعار بنحو الثلث؛ فسعر الوحدة للمدخلات والمخرجات والذاكرة المؤقتة أقل بنسبة 33% مقارنةً بـ K3. لكن مخرجاته أطول، كما أنه يفكر باستمرار، لذا تبقى تكلفة تنفيذ المهمة الواحدة قريبة من تكلفة K3.
فيما يلي الأدلة، مع تصنيف مصدر كل معلومة ضمن ثلاث فئات: «بيانات رسمية معلنة ذاتيًا»، و«مصادر مستقلة»، و«غير متحقق منها». هذا المقال ليس إعادة سرد لفعالية الإطلاق، ولا يدعو الجميع إلى التبديل فورًا. هدفه مساعدة المطورين الذين يستخدمون K3 على تحديد ما إذا كان ينبغي نقل أعمالهم إليه، ومتى يفعلون ذلك، وما الذي ينبغي الانتباه إليه أثناء الانتقال.
1. خمسة فروق جوهرية بين Kimi K3.1 Pro والجيل السابق
K3.1 Pro ليس نموذجًا جديدًا دُرّب من الصفر، بل خضع لعملية «تدريب لاحق» واسعة النطاق استنادًا إلى K3. ويُقصد بالتدريب اللاحق تعديل طريقة عمل النموذج بعد تدريب النموذج الأساسي، باستخدام مزيد من البيانات والتغذية الراجعة. وتصفه الشركة رسميًا بأنه «أول نموذج في سلسلة K3.1» و«أقوى نموذج مفتوح الأوزان من فئة 3T». وتعني الأوزان المفتوحة أن ملفات معاملات النموذج ستُتاح للعامة، بحيث يمكن تنزيلها ونشر النموذج ذاتيًا. وتُقدّر Artificial Analysis إجمالي عدد المعاملات بـ 2.8T، فيما يبلغ عدد المعاملات النشطة المشاركة فعليًا في كل عملية حسابية 104B.
| البُعد | Kimi K3 | Kimi K3.1 Pro | المصدر |
|---|---|---|---|
| أسلوب التدريب | الإصدار الأساسي | تدريب لاحق استنادًا إلى K3، مع زيادة كبيرة في القدرة الحاسوبية المخصصة للتدريب اللاحق | إفصاح رسمي |
| القدرات العامة | مؤشر الذكاء 44 | 55، في المركز الرابع على مستوى القائمة | جهة خارجية (AA، 2026-10-23) |
| السعر | الإدخال $3 / الإخراج $15 | الإدخال $2 / الإخراج $10، أي أقل بنسبة 33% | الأسعار الرسمية |
| حجم المخرجات لكل مهمة | متوسط 48K من الرموز (tokens) | متوسط 55K من الرموز، بزيادة 14% | جهة خارجية (AA) |
| السياق / الوسائط | 1M / نصوص+صور | 1M / نصوص+صور، من دون تغيير | إفصاح رسمي |
الرموز (tokens) هي الوحدات الأساسية التي تُستخدم في احتساب تكلفة النموذج وقياس مخرجاته. ويمكن فهمها تقريبًا على أنها «أجزاء من الكلمات»؛ إذ يقابل الحرف الصيني الواحد عادةً رمز واحد أو رمزان. عند قراءة الجدول، ركّز أولًا على التغييرين الأبرز: ارتفعت درجة القدرات، وانخفض السعر. أما عمود «حجم المخرجات لكل مهمة» فيوضح مقدار التوفير الفعلي بعد خفض السعر، وسنتناوله بالتفصيل في القسم الرابع.
أما بالنسبة إلى الأوزان، فقد تعهّدت الشركة رسميًا بإتاحة الأوزان الكاملة قبل 2026-11-04. وبحسب التاريخ الحالي (2026-10-24)، لا يزال هذا التعهّد قائمًا ولم يُنفّذ بعد، لذا تظل هذه المعلومة «غير مؤكدة». وترى Artificial Analysis أنه بعد إتاحة الأوزان، سيصبح K3.1 Pro أعلى نموذج مفتوح الأوزان تقييمًا على قائمتها، كما ستتقلص الفجوة بين أعلى النماذج مفتوحة الأوزان وأعلى النماذج مغلقة المصدر من 12 نقطة إلى 3 نقاط.
2. مقارنة نتائج Kimi K3.1 Pro: بين الأرقام التي أعلنتها الشركة ونتائج الجهات المستقلة
تجدر الإشارة أولًا إلى أن الجدولين أدناه يستندان إلى جهات مختلفة وبيئات اختبار مختلفة، لذا لا يصحّ الجمع بينهما أو المقارنة المباشرة بين نتائجهما. وأوضح مثال على ذلك اختبار Terminal-Bench 4.0: أعلنت الشركة رسميًا عن نتيجة قدرها 65.7%، بينما سجّلت Artificial Analysis، وهي جهة مستقلة، 67%. هاتان نتيجتان لاختبارين منفصلين، وليستا هامش خطأ في نتيجة واحدة. كما لم تعلن الشركة رسميًا عن نتيجة K3 في Terminal-Bench 4.0؛ أما نتيجة K3 البالغة 13%، فمصدرها الوحيد هو Artificial Analysis.
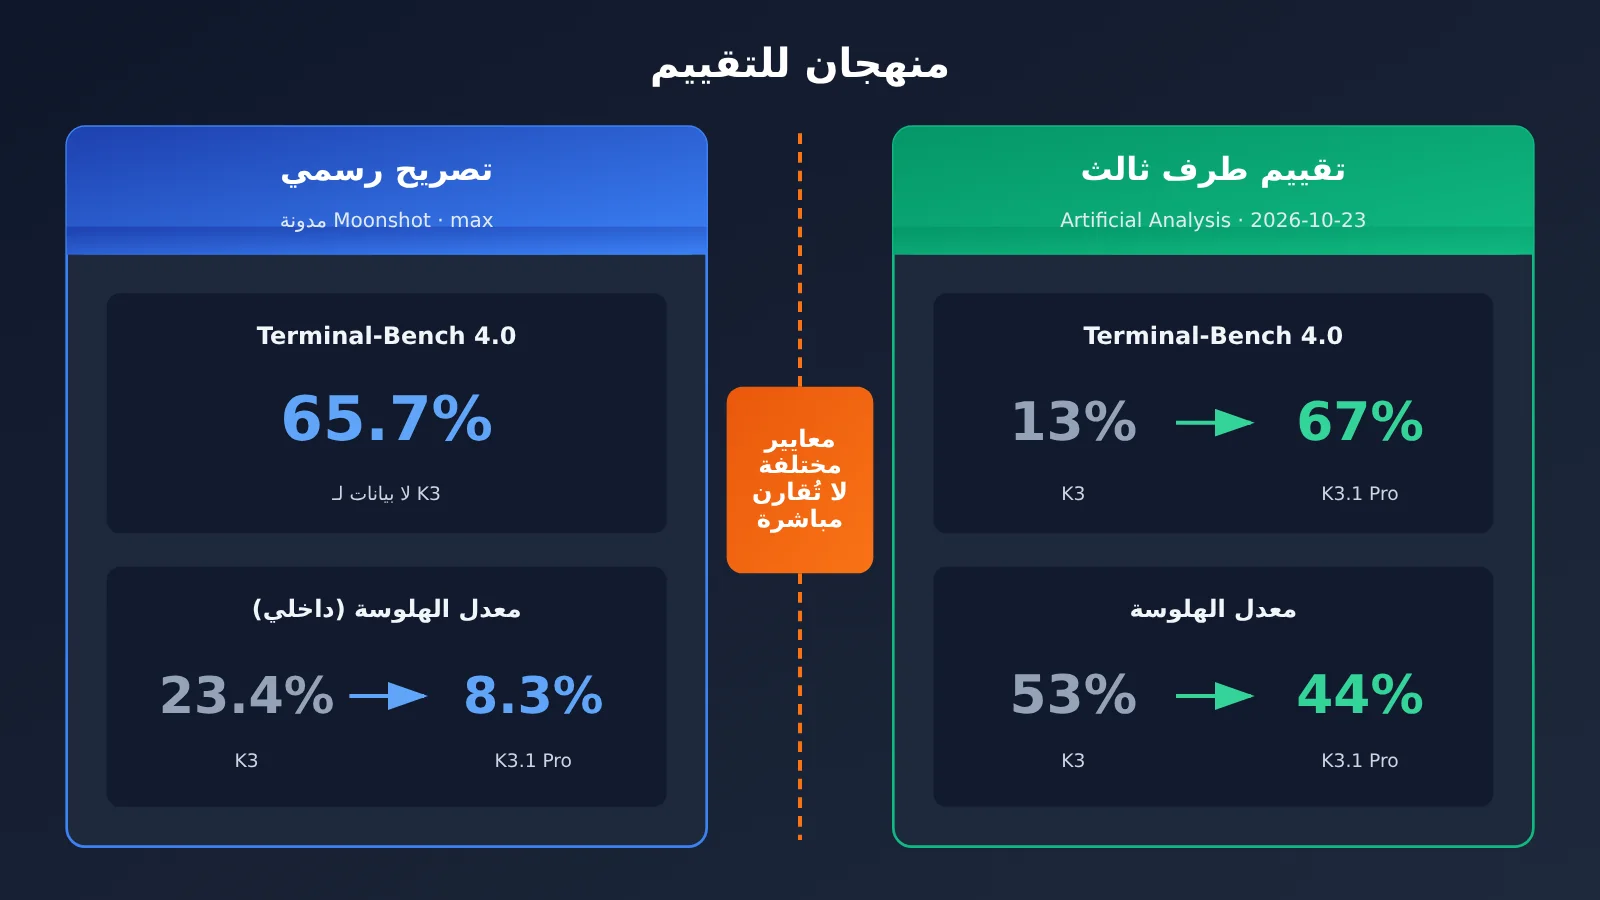
2.1 النتائج التي أعلنتها Kimi K3.1 Pro رسميًا
المصدر: مدونة Moonshot الرسمية. شروط الاختبار: ما لم يُذكر خلاف ذلك، أُجريت جميع الاختبارات باستخدام reasoning_effort=max (أي ضبط قوة الاستدلال على الحد الأقصى)، وtemperature=1.0، وtop_p=0.95. أما الاختبارات الموسومة بـ«داخلي»، فتُجرى على مجموعات اختبار أنشأتها Moonshot، ولا يمكن للجهات الخارجية إعادة إجرائها.
| الاختبار | K3.1 Pro | المقارنة | ملاحظات |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | GPT-6 Astra: 58.2%، وClaude Opus 5.5: 66.4% | شُغّل Opus 5.5 باستخدام إطار عمل Claude Code |
| Kimi Code Bench 3.0 Long-horizon | 61.2% | K3: 55.95% | اختبار داخلي لمهام برمجية متعددة المراحل |
| BenchCAD | 92.7% (مع الأدوات) | Opus 5.5: 96.2%، وGPT-6 Astra: 95.9% | تحويل الرسومات متعددة المناظر إلى شيفرة CAD |
| OfficeQA Pro v2 | 64.4 | يتفوق على K3 | تحليل مستندات مالية حقيقية؛ وتقول الشركة إنه يحقق أداءً رائدًا في المجال (SOTA) |
| Financial Modeling / Research | أعلى من K3 بمقدار 7.2 / 11.6 نقطة | K3 | داخلي |
| Business Operation | نحو 4.2 أضعاف نتيجة K3 | K3 | محاكاة داخلية لإدارة الأعمال |
| Kimi Hallu Bench Hard | معدل الهلوسة على مستوى الادعاء: 8.3% | K3: 23.4% | اختبار داخلي مكثف لقياس صحة المعلومات |
| xdev-bench-hard (pass@3) | 81.0% | إصدار المقارنة غير المنقّى أمنيًا: 90.5% | اكتشاف الثغرات |
بعض المصطلحات: يشير harness إلى «إطار قيادة» يُضاف حول النموذج أثناء الاختبار، ويتولى استدعاء الأدوات وتنفيذ الأوامر. وقد تتغير النتيجة بتغيّر هذا الإطار، لذا ينبغي النظر إلى نتيجة Opus 5.5 في هذا الاختبار على حدة. أما pass@3، فتعني منح النموذج ثلاث محاولات للإجابة عن السؤال، واحتساب الإجابة صحيحة إذا نجح في إحداها. والمقصود بالسطر الأخير أن الشركة خفّضت عمدًا، لأسباب تتعلق بالسلامة، قدرة النموذج على اكتشاف الثغرات؛ إذ جاءت نتيجة الإصدار الرسمي أقل بنحو 9.5 نقاط مئوية من نتيجة الإصدار الداخلي غير المقيّد.
2.2 نتائج Kimi K3.1 Pro في اختبارات جهات خارجية (Artificial Analysis)
المصدر: Artificial Analysis، بتاريخ 2026-10-23. نفّذت الجهة الاختبارات وفق إجراءات موحّدة، واستخدمت المنهجية نفسها مع K3 وK3.1 Pro.
| المعيار | K3.1 Pro | K3 | التغيير |
|---|---|---|---|
| Intelligence Index | 55 (المرتبة 4) | 44 | +11 |
| GDPval-AA (تقييم Elo لمهام العمل الواقعية) | 1846 (المرتبة 3) | 1534 | +312 |
| Terminal-Bench 4.0 | 67% | 13% | +54 نقطة مئوية |
| AutomationBench-AA (سير عمل SaaS) | 73% | 58% | +15 |
| Humanity’s Last Exam | 52% | 47% | +5 |
| CritPt / SciCode | 25% / 61% | 23% / 59% | +2 / +2 |
| AA-Omniscience Index | 30 | 20 | +10 |
| معدل الهلوسة / الدقة | 44% / 51% | 53% / 48% | انخفاض الهلوسة 9 نقاط |
| متوسط عدد الرموز الناتجة لكل مهمة | 55K | 48K | +14% |
يحتل K3.1 Pro المرتبة الرابعة في قائمة Artificial Analysis، بعد Claude Opus 5.5 (58) وClaude Sonnet 5.5 (56) وMuse Wonder Full (56). وتُعد نسبة 67% في Terminal-Bench 4.0 أعلى نتيجة سجلتها الجهة بين جميع النماذج التي اختبرتها، بينما حقق Sonnet 5.5 نسبة 64%.
تتفق نتائج الاختبارين في اتجاهها العام بشأن الهلوسة، لكن قيمها تختلف كثيرًا: ففي اختبار الضغط الداخلي الرسمي، انخفض المعدل من 23.4% إلى 8.3%، بينما سجّل AA انخفاضًا من 53% إلى 44%. استخدم الطرفان مجموعتين مختلفتين من الأسئلة، كما اختلفت صعوبة الاختبارات وطرق احتساب النتائج. عند الاستشهاد بهذه الأرقام، يُرجى ذكر المصدر بوضوح، وعدم دمجها في عبارة واحدة مثل «انخفض معدل الهلوسة إلى 8%».
3. خمسة مجالات حقق فيها Kimi K3.1 Pro تحسنًا ملحوظًا
يتناول هذا القسم المجالات التي تشير فيها مجموعتا البيانات إلى تحسن، أو التي كان التحسن فيها كبيرًا بما يكفي.
- وكلاء البرمجة والمهام الطرفية. الوكيل هو مساعد ذكاء اصطناعي يستطيع تقسيم المهمة بنفسه، واستخدام الأدوات، وتنفيذ خطوات متعددة. سجّل AA ارتفاعًا في نتيجة Terminal-Bench 4.0 من 13% إلى 67%، كما ارتفعت نتيجة الاختبار الداخلي الرسمي للبرمجة متعددة الخطوات من 55.95% إلى 61.2%. إذا كنت تستخدم K3 لتشغيل وكيل برمجة وتواجه كثيرًا تعثرًا في تنفيذ الأوامر أو التعامل مع الملفات أو استكشاف الأخطاء وإصلاحها عبر خطوات متعددة، فهذا هو المجال الذي يظهر فيه التحسن الأكبر.
- مهام العمل الواقعية. يقيس GDPval-AA مستوى أداء النموذج في إنجاز المهام المهنية الواقعية باستخدام نقاط Elo. وElo نظام لترتيب المتنافسين؛ يُستخدم مثلًا في تصنيف لاعبي الشطرنج، وكلما زاد فارق النقاط اتسع تفاوت فرص الفوز. يتقدم K3.1 Pro على K3 بـ312 نقطة، ويحتل المرتبة الثالثة، ما يشير إلى تحسن ملحوظ في المهام اليومية مثل كتابة الخطط وإعداد الجداول وتنظيم المواد.
- أتمتة سير العمل في البرمجيات كخدمة (SaaS). يقيس AutomationBench-AA قدرة النموذج على تنفيذ إجراءات آلية عبر أنواع مختلفة من البرامج عبر الإنترنت، مثل قراءة البريد الإلكتروني وتعديل تذاكر الدعم ومزامنة الجداول. وقد ارتفعت النتيجة من 58% إلى 73%. كما بلغت نتيجة الاختبار الداخلي الرسمي لمحاكاة إدارة الأعمال (Business Operation) نحو 4.2 أضعاف نتيجة K3، ما يشير بدوره إلى تحسن القدرة على تنفيذ سير عمل طويل. لكن هذه البيانات داخلية، لذا ينبغي التعامل معها على أنها مرجعية فقط.
- الدقة الواقعية والهلوسة. تعني الهلوسة أن يختلق النموذج حقائق غير موجودة بثقة. في الاختبارات الداخلية الرسمية، انخفض معدل الهلوسة على مستوى الادعاء (أي احتساب كل تقرير واقعي على حدة) من 23.4% إلى 8.3%، وأصبح عدد الإجابات التي تحتوي على خطأ واقعي واحد على الأقل يعادل 42.4% فقط من عددها لدى K3. أما معدل الهلوسة لدى AA فانخفض من 53% إلى 44%، وارتفعت الدقة من 48% إلى 51%.
- النمذجة المالية والبحوث المالية. أفادت الشركة بأن نتيجة OfficeQA Pro v2 بلغت 64.4، وهي الأفضل حاليًا (SOTA). كما تجاوز K3.1 Pro نتيجة K3 في الاختبارين الداخليين Financial Modeling وFinancial Research بمقدار 7.2 و11.6 نقطة على التوالي. لم تُعَد هذه النتائج بعد بصورة مستقلة من جهات خارجية، لذا تندرج ضمن فئة «النتائج المعلنة رسميًا».
تحسنت أيضًا مؤشرات الاستدلال العلمي، مثل Humanity’s Last Exam وCritPt وSciCode، لكن التحسن لم يتجاوز 2 إلى 5 نقاط مئوية. إذا كان عملك يتركز على الإجابة عن الأسئلة الأكاديمية أو كتابة الشفرات العلمية، فمكاسب K3.1 Pro ليست بقدر التحسن في مهام الوكلاء؛ لذلك لا داعي للاستعجال في الانتقال لمجرد هذه النتائج.
4. ما لم يتغير كثيرًا في Kimi K3.1 Pro والتكلفة الفعلية
4.1 ثلاثة أمور لم تتغير في Kimi K3.1 Pro
- نافذة السياق ما زالت مليون رمز: 1,048,576 رمزًا، مثل K3. ويمكن فهم السياق على أنه إجمالي المحتوى الذي يستطيع النموذج «قراءته» في المرة الواحدة.
- المدخلات ما زالت نصوصًا وصورًا: لم تُضف مدخلات صوتية أو مرئية.
- لم تعلن الشركة رسميًا عن معايير لقياس السرعة: قاست AA سرعة إخراج بلغت 80.7 رمزًا في الثانية، ما يضعها في المستوى الثاني ضمن تصنيف المؤسسة ذي المستويات الأربعة. وتقول الشركة إن إصدار highspeed أسرع بمقدار مرتين إلى ثلاث مرات، لكنها لم تقدم شروط اختبار يمكن تكرارها؛ لذلك نعدّ هذا الادعاء «غير مُتحقق منه» حتى الآن.
4.2 مقارنة الأسعار ضمن الفئات الخمس لـ Kimi K3.1 Pro
فيما يلي الأسعار الرسمية، جُمعت في 2026-10-24، بالدولار لكل مليون token، ولا تشمل الضرائب.
| النموذج | الإدخال | الإخراج | إصابة ذاكرة التخزين المؤقت | الكتابة لمدة 5 دقائق | الكتابة لمدة ساعة |
|---|---|---|---|---|---|
kimi-k3.1-pro |
$2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
kimi-k3 |
$3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
تعني إصابة ذاكرة التخزين المؤقت إعادة إرسال محتوى متطابق في بدايته، مثل موجه نظام ثابت أو المستند الطويل نفسه؛ ابتداءً من المرة الثانية، تُحتسب تكلفته بسعر أقل. أما الكتابة لمدة 5 دقائق أو ساعة، فهي رسوم تخزين المحتوى في ذاكرة التخزين المؤقت، وكلما طالت مدة التخزين ارتفعت التكلفة. وتؤدي الذاكرة المؤقتة دورًا مهمًا في تطبيقات الوكلاء الذكية أو الإجابة عن الأسئلة حول المستندات الطويلة. وإذا كان هيكل الموجه ثابتًا، فقد توفر كثيرًا من تكلفة جزء الإدخال في الفاتورة.
4.3 تكلفة Kimi K3.1 Pro: انخفاض السعر لا يعني توفيرًا في التكلفة
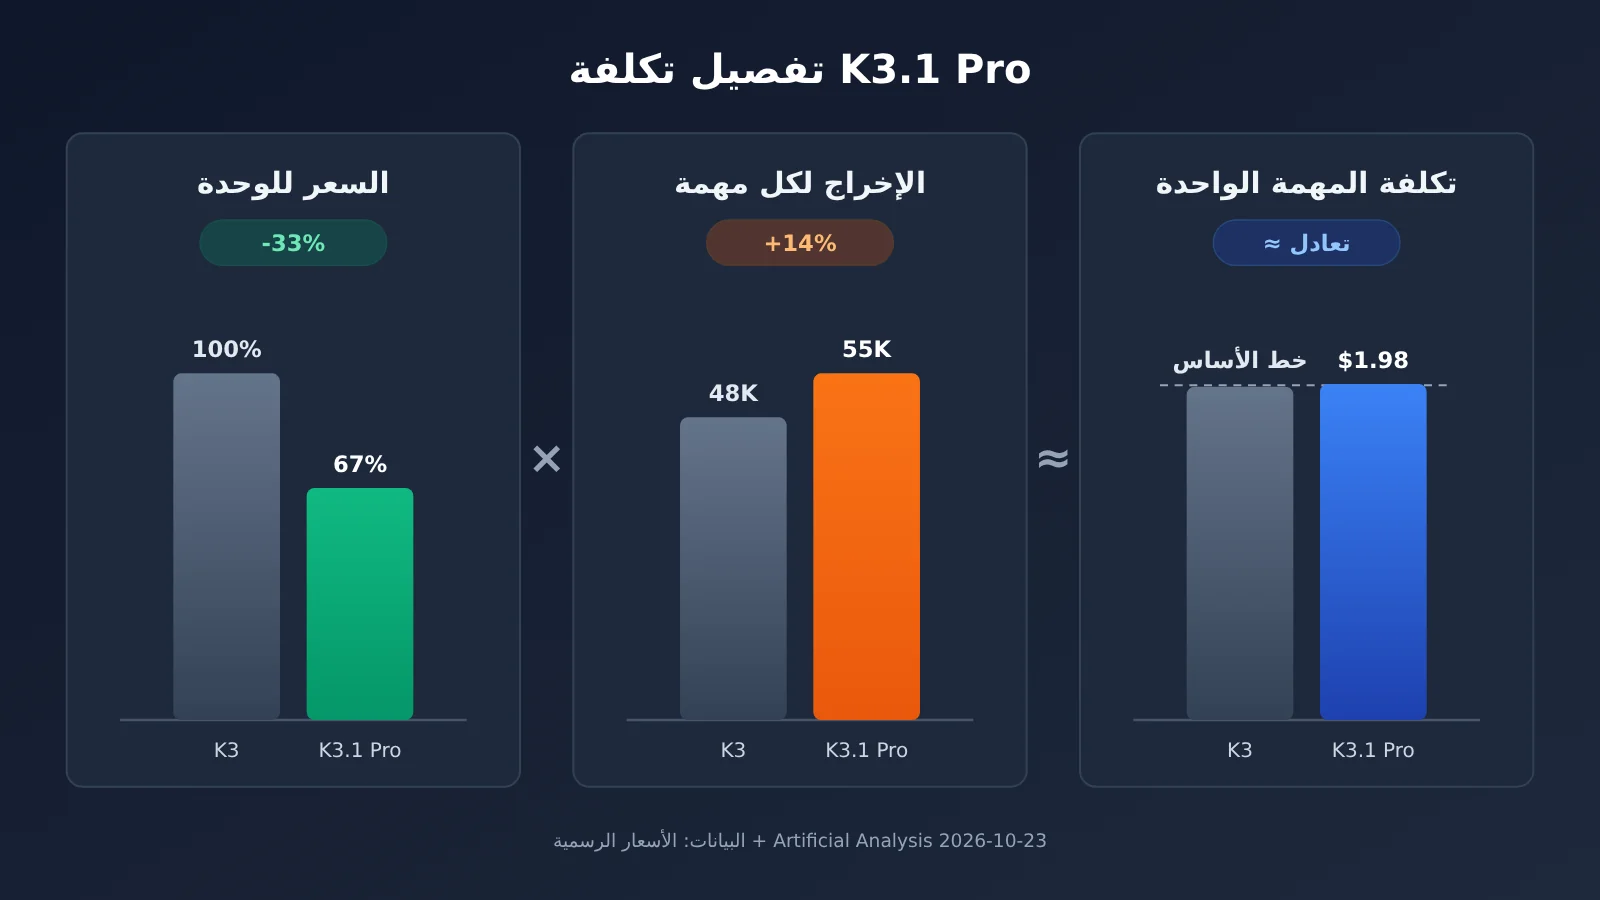
يعمل K3.1 Pro بالتفكير المستمر، أي إنه يجري استدلالًا داخليًا قبل كل إجابة، وتُحتسب هذه العملية ضمن tokens الإخراج. ووفقًا لقياسات AA، يبلغ متوسط الإخراج لكل مهمة 55K tokens، أي أكثر بنسبة 14% من K3 الذي يبلغ متوسطه 48K.
بحساب السعر لكل token، يُفترض أن يؤدي خفض السعر بنسبة 33% إلى توفير ملحوظ، لكن القياس الفعلي الذي أجرته AA أظهر أن تكلفة المهمة الواحدة تبلغ نحو $1.98 (في حين تعرض صفحة تفاصيل النموذج $2.11)، أي إنها تكاد تعادل تكلفة K3. لم تنشر المؤسسة تفاصيل توزيع التكلفة، لذا لا يوجد حتى الآن تفسير رسمي لسبب عدم تحقق التوفير. ومن الاحتمالات أن تزداد tokens الإدخال أيضًا خلال استدعاءات الوكيل المتعددة المراحل، لكن هذا مجرد تخمين و«غير مُتحقَّق منه».
كذلك، يبلغ سعر إصدار highspeed ضعف سعر الإصدار القياسي. لذا ننصح الفرق التي تهتم بالتكلفة بتجربة عينة من مهامها الفعلية قبل التبديل، ومقارنة إجمالي الإنفاق بدلًا من الاكتفاء بمقارنة سعر كل token.
إذا أردت مقارنة التكلفة الفعلية لـ K3 وK3.1 Pro باستخدام قاعدة الشفرة نفسها، يمكنك البدء بدمج واجهة API المتوافقة مع OpenAI من APIYI apiyi.com، وتشغيل kimi-k3 للحصول على خط أساس. يُرجى الرجوع إلى قائمة النماذج على المنصة لمعرفة اسم النموذج وسعر K3.1 Pro؛ وسنعمل على إتاحة هذا النموذج في أقرب وقت.
5. توصيات استخدام Kimi K3.1 Pro: متى ينبغي الترقية ومتى لا داعي للاستعجال؟
فيما يلي توصيات بحسب نوع المهمة، لمستخدمي K3 الحاليين.
| نوع المهمة | التوصية | السبب |
|---|---|---|
| وكلاء البرمجة وأتمتة الطرفية | يُنصح بالترقية قريبًا | ارتفعت نتيجة Terminal-Bench 4.0، وفق اختبار جهة خارجية، من 13% إلى 67%، وتجاوز التحسن الرسمي في البرمجة متعددة الخطوات 5 نقاط |
| تحليل المستندات والتقارير البحثية والنمذجة المالية | يُنصح بالترقية | ارتفعت نتيجة GDPval Elo بمقدار 312 نقطة، وتفوّق النموذج في جميع الاختبارات الرسمية المتعلقة بالتقارير المالية والبحثية، مع انخفاض واضح في الهلوسة |
| سير عمل SaaS والعمليات التجارية متعددة الخطوات | يُنصح بالترقية | ارتفعت نتيجة AutomationBench-AA من 58% إلى 73% |
| المهام الصغيرة المجمّعة، مثل التصنيف والاستخراج وإعادة الصياغة | لا داعي للاستعجال | تكلفة المهمة الواحدة مماثلة لـ K3، لكن التفكير المستمر يزيد حجم المخرجات، ولا يفيد تحسن القدرات كثيرًا في المهام البسيطة |
| السيناريوهات الحساسة للتأخير، مثل المحادثات الفورية وخدمة العملاء عبر الإنترنت | اختبر أولًا ثم قرر | لا تتوفر بيانات رسمية عن السرعة، وقد يؤدي التفكير المستمر إلى إطالة زمن ظهور أول كلمة، بينما يتضاعف السعر عند استخدام وضع highspeed |
عدم الحاجة إلى الاستعجال لا يعني أن K3 غير مناسب. فهو يؤدي الغرض بالفعل في المهام البسيطة، كما أن زمن الاستجابة والتكلفة أسهل في التوقع. لذلك لا داعي لإعادة بناء خط معالجة المهام المجمّعة بالكامل لمجرد الحصول على نتيجة إجمالية أعلى. يمكنك الانتظار حتى تتوفر أوزان K3.1 Pro وبيانات أكثر اكتمالًا عن سرعته من جهات خارجية، ثم إعادة التقييم.
5.1 سيناريوهات مناسبة لاختيار Kimi K3.1 Pro
- إصلاح الأخطاء وإعادة هيكلة الشيفرة وكتابة الاختبارات على مستوى مستودع برمجي، عندما تحتاج إلى أن ينفّذ النموذج الأوامر بنفسه، ويفحص الأخطاء، ثم يجري التعديلات.
- طرح الأسئلة وتلخيص التقارير المالية والعقود والتقارير البحثية الطويلة، عندما تكون الدقة في الحقائق مهمة.
- أتمتة عمليات تعتمد على عدة أدوات عبر الإنترنت، وتتطلب أكثر من عشر خطوات للمهمة الواحدة.
5.2 سيناريوهات مناسبة للإبقاء مؤقتًا على Kimi K3
- تصنيف مئات الآلاف من السجلات يوميًا أو استخراج الحقول منها، مع احتساب التكلفة بحسب عدد السجلات.
- التفاعلات الفورية التي تتطلب زمن استجابة منخفضًا ومستقرًا، بعد ضبط إعدادات المهلة الزمنية وإعادة المحاولة خصيصًا لـ K3.
نصيحة للاختيار: الطريقة الأكثر موثوقية هي اختبار 50 إلى 100 عينة حقيقية من أعمالك على كلا النموذجين، ثم مقارنة نسبة إنجاز المهام والتكلفة الإجمالية. تتيح لك APIYI عبر apiyi.com التبديل بين نماذج مختلفة باستخدام مفتاح API واحد، ما يجعلها مناسبة لهذا النوع من الاختبارات المقارنة. قبل إطلاق K3.1 Pro، يمكنك استخدام
kimi-k3لتحديد خط أساس. أما اسم طراز K3.1 Pro وسعره، فسيُحددان وفقًا لقائمة الطرز على المنصة، وسنطرحه في أقرب وقت ممكن.
6. توصيات واحتياطات اتخاذ قرار الانتقال إلى Kimi K3.1 Pro
6.1 الجدول الزمني لإيقاف سلسلة Kimi K2
إذا كنت لا تزال تستخدم نماذج سلسلة K2، فابدأ بمعالجة هذا الأمر. توضح الوثائق الرسمية أن سلسلة K2 لن تكون متاحة للمستخدمين الجدد اعتبارًا من 2026-10-31، وسيُوقف العمل بها بالكامل قبل نهاية عام 2026. ورغم أن المستخدمين الحاليين سيتمكنون من استخدامها مؤقتًا، فمن الأفضل إتمام الانتقال خلال الشهرين المقبلين، والانتقال مباشرةً إلى K3 أو K3.1 Pro، بدلًا من الانتظار حتى اقتراب موعد الإيقاف.
6.2 ثلاث نقاط أساسية عند التبديل إلى Kimi K3.1 Pro
- ابدأ جلسة جديدة، ولا تبدّل النموذج في أثناء الجلسة. توصي الشركة باستخدام K3.1 Pro في جلسة جديدة؛ إذ قد يؤدي نقل سجل محادثة قائم مع K3 إلى K3.1 Pro ومتابعة العمل فيه إلى مشكلات في توافق تنسيق السياق أو محتوى التفكير.
- استخدم الواجهات الأصلية كلما أمكن. ترى الشركة أن واجهات Responses وChat Completions وMessages الأصلية هي الأكثر استقرارًا.
- تأكد من كتابة اسم النموذج بدقة. إذا أخطأت في كتابة
kimi-k3.1-proعند إدخاله في أداة خارجية، فسيعود الطلب إلى K2.8 Preview، ولن ينفّذ النموذج التفكير. لن يظهر خطأ؛ لكن جودة النتائج ستتراجع، ما يجعل اكتشاف المشكلة يستغرق وقتًا طويلًا. يُنصح بالتحقق من حقل النموذج في الاستجابة قبل الإطلاق.
6.3 اختلاف مستويات العضوية في Kimi Code
يتطلب استخدام النماذج الجديدة في Kimi Code مستوى عضوية معينًا:
- يتطلب
k3.1-proعضوية Plus أو أعلى. - يتطلب سياق 1M عضوية Pro أو أعلى.
- يتطلب إصدار highspeed عضوية Pro أو أعلى، ويستهلك نحو ضعف الحصة.
تتيح عضوية Plus استخدام K3.1 Pro، لكنها لا توفر سياق 1M كاملًا. إذا كنت تعتمد أساسًا على السياق الطويل جدًا لقراءة مستودع الشفرة بالكامل، فتحقق من مستوى عضويتك قبل أن تقرر الترقية.
6.4 قائمة التحقق للربط عبر API
- عيّن
base_urlإلىhttps://api.apiyi.com/v1، وهو عنوان API المتوافق مع OpenAI لدى APIYI عبر apiyi.com. لن تحتاج إلى تغيير سوى هذا الحقل والمفتاح في الشفرة الحالية التي تستخدم OpenAI SDK. - ابدأ بتشغيل
kimi-k3للتحقق من سير العمل، ثم أدخل الاسم الدقيق لنموذج K3.1 Pro وفقًا لقائمة النماذج في المنصة. يُرجى الرجوع إلى القائمة لمعرفة اسم النموذج وسعره؛ وسنطرح هذا النموذج في أقرب وقت ممكن. - اضبط مهلة الانتظار على مدة أطول قليلًا؛ فالتفكير المستمر قد يجعل الاستجابة الواحدة أبطأ.
- لا تضبط
max_tokensعلى قيمة منخفضة جدًا، وإلا فقد يشغل محتوى التفكير مساحة الإخراج المخصصة للنص الأساسي.
الأسئلة الشائعة
س1: ما هو Kimi K3.1 Pro، وما علاقته بـ K3؟
K3.1 Pro إصدار جديد من Moonshot، طُوّر بزيادة موارد الحوسبة المخصصة للتدريب اللاحق مقارنةً بـ K3. وتصفه الشركة بأنه أول نموذج ضمن سلسلة K3.1. نافذة السياق وأنماط الإدخال فيه مماثلة لـ K3، بينما تتركز التحسينات أساسًا في وكلاء البرمجة، ومهام العمل الفعلية، ودقة الحقائق.
س2: ما نتيجة Kimi K3.1 Pro في Terminal-Bench، هل هي 65.7% أم 67%؟
كلتا النتيجتين صحيحة، لكن مصدرهما مختلف: 65.7% هي النتيجة التي أعلنتها الشركة، بينما 67% قاستها جهة Artificial Analysis بشكل مستقل. تختلف بيئة الاختبار وأدوات التقييم، لذا لا يمكن اعتبار النتيجتين نتيجة واحدة. يُرجى ذكر المصدر عند الاقتباس.
س3: انخفض سعر Kimi K3.1 Pro بنسبة 33%، فلماذا لا أوفّر المال؟
يفكر النموذج باستمرار، ويُخرج في المتوسط لكل مهمة نصًا أكثر بنسبة 14% مقارنةً بـ K3. وتُقدّر Artificial Analysis تكلفة المهمة الواحدة بنحو $1.98 في الاختبارات الفعلية (بينما تذكر صفحة النموذج $2.11)، وهي تكلفة مماثلة تقريبًا لـ K3. لم توضّح الجهة أسباب ذلك بالتفصيل، لذا يُنصح باختباره على مهامك الخاصة.
س4: متى ستُتاح أوزان Kimi K3.1 Pro؟
تعهّدت الشركة بإتاحة الأوزان الكاملة قبل 2026-11-04. وحتى 2026-10-24، لا يزال ذلك مجرد تعهّد لم يُنفّذ بعد. إذا كنت تخطط للنشر الذاتي، فاعتمد على ما تنشره الشركة فعليًا.
س5: كيف أقارن بسرعة بين Kimi K3.1 Pro وK3 عبر API؟
يمكنك التسجيل في APIYI على apiyi.com للحصول على مفتاح API ورصيد مجاني للاختبار، ثم استخدام واجهة متوافقة مع OpenAI لتجربة `kimi-k3` بوصفه خط أساس. يُرجى الرجوع إلى قائمة النماذج على المنصة لمعرفة اسم نموذج K3.1 Pro وسعره. سنوفر هذا النموذج في أقرب وقت، وبعد إطلاقه يمكنك المقارنة بتغيير قيمة المعامل `model` فقط.
س6: ما القيود المعروفة في Kimi K3.1 Pro؟
– لم تنشر الشركة اختبارات معيارية للسرعة، كما أن سعر إصدار highspeed مضاعف.
– يفكر النموذج باستمرار، لذا فهو غير مناسب للسيناريوهات التي تتطلب زمن استجابة منخفضًا جدًا.
– تستند بعض النتائج اللافتة إلى مجموعات اختبار داخلية، ولا يمكن للجهات الخارجية إعادة إنتاجها.
– تخضع قدرات اكتشاف الثغرات لقيود أمنية، وهي أقل من قدرات الإصدار غير المنقّى.
س7: ما زلت أستخدم K2، فهل ينبغي أن أنتقل مباشرةً إلى K3.1 Pro؟
سيُغلق التسجيل في سلسلة K2 للمستخدمين الجدد اعتبارًا من 2026-10-31، وستُوقف الخدمة قبل نهاية العام، لذا لا بد من الانتقال. يمكن نقل خدمات وكلاء البرمجة ومعالجة المستندات مباشرةً إلى K3.1 Pro، بينما يكون استخدام K3 أسهل للمهام الصغيرة المجمّعة. يمكنك البدء بإتمام عملية الانتقال باستخدام `kimi-k3` على APIYI عبر apiyi.com. يُرجى الرجوع إلى قائمة النماذج على المنصة لمعرفة اسم نموذج K3.1 Pro وسعره. سنوفر هذا النموذج في أقرب وقت.
النقاط الرئيسية حول Kimi K3.1 Pro
- تحسّن ملحوظ في القدرات: ارتفعت النتيجة الإجمالية في AA من 44 إلى 55، ليحتل المركز الرابع، بعد ثلاثة نماذج مغلقة المصدر.
- أكبر تحسّن كان في وكيل البرمجة: ارتفعت نتيجة الاختبارات العملية التي أجراها طرف ثالث على Terminal-Bench 4.0 من 13% إلى 67%.
- يجب التمييز بين مجموعتي البيانات: تختلف البيانات التي تنشرها الشركة عن نتائج AA؛ لذا يجب ذكر المصدر عند الاقتباس.
- خفض السعر لا يعني خفض التكلفة: انخفض سعر الوحدة 33%، لكن تكلفة المهمة الواحدة بقيت قريبة من مستواها في K3.
- المواصفات الأساسية لم تتغير: نافذة سياق بسعة 1M، ودعم النصوص والصور، ولا تتوفر بيانات رسمية عن السرعة.
- احرص على كتابة اسم النموذج بدقة عند الترحيل: فالخطأ في الاسم يؤدي إلى الرجوع إلى K2.8 Preview من دون تفعيل التفكير.
- طريقة الربط: يمكنك البدء باستخدام APIYI عبر apiyi.com لاختبار خط أساس K3. يُرجى الرجوع إلى قائمة النماذج على المنصة لمعرفة اسم نموذج K3.1 Pro وسعره؛ وسنطرحه في أقرب وقت.
الخلاصة: هل يستحق Kimi K3.1 Pro الترحيل من K3؟
يمكن تلخيص الفروق بين Kimi K3.1 Pro والجيل السابق في ثلاث نقاط:
- القدرات: تحسّن أداء وكيل البرمجة ومهام الطرفية ومهام العمل الواقعية وأتمتة البرمجيات كخدمة (SaaS) والدقة الواقعية بوضوح. وتتفق نتائج الجهات الخارجية والبيانات الرسمية في هذا الاتجاه.
- السعر: انخفض سعر الوحدة في الفئات الخمس كلها بنسبة 33% مقارنةً بـ K3، لكن التفكير المستمر يؤدي إلى مخرجات أطول، لذلك لم تنخفض تكلفة المهمة الواحدة كثيرًا.
- الترحيل: يُنصح بالانتقال سريعًا إلى النموذج الجديد للأعمال التي تعتمد على وكيل البرمجة أو معالجة المستندات والتقارير البحثية. أما المهام الصغيرة المنفذة على دفعات والسيناريوهات الحساسة لزمن الاستجابة، فيمكن اختبار النموذج فيها أولًا قبل اتخاذ القرار. وعلى مستخدمي K2 إتمام الترحيل قبل نهاية العام.
توفّر APIYI عبر apiyi.com حاليًا نماذج Kimi، مثل kimi-k3 (الإدخال $3 / الإخراج $15). ويمكنك استخدام المفتاح نفسه وواجهة متوافقة مع OpenAI لإنشاء خط أساس للتكلفة والأداء. يُرجى الرجوع إلى قائمة النماذج على المنصة لمعرفة اسم نموذج Kimi K3.1 Pro وسعره؛ سنطرحه في أقرب وقت، وبعد إتاحته يمكنك استبدال اسم النموذج مباشرةً ومقارنة النتائج.
المراجع
- المدونة الرسمية لـ Moonshot: إعلان إطلاق Kimi K3.1 Pro ونتائج الاختبارات المعيارية التي نشرتها الشركة
- ملاحظة: مصدر بيانات فئة «النتائج المعلنة رسميًا» في هذه المقالة. أُجريت الاختبارات بالإعدادات
reasoning_effort=maxوtemperature=1.0وtop_p=0.95. - الوثائق الرسمية لـ Moonshot: الأسعار، والجدول الزمني لإيقاف K2، وتوصيات التبديل بين النماذج، وتفاصيل عضوية Kimi Code
- ملاحظة: جُمعت الأسعار في 2026-10-24، وهي بالدولار لكل مليون token، ولا تشمل الضرائب.
- Artificial Analysis: تقييم مستقل للنماذج من جهة خارجية
- الرابط:
artificialanalysis.ai - ملاحظة: مصدر بيانات فئة «الجهات الخارجية» في هذه المقالة، والبيانات مؤرخة في 2026-10-23.
الكاتب: فريق APIYI التقني
للتواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI. ويمكنكم الاطلاع على مزيد من مواد التكامل في مركز الوثائق على docs.apiyi.com. يُرجى الرجوع إلى قائمة النماذج على المنصة لمعرفة طراز Kimi K3.1 Pro وسعره، وسنعمل على إتاحة هذا النموذج في أقرب وقت.