著者注:GPT-6.2 Sol は前世代の Standard トークン価格を踏襲し、複数の公開テストでスコアを向上させ、あるいはタスクあたりのコストを低減しました。既存システムをアップグレードする前に、コードベースQ&A、複雑な分析、マルチターン会話を個別に検証する必要があります。
まず結論から:GPT-6.2 Sol の短いコンテキストにおける Standard 単価は GPT-6.1 Sol と完全に一致し、総合評価ではスコアが高く、タスクあたりのコストも低くなっています。ただし、コードベースQ&Aと一部の難問では明確な失点が確認されました。 両者とも100万トークンあたりの通常入力、キャッシュ読み取り、出力の価格はそれぞれ $2、$0.10、$10 です。Artificial Analysis の Max ティアの総合スコアは55から57に上昇し、平均タスクコストは $1.27 から $1.01 に低下しました。一方、同機関のコードエージェントテストでは、コードベースQ&Aのサブ項目が60から46に低下し、Plotly のデータ分析テストも満点の43/43から40/43に落ちました。
したがって、今回のアップグレードはタスク種別ごとに段階的に進めるのが適しており、全体を一括で置き換えるのはおすすめしません。検証可能なコード修正、ターミナル操作、定型的な分析は先行して試験運用できます。コードベースQ&A、隠れた規則性を見つける類の難問、Flex に依存するバッチ処理については、先にリグレッションテストを追加する必要があります。また、GPT-6.2 の Responses API はマルチターン会話と指示の位置に関して挙動が変わっており、旧バージョンのマルチターンアプリケーションはモデルIDを変えるだけでは済みません。
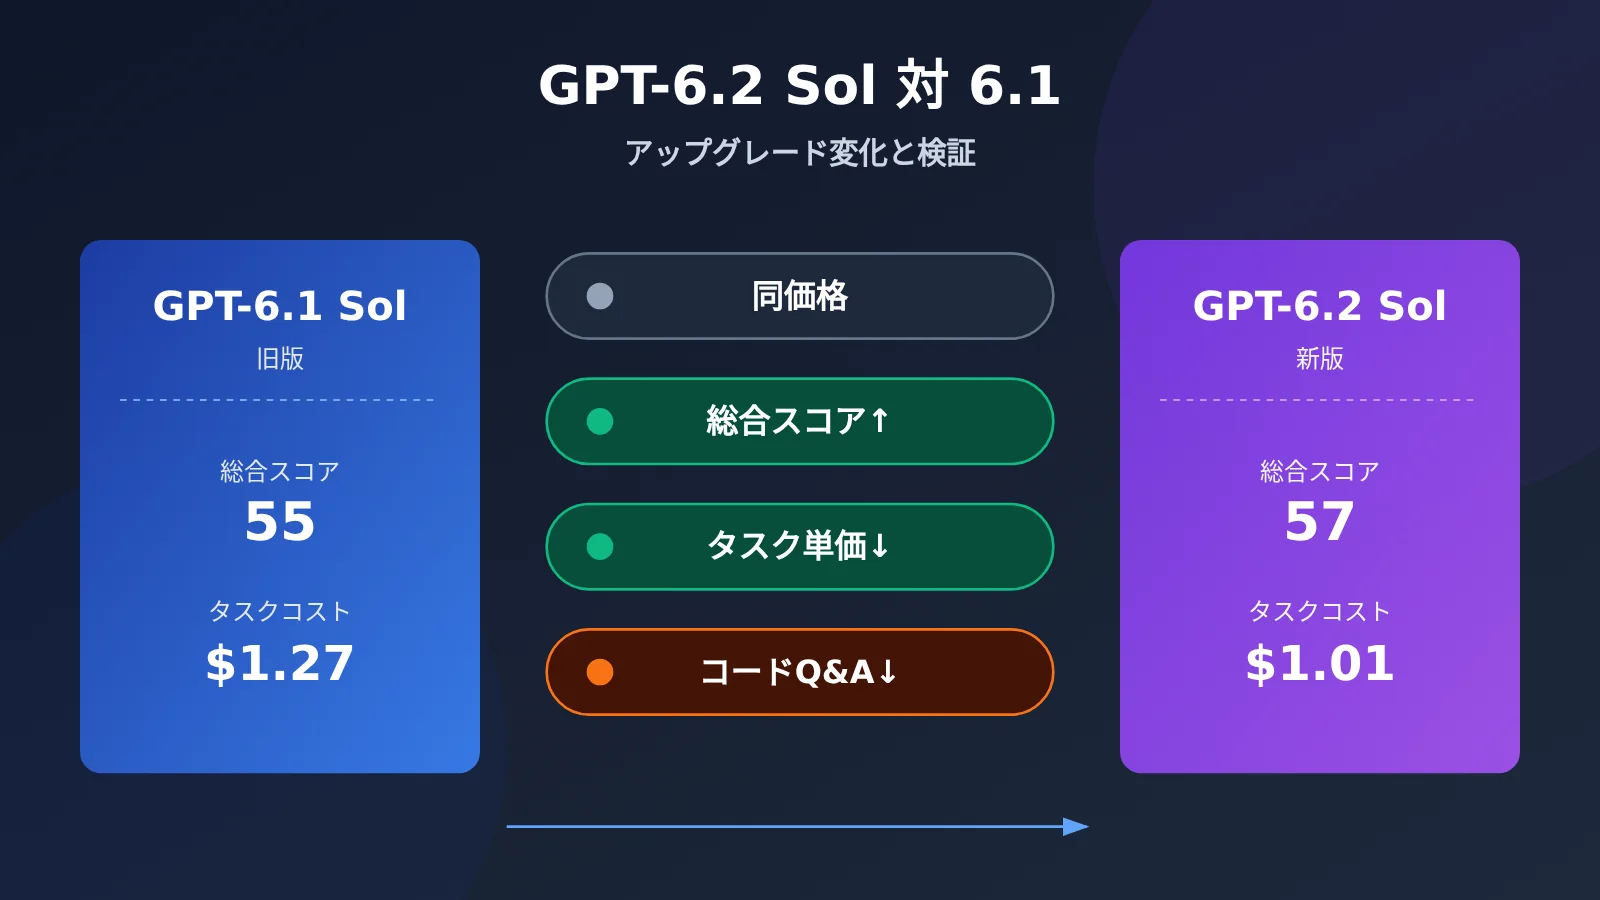
GPT-6.2 Sol と GPT-6.1 Sol の比較早見表
下表には、アップグレード判断に役立つ項目だけを掲載しています。仕様と価格は OpenAI 公式のモデルカード、価格ページ、更新ログに基づくもので、価格の単位はすべて USD / 100万トークンです。
| 比較項目 | GPT-6.1 Sol | GPT-6.2 Sol | 差分が意味するもの |
|---|---|---|---|
| モデル ID / リリース日 | gpt-6.1-sol / 2026-09-29 |
gpt-6.2-sol / 2026-11-17 |
新モデルはリリース直後で、しばらく様子を見る必要がある |
| コンテキスト / 最大出力 | 1,050,000 / 128,000 | 1,050,000 / 128,000 | 容量は変わらない |
| 最大入力 | モデルカードに単独記載なし | 922,000 | 超長文入力のタスクは新しい上限で確認が必要 |
| 知識カットオフ | 2026-04-30 | 2026-06-01 | 約1か月後ろにずれた |
| 短コンテキストの Standard 価格 | 入力 $2 / キャッシュ読み込み $0.10 / 出力 $10 | 同じ | トークンの組み合わせが同じなら請求額も同じ |
| Flex 処理 | 対応 | 非対応 | 旧 Flex ユーザーは別の処理方法に切り替える必要がある |
| バックグラウンド割引ウィンドウ | 今回の資料では未言及 | 2時間ウィンドウ -30%、8時間ウィンドウ -40% | 遅延を許容できるタスクには新たなコスト削減の選択肢 |
| 総合スコア(AA、Max 設定) | 55 | 57 | 全体としてやや強くなった |
| コードベース Q&A(AA、Codex + Max) | 60 | 46 | 明確に後退、専用の受け入れテストが必要 |
🚀 クイック比較:2世代のモデルは同じインターフェース上で切り替えて比較できます。APIYI apiyi.com の公開モデル一覧には
gpt-6.2-solがすでに収録されており、responses と chat の2つのエントリが明記されているため、同じ APIキーで新旧バージョンの回帰比較を実行するのに適しています。
読む順序の提案:本文の第1節ではまず価格と処理オプションを確認してください。これが請求の基準を決めるためです。第2節では公開テストにおける進歩と失点を比較し、どのタスクがアップグレードに値するかを判断します。第3節では API の挙動変化を確認し、既存サービスをスムーズに切り替えられるかを見ます。第4節ではタスク別の受け入れテスト方案を示します。プログラミングエージェントだけに関心がある場合は、2.2 と第4節を直接読んでください。
GPT-6.2 Sol の比較でまず知っておきたい用語
| 用語 | 簡潔な説明 |
|---|---|
| 標準トークン価格 | OpenAI の Standard 設定における、100万トークンあたりの入力・出力・各種キャッシュ利用量の公開価格 |
| タスクコスト | 1つのタスクを完了するために発生するモデル料金とツール料金。業務の受け入れ時には再実行や人手による再確認も加算できる |
| 推論レベル | モデルの推論予算を制御する設定。一般的な値は Low、Medium、High、Xhigh、Max で、横断テストではレベルを揃える必要がある |
| GDPval v2 | OpenAI 内部の複雑な知識作業の評価。実際のプロジェクト種類に由来する長いワークフローの納品に注目する |
| Coding Agent Index | Artificial Analysis がコード修正、ターミナル操作、コードベース Q&A などのサブ項目から算出するエージェント総合指標 |
| SWE-Atlas-QnA-AA | 上記指標のうちコードベース Q&A のサブ項目。回答に必要な事実が揃っているかを評価する |
| 会話プレフィックス / キャッシュ読み込み | マルチターンリクエストの冒頭で順序を一致させておく内容。サービス側が再利用可能なプレフィックスを識別すると、ヒット部分は読み込み料率で課金される |
1. GPT-6.2 Sol と GPT-6.1 Sol の比較:基本仕様と価格
1.1 GPT-6.2 Sol の仕様は基本的に前世代を引き継ぐ
両世代のモデルは Responses と Chat Completions のどちらからでも呼び出せます。関数呼び出しと組み込みツールは Responses の経路を使います。どちらもテキストと画像の入力を受け付け、ネイティブでテキストを出力し、コンテキストウィンドウは同じ 1,050,000 token、最大出力も同じ 128,000 token です。6.2 Sol のモデルカードでは、最大入力 922,000 token が別途記載されています。
ポジショニングには微妙な違いがあります。6.1 Sol のモデルページは、Astra より低いコストで複雑なコード、コンピュータ操作、専門的なタスクをこなすことを強調しています。一方、6.2 Sol のモデルページは日常的なコードと、規模を拡大したエージェント作業に寄っています。つまり 6.2 Sol は、高頻度・バッチ処理の場面をより明確に想定しています。
1.2 GPT-6.2 Sol の Standard 価格は前世代と同じ
公式の Standard 課金は次のとおりです。両世代とも 1 リクエストあたりの入力 272K token を境界とし、超えた場合はそのリクエスト全体の入力料金とキャッシュ料金が 2 倍、出力が 1.5 倍で計算されます。
| Standard 課金区分 | 短いコンテキスト(≤272K) | 長いコンテキスト(>272K) |
|---|---|---|
| 通常入力 | $2.00 | $4.00 |
| キャッシュ読み取り | $0.10 | $0.20 |
| 30 分キャッシュ書き込み | $2.50 | $5.00 |
| 12 時間キャッシュ書き込み | $5.00 | $10.00 |
| 出力(推論 token を含む) | $10.00 | $15.00 |
単価が同じでも、請求額が同じとは限りません。同じタスクを完了する場合でも、6.2 Sol では出力 token、ツール呼び出し回数、キャッシュヒットの状況が変わり得るため、実際の費用はタスクごとに計算する必要があります。キャッシュ書き込みはそれぞれの完全な料率で計算し、同じ token に対して通常入力の価格を重ねて加算しないでください。出力の総量は Responses の usage.output_tokens から取得でき、推論の使用量は通常 output_tokens_details.reasoning_tokens のサブ項目に記載されます。
国内からの呼び出しについて:2026-11-20 時点で、APIYI apiyi.com の公開価格インターフェースにおける gpt-6.2-sol の短いコンテキスト枠の価格は公式と一致しており、長いコンテキスト枠の通常入力、キャッシュ読み取り、キャッシュ書き込み、出力はそれぞれ $3、$0.15、$3.75、$11.25 です。これは公開されている表記上の計算式であり、実際の請求はアカウントグループとプラットフォームの現在の設定に基づきます。
1.3 Flex とバックグラウンド割引枠の使い分け
処理オプションの変化はもっとも見落とされやすい点です。6.1 Sol は依然として Flex の対象リストに含まれていますが、6.2 Sol は Flex をサポートしていません。代わりに、6.2 Sol では Responses のバックグラウンド割引枠を利用できます。条件を満たすリクエストでは、モデル token の料率が 2 時間枠で Standard より 30% 低く、8 時間枠で 40% 低くなります。
旧システムが Flex に依存してオフラインバッチ処理を実行している場合、移行時には納期とアクセス条件に応じて選び直す必要があります。数時間以内の納品で問題ないタスクはバックグラウンド枠を検討でき、即時の応答が必要なタスクは Standard 課金しか選択肢がありません。
2. GPT-6.2 Sol と GPT-6.1 Sol の比較:公開テストで見えた前進と後退
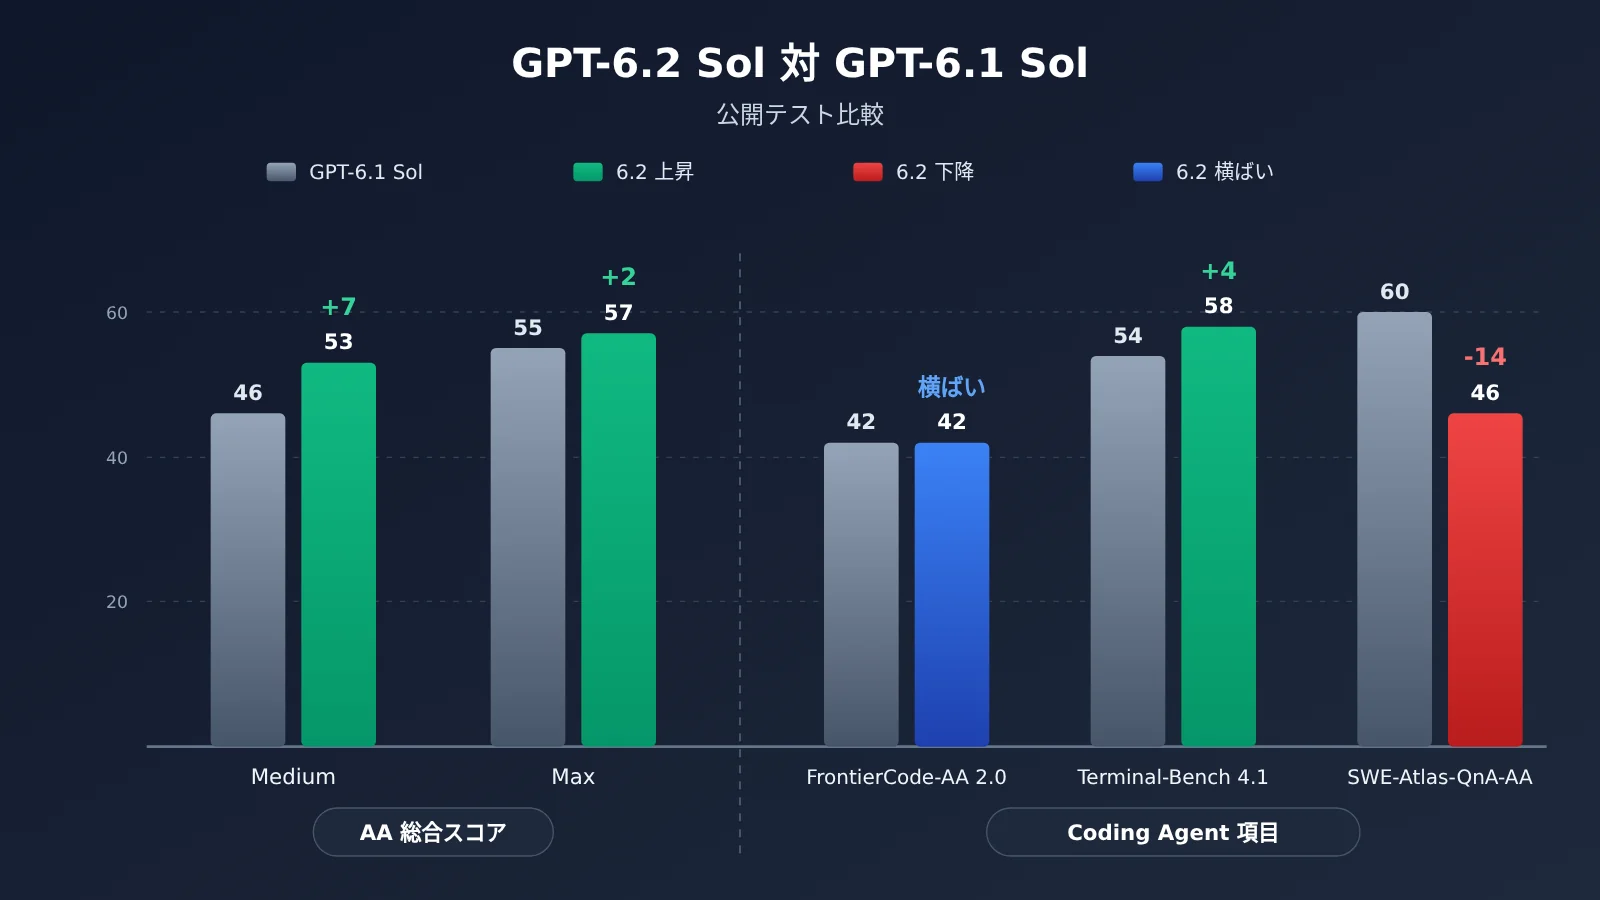
上の図はサードパーティの公開データをまとめたもので、緑は6.2 Solの向上、赤は下降を表しています。これらの数値は異なる機関やテストフレームワークに由来するため、それぞれの条件内での比較にとどめるべきです。自分のタスクで再現したい場合は、APIYI apiyi.comを通じて、同じチャネル・同じティアで2世代のモデルをそれぞれ呼び出せます。
2.1 知識作業と総合能力:GPT-6.2 Sol は着実に向上
公式発表:OpenAIは2026-11-17のリリース告知で、6.2 Solが内部評価GDPval v2において6.1 Solより5.3ポイント高いと述べています。GDPval v2はコンサルティング、金融、デザインなどの分野における多段階の知識作業をテストするもので、この結論はOpenAIが公表した内部テストにのみ当てはまります。告知には「出力トークンが22%減少」という項目もありますが、比較対象はGPT-6.2 AstraとGPT-6 Astraであり、Solの2世代間には当てはめられません。
サードパーティによる実測:Artificial Analysisの総合スコアは、知識作業、コーディング、科学、一般知識をカバーしています。6.1 Solから6.2 Solにかけて、Mediumティアは46から53へ、Maxティアは55から57へ上昇しました。Maxティアの平均タスクコストは$1.27から$1.01へ下がり、公開されている四捨五入済みの数値で計算すると約20%減です。
2組のデータは方向性が一致しており、6.2 Solは総合タスクでより強く、タスクあたりのコストも抑えられます。注目すべきは、Mediumティアの伸び(+7)がMaxティア(+2)より明らかに大きい点です。日常的に中程度の推論ティアを使うチームにとっては、今回のアップグレードの実感がより明確になるかもしれません。
2.2 コード修正、ターミナル、コードベースQ&A:GPT-6.2 Sol は良くも悪くも
Artificial Analysis の Coding Agent Index v2.1 では、両世代のモデルが Codex テストフレームワークと Max 推論ティアを使用しており、条件は統一されています:
| 指標(Codex + Max) | GPT-6.1 Sol | GPT-6.2 Sol | 変化 |
|---|---|---|---|
| Coding Agent Index 総合 | 52 | 49 | -3 |
| FrontierCode-AA 2.0 | 42 | 42 | 横ばい |
| Terminal-Bench 4.1 | 54 | 58 | +4 |
| SWE-Atlas-QnA-AA(コードベースQ&A) | 60 | 46 | -14 |
| 単一タスクあたりの平均 API コスト | $1.51 | $1.22 | 約 -19% |
| 平均エージェント実行時間 | 21.9 分 | 17.5 分 | -4.4 分 |
総合スコアが下降した主な原因は、コードベースQ&Aのサブ項目が 14 ポイント下落し、ターミナルのサブ項目の 4 ポイント上昇を打ち消してしまったことです。一方、コード修正のサブ項目は横ばいでした。実行時間の項目は、環境の起動、レビュー、検証にかかるコストを除外しており、エージェント自体の実行時間だけを反映しています。なお、ここでの FrontierCode-AA 2.0 は Artificial Analysis のバージョンであり、他機関の同名ランキングと混同してはいけません。
Plotly が 2026-11-17 に公開した DataAnalyticsBench の単一ラウンド比較は、別種の独立タスクにおける参考材料を提供しています。6.1 Sol → 6.2 Sol では、総合スコアが 43/43 → 40/43 となり、ラウンド全体のコストは $2.61 から $1.22 に、1 問あたりの中央値所要時間は 17.6 秒から 10.5 秒に短縮されました。ツール呼び出し回数は 258 回から 158 回に、出力量は約 70,000 トークンから 45,000 トークンに減少しています。6.2 Sol が誤答した 3 問は、いずれも隠れた規則性を問う問題に集中していました。
この結果には 2 つの制約があります。第一に、テストは OpenRouter と Plotly の固定フレームワークを使用しており、コストは当時のチャネル条件によるものです。第二に、各モデルは 1 ラウンドのみ実行されており、Plotly は他のモデルの再実行時に最大 3 問の変動を観測しています。したがって、この結果は「6.2 Sol は動作が少なく、より速く、より安いが、深く掘り下げる必要のある難問では“早々に手を引く”可能性がある」という傾向を示すのに適しています。
3. GPT-6.2 Sol の API 挙動が既存サービスに与える影響
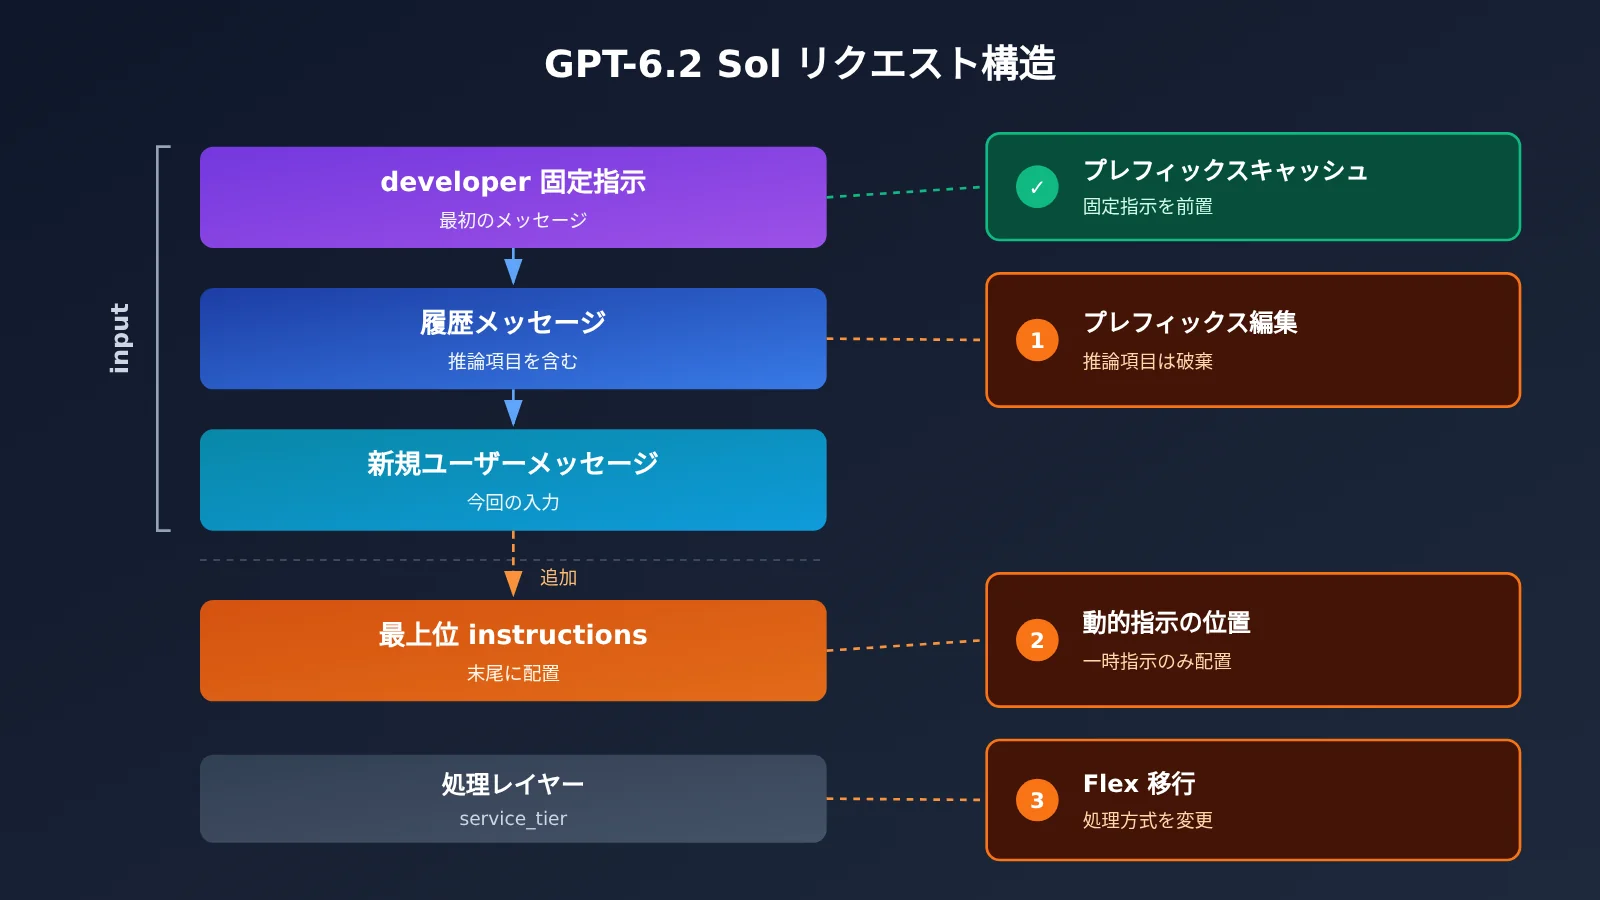
すでに 6.1 Sol を運用しているマルチターンアプリケーションでは、リスクは主に3つの側面に集中します。上の図は GPT-6.2 Responses リクエストの推奨構造を示しており、APIYI(apiyi.com)の responses エンドポイントからこの構造のまま直接検証できます。
- セッションのプレフィックス書き換え:GPT-6.2 の Responses API は、既存セッションのプレフィックスを編集するとき、一部のモデル切り替え時、エンドユーザーまたは組織を切り替えるときに、以前の推論項目を破棄します。システムに「履歴を書き換えて会話を継続する」というロジックがある場合は、会話の継続品質とキャッシュヒットが影響を受けるかどうかを検証する必要があります。
- 指示の位置:GPT-6.2 のトップレベル
instructionsはinputの後に追加されます。再利用し、キャッシュヒットを狙う固定指示は、inputの先頭のdeveloperメッセージに置くべきです。毎回変化する一時的な指示は、引き続きトップレベルinstructionsを使用できます。 - Flex マイグレーション:1.3 節を参照してください。元々 Flex を利用していたリクエストは、処理方法を選び直す必要があります。
また、どちらのエンドポイントも none 推論レベルを受け付けません。モデル ID を置き換える際は、公式のマイグレーションガイドに従って、履歴の書き換え、サンプリングパラメータ、推論レベル、処理層、キャッシュデータも確認してください。
3.1 GPT-6.2 Sol の最小呼び出し例
以下では、Chat Completions を使って最小限の検証を行います。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の統一インターフェース
)

resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "用三句话说明什么是会话前缀缓存"}]
)
print(resp.choices[0].message.content)
Responses API の新旧バージョンの対照コードを見る(固定命令の前置 + 使用量の記録)
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 新旧バージョンが同じチャネルを使い、比較の公平性を確保
)

STABLE_RULES = "你是代码库助手。回答必须列出涉及的文件路径、调用方和配置开关。"

def run(model: str, question: str, effort: str = "medium"):
    resp = client.responses.create(
        model=model,
        reasoning={"effort": effort},   # どちらのエンドポイントも none は受け付けません
        input=[
            # 固定命令は input の先頭の developer メッセージに置くと、プレフィックスキャッシュに有利です
            {"role": "developer", "content": STABLE_RULES},
            {"role": "user", "content": question},
        ],
        # 一時的な命令はトップレベルの instructions に置けます。これは input の後ろに追加されます
        instructions="本轮只回答与鉴权模块相关的部分。",
    )
    usage = resp.usage
    details = getattr(usage, "output_tokens_details", None)
    return {
        "model": model,
        "text": resp.output_text,
        "output_tokens": usage.output_tokens,
        "reasoning_tokens": getattr(details, "reasoning_tokens", None),
    }

for m in ["gpt-6.1-sol", "gpt-6.2-sol"]:
    r = run(m, "登录失败后的重试逻辑在哪里实现?受哪些配置影响?")
    print(r["model"], r["output_tokens"], r["reasoning_tokens"])
    print(r["text"][:300], "\n---")
🎯 技術的なヒント:マルチターンのアプリケーションを移行するときは、「プレフィックスは変えず、メッセージだけを追加する」実際のリクエストを一組用意し、それを新旧それぞれの世代に送り、回答とキャッシュ読み取りの使用量を比較することをおすすめします。APIYI apiyi.com では 2 世代のモデルを同時に呼び出せるため、比較テストを CI に組み込むのが簡単です。
4. GPT-6.2 Sol 切り替え前のタスク別受け入れ検証
以下の計画は、前述の公開エビデンスを参照して提案するテスト設計であり、公式な要件ではありません。中心となる原則は、モデル以外の条件をすべて固定することです。同一のAPIチャネル、推論レベル、入力資料、ツール一覧、タイムアウト設定、採点ルールを揃え、6.1 Solを対照群として残します。
| タスク種別 | トライアル優先度 | 主なエビデンス | 受け入れ条件 |
|---|---|---|---|
| コード修正 | 優先トライアル | FrontierCode-AA 2.0 は同等、コストと所要時間は低下 | テスト通過率が旧版以上、合格1件あたりのコストが低下 |
| ターミナル / コンピューター操作 | 優先トライアル | Terminal-Bench 4.1 +4 | 成功率とエンドツーエンド所要時間のP50、P95 |
| 通常分析 | 優先トライアル | 総合スコアが上昇、Plotlyの所要時間とコストが低下 | 初回受け入れ率、漏れ項目数 |
| コードベースQ&A | 個別受け入れ | SWE-Atlas-QnA-AA -14 | 事前にラベル付けした必須回答事項のカバー率 |
| 低頻度の複雑分析 / 難例 | 個別受け入れ | Plotlyの隠れたパターン問題での失点 | 再審査後の合格納品1件あたりのコスト |
| マルチターンフロー | 個別受け入れ | 推論項目の欠落、指示位置の変化 | リプレイ、履歴補記、障害復旧後の結果一貫性 |
実行時は、以下のチェックリストに沿って進めます。
- コードベースQ&A:各問題について、必ずカバーすべき呼び出し元、設定スイッチ、分岐条件、ファイルパスを事前にラベル付けし、回答が「正しそう」に見えるかどうかだけでなく、根拠が項目ごとに完全かどうかを確認します。
- 指標の記録:タスク種別ごとに、初回受け入れ率、漏れ項目、手戻り回数、エンドツーエンド所要時間、モデルとツールの使用量を記録します。サンプルが十分な場合は、P50とP95も併せて確認します。
- コストの計算:「評価期間中の総コスト ÷ 受け入れ通過タスク数」で、合格納品1件あたりのコストを見積もります。再審査と再実行の費用も総コストに含めます。6.2 Solは1回あたりのコストが安くなりますが、難問で手戻りが増えると、合格コストはかえって上昇する可能性があります。
- 拡大判断:品質基準、合格納品コスト、レイテンシの3項目すべてを満たすタスク種別のみ、トラフィックを拡大します。未達のタスク種別は引き続き6.1 Solに残し、次回の再テストを待ちます。
💰 コスト計算のヒント:同一チャネルでは単価が一致してこそ、比較結果に意味があります。APIYI apiyi.com の1つのAPIキーで2世代のモデルを同時に実行すると、請求はモデルごとに分けて記録され、合格納品1件あたりのコスト計算にそのまま使えます。
GPT-6.2 Sol と GPT-6.1 Sol の比較:どちらを選ぶか
負荷が主にコード修正、ターミナルエージェント、通常の分析であれば、6.2 Sol は同価格帯でより高速かつ低コストな選択肢であり、優先的に切り替えることをお勧めします。コードベースのQ&Aや隠れた規則性を見つけるタイプの難問の比率が高い場合、または業務が Flex に依存している場合は、まず第4節の専項検収を完了してください。対応する指標が基準を満たすまでは、引き続き 6.1 Sol がこの部分のトラフィックを担うことができます。この選択を左右する重要な変数はタスク構成です。難問の比率が高いほど、6.2 Sol の単価と速度における優位性が手戻りによって相殺される可能性が高くなります。
まず APIYI apiyi.com で新規ユーザー向けの無料テスト枠を利用し、各タスクタイプの代表サンプルを選んで一通り対照テストを実行し、その結果に基づいて切り替え範囲を決めることをお勧めします。
参考資料
- OpenAI の発表:GPT-6.2 Astra と Sol のリリースノートおよび GDPval v2 の結論
- リンク:
openai.com/index/introducing-gpt-6-2-astra-sol
- リンク:
- OpenAI API のモデルカードと料金:2世代の Sol の仕様、価格、処理オプション
- リンク:
developers.openai.com/api/docs/models/gpt-6.2-sol - リンク:
developers.openai.com/api/docs/pricing
- リンク:
- GPT-6.2 利用ガイド:Responses の動作変更と移行チェック項目
- リンク:
developers.openai.com/api/docs/guides/latest-model
- リンク:
- Artificial Analysis:総合スコアと Coding Agent Index の項目別データ
- リンク:
artificialanalysis.ai/agents/coding-agents/codex
- リンク:
- Plotly DataAnalyticsBench:6.2 Sol の単一ラウンド対照と誤答の説明
- リンク:
plotly.com/blog/gpt-6-2-sol-plotly-data-analytics-bench
- リンク:
作者:APIYI 技術チーム
技術交流:APIYI apiyi.com のトップページからお気軽にお問い合わせください。その他の接続資料は docs.apiyi.com のドキュメントセンターをご覧ください。