Catatan penulis: GPT-6.2 Sol memakai harga token Standard yang sama dengan generasi sebelumnya, dan pada sejumlah pengujian publik berhasil menaikkan skor atau menurunkan biaya per tugas. Meski begitu, sebelum sistem yang sudah berjalan di-upgrade, tanya jawab basis kode, analisis kompleks, dan sesi multi-giliran tetap perlu diuji secara terpisah.
Langsung ke kesimpulan: harga satuan Standard untuk konteks pendek pada GPT-6.2 Sol persis sama dengan GPT-6.1 Sol, skornya lebih tinggi di evaluasi menyeluruh dan biaya per tugasnya lebih rendah; tetapi ada penurunan skor yang jelas pada tanya jawab basis kode dan beberapa soal sulit. Untuk setiap juta token, harga input biasa, pembacaan cache, dan output keduanya adalah $2, $0,10, dan $10. Skor gabungan Artificial Analysis pada tingkat Max naik dari 55 ke 57, dan biaya rata-rata per tugas turun dari $1,27 ke $1,01. Namun pada pengujian agen kode dari lembaga yang sama, subbutir tanya jawab basis kode justru turun dari 60 ke 46, dan uji analisis data Plotly juga turun dari skor sempurna 43/43 menjadi 40/43.
Jadi, upgrade ini cocok dijalankan bertahap menurut jenis tugas, bukan mengganti semuanya sekaligus. Perubahan kode yang bisa diverifikasi, operasi terminal, dan analisis rutin bisa dicoba lebih dulu. Untuk tanya jawab basis kode, soal sulit bertipe pola tersembunyi, dan pemrosesan batch yang bergantung pada Flex, perlu disiapkan uji regresi terlebih dahulu. Selain itu, Responses API pada GPT-6.2 punya perubahan perilaku pada sesi multi-giliran dan posisi instruksi, jadi aplikasi multi-giliran versi lama tidak cukup hanya mengganti ID model.
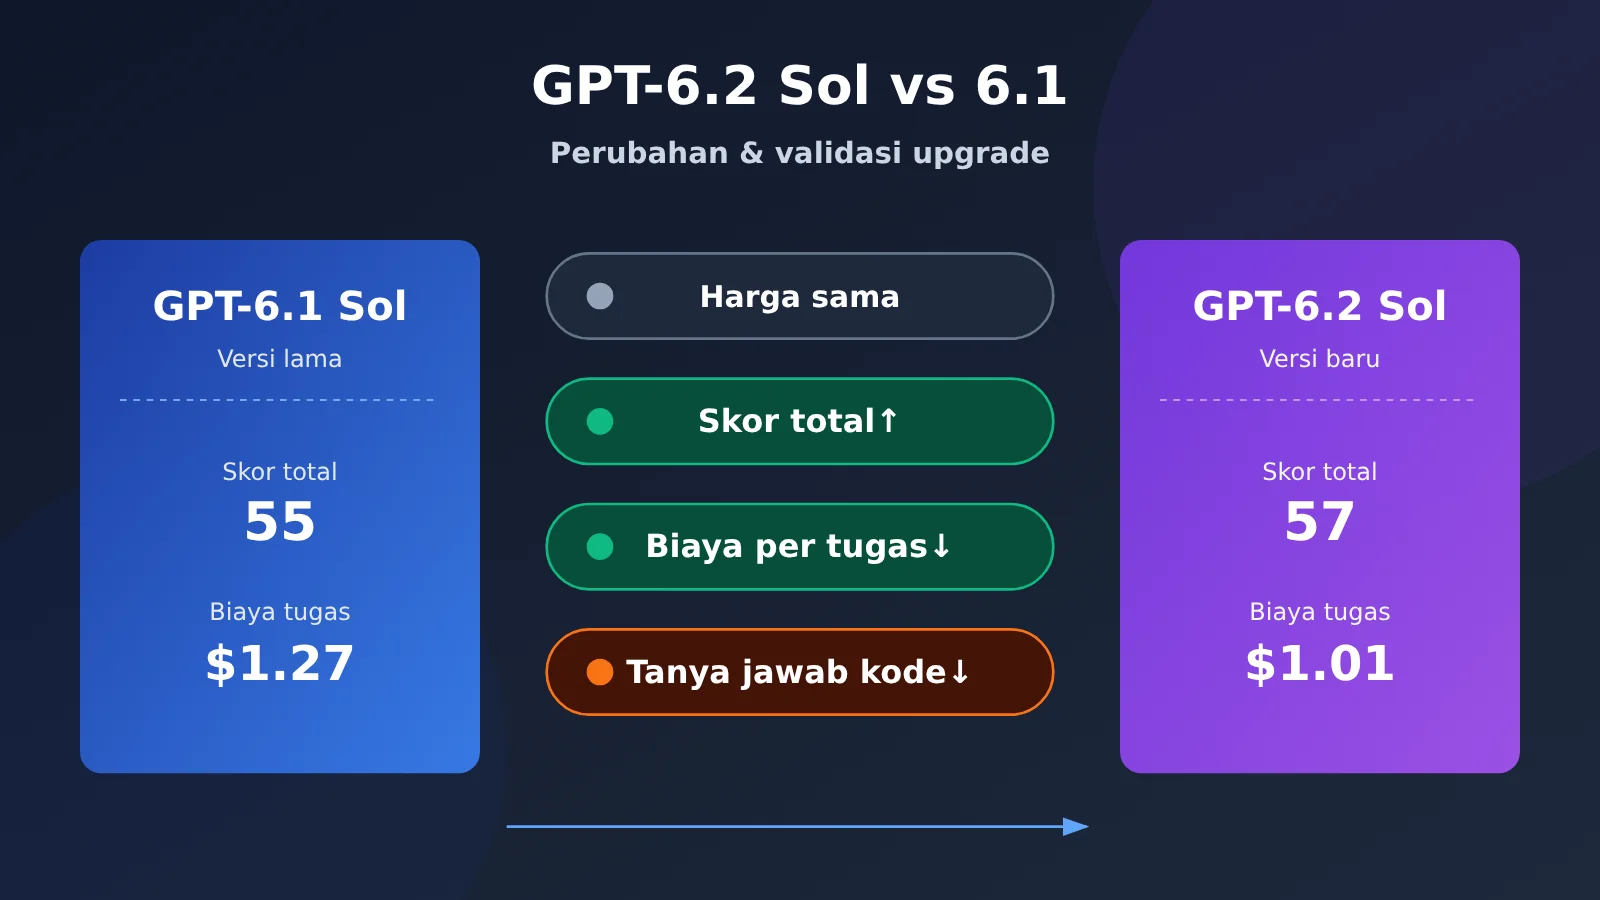
GPT-6.2 Sol vs GPT-6.1 Sol: Ringkasan Cepat
Tabel berikut hanya mencantumkan dimensi yang berguna untuk keputusan upgrade. Spesifikasi dan harga berasal dari kartu model resmi OpenAI, halaman harga, dan changelog. Satuan harga adalah USD per juta token.
| Dimensi perbandingan | GPT-6.1 Sol | GPT-6.2 Sol | Apa arti perbedaannya |
|---|---|---|---|
| ID model / tanggal rilis | gpt-6.1-sol / 2026-09-29 |
gpt-6.2-sol / 2026-11-17 |
Model baru baru saja dirilis, perlu diamati untuk sementara waktu |
| Konteks / output maksimum | 1.050.000 / 128.000 | 1.050.000 / 128.000 | Kapasitas tidak berubah |
| Input maksimum | Tidak dicantumkan terpisah di kartu model | 922.000 | Tugas dengan input sangat panjang perlu dicek terhadap batas baru |
| Batas pengetahuan | 2026-04-30 | 2026-06-01 | Diperpanjang sekitar satu bulan |
| Harga Standard konteks pendek | Input $2 / baca cache $0,10 / output $10 | Sama | Tagihan sama jika kombinasi token identik |
| Pemrosesan Flex | Didukung | Tidak didukung | Pengguna Flex versi lama harus beralih ke opsi pemrosesan lain |
| Jendela diskon background | Tidak dibahas dalam materi ini | Jendela 2 jam -30%, jendela 8 jam -40% | Tugas yang toleran terhadap latensi punya opsi penghematan baru |
| Skor keseluruhan (AA, tingkat Max) | 55 | 57 | Secara keseluruhan sedikit lebih kuat |
| Tanya jawab basis kode (AA, Codex + Max) | 60 | 46 | Menurun cukup jelas, perlu uji penerimaan khusus |
🚀 Perbandingan cepat: Kedua generasi model dapat dibandingkan dengan beralih di antarmuka yang sama. Daftar model publik APIYI apiyi.com sudah memuat
gpt-6.2-soldan mencantumkan dua pintu masuk, yaitu responses dan chat. Cocok untuk menjalankan pengujian regresi versi lama dan baru dengan kunci yang sama.
Saran urutan membaca: Bagian 1 membahas harga dan opsi pemrosesan terlebih dahulu karena keduanya menentukan dasar penagihan. Bagian 2 membandingkan kemajuan dan penurunan skor dalam pengujian publik untuk menilai tugas mana yang layak di-upgrade. Bagian 3 memeriksa perubahan perilaku API untuk menilai apakah layanan yang ada dapat beralih dengan mulus. Bagian 4 memberikan rencana uji penerimaan per tugas. Jika hanya peduli pada agen coding, langsung lihat 2.2 dan Bagian 4.
Istilah yang perlu dipahami sebelum membandingkan GPT-6.2 Sol
| Istilah | Penjelasan singkat |
|---|---|
| Harga token standar | Penagihan publik OpenAI untuk tingkat Standard per juta token input, output, dan berbagai penggunaan cache |
| Biaya tugas | Biaya model dan biaya alat yang timbul untuk menyelesaikan suatu tugas; saat uji penerimaan bisnis, biaya pengulangan dan tinjauan manual juga dapat dihitung |
| Tingkat penalaran | Pengaturan yang mengontrol anggaran penalaran model; nilai umumnya Low, Medium, High, Xhigh, Max; pengujian komparatif harus menggunakan tingkat yang sama |
| GDPval v2 | Evaluasi internal OpenAI untuk pekerjaan pengetahuan kompleks, berfokus pada hasil alur kerja panjang dari jenis proyek nyata |
| Coding Agent Index | Metrik komprehensif agen dari Artificial Analysis berdasarkan subitem seperti modifikasi kode, operasi terminal, dan tanya jawab basis kode |
| SWE-Atlas-QnA-AA | Subitem tanya jawab basis kode dalam metrik di atas, yang menguji apakah fakta yang dibutuhkan untuk jawaban sudah lengkap |
| Prefiks sesi / pembacaan cache | Konten yang urutannya tetap konsisten di awal permintaan multi-turn; setelah sisi layanan mengenali prefiks yang dapat digunakan ulang, bagian yang cocok ditagih dengan tarif pembacaan |
1. GPT-6.2 Sol vs GPT-6.1 Sol: Spesifikasi Dasar dan Harga
1.1 Spesifikasi GPT-6.2 Sol pada dasarnya melanjutkan generasi sebelumnya
Kedua generasi model dapat dipanggil melalui Responses dan Chat Completions; pemanggilan fungsi dan alat bawaan menggunakan jalur Responses. Keduanya menerima input teks dan gambar, menghasilkan teks secara native, dengan jendela konteks yang sama yaitu 1,050,000 token dan output maksimum yang sama yaitu 128,000 token. Kartu model 6.2 Sol secara terpisah mencantumkan input maksimum 922,000 token.
Ada perbedaan tipis dalam positioning. Halaman model 6.1 Sol menekankan penyelesaian tugas kode, operasi komputer, dan tugas profesional yang kompleks dengan biaya lebih rendah daripada Astra; halaman model 6.2 Sol lebih condong ke kode sehari-hari dan pekerjaan agen dalam skala besar. Artinya, 6.2 Sol lebih jelas diarahkan ke skenario frekuensi tinggi dan batch.
1.2 Harga Standard GPT-6.2 Sol sama dengan generasi sebelumnya
Penagihan Standard resmi adalah sebagai berikut. Kedua generasi memakai batas input 272K token per permintaan: jika melewati batas tersebut, tarif input dan cache untuk seluruh permintaan dihitung 2 kali lipat, sedangkan output dihitung 1.5 kali lipat.
| Kategori penagihan Standard | Konteks pendek (≤272K) | Konteks panjang (>272K) |
|---|---|---|
| Input biasa | $2.00 | $4.00 |
| Pembacaan cache | $0.10 | $0.20 |
| Penulisan cache 30 menit | $2.50 | $5.00 |
| Penulisan cache 12 jam | $5.00 | $10.00 |
| Output (sudah termasuk token penalaran) | $10.00 | $15.00 |
Harga satuan yang sama tidak berarti tagihannya sama. Saat menyelesaikan tugas yang sama, output token, jumlah pemanggilan alat, dan cache hit 6.2 Sol bisa berubah, jadi biaya aktual harus dihitung per tugas. Penulisan cache harus dihitung berdasarkan tarif penuh masing-masing, tanpa menambahkan lagi harga input biasa untuk token yang sama. Total output dapat dibaca dari usage.output_tokens pada Responses, sedangkan penggunaan penalaran biasanya tercantum dalam subbidang output_tokens_details.reasoning_tokens.
Tentang pemanggilan domestik: per 2026-11-20, dalam antarmuka harga publik APIYI apiyi.com, harga tier pendek gpt-6.2-sol sama dengan harga resmi; untuk tier panjang, input biasa, pembacaan cache, penulisan cache, dan output masing-masing adalah $3, $0.15, $3.75, dan $11.25. Ini adalah ekspresi harga yang terdaftar publik; tagihan aktual mengikuti grup akun dan konfigurasi platform saat ini.
1.3 Pilihan antara Flex dan jendela diskon background
Perubahan opsi pemrosesan paling mudah terlewat. 6.1 Sol masih ada dalam daftar yang memenuhi syarat Flex, sedangkan 6.2 Sol tidak mendukung Flex. Sebagai alternatif, 6.2 Sol dapat menggunakan jendela diskon background Responses: untuk permintaan yang memenuhi syarat, tarif token model dalam jendela 2 jam lebih rendah 30% dibanding Standard, dan dalam jendela 8 jam lebih rendah 40%.
Jika sistem lama bergantung pada Flex untuk menjalankan pemrosesan batch offline, saat migrasi perlu memilih ulang berdasarkan tenggat pengiriman dan kondisi akses. Tugas yang dapat menerima pengiriman dalam beberapa jam dapat mengevaluasi jendela background; tugas yang perlu respons segera hanya dapat ditagih dengan Standard.
2. Perbandingan GPT-6.2 Sol dengan GPT-6.1 Sol: Kemajuan dan Kelemahan dalam Uji Publik
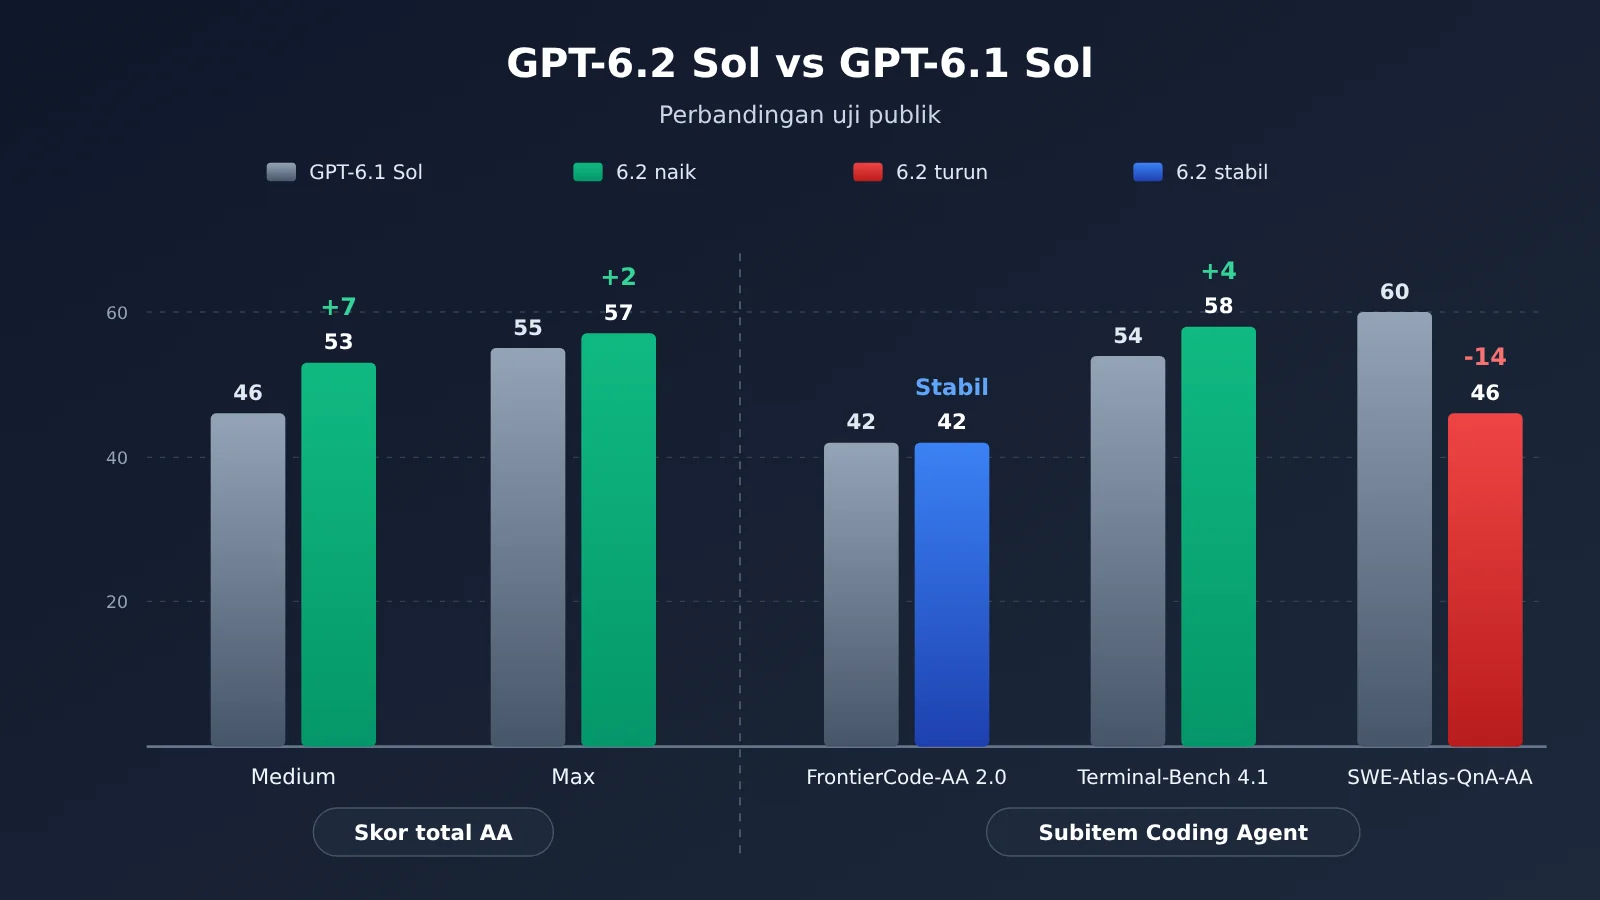
Grafik di atas merangkum data publik pihak ketiga; hijau menandakan peningkatan pada 6.2 Sol, merah menandakan penurunan. Angka-angka ini berasal dari lembaga dan kerangka pengujian yang berbeda, jadi hanya layak dibandingkan dalam kondisi masing-masing. Kalau ingin mereproduksinya pada tugas Anda sendiri, Anda bisa memanggil kedua generasi model lewat APIYI apiyi.com dengan kanal dan tingkat yang sama.
2.1 Pekerjaan Pengetahuan dan Kemampuan Komprehensif: GPT-6.2 Sol Meningkat secara Stabil
Laporan resmi OpenAI: Dalam pengumuman rilisnya pada 2026-11-17, OpenAI menyatakan bahwa 6.2 Sol unggul 5,3 poin persentase dibanding 6.1 Sol pada evaluasi internal GDPval v2. GDPval v2 menguji pekerjaan pengetahuan multi-langkah di bidang konsultasi, keuangan, desain, dan lain-lain; kesimpulan ini hanya berlaku untuk pengujian internal yang diumumkan OpenAI. Di pengumuman itu ada juga pernyataan “output token berkurang 22%”, yang objek perbandingannya adalah GPT-6.2 Astra dengan GPT-6 Astra, sehingga tidak bisa diterapkan pada perbandingan antara dua generasi Sol.
Pengukuran pihak ketiga: Skor komprehensif Artificial Analysis mencakup pekerjaan pengetahuan, pemrograman, sains, dan pengetahuan umum. Dari 6.1 Sol ke 6.2 Sol, tingkat Medium naik dari 46 ke 53, tingkat Max naik dari 55 ke 57. Biaya rata-rata per tugas pada tingkat Max turun dari $1,27 ke $1,01, yang berdasarkan nilai pembulatan yang dipublikasikan berarti turun sekitar 20%.
Kedua kelompok data searah: 6.2 Sol lebih kuat pada tugas komprehensif, dan biaya per tugasnya lebih hemat. Yang perlu dicatat, kenaikan pada tingkat Medium (+7) jelas lebih besar daripada tingkat Max (+2). Bagi tim yang sehari-hari memakai tingkat penalaran menengah, peningkatan ini mungkin terasa lebih nyata.
2.2 Modifikasi kode, terminal, dan tanya jawab basis kode: GPT-6.2 Sol ada yang naik, ada yang turun
Dalam Coding Agent Index v2.1 dari Artificial Analysis, kedua generasi model memakai framework pengujian Codex dan tingkat penalaran Max, jadi dasar pengukurannya sama:
| Metrik (Codex + Max) | GPT-6.1 Sol | GPT-6.2 Sol | Perubahan |
|---|---|---|---|
| Coding Agent Index keseluruhan | 52 | 49 | -3 |
| FrontierCode-AA 2.0 | 42 | 42 | Tetap |
| Terminal-Bench 4.1 | 54 | 58 | +4 |
| SWE-Atlas-QnA-AA (tanya jawab basis kode) | 60 | 46 | -14 |
| Biaya API rata-rata per tugas | $1.51 | $1.22 | sekitar -19% |
| Rata-rata waktu eksekusi agen | 21.9 menit | 17.5 menit | -4.4 menit |
Skor keseluruhan turun terutama karena subskor tanya jawab basis kode anjlok 14 poin, yang menutupi kenaikan 4 poin pada subskor terminal, sementara subskor modifikasi kode tetap. Metrik waktu eksekusi tidak memasukkan biaya startup lingkungan, review, dan validasi; angka itu hanya mencerminkan durasi eksekusi agen itu sendiri. Selain itu, FrontierCode-AA 2.0 di sini adalah versi Artificial Analysis dan tidak boleh dicampur dengan peringkat bernama sama dari lembaga lain.
Perbandingan satu putaran DataAnalyticsBench yang diumumkan Plotly pada 2026-11-17 memberikan referensi untuk jenis tugas independen lain. Skor total dari 6.1 Sol → 6.2 Sol adalah 43/43 → 40/43, biaya satu putaran penuh turun dari $2.61 menjadi $1.22, dan waktu median per soal turun dari 17.6 detik menjadi 10.5 detik. Jumlah pemanggilan alat turun dari 258 menjadi 158 kali, sedangkan volume output turun dari sekitar 70,000 token menjadi 45,000 token. Tiga soal yang dijawab salah oleh 6.2 Sol terpusat pada soal pola tersembunyi.
Hasil ini memiliki dua keterbatasan. Pertama, pengujian menggunakan framework tetap OpenRouter dan Plotly, dan biayanya mengikuti angka kanal pada saat itu. Kedua, setiap model hanya dijalankan satu putaran; saat menjalankan ulang model lain, Plotly mengamati fluktuasi hingga tiga soal. Jadi hasil ini lebih cocok menjelaskan satu pola: 6.2 Sol melakukan lebih sedikit aksi, lebih cepat, dan lebih hemat, tetapi pada soal sulit yang perlu digali lebih dalam mungkin “berhenti terlalu cepat”.
3. Bagaimana perilaku API GPT-6.2 Sol memengaruhi layanan yang sudah ada
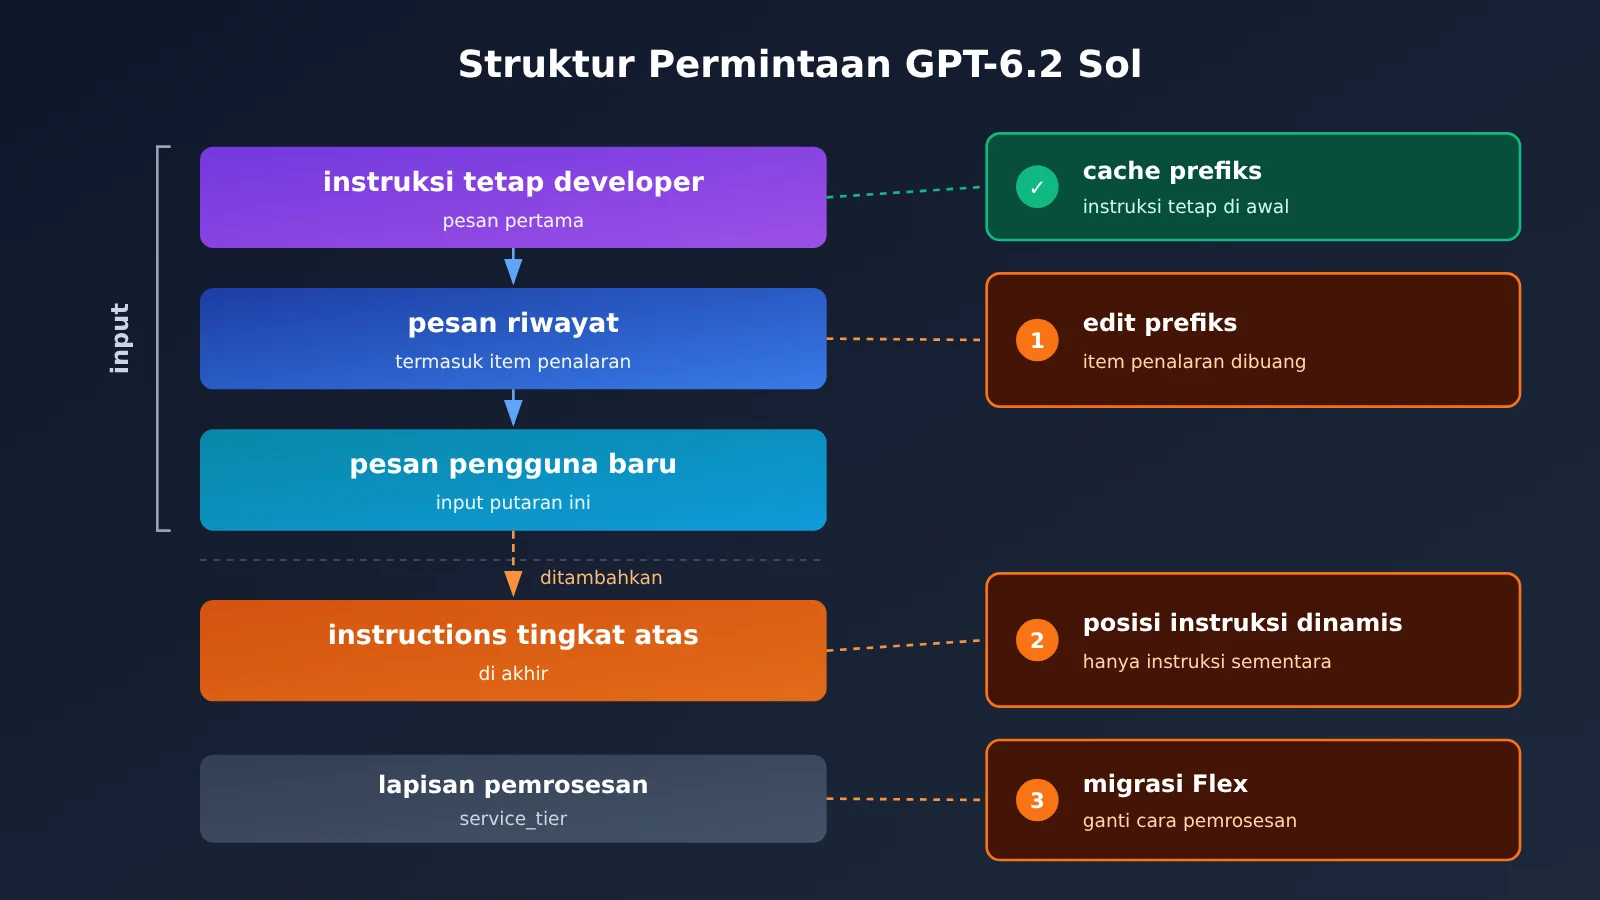
Bagi aplikasi multi-giliran yang sudah menjalankan 6.1 Sol, risikonya terutama terpusat pada tiga aspek. Gambar di atas menunjukkan struktur permintaan GPT-6.2 Responses yang direkomendasikan, dan Anda bisa memverifikasinya langsung mengikuti struktur ini melalui endpoint responses APIYI apiyi.com.
- Penulisan ulang prefiks sesi: Responses API GPT-6.2 akan membuang item penalaran sebelumnya saat mengedit prefiks sesi yang sudah ada, sebagian penggantian model, atau penggantian pengguna akhir maupun organisasi. Jika sistem Anda punya logika “menulis ulang riwayat lalu melanjutkan percakapan”, Anda perlu memverifikasi apakah kualitas penyambungan dan cache hit terpengaruh.
- Posisi instruksi:
instructionstingkat atas pada GPT-6.2 akan ditambahkan setelahinput. Instruksi tetap yang perlu digunakan ulang dan diharapkan mengenai cache sebaiknya diletakkan di pesandeveloperpertama dalaminput; instruksi sementara yang berubah setiap kali bisa tetap menggunakaninstructionstingkat atas. - Migrasi Flex: Lihat bagian 1.3, permintaan yang sebelumnya melalui Flex perlu memilih cara pemrosesan lain.
Selain itu, kedua endpoint tidak menerima tingkat penalaran none. Saat mengganti ID model, Anda juga sebaiknya memeriksa penulisan ulang riwayat, parameter sampling, tingkat penalaran, lapisan pemrosesan, dan data cache sesuai panduan migrasi resmi.
3.1 Contoh Pemanggilan Minimal GPT-6.2 Sol
Berikut adalah verifikasi minimal menggunakan Chat Completions:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # antarmuka terpadu APIYI
)

resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "用三句话说明什么是会话前缀缓存"}]
)
print(resp.choices[0].message.content)
Lihat kode perbandingan Responses API versi lama dan baru (penempatan instruksi tetap di depan + pencatatan penggunaan)
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # versi lama dan baru melalui saluran yang sama, memastikan perbandingan adil
)

STABLE_RULES = "你是代码库助手。回答必须列出涉及的文件路径、调用方和配置开关。"

def run(model: str, question: str, effort: str = "medium"):
    resp = client.responses.create(
        model=model,
        reasoning={"effort": effort},   # kedua endpoint tidak menerima none
        input=[
            # instruksi tetap diletakkan di pesan developer pertama pada input, berguna untuk cache prefiks
            {"role": "developer", "content": STABLE_RULES},
            {"role": "user", "content": question},
        ],
        # instruksi sementara dapat diletakkan di instructions tingkat atas, akan ditambahkan setelah input
        instructions="本轮只回答与鉴权模块相关的部分。",
    )
    usage = resp.usage
    details = getattr(usage, "output_tokens_details", None)
    return {
        "model": model,
        "text": resp.output_text,
        "output_tokens": usage.output_tokens,
        "reasoning_tokens": getattr(details, "reasoning_tokens", None),
    }

for m in ["gpt-6.1-sol", "gpt-6.2-sol"]:
    r = run(m, "登录失败后的重试逻辑在哪里实现?受哪些配置影响?")
    print(r["model"], r["output_tokens"], r["reasoning_tokens"])
    print(r["text"][:300], "\n---")
🎯 Saran teknis: Saat memigrasikan aplikasi multi-putaran, sebaiknya pertahankan sekumpulan permintaan nyata dengan “prefiks tidak berubah, hanya menambahkan pesan”, lalu kirim masing-masing ke generasi lama dan baru, bandingkan jawaban dan penggunaan pembacaan cache. APIYI apiyi.com mendukung pemanggilan kedua generasi model secara bersamaan, sehingga memudahkan memasukkan pengujian perbandingan ke dalam CI.
4. Penerimaan per Tugas Sebelum Beralih ke GPT-6.2 Sol
Rencana berikut adalah desain pengujian yang mengacu pada bukti publik di atas, bukan persyaratan resmi. Prinsip intinya: selain model, semua kondisi tetap sama, termasuk saluran API, tingkat penalaran, bahan masukan, daftar alat, pengaturan batas waktu, dan aturan penilaian; 6.1 Sol dipertahankan sebagai kelompok kontrol.
| Jenis tugas | Prioritas uji coba | Bukti utama | Kriteria penerimaan |
|---|---|---|---|
| Modifikasi kode | Uji coba prioritas | FrontierCode-AA 2.0 setara, biaya dan durasi turun | Tingkat kelulusan pengujian tidak lebih rendah dari versi lama, biaya per penyerahan yang memenuhi syarat turun |
| Operasi terminal / komputer | Uji coba prioritas | Terminal-Bench 4.1 +4 | Tingkat keberhasilan dan waktu proses ujung ke ujung P50, P95 |
| Analisis rutin | Uji coba prioritas | Skor keseluruhan naik, waktu dan biaya Plotly turun | Tingkat penerimaan putaran pertama, jumlah item terlewat |
| Tanya jawab basis kode | Penerimaan khusus | SWE-Atlas-QnA-AA -14 | Tingkat cakupan fakta wajib yang ditandai sebelumnya |
| Analisis kompleks frekuensi rendah / kasus sulit | Penerimaan khusus | Kehilangan poin pada soal pola tersembunyi Plotly | Biaya penyerahan yang memenuhi syarat setelah peninjauan ulang |
| Alur multi-putaran | Penerimaan khusus | Item penalaran dibuang, posisi instruksi berubah | Konsistensi hasil setelah pemutaran ulang, penulisan ulang riwayat, dan pemulihan kegagalan |
Saat eksekusi, ikuti daftar berikut:
- Tanya jawab basis kode: tandai lebih dulu untuk setiap soal pemanggil, sakelar konfigurasi, kondisi cabang, dan jalur file yang wajib tercakup; periksa kelengkapan bukti satu per satu, bukan hanya apakah jawabannya “terlihat benar”.
- Catat metrik: catat per jenis tugas tingkat penerimaan putaran pertama, item terlewat, jumlah pengerjaan ulang, waktu proses ujung ke ujung, serta penggunaan model dan alat; jika sampel cukup, lihat P50 dan P95 sekaligus.
- Hitung biaya: gunakan “total biaya selama evaluasi ÷ jumlah tugas yang lulus penerimaan” untuk memperkirakan biaya per penyerahan yang memenuhi syarat; biaya peninjauan ulang dan pengulangan harus dimasukkan ke total biaya. 6.2 Sol lebih murah per sekali jalan, tetapi jika kasus sulit lebih sering dikerjakan ulang, biaya yang memenuhi syarat bisa justru naik.
- Penentuan perluasan: hanya jenis tugas yang memenuhi ketiga ambang—kualitas, biaya penyerahan yang memenuhi syarat, dan latensi—yang aliran trafiknya diperbesar; yang belum memenuhi tetap di 6.1 Sol dan menunggu putaran pengujian berikutnya.
💰 Tips penghitungan biaya: Harga satuan pada saluran yang sama harus konsisten agar hasil perbandingan bermakna. Melalui APIYI apiyi.com, satu kunci API dapat menjalankan dua generasi model sekaligus; tagihan dicatat terpisah per model dan bisa langsung dipakai untuk menghitung biaya per penyerahan yang memenuhi syarat.
GPT-6.2 Sol vs GPT-6.1 Sol: bagaimana memilih
Jika beban kerja Anda didominasi oleh modifikasi kode, agen terminal, dan analisis rutin, 6.2 Sol adalah pilihan yang lebih cepat dan lebih hemat pada rentang harga yang sama, sehingga bisa diprioritaskan untuk migrasi. Jika tanya jawab seputar basis kode, soal-soal sulit bertipe pola tersembunyi punya proporsi cukup tinggi, atau bisnis bergantung pada Flex, sebaiknya selesaikan lebih dulu verifikasi khusus di bagian 4; sebelum metrik terkait terpenuhi, 6.1 Sol bisa tetap menangani lalu lintas bagian tersebut. Variabel kunci yang menentukan pilihan ini adalah komposisi tugas: semakin tinggi proporsi kasus sulit, semakin besar kemungkinan keunggulan 6.2 Sol pada harga satuan dan kecepatan tergerus oleh pekerjaan ulang.
Saran: mulai dengan kuota uji gratis pengguna baru di APIYI apiyi.com, pilih sampel representatif untuk tiap jenis tugas, jalankan satu putaran perbandingan, lalu tentukan cakupan migrasi berdasarkan hasilnya.
Referensi
- Pengumuman rilis OpenAI: catatan rilis GPT-6.2 Astra dan Sol serta kesimpulan GDPval v2
- Tautan:
openai.com/index/introducing-gpt-6-2-astra-sol
- Tautan:
- Kartu model dan harga OpenAI API: spesifikasi, harga, dan opsi pemrosesan kedua generasi Sol
- Tautan:
developers.openai.com/api/docs/models/gpt-6.2-sol - Tautan:
developers.openai.com/api/docs/pricing
- Tautan:
- Panduan penggunaan GPT-6.2: perubahan perilaku Responses dan item pemeriksaan migrasi
- Tautan:
developers.openai.com/api/docs/guides/latest-model
- Tautan:
- Artificial Analysis: data skor komprehensif dan subskor Coding Agent Index
- Tautan:
artificialanalysis.ai/agents/coding-agents/codex
- Tautan:
- Plotly DataAnalyticsBench: perbandingan satu putaran 6.2 Sol dan penjelasan soal yang salah
- Tautan:
plotly.com/blog/gpt-6-2-sol-plotly-data-analytics-bench
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami lewat beranda APIYI apiyi.com; materi integrasi lainnya tersedia di pusat dokumentasi docs.apiyi.com