Примечание автора: GPT-6.2 Sol сохраняет цену за токены Standard предыдущего поколения, при этом улучшает результаты в ряде публичных тестов или снижает стоимость одной задачи. Перед обновлением существующих систем всё равно нужно отдельно проверять ответы на вопросы по кодовой базе, сложный анализ и многоходовые диалоги.
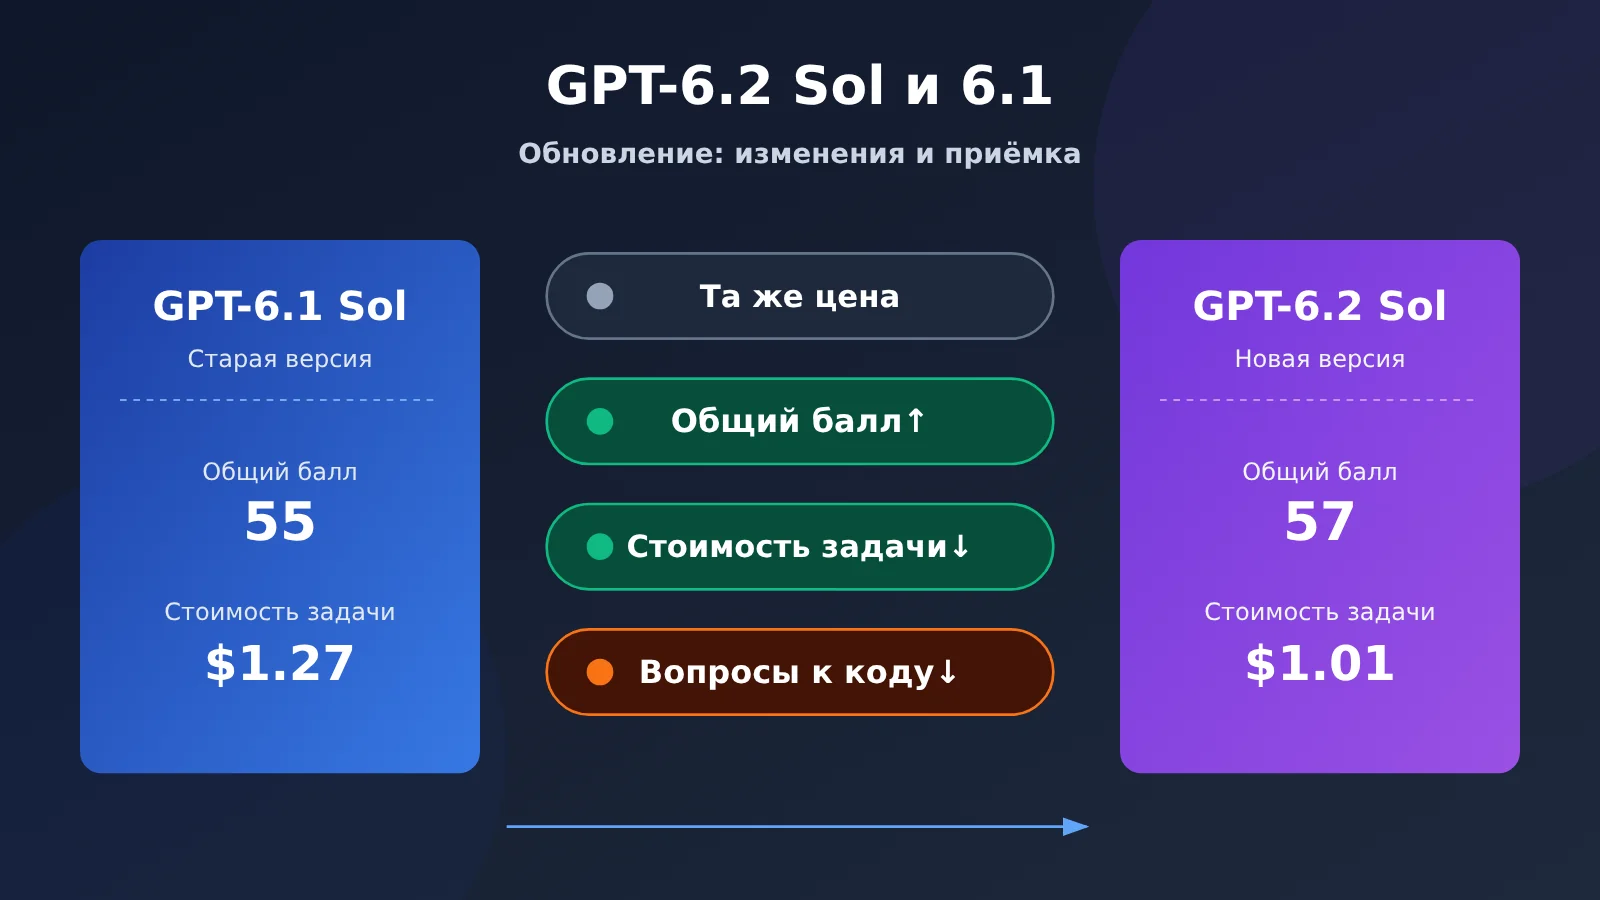
Сразу к выводу: цена Standard при коротком контексте у GPT-6.2 Sol точно такая же, как у GPT-6.1 Sol; в комплексных бенчмарках результат выше, а стоимость одной задачи ниже — но в вопросах по кодовой базе и на небольшом числе трудных задач есть явные потери баллов. У обоих обычный ввод, чтение из кэша и вывод стоят $2, $0.10 и $10 за миллион токенов. Комплексный балл в режиме Max от Artificial Analysis вырос с 55 до 57, а средняя стоимость задачи упала с $1.27 до $1.01. При этом в тесте кодового агента той же организации подпункт «вопросы по кодовой базе» просел с 60 до 46, а тест анализа данных Plotly — с максимальных 43/43 до 40/43.
Поэтому это обновление стоит внедрять постепенно, по типам задач, а не заменять всё сразу. Проверяемые изменения кода, операции в терминале и обычный анализ можно запускать в первую очередь. А вот вопросы по кодовой базе, задачи на скрытые закономерности и пакетную обработку через Flex нужно сначала закрыть регрессионными тестами. Кроме того, в Responses API у GPT-6.2 изменилось поведение при многоходовых диалогах и в отношении позиции инструкций — приложениям с многоходовыми диалогами на старой версии нельзя просто сменить ID модели.
GPT-6.2 Sol vs GPT-6.1 Sol: краткий обзор
В таблице ниже — только те параметры, которые важны для решения об обновлении. Спецификации и цены взяты из официальной карточки модели OpenAI, страницы с ценами и журнала изменений; цены указаны в USD за миллион токенов.
| Критерий | GPT-6.1 Sol | GPT-6.2 Sol | Что означает разница |
|---|---|---|---|
| ID модели / дата запуска | gpt-6.1-sol / 2026-09-29 |
gpt-6.2-sol / 2026-11-17 |
Новая модель только вышла, нужно время для наблюдения |
| Контекст / максимальный вывод | 1,050,000 / 128,000 | 1,050,000 / 128,000 | Ёмкость не изменилась |
| Максимальный вход | В карточке модели отдельно не указан | 922,000 | Для задач со сверхдлинным входом нужно сверяться с новым лимитом |
| Отсечка знаний | 2026-04-30 | 2026-06-01 | Сдвинулась примерно на месяц позже |
| Цена Standard для короткого контекста | Ввод $2 / чтение кэша $0.10 / вывод $10 | Та же | При одинаковом наборе токенов счёт тот же |
| Обработка Flex | Поддерживается | Не поддерживается | Пользователям старого Flex придётся перейти на другие способы обработки |
| Окно фоновой скидки | В этих материалах не рассматривается | Окно 2 часа −30%, окно 8 часов −40% | Для задач, где задержка допустима, появились новые варианты экономии |
| Общий балл (AA, уровень Max) | 55 | 57 | В целом немного сильнее |
| Вопросы по кодовой базе (AA, Codex + Max) | 60 | 46 | Заметный регресс, нужна отдельная приёмка |
🚀 Быстрое сравнение: обе генерации модели можно переключать и сравнивать в одном и том же наборе интерфейсов. В публичном общем списке моделей APIYI apiyi.com уже есть
gpt-6.2-sol, отмечены два входа — responses и chat; удобно использовать один и тот же Key для регрессионного сравнения новой и старой версий.
Рекомендуемый порядок чтения: в разделе 1 основного текста сначала уточните цены и варианты обработки — от них зависит, как считать счёт. В разделе 2 сравните улучшения и провалы в публичных тестах, чтобы понять, какие задачи стоят обновления. В разделе 3 проверьте изменения в поведении API — сможет ли существующий сервис перейти плавно. В разделе 4 даётся план приёмки по задачам. Если интересует только агент для программирования, можно сразу смотреть 2.2 и раздел 4.
Термины, которые нужно знать перед сравнением GPT-6.2 Sol
| Термин | Краткое объяснение |
|---|---|
| Стандартная цена токена | Публичная цена OpenAI в тарифе Standard за каждый миллион входных и выходных токенов, а также за разные объёмы использования кэша |
| Стоимость задачи | Расходы на модель и инструменты для выполнения одной задачи; при приёмке бизнесом сюда также можно включить повторные запуски и ручную проверку |
| Уровень рассуждений | Настройка, управляющая бюджетом рассуждений модели; типичные значения — Low, Medium, High, Xhigh, Max. При сравнительном тестировании уровни нужно выравнивать |
| GDPval v2 | Внутренняя оценка OpenAI для сложной интеллектуальной работы; в центре внимания — длительные процессы из реальных типов проектов |
| Coding Agent Index | Сводный показатель агентов от Artificial Analysis, рассчитываемый по подпунктам: изменение кода, работа в терминале, вопросы по кодовой базе и др. |
| SWE-Atlas-QnA-AA | Подпункт «вопросы по кодовой базе» в указанном выше индексе; проверяет, достаточно ли фактов для ответа |
| Префикс диалога / чтение из кэша | Содержимое в начале многоходовых запросов, которое сохраняется в одном и том же порядке; когда сервис распознаёт повторно используемый префикс, попавшая в кэш часть тарифицируется по ставке чтения |
1. Сравнение GPT-6.2 Sol и GPT-6.1 Sol: базовые характеристики и цены
1.1 Характеристики GPT-6.2 Sol в основном повторяют предыдущее поколение
Модели обоих поколений можно вызывать через Responses и Chat Completions; вызовы функций и встроенные инструменты идут через Responses. Обе принимают на вход текст и изображения, нативно выводят текст, контекстное окно у них одинаковое — 1 050 000 токенов, максимальный вывод тоже одинаковый — 128 000 токенов. В карточке модели 6.2 Sol отдельно указан максимальный вход — 922 000 токенов.
В позиционировании есть небольшие отличия. На странице модели 6.1 Sol подчёркивается выполнение сложного кода, компьютерных операций и профессиональных задач по цене ниже, чем у Astra; страница 6.2 Sol склоняется к повседневному коду и работе агентов в масштабе. Иными словами, 6.2 Sol более явно ориентирована на высокочастотные и массовые сценарии.
1.2 Цена Standard у GPT-6.2 Sol такая же, как у предыдущего поколения
Официальная тарификация Standard выглядит так. Оба поколения используют один и тот же порог — 272K токенов входа на один запрос: после его превышения вход и кэш считаются по всему запросу с коэффициентом 2, а вывод — с коэффициентом 1,5.
| Категория тарификации Standard | Короткий контекст (≤272K) | Длинный контекст (>272K) |
|---|---|---|
| Обычный вход | $2.00 | $4.00 |
| Чтение кэша | $0.10 | $0.20 |
| Запись кэша на 30 минут | $2.50 | $5.00 |
| Запись кэша на 12 часов | $5.00 | $10.00 |
| Вывод (включая токены рассуждений) | $10.00 | $15.00 |
Одинаковая цена за единицу ещё не значит одинаковый счёт. При выполнении одной и той же задачи у 6.2 Sol могут меняться токены вывода, число вызовов инструментов и попадания в кэш, так что фактическую стоимость нужно считать по конкретной задаче. Запись в кэш должна считаться по своему полному тарифу и не суммируется с ценой обычного входа для тех же токенов. Общий объём вывода можно прочитать из usage.output_tokens в Responses, а расход на рассуждения обычно указан в подполе output_tokens_details.reasoning_tokens.
Что касается вызовов внутри Китая: по состоянию на 2026-11-20 в публичном интерфейсе цен APIYI apiyi.com цена gpt-6.2-sol на коротком тарифе совпадает с официальной, а на длинном тарифе обычный вход, чтение кэша, запись кэша и вывод составляют $3, $0.15, $3.75 и $11.25 соответственно. Это публично указанное выражение тарификации; фактический счёт зависит от группы аккаунта и текущей конфигурации платформы.
1.3 Выбор между Flex и фоновыми скидочными окнами
Изменения в вариантах обработки упустить проще всего. 6.1 Sol всё ещё входит в список моделей с поддержкой Flex, а 6.2 Sol Flex не поддерживает. В качестве альтернативы 6.2 Sol может использовать фоновое скидочное окно Responses: для подходящих запросов тариф на токены модели в 2-часовом окне на 30% ниже, чем в Standard, а в 8-часовом — на 40%.
Если старая система опирается на Flex для офлайн-пакетной обработки, при миграции придётся заново выбирать вариант по срокам доставки и условиям доступа. Задачи, для которых допустима доставка в течение нескольких часов, можно оценить по фоновому окну; задачи, требующие немедленного ответа, можно тарифицировать только по Standard.
2. GPT-6.2 Sol против GPT-6.1 Sol: прогресс и провалы в публичных тестах
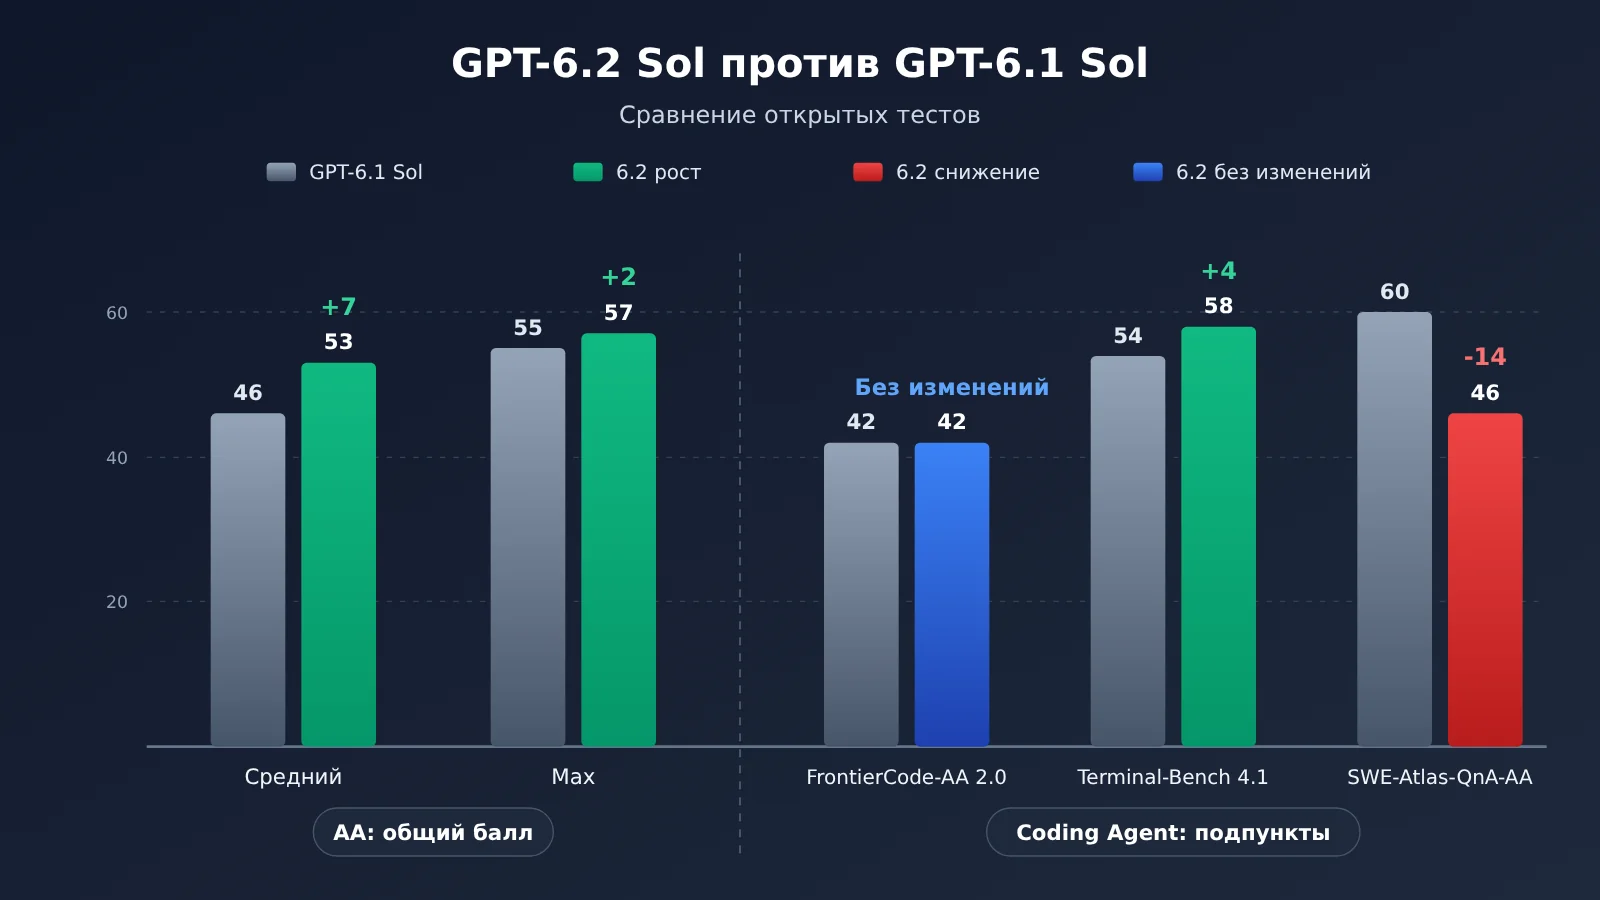
На диаграмме выше собраны сторонние публичные данные: зелёный цвет означает рост у 6.2 Sol, красный — снижение. Эти цифры получены от разных организаций и тестовых фреймворков, поэтому их корректно сравнивать только в рамках их собственных условий. Если хотите воспроизвести замеры на своих задачах, можно через APIYI apiyi.com вызывать оба поколения моделей по одному и тому же каналу и в одном и том же режиме.
2.1 Интеллектуальная работа и общие способности: GPT-6.2 Sol стабильно растёт
Официальные данные: OpenAI в анонсе от 2026-11-17 сообщила, что 6.2 Sol опережает 6.1 Sol на 5,3 процентного пункта во внутреннем бенчмарке GDPval v2. GDPval v2 проверяет многошаговую интеллектуальную работу в таких областях, как консалтинг, финансы и дизайн, так что этот вывод применим только к внутренним тестам, опубликованным OpenAI. В анонсе есть ещё один пункт — «вывод токенов сокращён на 22%», — но там сравниваются GPT-6.2 Astra и GPT-6 Astra, и переносить это на пару поколений Sol нельзя.
Независимые замеры: сводный балл Artificial Analysis охватывает интеллектуальную работу, программирование, науку и общие знания. От 6.1 Sol к 6.2 Sol режим Medium вырос с 46 до 53, режим Max — с 55 до 57. Средняя стоимость задачи в режиме Max снизилась с $1.27 до $1.01 — по опубликованным округлённым значениям это примерно на 20% меньше.
Обе группы данных указывают в одну сторону: 6.2 Sol сильнее на комплексных задачах и при этом дешевле в расчёте на задачу. Примечательно, что прирост в режиме Medium (+7) заметно больше, чем в Max (+2). Для команд, которые повседневно работают на среднем уровне рассуждений, эффект от этого обновления, скорее всего, будет ощутимее.
2.2 Изменение кода, работа в терминале и вопросы по кодовой базе: у GPT-6.2 Sol есть и рост, и падение
В Coding Agent Index v2.1 от Artificial Analysis обе модели тестировались в рамках Codex и на уровне рассуждений Max — то есть по одинаковой методике:
| Метрика (Codex + Max) | GPT-6.1 Sol | GPT-6.2 Sol | Изменение |
|---|---|---|---|
| Coding Agent Index, сводный | 52 | 49 | -3 |
| FrontierCode-AA 2.0 | 42 | 42 | без изменений |
| Terminal-Bench 4.1 | 54 | 58 | +4 |
| SWE-Atlas-QnA-AA (вопросы по кодовой базе) | 60 | 46 | -14 |
| Средняя стоимость API на одну задачу | $1.51 | $1.22 | около -19% |
| Среднее время работы агента | 21.9 мин | 17.5 мин | -4.4 мин |
Итоговый балл снизился в основном из-за подпункта «вопросы по кодовой базе»: он потерял 14 баллов и перекрыл рост на 4 балла в терминальном подпункте, тогда как подпункт «изменение кода» остался на прежнем уровне. В показателе времени работы не учитываются запуск окружения, ревью и проверка — он отражает только время выполнения самого агента. Кроме того, FrontierCode-AA 2.0 здесь — это версия Artificial Analysis, и её нельзя путать с одноимёнными рейтингами других организаций.
Другой ориентир — на задачи иного типа — даёт опубликованное Plotly 17.11.2026 сравнение DataAnalyticsBench за один прогон. При переходе с 6.1 Sol на 6.2 Sol общий балл изменился с 43/43 на 40/43, стоимость всего прогона упала с $2.61 до $1.22, а медианное время на одну задачу — с 17.6 до 10.5 секунды. Число вызовов инструментов снизилось с 258 до 158, объём вывода — примерно с 70,000 до 45,000 токенов. Три задачи, на которых 6.2 Sol ошибся, относятся к типу «скрытая закономерность».
У этих результатов есть два ограничения. Во-первых, тесты шли через фиксированный фреймворк OpenRouter и Plotly, и стоимость считалась по тарифам того канала на тот момент. Во-вторых, каждая модель прогонялась всего один раз, а при повторных прогонах других моделей Plotly наблюдал колебания до трёх задач. Так что эти данные скорее иллюстрируют одну закономерность: 6.2 Sol делает меньше действий, работает быстрее и дешевле, но на сложных задачах, где нужно копать глубже, может «сдаться слишком рано».
3. Как поведение API GPT-6.2 Sol влияет на существующие сервисы
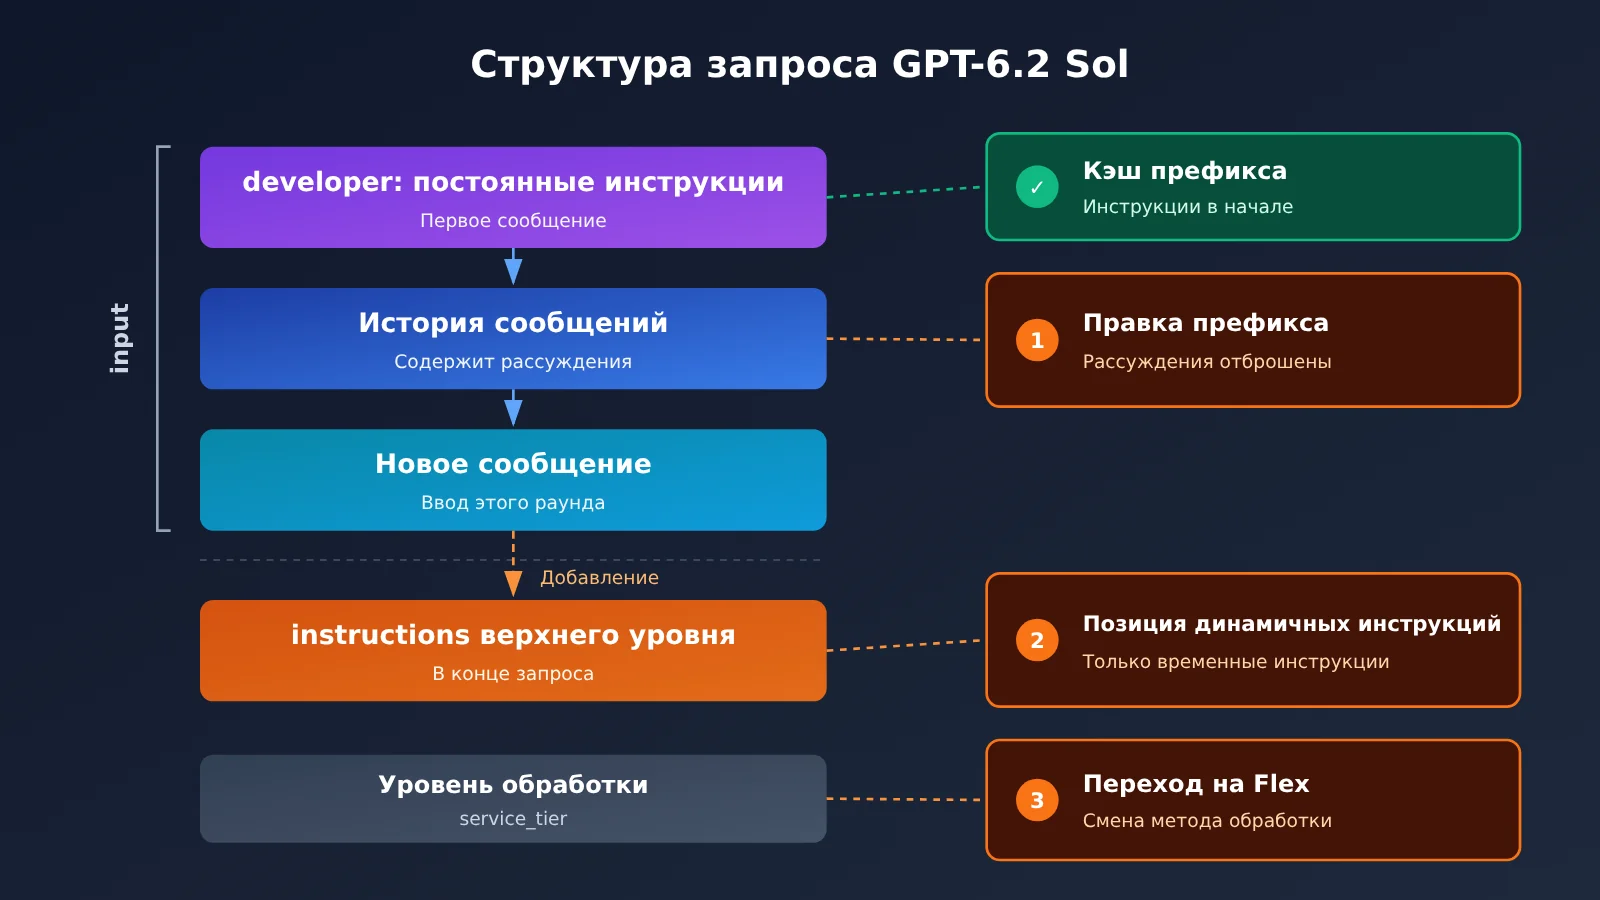
Для многошаговых приложений, которые уже работают на 6.1 Sol, риски сосредоточены в трёх областях. На схеме выше показана рекомендуемая структура запроса к GPT-6.2 Responses — её можно проверить напрямую через эндпоинт responses в APIYI apiyi.com.
- Перезапись префикса сессии: Responses API GPT-6.2 при редактировании существующего префикса сессии, частичном переключении модели, смене конечного пользователя или организации отбрасывает ранее полученные reasoning-элементы. Если в системе есть логика «переписать историю и продолжить диалог», нужно проверить, не пострадали ли качество продолжения и попадание в кэш.
- Позиция инструкций: верхнеуровневые
instructionsв GPT-6.2 добавляются послеinput. Фиксированные инструкции, которые нужно переиспользовать и которые должны попадать в кэш, следует помещать в первое сообщениеdeveloperвнутриinput; временные инструкции, меняющиеся каждый раз, можно по-прежнему передавать в верхнеуровневыхinstructions. - Миграция Flex: см. раздел 1.3 — запросы, которые раньше шли через Flex, нужно перевести на другой способ обработки.
Кроме того, оба эндпоинта не принимают уровень рассуждений none. При замене ID модели также стоит по официальному руководству по миграции проверить перезапись истории, параметры сэмплирования, уровень рассуждений, слой обработки и данные кэша.
3.1 Минимальный пример вызова GPT-6.2 Sol
Ниже — минимальная проверка через Chat Completions:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # единый интерфейс APIYI
)

resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "用三句话说明什么是会话前缀缓存"}]
)
print(resp.choices[0].message.content)
Посмотреть код сравнения старой и новой версий Responses API (фиксированные инструкции в начале + запись расхода)
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # обе версии идут через один канал — сравнение получается честным
)

STABLE_RULES = "你是代码库助手。回答必须列出涉及的文件路径、调用方和配置开关。"

def run(model: str, question: str, effort: str = "medium"):
    resp = client.responses.create(
        model=model,
        reasoning={"effort": effort},   # оба эндпоинта не принимают none
        input=[
            # фиксированные инструкции — первым developer-сообщением в input, это помогает префиксному кэшированию
            {"role": "developer", "content": STABLE_RULES},
            {"role": "user", "content": question},
        ],
        # временные инструкции можно передать в top-level instructions — они добавляются после input
        instructions="本轮只回答与鉴权模块相关的部分。",
    )
    usage = resp.usage
    details = getattr(usage, "output_tokens_details", None)
    return {
        "model": model,
        "text": resp.output_text,
        "output_tokens": usage.output_tokens,
        "reasoning_tokens": getattr(details, "reasoning_tokens", None),
    }

for m in ["gpt-6.1-sol", "gpt-6.2-sol"]:
    r = run(m, "登录失败后的重试逻辑在哪里实现?受哪些配置影响?")
    print(r["model"], r["output_tokens"], r["reasoning_tokens"])
    print(r["text"][:300], "\n---")
🎯 Технический совет: при миграции многошаговых приложений стоит сохранить набор реальных запросов, где «префикс не меняется, только добавляются сообщения», и отправить их обоим поколениям моделей, сравнив ответы и расход на чтение кэша. APIYI apiyi.com поддерживает одновременный вызов моделей обоих поколений, так что сравнительные тесты удобно включить в CI.
4. Приёмка по типам задач перед переключением на GPT-6.2 Sol
Схема ниже — это дизайн тестирования, построенный на основе перечисленных выше публичных данных, а не официальное требование. Ключевой принцип: всё, кроме модели, фиксируется — тот же канал API, уровень рассуждений, входные материалы, список инструментов, настройки тайм-аута и правила оценки, а 6.1 Sol сохраняется как контрольная группа.
| Тип задачи | Приоритет пробного прогона | Основные свидетельства | Условия приёмки |
|---|---|---|---|
| Правка кода | Приоритетный прогон | FrontierCode-AA 2.0 на том же уровне, стоимость и длительность снижаются | Доля прошедших тестов не ниже, чем у старой версии; стоимость одной качественной сдачи снижается |
| Работа в терминале / на компьютере | Приоритетный прогон | Terminal-Bench 4.1 +4 | Доля успешных выполнений и сквозное время P50, P95 |
| Обычный анализ | Приоритетный прогон | Общий балл растёт, время и стоимость Plotly снижаются | Доля принятых с первой попытки, число пропущенных пунктов |
| Вопросы по кодовой базе | Отдельная приёмка | SWE-Atlas-QnA-AA -14 | Покрытие заранее размеченных обязательных фактов |
| Редкий сложный анализ / трудные случаи | Отдельная приёмка | Потеря баллов на задачах со скрытыми закономерностями в Plotly | Стоимость качественной сдачи после повторной проверки |
| Многошаговые процессы | Отдельная приёмка | Отбрасывание пунктов рассуждения, смещение позиции инструкций | Согласованность результатов после воспроизведения, дописывания истории и восстановления после сбоя |
На практике можно идти по такому чек-листу:
- Вопросы по кодовой базе: заранее для каждого вопроса разметьте вызывающий код, конфигурационные переключатели, условия ветвления и пути к файлам, которые обязательно должны быть покрыты, и проверяйте полноту доказательств по каждому пункту, а не только «похож ли ответ на правильный».
- Фиксация метрик: по каждому типу задач записывайте долю принятых с первой попытки, пропущенные пункты, число переделок, сквозное время, а также расход модели и инструментов; при достаточной выборке смотрите и P50, и P95.
- Расчёт стоимости: оценивайте стоимость одной качественной сдачи как «общая стоимость за период оценки ÷ число принятых задач», причём расходы на повторную проверку и перезапуски тоже включайте в общую стоимость. Один вызов 6.2 Sol дешевле, но если трудных случаев с переделками становится больше, стоимость качественной сдачи может наоборот вырасти.
- Решение о масштабировании: расширяйте трафик только для тех типов задач, где выполнены все три критерия — порог качества, стоимость качественной сдачи и задержка; остальные оставляйте на 6.1 Sol до следующего раунда повторного тестирования.
💰 Подсказка по расчёту стоимости: в рамках одного канала цена за единицу одинакова — только тогда сравнение имеет смысл. Через APIYI apiyi.com с одним ключом можно параллельно запускать оба поколения моделей, а счета ведутся по каждой модели отдельно, так что их можно напрямую использовать для расчёта стоимости одной качественной сдачи.
GPT-6.2 Sol против GPT-6.1 Sol: как выбрать
Если ваша нагрузка — это в основном правки кода, терминальные агенты и обычный анализ, то 6.2 Sol при той же цене будет более быстрым и экономным вариантом, и переходить на него можно в первую очередь. Если же велика доля вопросов-ответов по кодовой базе и задач на поиск скрытых закономерностей, либо бизнес завязан на Flex, сначала пройдите отдельную приёмку из раздела 4. Пока соответствующие метрики не достигнуты, эту часть трафика может продолжать обслуживать 6.1 Sol. Ключевая переменная, определяющая выбор, — состав задач: чем выше доля сложных случаев, тем сильнее преимущества 6.2 Sol в цене и скорости может съесть переделка.
Рекомендуем сначала на APIYI apiyi.com воспользоваться бесплатным тестовым лимитом для новых пользователей, отобрать репрезентативные образцы по каждому типу задач и провести один сравнительный прогон, а затем по результатам решать, в каком объёме переключаться.
Справочные материалы
- Анонс OpenAI: описание релиза GPT-6.2 Astra и Sol и выводы GDPval v2
- Ссылка:
openai.com/index/introducing-gpt-6-2-astra-sol
- Ссылка:
- Модельная карточка и цены OpenAI API: характеристики, цены и варианты обработки двух поколений Sol
- Ссылка:
developers.openai.com/api/docs/models/gpt-6.2-sol - Ссылка:
developers.openai.com/api/docs/pricing
- Ссылка:
- Руководство по GPT-6.2: изменения поведения Responses и пункты проверки при миграции
- Ссылка:
developers.openai.com/api/docs/guides/latest-model
- Ссылка:
- Artificial Analysis: сводный балл и данные по отдельным метрикам Coding Agent Index
- Ссылка:
artificialanalysis.ai/agents/coding-agents/codex
- Ссылка:
- Plotly DataAnalyticsBench: сравнение 6.2 Sol в одном раунде и разбор ошибок
- Ссылка:
plotly.com/blog/gpt-6-2-sol-plotly-data-analytics-bench
- Ссылка:
Автор: техническая команда APIYI
Техническая связь: пишите нам на главной странице APIYI apiyi.com, больше материалов по подключению — в документации docs.apiyi.com