Resumo: Este artigo explica a promoção noturna de 8% em Credits do Qwen4-Max-Preview e compara o plano de assinatura Token Plan, a API oficial com pagamento por uso e a plataforma de agregação de APIs multimodelo em três aspectos: escopo de uso, unidade de cobrança e custo total por tarefa.
Conclusão antecipada sobre os 8% de Credits do Qwen4-Max-Preview
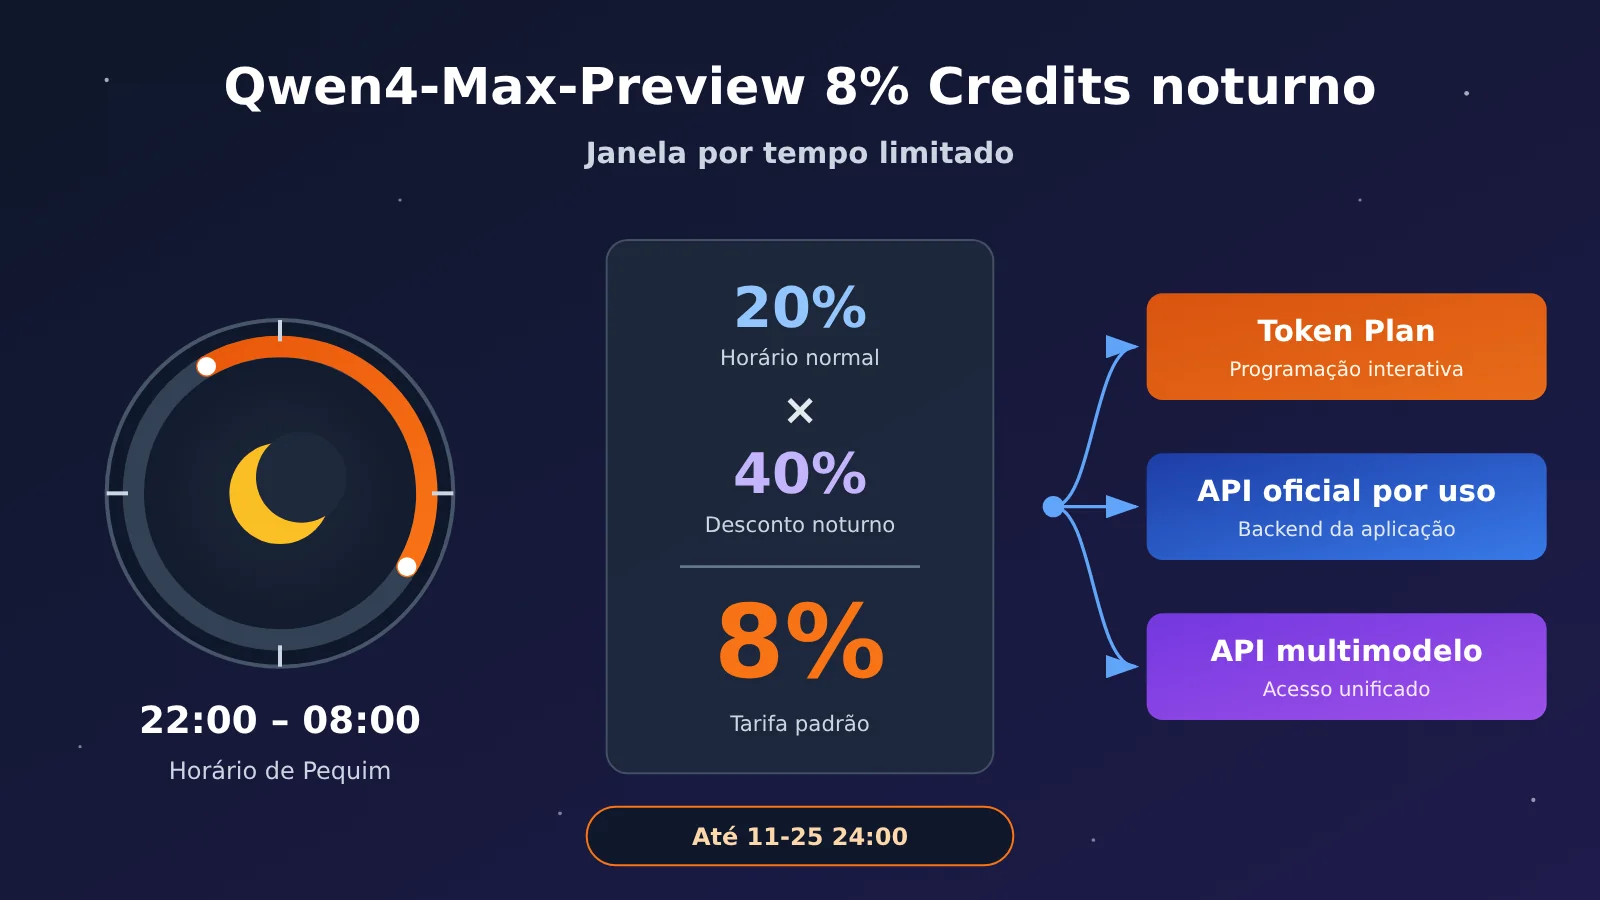
Ao chamar o Qwen4-Max-Preview no Token Plan, o consumo de Credits todas as noites, das 22:00 às 08:00 do dia seguinte, no horário de Pequim, corresponde a 8% da tarifa padrão. Esse percentual resulta de 20% × 40% = 8%: no horário normal, o valor fica em 20% da tarifa; à noite, há um desconto adicional que o reduz a 40% desse valor. A promoção vai até o fim do preview, em 25 de novembro de 2026, às 24:00 (horário de Pequim); depois disso, o modelo será descontinuado.
A promoção se aplica apenas aos cenários permitidos pelo Token Plan, ou seja, ao uso interativo em ferramentas de programação e ferramentas de agentes. Para integrar o modelo ao backend de uma aplicação própria ou a automações de negócios, é preciso escolher um produto de API com pagamento por uso que permita esse tipo de finalidade. A versão oficial do Qwen4-Max, lançada em 16 de novembro, já oferece preço independente de cobrança por uso e pode atender a essa necessidade.
A seguir, vamos detalhar como os 8% são calculados e os preços dos pacotes do Token Plan; depois, explicamos os critérios de cobrança por uso e o mecanismo de cache da versão oficial. Em seguida, comparamos três tipos de solução de invocação em quatro aspectos — tarefas aplicáveis, forma de uso, unidade de cobrança e interface — e apresentamos uma estrutura de cálculo para alocar custos por tarefa. Por fim, damos recomendações de escolha conforme o tipo real de tarefa do desenvolvedor.
Para saber: termos de cobrança do Qwen4-Max-Preview
| Termo | Explicação |
|---|---|
| Credits | Unidade de dedução do plano de assinatura Token Plan; o consumo depende do modelo usado e da composição específica desta chamada |
| Token | Unidade de medida da entrada, da saída e do conteúdo de raciocínio do modelo |
| Token Plan | Produto da Alibaba Cloud que concede benefícios em Credits por ciclo de assinatura, nas versões individual e para equipes |
| API de pagamento por uso | Modalidade de serviço de modelo cobrada pelo volume real de chamadas, voltada à integração em aplicações |
| Acerto de cache | Entradas repetidas são reutilizadas pelo servidor e cobradas conforme as regras de cobrança aplicáveis ao cache |
| Token de raciocínio | Tokens gerados no processo de inferência do modelo, que consomem o orçamento de saída e entram na cobrança de saída |
| Plataforma de agregação de API | Serviço que oferece invocação de vários modelos e gestão de uso por meio de uma interface unificada |
| Custo por tarefa unitária | Soma de todas as requisições, novas tentativas, chamadas de ferramentas e consumo de modelo necessários para concluir o mesmo objetivo |
1 Como surge o preço promocional de 0,8 (8% da tarifa) do Qwen4-Max-Preview
1.1 Duas camadas de redução acumuladas: 20% × 40% = 8%
Durante o período da campanha Preview, o Token Plan aplica duas camadas de benefício em Credits ao Qwen4-Max-Preview:
- Horário normal: o consumo de Credits é 20% da tarifa padrão, ou seja, paga-se 20% do valor. Com o mesmo orçamento de Credits, em teoria é possível realizar cerca de 5 vezes o volume de chamadas da tarifa padrão.
- Horário noturno: todos os dias, das 22h às 8h do dia seguinte, no horário de Pequim, aplica-se um fator de 40% sobre essa base de 20%.
- Resultado da acumulação: 20% × 40% = 8%, ou seja, 8% da tarifa padrão (0,8 na convenção chinesa de desconto).
A documentação oficial apresentou um exemplo de proporção: se uma chamada deveria consumir 100 Credits pela tarifa padrão, no horário normal ela consome de fato 20 Credits; no horário noturno, 8 Credits. Trata-se apenas de um exemplo matemático para demonstrar a proporção. O consumo real de cada chamada deve ser conferido no detalhamento de uso do console. A empresa também se reserva o direito de ajustar os benefícios conforme as condições operacionais.
1.2 Limites temporais da janela por tempo limitado do Qwen4-Max-Preview
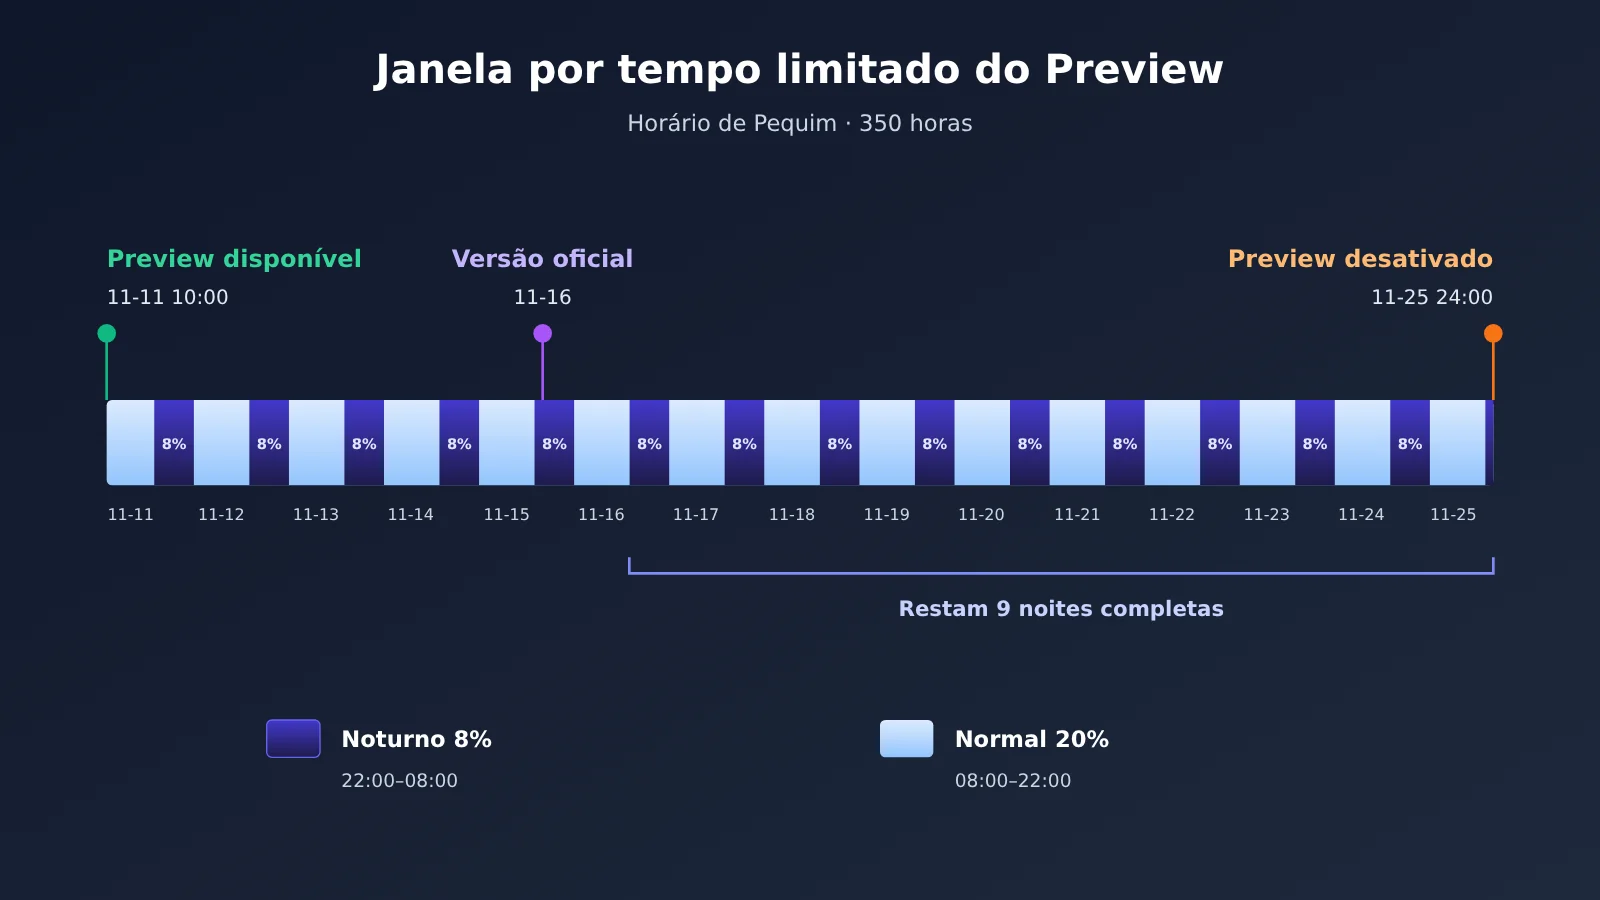
O Preview foi aberto em 11 de novembro de 2026, às 10h, e termina em 25 de novembro de 2026, às 24h (todos no horário de Pequim), totalizando 350 horas. Tomando como base hoje, 16 de novembro, os períodos noturnos completos restantes são as 9 noites entre a noite de 16 de novembro e a manhã de 25 de novembro. Na noite de 25 de novembro, a faixa noturna vai apenas das 22h às 24h, duas horas; depois disso, o Preview é desativado.
Depois que a versão oficial do Qwen4-Max entrar no ar em 16 de novembro, o horário de desativação do Preview permanece o mesmo. A documentação oficial do modelo já recomenda o uso da versão oficial; portanto, os fluxos de trabalho criados dentro da janela do Preview devem, em paralelo, ser preparados para migração para qwen4-max.
2 Como comprar e como os Credits do Token Plan são consumidos
2.1 Preços e franquias dos planos individuais do Token Plan
Até 16 de novembro de 2026, os planos individuais do Token Plan da Alibaba Cloud divulgados na página oficial são os seguintes. As franquias mensais e os preços passaram por um ajuste em 9 de novembro; capturas de tela e artigos mais antigos com os preços anteriores já não valem.
| Plano | Preço mensal | Credits mensais | Agentes simultâneos | Preço para novos usuários |
|---|---|---|---|---|
| Lite | 39 yuans | 20.000 | 1–2 | 19,5 yuans/mês |
| Essential | 79 yuans | 45.000 | 2–3 | 39,5 yuans/mês |
| Standard | 139 yuans | 80.000 | 3–4 | a página não lista desconto para novos usuários |
| Pro | 312 yuans | 200.000 | 6–8 | a página não lista desconto para novos usuários |
O preço para novos usuários vale até 30 de novembro de 2026, 23:59:59 (UTC+8), e é exclusivo para contas que nunca compraram o plano individual do Token Plan antes. O desconto para novos usuários reduz o preço da assinatura do plano; já os descontos de 80% e 92% (2 折 e 0,8 折) do Preview reduzem o consumo de Credits na invocação do modelo — ou seja, cada um age em uma etapa diferente.
2.2 Regras dos pacotes de uso extra do Token Plan
Quando a franquia do plano acaba, é possível comprar pacotes de uso extra. As regras são:
- Preço de 100 yuans por pacote por mês, com 20.000 Credits em cada pacote.
- É obrigatório já ter um plano ativo, e é possível acumular no máximo 5 pacotes ao mesmo tempo.
- A validade é de um mês; a franquia não utilizada expira ao final do período.
- A franquia do pacote é independente da franquia mensal original do plano.
2.3 A relação de medição entre Credits e Tokens
Credits são a unidade de desconto do Token Plan, e Tokens são a unidade de cálculo do modelo — não dá para converter um no outro na proporção de um para um. Segundo a explicação oficial, quantos Credits são descontados em uma invocação depende dos seguintes fatores:
- O tipo de modelo e o seu coeficiente de cobrança;
- O número de Tokens de entrada, incluindo os Tokens que tiveram cache hit;
- O número de Tokens de saída, incluindo os Tokens de raciocínio;
- O número de chamadas de ferramentas, além das chamadas extras geradas por ferramentas nativas e subtarefas.
Por isso, com 39 yuans e 20.000 Credits não é possível deduzir o preço por milhão de Tokens do Qwen4-Max-Preview. A documentação oficial não publica um preço independente por milhão de Tokens para o Preview, e o Preview também não tem cobrança por uso. Um registro real que serve de referência: um desenvolvedor concluiu um projeto interativo de máquina de pegar pelúcias no Qoder, levando cerca de 75 minutos, com consumo estimado em cerca de 65 Credits. Esse é o registro de uma única tarefa em uma ferramenta específica, útil apenas para se ter uma ideia da ordem de grandeza do consumo.
3 Comparação do modelo de cobrança entre o Qwen4-Max-Preview e a versão oficial
3.1 Preview: acesso exclusivo somente via Token Plan
O modo de acesso ao Preview é fixo: assine o Token Plan Individual ou Equipe, obtenha a chave API exclusiva do plano, use o URL base dedicado https://token-plan.cn-beijing.maas.aliyuncs.com e defina o ID do modelo como qwen4-max-preview (alias qwen4.0-max-preview, que é o nome exibido de forma padronizada na fatura). Ele é compatível com as especificações das interfaces OpenAI Chat Completions, Responses e Anthropic Messages.
O orçamento de saída do Preview é de 393.216 tokens, compartilhado entre o conteúdo de raciocínio e a resposta final, e a intensidade de raciocínio padrão é xhigh. Ao migrar de outros modelos, se você configurar max_tokens apenas com base no comprimento da resposta final, a resposta poderá ser truncada porque o conteúdo de raciocínio esgota o orçamento.
3.2 Qwen4-Max oficial: preços da API com pagamento por uso
A versão oficial qwen4-max foi lançada em 16 de novembro. Ela pode ser usada tanto no Token Plan quanto chamada com pagamento por uso. A seguir estão os preços de cobrança por uso da versão oficial listados na página oficial do modelo (em RMB, na unidade de yuans por milhão de tokens):
| Região de implantação | Entrada | Saída (incluindo raciocínio e resposta) |
|---|---|---|
| China Continental, Norte da China 2 (Pequim) | 10 yuans | 30 yuans |
| Virgínia, EUA | 10 yuans | 30 yuans |
| Frankfurt, Alemanha | 10 yuans | 30 yuans |
| Tóquio, Japão | 10 yuans | 30 yuans |
| Hong Kong, China | 10 yuans | 30 yuans |
| Singapura | 10,938 yuans | 32,813 yuans |
A região de Pequim também tem uma cota gratuita de 1 milhão de tokens, válida por 90 dias a partir do evento que inicia a contagem (ativação do Bailian, lançamento do modelo ou aprovação da solicitação, entre outros), conforme as regras da página oficial. Esses preços se aplicam apenas à versão oficial e não podem ser usados para inferir o consumo padrão de Credits do Preview.
Os parâmetros da versão oficial também são diferentes dos do Preview: a janela de contexto também é de 1.000.000 de tokens; a saída máxima é de 262.144 tokens no modo de raciocínio e de 131.072 tokens no modo sem raciocínio; a intensidade de raciocínio padrão é high e o orçamento de raciocínio padrão é 131.072. Ao migrar, é preciso revisar novamente a configuração do limite máximo de saída.
3.3 Mecanismo de cache explícito do Qwen4-Max oficial
A versão oficial oferece suporte a cache explícito, permitindo reutilizar prefixos de entrada fixos, como comandos do sistema, descrições de ferramentas e documentos de referência. O cache explícito é compatível com as três interfaces OpenAI Chat Completions, Responses e Anthropic Messages, e o TTL pode ser de 5 minutos ou 1 hora.
Tarefas de agente com múltiplos turnos normalmente precisam reenviar as mesmas instruções do sistema e descrições de ferramentas a cada turno, e é justamente aí que o cache consegue economizar mais custos. O cache tem regras de cobrança próprias; para saber o preço unitário específico, consulte a página de cobrança de invocação do modelo na região correspondente.
4 Para quem serve cada um dos três modos de invocação do Qwen4-Max-Preview
4.1 Comparação entre as três abordagens
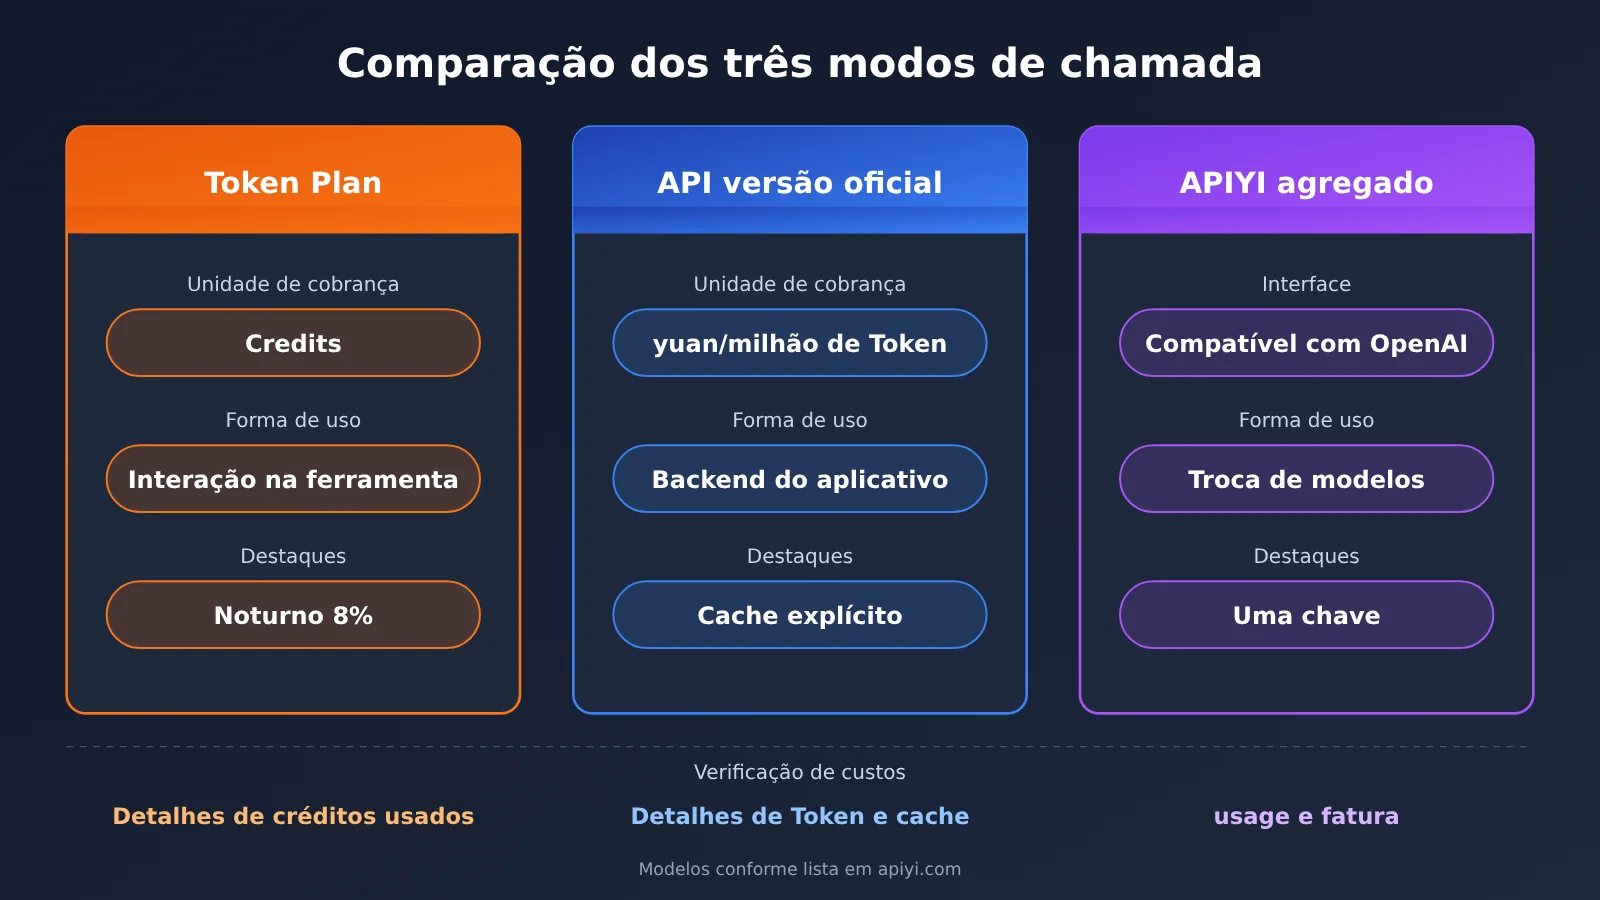
| Dimensão | Assinatura Token Plan | API da versão oficial com pagamento por uso | Plataforma de agregação de APIs multimodelo |
|---|---|---|---|
| Tarefas indicadas | Programação interativa, conversa com agentes | Backend de aplicações próprias, negócios automatizados | Aplicações multimodelo, comparação e alternância entre modelos |
| Formas de uso permitidas | Apenas uso interativo dentro de ferramentas de programação e de agentes inteligentes | Integração em aplicações | Integração em aplicações, com gestão unificada de vários modelos |
| Unidade de cobrança | Credits | Yuan/milhão de tokens (por região) | Preço unitário de tokens publicado na interface de preços da plataforma |
| Validade da cota | Pacotes e blocos de uso são mensais e expiram, sem reaproveitamento | Liquidação por uso; cota gratuita de Pequim por 90 dias | Liquidação por uso |
| Interface | Base URL dedicada e chave exclusiva do pacote | Interface oficial do Bailian | Interface compatível com OpenAI, como APIYI apiyi.com |
| Como conferir os custos | Detalhamento dos Credits efetivamente descontados no console | Agregação pelos detalhes de tokens e pela cobrança de cache | Agregação pelo campo usage das requisições e pela fatura da plataforma |
4.2 Assinatura do Token Plan: ideal para programação interativa dentro das ferramentas
O Token Plan oferece suporte a ferramentas como Claude Code, Cursor, Qwen Code, Qoder, Qoder CN, OpenClaw e outras, conforme a documentação oficial de integração de cada ferramenta. Quando o desenvolvedor inicia uma tarefa ativamente nessas ferramentas, o desconto noturno de 8% do Preview já entra em vigor, e o custo também fica travado antecipadamente na forma de Credits.
As fronteiras de uso estão definidas na especificação oficial de permissões: não é permitido chamar em lote por meio de scripts automatizados, nem colocar a chave do plano no backend de aplicações próprias, nem fazer chamadas em lote não interativas, nem usar indevidamente os benefícios do plano por meio de plataformas de workflow como Dify, n8n e Coze, ou de ferramentas de teste de API como Postman e Insomnia. Ultrapassar esses limites pode resultar na suspensão da assinatura ou no bloqueio da chave. Além disso, o aviso de assinatura da versão pessoal determina que as entradas e o conteúdo gerado durante o uso serão utilizados para melhoria do serviço e otimização do modelo; antes de processar materiais confidenciais, é preciso verificar primeiro o acordo.
4.3 API oficial de pagamento por uso: ideal para integração de aplicações em produção
Backends de aplicações próprias, tarefas em lote e fluxos automatizados devem usar a API de pagamento por uso do qwen4-max na versão oficial. O critério de cobrança é o preço unitário público, em yuan por milhão de tokens e, com cache explícito, o custo pode ser conferido solicitação por solicitação. Esse caminho não tem o desconto grande dos Credits, mas a forma de uso e o modo de cobrança são claros e compatíveis com as regras.
4.4 Plataformas de agregação de APIs multi-modelo: ideais para equipes que precisam de uma interface unificada
Se a aplicação precisar usar modelos de vários fornecedores, como OpenAI, Claude e Gemini, ao mesmo tempo, uma plataforma de agregação permite fazer as chamadas com uma única chave API e um conjunto de interfaces compatíveis com OpenAI, além de centralizar o gerenciamento de uso. A APIYI é uma dessas plataformas. Vale esclarecer que um artigo da Central de Ajuda da APIYI, de 13 de novembro, registrava que o Qwen4 ainda não constava na tabela geral de modelos nem no endpoint de preços, e um artigo público de 16 de novembro também marcava o qwen4-max como ainda não disponível. Todos esses registros são instantâneos daquele dia; para saber se o modelo já está disponível, consulte a tabela geral de modelos e o endpoint de preços atuais.
🎯 Dica técnica: ao criar uma aplicação multi-modelo, você pode primeiro usar o mesmo código na APIYI apiyi.com para comparar o desempenho de vários modelos já disponíveis na sua tarefa. Depois que o modelo desejado estiver disponível, basta alterar o parâmetro
modelpara fazer a troca.
5 Como os desenvolvedores calculam o custo real do Qwen4-Max-Preview e da API
5.1 Estrutura de cálculo do custo por tarefa do Qwen4-Max
O preço unitário do modelo ser baixo não garante que o custo total para concluir uma tarefa também seja baixo. Uma tarefa de Agent pode envolver dezenas de requisições, muito contexto repetido, saídas de raciocínio longas e novas tentativas após falhas. Ao comparar soluções, use “concluir o mesmo objetivo” como unidade e agrupe os custos de acordo com os detalhes de cobrança de cada produto:
| Item de custo | Forma de cálculo da API com pagamento por uso | Forma de registro do plano de Credits |
|---|---|---|
| Entrada não cacheada | Quantidade de entrada não cacheada × preço unitário de entrada correspondente | Registrar diretamente os Credits efetivamente deduzidos no console |
| Cache | Custos de leitura, escrita e armazenamento de cache, calculados conforme as regras da região correspondente | Já incluídos na dedução real |
| Saída | Quantidade de saída (incluindo Tokens de raciocínio cobrados) × preço unitário de saída | Já incluídos na dedução real |
| Ferramentas e novas tentativas | Custo de chamadas de ferramentas + todo o consumo das requisições de nova tentativa | Já incluídos na dedução real |
Em forma de fórmula: Custo da tarefa = quantidade de entrada não cacheada × preço de entrada + custos de leitura/escrita e armazenamento de cache + quantidade de saída (incluindo raciocínio cobrado) × preço de saída + custos de ferramentas/novas tentativas. O plano de Credits não faz conversão de Tokens; registra diretamente a diferença de saldo de Credits entre o início e o fim da tarefa. As duas categorias de resultado têm unidades diferentes; ao comparar, avalie separadamente “quantos yuan cada tarefa custou” e “quantos Credits cada tarefa consumiu”, e só então, junto com a mensalidade do pacote, julgue a relação custo-benefício.
5.2 Registrar com código o uso de tokens de cada requisição
A conferência do plano de pagamento por uso depende do campo usage retornado em cada requisição. O exemplo minimalista abaixo mostra como ler o consumo em uma interface compatível com OpenAI. Substitua o ID do modelo por uma versão já disponível na lista de modelos da plataforma:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # interface compatível com OpenAI da APIYI
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_ID",  # use um modelo já disponível na lista de modelos da plataforma
    messages=[{"role": "user", "content": "总结这段日志中的错误类型"}],
)
print(resp.usage)  # registra prompt_tokens / completion_tokens etc., para alocação de custos
Ver o código completo de alocação de custos por tarefa
import openai
from dataclasses import dataclass, field

@dataclass
class TaskLedger:
    """Aloca o uso de tokens por tarefa; o preço unitário é informado pelo chamador conforme o produto e a região escolhidos"""
    input_price_per_m: float          # yuan por milhão de tokens, entrada não cacheada
    output_price_per_m: float         # yuan por milhão de tokens, saída (incluindo raciocínio)
    cache_cost: float = 0.0           # custos de leitura, gravação e armazenamento de cache, preenchidos manualmente conforme o detalhamento
    tool_cost: float = 0.0            # custos de chamadas de ferramentas
    records: list = field(default_factory=list)

    def add(self, usage):
        cached = 0
        details = getattr(usage, "prompt_tokens_details", None)
        if details is not None:
            cached = getattr(details, "cached_tokens", 0) or 0
        self.records.append({
            "uncached_input": usage.prompt_tokens - cached,
            "output": usage.completion_tokens,
        })

    def total(self) -> float:
        inp = sum(r["uncached_input"] for r in self.records)
        out = sum(r["output"] for r in self.records)
        return (inp / 1e6 * self.input_price_per_m
                + out / 1e6 * self.output_price_per_m
                + self.cache_cost + self.tool_cost)

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# preencha o preço unitário conforme o produto e a região efetivamente utilizados
ledger = TaskLedger(input_price_per_m=0.0, output_price_per_m=0.0)

for attempt in range(3):  # o consumo gerado por novas tentativas também entra no custo da tarefa
    resp = client.chat.completions.create(
        model="YOUR_MODEL_ID",
        messages=[{"role": "user", "content": "修复 query.py 中的分页错误"}],
    )
    ledger.add(resp.usage)
    if resp.choices[0].finish_reason == "stop":
        break

print(f"本任务请求数: {len(ledger.records)},合计成本: {ledger.total():.4f} 元")
5.3 Cálculo hipotético: uma tarefa de Agent na versão oficial, região de Pequim
O cálculo abaixo é hipotético; os números servem apenas para demonstrar a fórmula. Suponha que uma tarefa seja chamada na versão oficial do Qwen4-Max, região de Pequim, com pagamento por uso, acumulando 2.000.000 Tokens de entrada não armazenados em cache e 50.000 Tokens de saída (incluindo raciocínio), sem usar cache nem ferramentas de cobrança:
- Entrada: 2 × 10 yuans = 20 yuans
- Saída: 0,05 × 30 yuans = 1,5 yuans
- Total: 21,5 yuans
Esse resultado mostra que o custo de uma tarefa de Agent com contexto longo vem principalmente da entrada reenviada repetidamente. Se transformarmos o comando de sistema fixo e as descrições das ferramentas em cache explícito, a estrutura da parte de entrada muda; quanto dá para economizar depende da taxa de acerto do cache e do preço unitário do cache na região correspondente. Para a mesma tarefa no plano de Credits, registre diretamente o valor real deduzido, sem converter esses 21,5 yuans em Credits.
💰 Conferência de custos: se o negócio precisar comparar ao mesmo tempo o custo por tarefa de vários modelos já disponibilizados na mesma tarefa, é possível ler o usage de cada modelo pela interface unificada do APIYI apiyi.com e consolidar com o TaskLedger acima usando o mesmo critério.
6 Como escolher o esquema de invocação durante a fase do Qwen4-Max-Preview
6.1 Programação interativa: usar o Token Plan na janela noturna para tarefas longas
Se você escreve código principalmente em ferramentas como Claude Code, Cursor ou Qoder, o Token Plan combina melhor com o desconto do Preview. Na prática:
- Agende para o período entre 22:00 e 08:00 as tarefas interativas que exigem contexto grande e raciocínio longo, iniciando e acompanhando você mesmo nas ferramentas — por exemplo, entender a base de código, depurar entre módulos ou analisar documentos longos.
- Reserve orçamento de saída para o conteúdo de raciocínio; no Preview, os 393.216 Tokens são compartilhados entre raciocínio e resposta.
- Anote o saldo de Credits no início e no fim de cada tarefa para acumular seus próprios dados de consumo por tarefa.
- Na primeira compra, compare os preços de novo usuário dos dois planos: Lite por 19,5 yuans e Essential por 39,5 yuans, com promoção até 30 de novembro.
- Antes de 25 de novembro, rode suas tarefas habituais com a versão oficial
qwen4-maxpara confirmar o limite de saída e a configuração de intensidade de raciocínio.
6.2 Aplicações próprias e operações automatizadas: escolher API de pagamento por uso ou plataforma agregadora
Serviços de backend, tarefas agendadas, processamento de dados em lote e integração com plataformas de workflow estão todos dentro das restrições do Token Plan pessoal; o certo é escolher uma API de pagamento por uso que permita chamadas de backend comercial. Se você usa apenas modelos da família Tongyi, pode se conectar diretamente à API oficial de pagamento por uso da versão oficial do Qwen4-Max e usar cache explícito para controlar o custo de entrada. Quando a aplicação precisa combinar modelos de vários provedores, dá para usar a interface e a fatura unificadas de uma plataforma agregadora de APIs.
💡 Sugestão de escolha: o canal de integração deve se basear na disponibilidade real do modelo. Se o modelo desejado já estiver disponibilizado no APIYI apiyi.com, você pode chamá-lo diretamente pela interface unificada; se ainda não estiver, pode primeiro usar na plataforma um modelo já disponibilizado para desenvolver o fluxo de interface e apuração de custos, e depois trocar o parâmetro
modelquando ele for disponibilizado.
6.3 Consulta rápida de decisão para o Qwen4-Max-Preview
- Desenvolvedor individual que interage principalmente dentro de ferramentas de programação: Token Plan + janela noturna do Preview; depois de 25 de novembro, mude para a versão oficial
qwen4-max. - Equipe desenvolvendo aplicação própria: API oficial de pagamento por uso, escolhendo o preço unitário por região, com cache explícito ativado.
- Aplicação com vários modelos ou fase de escolha de modelo: plataforma agregadora de APIs multi-modelo, interface unificada e custo consolidado por tarefa.
- Tratamento de dados confidenciais: verifique primeiro os termos de uso de dados do produto correspondente e só então decida a forma de integração.
7 Conclusão: uso correto da janela de 8% de Credits do Qwen4-Max-Preview
Os 8% de Credits noturnos do Qwen4-Max-Preview são uma promoção por tempo limitado dentro do Token Plan, válida até 24:00 de 25 de novembro, e se aplicam ao uso interativo em ferramentas de programação e ferramentas de agentes. A versão final do Qwen4-Max já foi lançada em 16 de novembro; na região de Pequim, o preço de cobrança por uso é de 10 yuans para entrada e 30 yuans para saída por milhão de Tokens, adequado para backends de aplicações e operações de automação. Credits e Tokens pertencem a dois sistemas de medição distintos; ao comparar custos, tome a unidade de tarefa como referência e registre separadamente o valor abatido em Credits e o valor acumulado por Tokens.
Ao tomar a decisão, siga esta ordem: primeiro determine se a tarefa é uma interação dentro de uma ferramenta ou uma chamada de backend; depois escolha o produto compatível correspondente; por fim, meça o custo real com a mesma tarefa. Quando precisar comparar desempenho e custo entre vários modelos já disponíveis, você pode fazer a validação rapidamente pela interface unificada da APIYI apiyi.com.
📚 Referências
-
Documentação oficial do Qwen4-Max-Preview: especificações do modelo, janela de disponibilidade e forma de acesso
- Link:
help.aliyun.com/zh/model-studio/qwen4-max-preview - Descrição: orçamento de saída, parâmetros de raciocínio, Base URL dedicada
- Link:
-
Documentação oficial da versão final do Qwen4-Max: preços de cobrança por uso e cache explícito
- Link:
help.aliyun.com/zh/model-studio/qwen4-max - Descrição: preço unitário por região, limite de saída, TTL de cache
- Link:
-
Assinatura e benefícios do Token Plan pessoal: preços dos planos, Credits e promoções por tempo limitado
- Link:
help.aliyun.com/zh/model-studio/token-plan-personal-overview - Descrição: regras de 20% e 40% do preço, incluindo o período noturno, preços para novos usuários, pacotes de uso
- Link:
-
Permissões e normas de uso do Token Plan: cenários de uso permitidos e proibidos
- Link:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - Descrição: escopo do uso interativo e consequências de violação
- Link:
-
Uso e cota do Token Plan: mecanismo de consumo de Credits
- Link:
help.aliyun.com/zh/model-studio/token-plan-usage-quota - Descrição: fatores que afetam o consumo de Credits
- Link:
-
Atualizações de recursos do Token Plan: registro de lançamento do Preview e da versão final
- Link:
help.aliyun.com/zh/model-studio/token-plan-product-updates - Descrição: eventos de versão de 11 e 16 de novembro
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: fale conosco pela página inicial da APIYI apiyi.com; mais materiais de integração estão disponíveis no centro de documentação docs.apiyi.com