Claude Fable 5.2 foi lançado em 9 de novembro de 2026, com preços padrão da API 20% menores que os do 5.1.
Muitas equipes logo se perguntam: se ficou mais barato, será que já podemos usar o max?
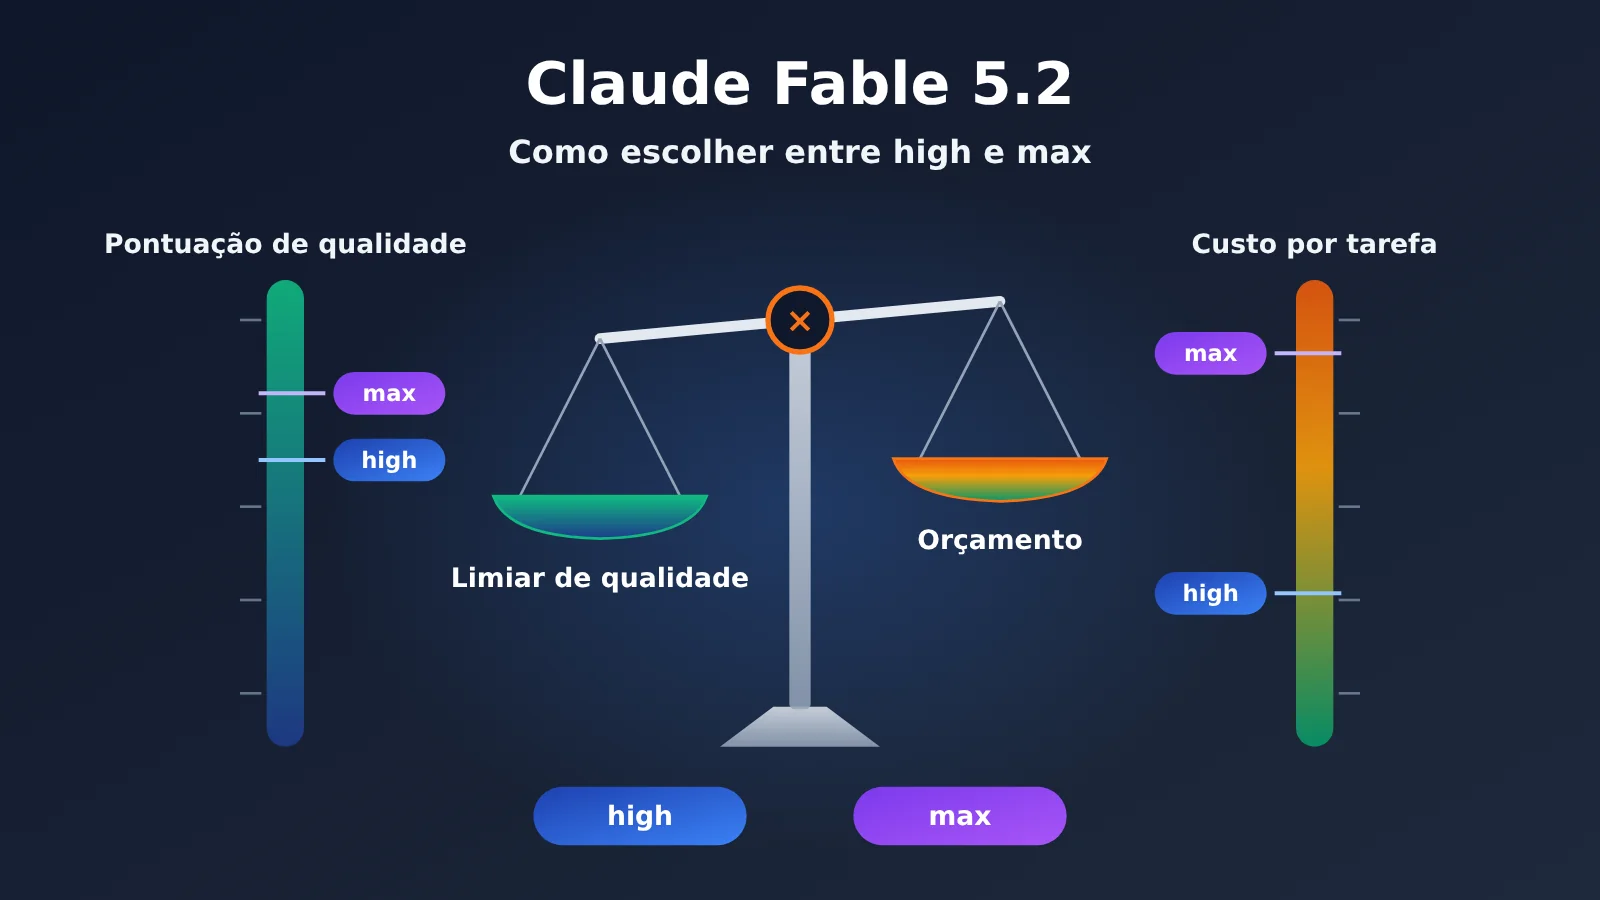
Neste artigo, comparamos Fable 5.2 high e Fable 5.2 max dentro do mesmo framework, analisando tanto a qualidade quanto o custo por tarefa.
Principal benefício: ao terminar a leitura, você saberá em quais situações cada opção, high ou max, é mais adequada e terá uma lista de verificação pronta para usar na avaliação de uma atualização.
Sumário
- O que saber: termos relacionados à escolha de nível do Fable 5.2
- 1 O que muda nos níveis high e max do Fable 5.2 não é o mesmo preço unitário
- 2 Qualidade e custo do Fable 5.2 na mesma tabela
- 3 Como verificar as tendências dos níveis do Fable 5.2 com dados de instituições independentes
- 4 Como escolher o nível do Fable 5.2 conforme o uso da tarefa
- 5 Como decidir, com a sua própria avaliação, se vale a pena atualizar o Fable 5.2 para o max
- Perguntas frequentes (FAQ) / Principais conclusões / Resumo
Para saber
| Termo | Significado | O que observar ao ler este artigo |
|---|---|---|
| Effort | Configuração que controla o quanto o modelo se dedica a pensar | O valor padrão da API para Fable 5.2 é high |
| Pensamento adaptativo | Mecanismo pelo qual o modelo distribui automaticamente o esforço de raciocínio | Está sempre ativado no Fable 5.2 |
| Harness | Ambiente de execução que fornece ferramentas, sessões e regras de execução ao modelo | O Harness do Cursor é diferente do Harness do AA |
| Intelligence Index | Índice composto que o AA calcula ponderando várias avaliações | É um índice, não uma taxa de acerto |
| Pontos percentuais | Diferença absoluta entre dois percentuais | De 56,9% para 60,0% são 3,1 pontos percentuais |
| Custo por tarefa | Custo do modelo atribuído a uma única tarefa em determinada condição de teste | Não equivale à sua fatura da API |
| Critério de aceitação | Requisito de qualidade que uma tarefa precisa cumprir | Primeiro, cumpra o critério; depois, compare os orçamentos |
| Segmentação de tarefas | Agrupamento de tarefas por dificuldade e custo de falha | Cada nível exige uma faixa diferente |
1 O high e o max do Fable 5.2 não mudam o mesmo preço unitário
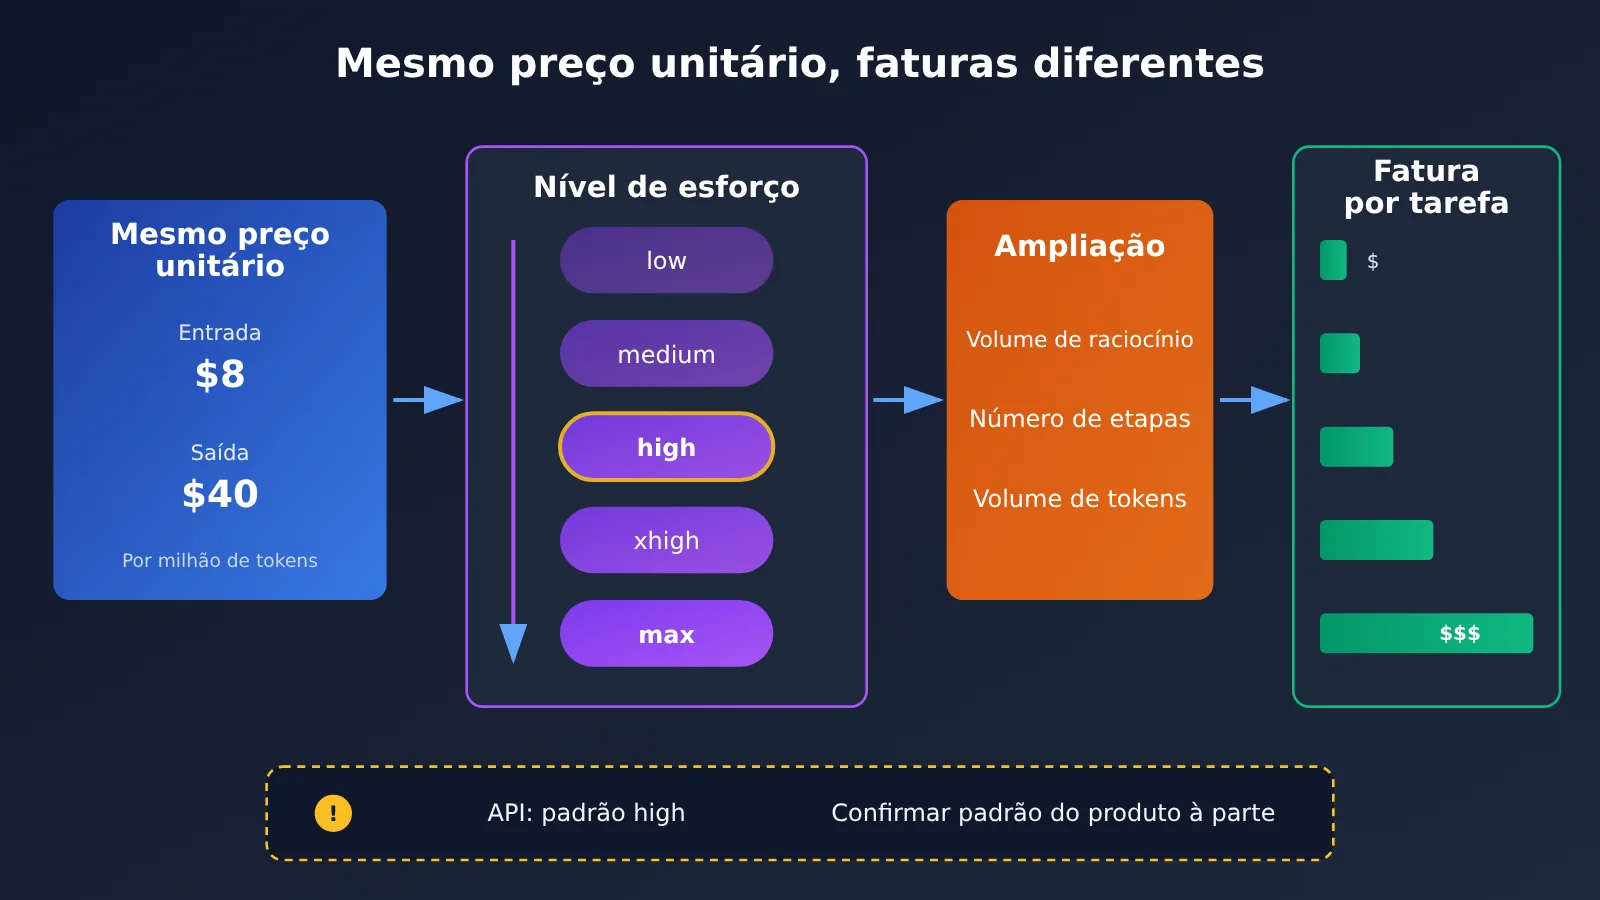
Muita gente acha que quanto maior a faixa, mais caro é o preço unitário. Na prática, com as tarifas padrão oficiais da Anthropic, o Fable 5.2 custa 8 dólares por milhão de tokens de entrada e 40 dólares por milhão de tokens de saída. Esses preços unitários não mudam de acordo com a faixa.
O effort muda o quanto o modelo pensa em uma tarefa, quantas etapas executa, quanto tempo leva e quantos tokens consome. Por isso, o preço unitário é o mesmo, mas a fatura por tarefa pode variar várias vezes.
Como as faixas do Fable 5.2 afetam a fatura
No Fable 5.2, o pensamento adaptativo está sempre ativado. O effort determina o limite e a tendência do esforço de raciocínio. Ao aumentar a faixa, o modelo geralmente faz mais inferências e chamadas de ferramentas, o que aumenta o número de tokens cobrados.
Com os mesmos 100 mil tokens de entrada, se a saída aumentar de 20 mil para 40 mil tokens, o custo no modo padrão do 5.2 sobe de 1,60 dólar para 2,40 dólares — mais do que os 2 dólares do 5.1 com o volume de uso original.
Também é importante distinguir dois tipos de “valor padrão”. A documentação oficial do modelo informa que o effort padrão da API é high. Produtos como o Cursor têm sua própria camada de configuração. Por exemplo, a janela de contexto padrão dele é de 300K, enquanto a especificação de 1M da documentação da API pertence a outra camada.
Outro ponto: o guia oficial de comandos alerta que faixas com o mesmo nome podem corresponder a quantidades diferentes de raciocínio em versões distintas. Portanto, não dá para aplicar ao 5.2, sem alterações, o que se aprendeu sobre as faixas na época do 5.1.
2 Veja a qualidade e o custo do Fable 5.2 na mesma tabela
O CursorBench 4.0 é uma avaliação feita pelo Cursor em suas próprias tarefas e ferramentas. Não é uma reprodução independente e genérica, mas compara os cinco níveis no mesmo harness, o que ajuda a observar as diferenças entre eles. Os dados abaixo foram consultados em 10 de novembro de 2026.
| Nível do Fable 5.2 | Pontuação | Custo por tarefa (US$) | tokens (campo agregado) | Etapas |
|---|---|---|---|---|
| Low | 53,2% | 3,94 | 36.616 | 30 |
| Medium | 54,8% | 4,66 | 44.103 | 35 |
| High | 56,9% | 9,70 | 99.259 | 69 |
| Extra High | 56,3% | 15,48 | 161.251 | 108 |
| Max | 60,0% | 32,79 | 352.794 | 218 |
Observação: a coluna de tokens é um campo agregado da página do benchmark; não significa que inclua apenas a quantidade de tokens de saída. Fonte: CursorBench 4.0.
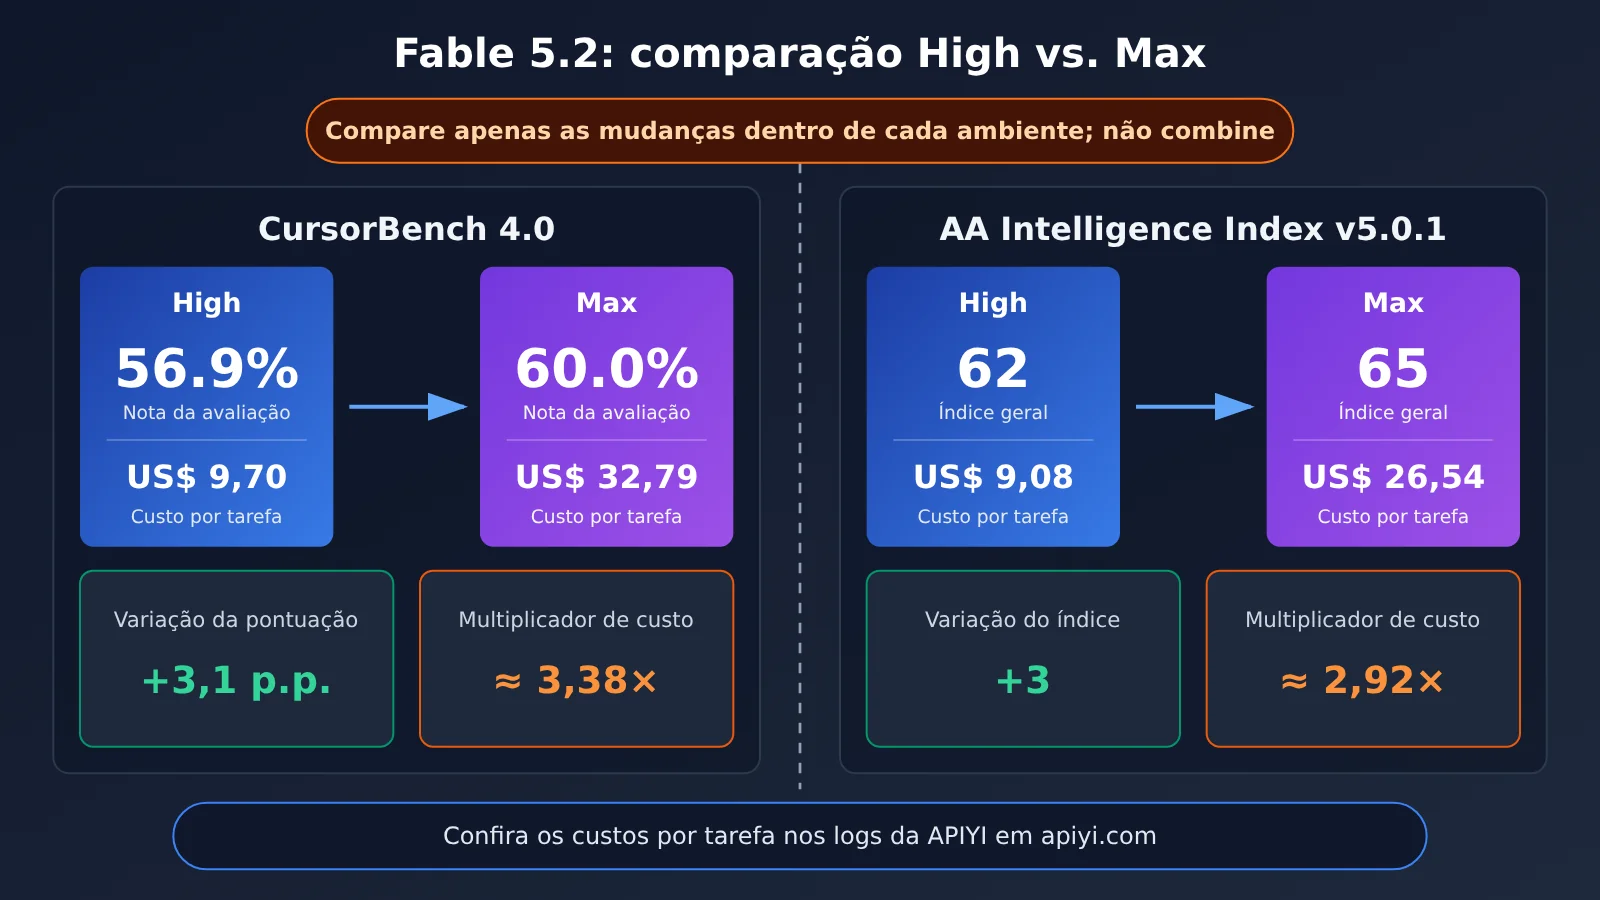
Do High ao Max no Fable 5.2: 3,1 pontos percentuais e um custo cerca de 3,38 vezes maior
Nesta tabela, a pontuação sobe de 56,9% no High para 60,0% no Max, um aumento de 3,1 pontos percentuais. O custo por tarefa passa de US$ 9,70 para US$ 32,79, ou seja, fica cerca de 3,38 vezes maior — um aumento de aproximadamente 238%.
Segundo os cálculos deste artigo, o campo de tokens aumenta para cerca de 3,55 vezes o valor inicial, e o número de etapas passa de 69 para 218, cerca de 3,16 vezes mais. O aumento do custo vem principalmente do maior número de etapas de raciocínio e execução, não do preço unitário.
Esses dados só mostram que, nesse ambiente, uma pontuação mais alta vem acompanhada de um custo significativamente maior.
Como interpretar o resultado inesperado do Extra High
Há outro ponto que chama atenção na tabela: o Extra High custa cerca de 60% mais que o High, mas sua pontuação é 0,6 ponto percentual menor.
💡 Sugestão para escolher: só é válido comparar os níveis dentro da mesma tabela. Não dá para combinar números de avaliações diferentes. Se quiser reproduzir uma comparação semelhante nas suas próprias tarefas, você pode usar a interface unificada da APIYI apiyi.com e os logs de chamadas para conferir os resultados. Antes, porém, confirme quais IDs de modelo e níveis a plataforma oferece naquele dia.
3. Verifique a tendência entre as faixas do Fable 5.2 com dados de uma instituição independente
Analisar apenas um ambiente de avaliação pode levar a conclusões influenciadas pelas particularidades desse ambiente. A AA é uma instituição independente de avaliação, e seu ranking permite verificar se a tendência observada no Cursor também aparece em outro ambiente. Abaixo está um retrato dinâmico de 10 de novembro de 2026, usando a versão metodológica Intelligence Index v5.0.1.
| Configuração | Intelligence Index | Custo por tarefa (dólares) |
|---|---|---|
| Fable 5.2 medium | 56 | 3.80 |
| Fable 5.2 high | 62 | 9.08 |
| Fable 5.2 xhigh | 62 | 14.83 |
| Fable 5.2 max | 65 | 26.54 |
| Opus 5.5 max | 59 | 10.04 |
65 não significa 65% de acerto
A página de metodologia da AA explica que o índice da versão v5.0.1 reúne 9 avaliações, com quatro categorias de capacidade valendo 25% cada. Portanto, 65 é uma pontuação composta do índice, não uma taxa de acerto de 65%. No ambiente da AA, o índice aumenta 3 pontos de high para max, enquanto o custo por tarefa fica cerca de 2,92 vezes maior. high e xhigh têm a mesma pontuação composta, 62, mas isso não significa que se comportem exatamente da mesma forma em cada tarefa.
Compare cada ambiente apenas internamente
Os dois ambientes mostram a mesma tendência: max tem pontuação mais alta e custa cerca de três vezes mais que high. Isso serve como confirmação da tendência, mas as tarefas, os métodos de pontuação e os cálculos de custo da AA e do Cursor são diferentes. Não é correto combinar os 65 da AA com os 60,0% do Cursor como se fossem uma única taxa de acerto.
4 Escolha o nível do Fable 5.2 de acordo com a tarefa
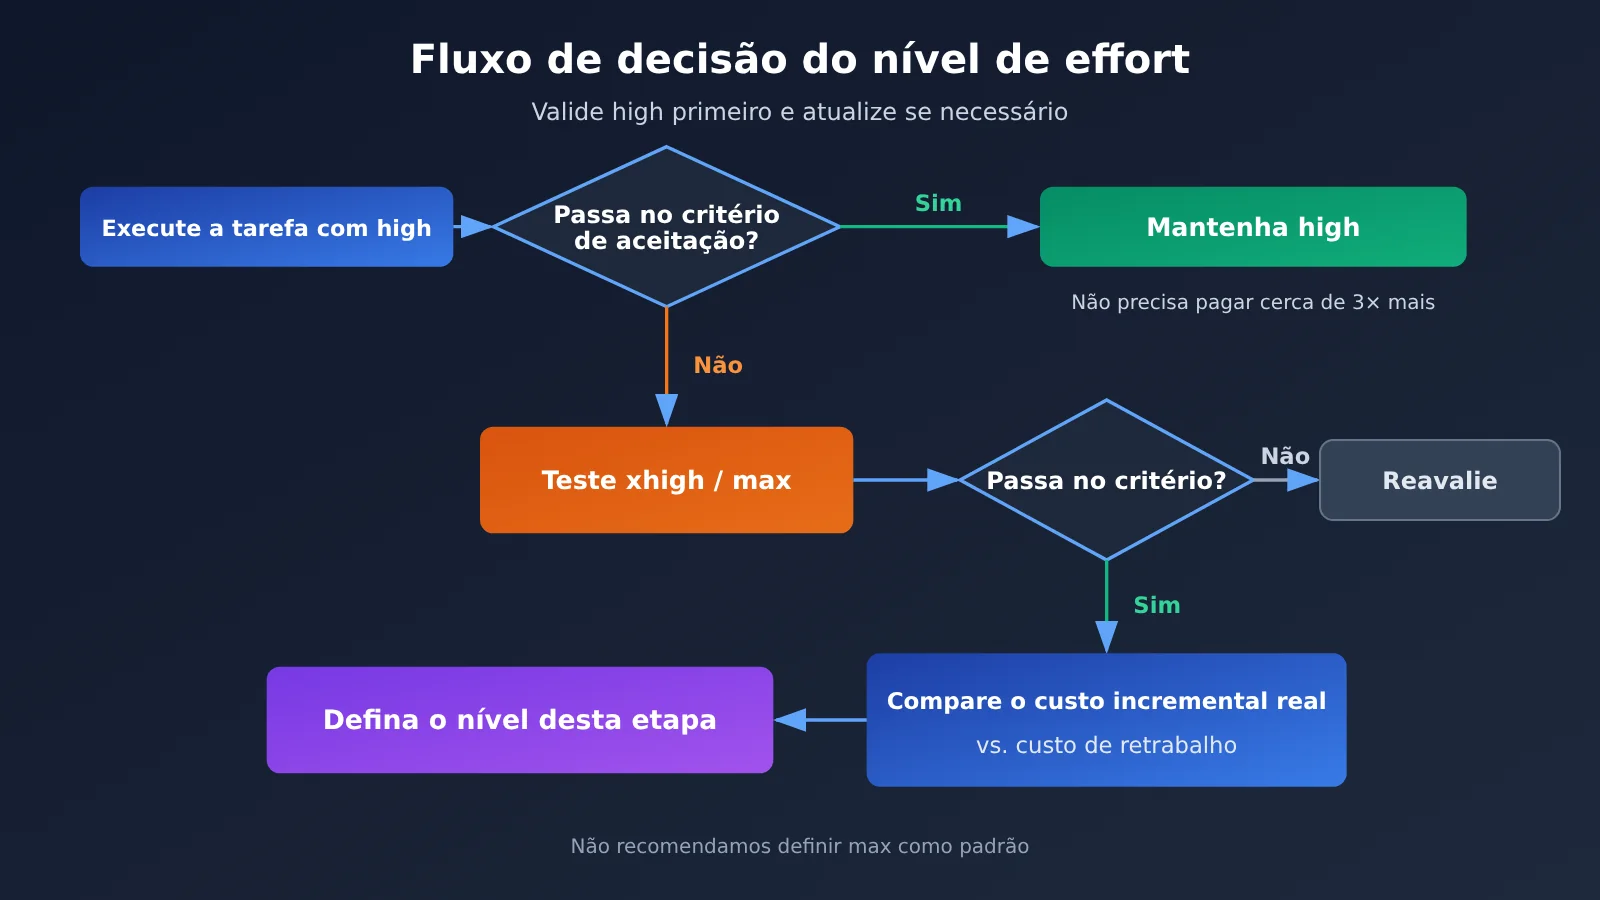
O guia oficial de comandos apresenta uma lógica inicial: comece com high na API e aumente ou reduza o nível com base nos resultados das suas avaliações. medium é mais indicado para cenários interativos; xhigh deve ficar reservado para tarefas longas e difíceis em que já se comprovou que ele traz benefícios adicionais; max serve para avaliar o limite de capacidade do modelo ou para poucas tarefas em que tempo e tokens não são uma preocupação. Nos níveis mais baixos, também é importante ficar atento ao risco de a tarefa ser encerrada antes da hora.
Tabela de recomendações por cenário para o Fable 5.2
Os três cenários abaixo são hipotéticos e servem para ilustrar como escolher.
| Cenário hipotético | Ponto de partida recomendado | Quando considerar aumentar o nível | O que não fazer |
|---|---|---|---|
| Mudança de requisitos (alterar campos, ajustar endpoints, adicionar testes) | Avalie medium; se necessário, use high |
Se medium encerrar a tarefa antes da hora ou deixar alterações de fora |
Usar max por padrão para pequenas mudanças |
| Correção complexa (bugs entre módulos, problemas de concorrência) | High |
Se a taxa de aprovação com high não atingir o critério de aceitação |
Pular direto para xhigh sem validar |
| Pesquisa de longo prazo (questões abertas, exploração de soluções) | Comece com high |
Se a questão tiver alto valor, o custo de falha for elevado e as avaliações já tiverem comprovado que max traz benefícios |
Definir max como padrão para todas as solicitações |
Quando escolher o Fable 5.2 high
- Para a maioria das tarefas de API que exigem raciocínio mais robusto e têm critérios de aceitação bem definidos;
- Quando a equipe ainda não tem um sistema de avaliação dos níveis e precisa de um ponto de partida recomendado oficialmente;
- Em fluxos de produção com alto volume de solicitações e sensibilidade ao custo por tarefa.
Quando escolher o Fable 5.2 max
- Para avaliar o limite de capacidade do modelo em determinado tipo de problema;
- Para poucas questões abertas em que o custo de uma falha é muito maior que o custo do modelo;
- Quando suas próprias amostras já comprovaram que
maxeleva a taxa de aprovação acima do limite exigido, enquantohighnão consegue.
🎯 Recomendação técnica: escolha o nível por categoria de tarefa; não é necessário decidir separadamente para cada solicitação. A prática recomendada oficialmente é começar com
highem um conjunto de tarefas representativas. Se você pretende centralizar a integração por meio da APIYI apiyi.com, confirme na plataforma, antes de iniciar a execução oficial, o ID do modelo, o grupo, o endpoint e o suporte aeffortdisponíveis no dia.
5 Decida com seus próprios critérios de aceitação se vale atualizar Fable 5.2 para max
As avaliações públicas mostram apenas tendências. Para saber se vale a pena atualizar, use os resultados dos seus próprios testes de aceitação. A lista de registro abaixo está pronta para uso. O princípio central é alterar apenas uma variável por vez: o nível de esforço.
| Item registrado | Requisito |
|---|---|
| Tarefa e entrada | Use o mesmo conjunto de tarefas, as mesmas entradas e o mesmo comando de sistema |
| Permissões das ferramentas | Mantenha exatamente o mesmo conjunto de ferramentas e as mesmas permissões |
| Modelo e nível de esforço | Registre o ID do modelo e o nível de esforço; altere apenas o nível de esforço a cada rodada |
| Critérios de aprovação | Defina os limites de aceitação com antecedência, sem ajustá-los depois de ver os resultados |
| Uso | Registre separadamente as entradas, as gravações e leituras em cache e as saídas |
| Tempo e novas tentativas | Registre o tempo total, o número de novas tentativas e quantas vezes a execução foi encerrada antes do esperado |
| Valor efetivamente cobrado | Considere como referência o valor registrado nos logs da plataforma; não use estimativas baseadas nas tarifas oficiais |
| Casos de falha | Guarde as saídas originais e analise quais problemas o max resolveu |
Guia rápido do Fable 5.2: comece registrando o usage
O exemplo mínimo abaixo mostra apenas como fazer uma chamada e registrar o usage. Este artigo não mostra como repassar o parâmetro effort: a disponibilidade do Fable 5.2 na plataforma e o suporte ao repasse de effort devem ser confirmados na documentação da plataforma vigente no dia.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI da APIYI
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_ID",  # Informe um ID de modelo confirmado como disponível na plataforma no dia
    messages=[{"role": "user", "content": "按验收标准修复以下函数……"}]
)
print(resp.usage)  # Registre o usage para conciliação posterior
Ver o código completo de registro e conciliação
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Tarifas padrão oficiais da Anthropic (dólares por milhão de tokens), usadas apenas para estimativa; não representam o valor efetivamente cobrado
RATE_IN, RATE_OUT = 8.0, 40.0

def run_task(task_id: str, prompt: str, model: str, effort_label: str, passed_fn):
    """Executa uma tarefa e retorna um registro de validação. effort_label é apenas uma etiqueta para registro."""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}]
    )
    text = resp.choices[0].message.content
    u = resp.usage
    est_usd = u.prompt_tokens / 1e6 * RATE_IN + u.completion_tokens / 1e6 * RATE_OUT
    return {
        "task_id": task_id,
        "model": model,
        "effort": effort_label,
        "passed": passed_fn(text),          # Função de validação definida previamente
        "prompt_tokens": u.prompt_tokens,
        "completion_tokens": u.completion_tokens,
        "est_usd": round(est_usd, 4),       # Valor estimado
        "seconds": round(time.time() - start, 1),
        "output": text,                     # Preserve o texto original dos casos que falharem
    }

def quota_to_usd(quota: int) -> float:
    """Nos logs da plataforma, quota ÷ 500000 corresponde ao valor efetivamente cobrado em dólares."""
    return quota / 500000
A documentação de logs da APIYI lista campos como model_name, prompt_tokens, completion_tokens, quota, duration_for_view e request_id. O valor de quota÷500000 corresponde à cobrança efetiva em dólares, e o campo other inclui informações adicionais, como o multiplicador do grupo. Ao vincular os registros de validação aos logs usando o request_id, você consegue calcular o custo real das “tarefas aprovadas”, em vez de olhar apenas o custo de uma chamada isolada.
🚀 Comece rápido: se quiser validar o fluxo primeiro com uma amostra pequena, você pode se cadastrar na APIYI, em apiyi.com, e usar os créditos gratuitos de teste para novos usuários. Assim, dá para testar o método de registro com “mesma tarefa, uma variável por vez e cobrança efetiva registrada” antes de ampliar a amostra.
O princípio para a decisão final é: primeiro, verifique se high atende ao nível mínimo de qualidade. Se atender, não há motivo para pagar cerca de três vezes mais por alguns pontos percentuais adicionais. Só compare o custo extra de max com o custo de falhas ou retrabalho quando high não atingir o nível exigido, mas max conseguir. Não recomendamos definir max como padrão para todas as solicitações.
Perguntas frequentes (FAQ)
Q1: Quais são os níveis de effort do Claude Fable 5.2?
O effort é uma configuração que controla o quanto o modelo se dedica a pensar. Os níveis disponíveis vão de low a max. Ele não altera o preço por token, mas muda a quantidade de raciocínio, o número de etapas, o tempo de execução e o uso de tokens. Por isso, a cobrança pela mesma tarefa pode variar várias vezes entre os níveis. O nível padrão da API é high.
Q2: Qual é a diferença entre high e max no Fable 5.2?
No CursorBench 4.0, high obteve 56.9% e custou 9.70 dólares, enquanto max obteve 60.0% e custou 32.79 dólares. A diferença foi de 3.1 pontos percentuais, e o custo de max foi cerca de 3.38 vezes maior. No AA, high obteve 62 e custou 9.08 dólares; max obteve 65 e custou 26.54 dólares, cerca de 2.92 vezes mais. Os dados de cada avaliação só podem ser comparados dentro do respectivo ambiente.
Q3: Quando esses dados foram coletados? Eles podem mudar?
O Fable 5.2 foi lançado em 9 de novembro de 2026, e os dados deste artigo são um retrato consultado em 10 de novembro. As páginas do AA e do Cursor são atualizadas dinamicamente. Os números podem mudar com novas versões, conjuntos de tarefas ou alterações no método de cálculo dos custos. Ao citar os dados, informe a data da consulta.
Q4: Extra High teve uma pontuação menor que High. Isso significa que não devo usar esse nível?
Esse resultado se refere apenas a essa execução do CursorBench 4.0; não dá para concluir que xhigh tenha um desempenho pior em todas as tarefas. A recomendação oficial é reservar xhigh para tarefas longas e difíceis nas quais suas próprias avaliações já tenham comprovado algum ganho. Antes de verificar esse ganho, não é necessário ativá-lo por padrão.
Q5: Como comparar pela API os custos dos diferentes níveis do Fable 5.2?
Use o mesmo conjunto de tarefas, altere apenas o nível e registre o usage e o valor efetivamente cobrado pela plataforma. Ao fazer chamadas pela interface unificada da APIYI, apiyi.com, você pode calcular o valor efetivamente cobrado em dólares usando quota÷500000, conforme os logs. Antes de iniciar, confirme o ID do modelo, o grupo e o suporte a effort disponíveis na plataforma naquele dia. Este artigo não inclui exemplos de repasse de parâmetros que não tenham sido verificados.
Q6: Quais são as limitações dos dados de avaliações públicas?
O CursorBench é uma avaliação feita por um provedor de ferramentas no próprio ambiente, e o índice AA é uma pontuação composta ponderada. Nenhum dos dois equivale à taxa de sucesso do seu negócio. Além disso, não dá para determinar a significância de uma diferença de cerca de 3 pontos percentuais com base apenas nesses dados. As opiniões nas redes sociais no primeiro dia podem servir como pistas, mas a conclusão final deve vir dos seus próprios testes de aceitação.
Q7: Com uma redução de 20% no preço da API, usar max passa a valer a pena?
Não necessariamente. A redução de preço representa uma economia proporcional apenas quando o uso permanece igual. O consumo de tokens e o número de etapas do max podem ser mais de 3 vezes maiores que os do high, então o aumento no uso pode facilmente anular a queda no preço por token. Compare o valor efetivamente cobrado para concluir uma tarefa, em vez de olhar apenas para o preço por token.
Principais pontos sobre Fable 5.2 high e max
- O preço unitário não muda, mas a conta pode mudar:
effortaltera a quantidade de raciocínio e o número de etapas. Mesmo com o mesmo preço por unidade, o custo de uma tarefa pode variar várias vezes. - O padrão da API é high: a recomendação oficial é começar com high e depois ajustar para cima ou para baixo com base nas suas próprias avaliações.
- Comparação no Cursor: de high para max, o resultado aumenta 3,1 pontos percentuais, enquanto o custo fica cerca de 3,38 vezes maior.
- Comparação no AA: o índice sobe de 62 para 65, com um custo cerca de 2,92 vezes maior. O valor 65 não representa a taxa de acerto.
- Não misture os ambientes: cada avaliação só permite comparações dentro do próprio ambiente. Não combine os resultados para criar uma pontuação única de custo-benefício.
- Reserve max para poucas tarefas: use essa opção para avaliar o limite de capacidade e lidar com problemas abertos de alto valor.
- Valide pelo valor realmente cobrado: use a mesma tarefa, altere uma variável por vez e registre o uso. Os logs da APIYI em apiyi.com podem ajudar a conferir os valores.
Resumo
A escolha entre Fable 5.2 high e max pode ser resumida em três pontos:
- Diferencie o preço unitário do custo da tarefa: o nível não altera o preço unitário, mas muda o volume de recursos usados.
- Analise os dados dentro do mesmo ambiente: tanto o Cursor quanto o AA mostram que max alcança uma pontuação um pouco maior, com custo cerca de três vezes superior ao de high. Mas não dá para combinar os resultados dos dois ambientes.
- Use o critério de aprovação como referência: se high atende ao critério, continue com high. Só compare o custo adicional com o custo de retrabalho quando high não atender ao critério e max conseguir.
Para a maioria das equipes, uma abordagem mais segura é começar com high para definir categorias de tarefas e registrar os critérios de aprovação. Depois, selecione algumas tarefas de alto valor para avaliar max separadamente. Recomendamos usar a interface unificada e os logs de chamadas da APIYI em apiyi.com para validar rapidamente seus próprios exemplos. Confirme o suporte ao modelo e ao nível escolhido antes de ampliar o uso.
📚 Referências
- Anúncio da Anthropic: escopo do lançamento do Fable e do Mythos 5.2 e avaliação da própria empresa
- Link:
anthropic.com/claude-fable-and-mythos-5-2 -
Observação: publicado em 2026-11-09, inclui critérios de velocidade e tabela de avaliações
-
Preços da Claude API: tarifas padrão oficiais
- Link:
platform.claude.com/docs/en/about-claude/pricing -
Observação: para o Fable 5.2, entrada/saída custam US$ 8 / US$ 40 por milhão de tokens
-
Especificações do modelo Fable 5.2: contexto, limite de saída e nível de esforço padrão
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview -
Observação: o pensamento adaptativo está sempre ativado; o padrão da API é high
-
Guia de comandos do Fable 5.2: recomendações oficiais para escolher o nível
- Link:
platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-fable-5-2 -
Observação: cenários de uso de medium, high, xhigh e max
-
CursorBench 4.0: avaliação em cinco níveis no ambiente próprio do Cursor
- Link:
prod.cursor.com/evals -
Observação: avaliação própria do provedor da ferramenta, não uma reavaliação independente de uso geral
-
Ranking de modelos da Artificial Analysis: ranking dinâmico de uma instituição independente
- Link:
artificialanalysis.ai/leaderboards/models -
Observação: Intelligence Index e custo por tarefa
-
Metodologia de avaliação da Artificial Analysis: composição do Intelligence Index v5.0.1
- Link:
artificialanalysis.ai/methodology/intelligence-benchmarking -
Observação: 9 avaliações; cada uma das quatro categorias de capacidade representa 25%
-
Como o Cursor compara a qualidade dos modelos: artigo sobre a metodologia da versão antiga do benchmark
- Link:
prod.cursor.com/blog/cursorbench -
Observação: útil apenas para entender os princípios do projeto; não se aplica às conclusões estatísticas da versão 4.0
-
API de consulta de logs da APIYI: campos de log e cálculo do valor efetivamente cobrado
- Link:
docs.apiyi.com/api-capabilities/log-query - Observação: quota÷500000 corresponde ao valor efetivamente cobrado em dólares
Autor: Equipe técnica da APIYI
Contato técnico: entre em contato conosco pela página inicial do site APIYI apiyi.com. Para mais materiais, acesse a central de documentação docs.apiyi.com.