Resumo: Este artigo compara o Qwen4-Max-Preview com a versão oficial do Qwen4-Max em relação ao orçamento de saída, aos padrões de raciocínio e à forma de cobrança, além de apresentar um checklist de migração que pode ser executado item por item antes da desativação do Preview em 25 de novembro.
O Qwen4-Max-Preview encerrará a prévia e será desativado em 25 de novembro de 2026, às 24:00 (UTC+8). A versão oficial do Qwen4-Max foi lançada em 16 de novembro, com o ID de modelo qwen4-max. Ao migrar para a versão oficial, é preciso verificar simultaneamente cinco pontos: produtos de integração, orçamento de saída, padrões de raciocínio, comportamento das ferramentas e custo. Ambas as versões oferecem contexto de 1 milhão de tokens, mas, na versão oficial, o limite de saída no modo de pensamento cai de 393.216 para 262.144, a intensidade padrão de raciocínio passa de xhigh para high, e a cobrança, que antes era feita com Token Plan Credits, agora também inclui o pagamento por uso. Alterar apenas o ID do modelo não garante que as tarefas de produção tenham o mesmo desempenho.
A seguir, o texto primeiro organiza a linha do tempo e as diferenças de especificação entre o Preview e a versão oficial, e depois apresenta o protocolo de API, as regiões, os preços e o cache da versão oficial. Em seguida, na ordem “salvar a linha de base, configurar a integração, ajustar os parâmetros da requisição, validar funcionalidades, acompanhar a cobrança e fazer a migração gradual”, fornece o checklist de migração. Por fim, lista os pontos de aceitação para tarefas como relatórios longos, geração de código e Agent multiturno. Depois da leitura, você poderá transformar essa troca em um processo de gestão de versões de modelos reutilizável pela equipe.
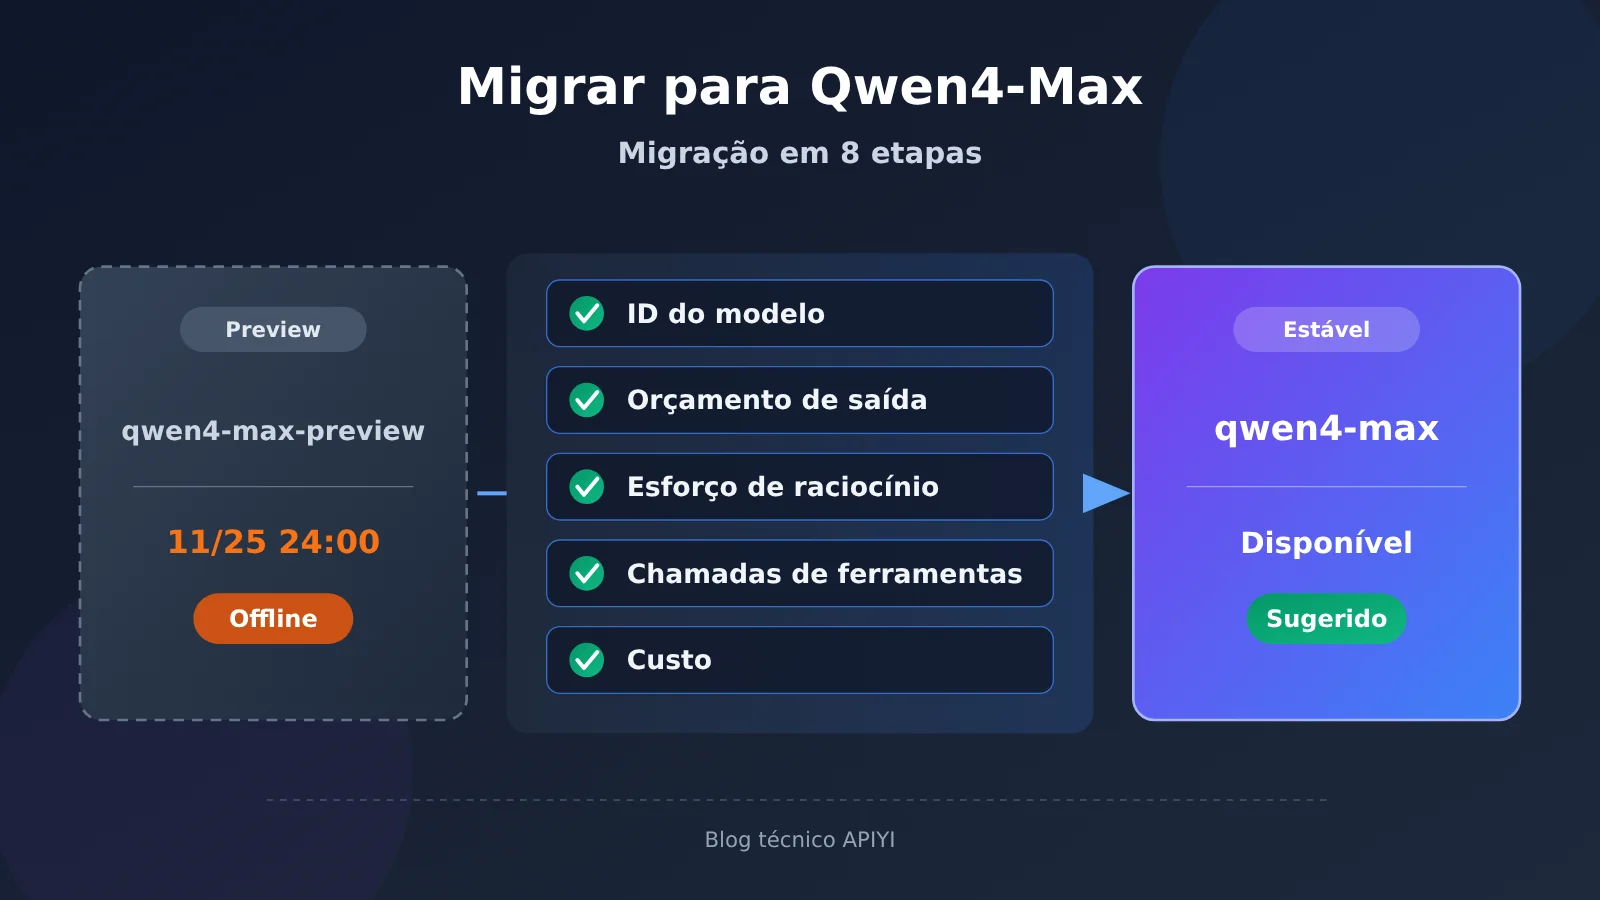
Para saber: terminologia da migração do Qwen4-Max
| Termo | Explicação |
|---|---|
| Model ID | Identificador usado na requisição para especificar a versão concreta do modelo, por exemplo qwen4-max. |
| Base URL | Endereço base da interface usado pelo cliente para se conectar a um produto ou a um serviço de uma região específica. |
| Janela de contexto | Capacidade total que o modelo consegue processar em uma única requisição, incluindo entrada, histórico e conteúdo gerado. |
| Orçamento de saída | Limite máximo de Tokens que podem ser gerados em uma única requisição. No modo de raciocínio, o conteúdo de inferência e a resposta final compartilham esse orçamento. |
| reasoning_effort | Parâmetro da requisição que controla a intensidade do raciocínio. O valor padrão é diferente entre a Preview e a versão oficial. |
| thinking_budget | Parâmetro que controla o orçamento de Tokens de raciocínio. Na Preview, ele não pode ser configurado junto com reasoning_effort. |
| Token Plan | Serviço de assinatura do Alibaba Cloud Bailian, medido em Credits, e também o único canal de acesso da Preview. |
| Function Calling | Mecanismo pelo qual o modelo retorna solicitações de chamada com base na definição das ferramentas, e a aplicação executa a ferramenta e devolve o resultado. |
| JSON Schema | Especificação que descreve a estrutura de dados JSON, os campos e as restrições, usada para impor o formato de saída do modelo. |
| TTL | Tempo de retenção do cache, que afeta o alcance da reutilização do cache e os custos correspondentes. |
| Validação de regressão | Usar tarefas representativas já existentes para verificar mudanças em funcionalidades, resultados e custos após a troca de versão. |
1 Quando o Qwen4-Max-Preview termina e quando a versão oficial entra no ar
1.1 Cronologia das versões do Qwen4-Max
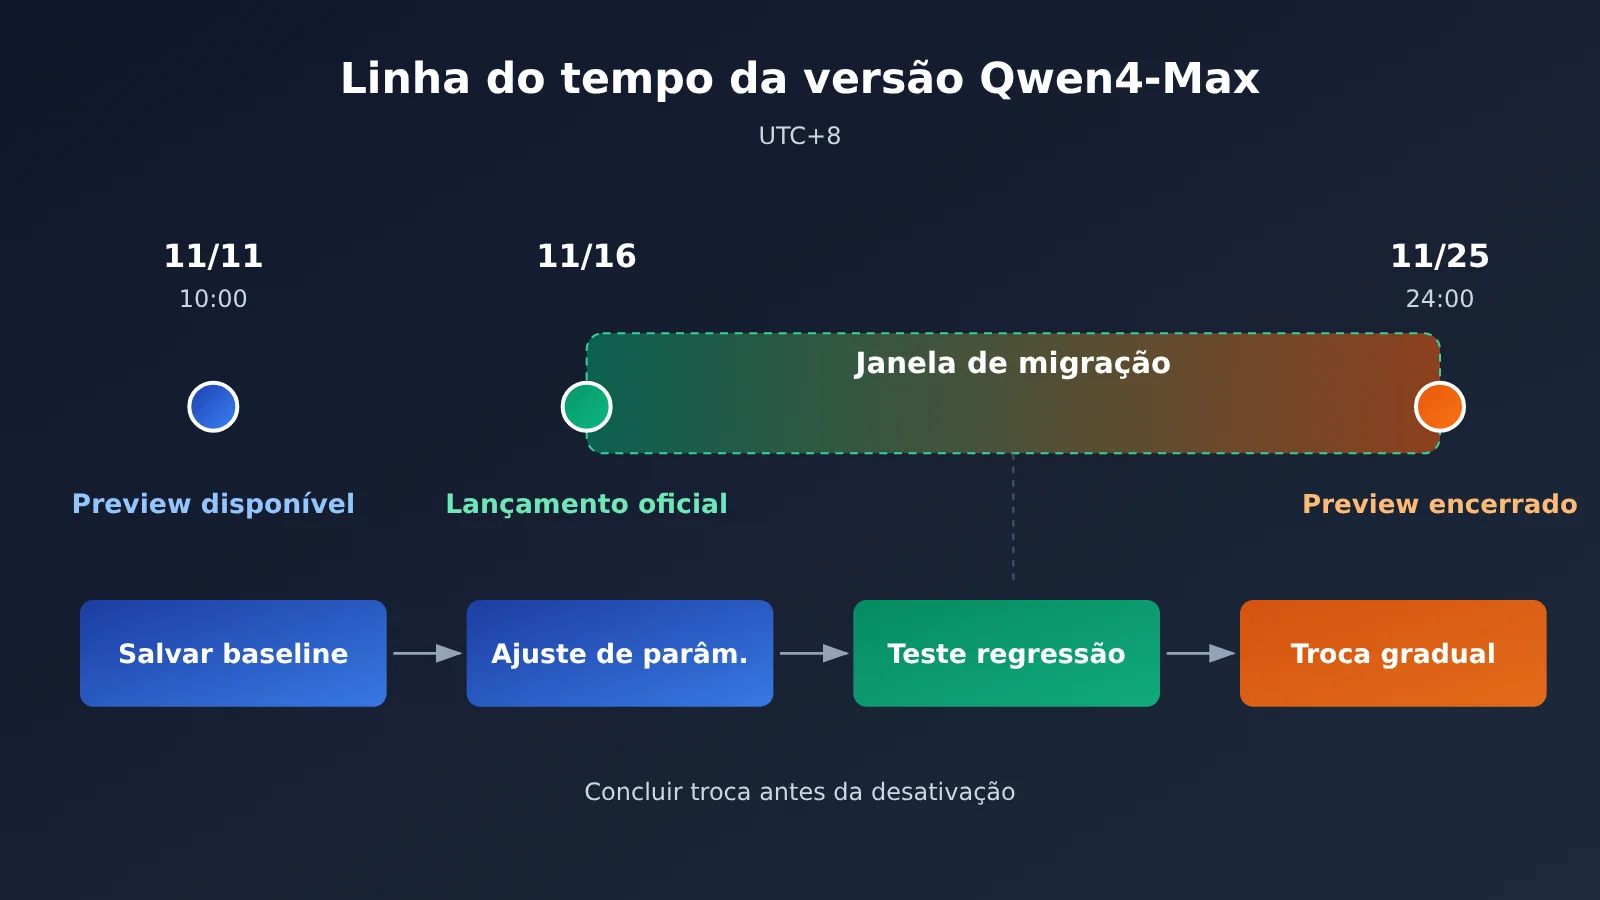
O registro de atualizações de funcionalidades do Token Plan da Alibaba Cloud lista dois eventos independentes: em 11 de novembro o Preview entrou no ar, e em 16 de novembro a versão oficial entrou no ar. Depois do lançamento da versão oficial, a data original de descontinuação do Preview não mudou. A documentação oficial do Preview também já traz o aviso no topo: “A versão oficial do Qwen4-Max já está no ar, recomendamos usar a versão oficial”.
| Data (UTC+8) | Evento | O que significa para o desenvolvedor |
|---|---|---|
| 2026-11-11 10:00 | Qwen4-Max-Preview liberado | Só pode ser chamado pelo Token Plan individual ou de equipe |
| 2026-11-16 | Versão oficial do Qwen4-Max entra no ar | Suporta API de cobrança por uso, e também pode ser usado via Token Plan |
| 2026-11-25 24:00 | Fim da prévia do Preview e descontinuação | qwen4-max-preview não pode mais ser chamado nem servir como alvo de fallback |
1.2 Dois Model IDs e os canais de cada um
O Model ID do Preview é qwen4-max-preview, com o alias qwen4.0-max-preview. Os dois IDs podem ser chamados, e na fatura aparecem unificados como qwen4.0-max-preview. A forma de acesso do Preview é a API Key dedicada do Token Plan mais a Base URL dedicada https://token-plan.cn-beijing.maas.aliyuncs.com, sem suporte a cobrança por uso.
O Model ID da versão oficial é qwen4-max. A versão oficial oferece dois caminhos de uso: o primeiro é o Token Plan individual ou de equipe, e o segundo é a API de cobrança por uso do Bailian. Esses dois caminhos têm Key, Base URL e forma de cobrança diferentes, então na migração é preciso primeiro definir por qual deles seguir.
2 Diferenças de especificação entre o Qwen4-Max-Preview e a versão oficial
2.1 Tabela comparativa de especificações do Qwen4-Max
Os dados abaixo vêm da documentação oficial dos modelos Preview e da versão oficial.
| Métrica técnica | Qwen4-Max-Preview | Qwen4-Max versão oficial |
|---|---|---|
| Model ID | qwen4-max-preview |
qwen4-max |
| Janela de contexto | 1.000.000 | 1.000.000 |
| Entrada máxima (sem pensamento / com pensamento) | não listado separadamente na documentação | 991.808 / 983.616 |
| Saída máxima (modo sem pensamento) | não listado separadamente na documentação | 131.072 |
| Total máximo combinado de pensamento + resposta | 393.216 | 262.144 |
| Intensidade de raciocínio padrão | xhigh | high |
| Orçamento de pensamento padrão | conforme os parâmetros da interface Preview | 131.072 |
| Protocolo de API | OpenAI Chat Completions, Responses, Anthropic Messages | os três anteriores + DashScope |
| Forma de cobrança | apenas Token Plan Credits | API com pagamento por uso, ou Token Plan |
2.2 Diferenças entre contexto, entrada, saída e orçamento de pensamento
Esses quatro números medem coisas diferentes, e é justamente aí que a confusão costuma aparecer na hora de migrar. A janela de contexto é a capacidade total que uma requisição consegue processar, e nas duas versões ela é de 1 milhão. A entrada máxima define quanto material pode ser colocado em uma única chamada: na versão oficial, no modo de pensamento, ela é de 983.616, um pouco menor que no modo sem pensamento, deixando a margem restante para o raciocínio. A saída máxima define quantos Tokens podem ser gerados no máximo por chamada, e o orçamento de pensamento determina quanto disso pode ser usado para raciocínio.
A mudança mais significativa está do lado da saída. No Preview, pensamento e resposta compartilham 393.216 Tokens; na versão oficial, no modo de pensamento, o teto combinado é de 262.144, com orçamento de pensamento padrão de 131.072. Estimando com a configuração padrão, a versão oficial deixa cerca de 130 mil Tokens de espaço para a resposta final. Se o seu negócio depende, no Preview, de saídas longas acima de 200 mil Tokens em uma única chamada, depois da migração será necessário redesenhar a forma de produzir a saída.
3 Capacidades de integração via API e custos da versão oficial do Qwen4-Max
3.1 Protocolos e funcionalidades
A versão oficial oferece suporte a quatro protocolos: OpenAI Chat Completions, OpenAI Responses, Anthropic Messages e DashScope. Entre os recursos, a documentação oficial lista Function Calling, chamadas paralelas de ferramentas, pesquisa na web, JSON Object, JSON Schema, cache explícito, cache implícito, além de resumos da cadeia de raciocínio e criptografia.
Em comparação com a Preview, a documentação da versão oficial adicionou o protocolo DashScope, as chamadas paralelas de ferramentas e explicações sobre os dois tipos de cache. Se a aplicação antes tratava apenas um único tool_call, agora é preciso confirmar se o código lida corretamente com o caso de várias chamadas de ferramentas retornadas em uma única resposta.
3.2 Regiões e preços por consumo
A API por consumo da versão oficial abrange seis regiões. Ao escolher a região, além do preço, considere a latência de rede, os requisitos de residência de dados e o escopo de implantação do negócio. As capacidades específicas de cada região devem ser consultadas na matriz oficial de capacidades.
| Região | Escopo de implantação | Entrada (CNY/milhão de tokens) | Saída (CNY/milhão de tokens, incluindo raciocínio) |
|---|---|---|---|
| China Norte 2 (Pequim) | China continental | 10 | 30 |
| EUA (Virgínia) | Global | 10 | 30 |
| Alemanha (Frankfurt) | Global | 10 | 30 |
| Japão (Tóquio) | Global | 10 | 30 |
| Hong Kong (China) | Global | 10 | 30 |
| Singapura | Internacional | 10.938 | 32.813 |
A página oficial da região de Pequim lista uma cota gratuita de 1 milhão de tokens, válida por 90 dias. O marco inicial é a mais tardia entre as seguintes condições: ativação do Bailian, lançamento do modelo, aprovação da solicitação etc. Os preços acima se aplicam apenas à versão oficial. O preço a 2 折 (20% do valor) da Preview e a tarifa de 8% após o acúmulo noturno fazem parte dos benefícios do Token Plan Credits e não podem ser considerados no cálculo de custos da versão oficial.
3.3 Cache explícito e cache implícito
O cache na versão oficial é cobrado separadamente. O cache explícito é criado ativamente pelo desenvolvedor e é adequado para armazenar prefixos que permanecem inalterados por longos períodos, como comandos de sistema, descrições de ferramentas e materiais de referência fixos. O TTL pode ser escolhido entre 5 minutos e 1 hora, e há suporte a Chat Completions, Responses e Anthropic Messages. O cache implícito é tratado automaticamente pela plataforma com base em condições como prefixos repetidos, sem necessidade de configuração adicional.
Em agentes com múltiplas rodadas, cada rodada carrega as mesmas definições de ferramentas e os mesmos materiais de contexto; o uso adequado de cache pode reduzir claramente o custo de entradas repetidas. O TTL deve ser escolhido de acordo com o intervalo entre sessões: sessões com interação intensa podem usar 5 minutos, enquanto fluxos de processamento em lote com intervalos maiores podem considerar 1 hora.
4 Passos para migrar do Qwen4-Max-Preview para a versão oficial
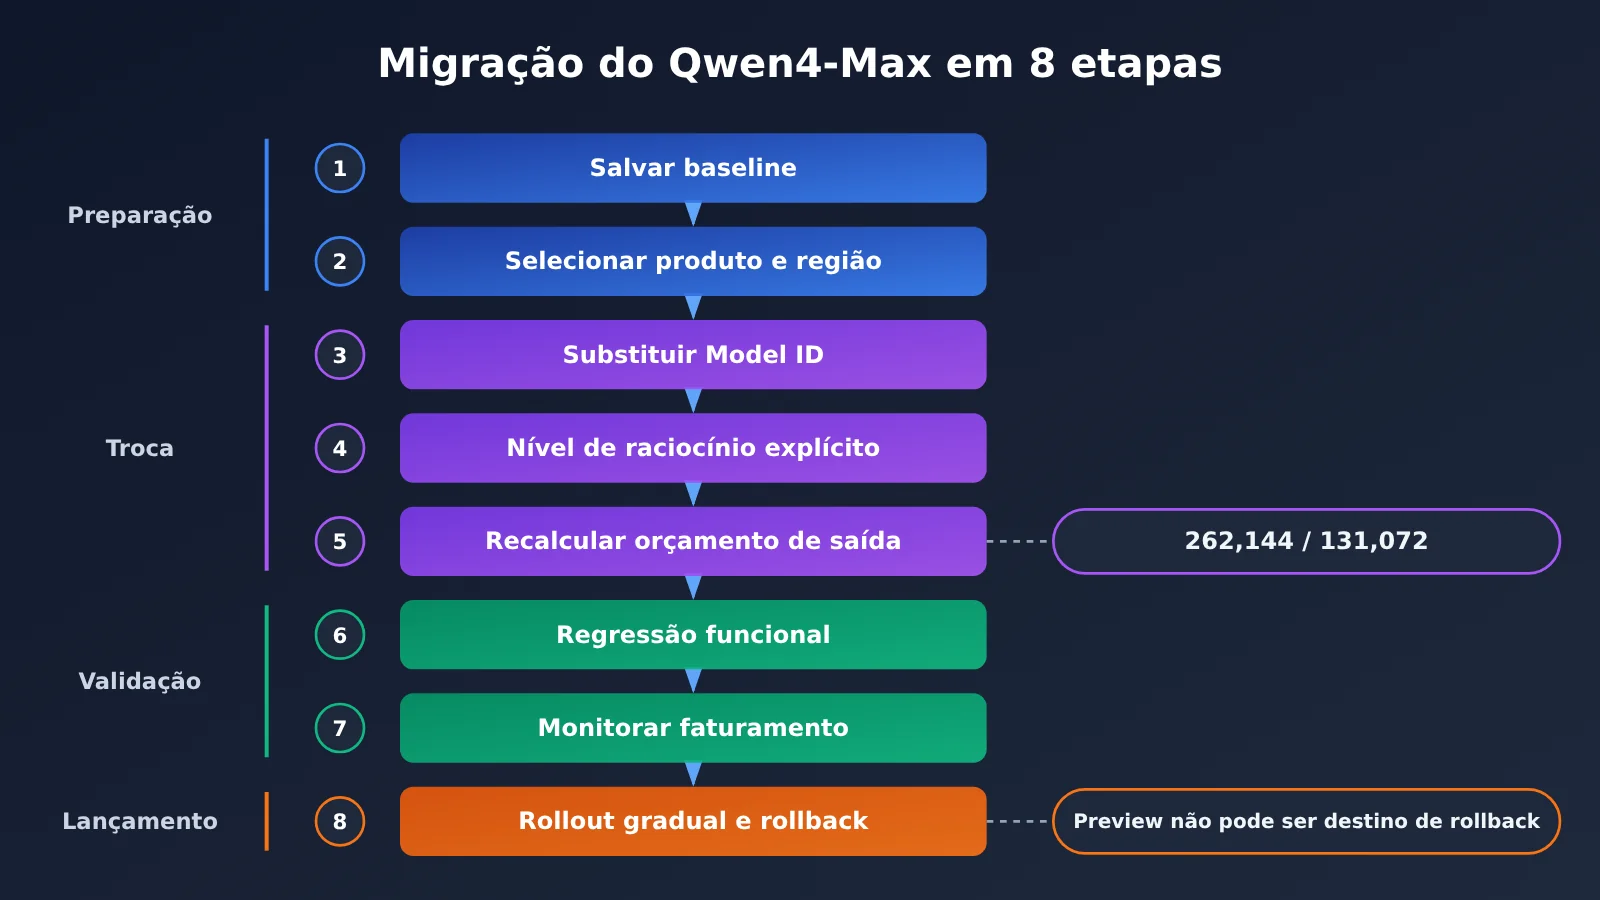
Os 8 passos abaixo formam um roteiro de verificação para desenvolvedores, montado a partir das especificações oficiais. A documentação oficial não oferece ferramenta de migração automática nem afirma que todos os parâmetros de requisição são compatíveis sem ajustes, então cada etapa precisa ser realmente testada no seu próprio negócio.
| Etapa | Item de verificação | Critério de aceitação |
|---|---|---|
| 1 | Salvar a configuração antiga e as tarefas representativas | Parâmetros de requisição, amostras de saída, tempo de execução e consumo do Preview já arquivados |
| 2 | Escolher o produto de acesso e conferir região, Key e Base URL | Serviços de backend usam a API por uso; ferramentas interativas usam o Token Plan |
| 3 | Substituir o campo model por qwen4-max |
A requisição de smoke test responde normalmente e o nome do modelo na fatura está correto |
| 4 | Definir explicitamente o esforço de raciocínio | Escrever reasoning_effort ou o campo correspondente conforme a tarefa, sem depender do valor padrão |
| 5 | Recalcular o orçamento de saída | No modo de raciocínio, total ≤ 262,144; no modo sem raciocínio, ≤ 131,072 |
| 6 | Validar chamada de ferramentas, estrutura JSON, saídas longas e histórico de múltiplas rodadas | A taxa de aprovação nas tarefas representativas fica igual à linha de base do Preview |
| 7 | Observar o consumo e a cobrança de cache | Os custos de entrada, saída e cache ficam dentro do esperado |
| 8 | Migrar com pouco tráfego e preparar a configuração de rollback | O alvo de rollback é um modelo ainda válido, e o Preview não está entre eles |
4.1 Salvar configurações antigas e tarefas representativas
Antes que o Preview seja descontinuado, exporte todas as configurações atuais que fazem chamadas a qwen4-max-preview, incluindo max_tokens, reasoning_effort ou thinking_budget, definições de ferramentas, response_format e o comando de sistema. Ao mesmo tempo, selecione de 10 a 30 tarefas representativas e salve as saídas, os tempos de execução e o uso do Preview como linha de base para comparação. Depois de 25 de novembro, não será mais possível obter resultados do Preview.
4.2 Escolher o produto de integração e verificar a Key e a Base URL
O Token Plan permite apenas uso interativo em ferramentas de programação ou ferramentas de agentes, como Claude Code, Cursor, Qwen Code e Qoder. Scripts automatizados, backends de aplicações próprias e chamadas em lote por plataformas de workflow não estão no escopo permitido. Violações podem levar à suspensão da assinatura ou ao bloqueio da Key. Se o Preview for usado apenas em ferramentas como o Qoder, você pode continuar usando o Token Plan para migrar para a versão oficial. Se precisar integrar ao seu próprio backend, use a API de cobrança por uso da versão oficial e utilize a Key e a Base URL da região correspondente no console.
A versão pessoal do Token Plan também inclui uma cláusula de autorização de dados: durante o uso, as entradas e o conteúdo gerado serão usados para melhorar o serviço. Equipes que lidam com materiais confidenciais precisam considerar esse ponto na avaliação ao escolher o produto de integração.
4.3 Substituir o ID do modelo: início rápido com Qwen4-Max
Basta alterar o ID do modelo para qwen4-max para enviar a primeira requisição. Abaixo está um exemplo mínimo usando a interface compatível com OpenAI; primeiro confirme que a requisição funciona e depois passe ao ajuste dos parâmetros:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada da APIYI; também pode ser substituída pelo Base URL da região correspondente do Bailian
)

resp = client.chat.completions.create(
    model="qwen4-max",                   # Valor original: qwen4-max-preview
    messages=[{"role": "user", "content": "用三句话说明你的版本信息"}],
    reasoning_effort="high",             # Especifique explicitamente, sem depender do valor padrão
    max_tokens=8192
)
print(resp.choices[0].message.content)
Quais modelos estão disponíveis na mesma interface compatível com OpenAI depende da lista de modelos em tempo real da plataforma. Em ambiente de produção, confirme mais uma vez antes de publicar.
4.4 Definir explicitamente os parâmetros de raciocínio
O Preview usa xhigh por padrão; a versão oficial usa high. Se o código antigo não especificar a intensidade de raciocínio, a intensidade após a troca cairá automaticamente, e a qualidade, o tempo de execução e o consumo de tokens em tarefas complexas também podem mudar junto. Recomenda-se especificar a intensidade de raciocínio de acordo com o tipo de tarefa: para código complexo e raciocínio científico, primeiro use a mesma intensidade do Preview como linha de base para comparação; para tarefas simples de extração e formatação, tente reduzir depois.
A documentação do Preview determina que reasoning_effort e thinking_budget não podem ser definidos ao mesmo tempo. Na versão oficial, os nomes dos campos e os valores nos quatro protocolos Chat Completions, Responses, Anthropic Messages e DashScope devem seguir a documentação do protocolo correspondente. No Preview, conversas de múltiplos turnos ativam preserve_thinking por padrão, e o conteúdo de pensamento histórico deve ser colocado de volta no campo reasoning_content. Se a sua aplicação enviar de volta o conteúdo de pensamento, também será preciso validar na versão oficial se o formato das mensagens históricas é aceito corretamente.
4.5 Recalcular o orçamento de saída com base no novo limite
No Preview, max_tokens e max_completion_tokens são equivalentes, e o raciocínio e a resposta compartilham um orçamento total de 393.216. Na versão oficial, o orçamento total do modo de raciocínio é de 262.144, e o limite de saída do modo sem raciocínio é de 131.072. Todas as requisições que definem valores acima de 262.144 no Preview precisam ser reduzidas. Para as requisições que já estavam com o orçamento apertado, ainda é preciso considerar a parte ocupada pelo orçamento de raciocínio padrão de 131.072.
Ver o código completo de configuração de migração (validação de orçamento + fallback)
from openai import OpenAI

# Limite oficial da versão de produção (no modo de raciocínio, é a soma de raciocínio + resposta)
LIMITS = {
    "qwen4-max": {"thinking": 262_144, "non_thinking": 131_072},
}

def plan_max_tokens(model: str, thinking: bool,
                    answer_tokens: int, thinking_tokens: int = 0) -> int:
    """Calcula max_tokens conforme o modo; se ultrapassar o limite oficial, lança erro imediatamente para evitar truncamento silencioso"""
    limit = LIMITS[model]["thinking" if thinking else "non_thinking"]
    need = answer_tokens + (thinking_tokens if thinking else 0)
    if need > limit:
        raise ValueError(f"{model} 预算 {need} 超过上限 {limit},请拆分任务")
    return need

PRIMARY = {
    "model": "qwen4-max",
    "base_url": "https://api.apiyi.com/v1",  # Endereço compatível com OpenAI da APIYI
    "reasoning_effort": "high",
}
# O destino de fallback precisa ser um modelo ainda em serviço; o qwen4-max-preview fica indisponível após ser descontinuado
FALLBACK = {
    "model": "YOUR_FALLBACK_MODEL",
    "base_url": "https://api.apiyi.com/v1",
}

def call(cfg: dict, messages: list, max_tokens: int):
    client = OpenAI(api_key="YOUR_API_KEY", base_url=cfg["base_url"])
    kwargs = {"model": cfg["model"], "messages": messages, "max_tokens": max_tokens}
    if "reasoning_effort" in cfg:
        kwargs["reasoning_effort"] = cfg["reasoning_effort"]
    return client.chat.completions.create(**kwargs)

def run(messages: list, answer_tokens: int = 60_000, thinking_tokens: int = 131_072):
    budget = plan_max_tokens("qwen4-max", True, answer_tokens, thinking_tokens)
    try:
        resp = call(PRIMARY, messages, budget)
    except Exception as e:
        print(f"主模型失败,切换回退:{e}")
        resp = call(FALLBACK, messages, min(budget, 32_000))
    choice = resp.choices[0]
    if choice.finish_reason == "length":
        print("警告:输出因长度被截断,需要拆分任务或调整预算")
    print("用量:", resp.usage)
    return choice.message.content

if __name__ == "__main__":
    print(run([{"role": "user", "content": "生成一份模型迁移回归报告的大纲"}]))
4.6 Validar chamadas de ferramentas, saída estruturada e saídas longas
Use tarefas representativas para reproduzir item por item: se o Function Calling retorna o mesmo nome de ferramenta e a mesma estrutura de parâmetros, se as chamadas paralelas de ferramentas são tratadas corretamente pelo código, se a saída do JSON Schema passa pelo validador original, se a saída longa termina com finish_reason == "length" e se o contexto permanece coerente depois de várias rodadas de histórico reenviado. Compare cada item com a linha de base salva em 4.1 e registre as diferenças.
4.7 Observar consumo e cobrança de cache
Depois de migrar de Credits para cobrança por uso, o custo precisa ser calculado separadamente em três itens: entrada, saída (incluindo raciocínio) e cache. O preço unitário da saída na versão oficial é 3 vezes o da entrada, e os tokens de raciocínio também entram na conta da saída, então a configuração do esforço de raciocínio afeta diretamente a fatura. Você pode primeiro usar a cota gratuita da região de Pequim para rodar toda a regressão e, em seguida, estimar o custo mensal com base no consumo real.
4.8 Mudança com tráfego reduzido e configuração de rollback preservada
Primeiro, direcione de 5% a 10% do tráfego para o qwen4-max, observe a taxa de erro, a taxa de truncamento e o custo por tarefa e, só depois de confirmar que está estável, faça a migração total. A configuração de rollback deve apontar para um modelo que ainda esteja em serviço, como outra versão disponível da mesma família ou um modelo de outro provedor já validado. Depois de ser desativado, o Preview não pode servir como destino de rollback.
🎯 Recomendação técnica: o ideal é que o modelo de rollback já tenha sido validado com o mesmo conjunto de tarefas representativas antes do deploy gradual. Com a interface compatível com OpenAI do serviço proxy de API da APIYI apiyi.com, uma única chave API permite alternar entre vários modelos de mercado, bastando alterar o campo
modelpara concluir o ensaio de rollback.
5 Os problemas mais comuns depois da migração para o Qwen4-Max
5.1 Truncamento da saída
Este é o problema mais comum. Relatórios longos ou arquivos grandes que o Preview gerava por completo podem sair truncados na versão oficial, seja por causa do limite de 262.144, seja pelo consumo do orçamento de raciocínio padrão. A solução é verificar o finish_reason, gerar tarefas muito longas em capítulos ou em arquivos separados e deixar um orçamento explícito reservado para a parte da resposta.
5.2 Queda na intensidade de raciocínio padrão
Ao passar de xhigh para high, o desempenho em tarefas complexas pode mudar, enquanto tarefas simples podem ficar mais rápidas e mais baratas. Códigos que não definem os parâmetros de raciocínio mudam de comportamento sem que ninguém perceba. Toda requisição em produção deve definir explicitamente a intensidade de raciocínio, e o replay A/B deve determinar o nível adequado para cada tipo de tarefa.
5.3 Chamadas de ferramenta e diferenças de protocolo
A versão oficial dá suporte explícito a chamadas paralelas de ferramentas, então uma única resposta pode conter várias solicitações de chamada de ferramenta. Códigos que leem apenas o primeiro tool_call deixam ferramentas sem executar e interrompem o fluxo do Agent. Ao trocar de protocolo — por exemplo, de Chat Completions para DashScope —, a nomenclatura dos campos e a forma de devolver o conteúdo de raciocínio também precisam ser conferidas de novo na documentação.
5.4 Mudanças no cache e na base de cobrança
O consumo de Credits no Preview é afetado por fatores como coeficiente de cobrança, acerto de cache e chamadas de ferramenta, então não dá para convertê-lo diretamente em preço por milhão de tokens. A versão oficial usa preços em yuan por milhão de tokens, com o cache cobrado separadamente. O modelo de orçamento que você montou em Credits precisa ser refeito, incluindo o custo de gravação do cache explícito e a escolha de TTL.
6 Quais tarefas precisam ser testadas novamente na versão oficial do Qwen4-Max
| Tipo de tarefa | Principais itens de verificação | Parâmetros de interesse |
|---|---|---|
| Geração de relatórios longos | Truncamento, completude das seções, consistência factual antes e depois | orçamento de saída, finish_reason |
| Geração de código complexo | Taxa de aprovação em compilação e testes, comprimento de arquivo único, consistência entre arquivos | reasoning_effort, orçamento de saída |
| Agent multi-turno | Ordem de chamadas de ferramentas, tratamento de chamadas paralelas, retorno do histórico de raciocínio | tool_calls, reasoning_content |
| Recuperação em documentos longos | Precisão de associação entre parágrafos, se a entrada ultrapassa 983,616 ou 991,808 | entrada máxima, acerto de cache |
| Saída estruturada JSON | Taxa de aprovação na validação de Schema, campos ausentes e erros de tipo | response_format, JSON Schema |
A recuperação em documentos longos exige atenção especial: a entrada máxima da versão oficial varia conforme o modo, e o modo de raciocínio tem cerca de 8.000 Tokens a menos que o modo sem raciocínio. Tarefas que preenchem material até o limite podem ultrapassar a restrição após a troca de modo. Para tarefas de código, recomenda-se reutilizar diretamente o conjunto de testes unitários já existente e usar a taxa de aprovação nos testes como indicador de aceitação, o que é mais confiável do que ler manualmente a saída.
💡 Sugestão de escolha: Se você precisar comparar ao mesmo tempo o desempenho do Qwen4-Max e de outros modelos de ponta nessas tarefas, pode usar a interface unificada do APIYI apiyi.com para reproduzir o mesmo lote de tarefas, reduzindo o trabalho de escrever código de adaptação separado para cada fornecedor.
7 Perguntas frequentes sobre a migração do Qwen4-Max-Preview
P1: Depois que o Qwen4-Max-Preview for descontinuado, as requisições antigas serão redirecionadas automaticamente para a versão oficial?
A documentação oficial apenas informa que o Preview será descontinuado e recomenda o uso da versão oficial; não menciona redirecionamento automático. Altere manualmente o campo `model` para `qwen4-max` antes das 24h do dia 25 de novembro e conclua as verificações da seção 4 deste artigo.
P2: Basta alterar o ID do modelo para qwen4-max?
Não. O limite de saída, o esforço de raciocínio padrão e o método de cobrança mudaram. No mínimo, ainda é preciso recalcular o orçamento de saída, definir explicitamente o esforço de raciocínio e validar por regressão as chamadas de ferramentas e as saídas estruturadas.
P3: O desconto de 80% e a promoção noturna do Preview ainda valem na versão oficial?
Essas duas promoções se aplicam apenas ao consumo de Credits do Preview no Token Plan. A API oficial com cobrança por uso tem como referência, na região de Pequim, 10 yuans por milhão de tokens de entrada e 30 yuans por milhão de tokens de saída; é preciso recalcular o custo.
P4: O backend do serviço pode continuar usando a chave do Token Plan?
Não. O Token Plan permite apenas uso interativo em ferramentas de programação ou de agentes especificadas. O backend de aplicações próprias deve passar a usar a API oficial com cobrança por uso ou recorrer a um serviço de agregação como APIYI (apiyi.com), que oferece uma interface compatível com OpenAI e cobrança por uso.
P5: Como montar rapidamente um ambiente de regressão durante a migração?
Reúna tarefas representativas em um conjunto fixo de requisições; basta alternar o campo `model` no mesmo código para fazer o replay. A APIYI (apiyi.com) oferece cota gratuita de testes para novos usuários, que pode ser usada para validar modelos de fallback e comparar abordagens.
8 Conclusão: incorporar o gerenciamento de versões de modelo ao fluxo de produção do Qwen4-Max
A migração do Qwen4-Max-Preview para a versão oficial envolve cinco dimensões que precisam ser gerenciadas continuamente:
- ID do modelo: mantenha centralizado no centro de configuração, sem hardcode no código, e acompanhe os comunicados sobre o ciclo de vida do modelo.
- Parâmetros da interface: defina explicitamente o esforço de raciocínio, o orçamento de raciocínio e o response_format.
- Limites de saída: registre, para cada modelo, os quatro números — janela de contexto, entrada máxima, saída máxima e orçamento de raciocínio — e faça a validação antes de enviar a solicitação.
- Custo: monitore separadamente entrada, saída e cache; refaça o modelo de orçamento quando o modelo de cobrança mudar.
- Testes de regressão: mantenha um conjunto de tarefas representativas e os resultados de linha de base, e reproduza tudo do início ao fim a cada troca de versão.
O ciclo de vida do Preview dura apenas duas semanas, e a versão oficial também terá novas versões e planos de descontinuação. Estabeleça um processo fixo de “salvar linha de base, definir parâmetros explicitamente, fazer chaveamento gradual e manter fallback disponível”; na próxima troca de versão, a migração poderá ser concluída em poucos dias. Equipes que precisam preparar um plano de fallback para múltiplos modelos podem validar tudo na mesma interface por meio da APIYI apiyi.com.
Referências
-
Documentação oficial do Qwen4-Max (versão oficial): contexto, limites de entrada e saída, esforço de raciocínio padrão, região, preço e cache
- Link:
help.aliyun.com/zh/model-studio/qwen4-max - Descrição: principal base para os parâmetros de migração
- Link:
-
Documentação oficial do Qwen4-Max-Preview: especificações do Preview, forma de acesso e data de descontinuação
- Link:
help.aliyun.com/zh/model-studio/qwen4-max-preview - Descrição: referência de comparação ao manter a configuração antiga
- Link:
-
Atualizações do recurso Token Plan: registros de lançamento do Preview e da versão oficial
- Link:
help.aliyun.com/zh/model-studio/token-plan-product-updates - Descrição: fonte da linha do tempo das versões
- Link:
-
Permissões e normas de uso do Token Plan: escopo de uso interativo e cenários proibidos
- Link:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - Descrição: base de conformidade ao escolher o produto de acesso
- Link:
-
Assinatura e benefícios do Token Plan Individual: planos, Credits e desconto do Preview
- Link:
help.aliyun.com/zh/model-studio/token-plan-personal-overview - Descrição: diferencia o desconto do Preview da cobrança da versão oficial
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: fale conosco pela página inicial da APIYI apiyi.com; mais materiais de acesso estão disponíveis no centro de documentação docs.apiyi.com