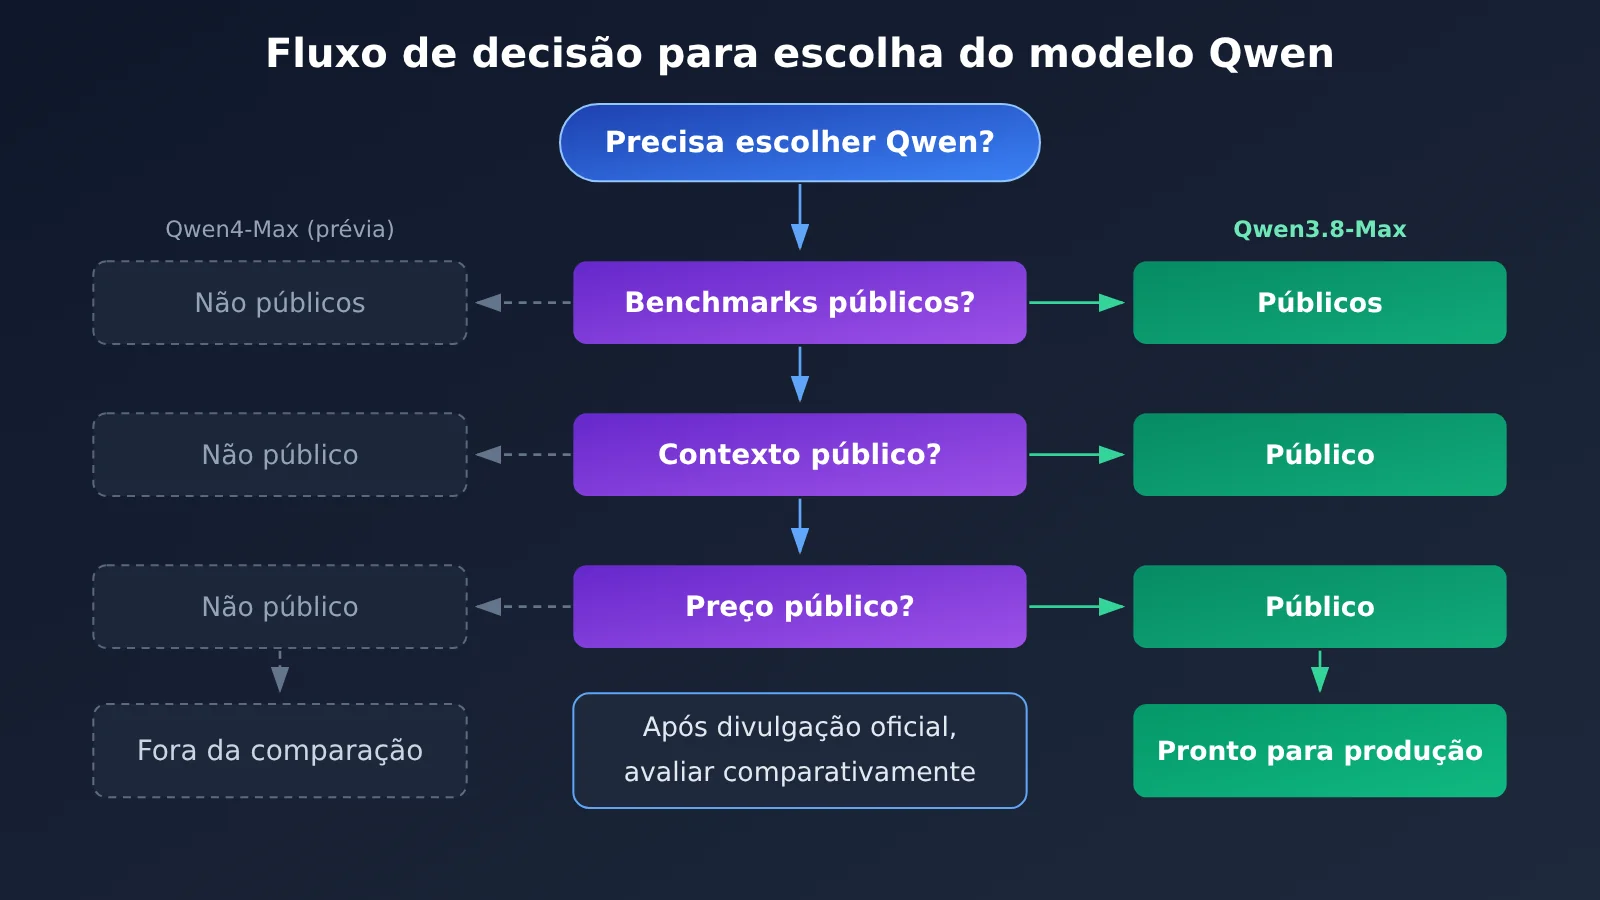
Nota do autor: o Qwen4-Max ainda está em fase de preview e não tem benchmarks públicos, tamanho de janela de contexto nem preço por token. Por isso, esses três pontos não dão para comparar diretamente com o Qwen3.8-Max. O modelo que hoje dá para invocar com cobrança por uso continua sendo o
qwen3.8-max.
Quando o preview do Qwen4-Max saiu, a primeira pergunta de quem já usa Qwen foi: vale a pena migrar? Ele é quanto melhor que o Qwen3.8-Max? E quanto mais caro? Por enquanto, essas perguntas não têm uma resposta comparável, porque o preview ainda não traz três informações públicas indispensáveis para qualquer comparação.
Isso não é uma crítica ao Qwen4-Max. Não estamos julgando se ele é forte ou fraco, só apontando um fato: até 12/11/2026, o preview do Qwen4-Max ainda não tem benchmarks públicos, tamanho de janela de contexto nem preço por token, enquanto o Qwen3.8-Max já foi lançado e pode ser invocado com cobrança por uso. Segundo a lista de modelos da APIYI (apiyi.com) em 12/11/2026, o que dá para integrar direto hoje é o qwen3.8-max.
Valor central: em 3 minutos você entende quais itens do Qwen4-Max (preview) e do Qwen3.8-Max não podem ser comparados agora e como organizar o seu projeto até que as informações oficiais saiam.
Qwen4-Max e Qwen3.8: visão rápida das informações principais
Primeiro, vamos juntar o que dá para confirmar dos dois lados. A tabela abaixo traz só o que as fontes de referência comprovam. O que não foi divulgado aparece como “não divulgado”, sem especulação.
| Item | Qwen4-Max (prévia) | Qwen3.8-Max |
|---|---|---|
| Status de lançamento | Fase de prévia | Modelo já lançado |
| Benchmarks públicos | Não divulgado | Modelo já lançado, com material oficial para consulta |
| Tamanho da janela de contexto | Não divulgado | Conforme a documentação oficial e a descrição do modelo |
| Preço por token | Não divulgado | Entrada $1,65 / saída $4,95 / leitura de cache $0,20625 (por 1M de tokens) |
| Invocação sob demanda | Ainda não consta na lista de modelos de 2026-11-12 | Disponível, com o ID de modelo qwen3.8-max |
| Plataformas disponíveis | Conforme anúncios oficiais futuros | APIYI e outras plataformas |
“Não divulgado” aparece três vezes na tabela: benchmarks, janela de contexto e preço. Essas são justamente as três dimensões mais usadas na hora de escolher um modelo, e sem qualquer uma delas a comparação lado a lado perde a base. Já existem artigos anteriores sobre a abertura da prévia, então aqui vamos tratar só de por que esses três pontos não permitem comparação forçada.
O que cada uma das três informações ausentes na prévia do Qwen4-Max afeta
Benchmarks definem a avaliação de capacidade. Sem pontuações oficiais públicas, não existe um critério único para medir se o Qwen4-Max avança ou recua em relação ao Qwen3.8-Max em raciocínio, código, textos longos e outras tarefas. Prints soltos da comunidade ou impressões de conversas isoladas usam conjuntos de teste, comandos e parâmetros de amostragem diferentes, então não substituem benchmarks oficiais.
O tamanho da janela de contexto define a arquitetura. O tamanho dos chunks no RAG, a estratégia de truncar o histórico de conversa, a decisão de mandar um documento longo de uma vez ou em partes: tudo isso depende de um limite de contexto definido. Sem esse número, não dá para avaliar se a migração permitiria eliminar a lógica de segmentação que você já tem, nem prever se vão aparecer erros de excesso de tamanho.
O preço por token define o modelo de custos. Orçamento, precificação e política de limite de taxa partem do preço unitário. Mesmo que dê para experimentar na fase de prévia, isso não significa que já exista um preço que possa entrar na planilha de custos. Comparar um preço indefinido com o preço atual do qwen3.8-max não leva a nenhuma conclusão útil.
Preço e acesso ao Qwen3.8-Max com cobrança por uso
Como ainda não dá para fazer a comparação, o melhor é seguir com o modelo que já foi lançado. A tabela abaixo mostra os preços do qwen3.8-max na lista de modelos de 12/11/2026, em dólares por 1M de tokens.
| Item de cobrança | Preço unitário (por 1M tokens) | Observação |
|---|---|---|
| Entrada | $1,65 | Parte do comando que não acertou o cache |
| Saída | $4,95 | Conteúdo gerado pelo modelo, 3 vezes o preço da entrada |
| Leitura de cache | $0,20625 | Parte da entrada que acertou o cache, 1/8 do preço da entrada |
Pela estrutura de preços, a saída custa 3 vezes mais que a entrada, e a leitura de cache custa só 12,5% da entrada. Por isso, controlar o tamanho da saída e aumentar a taxa de acerto do cache são as duas formas mais diretas de reduzir o custo do qwen3.8-max. Em cenários com comando de sistema longo e prefixo estável nas conversas de vários turnos, o ganho com o cache fica ainda mais evidente.
Exemplos de estimativa de custo do Qwen3.8-Max
Com os preços acima, dá para calcular o custo de algumas requisições típicas. Todos os números saem diretamente dos preços públicos, então é fácil adaptá-los ao volume do seu negócio.
| Cenário | Tokens de entrada | Acertos de cache | Tokens de saída | Custo por requisição |
|---|---|---|---|---|
| Requisição comum | 10.000 | 0 | 2.000 | $0,0264 |
| Mesma requisição, prefixo com acerto de cache | 10.000 | 8.000 | 2.000 | $0,01485 |
| Processamento em lote de 1M de entrada | 1.000.000 | 0 | 200.000 | $2,64 |
A segunda linha tem o mesmo total de entrada e saída da primeira. A única diferença é que 8.000 tokens de entrada acertaram o cache, e o custo por requisição cai de $0,0264 para cerca de $0,0149, uma redução de mais de 40%. Esse é um cálculo que o Qwen4-Max Preview ainda não permite, porque o preço dele não foi divulgado.
Como acessar o qwen3.8-max
O APIYI oferece uma interface compatível com a OpenAI, então dá para usar o SDK da OpenAI ou qualquer cliente compatível. Basta alterar três parâmetros:
base_url:https://api.apiyi.com/v1(interface unificada do APIYI)api_key: a chave API criada no console do APIYImodel:qwen3.8-max
A invocação segue o padrão do Chat Completions, e o array messages é organizado na ordem dos papéis system, user e assistant. Se o seu projeto já usa um endpoint compatível com a OpenAI, normalmente só é preciso trocar o base_url e o ID do modelo, sem mexer no código de negócio.
🚀 Comece agora: cadastre-se no APIYI (apiyi.com) para ganhar créditos gratuitos de teste. Rode os comandos reais do seu negócio com o
qwen3.8-maxe registre as proporções reais de entrada, saída e acerto de cache. Assim, quando o Qwen4-Max for liberado oficialmente, você já terá dados prontos para comparar.
Impacto da prévia do Qwen4-Max nos projetos Qwen existentes
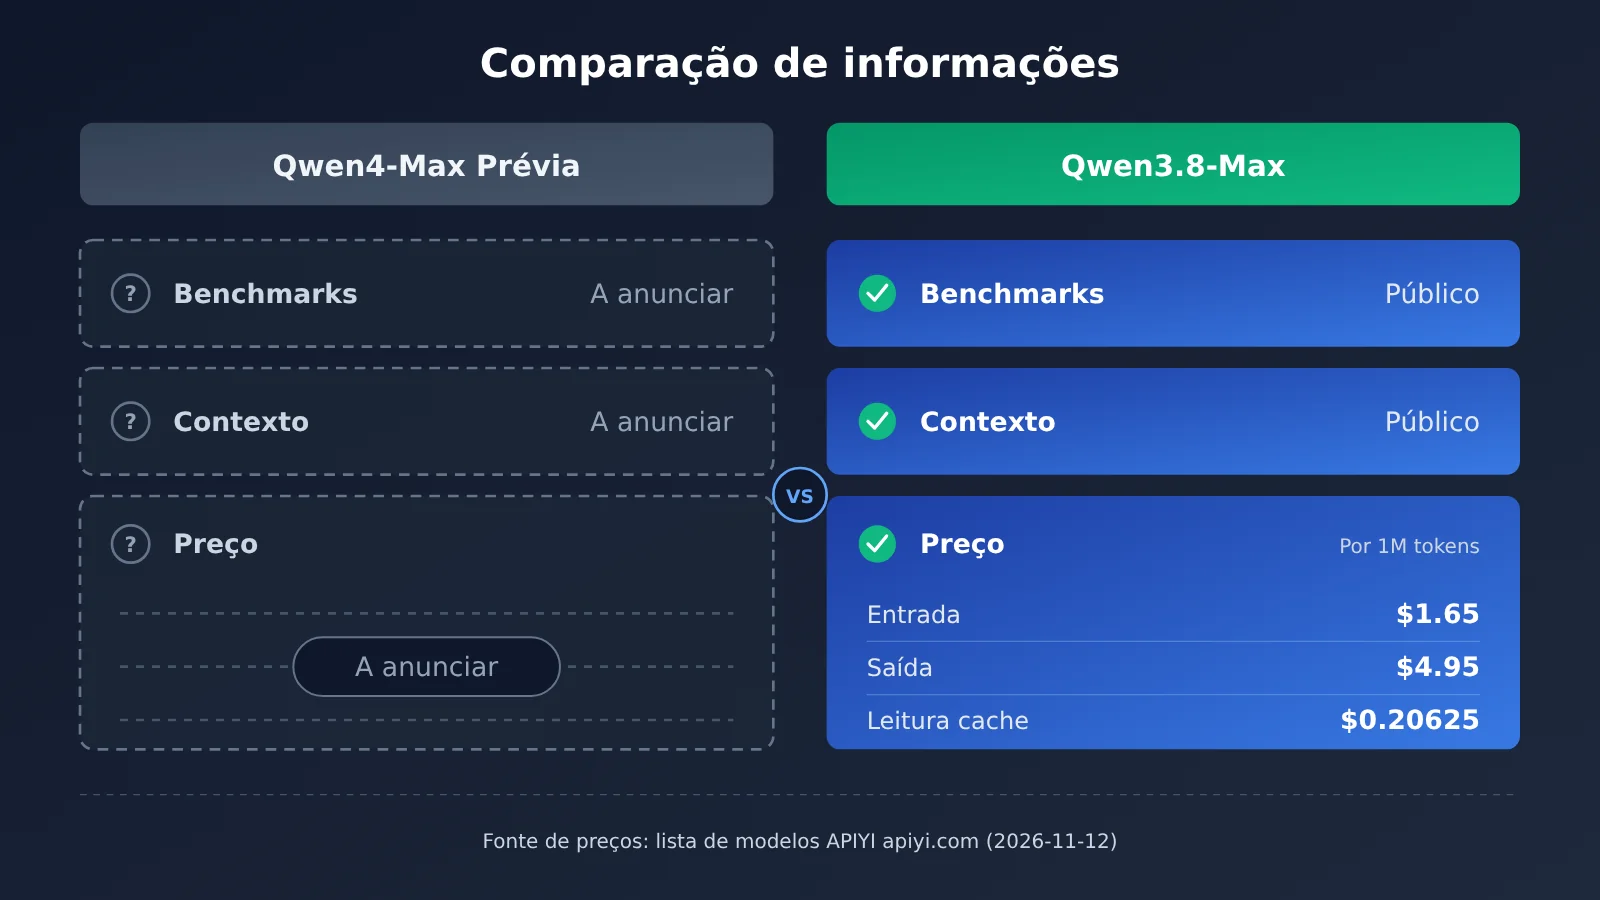
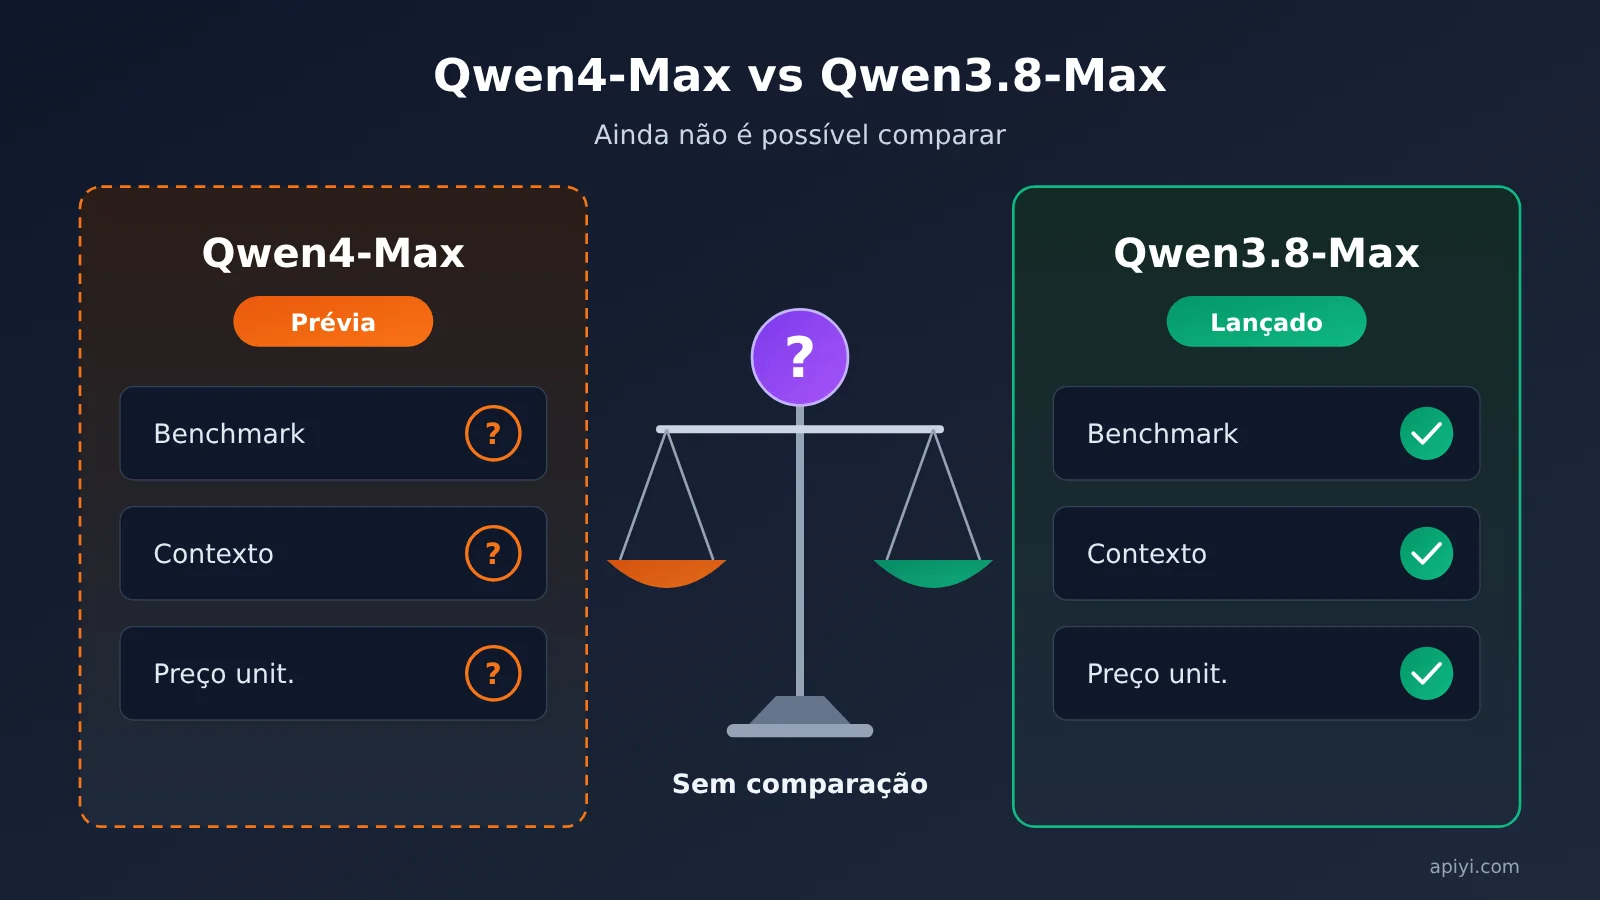
A imagem acima coloca lado a lado o nível de informação de cada modelo: de um lado, três campos ainda “a anunciar”; do outro, dados que você já pode consultar. Nesse cenário, qualquer conclusão do tipo “é X vezes mais forte” ou “é Y vezes mais caro” fica sem base. Os preços podem ser conferidos na lista de modelos do APIYI (apiyi.com).
Impacto para quem já usa Qwen
- Produção não precisa mudar: a prévia do Qwen4-Max não altera a disponibilidade nem o preço do qwen3.8-max, e as chamadas atuais continuam funcionando normalmente.
- Dá para ir preparando a avaliação: monte um conjunto de comandos de teste que represente o seu negócio, com critérios de pontuação definidos. Quando as informações oficiais saírem, é só usar esse material para comparar os dois modelos.
- O orçamento continua baseado no qwen3.8-max: na fase de prévia não há preço unitário, então não vale incluir o Qwen4-Max no orçamento ou em propostas da próxima etapa.
- Deixe de lado mudanças ligadas à janela de contexto: até o tamanho do contexto do Qwen4-Max ser divulgado, não é recomendável ajustar a lógica de chunking ou truncamento por causa dele.
Como cada perfil deve se posicionar
| Perfil | O que dá para fazer agora | O que fazer depois das informações oficiais |
|---|---|---|
| Desenvolvedor de aplicações | Continuar com qwen3.8-max e construir um conjunto de avaliação do seu negócio |
Comparar os dois modelos com o mesmo conjunto de avaliação |
| Responsável por arquitetura | Desenhar a estratégia de contexto com base no limite real do qwen3.8-max | Avaliar, com base no contexto do Qwen4-Max, se dá para simplificar o chunking |
| Responsável por custos | Montar o orçamento com entrada a $1,65 e saída a $4,95 por 1M de tokens | Recalcular o custo de migração quando o preço do Qwen4-Max sair |
| Gerente de produto | Manter a comunicação externa baseada nas capacidades dos modelos já lançados | Decidir se vale divulgar o upgrade com base nos benchmarks públicos |
O que isso ensina sobre o processo de escolha de modelos
O problema mais comum de uma versão de prévia é tratar “parece mais novo” como “já é melhor”. Um processo de seleção sério precisa de pelo menos três tipos de dado público: capacidade (benchmarks), capacidade de contexto (janela de contexto) e custo (preço unitário). Enquanto os três não estiverem completos, o modelo novo cabe na lista de observação, mas não no plano de produção.
Gerenciar a invocação do modelo por uma interface unificada traz mais um benefício: quando o Qwen4-Max for aberto para cobrança por uso, basta alterar o parâmetro model para fazer um teste A/B, sem precisar integrar outro SDK.
💡 Sugestão: até que as três informações-chave do Qwen4-Max sejam divulgadas, o ideal é manter o qwen3.8-max como principal modelo de produção. Integrando pela interface unificada do APIYI (apiyi.com), você consegue alternar e comparar os novos modelos no mesmo código assim que eles forem lançados.
Perguntas frequentes (FAQ)
P1: Já dá para comparar o Qwen4-Max Preview com o Qwen3.8-Max?
Em benchmarks, comprimento de contexto e preço por token, ainda não. O Qwen4-Max continua em fase de prévia e nenhum desses três itens foi divulgado, então não existe uma base de comparação uniforme. O que dá para afirmar é só o status de lançamento: o Qwen3.8-Max já foi lançado e pode ser chamado com cobrança por uso, enquanto o Qwen4-Max ainda está em prévia.
P2: O Qwen4-Max já superou o Qwen3.8-Max em tudo?
Hoje não há dados públicos que sustentem essa conclusão. Um número de versão maior não significa que o modelo seja melhor em todas as tarefas, nem que o preço seja mais vantajoso. Para saber se ele supera o antecessor, e em quais tarefas, é preciso esperar a divulgação oficial dos benchmarks e, de preferência, validar com o seu próprio conjunto de avaliação de negócio.
P3: Quanto custa chamar o Qwen3.8-Max hoje?
Segundo a lista de modelos de 2026-11-12, o qwen3.8-max custa, a cada 1M de tokens: $1,65 de entrada, $4,95 de saída e $0,20625 de leitura de cache. O preço de leitura de cache é só 1/8 do preço de entrada, então, em cenários com prefixo de comando estável, dá para reduzir bastante o custo.
P4: Como chamar o Qwen3.8-Max rapidamente via API?
A recomendação é usar uma plataforma agregadora de APIs com suporte a vários modelos:
1. Acesse o APIYI (apiyi.com), crie uma conta e pegue sua chave API e o crédito gratuito para testes
2. Defina o base_url como `https://api.apiyi.com/v1`
3. Informe `qwen3.8-max` como ID do modelo e faça a chamada no formato Chat Completions compatível com a OpenAI
P5: Quando o Qwen4-Max for liberado oficialmente, o custo de migração será alto?
No nível da interface, o custo de migração depende de como você integra os modelos. Se você gerencia tudo por uma interface compatível com a OpenAI, normalmente basta trocar o ID do modelo; o que realmente precisa ser avaliado é a diferença de desempenho e de custo. Minha sugestão é começar já a acumular dados de avaliação com o qwen3.8-max no APIYI (apiyi.com), para comparar direto quando chegar a hora.
P6: Quais limitações devo ter em mente durante a fase de prévia?
Na prévia, todos os parâmetros importantes podem mudar. Sem benchmarks públicos, não dá para saber até onde vai a capacidade do modelo; sem o comprimento de contexto, não dá para fechar uma solução para textos longos; sem o preço unitário, não dá para colocar o modelo no orçamento. Por isso, não recomendo usar modelos em prévia em produção quando há exigência de estabilidade e controle de custo.
Principais pontos sobre Qwen4-Max e Qwen3.8 (Key Takeaways)
- Status de lançamento diferente: o Qwen4-Max ainda está em prévia, enquanto o Qwen3.8-Max já foi lançado e pode ser invocado com cobrança por uso.
- Três itens que não dá para comparar: benchmarks, tamanho da janela de contexto e preço por token do Qwen4-Max ainda não foram divulgados.
- Nada de conclusões precipitadas: sem dados públicos, não dá para afirmar que o Qwen4-Max supera o Qwen3.8-Max em todos os aspectos.
- Preços atuais disponíveis: o qwen3.8-max custa US$ 1,65 por 1M de tokens de entrada, US$ 4,95 de saída e US$ 0,20625 de leitura de cache.
- Cache é a chave para reduzir custos: o preço de leitura de cache é só 1/8 do preço de entrada, o que traz um ganho claro em cenários com prefixo estável.
- Em produção, fique com o qwen3.8-max: integre pela interface unificada da APIYI e, quando precisar trocar de modelo, basta mudar o ID do modelo.
Resumo
A relação entre a prévia do Qwen4-Max e o Qwen3.8-Max se resume nos seguintes pontos:
- Ainda não há condições de comparar: a prévia do Qwen4-Max não tem benchmarks públicos, tamanho de janela de contexto nem preço por token, então nenhum desses três itens pode ser comparado de forma direta com o Qwen3.8-Max.
- O que está disponível hoje é o qwen3.8-max: os preços são claros — US$ 1,65 de entrada, US$ 4,95 de saída e US$ 0,20625 de leitura de cache (por 1M de tokens).
- Prepare-se agora e compare quando houver o anúncio oficial: monte desde já seu conjunto de avaliação de negócio e os dados de custo, e só decida sobre a migração quando as informações estiverem completas.
Até que as informações oficiais do Qwen4-Max sejam divulgadas, o mais seguro é continuar usando o qwen3.8-max para sustentar o seu negócio e, ao mesmo tempo, deixar prontas as bases de avaliação e de custo. Recomendamos acessar o qwen3.8-max pela APIYI (apiyi.com), que oferece uma interface unificada compatível com OpenAI e créditos gratuitos para testes. Quando o novo modelo for lançado, você poderá compará-lo diretamente usando o mesmo código.
📚 Referências
- Lista de modelos e preços da APIYI: conferência dos modelos disponíveis em 2026-11-12
- Link:
api.apiyi.com/api/pricing -
Descrição: usada para confirmar quais modelos Qwen podem ser invocados atualmente com cobrança por uso
-
Documentação de modelos da APIYI: informações de cobrança do qwen3.8-max
- Link:
docs.apiyi.com/models - Descrição: inclui os preços unitários de entrada, saída e leitura de cache do qwen3.8-max
Autor: equipe técnica da APIYI
Troca de experiências: fale com a gente na página inicial da APIYI. Para mais materiais sobre como integrar outros modelos, consulte a central de documentação da APIYI.