Ringkasan: Artikel ini membahas diskon 8% Credits malam hari untuk Qwen4-Max-Preview, lalu membandingkan paket langganan Token Plan, API bayar-per-pakai versi resmi, dan platform agregasi API multi-model dari tiga sisi: cakupan penggunaan, satuan penagihan, dan total biaya tugas.
Kesimpulan Qwen4-Max-Preview 8% Credits di awal
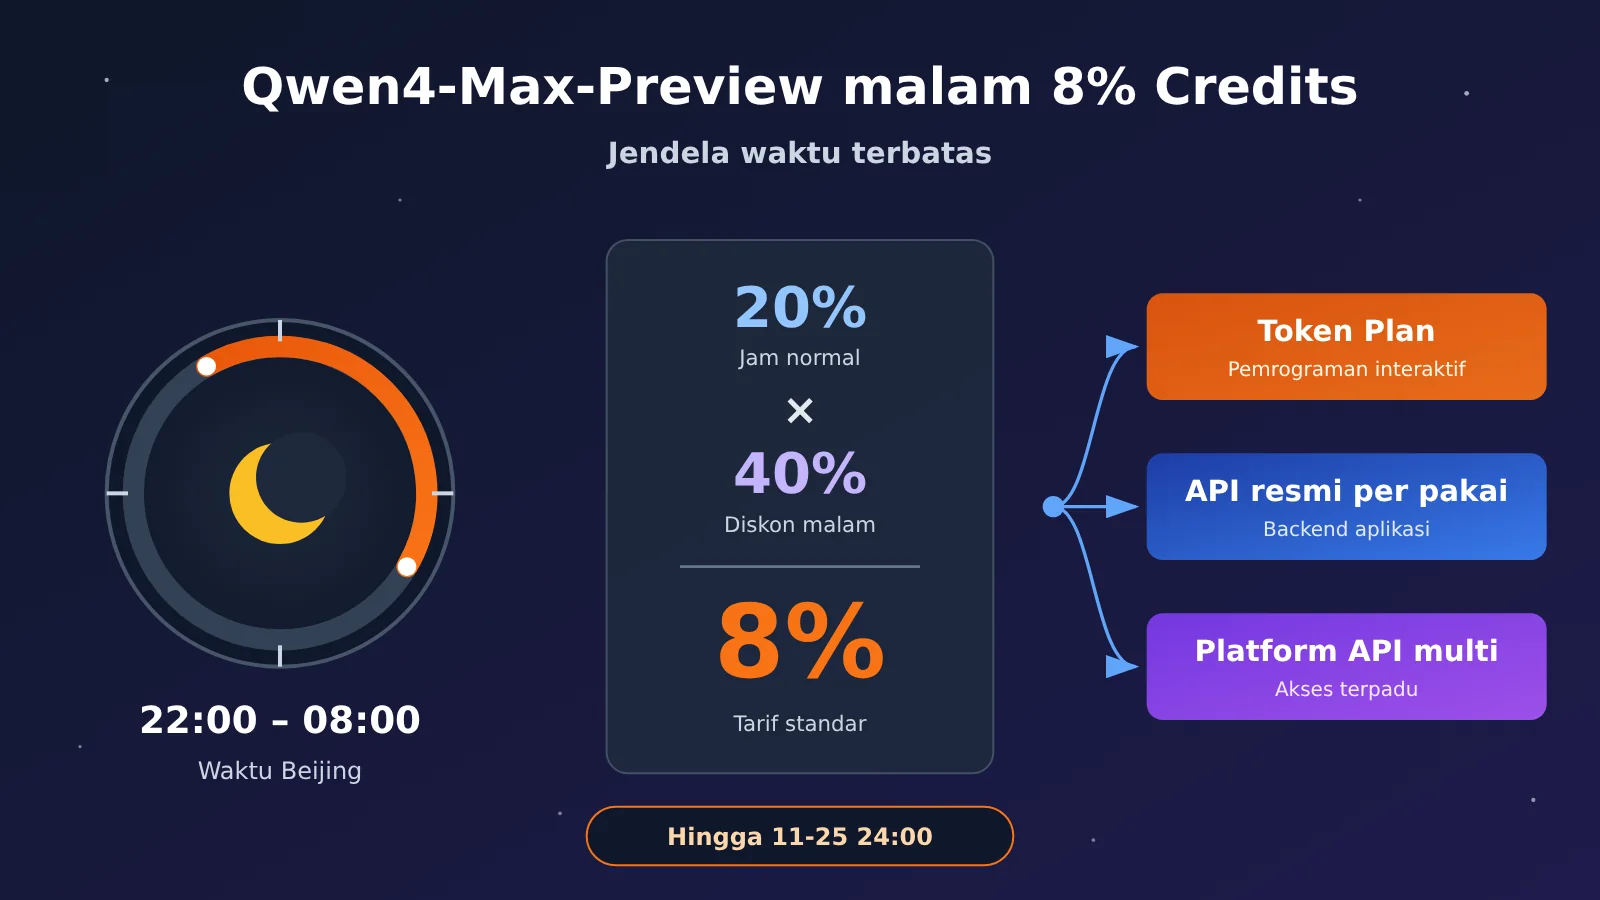
Saat memanggil Qwen4-Max-Preview di Token Plan, konsumsi Credits setiap malam pukul 22:00 hingga 08:00 keesokan harinya (waktu Beijing) hanya 8% dari tarif standar. Rasio ini didapat dari tarif 20% di jam normal yang ditumpuk dengan tambahan 40% di malam hari. Diskon ini berlaku sampai Preview berakhir, yaitu 25 November 2026 pukul 24:00 (waktu Beijing), setelah itu model tersebut dihentikan.
Diskon ini hanya berlaku untuk skenario yang diizinkan Token Plan, yakni penggunaan interaktif di alat coding dan alat agen. Kalau ingin menghubungkan model ke backend aplikasi sendiri atau ke bisnis otomasi, perlu memilih produk API bayar-per-pakai yang mengizinkan penggunaan seperti itu. Versi resmi Qwen4-Max yang diluncurkan 16 November sudah menyediakan harga penagihan per pemakaian tersendiri, sehingga bisa menampung kebutuhan tersebut.
Berikut ini kita uraikan dulu cara menghitung 8% dan harga paket Token Plan, lalu menjelaskan dasar penagihan per pemakaian pada versi resmi beserta mekanisme cache-nya. Setelah itu kita bandingkan tiga skema pemanggilan dari empat aspek: tugas yang cocok, bentuk penggunaan, satuan penagihan, dan antarmuka. Kita juga akan memberikan kerangka perhitungan yang mengelompokkan biaya berdasarkan tugas. Terakhir, ada rekomendasi pilihan berdasarkan jenis tugas nyata developer.
Perlu Diketahui: Terminologi Terkait Penagihan Qwen4-Max-Preview
| Istilah | Penjelasan |
|---|---|
| Credits | Unit pengurang untuk paket langganan Token Plan; jumlah konsumsinya bergantung pada model yang digunakan dan komposisi spesifik pemanggilan tersebut |
| Token | Unit pengukuran untuk input, output, serta konten pemikiran model |
| Token Plan | Produk Alibaba Cloud yang memberikan hak Credits berdasarkan siklus langganan, tersedia dalam versi individu dan versi tim |
| API bayar sesuai pemakaian | Cara layanan model dengan penagihan berdasarkan volume pemanggilan aktual, ditujukan untuk integrasi aplikasi |
| Cache hit | Input yang dikirim berulang digunakan kembali oleh server, lalu dihitung berdasarkan aturan penagihan yang berlaku untuk cache |
| Token pemikiran | Token yang dihasilkan selama proses penalaran model; memakan anggaran output dan ikut dihitung dalam penagihan output |
| Platform agregasi API | Layanan yang menyediakan pemanggilan berbagai model dan manajemen penggunaan melalui satu antarmuka terpadu |
| Biaya per tugas | Jumlah total dari seluruh permintaan, percobaan ulang, pemanggilan alat, dan konsumsi model yang dibutuhkan untuk menyelesaikan satu tujuan yang sama |
1 Dari Mana Diskon 0.8 Kali Qwen4-Max-Preview Berasal
1.1 Dua Lapisan Diskon yang Bertumpuk: 20% × 40% = 8%
Selama periode kampanye Preview, Token Plan menetapkan dua lapisan keuntungan Credits untuk Qwen4-Max-Preview:
- Waktu normal: Konsumsi Credits adalah 20% dari tarif standar, artinya hanya 20% dari tarif normal. Dengan anggaran Credits yang sama, secara teori bisa menyelesaikan sekitar 5 kali volume pemanggilan dibandingkan tarif standar.
- Waktu malam: Setiap hari pukul 22:00 hingga 08:00 waktu Beijing, dikenakan potongan tambahan 40% di atas tarif 20% tersebut.
- Hasil penggabungan: 20% × 40% = 8%, yaitu hanya 8% dari tarif standar (0.8 kali).
Pihak resmi pernah memberikan contoh proporsi: jika suatu pemanggilan menurut tarif standar seharusnya mengonsumsi 100 Credits, pada waktu normal aktualnya mengonsumsi 20 Credits, dan pada waktu malam aktualnya mengonsumsi 8 Credits. Ini hanyalah contoh matematis untuk menunjukkan proporsi; berapa konsumsi aktual per pemanggilan harus mengacu pada rincian penggunaan di konsol. Pihak resmi juga berhak menyesuaikan keuntungan sesuai kondisi operasional.
1.2 Batas Waktu Jendela Terbatas Qwen4-Max-Preview
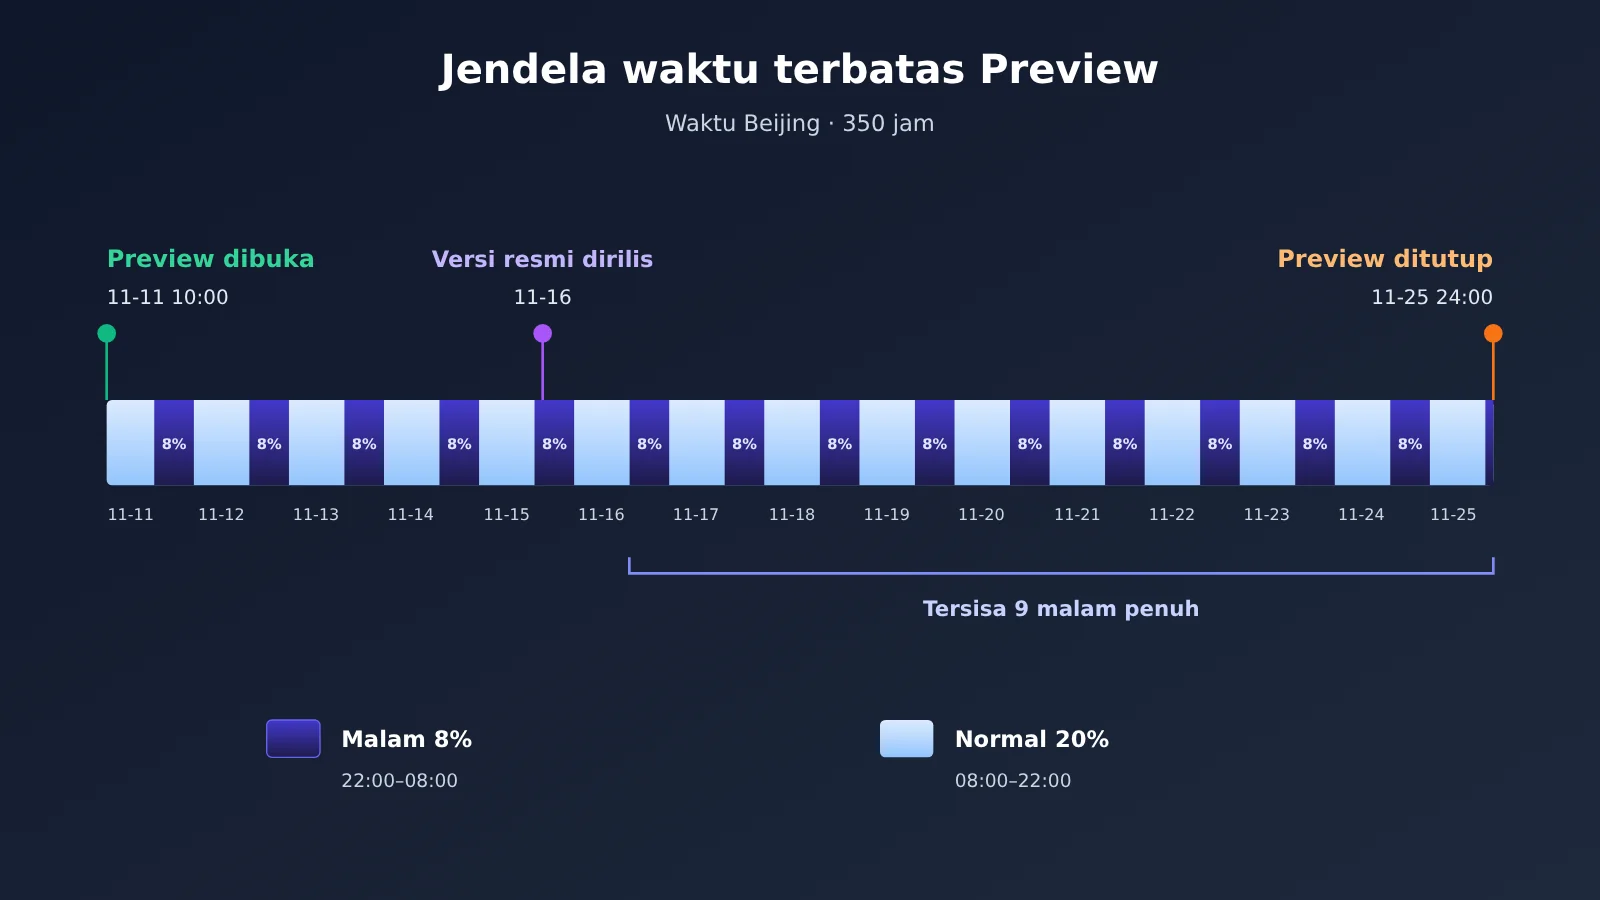
Preview dibuka pada 11 November 2026 pukul 10:00 dan berakhir pada 25 November pukul 24:00 (keduanya waktu Beijing), dengan total 350 jam. Dihitung dari hari ini, 16 November, sisa periode malam yang masih utuh adalah 9 malam, yaitu dari malam 16 November hingga pagi 25 November. Pada malam 25 November, periode malam hanya berlangsung dua jam, dari pukul 22:00 sampai 24:00, setelah itu Preview dihentikan.
Setelah versi resmi Qwen4-Max diluncurkan pada 16 November, waktu penghentian Preview tetap tidak berubah. Dokumentasi model resmi sudah menyarankan penggunaan versi resmi, jadi alur kerja yang terbentuk di dalam jendela Preview sebaiknya disiapkan untuk migrasi ke qwen4-max sejak sekarang.
2 Cara Membeli dan Menghabiskan Credits di Token Plan
2.1 Harga dan Kuota Paket Token Plan Versi Personal
Hingga 16 November 2026, paket yang tercantum di halaman resmi Token Plan versi personal Alibaba Cloud adalah sebagai berikut. Kuota bulanan dan harga sempat disesuaikan pada 9 November, jadi tangkapan layar dan harga di artikel-artikel yang lebih lama sudah tidak berlaku.
| Paket | Harga Bulanan | Credits Bulanan | Agent Bersamaan | Harga Pengguna Baru |
|---|---|---|---|---|
| Lite | 39 yuan | 20,000 | 1–2 | 19.5 yuan/bulan |
| Essential | 79 yuan | 45,000 | 2–3 | 39.5 yuan/bulan |
| Standard | 139 yuan | 80,000 | 3–4 | Halaman tidak mencantumkan promo pengguna baru |
| Pro | 312 yuan | 200,000 | 6–8 | Halaman tidak mencantumkan promo pengguna baru |
Harga pengguna baru berlaku hingga 30 November 2026 pukul 23:59:59 (UTC+8), dan hanya untuk akun yang sebelumnya belum pernah membeli Token Plan versi personal. Diskon pengguna baru memotong harga langganan paket; sementara diskon 2 折 dan 0.8 折 untuk Preview memotong konsumsi Credits saat pemanggilan model. Keduanya bekerja di tahap yang berbeda.
2.2 Aturan Paket Kuota Tambahan Token Plan
Kalau kuota paket sudah habis, kamu bisa membeli paket kuota tambahan. Aturannya begini:
- Harga 100 yuan per unit per bulan, tiap paket berisi 20,000 Credits.
- Kamu harus sudah punya paket aktif, dan maksimal bisa memegang 5 paket sekaligus.
- Masa berlaku satu bulan, kuota yang tidak terpakai akan hangus saat kedaluwarsa.
- Kuota paket tambahan terpisah dari kuota bulanan bawaan paket.
2.3 Hubungan Pengukuran Credits dan Token
Credits adalah satuan potongan untuk Token Plan, sedangkan Token adalah satuan komputasi model. Keduanya tidak bisa dikonversi satu banding satu. Menurut penjelasan resmi, berapa Credits yang dipotong dalam satu pemanggilan bergantung pada faktor-faktor berikut:
- Jenis model beserta koefisien penagihannya;
- Jumlah Token input, termasuk berapa Token di antaranya yang kena cache;
- Jumlah Token output, termasuk Token pemikiran (thinking);
- Jumlah pemanggilan alat (tool call), serta pemanggilan tambahan yang muncul dari alat bawaan dan sub-tugas.
Jadi, dengan 39 yuan dan 20,000 Credits, kita tidak bisa menghitung harga per juta Token untuk Qwen4-Max-Preview. Pihak resmi tidak mengumumkan harga terpisah per juta Token untuk Preview, dan juga tidak mendukung pembayaran sesuai pemakaian untuk Preview. Sebagai gambaran, ada catatan aktual yang bisa dijadikan acuan: seorang developer menyelesaikan proyek interaktif mesin capit boneka di Qoder, memakan waktu sekitar 75 menit, dengan perkiraan konsumsi sekitar 65 Credits. Ini catatan satu tugas pada alat tertentu, jadi anggap saja sebagai gambaran skala konsumsinya.
3 Perbandingan cara penagihan Qwen4-Max-Preview dan versi resmi
3.1 Preview: hanya bisa diakses lewat Token Plan khusus
Cara akses Preview sudah tetap: berlangganan Token Plan versi personal atau tim, dapatkan kunci API khusus paket, gunakan Base URL khusus https://token-plan.cn-beijing.maas.aliyuncs.com, dan setel ID model ke qwen4-max-preview (alias qwen4.0-max-preview, yang di tagihan selalu ditampilkan dengan nama alias ini). Model ini kompatibel dengan spesifikasi antarmuka OpenAI Chat Completions, Responses, dan Anthropic Messages.
Anggaran output Preview adalah 393.216 Token, dipakai bersama oleh konten berpikir dan jawaban akhir, dengan tingkat penalaran default xhigh. Saat migrasi dari model lain, kalau max_tokens hanya disetel berdasarkan panjang jawaban akhir, jawaban bisa terpotong karena konten berpikir menghabiskan seluruh anggaran.
3.2 Versi resmi Qwen4-Max: harga API bayar sesuai pemakaian
Versi resmi qwen4-max diluncurkan pada 16 November. Model ini bisa dipakai di Token Plan maupun dipanggil dengan skema bayar sesuai pemakaian. Berikut harga bayar sesuai pemakaian versi resmi yang tercantum di halaman model resmi (yuan RMB, per juta Token):
| Wilayah deployment | Input | Output (termasuk proses berpikir dan jawaban) |
|---|---|---|
| Tiongkok daratan, Tiongkok Utara 2 (Beijing) | 10 yuan | 30 yuan |
| Virginia, Amerika Serikat | 10 yuan | 30 yuan |
| Frankfurt, Jerman | 10 yuan | 30 yuan |
| Tokyo, Jepang | 10 yuan | 30 yuan |
| Hong Kong, Tiongkok | 10 yuan | 30 yuan |
| Singapura | 10.938 yuan | 32.813 yuan |
Wilayah Beijing juga punya kuota gratis 1 juta Token, berlaku dalam 90 hari sejak waktu mulai berlakunya (misalnya saat Bailian diaktifkan, model dirilis, atau permohonan disetujui) — aturan detailnya mengikuti halaman resmi. Harga ini hanya berlaku untuk versi resmi dan tidak bisa dipakai untuk menghitung balik konsumsi Credits standar Preview.
Parameter versi resmi juga berbeda dari Preview: jendela konteksnya sama, 1.000.000 Token, tetapi output maksimumnya 262.144 Token dalam mode berpikir dan 131.072 Token dalam mode non-berpikir; tingkat penalaran default high, anggaran berpikir default 131.072. Saat migrasi, batas output perlu diperiksa ulang.
3.3 Mekanisme cache eksplisit versi resmi Qwen4-Max
Versi resmi mendukung cache eksplisit, yang bisa memakai ulang prefiks input tetap seperti system prompt, deskripsi tool, dan dokumen referensi. Cache eksplisit mendukung tiga antarmuka: OpenAI Chat Completions, Responses, dan Anthropic Messages, dengan TTL 5 menit atau 1 jam.
Tugas Agent multi-putaran biasanya mengirim ulang instruksi sistem dan deskripsi tool yang sama di setiap putaran — di sinilah cache paling menghemat biaya. Cache punya aturan penagihan tersendiri; untuk harga satuannya, silakan lihat halaman penagihan pemanggilan model di wilayah yang bersangkutan.
4 Tiga cara pemanggilan Qwen4-Max-Preview dan siapa yang cocok untuk masing-masing
4.1 Perbandingan tiga opsi
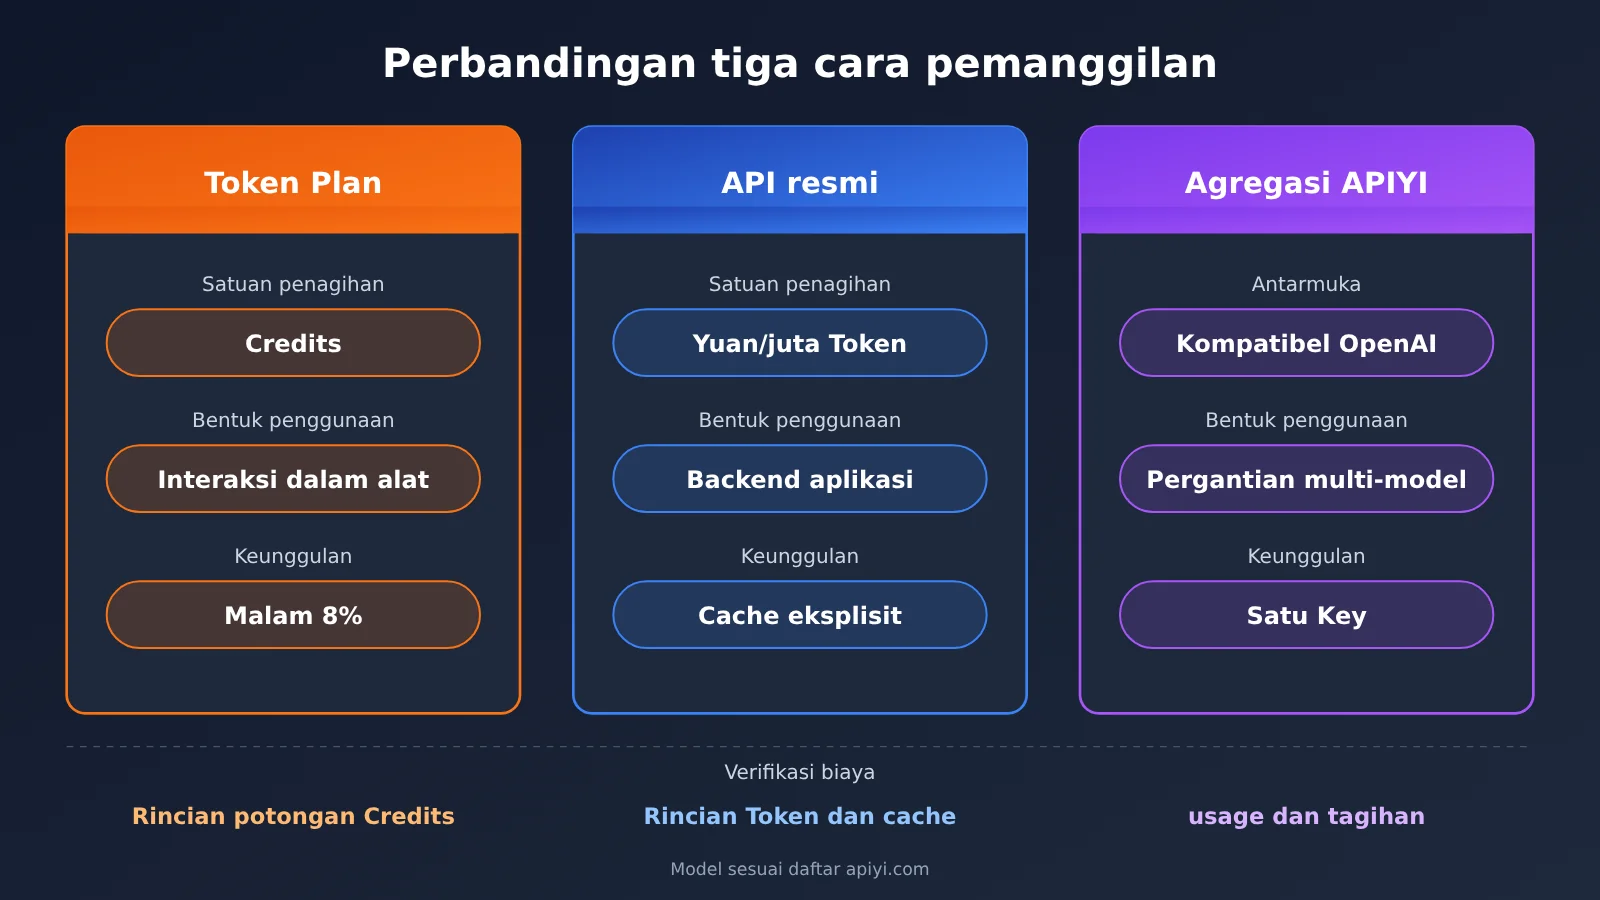
| Dimensi | Langganan Token Plan | API bayar sesuai pemakaian versi resmi | Platform agregasi API multi-model |
|---|---|---|---|
| Tugas yang cocok | Pemrograman interaktif, percakapan Agent | Backend aplikasi mandiri, operasional otomatis | Aplikasi multi-model, perbandingan dan peralihan model |
| Bentuk penggunaan yang diizinkan | Hanya penggunaan interaktif di alat pemrograman dan alat agen | Integrasi aplikasi | Integrasi aplikasi, pengelolaan terpadu beberapa model |
| Satuan penagihan | Credits | Yuan/juta Token (berdasarkan wilayah) | Harga satuan Token yang diumumkan di antarmuka harga platform |
| Masa berlaku kuota | Paket dan paket penggunaan berlaku bulanan, hangus saat kedaluwarsa | Penagihan sesuai pemakaian; kuota gratis Beijing 90 hari | Penagihan sesuai pemakaian |
| Antarmuka | Base URL khusus dan kunci API khusus paket | Antarmuka resmi Bailian | Antarmuka kompatibel OpenAI, seperti APIYI apiyi.com |
| Cara verifikasi biaya | Rincian pemotongan Credits aktual di konsol | Dikumpulkan dari rincian Token dan penagihan cache | Dikumpulkan dari kolom usage permintaan dan tagihan platform |
4.2 Langganan Token Plan: cocok untuk pemrograman interaktif di dalam tool
Token Plan mendukung Claude Code, Cursor, Qwen Code, Qoder, Qoder CN, OpenClaw, dan tool lain; ketentuan detailnya mengikuti dokumen integrasi resmi masing-masing tool. Saat pengembang memulai tugas secara aktif di tool tersebut, diskon 8% malam hari dari Preview langsung berlaku, dan biaya juga dikunci di muka dalam bentuk Credits.
Batas penggunaan tertulis dalam spesifikasi izin resmi: tidak boleh memakai skrip otomatis untuk pemanggilan batch, tidak boleh menaruh Key paket di backend aplikasi mandiri, tidak boleh melakukan pemanggilan batch non-interaktif, dan tidak boleh memakai hak paket lewat platform workflow seperti Dify, n8n, Coze, atau alat uji API seperti Postman, Insomnia. Melebihi cakupan tersebut bisa menyebabkan langganan dijeda atau Key diblokir. Selain itu, ketentuan langganan versi personal menyatakan bahwa input dan konten yang dihasilkan selama penggunaan akan dipakai untuk peningkatan layanan dan optimalisasi model; sebelum memproses materi rahasia, periksa dulu perjanjiannya.
4.3 API bayar sesuai pemakaian resmi: cocok untuk integrasi aplikasi versi produksi
Backend aplikasi mandiri, tugas batch, dan alur otomatis sebaiknya menggunakan API bayar sesuai pemakaian qwen4-max versi resmi. Dasar penagihannya adalah harga satuan publik per juta Token dalam yuan; dengan cache eksplisit, biaya bisa diperiksa per permintaan. Jalur ini tidak memiliki diskon besar seperti Credits, tetapi bentuk penggunaan dan cara penagihannya jelas dan sesuai ketentuan.
4.4 Platform agregasi API multi-model: cocok untuk tim yang membutuhkan antarmuka terpadu
Jika aplikasi perlu menggunakan beberapa model sekaligus seperti OpenAI, Claude, dan Gemini, platform agregasi memungkinkan pemanggilan dilakukan dengan satu kunci API dan satu set antarmuka yang kompatibel dengan OpenAI, sekaligus mengelola penggunaan secara terpusat. APIYI adalah salah satu platform semacam ini. Perlu dicatat bahwa artikel di pusat bantuan APIYI tanggal 13 November mencatat Qwen4 belum masuk ke tabel model utama dan endpoint harga, sementara artikel publik tanggal 16 November juga menandai qwen4-max sebagai belum tersedia. Semua ini adalah snapshot pada hari tersebut; untuk status ketersediaan terkini, silakan mengacu pada tabel model utama dan endpoint harga saat ini.
🎯 Saran teknis: Saat membangun aplikasi multi-model, Anda bisa lebih dulu membandingkan performa beberapa model yang sudah tersedia pada tugas Anda menggunakan kode yang sama di APIYI apiyi.com. Setelah model target tersedia, Anda hanya perlu mengubah parameter
modeluntuk beralih.
5 Cara pengembang menghitung biaya aktual Qwen4-Max-Preview dan API
5.1 Kerangka Perhitungan Biaya per Tugas Qwen4-Max
Harga satuan model yang murah tidak otomatis membuat biaya total untuk menyelesaikan satu tugas menjadi murah. Satu tugas Agent bisa mencakup puluhan permintaan, konteks berulang dalam jumlah besar, output pemikiran yang panjang, dan percobaan ulang yang gagal. Saat membandingkan opsi, gunakan “menyelesaikan tujuan yang sama” sebagai unit, lalu kumpulkan biaya berdasarkan rincian penagihan masing-masing produk:
| Item biaya | Cara perhitungan API bayar sesuai penggunaan | Cara pencatatan skema Credits |
|---|---|---|
| Input tanpa cache | Jumlah input tanpa cache × harga satuan input yang sesuai | Langsung mencatat Credits yang benar-benar dipotong di konsol |
| Cache | Biaya baca, tulis, dan penyimpanan cache, dihitung berdasarkan aturan wilayah yang sesuai | Sudah termasuk dalam pemotongan aktual |
| Output | Jumlah output (termasuk Token pemikiran yang ditagih) × harga satuan output | Sudah termasuk dalam pemotongan aktual |
| Alat dan percobaan ulang | Biaya pemanggilan alat + seluruh konsumsi permintaan percobaan ulang | Sudah termasuk dalam pemotongan aktual |
Jika ditulis sebagai rumus: Biaya tugas = jumlah input tanpa cache × harga input + biaya baca/tulis dan penyimpanan cache + jumlah output (termasuk pemikiran yang ditagih) × harga output + biaya alat/percobaan ulang dan sebagainya. Skema Credits tidak melakukan konversi Token, melainkan langsung mencatat selisih saldo Credits pada awal dan akhir tugas. Karena satuan kedua hasil berbeda, saat membandingkan sebaiknya evaluasi secara terpisah “berapa yuan yang dihabiskan per tugas” dan “berapa Credits yang dipotong per tugas”, lalu padukan dengan biaya langganan bulanan paket untuk menilai nilai terbaiknya.
5.2 Mencatat penggunaan Token setiap permintaan dengan kode
Verifikasi skema bayar sesuai pemakaian bergantung pada field usage yang dikembalikan setiap permintaan. Contoh minimal berikut menunjukkan cara membaca penggunaan pada antarmuka yang kompatibel dengan OpenAI. Ganti ID model dengan model yang sudah tersedia di daftar model platform:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # antarmuka kompatibel OpenAI APIYI
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_ID",  # gunakan model yang sudah tersedia di daftar model platform
    messages=[{"role": "user", "content": "总结这段日志中的错误类型"}],
)
print(resp.usage)  # catat prompt_tokens / completion_tokens, dll., untuk pengelompokan biaya
Lihat kode lengkap untuk mengelompokkan biaya per tugas
import openai
from dataclasses import dataclass, field

@dataclass
class TaskLedger:
    """Mengelompokkan penggunaan Token per tugas; harga satuan diteruskan oleh pemanggil sesuai produk dan wilayah yang dipilih"""
    input_price_per_m: float          # yuan/juta Token, input tanpa cache
    output_price_per_m: float         # yuan/juta Token, output (termasuk penalaran)
    cache_cost: float = 0.0           # biaya baca/tulis cache dan penyimpanan, diisi manual sesuai rincian
    tool_cost: float = 0.0            # biaya pemanggilan alat
    records: list = field(default_factory=list)

    def add(self, usage):
        cached = 0
        details = getattr(usage, "prompt_tokens_details", None)
        if details is not None:
            cached = getattr(details, "cached_tokens", 0) or 0
        self.records.append({
            "uncached_input": usage.prompt_tokens - cached,
            "output": usage.completion_tokens,
        })

    def total(self) -> float:
        inp = sum(r["uncached_input"] for r in self.records)
        out = sum(r["output"] for r in self.records)
        return (inp / 1e6 * self.input_price_per_m
                + out / 1e6 * self.output_price_per_m
                + self.cache_cost + self.tool_cost)

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# isi harga satuan sesuai produk dan wilayah yang sebenarnya dipilih
ledger = TaskLedger(input_price_per_m=0.0, output_price_per_m=0.0)

for attempt in range(3):  # konsumsi dari percobaan ulang juga ikut dihitung dalam biaya tugas
    resp = client.chat.completions.create(
        model="YOUR_MODEL_ID",
        messages=[{"role": "user", "content": "修复 query.py 中的分页错误"}],
    )
    ledger.add(resp.usage)
    if resp.choices[0].finish_reason == "stop":
        break

print(f"本任务请求数: {len(ledger.records)},合计成本: {ledger.total():.4f} 元")
5.3 Perhitungan hipotetis: satu tugas Agent di region Beijing versi resmi
Berikut adalah perhitungan hipotetis; angka hanya untuk mendemonstrasikan rumus. Misalkan satu tugas dipanggil dengan Qwen4-Max versi resmi di region Beijing secara bayar sesuai pemakaian, dengan total input tanpa cache 2,000,000 Tokens dan output (termasuk thinking) 50,000 Tokens, tanpa menggunakan cache dan alat penagihan:
- Input: 2 × 10 yuan = 20 yuan
- Output: 0.05 × 30 yuan = 1.5 yuan
- Total: 21.5 yuan
Hasil ini menunjukkan bahwa biaya tugas Agent dengan konteks panjang terutama berasal dari input yang dikirim berulang. Jika petunjuk sistem dan deskripsi alat yang tetap di dalamnya diubah menjadi cache eksplisit, struktur bagian input akan berubah; berapa besar penghematan yang bisa diperoleh bergantung pada rasio cache hit dan harga satuan cache di region terkait. Untuk tugas yang sama dalam paket Credits, catat langsung jumlah pemotongan aktual; jangan menggunakan 21.5 yuan ini untuk mengonversi ke Credits.
💰 Pemeriksaan biaya: Jika bisnis perlu membandingkan biaya per tugas dari beberapa model yang sudah tersedia untuk tugas yang sama, Anda dapat membaca usage tiap model melalui antarmuka terpadu APIYI apiyi.com, lalu mengumpulkannya dengan TaskLedger di atas menggunakan basis yang sama.
6 Cara memilih skema pemanggilan pada periode Qwen4-Max-Preview
6.1 Pemrograman interaktif: gunakan Token Plan pada jendela malam untuk menangani tugas panjang
Jika sebagian besar pekerjaan menulis kode dilakukan di alat seperti Claude Code, Cursor, dan Qoder, promo Token Plan dan Preview paling cocok. Langkah praktisnya:
- Jadwalkan tugas interaktif yang membutuhkan konteks besar dan thinking panjang antara 22:00 dan 08:00, lalu mulai dan pantau sendiri di dalam alat, misalnya memahami basis kode, debugging lintas modul, dan analisis dokumen panjang.
- Sisihkan anggaran output untuk konten thinking; 393,216 Tokens pada Preview dibagi antara thinking dan jawaban.
- Catat saldo Credits di awal dan akhir setiap tugas untuk mengumpulkan data konsumsi per tugas Anda sendiri.
- Saat pembelian pertama, bandingkan dua tingkat harga pengguna baru, Lite 19.5 yuan dan Essential 39.5 yuan; promo berlaku hingga 30 November.
- Sebelum 25 November, jalankan tugas-tugas umum dengan
qwen4-maxversi resmi untuk memastikan batas output dan pengaturan intensitas reasoning.
6.2 Aplikasi mandiri dan bisnis otomasi: pilih API bayar sesuai pemakaian atau platform agregator
Layanan backend, tugas terjadwal, pemrosesan data batch, dan integrasi platform workflow semuanya termasuk dalam cakupan batasan Token Plan versi personal; sebaiknya pilih API bayar sesuai pemakaian yang mengizinkan pemanggilan backend komersial. Jika hanya menggunakan model seri Tongyi, Anda dapat langsung terhubung ke API Qwen4-Max versi resmi dengan skema bayar sesuai pemakaian, dan memanfaatkan cache eksplisit untuk mengendalikan biaya input. Jika aplikasi perlu menggabungkan beberapa model, gunakan platform agregator API untuk menyatukan antarmuka dan tagihan.
💡 Saran pemilihan: Saluran integrasi harus mengikuti status ketersediaan aktual model. Jika model target sudah tersedia di APIYI apiyi.com, Anda dapat memanggilnya langsung melalui antarmuka terpadu; jika belum tersedia, selesaikan dulu pengembangan alur integrasi dan perhitungan biaya di platform menggunakan model yang sudah tersedia, lalu ganti parameter
modelsetelah model tersebut tersedia.
6.3 Panduan cepat keputusan Qwen4-Max-Preview
- Pengembang individu yang terutama berinteraksi di dalam alat pemrograman: Token Plan ditambah jendela malam Preview; setelah 25 November beralih ke
qwen4-maxversi resmi. - Tim yang mengembangkan aplikasi mandiri: API bayar sesuai pemakaian versi resmi, pilih harga satuan berdasarkan region, aktifkan cache eksplisit.
- Aplikasi multi-model atau tahap pemilihan model: platform agregator API multi-model, antarmuka terpadu, kumpulkan biaya per tugas.
- Menangani data konfidensial: periksa dulu ketentuan penggunaan data produk terkait, lalu tentukan cara integrasi.
7 Ringkasan: Cara tepat memakai jendela 8% Credits Qwen4-Max-Preview
Credits 8% malam hari Qwen4-Max-Preview adalah promo waktu terbatas di dalam Token Plan, berlaku sampai 25 November pukul 24.00, dan ditujukan untuk penggunaan interaktif di alat pemrograman serta alat agen. Versi resmi Qwen4-Max sudah diluncurkan pada 16 November, dengan harga bayar sesuai pemakaian di wilayah Beijing sebesar 10 yuan untuk input dan 30 yuan per juta Token untuk output — cocok untuk backend aplikasi dan bisnis otomatis. Credits dan Token adalah dua sistem pengukuran yang berbeda, jadi saat membandingkan biaya, patokannya harus per unit tugas: catat terpisah potongan Credits dan jumlah yang dihitung berdasarkan Token.
Saat mengambil keputusan, ikuti urutan ini: pertama tentukan apakah tugasnya berupa interaksi di dalam alat atau pemanggilan backend, lalu tentukan produk yang sesuai ketentuan, dan terakhir uji biaya nyata dengan tugas yang sama. Kalau perlu membandingkan hasil dan biaya di antara beberapa model yang sudah tersedia, verifikasi bisa dilakukan dengan cepat lewat antarmuka terpadu APIYI apiyi.com.
📚 Referensi
-
Dokumentasi resmi Qwen4-Max-Preview: spesifikasi model, waktu ketersediaan, dan cara akses
- Tautan:
help.aliyun.com/zh/model-studio/qwen4-max-preview - Keterangan: anggaran output, parameter thinking, Base URL khusus
- Tautan:
-
Dokumentasi resmi Qwen4-Max versi rilis: harga bayar sesuai pemakaian dan cache eksplisit
- Tautan:
help.aliyun.com/zh/model-studio/qwen4-max - Keterangan: harga satuan per wilayah, batas maksimum output, TTL cache
- Tautan:
-
Langganan dan hak Token Plan versi personal: harga paket, Credits, dan promo waktu terbatas
- Tautan:
help.aliyun.com/zh/model-studio/token-plan-personal-overview - Keterangan: aturan diskon 2折 (cukup bayar 20%) dan diskon malam 4折 (bayar 40%), harga pengguna baru, paket kuota pemakaian
- Tautan:
-
Izin dan ketentuan penggunaan Token Plan: skenario penggunaan yang diizinkan dan dilarang
- Tautan:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - Keterangan: cakupan penggunaan interaktif dan konsekuensi pelanggaran
- Tautan:
-
Pemakaian dan kuota Token Plan: mekanisme konsumsi Credits
- Tautan:
help.aliyun.com/zh/model-studio/token-plan-usage-quota - Keterangan: berbagai faktor yang memengaruhi konsumsi Credits
- Tautan:
-
Pembaruan fitur Token Plan: catatan peluncuran versi Preview dan versi resmi
- Tautan:
help.aliyun.com/zh/model-studio/token-plan-product-updates - Keterangan: peristiwa versi pada 11 November dan 16 November
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami lewat halaman utama APIYI apiyi.com; materi integrasi lainnya tersedia di pusat dokumentasi docs.apiyi.com