要約:本記事では、Qwen4-Max-Previewの夜間8% Credits割引を解説し、利用範囲・課金単位・タスク総コストの3つの観点から、Token Planのサブスクリプションプラン、正式版の従量課金API、マルチモデルAPIアグリゲーションプラットフォームを比較します。
Qwen4-Max-Preview 8% Credits の結論を先に
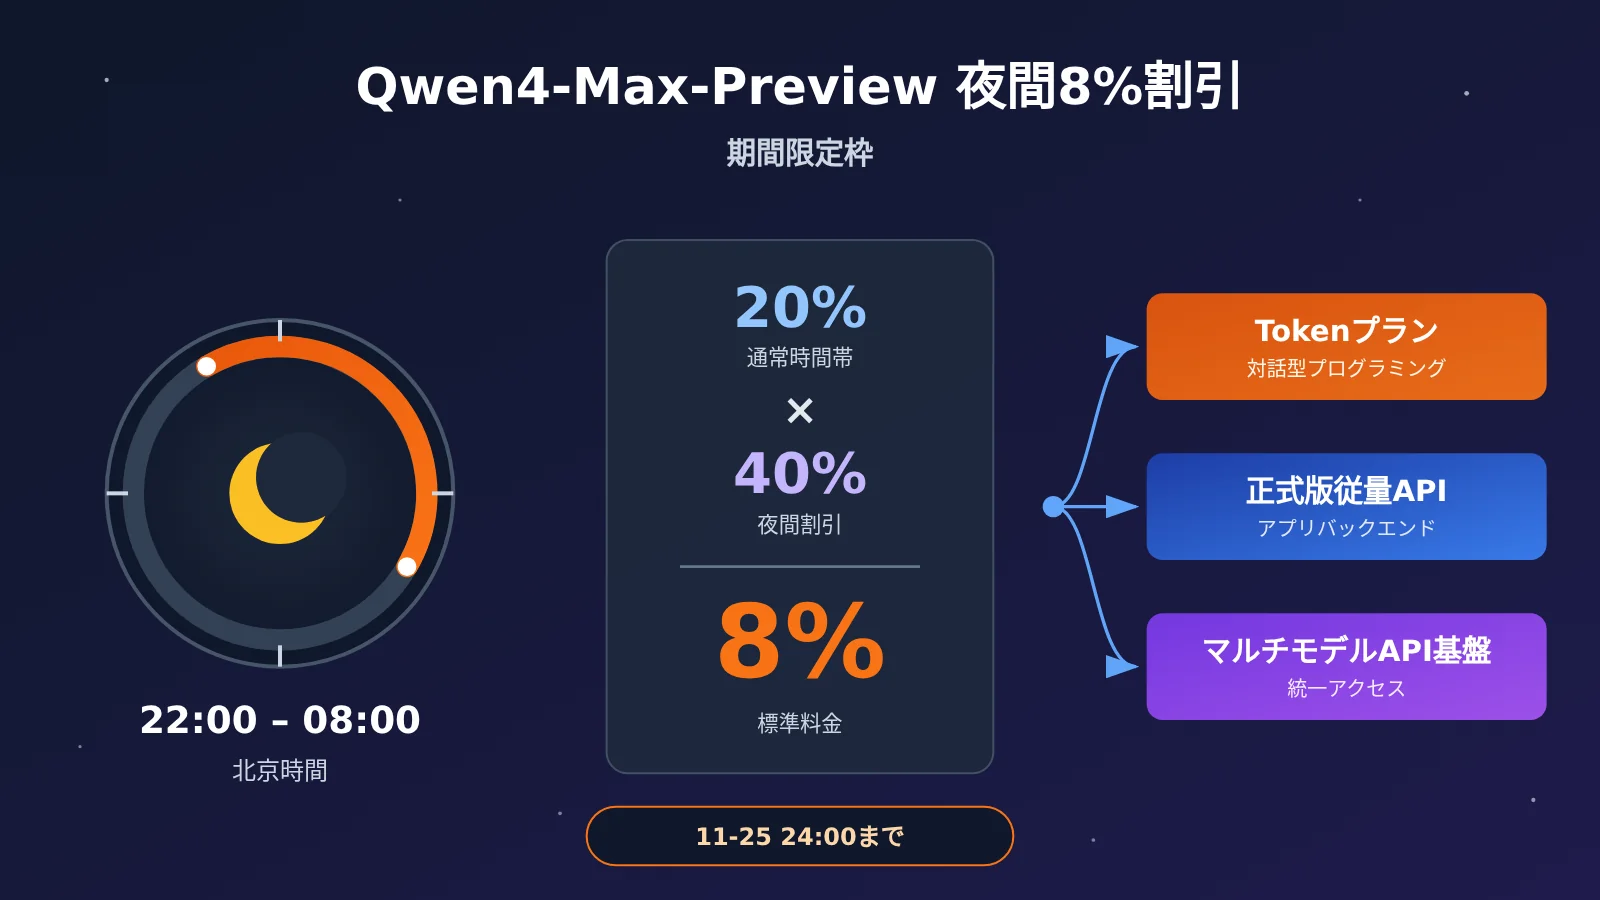
Token PlanでQwen4-Max-Previewを呼び出す場合、北京時間の毎晩22:00から翌日08:00までのCredits消費は標準料金の8%となります。この比率は、通常時間帯の2割(20%)と夜間の追加4割(40%)を掛け合わせたものです。割引はPreviewの提供終了、すなわち2026年11月25日24:00(北京時間)まで適用され、その後このモデルは提供終了となります。
この割引はToken Planが許可する利用シーン、つまりコーディングツールやエージェントツールでの対話的な利用にのみ適用されます。モデルを自社アプリのバックエンドや自動化業務に組み込む場合は、そうした用途を許可する従量課金API製品を選ぶ必要があります。11月16日にリリースされたQwen4-Max正式版は独立した従量課金価格を提供しており、こうしたニーズに対応できます。
以下ではまず、8%の計算方法とToken Planのプラン料金を分解し、続いて正式版の従量課金の基準とキャッシュの仕組みを説明します。その後、適用タスク・利用形態・課金単位・インターフェースの4つの観点から3種類の呼び出し方法を比較し、タスク別にコストを集計する計算フレームワークを示します。最後に、開発者の実際のタスク種別に応じた選択の指針を示します。
知っておきたい:Qwen4-Max-Previewの課金関連用語
| 用語 | 説明 |
|---|---|
| Credits | Token Planサブスクリプションプランで利用量に充当する単位。消費量は、使用するモデルと今回の呼び出しの具体的な構成によって決まります |
| Token | モデルの入力、出力、および思考内容の計量単位 |
| Token Plan | アリババクラウドがサブスクリプション期間ごとにCredits特典を付与する製品で、個人版とチーム版があります |
| 従量課金API | 実際の呼び出し量に応じて課金する、アプリケーション連携向けのモデルサービス方式 |
| キャッシュヒット | 繰り返し送信された入力がサーバー側で再利用され、キャッシュに対応する課金ルールに従って計算されます |
| 思考Token | モデルの推論過程で生成されるToken。出力予算を消費し、出力課金に含まれます |
| APIアグリゲーションプラットフォーム | 単一の統一インターフェースで、多様なモデルの呼び出しと利用量管理を提供するサービス |
| タスクあたりのコスト | 同じ目標を達成するために必要なすべてのリクエスト、リトライ、ツール呼び出し、モデル消費の合計 |
1 Qwen4-Max-Previewの「0.8折」(標準料金8%)はどう生まれるか
1.1 2層の割引が重なる:20% × 40% = 8%
Previewキャンペーン期間中、Token PlanはQwen4-Max-Previewに対して2段階のCredits優待を設定しています:
- 通常時間帯:Credits消費量は標準料金の20%、つまり標準料金の2割(20%)です。同じCredits予算で、理論上は標準料金時の約5倍の呼び出し量をこなせます。
- 夜間時間帯:北京時間の毎日22:00から翌日08:00まで、標準料金の2割に対してさらに4割(40%)を適用します。
- 重ね合わせの結果:20% × 40% = 8%、つまり標準料金の8%(0.8折、実質92%オフ)です。
公式側は割合の例を1つ示しています。ある呼び出しが標準料金で100 Creditsを消費する場合、通常時間帯は実際に20 Credits、夜間時間帯は実際に8 Creditsを消費します。これは割合を示すための数学的な例にすぎません。1回の呼び出しで実際にどれだけ消費するかは、コンソールの利用明細を基準にしてください。公式側は運用状況に応じて優待内容を調整する権利も留保しています。
1.2 Qwen4-Max-Previewの期間限定ウィンドウの時間範囲
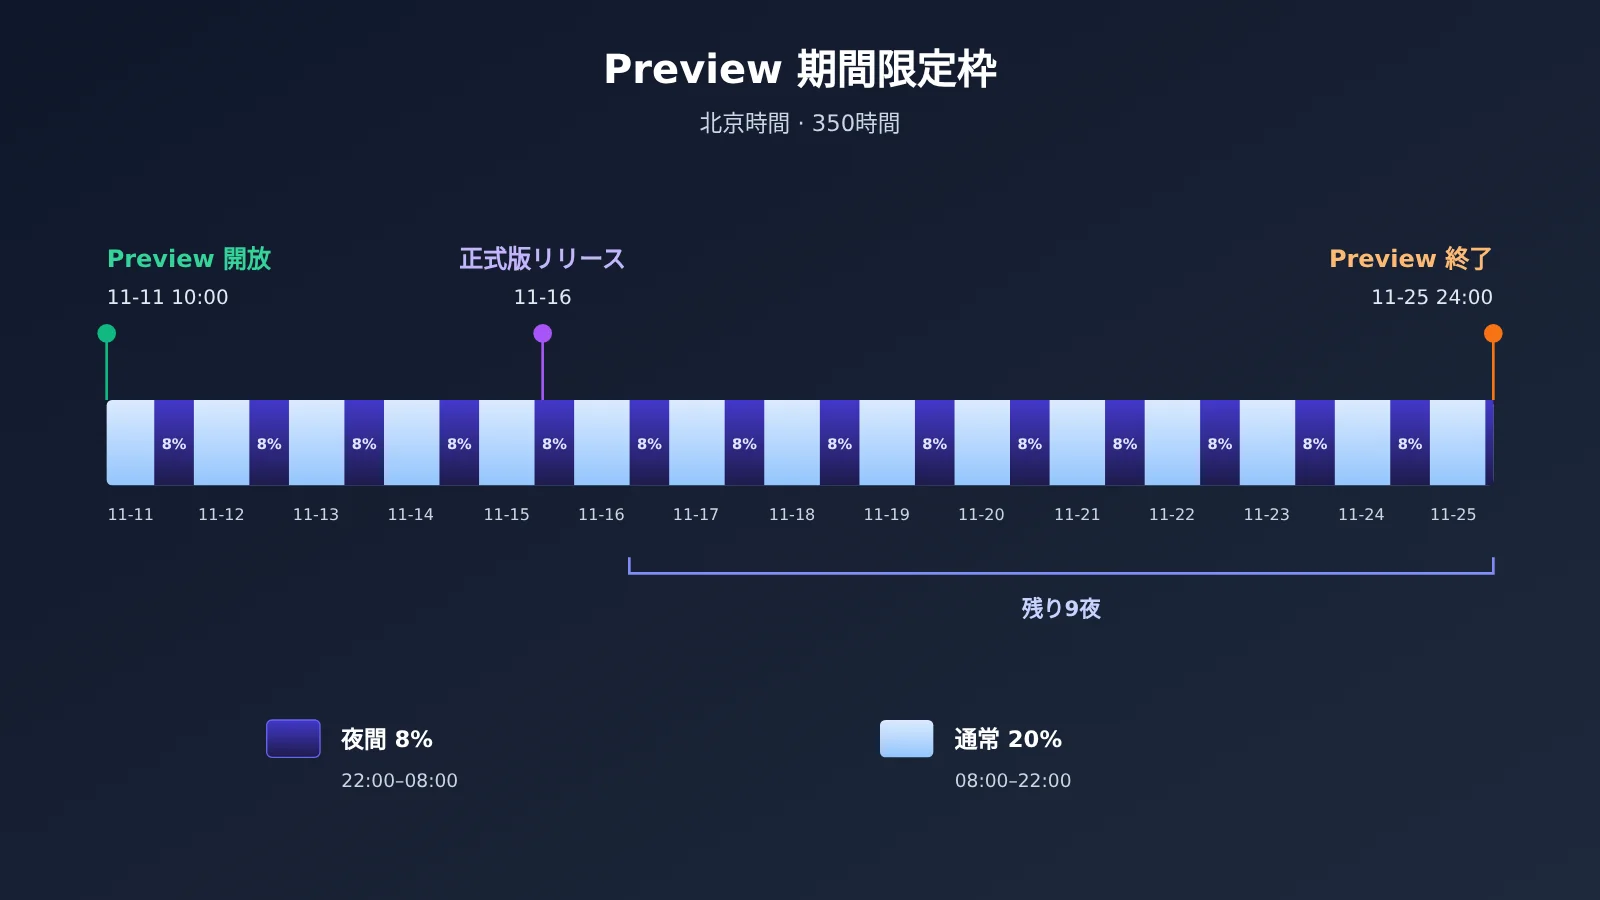
Previewは2026年11月11日10:00に開放され、11月25日24:00に終了します(いずれも北京時間)。合計350時間です。本日11月16日を基準に数えると、残りの完全な夜間時間帯は11月16日の夜から11月25日の朝までの9晩です。11月25日当日の夜間時間帯は22:00から24:00までの2時間だけです。その後、Previewは提供を終了します。
11月16日に正式版Qwen4-Maxが提供開始された後も、Previewの提供終了日時は変わりません。公式のモデルドキュメントでは正式版の利用が推奨されているため、Previewの提供期間内で構築したワークフローは、並行してqwen4-maxへの移行準備を進めておくべきです。
2 Token Plan の Credits はどのように購入し、どのように消費されるのか
2.1 Token Plan 個人版プランの価格と利用枠
2026年11月16日時点で、Alibaba Cloud Token Plan 個人版の公式ページに公開されているプランは以下のとおりです。月間利用枠と価格は11月9日に調整されており、それ以前のスクリーンショットや記事に掲載された価格は適用されません。
| プラン | 月額料金 | 月間 Credits | 同時実行エージェント数 | 新規ユーザー価格 |
|---|---|---|---|---|
| Lite | 39 元 | 20,000 | 1–2 | 19.5 元/月 |
| Essential | 79 元 | 45,000 | 2–3 | 39.5 元/月 |
| Standard | 139 元 | 80,000 | 3–4 | 新規ユーザー優待の記載なし |
| Pro | 312 元 | 200,000 | 6–8 | 新規ユーザー優待の記載なし |
新規ユーザー価格は2026年11月30日 23:59:59(UTC+8)まで有効で、過去に Token Plan 個人版を購入したことがないアカウントに限られます。新規ユーザー優待はプランのサブスクリプション価格を下げるものです。一方、Preview の「2折」(80%オフ)と「0.8折」(92%オフ)は、モデル呼び出し時の Credits 消費を低減するもので、両者は異なる段階で作用します。
2.2 Token Plan 追加用量パッケージのルール
プランの利用枠を使い切った後、追加用量パッケージを購入できます。ルールは以下のとおりです。
- 価格は1個あたり月額100元で、1パッケージあたり20,000 Credits です。
- 有効なプランを保有している必要があり、同時に最大5個まで保有できます。
- 有効期間は1か月で、使い切れなかった枠は期限切れで失効します。
- 用量パッケージの枠は、プラン本来の月間利用枠とは独立しています。
2.3 Credits と Token の計量関係
Credits は Token Plan の利用枠を消費するための単位、Token はモデルの計算単位であり、両者を1対1で換算することはできません。公式説明によると、1回の呼び出しで消費される Credits は次の要素によって決まります。
- モデルの種類とその課金係数
- 入力 Token 数と、そのうちキャッシュヒットした Token 数
- 出力 Token 数(思考 Token を含む)
- ツール呼び出し回数、および組み込みツールやサブタスクによる追加呼び出し
したがって、39元と20,000 Credits から Qwen4-Max-Preview の100万 Token あたりの単価を算出することはできません。公式は Preview 単独の100万 Token あたりの料金を公表しておらず、Preview の従量課金にも対応していません。参考にできる実績として、ある開発者が Qoder でクレーンゲームのインタラクティブプロジェクトを完成させ、所要時間は約75分、消費量は約65 Credits と見積もられています。これは特定のツールにおける単一タスクの記録であり、消費量の目安を把握するためのものです。
3 Qwen4-Max-Preview と正式版の課金方式の比較
3.1 Preview:Token Plan 専用の接続のみ
Preview の接続方法は決まっています。Token Plan の個人版またはチーム版を購読して、プラン専用の APIキーを取得し、専用の Base URL https://token-plan.cn-beijing.maas.aliyuncs.com を使用し、モデル ID を qwen4-max-preview(別名 qwen4.0-max-preview、請求書上は後者で統一表示)に設定します。OpenAI Chat Completions、Responses、Anthropic Messages の各インターフェース仕様に対応しています。
Preview の出力予算は 393,216 トークンで、思考内容と最終回答で共有され、デフォルトの推論強度は xhigh です。他のモデルから移行する際、最終回答の長さだけを見て max_tokens を設定すると、思考内容が予算を埋めてしまい回答が途中で打ち切られる可能性があります。
3.2 正式版 Qwen4-Max:従量課金 API の価格
正式版 qwen4-max は 11 月 16 日にリリースされました。Token Plan で利用できるほか、従量課金で呼び出すこともできます。以下は公式モデルページに掲載されている正式版の従量課金価格です(人民元、単位は元/100万トークン):
| デプロイ地域 | 入力 | 出力(思考および回答を含む) |
|---|---|---|
| 中国本土 華北2(北京) | 10 元 | 30 元 |
| 米国バージニア | 10 元 | 30 元 |
| ドイツ・フランクフルト | 10 元 | 30 元 |
| 日本・東京 | 10 元 | 30 元 |
| 中国香港 | 10 元 | 30 元 |
| シンガポール | 10.938 元 | 32.813 元 |
北京地域には別途 100 万トークンの無料枠があり、百炼の開通、モデルのリリース、申請の承認などの起算時点から 90 日間有効です。詳細は公式ページの規約に準じます。これらの価格は正式版にのみ適用され、Preview の標準 Credits 消費量を逆算するのには使えません。
正式版のパラメータも Preview とは異なります。コンテキストは同じく 1,000,000 トークンですが、最大出力は思考モードで 262,144 トークン、非思考モードで 131,072 トークンです。デフォルトの推論強度は high、デフォルトの思考予算は 131,072 です。移行の際は出力上限の設定を再確認する必要があります。
3.3 正式版 Qwen4-Max の明示的キャッシュ機構
正式版は明示的キャッシュに対応しており、システムプロンプト、ツールの説明、参照ドキュメントなど、固定された入力プレフィックスを再利用できます。明示的キャッシュは OpenAI Chat Completions、Responses、Anthropic Messages の 3 種類のインターフェースに対応し、TTL は 5 分または 1 時間から選択できます。
マルチターンの Agent タスクでは、通常、毎ターン同じシステム指示とツール記述を繰り返し送信します。ここがキャッシュによるコスト削減が最も効果を発揮するポイントです。キャッシュには独自の課金ルールがあり、具体的な単価は該当地域のモデル呼び出し課金ページをご確認ください。
4 Qwen4-Max-Preview の3つの呼び出し方式は、それぞれ誰に適しているか
4.1 3つの方式の比較
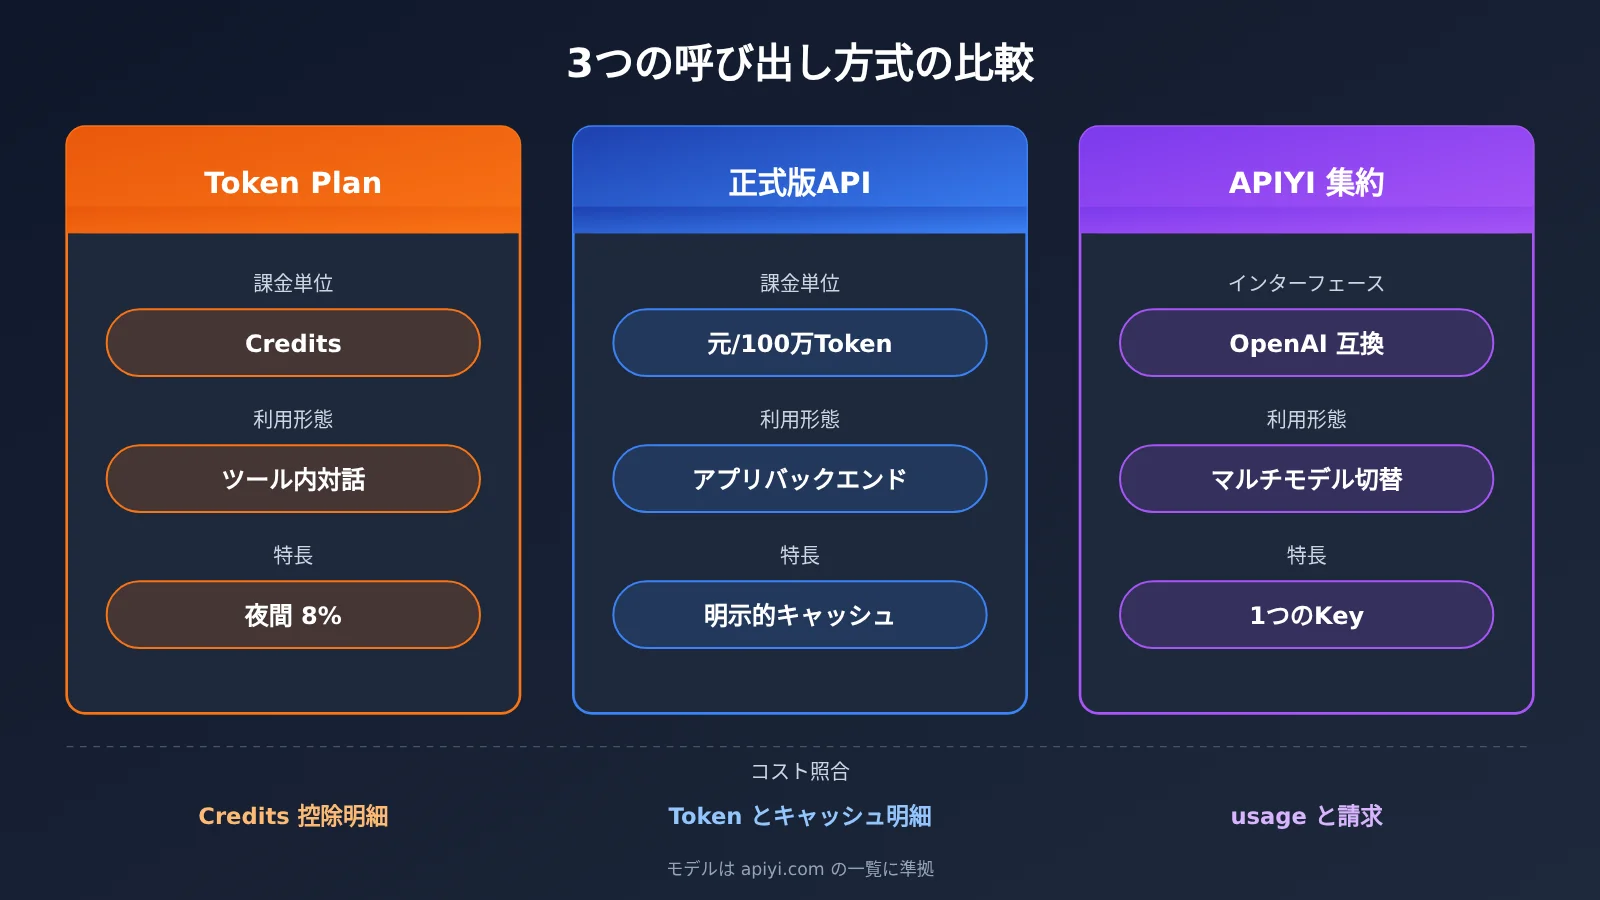
| 観点 | Token Plan サブスクリプション | 正式版の従量課金API | マルチモデルAPIアグリゲーションプラットフォーム |
|---|---|---|---|
| 適するタスク | 対話型プログラミング、Agent 対話 | 自社構築アプリケーションバックエンド、自動化業務 | マルチモデルアプリ、モデル比較と切り替え |
| 許可される利用形態 | プログラミングツールおよびエージェントツール内での対話型利用に限定 | アプリケーション連携 | アプリケーション連携、複数モデルの一元管理 |
| 課金単位 | Credits | 元/百万Token(地域別) | プラットフォームの価格APIで公表されたToken単価 |
| クォータの有効期限 | プランと利用量パックは月単位、期限切れで失効 | 従量精算;北京の無料枠は90日 | 従量精算 |
| インターフェース | 専用Base URLとプラン専用キー | 百炼公式インターフェース | OpenAI互換インターフェース(例:APIYI apiyi.com) |
| コスト確認方法 | コンソールのCredits実際の控除明細 | Token明細とキャッシュ課金による集計 | リクエストのusageフィールドとプラットフォーム請求による集計 |
4.2 Token Plan サブスクリプション:ツール内のインタラクティブなプログラミングに適する
Token Plan は Claude Code、Cursor、Qwen Code、Qoder、Qoder CN、OpenClaw などのツールに対応しています。詳細は公式のツール接続ドキュメントに従ってください。開発者がこれらのツール内で自らタスクを開始すると、Preview の夜間 8% 割引がそのまま適用され、コストも Credits の形で事前に固定されます。
利用範囲は公式の権限仕様に記載されています。自動化スクリプトによる一括呼び出しはできません。プラン用 Key を自社アプリケーションのバックエンドに組み込むことはできません。非対話型の一括呼び出しもできません。また、Dify、n8n、Coze などのワークフロープラットフォームや、Postman、Insomnia などの API テストツールを通じてプランの権益を不正に使用することもできません。範囲を超えると、サブスクリプションの一時停止や Key の利用停止につながる可能性があります。さらに、個人版サブスクリプションの注意事項では、利用期間中の入力および生成コンテンツがサービス改善とモデル最適化に使用されると規定されています。機密資料を扱う前に、契約内容を確認する必要があります。
4.3 公式の従量課金 API:正式版アプリケーションの接続に適する
自社アプリケーションのバックエンド、バッチタスク、自動化フローでは、正式版 qwen4-max の従量課金 API を使用すべきです。課金基準は公開されている元/百万 Token の単価で、明示的キャッシュと組み合わせることで、コストをリクエストごとに個別に確認できます。この経路には Credits のような大幅な割引はありませんが、利用形態と課金方法はどちらも明確でコンプライアントです。
4.4 マルチモデルAPI集約プラットフォーム:統一インターフェースを必要とするチームに最適
アプリケーションで OpenAI、Claude、Gemini など複数のモデルを同時に利用する場合、集約プラットフォームを使えば、1つのAPIキーとOpenAI互換インターフェースだけで呼び出しを完結でき、使用量も一元管理できます。APIYI はこうしたプラットフォームのひとつです。なお、APIYI ヘルプセンターの11月13日の記事では、Qwen4 がまだモデル一覧表と価格インターフェースに含まれていないことが記録されており、11月16日の公開記事でも qwen4-max は未提供とされていました。いずれもその時点でのスナップショットですので、現在提供されているかどうかは、最新のモデル一覧表と価格インターフェースでご確認ください。
🎯 技術的なヒント:マルチモデルアプリを構築する際は、まず APIYI apiyi.com 上で同じコードを使い、すでに提供されている複数のモデルがご自身のタスクでどれだけ性能を発揮するかを比較してみてください。目的のモデルが提供開始されたら、
modelパラメータを変更するだけで切り替えられます。
5 開発者が Qwen4-Max-Preview と API の実際のコストを計算する方法
5.1 Qwen4-Max のタスクあたりコスト計算フレームワーク
モデルの単価が安くても、1つのタスクを完了するまでの総コストが安いとは限りません。1つの Agent タスクには、数十回のリクエスト、大量の重複コンテキスト、長めの思考出力、失敗時のリトライが含まれることがあります。プランを比較する際は、「同じ目標を達成すること」を単位とし、各製品の課金明細に基づいてコストを集計します。
| コスト項目 | 従量課金 API での計算方法 | Credits プランでの記録方法 |
|---|---|---|
| 未キャッシュ入力 | 未キャッシュ入力量 × 該当する入力単価 | コンソールで実際に差し引かれた Credits をそのまま記録 |
| キャッシュ | キャッシュの読み取り、書き込み、保存費用を該当リージョンの規則に従って計算 | 実際の差し引き額に含まれる |
| 出力 | 出力量(課金対象の思考トークンを含む)× 出力単価 | 実際の差し引き額に含まれる |
| ツールとリトライ | ツール呼び出し費用 + リトライリクエストの全消費量 | 実際の差し引き額に含まれる |
式に表すと、次のようになります。タスクコスト = 未キャッシュ入力量 × 入力単価 + キャッシュ読み取り/書き込みおよび保存費用 + 出力(課金対象の思考を含む)量 × 出力単価 + ツール/リトライなどの費用。Credits プランではトークン換算を行わず、タスク開始時と終了時の Credits 残高の差をそのまま記録します。この2種類の結果は単位が異なるため、比較する際は「1タスクあたり何元かかったか」と「1タスクあたり何 Credits 差し引かれたか」をそれぞれ評価し、さらにプランの月額料金を踏まえてコストパフォーマンスを判断します。
5.2 コードでリクエストごとの Token 使用量を記録する
従量課金プランの突合は、各リクエストが返す usage フィールドに依存します。以下のおおよその最小構成サンプルでは、OpenAI 互換インターフェースで使用量を読み取る方法を示しています。モデル ID は、プラットフォームのモデル一覧に登録済みのモデル名に置き換えてください:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の OpenAI 互換インターフェース
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_ID",  # プラットフォームのモデル一覧に登録済みのモデルIDを指定
    messages=[{"role": "user", "content": "总结这段日志中的错误类型"}],
)
print(resp.usage)  # prompt_tokens / completion_tokens などを記録し、コスト按分に利用
タスク別にコストを集計する完全なコードを見る
import openai
from dataclasses import dataclass, field

@dataclass
class TaskLedger:
    """タスクごとに Token 使用量を集計する。単価は呼び出し元が選択した製品と地域に応じて渡す"""
    input_price_per_m: float          # 元/100万 Token、未キャッシュ入力
    output_price_per_m: float         # 元/100万 Token、出力(思考を含む)
    cache_cost: float = 0.0           # キャッシュの読み書きおよび保存費用、明細に基づき手動で入力
    tool_cost: float = 0.0            # ツール呼び出し費用
    records: list = field(default_factory=list)

    def add(self, usage):
        cached = 0
        details = getattr(usage, "prompt_tokens_details", None)
        if details is not None:
            cached = getattr(details, "cached_tokens", 0) or 0
        self.records.append({
            "uncached_input": usage.prompt_tokens - cached,
            "output": usage.completion_tokens,
        })

    def total(self) -> float:
        inp = sum(r["uncached_input"] for r in self.records)
        out = sum(r["output"] for r in self.records)
        return (inp / 1e6 * self.input_price_per_m
                + out / 1e6 * self.output_price_per_m
                + self.cache_cost + self.tool_cost)

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 単価は実際に選択した製品と地域に合わせて記入してください
ledger = TaskLedger(input_price_per_m=0.0, output_price_per_m=0.0)

for attempt in range(3):  # リトライで発生した消費も同様にタスクコストに計上する
    resp = client.chat.completions.create(
        model="YOUR_MODEL_ID",
        messages=[{"role": "user", "content": "修复 query.py 中的分页错误"}],
    )
    ledger.add(resp.usage)
    if resp.choices[0].finish_reason == "stop":
        break

print(f"本任务请求数: {len(ledger.records)},合计成本: {ledger.total():.4f} 元")
5.3 仮想計算:正式版の北京リージョンにおける1つのAgentタスク
以下は仮想の計算であり、数値は計算式を示すための例にすぎません。 あるタスクが正式版Qwen4-Maxの北京リージョンで従量課金により呼び出され、キャッシュされていない入力が累計2,000,000 Tokens、出力(思考を含む)が50,000 Tokensで、キャッシュと課金ツールを使用しない場合を仮定します:
- 入力:2 × 10元 = 20元
- 出力:0.05 × 30元 = 1.5元
- 合計:21.5元
この結果が示すのは、長いコンテキストを持つAgentタスクのコストは主に、繰り返し送信される入力に由来するということです。そのうち固定的なシステムプロンプトとツール説明を明示的キャッシュに変更すると、入力部分の構造が変わります。どれだけ節約できるかは、キャッシュヒット率と該当リージョンのキャッシュ単価によって決まります。Creditsプランでの同一タスクについては、実際の控除量をそのまま記録してください。この21.5元を使ってCreditsに換算しないでください。
💰 コスト照合:複数の公開済みモデルを同一タスク上で単位タスクコストとして同時に比較する必要がある場合は、APIYI apiyi.com の統一インターフェースから各モデルのusageを読み取り、上記のTaskLedgerで同じ基準に基づいて集計できます。
6 Qwen4-Max-Preview期の呼び出しプランをどう選ぶか
6.1 インタラクティブプログラミング:夜間ウィンドウでToken Planを使って長いタスクを処理する
主にClaude Code、Cursor、Qoderなどのツールでコードを書く場合、Token PlanとPreviewの割引が最もよく合います。具体的な方法は次のとおりです:
- 大きなコンテキストや長い思考を必要とするインタラクティブなタスクを22:00から08:00の間に配置し、本人がツール内で起動してフォローします。たとえばコードベースの理解、モジュールをまたぐデバッグ、長いドキュメントの分析などです。
- 思考内容のために出力予算を確保しておきます。Previewの393,216 Tokensは思考と回答で共有されます。
- 各タスクの開始時と終了時にCredits残高を記録し、自分自身の単位タスク消費データを蓄積します。
- 初回購入時にはLite 19.5元とEssential 39.5元の2つの新規ユーザー価格を比較してください。割引は11月30日までです。
- 11月25日より前に、正式版
qwen4-maxでよく使うタスクを一通り実行し、出力上限と推論の強さの設定を確認します。
6.2 自社アプリケーションと自動化業務:従量課金APIまたは集約プラットフォームを選ぶ
バックエンドサービス、定期実行タスク、一括データ処理、ワークフロープラットフォームの接続は、いずれもToken Plan個人版の制限範囲に該当するため、商用バックエンドからの呼び出しを許可する従量課金APIを選ぶべきです。通義シリーズのモデルだけを使う場合は、正式版Qwen4-Maxの公式従量課金APIに直接接続し、明示的キャッシュを利用して入力コストを制御できます。アプリケーションが複数社のモデルを組み合わせる必要がある場合は、API集約プラットフォームの統一インターフェースと請求を利用できます。
💡 選択のヒント:接続チャネルはモデルの実際の利用可能状況を基準にすべきです。対象モデルがすでにAPIYI apiyi.com で公開されている場合は、統一インターフェースを通じて直接呼び出せます。まだ公開されていない場合は、まずプラットフォーム上で公開済みのモデルを使ってインターフェースとコスト計算の流れの開発を完了させ、公開後にmodelパラメータを切り替えてください。
6.3 Qwen4-Max-Preview 意思決定クイックリファレンス
- 個人開発者で、主にプログラミングツール内でインタラクティブに作業する場合:Token Plan + Previewの夜間ウィンドウを使い、11月25日以降は正式版
qwen4-maxに切り替えます。 - チームで自社アプリケーションを開発する場合:正式版の従量課金APIを使い、リージョンごとに単価を選び、明示的キャッシュを有効にします。
- マルチモデルアプリケーション、またはモデル選定段階:マルチモデルAPI集約プラットフォームを使い、統一インターフェースでタスクごとにコストを集計します。
- 機密データを扱う場合:まず該当製品のデータ使用条項を確認してから、接続方法を決定します。
7 まとめ:Qwen4-Max-Preview 8% Credits ウィンドウの正しい使い方
Qwen4-Max-Preview の夜間 8% Credits は、Token Plan 内の期間限定キャンペーンで、11月25日 24:00 まで有効です。プログラミングツールやエージェントツールでの対話的な利用に適用されます。正式版の Qwen4-Max はすでに11月16日にリリースされており、北京リージョンの従量課金価格は入力10元・出力30元/百万トークンで、アプリケーションのバックエンドや自動化業務に適しています。Credits とトークンは2つの異なる課金体系に属するため、コストを比較する際はタスク単位を基準とし、Credits での相殺分とトークンで計上される金額をそれぞれ記録してください。
判断は次の順序で進めるとよいでしょう。まずタスクがツール内の対話なのかバックエンド呼び出しかを判断し、次に対応する適合製品を決め、最後に同じタスクで実測コストを確認します。すでに提供開始されている複数モデル間で効果とコストを比較したい場合は、APIYI apiyi.com の統一インターフェースを使えば迅速に検証できます。
📚 参考資料
-
Qwen4-Max-Preview 公式ドキュメント:モデル仕様、提供開始日時、接続方法
- リンク:
help.aliyun.com/zh/model-studio/qwen4-max-preview - 説明: 出力予算、思考パラメータ、専用 Base URL
- リンク:
-
Qwen4-Max 正式版 公式ドキュメント:従量課金価格と明示的キャッシュ
- リンク:
help.aliyun.com/zh/model-studio/qwen4-max - 説明: リージョン別の単価、出力上限、キャッシュ TTL
- リンク:
-
Token Plan 個人版のサブスクリプションと特典:プラン価格、Credits、期間限定キャンペーン
- リンク:
help.aliyun.com/zh/model-studio/token-plan-personal-overview - 説明: 2割引・夜間4割引のルール、新規ユーザー価格、利用量パック
- リンク:
-
Token Plan の権限と利用規範:許可される利用シーンと禁止される利用シーン
- リンク:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - 説明: 対話的利用の範囲と違反時の結果
- リンク:
-
Token Plan の利用量とクォータ:Credits の消費メカニズム
- リンク:
help.aliyun.com/zh/model-studio/token-plan-usage-quota - 説明: Credits 消費に影響する各要素
- リンク:
-
Token Plan の機能更新:Preview と正式版のリリース履歴
- リンク:
help.aliyun.com/zh/model-studio/token-plan-product-updates - 説明: 11月11日と11月16日のバージョンイベント
- リンク:
作者: APIYI 技術チーム
技術交流: APIYI apiyi.com のトップページからぜひお問い合わせください。さらに詳しい接続資料は docs.apiyi.com のドキュメントセンターをご覧ください