Аннотация: В статье разбираем ночную скидку 8% Credits на Qwen4-Max-Preview и сравниваем Token Plan, официальный API с оплатой по мере использования и мультимодельную платформу агрегации API по трём параметрам: область применения, единица тарификации и суммарная стоимость задачи.
Qwen4-Max-Preview и 8% Credits: главное сразу
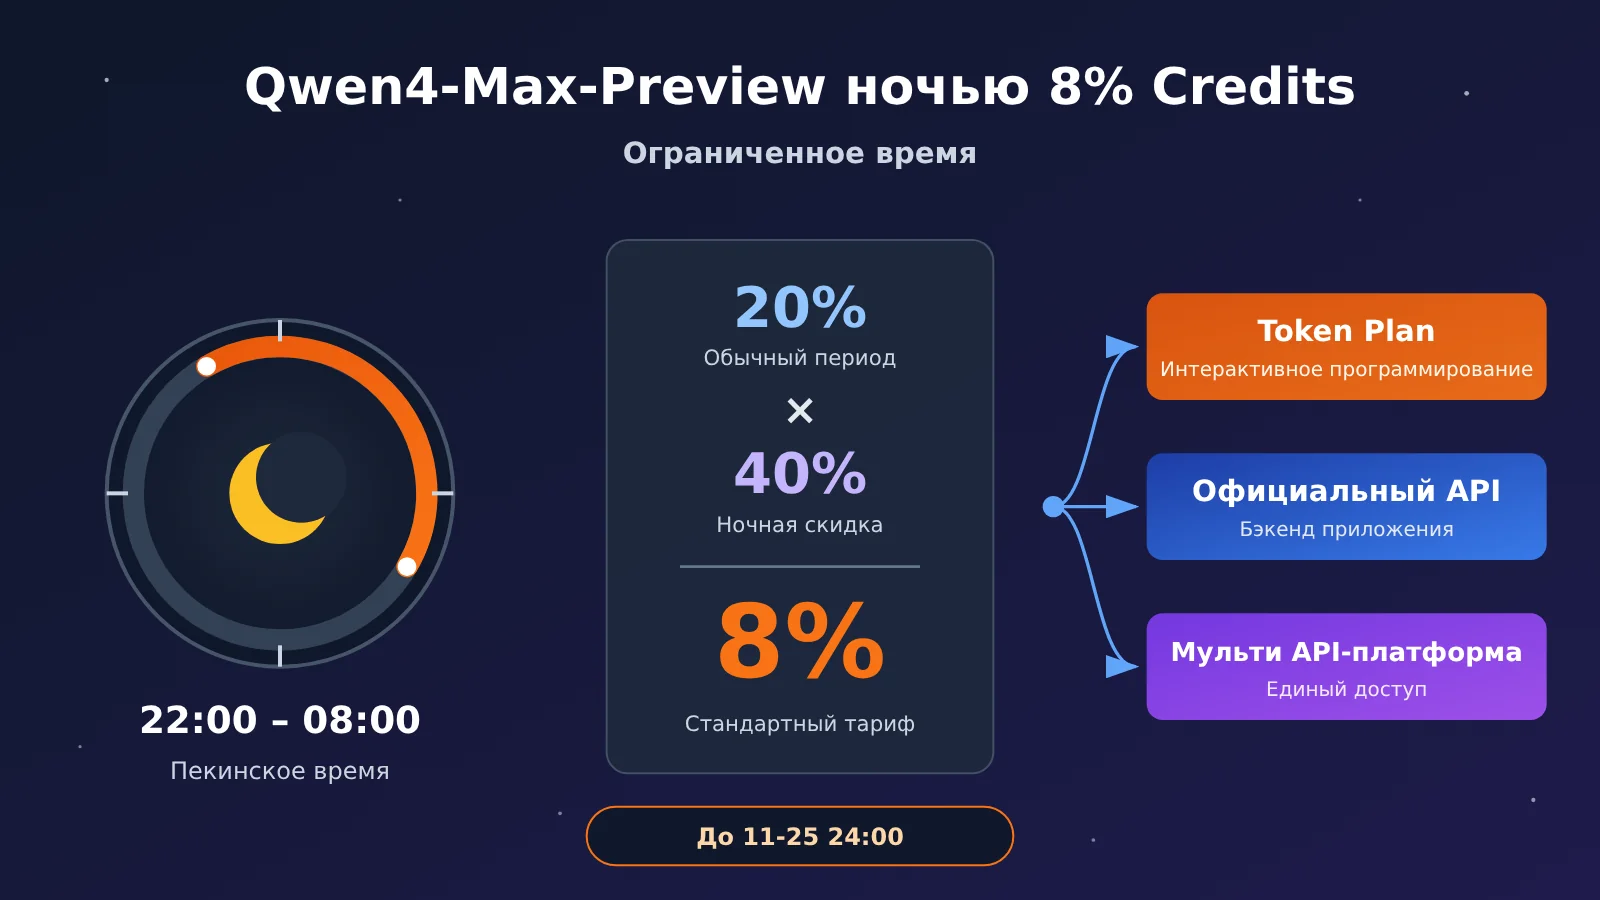
Когда вы вызываете Qwen4-Max-Preview в Token Plan, расход Credits каждый день с 22:00 до 08:00 следующего дня по пекинскому времени составляет 8% от стандартного тарифа. Такой показатель получается при наложении двух скидок. Сначала в обычное время действует скидка 80% — остаётся 20% ставки; ночью добавляется ещё скидка 60% — остаётся 40% от этой суммы. В итоге 20% × 40% = 8%.
Скидка действует до окончания Preview — до 24:00 25 ноября 2026 года по пекинскому времени; после этого модель отключат.
Скидка распространяется только на сценарии, разрешённые в Token Plan: интерактивную работу в инструментах для программирования и агентных инструментах. Если нужно подключать модель к собственному бэкенду приложения или к автоматизированным бизнес-процессам, выбирайте API с оплатой по мере использования, где такие сценарии разрешены. Официальная версия Qwen4-Max, вышедшая 16 ноября, уже имеет отдельные тарифы с оплатой по мере использования и закрывает этот сценарий.
Ниже сначала разберём, как получаются 8% и сколько стоят тарифы Token Plan, а затем объясним правила тарификации в официальной версии и механизм кеширования. После этого сравним три варианта вызова по задачам, форме использования, единице тарификации и интерфейсу, а также дадим схему расчёта затрат с группировкой по задачам. В конце — рекомендации по выбору в зависимости от реальных типов задач разработчика.
К сведению: термины тарификации Qwen4-Max-Preview
| Термин | Объяснение |
|---|---|
| Credits | Единица списания в подписке Token Plan; объём списания зависит от используемой модели и от того, из чего состоит конкретный вызов |
| Token | Единица измерения входа, выхода и рассуждений модели |
| Token Plan | Продукт Alibaba Cloud, который начисляет Credits на каждый период подписки; есть индивидуальная и командная версии |
| API с оплатой по факту | Способ доступа к моделям для приложений с оплатой по фактическому объёму вызовов |
| Попадание в кеш | Повторно переданные входные данные переиспользуются сервером и считаются по правилам тарификации кеша |
| Токены рассуждений | Токены, возникающие в процессе推理 модели; занимают бюджет вывода и включаются в оплату вывода |
| Платформа-агрегатор API | Сервис, который через единый интерфейс даёт вызов разных моделей и управление расходом |
| Стоимость единицы задачи | Сумма всех запросов, повторных попыток, вызовов инструментов и расхода модели, нужных для одной цели |
1 Откуда берётся скидка 92% на Qwen4-Max-Preview
1.1 Две скидки накладываются друг на друга: 20% × 40% = 8%
В период акции Preview Token Plan устанавливает для Qwen4-Max-Preview две ступени скидки на Credits:
- Обычное время: расход Credits составляет 20% от стандартной ставки, то есть платите 20% (скидка 80%). С тем же бюджетом Credits теоретически можно сделать примерно в 5 раз больше вызовов, чем по стандартной ставке.
- Ночное время: каждый день с 22:00 до 08:00 по пекинскому времени поверх этих 20% действует ещё одна скидка — платите 40% от них (скидка 60%).
- Итог наложения: 20% × 40% = 8%, то есть 8% от стандартной ставки.
Официальный пример пропорции: если по стандартной ставке вызов должен стоить 100 Credits, в обычное время он фактически спишет 20 Credits, а в ночное — 8 Credits. Это лишь математический пример для демонстрации пропорции; сколько реально спишется за конкретный вызов, смотрите в детализации расходов в консоли. Официальная сторона также оставляет за собой право корректировать скидки в зависимости от ситуации.
1.2 Временные границы окна Qwen4-Max-Preview
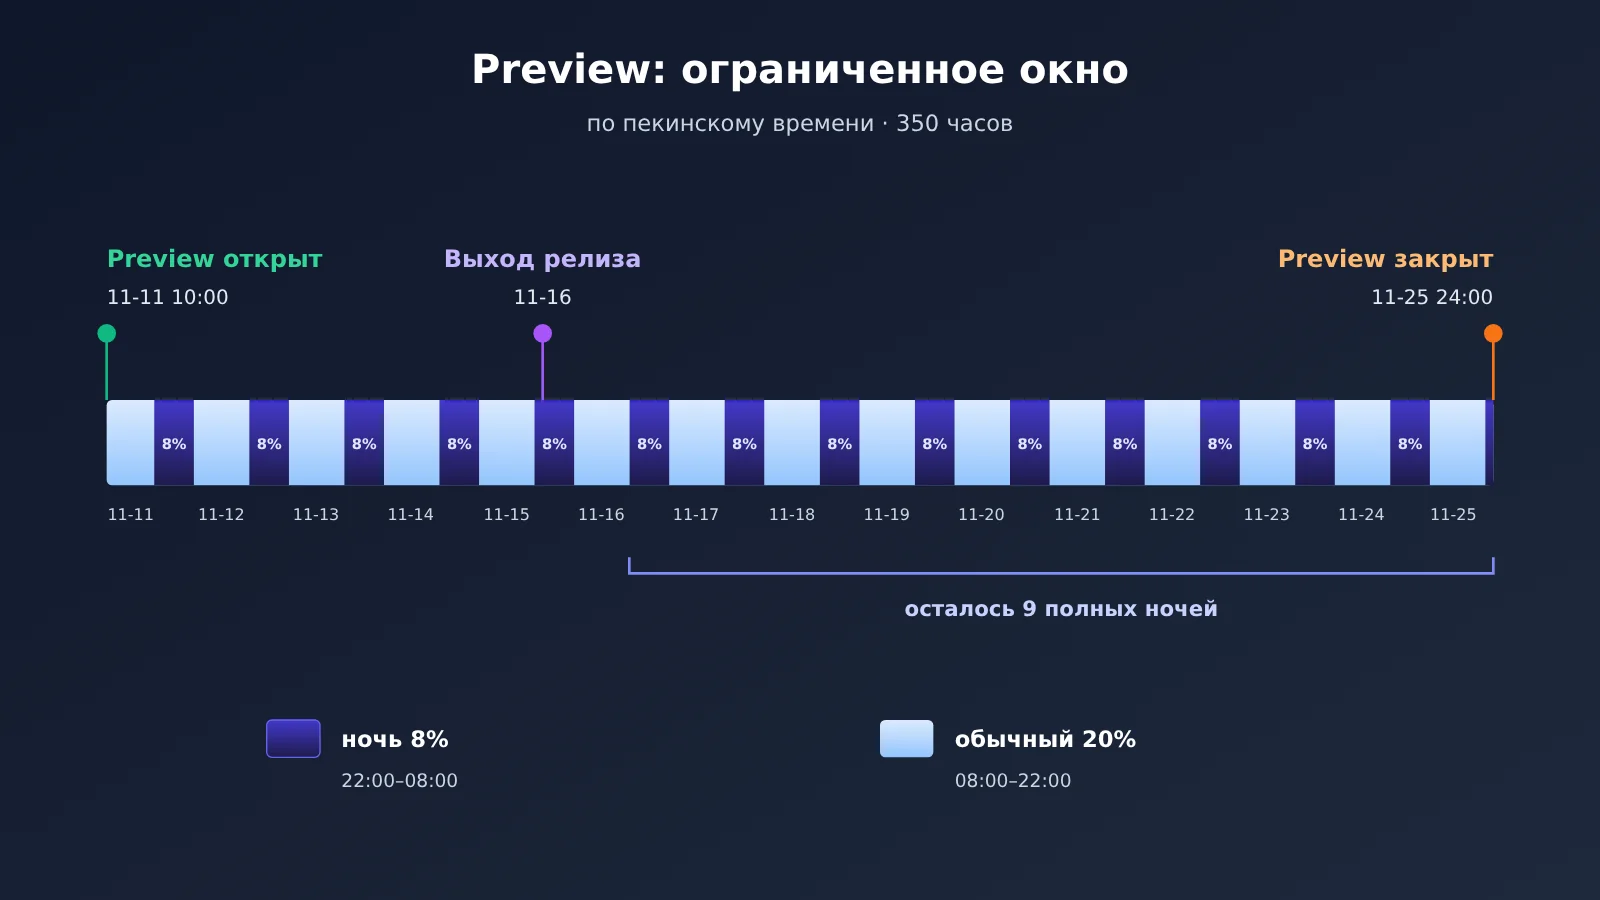
Preview открылся 11 ноября 2026 года в 10:00 и завершится 25 ноября в 24:00 (время везде пекинское), всего 350 часов. Если считать от сегодняшнего 16 ноября, оставшиеся полные ночные окна — это 9 ночей: с вечера 16 ноября по утро 25 ноября. В ночь на 25 ноября ночное окно длится всего два часа, с 22:00 до 24:00, после чего Preview отключают.
После выхода正式ной версии Qwen4-Max 16 ноября время отключения Preview не меняется. Официальная документация модели уже рекомендует использовать正式ную версию, поэтому рабочие процессы, выстроенные в окне Preview, стоит параллельно готовить к переезду на qwen4-max.
2. Как покупать и расходовать Credits в Token Plan
2.1 Цены и лимиты тарифов персональной версии Token Plan
По состоянию на 16 ноября 2026 года на официальной странице персональной версии Token Plan опубликованы следующие тарифы. Месячные лимиты и цены были изменены 9 ноября, поэтому более ранние скриншоты и цены из статей уже неактуальны.
| Тариф | Цена в месяц | Credits в месяц | Параллельные агенты | Цена для новых пользователей |
|---|---|---|---|---|
| Lite | 39 юаней | 20 000 | 1–2 | 19,5 юаня/мес. |
| Essential | 79 юаней | 45 000 | 2–3 | 39,5 юаня/мес. |
| Standard | 139 юаней | 80 000 | 3–4 | на странице не указана скидка для новых пользователей |
| Pro | 312 юаней | 200 000 | 6–8 | на странице не указана скидка для новых пользователей |
Цена для новых пользователей действует до 23:59:59 30 ноября 2026 года (UTC+8) и распространяется только на аккаунты, которые ранее никогда не приобретали персональную версию Token Plan. Скидка для новых пользователей снижает цену подписки на тариф; скидки 80% и 92% для Preview снижают расход Credits при вызове моделей. Эти скидки действуют на разных этапах.
2.2 Правила дополнительных пакетов использования Token Plan
Когда лимит тарифа заканчивается, можно купить дополнительные пакеты использования. Правила такие:
- Цена — 100 юаней за пакет в месяц, в каждом пакете 20 000 Credits.
- У вас уже должен быть действующий тариф; одновременно можно держать не более 5 пакетов.
- Срок действия — один месяц; неиспользованный лимит по окончании срока сгорает.
- Лимит пакета не зависит от исходного месячного лимита тарифа.
2.3 Соотношение единиц Credits и токенов
Credits — единица списания в Token Plan, токен — единица расчёта модели. Их нельзя пересчитывать один к одному. По официальному описанию, сколько Credits списывается за один вызов, зависит от следующих факторов:
- тип модели и её коэффициент тарификации;
- количество входных токенов и число токенов, попавших в кэш;
- количество выходных токенов, включая токены рассуждений;
- количество вызовов инструментов, а также дополнительные вызовы, связанные со встроенными инструментами и подзадачами.
Поэтому по 39 юаням и 20 000 Credits нельзя вычислить цену Qwen4-Max-Preview за миллион токенов. Официально не опубликована отдельная цена Preview за миллион токенов, и для Preview не поддерживается оплата по факту использования. Есть реальный пример, на который можно ориентироваться: один разработчик завершил в Qoder интерактивный проект с автоматом для захвата игрушек. Это заняло около 75 минут, а расход оценивается примерно в 65 Credits. Это запись по одной задаче в конкретном инструменте — только для понимания порядка расхода.
3 Сравнение тарификации Qwen4-Max-Preview и официальной версии
3.1 Preview: доступ только через Token Plan
Подключение Preview возможно только одним способом: нужно подписаться на Token Plan в личной или командной версии, получить API-ключ, предназначенный для этого тарифного плана, использовать специальный Base URL https://token-plan.cn-beijing.maas.aliyuncs.com и указать ID модели qwen4-max-preview (псевдоним qwen4.0-max-preview; в счетах всегда отображается последний). Модель совместима со спецификациями интерфейсов OpenAI Chat Completions, Responses и Anthropic Messages.
Бюджет вывода Preview составляет 393,216 токенов, которые делятся между рассуждением и итоговым ответом. Уровень рассуждения по умолчанию — xhigh. При переходе с других моделей, если задать max_tokens только исходя из длины итогового ответа, ответ может обрезаться: рассуждение займет весь бюджет.
3.2 Официальная версия Qwen4-Max: цены API при оплате по мере использования
Официальная версия qwen4-max стала доступна 16 ноября. Ее можно использовать как в Token Plan, так и через API с оплатой по мере использования. Ниже приведены цены официальной версии при оплате по мере использования с официальной страницы модели (в юанях за миллион токенов):
| Регион развертывания | Вход | Выход (включая рассуждение и ответ) |
|---|---|---|
| Материковый Китай, Северный Китай 2 (Пекин) | 10 юаней | 30 юаней |
| США, Вирджиния | 10 юаней | 30 юаней |
| Германия, Франкфурт | 10 юаней | 30 юаней |
| Япония, Токио | 10 юаней | 30 юаней |
| Гонконг (Китай) | 10 юаней | 30 юаней |
| Сингапур | 10.938 юаня | 32.813 юаня |
В пекинском регионе также доступен бесплатный лимит в 1 млн токенов. Он действует в течение 90 дней с момента начала отсчета — активации Bailian, публикации модели или одобрения заявки; точные условия определяются правилами на официальной странице. Эти цены действуют только для официальной версии; по ним нельзя вычислять стандартный расход Credits в Preview.
Параметры официальной версии также отличаются от Preview: контекстное окно такое же — 1,000,000 токенов, максимальный выход составляет 262,144 токена в режиме рассуждения и 131,072 токена без рассуждения. Уровень рассуждения по умолчанию — high, бюджет рассуждения по умолчанию — 131,072. При миграции нужно заново проверить настройки верхнего предела вывода.
3.3 Механизм явного кэширования в официальной версии Qwen4-Max
Официальная версия поддерживает явное кэширование, которое позволяет повторно использовать фиксированные входные префиксы — системные промпты, описания инструментов, справочные документы и т. п. Явное кэширование поддерживается для трех интерфейсов — OpenAI Chat Completions, Responses и Anthropic Messages; TTL можно выбрать 5 минут или 1 час.
В многошаговых задачах агента на каждом шаге обычно повторно передаются одни и те же системные инструкции и описания инструментов — именно здесь кэширование дает максимальную экономию затрат. У кэширования отдельные правила тарификации; точные цены смотрите на странице тарификации вызовов модели для соответствующего региона.
4. Три способа вызова Qwen4-Max-Preview: кому какой подходит
4.1. Сравнение трёх вариантов
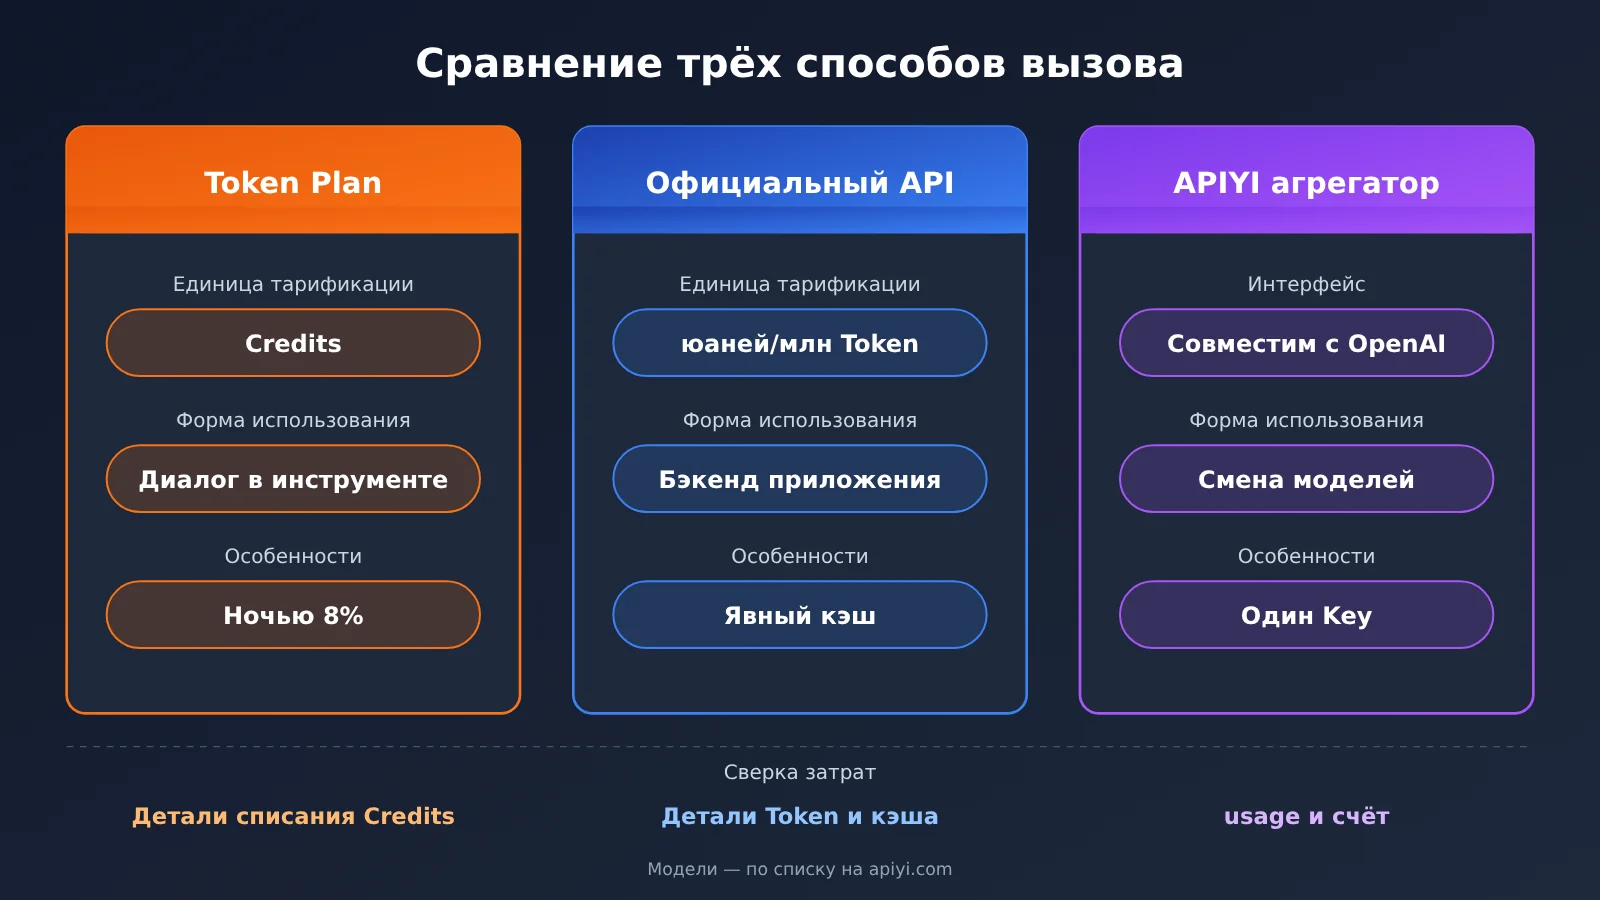
| Параметр | Подписка Token Plan | Платный API официальной версии (по факту использования) | API-агрегатор для нескольких моделей |
|---|---|---|---|
| Подходящие задачи | Интерактивное программирование, диалоги с агентом | Бэкенд собственных приложений, автоматизированные бизнес-процессы | Мультимодельные приложения, сравнение и переключение моделей |
| Допустимые способы использования | Только интерактивная работа в инструментах для программирования и агентских инструментах | Подключение приложений | Подключение приложений, централизованное управление несколькими моделями |
| Единица тарификации | Credits | Юаней/1 млн токенов (с разбивкой по регионам) | По цене за токен, указанной в интерфейсе тарифов платформы |
| Срок действия квоты | Тариф и пакеты использования — помесячно; по истечении срока неиспользованное сгорает | Оплата по факту использования; бесплатный лимит в Пекине — 90 дней | Оплата по факту использования |
| Интерфейс | Отдельный Base URL и отдельный ключ для тарифа | Официальный интерфейс Bailian | OpenAI-совместимый интерфейс, например APIYI apiyi.com |
| Как проверять затраты | Фактические списания Credits в консоли, с детализацией | Сверка по детализации токенов и стоимости кеширования | Сверка по полю usage в запросах и счётам платформы |
4.2 Подписка Token Plan: для интерактивного программирования внутри инструментов
Token Plan поддерживает Claude Code, Cursor, Qwen Code, Qoder, Qoder CN, OpenClaw и другие инструменты — актуальный список смотрите в официальной документации по подключению инструментов. Когда разработчик сам инициирует задачу в этих инструментах, ночная скидка 8% в Preview начинает действовать сразу, а расходы заранее фиксируются в виде Credits.
Границы использования прописаны в официальных правилах доступа: нельзя массово вызывать сервис через автоматические скрипты, нельзя встраивать ключ тарифа в бэкенд собственного приложения, нельзя выполнять неинтерактивные массовые вызовы, а также нельзя использовать преимущества тарифа через платформы рабочих процессов вроде Dify, n8n, Coze или через инструменты тестирования API вроде Postman, Insomnia. Выход за эти рамки может привести к приостановке подписки или блокировке ключа. Кроме того, условия личной подписки предусматривают, что вводимые данные и генерируемый контент в период использования применяются для улучшения сервиса и оптимизации модели, поэтому перед обработкой конфиденциальных материалов нужно сначала проверить соглашение.
4.3 Официальный API с оплатой по факту использования: для подключения приложений к официальной версии
Бэкенд собственных приложений, пакетные задачи и автоматизированные процессы стоит переводить на API с оплатой по факту использования официальной версии qwen4-max. Расчёт ведётся по публичной цене за миллион Token в юанях, а в сочетании с явным кэшированием затраты можно сверять по каждому запросу. На этом пути нет таких крупных скидок, как с Credits, зато схема использования и способ тарификации прозрачны и соответствуют правилам.
4.4 Платформы-агрегаторы API для нескольких моделей: подходят командам, которым нужен единый интерфейс
Если приложению одновременно нужны модели от OpenAI, Claude, Gemini и других провайдеров, агрегатор позволяет вызывать их через один API-ключ и один набор OpenAI-совместимых интерфейсов, а также централизованно управлять использованием. APIYI — одна из таких платформ. Важно уточнить: в статье справочного центра APIYI от 13 ноября указано, что Qwen4 ещё не включена в сводную таблицу моделей и в API цен; публичная статья от 16 ноября также помечает qwen4-max как пока не добавленную в каталог. Это снимки на конкретные даты, поэтому насчёт того, доступна ли модель сейчас, ориентируйтесь на актуальную сводную таблицу моделей и API цен.
🎯 Технический совет: при создании приложения с несколькими моделями можно сначала на APIYI apiyi.com с помощью одного и того же кода сравнить несколько уже доступных моделей на вашей задаче. Когда нужная модель появится в каталоге, достаточно будет изменить параметр
model, чтобы переключиться.
5 Как разработчику рассчитать реальную стоимость Qwen4-Max-Preview и API
5.1 Методика расчёта стоимости одной задачи для Qwen4-Max
Низкая цена модели сама по себе не означает, что выполнение задачи в целом будет дешёвым. Одна задача агента может включать десятки запросов, большой объём повторяющегося контекста, длинный вывод рассуждений и повторные попытки после ошибок. Когда сравниваете варианты, считайте единицей «достижение одной и той же цели» и собирайте стоимость по детализации тарификации каждого продукта:
| Статья затрат | Как считается для API с оплатой по мере использования | Как это фиксируется в схеме Credits |
|---|---|---|
| Некэшированный ввод | Объём некэшированного ввода × соответствующая цена ввода | Напрямую фиксируются Credits, фактически списанные в консоли |
| Кэш | Стоимость чтения, записи и хранения кэша, рассчитывается по правилам соответствующего региона | Уже включено в фактическое списание |
| Вывод | Объём вывода (включая оплачиваемые токены рассуждений) × цена вывода | Уже включено в фактическое списание |
| Инструменты и повторные попытки | Стоимость вызовов инструментов + весь расход на повторные запросы | Уже включено в фактическое списание |
В виде формулы это выглядит так: Стоимость задачи = объём некэшированного ввода × цена ввода + стоимость чтения/записи кэша и хранения + объём вывода (включая оплачиваемые токены рассуждений) × цена вывода + расходы на инструменты, повторные попытки и т. п.
Схема Credits не пересчитывает токены, а просто фиксирует разницу баланса Credits на старте и в конце задачи. У этих двух результатов разные единицы измерения. При сравнении отдельно оценивайте «сколько юаней ушло на каждую задачу» и «сколько Credits списалось за каждую задачу», а затем с учётом месячной платы по тарифу решайте, что выгоднее.
5.2 Записываем расход токенов на каждый запрос с помощью кода
Сверка расчётов по схеме оплаты за фактическое использование опирается на поле usage, которое возвращается в каждом запросе. Приведённый ниже минимальный пример показывает, как считывать расход в OpenAI-совместимом интерфейсе. ID модели замените на ту, что уже доступна в списке моделей платформы:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_ID",  # ориентируйтесь на модель, уже доступную в списке моделей платформы
    messages=[{"role": "user", "content": "总结这段日志中的错误类型"}],
)
print(resp.usage)  # фиксируем prompt_tokens / completion_tokens и т. п. для распределения затрат
Посмотреть полный код распределения затрат по задачам
import openai
from dataclasses import dataclass, field

@dataclass
class TaskLedger:
    """Учёт расхода токенов по задачам; цену за единицу передаёт вызывающая сторона в зависимости от выбранного продукта и региона"""
    input_price_per_m: float          # юаней за миллион токенов, некэшированный ввод
    output_price_per_m: float         # юаней за миллион токенов, вывод (включая рассуждения)
    cache_cost: float = 0.0           # расходы на чтение/запись кэша и хранение, заполняются вручную по детализации
    tool_cost: float = 0.0            # расходы на вызовы инструментов
    records: list = field(default_factory=list)

    def add(self, usage):
        cached = 0
        details = getattr(usage, "prompt_tokens_details", None)
        if details is not None:
            cached = getattr(details, "cached_tokens", 0) or 0
        self.records.append({
            "uncached_input": usage.prompt_tokens - cached,
            "output": usage.completion_tokens,
        })

    def total(self) -> float:
        inp = sum(r["uncached_input"] for r in self.records)
        out = sum(r["output"] for r in self.records)
        return (inp / 1e6 * self.input_price_per_m
                + out / 1e6 * self.output_price_per_m
                + self.cache_cost + self.tool_cost)

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# цену за единицу указывайте согласно фактически выбранному продукту и региону
ledger = TaskLedger(input_price_per_m=0.0, output_price_per_m=0.0)

for attempt in range(3):  # расход от повторных попыток тоже входит в стоимость задачи
    resp = client.chat.completions.create(
        model="YOUR_MODEL_ID",
        messages=[{"role": "user", "content": "修复 query.py 中的分页错误"}],
    )
    ledger.add(resp.usage)
    if resp.choices[0].finish_reason == "stop":
        break

print(f"本任务请求数: {len(ledger.records)},合计成本: {ledger.total():.4f} 元")
5.3 Гипотетический расчёт: задача агента в регионе Пекин на релизной версии
Ниже приведён гипотетический расчёт; цифры нужны только для демонстрации формулы. Предположим, задача в релизной версии Qwen4-Max в регионе Пекин вызывается с оплатой по мере использования: суммарный некешированный ввод — 2,000,000 Tokens, вывод (включая рассуждения) — 50,000 Tokens, кеш и инструменты биллинга не используются:
- Ввод: 2 × 10 юаней = 20 юаней
- Вывод: 0.05 × 30 юаней = 1.5 юаня
- Итого: 21.5 юаня
Этот результат показывает, что стоимость задач агента с длинным контекстом в основном складывается из повторно передаваемого ввода. Если фиксированные системные промпты и описания инструментов в нём перевести в явное кеширование, структура входной части изменится; сколько именно удастся сэкономить, зависит от доли попаданий в кеш и цены кеширования в соответствующем регионе. Для той же задачи в рамках схемы Credits просто фиксируйте фактический объём списания; не пересчитывайте Credits из этих 21.5 юаня.
💰 Проверка затрат: если нужно одновременно сравнить удельную стоимость одной задачи у нескольких доступных моделей на одной и той же задаче, можно через единый интерфейс APIYI apiyi.com считывать usage каждой модели и сводить данные с помощью TaskLedger выше по единой методике.
6 Как выбрать схему вызовов в период Qwen4-Max-Preview
6.1 Интерактивное программирование: ночное окно и Token Plan для длинных задач
Если вы в основном пишете код в Claude Code, Cursor, Qoder и подобных инструментах, Token Plan лучше всего сочетается со скидками Preview. Конкретный план:
- Планируйте интерактивные задачи, требующие большого контекста и долгих рассуждений, на период с 22:00 до 08:00 — запускайте и ведите их самостоятельно в инструменте: например, разбор кодовой базы, отладку между модулями, анализ длинных документов.
- Резервируйте бюджет вывода под рассуждения: 393 216 токенов Preview делятся между рассуждением и ответом.
- В начале и в конце каждой задачи фиксируйте баланс Credits — так вы накопите собственные данные о расходе на одну задачу.
- При первой покупке сравните два тарифа для новых пользователей: Lite за 19,5 юаня и Essential за 39,5 юаня. Скидка действует до 30 ноября.
- До 25 ноября прогоните свои обычные задачи на официальной версии
qwen4-max, чтобы проверить лимит вывода и настройки интенсивности рассуждений.
6.2 Собственные приложения и автоматизация: API с оплатой по факту или агрегатор
Бэкенд-сервисы, задачи по расписанию, пакетная обработка данных и подключение к workflow-платформам — всё это попадает под ограничения персональной версии Token Plan. Здесь стоит выбрать API с оплатой по факту использования, который допускает вызовы из коммерческого бэкенда. Если вы используете только модели семейства Tongyi, можно напрямую подключиться к официальному API Qwen4-Max с оплатой по факту и с помощью явного кэширования контролировать затраты на вход. Если приложению нужно комбинировать несколько моделей, используйте агрегатор API с единым интерфейсом и единым биллингом.
💡 Рекомендация: при подключении ориентируйтесь на фактическую доступность модели. Если целевая модель уже доступна на APIYI apiyi.com, можно вызывать её напрямую через единый интерфейс; если ещё нет — сначала отработайте на платформе с уже доступными моделями всю цепочку интеграции и расчёта стоимости, а когда модель появится, просто переключите параметр model.
6.3 Быстрая шпаргалка по Qwen4-Max-Preview
- Индивидуальный разработчик, работающий в основном в инструментах для программирования: Token Plan плюс ночное окно Preview; после 25 ноября переходите на официальную версию
qwen4-max. - Команда, разрабатывающая собственное приложение: официальный API с оплатой по факту, выбор цены по региону, включённое явное кэширование.
- Приложение с несколькими моделями или этап выбора модели: агрегатор API для нескольких моделей, единый интерфейс, учёт затрат по задачам.
- Работа с конфиденциальными данными: сначала проверьте условия использования данных соответствующего продукта, а затем решайте, как подключаться.
7. Итог: как правильно использовать ночное окно 8% Credits для Qwen4-Max-Preview
Ночные 8% Credits на Qwen4-Max-Preview — это ограниченная по времени скидка в рамках Token Plan, действует до 24:00 25 ноября и распространяется на интерактивное использование в инструментах для программирования и агентных инструментах. Официальная версия Qwen4-Max вышла 16 ноября; в регионе Пекин цена при оплате по факту использования составляет 10 юаней за входные и 30 юаней за выходные данные на миллион токенов — она подходит для бэкенда приложений и автоматизированных бизнес-процессов. Credits и токены — это две разные системы учёта, поэтому при сравнении затрат ориентируйтесь на единицу задачи: отдельно фиксируйте списание Credits и отдельно — суммы, агрегированные по токенам.
При принятии решения можно идти в таком порядке: сначала определите, это интерактивная задача внутри инструмента или вызов из бэкенда, затем выберите соответствующий разрешённый продукт и в конце измерьте затраты на одной и той же задаче. Если нужно сравнить качество и стоимость нескольких уже доступных моделей, это можно быстро проверить через единый интерфейс APIYI apiyi.com.
📚 Справочные материалы
-
Официальная документация Qwen4-Max-Preview: спецификации модели, время запуска и способы подключения
- Ссылка:
help.aliyun.com/zh/model-studio/qwen4-max-preview - Пояснение: бюджет вывода, параметры «размышления», выделенный Base URL
- Ссылка:
-
Официальная документация финальной версии Qwen4-Max: цены при оплате по факту и явное кэширование
- Ссылка:
help.aliyun.com/zh/model-studio/qwen4-max - Пояснение: цена за единицу в каждом регионе,上限 вывода, TTL кэша
- Ссылка:
-
Подписка Token Plan для физлиц и её преимущества: стоимость тарифов, Credits и ограниченные по времени скидки
- Ссылка:
help.aliyun.com/zh/model-studio/token-plan-personal-overview - Пояснение: правила скидок 20% и ночных 60%, цены для новых пользователей, пакеты用量
- Ссылка:
-
Права и правила использования Token Plan: разрешённые и запрещённые сценарии
- Ссылка:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - Пояснение: границы интерактивного использования и последствия нарушений
- Ссылка:
-
Использование и лимиты Token Plan: механизм расхода Credits
- Ссылка:
help.aliyun.com/zh/model-studio/token-plan-usage-quota - Пояснение: факторы, влияющие на расход Credits
- Ссылка:
-
Обновления функций Token Plan: история запуска Preview и финальной версии
- Ссылка:
help.aliyun.com/zh/model-studio/token-plan-product-updates - Пояснение: события версий 11 и 16 ноября
- Ссылка:
Автор: техническая команда APIYI
Техническая связь: свяжитесь с нами на главной странице APIYI apiyi.com — больше материалов по подключению доступно в справочном центре docs.apiyi.com