Résumé : Cet article décrypte l’offre nocturne à 8 % sur les Credits de Qwen4-Max-Preview et compare, sous l’angle du périmètre d’utilisation, de l’unité de facturation et du coût total par tâche, les forfaits d’abonnement Token Plan, l’API officielle à paiement à l’usage et les plateformes d’agrégation d’API multi-modèles.
Qwen4-Max-Preview : l’offre nocturne à 8 % sur les Credits, conclusion d’abord
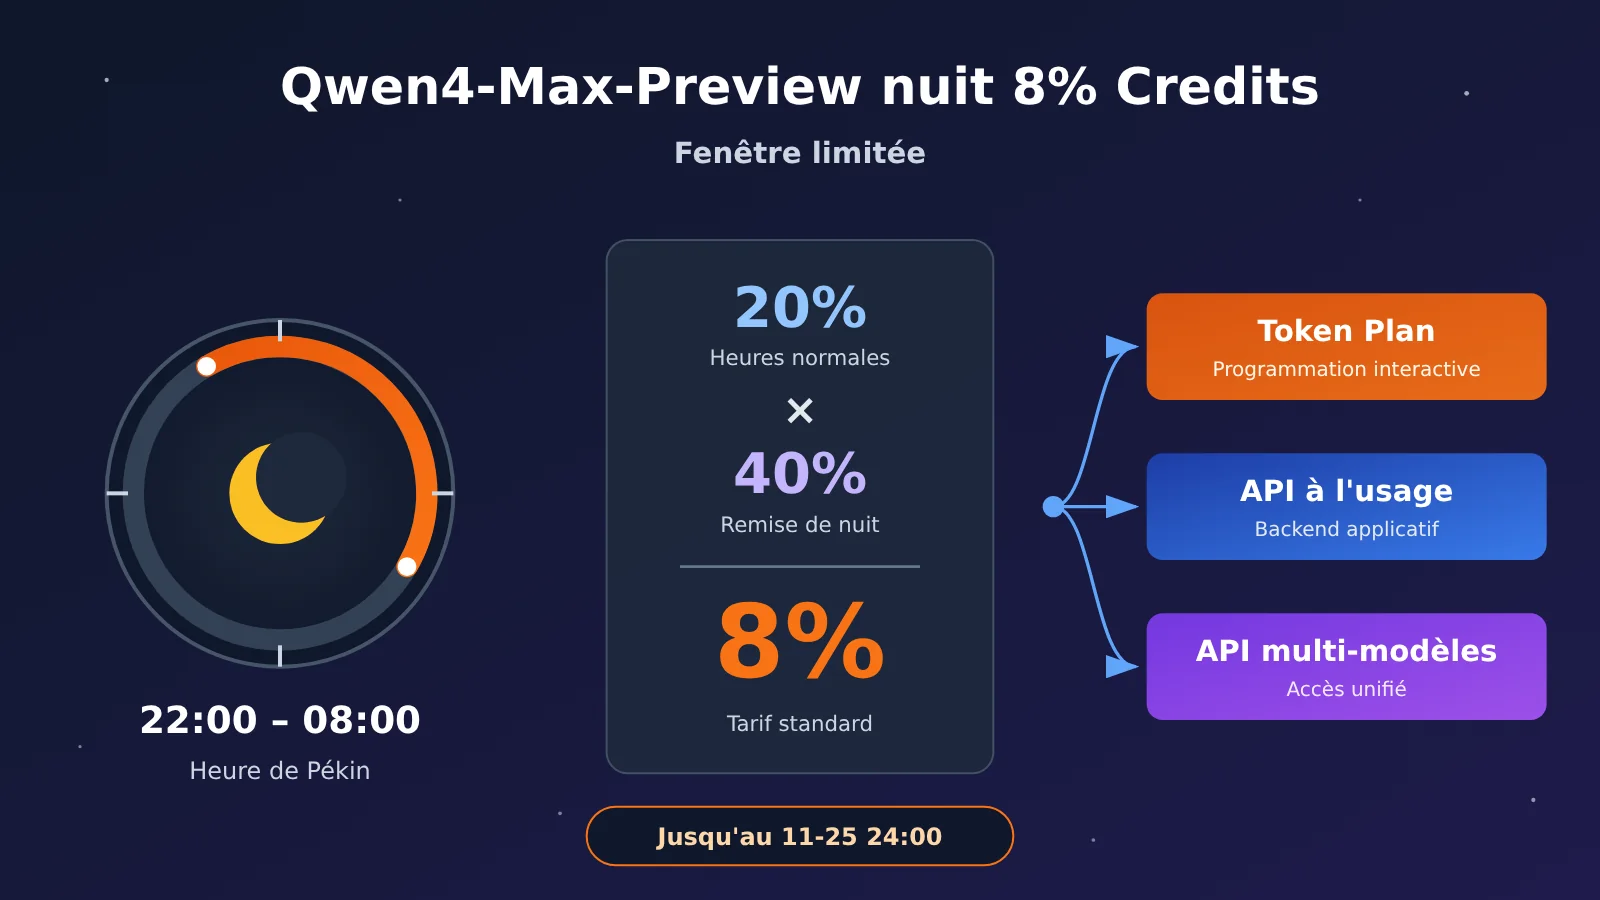
Dans Token Plan, lorsque vous appelez Qwen4-Max-Preview, chaque nuit, entre 22 h 00 et 8 h 00 (heure de Pékin), la consommation de Credits est facturée à 8 % du tarif standard. Ce taux résulte de la combinaison du tarif de journée, fixé à 20 % du prix normal, et d’une remise nocturne supplémentaire de 60 %, soit 40 % de ce tarif déjà réduit. L’offre court jusqu’à la fin de la Preview, le 25 novembre 2026 à 24 h 00 (heure de Pékin) ; le modèle sera ensuite retiré.
Cette remise ne s’applique qu’aux usages autorisés par Token Plan, c’est-à-dire l’utilisation interactive dans les outils de programmation et les outils d’agents. Pour intégrer le modèle au backend d’une application maison ou à un processus métier automatisé, il faut se tourner vers une API à paiement à l’usage autorisant ce type d’usage. La version officielle de Qwen4-Max, mise en ligne le 16 novembre, propose déjà un tarif à l’usage distinct et peut répondre à ce besoin.
Nous allons d’abord détailler le calcul des 8 % et le prix des forfaits Token Plan, puis préciser les règles de facturation à l’usage de la version officielle et son mécanisme de cache. Nous comparerons ensuite les trois options d’appel selon quatre axes : types de tâches adaptés, mode d’utilisation, unité de facturation et interface. Nous proposerons un cadre de calcul pour agréger les coûts par tâche, avant de formuler des recommandations selon le type de tâche réel du développeur.
À savoir : la terminologie de facturation de Qwen4-Max-Preview
| Terme | Explication |
|---|---|
| Credits | Unité de déduction des forfaits d’abonnement Token Plan ; la consommation dépend du modèle utilisé et de la composition précise de l’appel |
| Token | Unité de mesure des entrées, des sorties et du contenu de réflexion du modèle |
| Token Plan | Produit d’Alibaba Cloud qui attribue des Credits par cycle d’abonnement, en versions personnelle et équipe |
| API à paiement à l’usage | Mode de fourniture des services de modèle facturé selon le volume réel d’appels, destiné à l’intégration dans des applications |
| Correspondance de cache | Les entrées répétées sont réutilisées par le serveur et facturées selon la règle de tarification du cache |
| Tokens de réflexion | Tokens produits par le processus de raisonnement du modèle ; ils consomment le budget de sortie et sont facturés comme sortie |
| Plateforme d’agrégation d’API | Service qui fournit, via une interface unifiée, l’appel de plusieurs modèles et la gestion de l’usage |
| Coût unitaire par tâche | Somme de toutes les requêtes, réessais, appels d’outils et consommation de modèle nécessaires pour atteindre un même objectif |
1 D’où vient le tarif à 8 % du prix standard sur Qwen4-Max-Preview
1.1 Deux niveaux de remise cumulés : 20 % × 40 % = 8 %
Pendant la période de l’offre Preview, Token Plan applique deux niveaux de remise en Credits sur Qwen4-Max-Preview :
- Période normale : la consommation de Credits représente 20 % du tarif standard, soit une remise de 80 %. Avec le même budget de Credits, on peut théoriquement effectuer environ 5 fois plus d’appels qu’au tarif standard.
- Période nocturne : chaque jour de 22:00 à 08:00, heure de Pékin, on applique en plus un facteur de 40 % sur ces 20 %.
- Résultat du cumul : 20 % × 40 % = 8 %, soit 8 % du tarif standard.
L’éditeur a donné un exemple de proportion : si un appel devait consommer 100 Credits au tarif standard, il en consomme 20 en période normale et 8 en période nocturne. Il ne s’agit que d’un exemple mathématique pour illustrer le rapport ; la consommation réelle d’un appel donné doit être vérifiée dans le détail d’usage de la console. L’éditeur se réserve également le droit d’ajuster les remises selon les conditions d’exploitation.
1.2 Les limites temporelles de la fenêtre Qwen4-Max-Preview
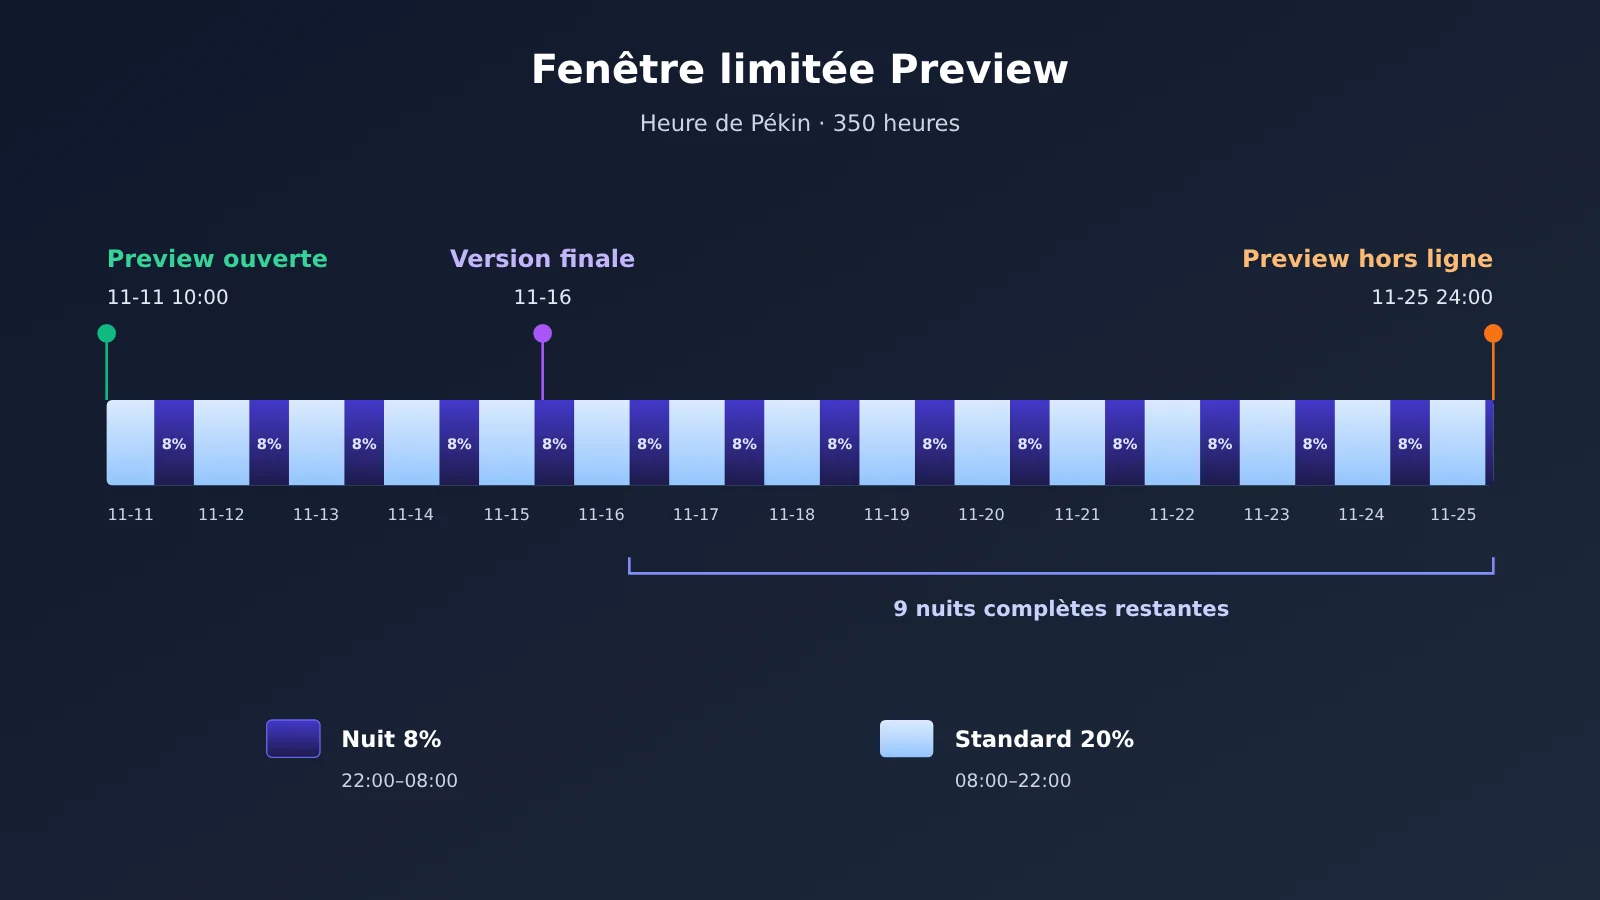
La Preview a ouvert le 11 novembre 2026 à 10:00 et se termine le 25 novembre à 24:00 (heures de Pékin), soit 350 heures au total. En comptant à partir d’aujourd’hui, 16 novembre, il reste 9 nuits complètes en période nocturne : du soir du 16 novembre au matin du 25 novembre. Le soir du 25 novembre, la plage nocturne ne dure que deux heures, de 22:00 à 24:00 ; ensuite, la Preview est retirée.
Après la mise en ligne de la version officielle Qwen4-Max le 16 novembre, la date de retrait de la Preview reste inchangée. La documentation officielle des modèles recommande déjà d’utiliser la version officielle ; les workflows mis en place pendant la fenêtre Preview doivent donc être préparés en parallèle à une migration vers qwen4-max.
2. Comment acheter et consommer les Credits du Token Plan
2.1 Prix et quotas des forfaits personnels Token Plan
Au 16 novembre 2026, voici les forfaits publiés sur la page officielle du Token Plan personnel d’Aliyun. Les quotas mensuels et les prix ont été révisés le 9 novembre : les captures d’écran et les prix cités dans des articles plus anciens ne sont donc plus valables.
| Forfait | Prix mensuel | Credits mensuels | Agents simultanés | Prix nouveaux utilisateurs |
|---|---|---|---|---|
| Lite | 39 yuans | 20 000 | 1–2 | 19,5 yuans/mois |
| Essential | 79 yuans | 45 000 | 2–3 | 39,5 yuans/mois |
| Standard | 139 yuans | 80 000 | 3–4 | Aucune offre nouveaux utilisateurs indiquée sur la page |
| Pro | 312 yuans | 200 000 | 6–8 | Aucune offre nouveaux utilisateurs indiquée sur la page |
Le prix nouveaux utilisateurs est valable jusqu’au 30 novembre 2026 à 23:59:59 (UTC+8) et réservé aux comptes n’ayant jamais acheté de forfait Token Plan personnel auparavant. La remise nouveaux utilisateurs porte sur le prix de l’abonnement ; les remises de 80 % (2 折) et de 92 % (0,8 折) appliquées au Preview portent sur les Credits consommés lors de l’invocation du modèle. Les deux n’agissent donc pas au même niveau.
2.2 Règles des packs d’usage supplémentaire
Une fois le quota du forfait épuisé, il est possible d’acheter des packs d’usage supplémentaire, selon les règles suivantes :
- Prix : 100 yuans l’unité par mois, chaque pack contenant 20 000 Credits.
- Il faut déjà détenir un forfait valide, et ne pas dépasser 5 packs détenus simultanément.
- Validité d’un mois ; le quota non consommé est perdu à l’expiration.
- Le quota des packs est indépendant du quota mensuel du forfait.
2.3 Relation de mesure entre Credits et Tokens
Les Credits sont l’unité de déduction du Token Plan, les Tokens l’unité de calcul du modèle : les deux ne se convertissent pas en 1:1. D’après la documentation officielle, le nombre de Credits déduits lors d’un appel dépend des facteurs suivants :
- le type de modèle et son coefficient de facturation ;
- le nombre de Tokens d’entrée, dont ceux ayant bénéficié d’un cache hit ;
- le nombre de Tokens de sortie, y compris les Tokens de réflexion ;
- le nombre d’appels d’outils, ainsi que les appels supplémentaires générés par les outils intégrés et les sous-tâches.
Il est donc impossible de déduire le prix par million de Tokens de Qwen4-Max-Preview à partir de 39 yuans et 20 000 Credits. L’éditeur n’a pas publié de tarif indépendant par million de Tokens pour le Preview, et le paiement à l’usage pour le Preview n’est pas pris en charge. Un cas réel peut servir de repère : un développeur a réalisé dans Qoder un projet interactif de machine à pince en environ 75 minutes, pour une consommation estimée à environ 65 Credits. Il s’agit d’une tâche unique dans un outil précis, à prendre seulement comme indication de l’ordre de grandeur de la consommation.
3 Comparaison des modes de facturation entre Qwen4-Max-Preview et la version officielle
3.1 Preview : un accès réservé au plan Token
Le mode d’accès à Preview est fixe : il faut souscrire au plan Token individuel ou à la version équipe, récupérer la clé API dédiée au forfait, utiliser l’URL de base spécifique https://token-plan.cn-beijing.maas.aliyuncs.com et définir l’ID du modèle sur qwen4-max-preview (alias qwen4.0-max-preview, ce dernier apparaissant systématiquement sur la facture). Il est compatible avec les spécifications d’interface OpenAI Chat Completions, Responses et Anthropic Messages.
Le budget de sortie de Preview est de 393 216 tokens, partagé entre le contenu de réflexion et la réponse finale, avec un effort de raisonnement par défaut réglé sur xhigh. Lors d’une migration depuis un autre modèle, si vous ne dimensionnez max_tokens qu’en fonction de la longueur de la réponse finale, celle-ci risque d’être tronquée parce que le contenu de réflexion aura épuisé tout le budget.
3.2 Version officielle Qwen4-Max : tarifs de l’API à l’usage
La version officielle qwen4-max est disponible depuis le 16 novembre. Elle peut être utilisée dans le plan Token comme appelée en paiement à l’usage. Voici les tarifs à l’usage de la version officielle publiés sur la page officielle du modèle (en yuan, pour un million de tokens) :
| Région de déploiement | Entrée | Sortie (réflexion et réponse incluses) |
|---|---|---|
| Chine continentale, Chine du Nord 2 (Pékin) | 10 yuan | 30 yuan |
| États-Unis, Virginie | 10 yuan | 30 yuan |
| Allemagne, Francfort | 10 yuan | 30 yuan |
| Japon, Tokyo | 10 yuan | 30 yuan |
| Chine, Hong Kong | 10 yuan | 30 yuan |
| Singapour | 10,938 yuan | 32,813 yuan |
La région de Pékin bénéficie en outre d’un quota gratuit de 1 million de tokens, valable 90 jours à compter de la date de départ (activation de Bailian, publication du modèle ou acceptation de la demande, selon le cas) ; les règles de la page officielle font foi. Ces prix ne concernent que la version officielle et ne permettent pas de déduire la consommation standard en Credits de Preview.
Les paramètres de la version officielle diffèrent eux aussi de ceux de Preview : la fenêtre de contexte reste de 1 000 000 de tokens, la sortie maximale est de 262 144 tokens en mode réflexion et de 131 072 tokens en mode sans réflexion ; l’effort de raisonnement par défaut est high et le budget de réflexion par défaut de 131 072. Pensez donc à revérifier le réglage de la limite de sortie lors d’une migration.
3.3 Le mécanisme de cache explicite de la version officielle Qwen4-Max
La version officielle prend en charge le cache explicite, qui permet de réutiliser des préfixes d’entrée fixes comme l’invite système, les descriptions d’outils ou les documents de référence. Le cache explicite fonctionne avec les trois interfaces OpenAI Chat Completions, Responses et Anthropic Messages, et le TTL peut être réglé sur 5 minutes ou 1 heure.
Dans les tâches d’agent multi-tours, on renvoie généralement à chaque tour les mêmes instructions système et les mêmes descriptions d’outils : c’est précisément là que le cache permet le plus d’économies. Le cache a ses propres règles de facturation ; pour les tarifs exacts, consultez la page de facturation des appels de modèle de la région concernée.
4 Qwen4-Max-Preview : à qui convient chacun des trois modes d’invocation
4.1 Comparaison des trois approches
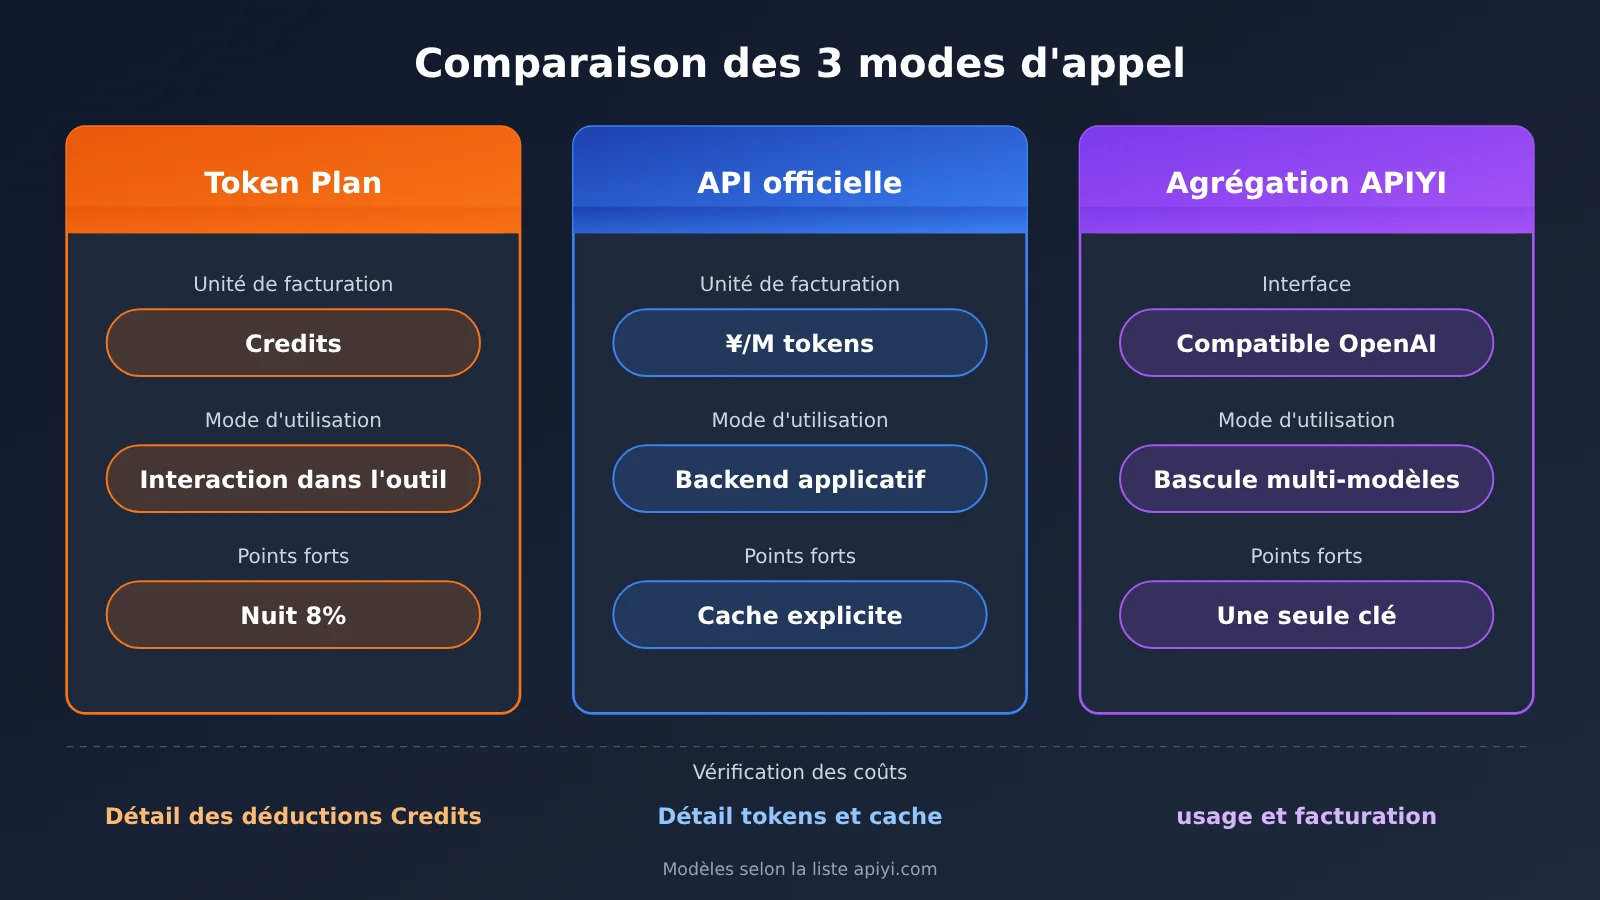
| Critère | Abonnement Token Plan | API à la consommation (version officielle) | Plateforme d’agrégation d’API multi-modèles |
|---|---|---|---|
| Tâches adaptées | Programmation interactive, dialogue avec des agents | Backend d’application maison, processus métier automatisés | Applications multi-modèles, comparaison et bascule entre modèles |
| Formes d’utilisation autorisées | Uniquement un usage interactif dans les outils de programmation et les outils d’agents | Intégration applicative | Intégration applicative, gestion unifiée de plusieurs modèles |
| Unité de facturation | Credits | yuan par million de Tokens (selon la région) | Prix unitaire du Token publié sur la page tarifs de la plateforme |
| Validité du quota | Forfaits et packs d’usage mensuels, perdus à expiration | Facturation à l’usage ; quota gratuit de 90 jours à Pékin | Facturation à l’usage |
| Interface | Base URL dédiée et clé dédiée au forfait | Interface officielle Bailian | Interface compatible OpenAI, par exemple APIYI apiyi.com |
| Méthode de vérification des coûts | Détail des Credits réellement déduits dans la console | Regroupement par détail des Tokens et facturation du cache | Regroupement via le champ usage des requêtes et la facturation de la plateforme |
4.2 Abonnement Token Plan : adapté à la programmation interactive dans les outils
Token Plan prend en charge des outils comme Claude Code, Cursor, Qwen Code, Qoder, Qoder CN, OpenClaw, etc., en se référant à la documentation officielle d’intégration des outils. Lorsque les développeurs lancent des tâches depuis ces outils, la remise nocturne de 8 % appliquée par Preview prend effet directement, et le coût est verrouillé à l’avance sous forme de Credits.
Les limites d’usage sont inscrites dans les règles officielles d’autorisation : pas d’appels massifs via des scripts automatisés, pas de clé d’abonnement dans le backend d’une application auto-hébergée, pas d’appels massifs non interactifs, et pas d’usage détourné des droits de l’abonnement via des plateformes de workflow comme Dify, n8n ou Coze, ou des outils de test d’API comme Postman ou Insomnia. Sortir de ce cadre peut entraîner la suspension de l’abonnement ou le bannissement de la clé. Par ailleurs, les conditions de l’abonnement personnel précisent que les entrées et les contenus générés pendant l’utilisation servent à améliorer le service et à optimiser le modèle : avant de traiter des informations confidentielles, il faut d’abord vérifier les conditions.
4.3 API officielle facturée à l’usage : adaptée à l’intégration d’applications en production
Pour un backend d’application auto-hébergée, des tâches par lots et des flux automatisés, il convient d’utiliser l’API facturée à l’usage de la version officielle qwen4-max. La facturation repose sur un prix public en yuans par million de Tokens ; avec le cache explicite, le coût peut être vérifié requête par requête. Cette voie n’offre pas les remises importantes des Credits, mais sa forme d’utilisation et son mode de facturation sont clairs et conformes.
4.4 Plateforme d’agrégation d’API multi-modèles : penser aux équipes qui ont besoin d’une interface unifiée
Si votre application doit recourir à plusieurs modèles à la fois (OpenAI, Claude, Gemini, etc.), une plateforme d’agrégation vous permet de tout faire avec une seule clé API et un ensemble d’interfaces compatibles OpenAI, tout en centralisant la gestion de la consommation. APIYI fait partie de ces plateformes. À noter : un article du centre d’aide d’APIYI daté du 13 novembre indiquait que Qwen4 n’était pas encore répertorié dans le tableau récapitulatif des modèles et l’interface de tarification ; un autre article public du 16 novembre classait lui aussi qwen4-max comme non disponible pour le moment. Ce sont des instantanés à ces dates-là. Pour savoir si le modèle est désormais disponible, fiez-vous au tableau récapitulatif des modèles et à l’interface de tarification actuels.
🎯 Conseil technique : quand vous construisez une application multi-modèles, vous pouvez d’abord utiliser le même code sur APIYI apiyi.com pour comparer les performances de plusieurs modèles déjà disponibles sur votre tâche. Une fois le modèle cible disponible, il suffit de modifier le paramètre
modelpour basculer.
5 Comment les développeurs calculent le coût réel de Qwen4-Max-Preview et de l’API
5.1 Cadre de calcul du coût unitaire par tâche pour Qwen4-Max
Un prix unitaire bas ne garantit pas un coût total faible pour une tâche. Une tâche d’agent peut comporter des dizaines de requêtes, un contexte répété en grande quantité, des sorties de réflexion plus longues et des nouvelles tentatives en cas d’échec. Pour comparer des solutions, il faut prendre « l’accomplissement d’un même objectif » comme unité et regrouper les coûts selon le détail de facturation de chaque produit :
| Poste de coût | Mode de calcul pour l’API à l’usage | Mode d’enregistrement pour l’offre Credits |
|---|---|---|
| Entrée non mise en cache | Volume d’entrée non mise en cache × prix unitaire d’entrée correspondant | Enregistrer directement les Credits réellement déduits dans la console |
| Cache | Frais de lecture, d’écriture et de stockage du cache, calculés selon les règles de la région correspondante | Déjà inclus dans la déduction réelle |
| Sortie | Volume de sortie (y compris les tokens de réflexion facturés) × prix unitaire de sortie | Déjà inclus dans la déduction réelle |
| Outils et nouvelles tentatives | Frais d’appel des outils + consommation totale des requêtes de nouvelle tentative | Déjà inclus dans la déduction réelle |
Sous forme de formule : Coût de la tâche = volume d’entrée non mise en cache × prix d’entrée + frais de lecture/écriture et de stockage du cache + volume de sortie (y compris la réflexion facturée) × prix de sortie + frais d’outils/nouvelles tentatives, etc. L’offre Credits ne fait pas de conversion en tokens : elle enregistre directement la différence de solde Credits entre le début et la fin de la tâche. Les deux types de résultats ont des unités différentes ; lors de la comparaison, il faut évaluer séparément « combien de yuans chaque tâche a coûté » et « combien de Credits chaque tâche a débité », puis juger le rapport qualité-prix en tenant compte du forfait mensuel.
5.2 Suivre par code la consommation de tokens de chaque requête
La vérification de l’offre à l’usage repose sur le champ usage renvoyé à chaque requête. L’exemple minimal ci-dessous montre comment lire la consommation dans une interface compatible OpenAI. Remplacez l’ID du modèle par une référence déjà disponible dans la liste des modèles de la plateforme :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d'APIYI
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_ID",  # Utilisez un modèle déjà disponible dans la liste des modèles de la plateforme
    messages=[{"role": "user", "content": "总结这段日志中的错误类型"}],
)
print(resp.usage)  # Enregistrez prompt_tokens / completion_tokens, etc., pour imputer les coûts
Voir le code complet d’imputation des coûts par tâche
import openai
from dataclasses import dataclass, field

@dataclass
class TaskLedger:
    """Suivre la consommation de tokens par tâche ; les prix unitaires sont fournis par l'appelant selon le produit et la région choisis"""
    input_price_per_m: float          # Yuan par million de tokens, entrée non mise en cache
    output_price_per_m: float         # Yuan par million de tokens, sortie (réflexion incluse)
    cache_cost: float = 0.0           # Frais de lecture/écriture et de stockage du cache, à saisir manuellement selon le détail
    tool_cost: float = 0.0            # Frais d'appel des outils
    records: list = field(default_factory=list)

    def add(self, usage):
        cached = 0
        details = getattr(usage, "prompt_tokens_details", None)
        if details is not None:
            cached = getattr(details, "cached_tokens", 0) or 0
        self.records.append({
            "uncached_input": usage.prompt_tokens - cached,
            "output": usage.completion_tokens,
        })

    def total(self) -> float:
        inp = sum(r["uncached_input"] for r in self.records)
        out = sum(r["output"] for r in self.records)
        return (inp / 1e6 * self.input_price_per_m
                + out / 1e6 * self.output_price_per_m
                + self.cache_cost + self.tool_cost)

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Renseignez les prix unitaires selon le produit et la région réellement choisis
ledger = TaskLedger(input_price_per_m=0.0, output_price_per_m=0.0)

for attempt in range(3):  # La consommation liée aux nouvelles tentatives est aussi comptabilisée dans le coût de la tâche
    resp = client.chat.completions.create(
        model="YOUR_MODEL_ID",
        messages=[{"role": "user", "content": "修复 query.py 中的分页错误"}],
    )
    ledger.add(resp.usage)
    if resp.choices[0].finish_reason == "stop":
        break

print(f"本任务请求数: {len(ledger.records)},合计成本: {ledger.total():.4f} 元")
5.3 Calcul hypothétique : une tâche Agent dans la région de Pékin, version officielle
Ce qui suit est un calcul hypothétique ; les chiffres servent uniquement à illustrer la formule. Supposons qu’une tâche soit exécutée via un appel facturé à l’usage à Qwen4-Max en version officielle dans la région de Pékin, avec 2,000,000 Tokens d’entrée non mise en cache cumulés et 50,000 Tokens de sortie (raisonnement inclus), sans utiliser le cache ni les outils de facturation :
- Entrée : 2 × 10 yuans = 20 yuans
- Sortie : 0.05 × 30 yuans = 1.5 yuans
- Total : 21.5 yuans
Ce résultat montre que, pour les tâches Agent à long contexte, le coût provient principalement de l’entrée transmise à plusieurs reprises. Si l’on passe les invites système et les descriptions d’outils fixes concernées en cache explicite, la structure de la partie entrée change ; le montant exact des économies dépend du taux de hit du cache et du prix unitaire du cache dans la région correspondante. Pour la même tâche avec la formule Credits, notez directement le montant réellement déduit, sans convertir ces 21.5 yuans en Credits.
💰 Vérification des coûts : si votre activité doit comparer simultanément le coût unitaire par tâche de plusieurs modèles déjà disponibles pour une même tâche, vous pouvez lire l’usage de chaque modèle via l’interface unifiée d’APIYI apiyi.com, puis l’agréger avec le TaskLedger ci-dessus selon la même convention de calcul.
6 Comment choisir sa stratégie d’invocation à l’époque de Qwen4-Max-Preview
6.1 Programmation interactive : traiter les tâches longues avec le Token Plan pendant la fenêtre nocturne
Si vous écrivez surtout du code dans des outils comme Claude Code, Cursor ou Qoder, c’est le Token Plan et l’offre Preview qui collent le mieux. Concrètement :
- Placez les tâches interactives qui demandent une grande fenêtre de contexte et une longue réflexion entre 22h00 et 08h00, en les lançant et en les suivant vous-même dans l’outil : compréhension d’un dépôt de code, débogage inter-modules, analyse de longs documents, par exemple.
- Réservez un budget de sortie pour le contenu de réflexion : les 393,216 Tokens de la Preview sont partagés entre le raisonnement et la réponse.
- Notez le solde de Credits au début et à la fin de chaque tâche, histoire de vous constituer vos propres données de consommation par tâche.
- Pour le premier achat, comparez les deux tarifs réservés aux nouveaux utilisateurs, Lite à 19.5 yuans et Essential à 39.5 yuans ; l’offre se termine le 30 novembre.
- Avant le 25 novembre, faites tourner vos tâches habituelles avec la version stable
qwen4-maxpour vérifier le plafond de sortie et les réglages d’intensité de raisonnement.
6.2 Applications maison et automatisation métier : API à la consommation ou plateforme d’agrégation
Services backend, tâches planifiées, traitement de données par lots et intégration à des plateformes de workflow : tout cela tombe dans le périmètre restreint du Token Plan personnel. Il faut donc se tourner vers une API facturée à l’usage, qui autorise les appels backend commerciaux. Si vous n’utilisez que les modèles de la famille Tongyi, vous pouvez passer directement par l’API officielle facturée à l’usage de Qwen4-Max en version stable, et exploiter le cache explicite pour maîtriser le coût des entrées. Si votre application doit combiner plusieurs fournisseurs de modèles, une plateforme d’agrégation d’API vous permet d’unifier l’interface et la facturation.
💡 Conseil de choix : le canal d’accès doit être décidé en fonction de la disponibilité réelle du modèle. Si le modèle visé est déjà disponible sur APIYI apiyi.com, vous pouvez l’appeler directement via l’interface unifiée ; s’il ne l’est pas encore, développez d’abord le flux d’intégration et de calcul des coûts sur la plateforme avec un modèle déjà disponible, puis basculez le paramètre
modelune fois le modèle publié.
6.3 Aide-mémoire de décision pour Qwen4-Max-Preview
- Développeur individuel, surtout en interaction dans des outils de programmation : Token Plan plus la fenêtre nocturne de la Preview, puis passage à la version stable
qwen4-maxaprès le 25 novembre. - Équipe qui développe une application maison : API facturée à l’usage en version stable, prix unitaire choisi selon la région, cache explicite activé.
- Application multi-modèles ou phase de sélection de modèle : plateforme d’agrégation d’API multi-modèles, interface unifiée, coûts regroupés par tâche.
- Traitement de données confidentielles : vérifiez d’abord les conditions d’utilisation des données du produit concerné, puis décidez du mode d’accès.
7 Conclusion : le bon usage de la fenêtre à 8 % de Credits sur Qwen4-Max-Preview
Les 8 % de Credits nocturnes de Qwen4-Max-Preview sont une offre à durée limitée du Token Plan, valable jusqu’au 25 novembre à 24 h 00, et destinée à un usage interactif dans les outils de programmation et les outils d’agents. La version officielle Qwen4-Max est en ligne depuis le 16 novembre ; en région Pékin, le paiement à l’usage est facturé 10 yuans en entrée et 30 yuans en sortie par million de Tokens, ce qui convient aux backends d’applications et aux traitements automatisés. Credits et Tokens relèvent de deux systèmes de mesure distincts : pour comparer les coûts, il faut raisonner par tâche unitaire, en enregistrant séparément la déduction en Credits et le montant cumulé en Tokens.
Pour décider, suivez cet ordre : déterminez d’abord si la tâche relève d’une interaction dans un outil ou d’un appel depuis un backend, identifiez ensuite le produit conforme correspondant, puis mesurez le coût sur une même tâche réelle. Lorsque vous avez besoin de comparer les résultats et les coûts entre plusieurs modèles déjà disponibles, l’interface unifiée d’APIYI apiyi.com permet de réaliser cette vérification rapidement.
📚 Références
-
Documentation officielle de Qwen4-Max-Preview : spécifications du modèle, période d’ouverture et modalités d’accès
- Lien :
help.aliyun.com/zh/model-studio/qwen4-max-preview - Description : budget de sortie, paramètres de réflexion, Base URL dédiée
- Lien :
-
Documentation officielle de Qwen4-Max (version stable) : tarifs à l’usage et cache explicite
- Lien :
help.aliyun.com/zh/model-studio/qwen4-max - Description : prix unitaires par région, plafond de sortie, TTL du cache
- Lien :
-
Abonnement et avantages du Token Plan personnel : prix des forfaits, Credits et offres à durée limitée
- Lien :
help.aliyun.com/zh/model-studio/token-plan-personal-overview - Description : règles de réduction de 80 % et de 60 % la nuit, tarifs nouveaux utilisateurs, packs d’usage
- Lien :
-
Droits et règles d’usage du Token Plan : cas d’usage autorisés et interdits
- Lien :
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - Description : périmètre de l’usage interactif et conséquences en cas de violation
- Lien :
-
Usage et quotas du Token Plan : mécanisme de consommation des Credits
- Lien :
help.aliyun.com/zh/model-studio/token-plan-usage-quota - Description : les différents facteurs qui influencent la consommation de Credits
- Lien :
-
Mises à jour fonctionnelles du Token Plan : historique de mise en ligne de la Preview et de la version stable
- Lien :
help.aliyun.com/zh/model-studio/token-plan-product-updates - Description : les événements de version du 11 novembre et du 16 novembre
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil d’APIYI apiyi.com ; davantage de documentation d’intégration est disponible sur le centre de documentation docs.apiyi.com