Zusammenfassung: Dieser Beitrag erläutert den 8-%-Credits-Rabatt für Qwen4-Max-Preview in der Nacht und vergleicht drei Wege – das Token-Plan-Abo, die Pay-as-you-go-API der finalen Version und eine Multi-Modell-API-Aggregationsplattform – anhand von Nutzungsumfang, Abrechnungseinheit und Gesamtkosten pro Aufgabe.
Qwen4-Max-Preview: 8 % Credits – das Fazit vorab
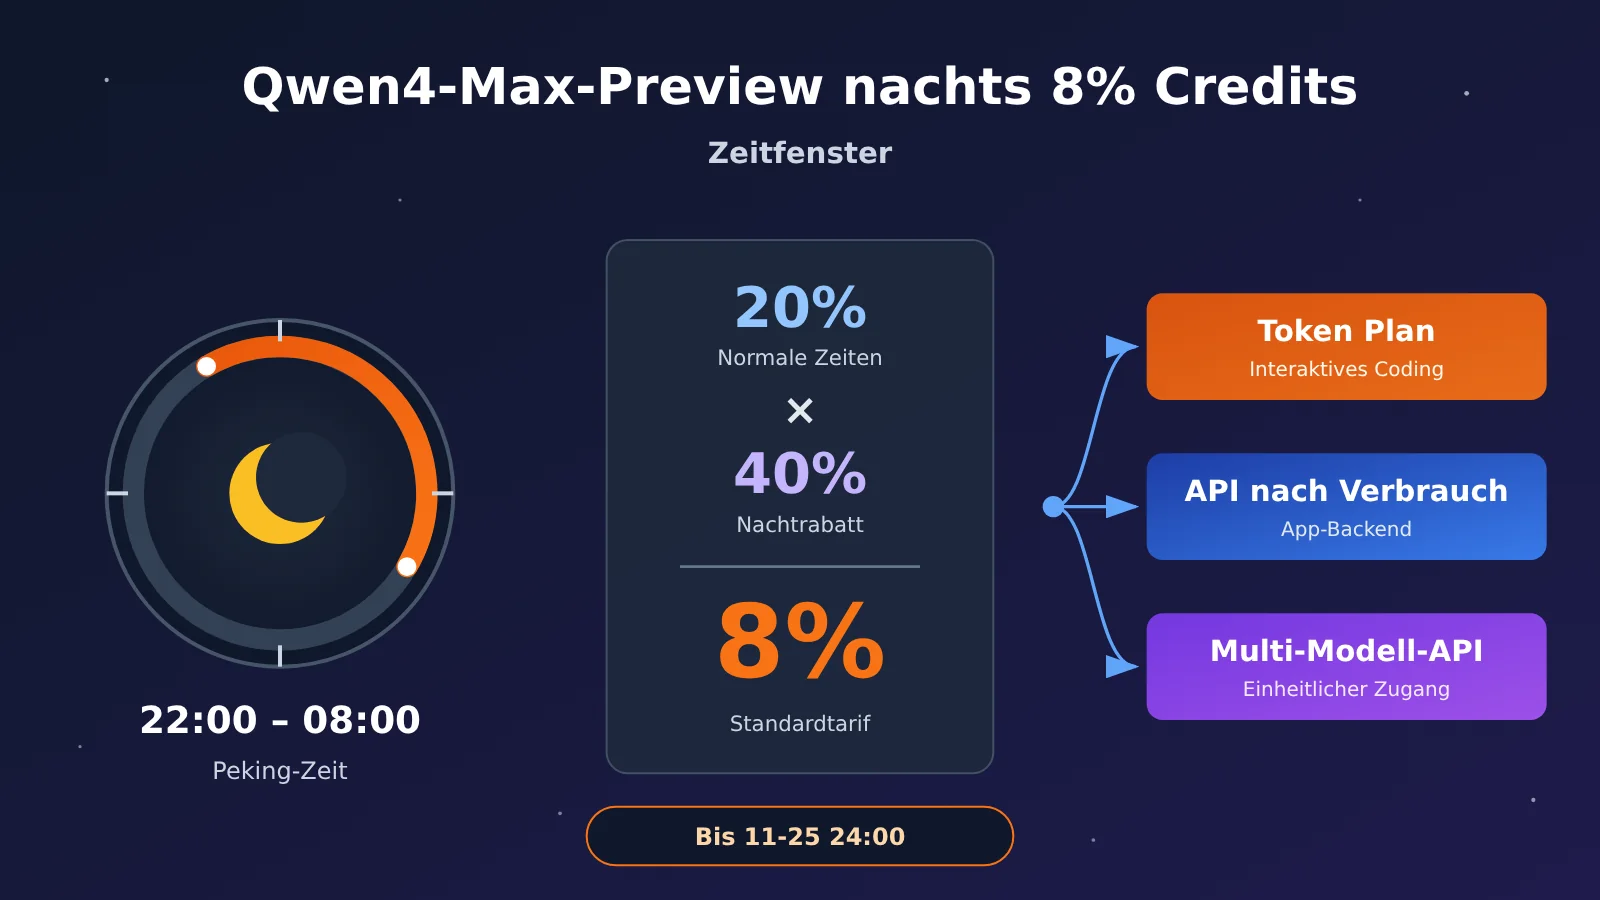
Beim Aufruf von Qwen4-Max-Preview im Token Plan beträgt der Verbrauch an Credits täglich zwischen 22:00 und 08:00 Uhr Pekinger Zeit 8 % des Standardtarifs. Dieser Satz ergibt sich aus dem 20-%-Satz für reguläre Zeitfenster und einem zusätzlichen Nachtfaktor von 40 % (20 % × 40 % = 8 %). Das Angebot gilt bis zum Ende der Preview-Phase am 25. November 2026, 24:00 Uhr Pekinger Zeit; danach wird das Modell abgeschaltet.
Das Angebot gilt nur für Szenarien, die der Token Plan zulässt – also für die interaktive Nutzung in Coding- und Agent-Tools. Wer das Modell in das Backend einer selbst betriebenen Anwendung oder in automatisierte Geschäftsprozesse einbinden will, braucht ein Pay-as-you-go-API-Produkt, das diese Nutzung erlaubt. Die am 16. November veröffentlichte finale Version Qwen4-Max bietet bereits eigene Pay-as-you-go-Preise und kann diesen Bedarf abdecken.
Im Folgenden wird zunächst die 8-%-Berechnung und die Preise des Token-Plan-Abos aufgeschlüsselt. Danach folgen die Abrechnungslogik und der Cache-Mechanismus der finalen Version. Anschließend werden die drei Aufrufvarianten nach geeigneten Aufgaben, Nutzungsform, Abrechnungseinheit und Schnittstelle verglichen und ein Berechnungsrahmen zur Kostenaggregation pro Aufgabe vorgestellt. Zum Schluss gibt es Empfehlungen, die sich nach den tatsächlichen Aufgabentypen von Entwicklern richten.
Wissenswertes: Abrechnungsbegriffe für Qwen4-Max-Preview
| Begriff | Erklärung |
|---|---|
| Credits | Verrechnungseinheit des Token-Plan-Abonnements; der Verbrauch hängt vom verwendeten Modell und der konkreten Zusammensetzung dieses Aufrufs ab |
| Token | Maßeinheit für Modell-Eingaben, Modell-Ausgaben und Reasoning-Inhalte |
| Token Plan | Ein Produkt von Alibaba Cloud, das Credits-Guthaben pro Abo-Zyklus bereitstellt; verfügbar als Personal- und Team-Version |
| API mit nutzungsbasierter Abrechnung | Modell-Service-Modell, das nach tatsächlichem Aufrufvolumen abgerechnet wird und für die Anbindung von Anwendungen vorgesehen ist |
| Cache-Treffer | Wenn wiederholt übermittelte Eingaben serverseitig wiederverwendet werden, erfolgt die Abrechnung nach den für den Cache geltenden Regeln |
| Reasoning-Token | Token, die beim Reasoning des Modells entstehen; sie belegen das Ausgabebudget und fließen in die Ausgabeabrechnung ein |
| API-Aggregationsplattform | Ein Dienst, der über eine einheitliche Schnittstelle den Aufruf verschiedener Modelle und die Verbrauchsverwaltung ermöglicht |
| Kosten pro Aufgabe | Die Summe aller Anfragen, Wiederholungsversuche, Tool-Aufrufe und Modellverbräuche, die zum Erreichen desselben Ziels nötig sind |
1 Wie der 8-%-Aktionspreis für Qwen4-Max-Preview zustande kommt
1.1 Zwei Rabattstufen kombiniert: 20 % × 40 % = 8 %
Während des Preview-Zeitraums gewährt Token Plan für Qwen4-Max-Preview zwei Stufen von Credits-Vergünstigungen:
- Regulärer Zeitraum: Der Credits-Verbrauch entspricht 20 % des Standardtarifs. Mit demselben Credits-Budget lassen sich theoretisch etwa 5-mal so viele Aufrufe durchführen wie zum Standardtarif.
- Nachtzeitraum: Täglich von 22:00 bis 08:00 Uhr Pekinger Zeit kommt auf den bereits reduzierten Satz von 20 % noch ein Faktor von 40 % hinzu.
- Kombiniertes Ergebnis: 20 % × 40 % = 8 %, also 8 % des Standardtarifs.
Ein offizielles Beispiel verdeutlicht die Proportionen: Würde ein Aufruf zum Standardtarif 100 Credits kosten, so sind es im regulären Zeitraum tatsächlich 20 Credits und im Nachtzeitraum 8 Credits. Dies ist lediglich ein mathematisches Beispiel zur Veranschaulichung der Proportionen; wie viele Credits ein einzelner Aufruf tatsächlich verbraucht, richtet sich nach den Verbrauchsdetails in der Konsole. Der Anbieter behält sich außerdem das Recht vor, die Vergünstigungen je nach Betriebslage anzupassen.
1.2 Zeitrahmen des befristeten Qwen4-Max-Preview-Fensters
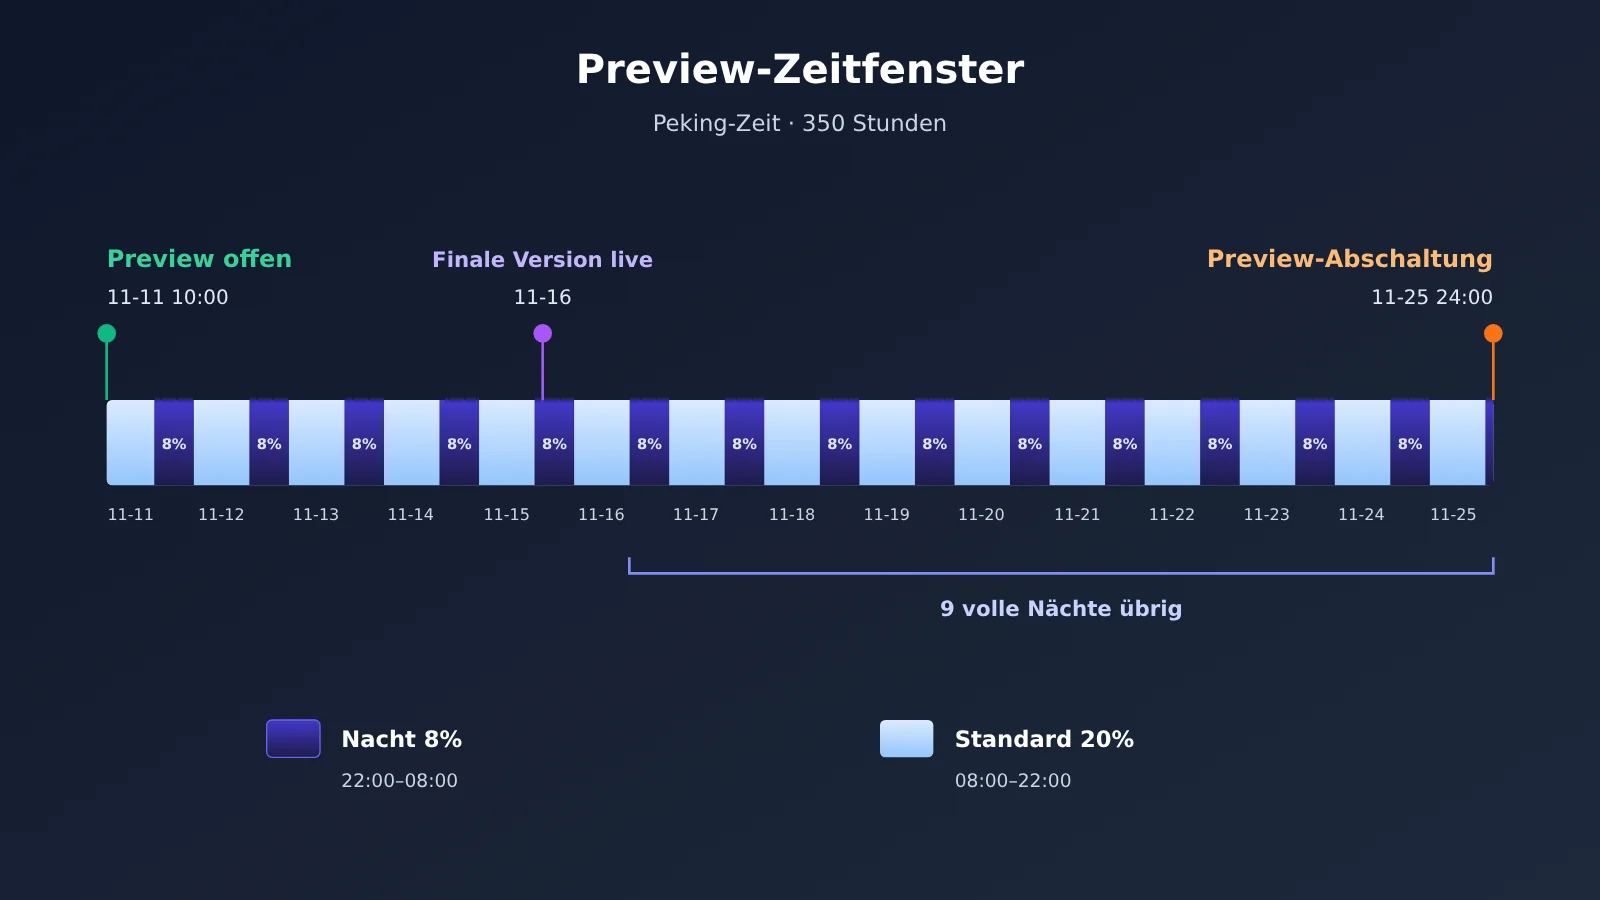
Preview wurde am 11. November 2026 um 10:00 Uhr geöffnet und endet am 25. November um 24:00 Uhr (jeweils Pekinger Zeit); insgesamt sind es 350 Stunden. Vom heutigen 16. November aus betrachtet verbleiben als vollständige Nachtzeiträume die 9 Nächte vom Abend des 16. November bis zum Morgen des 25. November. Am Abend des 25. November umfasst der Nachtzeitraum nur noch 2 Stunden von 22:00 bis 24:00 Uhr; danach wird Preview abgeschaltet.
Nachdem am 16. November die finale Version Qwen4-Max an den Start gegangen ist, bleibt der Abschalttermin von Preview unverändert. Die offizielle Modelldokumentation empfiehlt bereits die finale Version; Workflows, die innerhalb des Preview-Fensters entstanden sind, sollten daher parallel für die Migration auf qwen4-max vorbereitet werden.
2 Wie man Credits für den Token Plan kauft und verbraucht
2.1 Preise und Kontingente der Token-Plan-Pakete für Privatnutzer
Stand 16. November 2026 listet die offizielle Seite des Alibaba-Cloud-Token-Plans für Privatnutzer folgende Pakete. Monatskontingente und Preise wurden am 9. November angepasst; ältere Screenshots und in Artikeln genannte Preise gelten nicht mehr.
| Paket | Monatspreis | Monatliche Credits | Parallele Agenten | Preis für neue Nutzer |
|---|---|---|---|---|
| Lite | 39 Yuan | 20.000 | 1–2 | 19,5 Yuan/Monat |
| Essential | 79 Yuan | 45.000 | 2–3 | 39,5 Yuan/Monat |
| Standard | 139 Yuan | 80.000 | 3–4 | Kein Neukundenrabatt auf der Seite angegeben |
| Pro | 312 Yuan | 200.000 | 6–8 | Kein Neukundenrabatt auf der Seite angegeben |
Der Neukundenpreis gilt bis zum 30. November 2026, 23:59:59 (UTC+8), und nur für Konten, die zuvor noch nie ein Token-Plan-Paket für Privatnutzer gekauft haben. Der Neukundenrabatt senkt den Abonnementpreis des Pakets; die 20 % bzw. 8 % bei Preview senken den Credits-Verbrauch beim Modellaufruf – beide wirken an unterschiedlichen Stellen.
2.2 Regeln für zusätzliche Verbrauchspakete beim Token Plan
Ist das Kontingent eines Pakets aufgebraucht, lassen sich zusätzliche Verbrauchspakete kaufen. Es gelten folgende Regeln:
- Preis 100 Yuan pro Stück und Monat, jedes Paket enthält 20.000 Credits.
- Man muss bereits ein gültiges Paket besitzen; maximal 5 Pakete gleichzeitig.
- Die Laufzeit beträgt einen Monat, nicht verbrauchtes Kontingent verfällt zum Laufzeitende.
- Das Kontingent eines Verbrauchspakets ist unabhängig vom ursprünglichen Monatskontingent des Pakets.
2.3 Das Verhältnis zwischen Credits und Token bei der Abrechnung
Credits sind die Abrechnungseinheit des Token Plan, Token die Recheneinheit des Modells – die beiden lassen sich nicht eins zu eins umrechnen. Laut offizieller Dokumentation hängt davon, wie viele Credits ein Aufruf kostet, von folgenden Faktoren ab:
- dem Modelltyp und dessen Abrechnungsfaktor;
- der Anzahl der Input-Token und davon der Anzahl der Token, die aus dem Cache bedient wurden;
- der Anzahl der Output-Token, einschließlich der Thinking-Token;
- der Anzahl der Tool-Aufrufe sowie zusätzlicher Aufrufe durch integrierte Tools und Subtasks.
Deshalb lässt sich aus 39 Yuan und 20.000 Credits kein Preis pro Million Token für Qwen4-Max-Preview ableiten. Offiziell gibt es keine separate Preisangabe pro Million Token für Preview, und eine nutzungsbasierte Abrechnung für Preview wird nicht unterstützt. Als reale Referenz lässt sich festhalten: Ein Entwickler baute in Qoder ein interaktives Greifautomaten-Projekt, brauchte dafür etwa 75 Minuten und schätzte den Verbrauch auf rund 65 Credits. Das ist ein einzelner Datensatz für eine bestimmte Aufgabe in einem bestimmten Tool und dient nur dazu, die Größenordnung des Verbrauchs einzuschätzen.
3 Vergleich der Abrechnung zwischen Qwen4-Max-Preview und der offiziellen Version
3.1 Preview: ausschließlich über den Token-Plan-Zugang
Der Zugang zu Preview ist fest vorgegeben: Sie abonnieren den Token Plan (Einzel- oder Teamversion), beziehen einen paketspezifischen API-Schlüssel, verwenden die dedizierte Base-URL https://token-plan.cn-beijing.maas.aliyuncs.com und setzen die Modell-ID auf qwen4-max-preview (Alias qwen4.0-max-preview, der in der Abrechnung einheitlich als letzterer erscheint). Das Modell ist mit den Schnittstellenspezifikationen von OpenAI Chat Completions, Responses und Anthropic Messages kompatibel.
Das Ausgabebudget von Preview beträgt 393.216 Tokens und wird von den Denkinhalten und der finalen Antwort gemeinsam genutzt; die standardmäßige Reasoning-Intensität ist xhigh. Wenn Sie von anderen Modellen migrieren und max_tokens nur anhand der Länge der finalen Antwort festlegen, kann die Antwort abgeschnitten werden, weil die Denkinhalte das Budget aufbrauchen.
3.2 Offizielle Version Qwen4-Max: Preise der Pay-as-you-go-API
Die offizielle Version qwen4-max ist am 16. November gestartet. Sie lässt sich sowohl im Token Plan als auch per Pay-as-you-go nutzen. Die folgenden Preise für die nutzungsbasierte Abrechnung der offiziellen Version stammen von der offiziellen Modellseite (in RMB, angegeben in Yuan pro Million Tokens):
| Bereitstellungsregion | Eingabe | Ausgabe (inkl. Denken und Antwort) |
|---|---|---|
| China Festland, Nordchina 2 (Peking) | 10 Yuan | 30 Yuan |
| USA, Virginia | 10 Yuan | 30 Yuan |
| Deutschland, Frankfurt | 10 Yuan | 30 Yuan |
| Japan, Tokio | 10 Yuan | 30 Yuan |
| China, Hongkong | 10 Yuan | 30 Yuan |
| Singapur | 10,938 Yuan | 32,813 Yuan |
Für die Region Peking gibt es zusätzlich ein Freikontingent von 1 Million Tokens, das 90 Tage ab dem Startzeitpunkt gilt – etwa nach Aktivierung von Bailian, Modellveröffentlichung oder Genehmigung des Antrags; im Detail gelten die Regeln der offiziellen Seite. Diese Preise gelten nur für die offizielle Version und lassen sich nicht zur Rückrechnung des Standard-Credits-Verbrauchs von Preview verwenden.
Auch die Parameter der offiziellen Version unterscheiden sich von Preview: Das Kontextfenster umfasst ebenfalls 1.000.000 Tokens, die maximale Ausgabe beträgt im Denkmodus 262.144 Tokens und im Nicht-Denkmodus 131.072 Tokens; die standardmäßige Reasoning-Intensität ist high, das standardmäßige Denkbudget 131.072. Bei der Migration sollten Sie die Einstellungen für die Ausgabeobergrenze erneut prüfen.
3.3 Explizites Caching in der offiziellen Version Qwen4-Max
Die offizielle Version unterstützt explizites Caching, mit dem sich feste Eingabe-Präfixe wie Systemeingabeaufforderungen, Tool-Beschreibungen und Referenzdokumente wiederverwenden lassen. Das explizite Caching unterstützt die drei Schnittstellen OpenAI Chat Completions, Responses und Anthropic Messages; die TTL ist wahlweise 5 Minuten oder 1 Stunde.
Bei mehrstufigen Agent-Aufgaben werden in jeder Runde meist dieselben Systemanweisungen und Tool-Beschreibungen erneut übergeben – genau hier lässt sich mit Caching am meisten sparen. Das Caching hat eigene Abrechnungsregeln; die konkreten Einzelpreise finden Sie auf der Seite zur Abrechnung von Modellaufrufen der jeweiligen Region.
4 Für wen sich die drei Aufrufvarianten von Qwen4-Max-Preview jeweils eignen
4.1 Vergleich der drei Lösungen
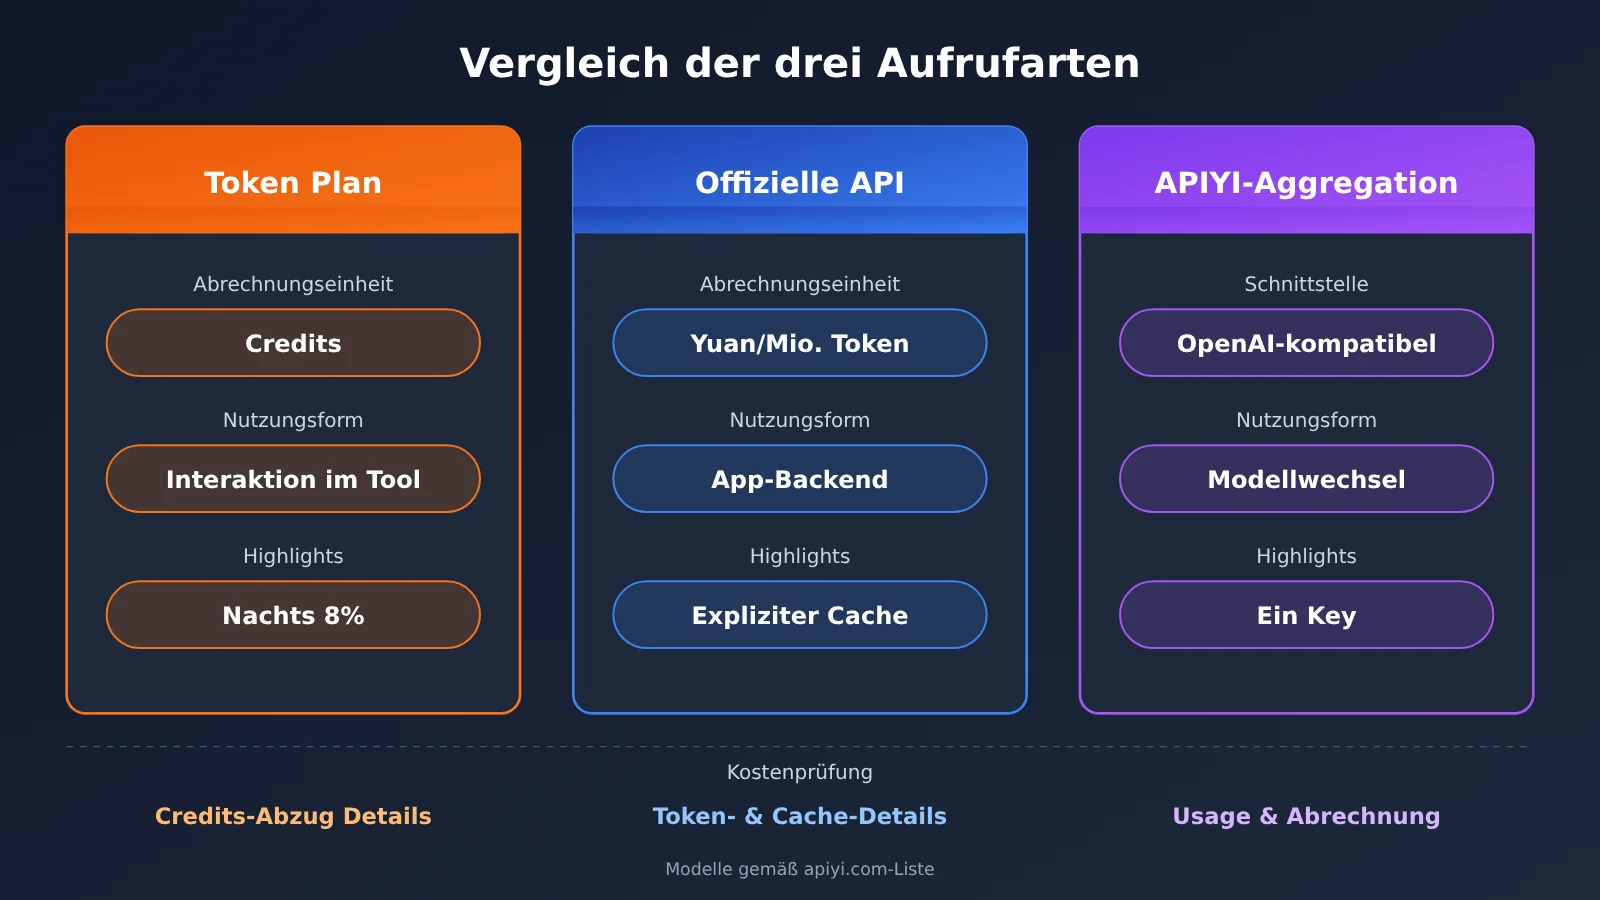
| Dimension | Token-Plan-Abonnement | Kostenpflichtige API der offiziellen Version | Multi-Modell-API-Aggregationsplattform |
|---|---|---|---|
| Geeignete Aufgaben | Interaktive Programmierung, Agent-Dialoge | Eigenes Anwendungs-Backend, automatisierte Geschäftsprozesse | Multi-Modell-Anwendungen, Modellvergleich und -wechsel |
| Zulässige Nutzungsform | Ausschließlich interaktive Nutzung in Programmier- und Agent-Tools | Anwendungsintegration | Anwendungsintegration, einheitliche Verwaltung mehrerer Modelle |
| Abrechnungseinheit | Credits | Yuan pro Million Token (je nach Region) | Token-Einzelpreis gemäß den vom Plattform-Preisdienst veröffentlichten Angaben |
| Laufzeit des Kontingents | Pakete und Nutzungskontingente monatlich, verfallen bei Ablauf | Abrechnung nach Verbrauch; kostenloses Kontingent für Peking 90 Tage | Abrechnung nach Verbrauch |
| Schnittstelle | Dedizierte Base-URL und paketspezifischer Key | Offizielle Bailian-Schnittstelle | OpenAI-kompatible Schnittstelle, z. B. APIYI apiyi.com |
| Methode zur Kostenprüfung | Tatsächliche Credit-Abzugsposten in der Konsole | Aggregation nach Token-Details und Caching-Abrechnung | Aggregation nach dem usage-Feld der Anfrage und den Plattformabrechnungen |
4.2 Token-Plan-Abonnement: Geeignet für interaktive Programmierung innerhalb von Tools
Der Token-Plan unterstützt Tools wie Claude Code, Cursor, Qwen Code, Qoder, Qoder CN und OpenClaw; maßgeblich ist dabei die offizielle Dokumentation zur Tool-Integration. Wenn Entwickler in diesen Tools aktiv Aufgaben starten, greift der nächtliche 8%-Rabatt von Preview direkt, und die Kosten werden bereits im Voraus in Form von Credits fixiert.
Die Nutzungsgrenzen sind in der offiziellen Berechtigungsrichtlinie festgehalten: Keine Batch-Aufrufe per Automatisierungsskript, der Plan-Schlüssel darf nicht im Backend einer selbstgebauten Anwendung verwendet werden, nicht-interaktive Batch-Aufrufe sind nicht erlaubt, und die Plan-Vorteile dürfen nicht über Workflow-Plattformen wie Dify, n8n oder Coze oder über API-Testtools wie Postman oder Insomnia missbräuchlich genutzt werden. Eine Überschreitung des Rahmens kann zur Aussetzung des Abonnements oder zur Sperrung des Schlüssels führen. Darüber hinaus legt die Abonnement-Richtlinie der Personal-Version fest, dass Eingaben und generierte Inhalte während der Nutzung zur Serviceverbesserung und Modelloptimierung verwendet werden; bevor vertrauliche Daten verarbeitet werden, sollte man die Vereinbarung prüfen.
4.3 Offizielle Pay-as-you-go-API: Geeignet für die Anbindung von Anwendungen in der Produktionsversion
Für selbstgebaute Anwendungs-Backends, Batch-Aufgaben und Automatisierungsabläufe sollte man die Pay-as-you-go-API der Produktionsversion von qwen4-max verwenden. Die Abrechnungsgrundlage ist der öffentliche Stückpreis in Yuan pro Million Token; zusammen mit explizitem Caching lassen sich die Kosten pro Anfrage einzeln nachvollziehen. Dieser Weg bietet keine so großen Rabatte wie bei Credits, aber Nutzungsform und Abrechnungsmethode sind klar und regelkonform.
4.4 Multi-Modell-API-Aggregationsplattformen: geeignet für Teams, die eine einheitliche Schnittstelle benötigen
Wenn eine Anwendung gleichzeitig Modelle von OpenAI, Claude, Gemini und anderen Anbietern nutzen muss, lassen sich die Aufrufe über eine Aggregationsplattform mit einem einzigen API-Schlüssel und einem Satz OpenAI-kompatibler Schnittstellen abwickeln – inklusive zentraler Verwaltung des Verbrauchs. APIYI ist eine dieser Plattformen. Wichtig zu erwähnen: Ein Beitrag im APIYI-Hilfezentrum vom 13. November hält fest, dass Qwen4 noch nicht in der Modellübersicht und der Preis-Schnittstelle auftaucht, und ein öffentlicher Artikel vom 16. November kennzeichnet qwen4-max ebenfalls als noch nicht gelistet. Das sind Momentaufnahmen von jenem Tag – ob das Modell inzwischen verfügbar ist, richtet sich nach der aktuellen Modellübersicht und Preis-Schnittstelle.
🎯 Technischer Hinweis: Beim Aufbau einer Multi-Modell-Anwendung können Sie zunächst mit demselben Code bei APIYI apiyi.com mehrere bereits gelistete Modelle daraufhin vergleichen, wie sie sich auf Ihrer Aufgabe schlagen. Sobald das Zielmodell gelistet ist, genügt eine Änderung des Parameters
model, um zu wechseln.
5 Wie Entwickler die tatsächlichen Kosten von Qwen4-Max-Preview und der API berechnen
5.1 Berechnungsrahmen für die Kosten pro Aufgabe bei Qwen4-Max
Ein niedriger Modell-Stückpreis bedeutet nicht automatisch, dass die Gesamtkosten für die Erledigung einer Aufgabe niedrig sind. Eine Agent-Aufgabe kann Dutzende Anfragen, umfangreichen wiederholten Kontext, längere Thinking-Ausgaben und Wiederholungsversuche nach Fehlern umfassen. Beim Vergleich von Lösungen sollte man daher „das Erreichen desselben Ziels“ als Einheit zugrunde legen und die Kosten anhand der Abrechnungsdetails der jeweiligen Produkte zusammenführen:
| Kostenposition | Berechnung bei nutzungsbasierter API-Abrechnung | Erfassung im Credits-Modell |
|---|---|---|
| Nicht gecachte Eingabe | Nicht gecachte Eingabemenge × jeweiliger Eingabepreis | Direkte Erfassung der in der Konsole tatsächlich abgebuchten Credits |
| Cache | Kosten für Cache-Lesen, Cache-Schreiben und Cache-Speicherung, berechnet nach den Regeln der jeweiligen Region | Bereits in den tatsächlich abgebuchten Credits enthalten |
| Ausgabe | Ausgabemenge (inkl. abrechenbarer Thinking-Token) × Ausgabepreis | Bereits in den tatsächlich abgebuchten Credits enthalten |
| Tools und Wiederholungen | Kosten für Tool-Aufrufe + sämtlicher Verbrauch durch Wiederholungsanfragen | Bereits in den tatsächlich abgebuchten Credits enthalten |
Als Formel ausgedrückt: Aufgabenkosten = nicht gecachte Eingabemenge × Eingabepreis + Cache-Lese-/Schreib- und Speicherkosten + Ausgabemenge (inkl. abrechenbarer Thinking-Token) × Ausgabepreis + Tool-/Wiederholungskosten usw. Das Credits-Modell rechnet nicht in Token um, sondern erfasst direkt die Differenz des Credits-Guthabens zu Beginn und am Ende der Aufgabe. Da die Einheiten der beiden Ergebnisse unterschiedlich sind, sollte man beim Vergleich getrennt bewerten, „wie viel Yuan eine Aufgabe gekostet hat“ und „wie viele Credits pro Aufgabe abgebucht wurden“, und dann unter Berücksichtigung der monatlichen Tarifgebühr das Preis-Leistungs-Verhältnis beurteilen.
5.2 Token-Verbrauch jeder Anfrage per Code protokollieren
Die Abrechnung des nutzungsbasierten Modells stützt sich auf das Feld usage, das jede Anfrage zurückliefert. Das folgende Minimalbeispiel zeigt, wie man den Verbrauch über die OpenAI-kompatible Schnittstelle ausliest. Ersetzen Sie die Modell-ID durch ein Modell, das im Modellkatalog der Plattform bereits verfügbar ist:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI-kompatible Schnittstelle
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_ID",  # Maßgeblich ist ein Modell, das im Modellkatalog der Plattform verfügbar ist
    messages=[{"role": "user", "content": "总结这段日志中的错误类型"}],
)
print(resp.usage)  # prompt_tokens / completion_tokens usw. erfassen, um Kosten zuzuordnen
Vollständigen Code zur Kostenzuordnung pro Aufgabe anzeigen
import openai
from dataclasses import dataclass, field

@dataclass
class TaskLedger:
    """Token-Verbrauch pro Aufgabe erfassen; der Stückpreis wird vom Aufrufer je nach gewähltem Produkt und Region übergeben"""
    input_price_per_m: float          # Yuan pro Million Token, nicht gecachte Eingabe
    output_price_per_m: float         # Yuan pro Million Token, Ausgabe (inkl. Reasoning)
    cache_cost: float = 0.0           # Kosten für Cache-Lesen/-Schreiben und -Speicherung, manuell nach Einzelposten eintragen
    tool_cost: float = 0.0            # Kosten für Tool-Aufrufe
    records: list = field(default_factory=list)

    def add(self, usage):
        cached = 0
        details = getattr(usage, "prompt_tokens_details", None)
        if details is not None:
            cached = getattr(details, "cached_tokens", 0) or 0
        self.records.append({
            "uncached_input": usage.prompt_tokens - cached,
            "output": usage.completion_tokens,
        })

    def total(self) -> float:
        inp = sum(r["uncached_input"] for r in self.records)
        out = sum(r["output"] for r in self.records)
        return (inp / 1e6 * self.input_price_per_m
                + out / 1e6 * self.output_price_per_m
                + self.cache_cost + self.tool_cost)

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Bitte den Stückpreis entsprechend dem tatsächlich gewählten Produkt und der Region eintragen
ledger = TaskLedger(input_price_per_m=0.0, output_price_per_m=0.0)

for attempt in range(3):  # Auch der Verbrauch durch Wiederholungsversuche zählt zu den Aufgabenkosten
    resp = client.chat.completions.create(
        model="YOUR_MODEL_ID",
        messages=[{"role": "user", "content": "修复 query.py 中的分页错误"}],
    )
    ledger.add(resp.usage)
    if resp.choices[0].finish_reason == "stop":
        break

print(f"本任务请求数: {len(ledger.records)},合计成本: {ledger.total():.4f} 元")
5.3 Beispielrechnung: Eine Agent-Aufgabe in der Region Peking (offizielle Version)
Die folgende Rechnung ist ein Beispiel; die Zahlen dienen nur zur Veranschaulichung der Formel. Angenommen, eine Aufgabe wird in der offiziellen Version von Qwen4-Max in der Region Peking nutzungsabhängig (Pay-as-you-go) aufgerufen, mit insgesamt 2.000.000 nicht zwischengespeicherten Eingabe-Tokens und 50.000 Ausgabe-Tokens (inklusive Denkprozess), ohne Cache und ohne Abrechnungstools:
- Eingabe: 2 × 10 Yuan = 20 Yuan
- Ausgabe: 0,05 × 30 Yuan = 1,5 Yuan
- Gesamt: 21,5 Yuan
Dieses Ergebnis zeigt, dass die Kosten einer Langkontext-Agent-Aufgabe hauptsächlich durch die wiederholt übermittelte Eingabe entstehen. Wenn man die darin festen System-Eingabeaufforderungen und Tool-Beschreibungen auf explizites Caching umstellt, ändert sich die Struktur des Eingabeteils; wie viel sich konkret einsparen lässt, hängt von der Cache-Trefferquote und dem Einheitspreis für den Cache in der jeweiligen Region ab. Bei derselben Aufgabe im Credits-Tarif erfassen Sie direkt die tatsächlich abgezogene Menge und rechnen Sie nicht diese 21,5 Yuan in Credits um.
💰 Kostenprüfung: Wenn Sie die Kosten pro Aufgabe mehrerer bereits verfügbarer Modelle bei derselben Aufgabe gleichzeitig vergleichen möchten, können Sie über die einheitliche Schnittstelle von APIYI apiyi.com die
usagejedes Modells auslesen und mit dem obigen TaskLedger nach derselben Methodik aggregieren.
6 Wie man das Aufrufschema für die Qwen4-Max-Preview-Phase wählt
6.1 Interaktive Programmierung: Lange Aufgaben mit dem Token Plan im Nachtfenster erledigen
Wenn Sie hauptsächlich in Tools wie Claude Code, Cursor oder Qoder programmieren, passt der Token Plan am besten zu den Preview-Vorteilen. Konkret gehen Sie so vor:
- Legen Sie interaktive Aufgaben, die viel Kontext und langes Nachdenken erfordern, in den Zeitraum zwischen 22:00 und 08:00 und starten und verfolgen Sie sie selbst im Tool – etwa das Verstehen einer Codebasis, das Debuggen über mehrere Module hinweg oder die Analyse langer Dokumente.
- Reservieren Sie ein Ausgabebudget für die Denkinhalte; bei der Preview teilen sich Denken und Antwort die 393.216 Tokens.
- Notieren Sie zu Beginn und am Ende jeder Aufgabe den Credits-Kontostand, um eigene Verbrauchsdaten pro Aufgabe aufzubauen.
- Vergleichen Sie beim Erstkauf die beiden Neukundenpreise Lite 19,5 Yuan und Essential 39,5 Yuan; das Angebot gilt bis zum 30. November.
- Führen Sie vor dem 25. November mit der offiziellen Version
qwen4-maxeinmal Ihre üblichen Aufgaben aus, um das Ausgabelimit und die Einstellungen für die Reasoning-Intensität zu prüfen.
6.2 Eigene Anwendungen und automatisierte Geschäftsprozesse: Pay-as-you-go-API oder Aggregationsplattform wählen
Backend-Dienste, geplante Aufgaben, Batch-Datenverarbeitung sowie die Anbindung an Workflow-Plattformen fallen alle unter die Beschränkungen der persönlichen Token-Plan-Version. Hier sollte man eine Pay-as-you-go-API wählen, die kommerzielle Backend-Aufrufe erlaubt. Wenn Sie ausschließlich Modelle der Tongyi-Reihe nutzen, können Sie direkt die offizielle Pay-as-you-go-API der finalen Version Qwen4-Max anbinden und mit explizitem Caching die Eingabekosten steuern. Muss eine Anwendung mehrere Modelle kombinieren, bietet sich eine API-Aggregationsplattform mit einheitlicher Schnittstelle und Abrechnung an.
💡 Auswahlhinweis: Bei der Anbindung sollten Sie sich am tatsächlichen Verfügbarkeitsstatus des Modells orientieren. Ist das Zielmodell bereits auf APIYI apiyi.com gelistet, können Sie es direkt über die einheitliche Schnittstelle aufrufen; ist es noch nicht gelistet, können Sie auf der Plattform zunächst mit den bereits verfügbaren Modellen die Entwicklung der Schnittstellen- und Kostenkalkulationsprozesse abschließen und nach der Listung den Parameter
modelwechseln.
6.3 Schnellreferenz für Entscheidungen rund um Qwen4-Max-Preview
- Einzelentwickler, die hauptsächlich in Programmier-Tools interagieren: Token Plan plus Preview-Nachtfenster, nach dem 25. November auf die offizielle Version
qwen4-maxumsteigen. - Teams, die eigene Anwendungen entwickeln: offizielle Pay-as-you-go-API, Einzelpreis je nach Region wählen, explizites Caching aktivieren.
- Multi-Modell-Anwendungen oder Modellauswahlphase: Multi-Modell-API-Aggregationsplattform, einheitliche Schnittstelle, Kosten nach Aufgabe zuordnen.
- Verarbeitung vertraulicher Daten: Zuerst die Datenverwendungsbedingungen des jeweiligen Produkts prüfen, dann über die Anbindungsmethode entscheiden.
7 Fazit: Die richtige Nutzung des 8-%-Credits-Fensters von Qwen4-Max-Preview
Die nächtlichen 8 % Credits bei Qwen4-Max-Preview sind ein zeitlich begrenztes Angebot innerhalb des Token Plans, gültig bis zum 25. November um 24:00 Uhr, und gelten für die interaktive Nutzung in Programmier- und Agent-Tools. Die offizielle Version Qwen4-Max ist bereits am 16. November an den Start gegangen; in der Region Peking liegen die Pay-as-you-go-Preise bei 10 Yuan für den Input und 30 Yuan für den Output pro Million Token – passend für Anwendungs-Backends und automatisierte Abläufe. Credits und Token gehören zu zwei getrennten Abrechnungssystemen. Beim Kostenvergleich sollte man sich an der einzelnen Aufgabe orientieren und sowohl die über Credits abgedeckten Beträge als auch die nach Token zusammengefassten Beträge getrennt erfassen.
Bei der Entscheidung kann man dieser Reihenfolge folgen: Zuerst klären, ob es sich um eine Interaktion innerhalb eines Tools oder um einen Backend-Aufruf handelt, dann das passende regelkonforme Produkt festlegen und schließlich die Kosten mit derselben Aufgabe real messen. Wenn Sie Wirkung und Kosten mehrerer bereits verfügbarer Modelle vergleichen möchten, lässt sich das über die einheitliche Schnittstelle von APIYI apiyi.com schnell verifizieren.
📚 Referenzen
-
Offizielle Dokumentation zu Qwen4-Max-Preview: Modellspezifikationen, Verfügbarkeitszeitpunkt und Integrationswege
- Link:
help.aliyun.com/zh/model-studio/qwen4-max-preview - Beschreibung: Output-Budget, Thinking-Parameter, dedizierte Base-URL
- Link:
-
Offizielle Dokumentation zur finalen Version von Qwen4-Max: Pay-as-you-go-Preise und explizites Caching
- Link:
help.aliyun.com/zh/model-studio/qwen4-max - Beschreibung: Einzelpreise je Region, Output-Obergrenze, Cache-TTL
- Link:
-
Token Plan – Abonnement und Vorteile der Personal Edition: Paketpreise, Credits und zeitlich begrenzte Angebote
- Link:
help.aliyun.com/zh/model-studio/token-plan-personal-overview - Beschreibung: Regeln zum 80-%-Rabatt und zum 60-%-Nachtrabatt, Neukundenpreise, Nutzungspakete
- Link:
-
Token Plan – Berechtigungen und Nutzungsrichtlinien: erlaubte und untersagte Einsatzszenarien
- Link:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - Beschreibung: Umfang der interaktiven Nutzung und Folgen bei Verstößen
- Link:
-
Token Plan – Nutzung und Kontingente: Mechanismus des Credits-Verbrauchs
- Link:
help.aliyun.com/zh/model-studio/token-plan-usage-quota - Beschreibung: Faktoren, die den Credits-Verbrauch beeinflussen
- Link:
-
Token Plan – Funktionsupdates: Protokoll der Veröffentlichung von Preview- und finaler Version
- Link:
help.aliyun.com/zh/model-studio/token-plan-product-updates - Beschreibung: Versionsereignisse vom 11. und 16. November
- Link:
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gern über die Startseite von APIYI apiyi.com – weitere Integrationsunterlagen finden Sie im Dokumentationszentrum unter docs.apiyi.com