Nota do autor: compare o custo por tarefa bem-sucedida sob o mesmo padrão de entrega entre a assinatura do ChatGPT Dots e um Agent construído internamente, considerando modelo, infraestrutura, manutenção e revisão humana.
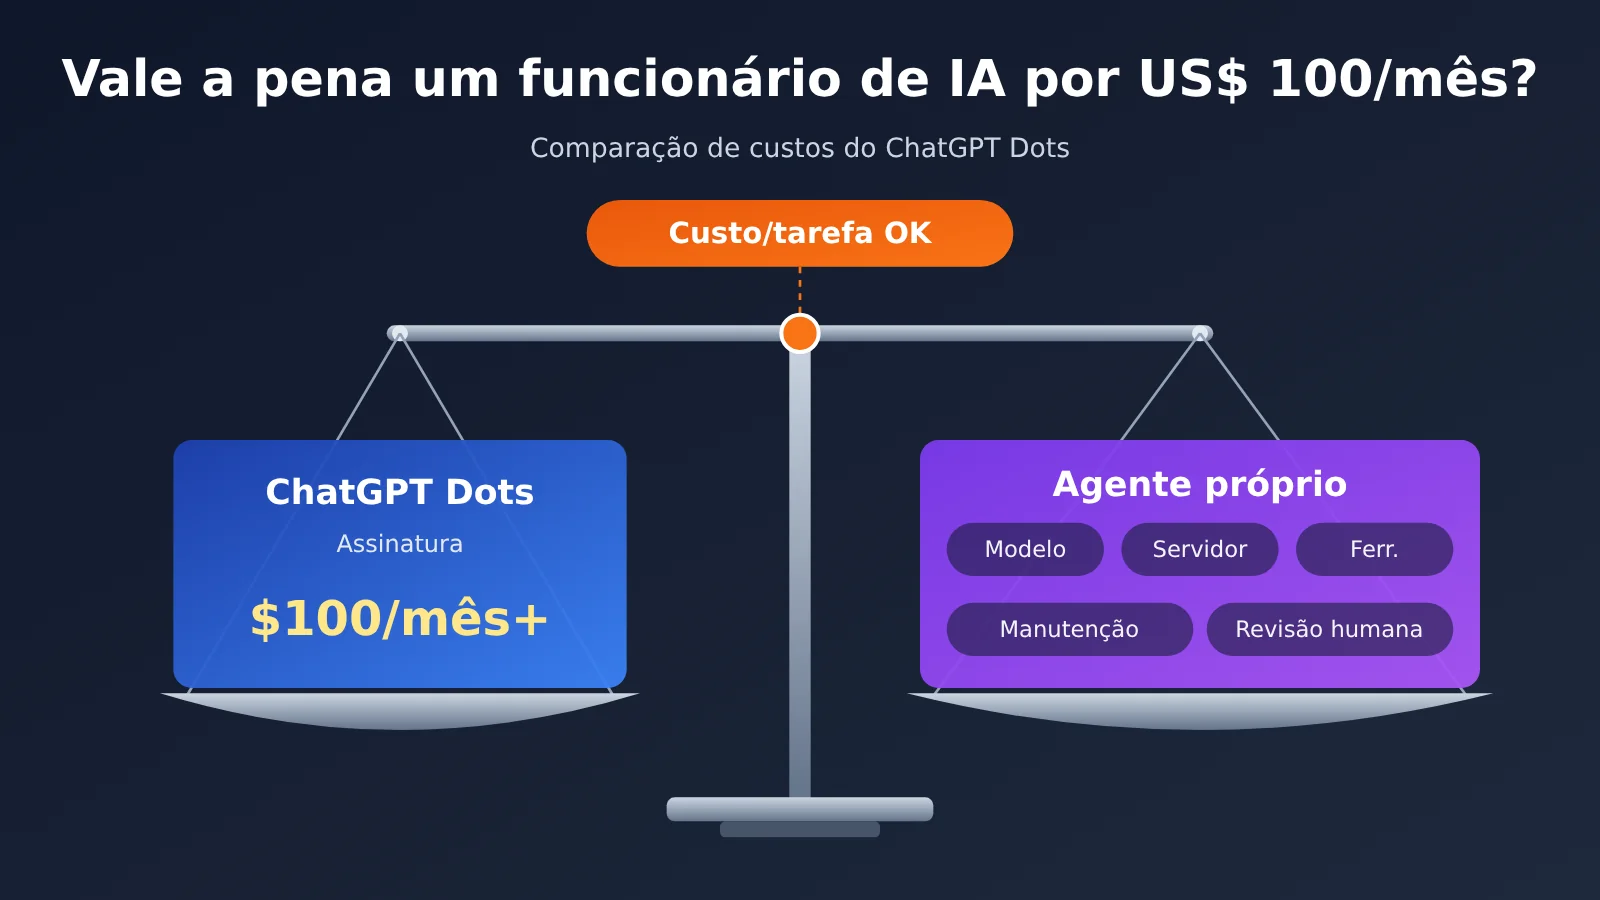
Conclusão principal: para saber se “gastar 100 dólares por mês para manter um funcionário de IA” vale a pena, é preciso olhar para o custo total de concluir uma tarefa qualificada sob o mesmo padrão de entrega — a mensalidade e o preço unitário do Token são apenas parte da conta. Segundo os materiais oficiais de 16 de novembro de 2026, a porta de entrada para usuários individuais usarem o ChatGPT Dots é o plano Pro 100 (US$ 100/mês), que já vem com computador na nuvem, contexto de longo prazo, coordenação de tarefas e conexão com aplicativos. Em uma amostra hipotética, o custo de modelo de um Agent construído internamente para 300 tarefas por mês fica entre US$ 33 e US$ 66, mas isso ainda não inclui servidor, ferramentas, desenvolvimento e manutenção, novas tentativas após falhas e revisão humana. Qual caminho sai mais barato só dá para concluir depois de testar com o mesmo lote de tarefas.
Este artigo primeiro decompõe os critérios de preço e o escopo de capacidades da assinatura Dots, depois divide o custo de um Agent construído internamente em cinco categorias — modelo, infraestrutura, ferramentas, desenvolvimento e manutenção — e usa os preços Claude da APIYI para demonstrar o cálculo do custo de Token por tarefa. Em seguida, compara Dots, Agent de modelo único e Agent multimodelo em seis dimensões, apresentando um método de experimento controlado centrado no “custo por tarefa bem-sucedida”. Por fim, oferece recomendações de escolha para três perfis de necessidade — usuário individual, desenvolvedor intensivo e empresa — e apresenta formas de gestão de custos com uso combinado de assinatura e API.
Para saber: 8 termos para entender o custo de um funcionário de IA
| Termo | Explicação |
|---|---|
| Assinatura Pro | Plano do ChatGPT pago mensalmente, que inclui os benefícios e a cota de uso correspondentes; Pro 100, Pro 200 e Pro 500 podem todos usar o Dots |
| Dot | Agente pessoal residente no ChatGPT Dots, com seu próprio computador na nuvem e navegador, capaz de avançar continuamente tarefas delegadas |
| Token | Unidade de medida da entrada e da saída de conteúdo do modelo; a API é cobrada por milhão de Token |
| Leitura de cache | O conteúdo de prefixo repetido na requisição (como comandos de sistema e definições de ferramentas) reaproveita resultados de processamento já existentes, com preço unitário muito menor que o da entrada normal |
| Gravação de cache | O primeiro salvamento de um prefixo reutilizável, para que requisições posteriores possam lê-lo; as regras de cobrança seguem o console da plataforma |
| Custo de infraestrutura | Despesas com servidores, contêineres, bancos de dados, armazenamento e ambiente de execução necessários para construir um Agente próprio |
| Taxa de sucesso das tarefas | Segundo um critério único de aceitação, a proporção de tarefas entregues em conformidade após uma ou mais execuções |
| Custo por tarefa bem-sucedida | O gasto total de todas as execuções (incluindo novas tentativas que falharam), mais infraestrutura e revisão humana, dividido pelo número de tarefas entregues em conformidade |
1 O que os US$ 100 por mês do ChatGPT Dots entregam
1.1 Preços do ChatGPT Dots para Pro individual e Enterprise
O ChatGPT Dots foi lançado oficialmente pela OpenAI em 29 de setembro de 2026. Ele se posiciona como um agente de IA pessoal sempre ativo: depois que o usuário delega um objetivo, o Dot pode continuar avançando o trabalho na nuvem enquanto o usuário está ausente ou com o computador desligado, e devolve a tarefa ao usuário quando é preciso tomar uma decisão.
Ao falar sobre o preço do Dots, é preciso separar claramente o Pro individual do Dot Enterprise. A tabela abaixo foi organizada com base na documentação oficial de ajuda da OpenAI, com data de consulta em 16 de novembro de 2026.
| Público-alvo | Critério de cobrança | Condições de uso | Cobrança adicional |
|---|---|---|---|
| ChatGPT Pro 100 | US$ 100/mês | 18 anos ou mais; exceto Espaço Econômico Europeu, Reino Unido e Suíça; liberação gradual | Tarefas Work/Codex delegadas consomem a cota correspondente do produto |
| ChatGPT Pro 200 | US$ 200/mês | O mesmo que acima | O mesmo que acima |
| ChatGPT Pro 500 | US$ 500/mês | O mesmo que acima | O mesmo que acima |
| Espaço de trabalho Enterprise | Taxa fixa por tipo de trabalho ou cobrança por uso; valor conforme o contrato ou o orçamento do workspace | Período de prévia gratuita para administradores de 04/11/2026 a 18/11/2026; Dots ativados a partir de 18/11 passam a ser cobrados; cada membro pode criar 1 Dot pessoal | Tarefas delegadas ao Work ou ao Codex são cobradas separadamente conforme os padrões correspondentes |
A descrição do Dots no Pro individual não lista uma assinatura mensal separada para o Dot; a mensalidade do Pro já é o requisito de acesso. A OpenAI também informa que as tarefas do ChatGPT Work ou Codex delegadas pelo Dot seguem as regras de cota dos produtos correspondentes, e o consumo depende de fatores como modelo, contexto, raciocínio, chamadas de ferramentas e recuperação. Portanto, os US$ 100/mês correspondem a um conjunto delimitado de cotas de uso, e os materiais oficiais também não informam quantas tarefas de trabalho profundo do Dot correspondem a esse valor no Pro individual.
1.2 Capacidades de funcionário de IA empacotadas na assinatura do Dots
Ao comparar o Dots com chamadas de API, é fácil focar apenas no item “modelo”. Na prática, a assinatura empacota um ambiente operacional completo; se você montar a sua própria solução, precisará implementar tudo isso:
- Computador e navegador na nuvem: cada Dot tem seu próprio computador na nuvem, pode abrir sites, organizar documentos e produzir relatórios; o usuário pode acompanhar e assumir o controle da operação a qualquer momento.
- Contexto de longo prazo: combina ChatGPT Memory, as próprias notas do Dot, materiais da tarefa atual e dados de aplicativos autorizados.
- Coordenação de múltiplos projetos: divide tarefas complexas, inicia agentes de pesquisa em segundo plano para processamento paralelo, resume resultados e pede intervenção do usuário quando há bloqueios.
- Modo de trabalho contínuo: oferece suporte a tarefas agendadas e monitoramento de eventos, como verificar concorrentes toda semana e monitorar novos bugs que aparecem no Slack.
- Pesquisa proativa: quando não há novas mensagens, pesquisa fontes de dados autorizadas; esse processo é somente leitura, e as ações seguintes passam pelo fluxo normal de aprovação.
- Conexão com aplicativos e canais de comunicação: na publicação, a descrição oficial menciona um ecossistema de plugins com mais de 4.000 aplicativos conectáveis, e é possível entrar em contato por canais como ChatGPT, Slack e Microsoft Teams.
- Permissões e mecanismos de segurança: Custom Rules definem os limites de execução; Auto-review verifica antes de operações como enviar e-mails; ações como alterar senha e transferir fundos precisam ser assumidas pelo usuário.
Testes de terceiros oferecem uma referência sobre os limites de capacidade. No teste da Axios em 20 de outubro de 2026, o Dots produziu um programa comemorativo de 38 páginas da WNBA e gerou, em 47 segundos, um álbum de fotos comemorativo de 12 páginas; no entanto, o programa trazia estatísticas questionáveis, e a etapa de compra também exigia que o usuário fosse ao aplicativo Target e concluísse a tarefa por conta própria. A conclusão do autor é que esse tipo de agente é adequado para assumir pesquisa e preparação, mas os resultados ainda precisam de edição humana e verificação de fatos. Essa conclusão determina diretamente que o modelo de custos discutido adiante precisa incluir revisão humana.
2 Custo total de um agente funcionário de IA autoconstruído
2.1 As cinco categorias de custo de um agente autoconstruído
Construir com API um agente capaz de trabalhar continuamente gera uma conta que vai muito além da invocação do modelo. Dá para dividir os custos em cinco categorias:
- Custos de modelo: entrada, saída, leitura e gravação de cache e consumo de inferência, variando linearmente com o volume de tarefas.
- Custos de infraestrutura: servidores em nuvem, contêineres, bancos de dados e armazenamento; parte é mensalidade fixa e parte varia com a carga.
- Custos de ferramentas: APIs de busca, navegadores headless e interfaces de dados de terceiros, geralmente cobrados por chamada.
- Custos de desenvolvimento: desenvolvimento inicial, integração de sistemas e definição de permissões, com investimento concentrado no início.
- Custos de manutenção: monitoramento e alertas, diagnóstico de falhas e testes de regressão após atualizações de modelo, acontecendo de forma contínua.
Escrevendo como fórmula:
$$C_{self}=C_{API}+C_{infra}+C_{tools}+C_{dev}+C_{maintenance}$$
A estrutura de custos da rota por assinatura é:
$$C_{subscription}=C_{plan}+C_{extra\ usage}+C_{human\ review}$$
As duas rotas precisam contabilizar tempo humano. Na rota autoconstruída, o tempo humano se distribui entre desenvolvimento, manutenção e revisão; na rota por assinatura, ele fica principalmente na delegação de tarefas, verificação de resultados e aprovação.
2.2 Uma proposta de arquitetura para um agente funcionário de IA autoconstruído
A seguir, uma proposta de arquitetura para estimativa de custos, usada para mostrar de quais componentes um agente autoconstruído precisa. Preencha o custo de cada componente com os preços dos serviços de nuvem que você realmente usar; este artigo não testou a implantação dessa proposta.
- Camada de agendamento: gatilhos agendados ou filas de mensagens, responsáveis por tarefas periódicas como “gerar relatórios de inteligência todas as manhãs às 8h”.
- Camada de orquestração: o framework do agente planeja etapas, chama ferramentas e salva estado intermediário (como o Checkpointer do LangGraph ou o fluxo de trabalho do OpenAI Agents SDK).
- Camada de modelo: chama modelos por interface compatível com OpenAI, roteando para modelos diferentes conforme a dificuldade da tarefa.
- Camada de ferramentas: busca, coleta de páginas web, navegador headless e geração de arquivos.
- Camada de estado: banco de dados que guarda registros de tarefas, notas de longo prazo e informações de deduplicação.
- Camada de aprovação: operações de envio externo, pagamento ou exclusão entram na fila de aprovação humana.
- Camada de observabilidade: registra o Token, a duração e o motivo de falha de cada chamada, servindo de fonte de dados para a apuração de custos.
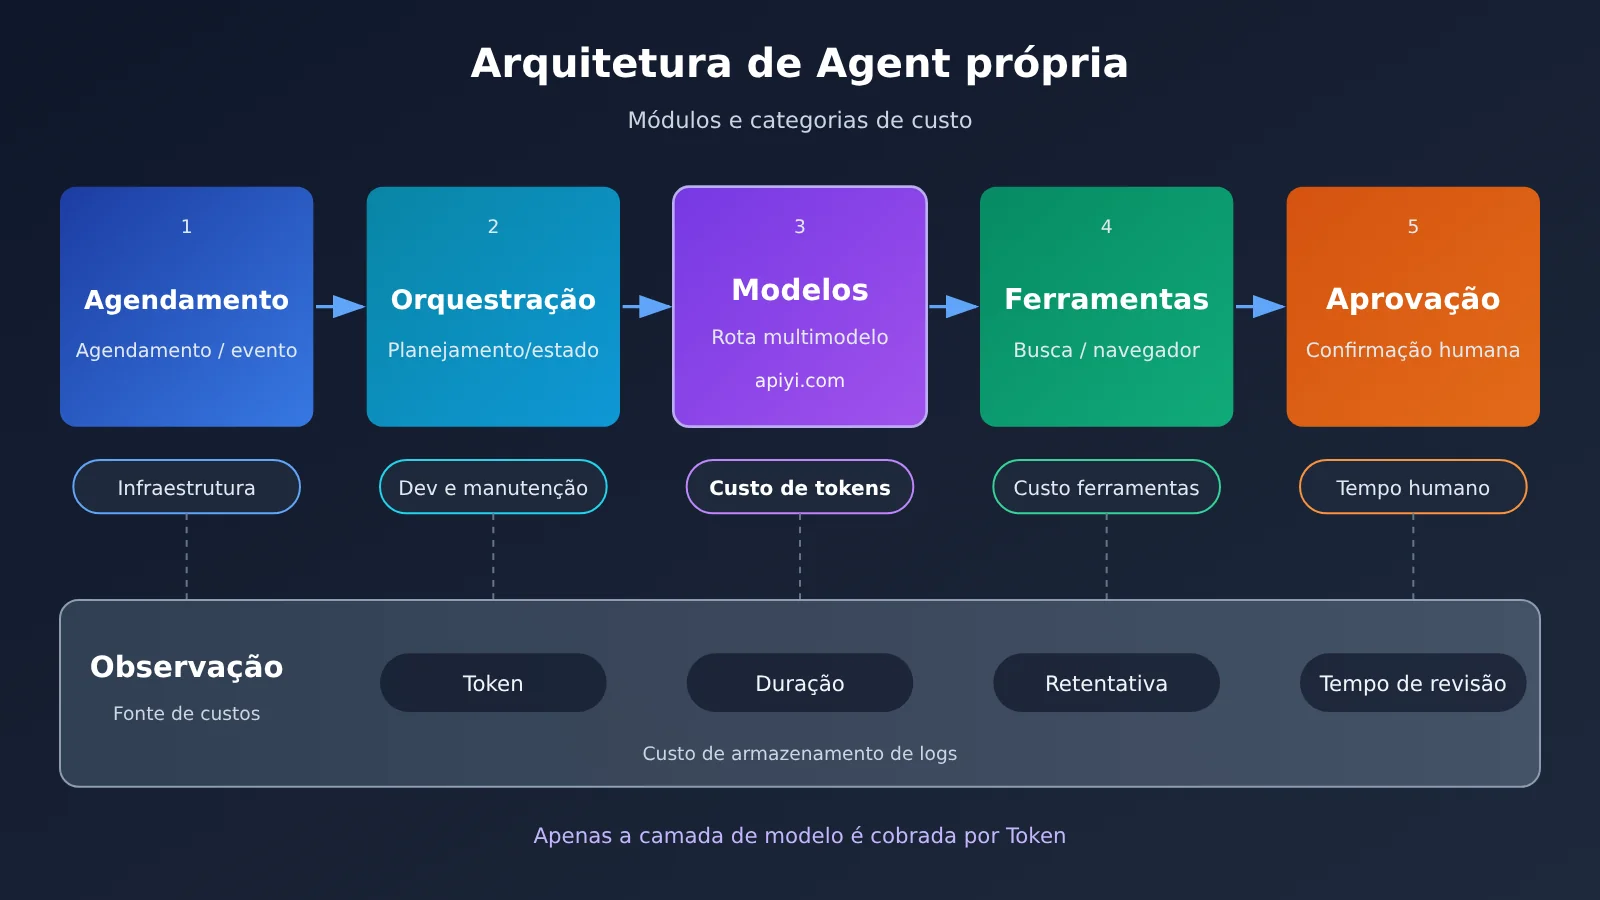
Dos sete componentes mostrados nesta imagem, apenas o custo da camada de modelo pode ser calculado diretamente pelo preço por Token. Os demais dependem das escolhas de arquitetura e da capacidade da equipe. É por isso que o custo de Token representa só uma parte do custo de uma solução autoconstruída.
3 Quanto de Token uma Tarefa de Funcionário de IA Consome
3.1 Diferenças de Cobrança entre Entrada, Saída e Cache
Uma tarefa de um Agent normalmente envolve várias rodadas de invocação do modelo: uma para planejar, outra para raciocinar após cada chamada de ferramenta e uma última para consolidar o resultado. Em cada rodada, o comando de sistema, as definições de ferramentas e o histórico de passos são reenviados como entrada. Por isso, os Tokens de entrada de um Agent costumam ser muito maiores do que os de saída.
É justamente aí que o cache entra em ação. O comando de sistema e as definições de ferramentas permanecem inalterados ao longo das várias rodadas. Quando há acerto no cache, a cobrança é feita pelo preço de leitura do cache, cujo valor unitário é cerca de um vinte avos do preço de entrada normal. A gravação no cache ocorre no momento em que o prefixo é salvo pela primeira vez, e seu preço depende do console da plataforma; nos exemplos deste artigo, ela não foi incluída no cálculo.
3.2 Cálculo do custo de modelo por tarefa usando os preços do APIYI
Os preços abaixo vêm da tabela de preços dos modelos Claude publicada pelo APIYI em 13 de novembro de 2026; na prática, vale o que estiver no console e na lista de modelos no momento da invocação. O consumo da tarefa é uma amostra hipotética usada para demonstrar o algoritmo: cada tarefa tem 30.000 Tokens de entrada e 5.000 Tokens de saída, com 300 tarefas por mês. Essa amostra não tem relação com o uso médio real do Dots nem de qualquer outra plataforma.
| Item de cálculo | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Preço de entrada / saída / leitura de cache (por milhão de Tokens) | $4 / $20 / $0,20 | $2 / $10 / $0,10 |
| Custo por tarefa (sem cache) | 30.000×$4/10⁶ + 5.000×$20/10⁶ = $0,22 | 30.000×$2/10⁶ + 5.000×$10/10⁶ = $0,11 |
| Custo mensal de 300 tarefas (sem cache) | $66 | $33 |
| Custo por tarefa (assumindo 20.000 Tokens de entrada com leitura de cache) | $0,04 + $0,004 + $0,10 = $0,144 | $0,02 + $0,002 + $0,05 = $0,072 |
| Custo mensal de 300 tarefas (com a hipótese de leitura de cache) | $43,2 | $21,6 |
| Plataformas disponíveis | APIYI, API oficial | APIYI, API oficial |
Nessa hipótese, o custo puramente de modelo fica abaixo da mensalidade de $100 do Pro 100. Esse resultado mostra apenas que a camada de modelo é barata: ele não inclui infraestrutura, ferramentas, desenvolvimento e manutenção, nem revisão humana, e também não considera novas execuções em caso de falha.
3.3 Registrar com código o uso real de Tokens das tarefas do funcionário de IA
O cálculo de custos precisa substituir os valores hipotéticos pelos valores reais de uso. O exemplo mínimo abaixo chama o modelo uma vez e lê o campo usage retornado:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI da APIYI
)

resp = client.chat.completions.create(
    model="claude-sonnet-5.5",  # Use o nome real da lista de modelos da APIYI
    messages=[{"role": "user", "content": "汇总今天的 AI 行业新闻要点"}]
)
print(resp.usage)  # Quantidade de Tokens de entrada e saída, para o cálculo de custos
Ver a implementação completa: registrar cada execução e calcular o custo por tarefa bem-sucedida
import time
import openai
from dataclasses import dataclass, field

# Preço por milhão de Tokens (USD), conforme o console no momento da chamada
PRICES = {
    "claude-opus-5.5":   {"input": 4.0, "output": 20.0, "cache_read": 0.20},
    "claude-sonnet-5.5": {"input": 2.0, "output": 10.0, "cache_read": 0.10},
}

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class RunRecord:
    task_id: str
    model: str
    input_tokens: int
    output_tokens: int
    cached_tokens: int
    seconds: float
    cost: float
    passed: bool = False          # Julgamento humano segundo critérios de aceitação unificados
    review_minutes: float = 0.0   # Tempo de verificação e correção humana

@dataclass
class Ledger:
    runs: list = field(default_factory=list)

    def call(self, task_id: str, model: str, messages: list) -> str:
        start = time.time()
        resp = client.chat.completions.create(model=model, messages=messages)
        usage = resp.usage
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        p = PRICES[model]
        uncached_input = usage.prompt_tokens - cached
        cost = (uncached_input * p["input"]
                + cached * p["cache_read"]
                + usage.completion_tokens * p["output"]) / 1_000_000
        self.runs.append(RunRecord(task_id, model, usage.prompt_tokens,
                                   usage.completion_tokens, cached,
                                   time.time() - start, cost))
        return resp.choices[0].message.content

    def cost_per_success(self, hourly_rate: float, fixed_cost: float = 0.0) -> float:
        """(custo de todas as execuções + custo fixo + mão de obra de revisão) / número de tarefas aprovadas"""
        api = sum(r.cost for r in self.runs)
        review = sum(r.review_minutes for r in self.runs) / 60 * hourly_rate
        passed_tasks = {r.task_id for r in self.runs if r.passed}
        if not passed_tasks:
            return float("inf")
        return (api + fixed_cost + review) / len(passed_tasks)

ledger = Ledger()
text = ledger.call("news-1116", "claude-sonnet-5.5",
                   [{"role": "user", "content": "汇总今天的 AI 行业新闻要点"}])
ledger.runs[-1].passed = True
ledger.runs[-1].review_minutes = 8
print(ledger.cost_per_success(hourly_rate=30, fixed_cost=0))
🚀 Dica para começar rápido: ao fazer experimentos de comparação de custos, você pode primeiro usar a mesma chave API no APIYI apiyi.com para chamar o Opus e o Sonnet separadamente, conectar o Ledger acima ao seu Agent e, depois de uma semana de tarefas reais, olhar o livro-caixa. A plataforma cobra por uso e novos usuários têm cota gratuita de testes, o que é ideal para obter dados reais de Tokens antes de investir no desenvolvimento.
4 Por que o custo dos funcionários de IA se distancia conforme o modelo
Na amostra hipotética da seção 3, o custo de modelo por tarefa do Opus 5.5 é o dobro do Sonnet 5.5. Olhando só essa coluna, o Sonnet economiza US$ 33 por mês. Mas o custo final das tarefas de Agent também é afetado pela taxa de sucesso e pela revisão humana — e é isso que vamos mostrar abaixo com um conjunto de parâmetros hipotéticos.
Suponha que o Opus acerte 90% das execuções e o Sonnet 60%, e que as tarefas reprovadas sejam reexecutadas até passarem. Pelo valor esperado, o custo de modelo por tarefa aprovada fica em torno de US$ 0,22÷0,9 ≈ US$ 0,24 e US$ 0,11÷0,6 ≈ US$ 0,18, respectivamente. A diferença de taxa de sucesso já engoliu mais da metade da vantagem de preço unitário.
O impacto do tempo humano é ainda maior. Suponha que a hora do revisor seja convertida em US$ 30, ou seja, cerca de US$ 0,5 por minuto. Basta que a saída do Sonnet precise, em média, de 1 minuto extra de correção por tarefa para que esses US$ 0,5 adicionais superem toda a diferença de preço unitário entre os dois modelos. Em tarefas de coleta de informações e elaboração de relatórios, que exigem conferir os dados item por item, o tempo de revisão costuma ser contado em minutos — e, nesse cenário, escolher o modelo mais estável acaba reduzindo o custo total.
Por outro lado, em tarefas simples com formato fixo e fácil verificação automática (como classificação, resumo e extração de campos), a taxa de sucesso dos modelos mais baratos pode ficar próxima da dos mais caros, e nesses casos faz mais sentido usar o Sonnet ou modelos ainda mais econômicos. As duas direções de julgamento só podem ser colocadas em prática depois de medir a taxa de sucesso com tarefas reais.
Comparação em seis dimensões dos funcionários de IA: 5 Dots, Agente de modelo único e Agente multimodelo
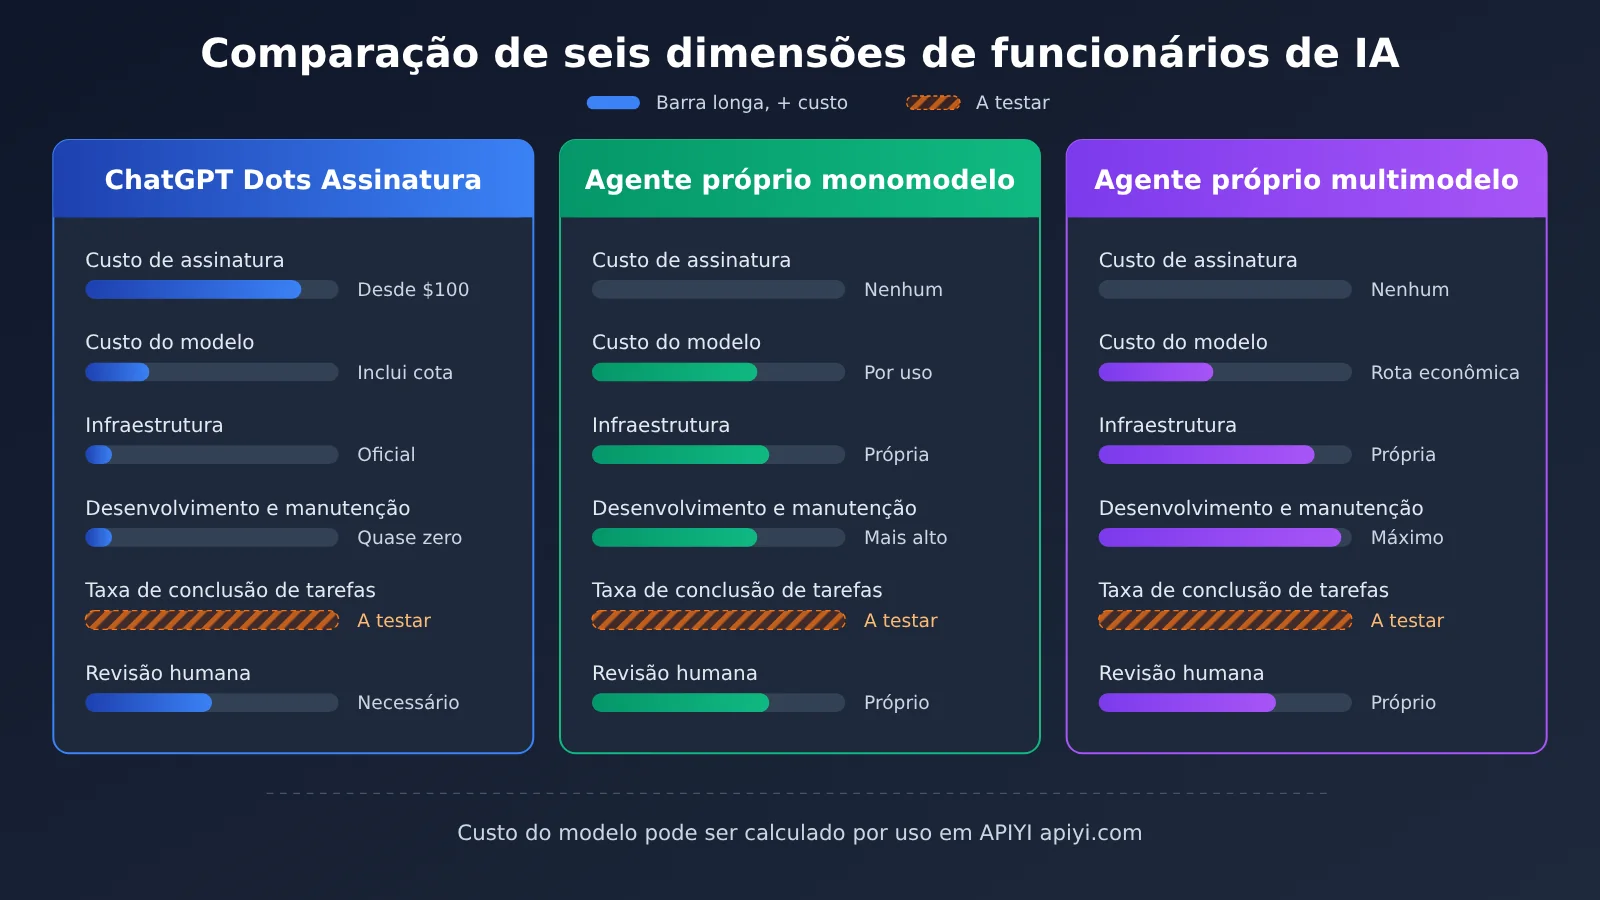
| Dimensão | ChatGPT Dots | Agente de modelo único (construído internamente) | Agente multimodelo (construído internamente) |
|---|---|---|---|
| Custo da assinatura | Pro individual a partir de US$ 100/mês; empresas conforme contrato | Nenhum | Nenhum |
| Custo dos modelos | Incluído na cota da assinatura; delegações para Work/Codex consomem cota à parte | Cobrança por token, crescendo linearmente com o volume de tarefas | Cobrança por token, com roteamento por dificuldade para reduzir o preço médio |
| Infraestrutura | Computador em nuvem e navegador fornecidos oficialmente | Servidor, banco de dados e ambiente de navegador próprios | Igual ao modelo único, além de lógica de roteamento e avaliação |
| Desenvolvimento e manutenção | Quase nenhum desenvolvimento; principalmente configuração de regras e permissões | Investimento inicial de desenvolvimento mais alto e manutenção contínua | Maior complexidade de desenvolvimento e manutenção |
| Taxa de conclusão de tarefas | Precisa ser medida com as próprias tarefas; testes de terceiros mostram que ainda exige verificação humana | Depende do modelo e da qualidade da engenharia; precisa ser medida | Depende da estratégia de roteamento; precisa ser medida |
| Revisão humana | Necessária, com mecanismos de Auto-review e aprovação como apoio | Necessária; o fluxo de aprovação precisa ser construído internamente | Necessária; o fluxo de aprovação precisa ser construído internamente |
| Integração de modelos | Integrada aos produtos OpenAI | Via interface unificada da APIYI | Via APIYI, uma chave para chamar modelos de vários provedores |
Análise comparativa do Dots: o Dots tem vantagens claras em uso imediato, colaboração entre aplicativos e contexto de longo prazo; computador em nuvem, ecossistema com mais de 4.000 aplicativos e comunicação multicanal não exigem desenvolvimento. Seus limites estão na falta de transparência das regras de cota em relação ao número de tarefas, na impossibilidade de personalizar profundamente a lógica de execução e no fato de o Pro individual ainda estar sujeito a restrições de região e idade.
Análise comparativa do agente de modelo único: a estrutura de custos é a mais clara: tokens e custos de cada chamada podem ser registrados com precisão, e a lógica de execução é totalmente controlável. O preço disso é construir internamente navegador, escalonamento, gerenciamento de estado e aprovação; a taxa de conclusão de tarefas depende inteiramente da capacidade de engenharia da equipe.
Análise comparativa do agente multimodelo: o agente multimodelo entrega etapas simples a modelos mais baratos e a inferência crítica a modelos mais fortes, tendo a maior chance de reduzir o custo por tarefa concluída com sucesso quando o volume é alto. É ele que exige mais do sistema de avaliação, com monitoramento contínuo da taxa de sucesso de cada modelo em cada tipo de etapa.
6 Medir se os funcionários de IA valem a pena pelo custo por tarefa bem-sucedida
6.1 Custo por tarefa bem-sucedida e fórmula de ROI
A métrica unificada é:
$$C_{successful\ task}=\frac{C_{all\ runs}+C_{infrastructure}+C_{review}}{N_{successfully\ completed\ tasks}}$$
O numerador inclui todas as execuções (incluindo falhas e novas tentativas), a infraestrutura rateada nesse período e a revisão humana; o denominador conta apenas as tarefas entregues de forma qualificada. Para o Dots, o “custo de execução” no numerador é substituído pela mensalidade da assinatura e pelo uso adicional.
Com base nisso, é possível calcular o retorno sobre o investimento:
$$ROI=\frac{V_{time\ saved}-C_{total}}{C_{total}}$$
A economia de tempo deve usar o tempo real que uma pessoa levaria para concluir a tarefa multiplicado por um custo de mão de obra razoável; o modelo gerar um documento em dezenas de segundos representa apenas a velocidade de geração, e o tempo humano economizado precisa descontar a parte de verificação e correção.
6.2 Experimento comparativo de custos de funcionários de IA em três tipos de tarefas
Recomenda-se selecionar três tipos de tarefas contínuas representativas: inteligência diária de notícias de IA, monitoramento semanal de concorrentes e relatório mensal de análise de dados. Usando os mesmos dados de entrada e o mesmo padrão de entrega, atribua a execução respectivamente ao ChatGPT Dots, APIYI + Agent de modelo único e APIYI + Agent multimodelo, registrando a cada execução os itens da tabela abaixo:
| Item registrado | Método de registro | Uso |
|---|---|---|
| Horário de início e conclusão | Timestamp do log de tarefas | Calcular o ciclo real de entrega |
| Número de invocações do modelo | Contagem da camada de orquestração | Identificar loops e invocações excessivas |
| Tokens de entrada / saída / cache | Campo usage retornado pela API |
Calcular o custo do modelo e o ganho com cache |
| Número de chamadas de ferramentas | Contagem da camada de ferramentas | Calcular custos de busca, navegador etc. |
| Falhas e novas tentativas | Classificação do motivo da falha | Calcular o consumo extra |
| Tempo de correção humana | Cronometragem do revisor | Calcular o esforço humano real |
| Resultado final da aceitação | Julgar como aprovado / reprovado conforme a lista predefinida | Calcular a taxa de sucesso das tarefas e o denominador |
No lado do Dots, não é possível obter o detalhamento de Tokens, então podem ser registrados a mensalidade da assinatura, o consumo de cota, o tempo de conclusão, o tempo de correção humana e o resultado da aceitação. Ao final, as três rotas são todas convertidas em “quanto dinheiro e quantos minutos de trabalho humano custou cada tarefa qualificada”. Recomenda-se que o período do experimento cubra pelo menos um ciclo completo de relatório mensal, pois com um volume de amostra muito pequeno, falhas isoladas distorcem severamente os resultados.
7 Quando escolher a assinatura Dots e quando construir seu próprio agente de funcionário de IA
7.1 Usuários individuais: priorize a assinatura Dots
- Delegação de tarefas do dia a dia: para tarefas entre aplicativos, como organizar a agenda, preparar reuniões, classificar e-mails e planejar viagens, as conexões de aplicativos e o computador na nuvem do Dots ficam disponíveis de imediato.
- Não querer manter um sistema: construir seu próprio agente exige lidar continuamente com falhas e atualizações, e o custo de tempo para usuários individuais geralmente é maior que a assinatura.
- Pré-requisitos: atender aos requisitos de idade e região e aceitar as regras de cota do Pro; se o volume de tarefas mensais for muito baixo, o limite de US$ 100 precisa ser avaliado em relação à frequência real de uso.
7.2 Desenvolvedores com uso intenso: vale construir o próprio agente ou adotar uma abordagem híbrida
- Precisar de lógica de execução personalizada: coleta de inteligência em formato fixo, monitoramento de fontes de dados específicas e integração profunda com sistemas internos.
- Precisar de controle de custos detalhado: escolher o modelo por etapa, usar cache e contabilizar cada centavo com base nos registros de chamadas.
- Já ter capacidade técnica: conseguir montar por conta própria o agendamento, o gerenciamento de estado e as aprovações, diluindo o custo de desenvolvimento em tarefas de longo prazo.
7.3 Equipes corporativas: analise a cotação do contrato e os requisitos de conformidade
- Já ter um workspace Enterprise: o Dots pode ser configurado de forma centralizada pelos administradores; por padrão, os dados dos workspaces Business, Enterprise e Edu não são usados para treinamento de modelos, e a cobrança precisa ser calculada conforme a cotação do workspace.
- Precisar integrar sistemas internos ou processos privados: um agente próprio oferece mais controle sobre o ambiente de execução, o fluxo de dados e os logs de auditoria.
- Tarefas padronizadas em larga escala: quando o volume de tarefas é grande o suficiente e o processo é estável o bastante, um agente próprio multimodelo tem mais chance de reduzir o custo por tarefa, desde que isso seja validado com experimentos controlados.
8. Esquema híbrido de funcionários de IA: combinando assinatura com chamadas avulsas de API
Assinatura e API podem dividir o trabalho conforme as características de cada tarefa, cada uma assumindo a parte em que é melhor:
- Interações do dia a dia e trabalhos que exigem julgamento humano: entregue ao Dots ou à sua assinatura atual do ChatGPT, aproveitando o contexto de longo prazo e o mecanismo de aprovação.
- Tarefas em lote estáveis e verificáveis automaticamente: use a API com pagamento por consumo, deixando para modelos de baixo custo.
- Raciocínio de alta dificuldade e conclusões críticas: chame modelos mais capazes, trocando um preço unitário mais alto por uma taxa de retrabalho menor.
- Picos de demanda: quando a cota da assinatura aperta, migre as tarefas que podem ser deslocadas para o consumo por chamada.
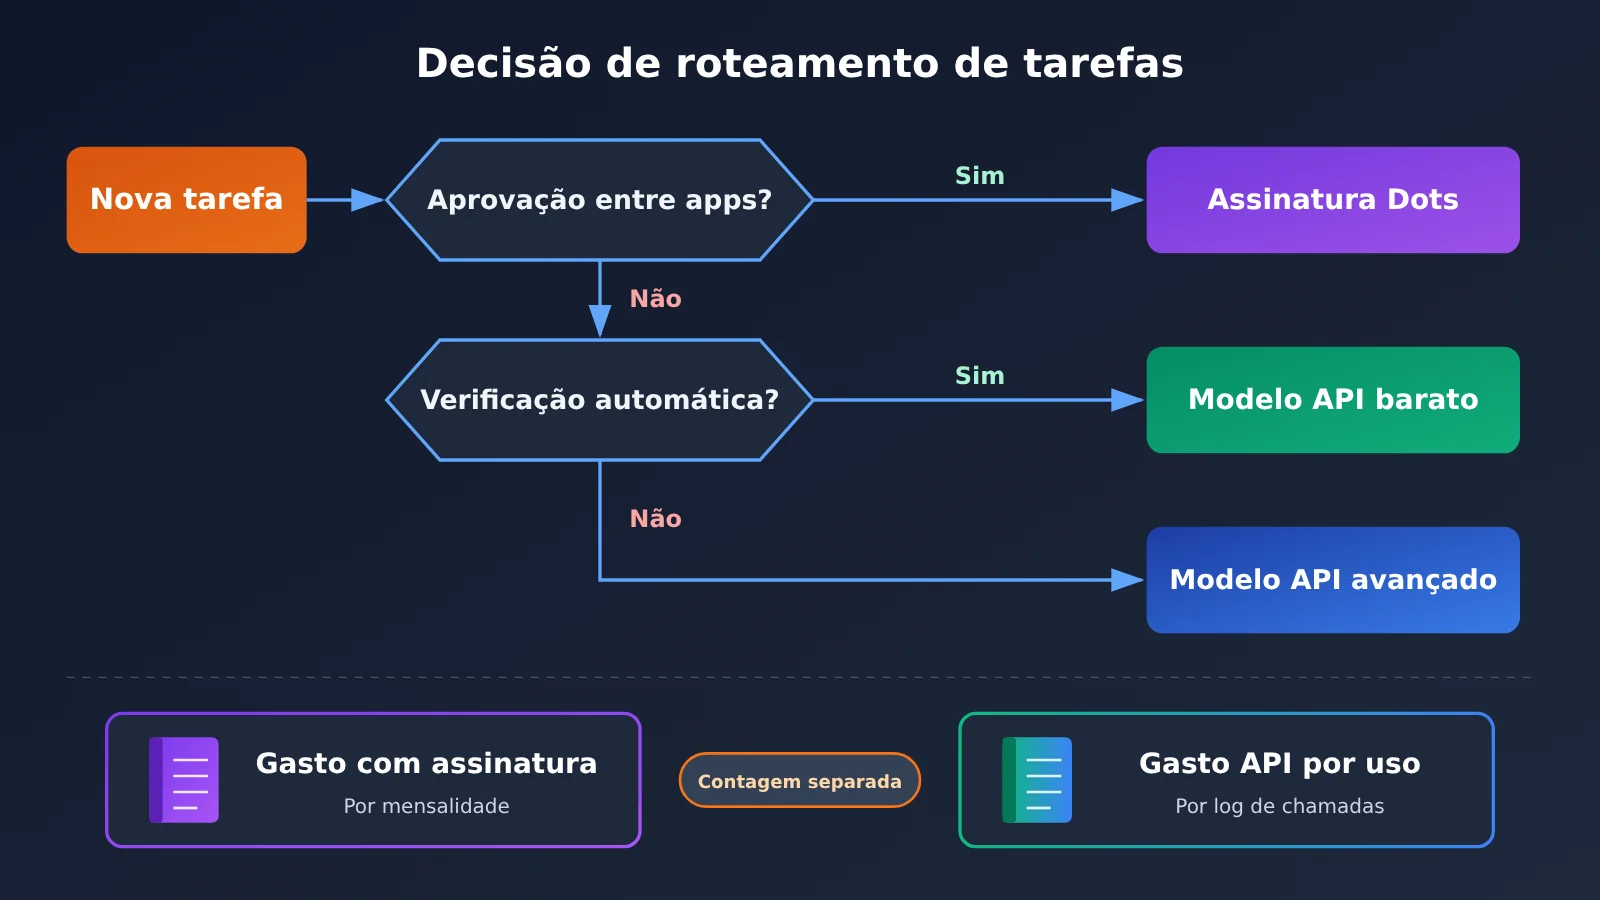
O ponto-chave do esquema híbrido é manter contabilidades separadas: o gasto com assinatura entra como mensalidade, o gasto com API entra pelo log de chamadas, e cada tarefa é lançada apenas na rota que realmente a executou — assim você evita contar duas vezes.
💡 Sugestão de decisão: comece usando o Dots ou sua assinatura atual para o trabalho cotidiano e, ao mesmo tempo, separe 1 ou 2 tipos de tarefa padronizada para rodar experimentos comparativos com vários modelos via APIYI apiyi.com. Decidir com base em um mês de dados de custo por tarefa bem-sucedida — quais tarefas migram para a API e quais ficam na assinatura — é bem mais seguro do que escolher um dos dois caminhos de cara.
Perguntas frequentes (FAQ)
Q1: O que é o ChatGPT Dots?
O ChatGPT Dots é um agente de IA pessoal persistente lançado pela OpenAI em 29 de setembro de 2026. Ele tem seu próprio computador e navegador na nuvem, consegue levar adiante tarefas delegadas entre sessões e aplicativos, e devolve o controle ao usuário sempre que é preciso um julgamento humano.
Q2: Quanto custa por mês para usar o Dots individualmente?
Até 16 de novembro de 2026, usuários individuais precisam assinar o ChatGPT Pro. As mensalidades do Pro 100, Pro 200 e Pro 500 são de $100, $200 e $500, respectivamente, e os três planos dão acesso ao Dots. A OpenAI não lista uma mensalidade separada para o Dots. As tarefas de Work ou Codex delegadas pelo Dots são cobradas conforme a cota do produto correspondente.
Q3: Como é a cobrança do Dots na versão empresarial?
Workspaces corporativos elegíveis podem optar por uma taxa fixa por tipo de trabalho ou por cobrança baseada em uso. Os valores exatos seguem o contrato ou a proposta aplicável ao workspace. De 4 a 18 de novembro de 2026 há um período de prévia gratuita para administradores; a partir de 18 de novembro, os Dots ativados passam a ser cobrados, e as tarefas delegadas para Work ou Codex são cobradas à parte.
Q4: Se o custo de modelo de um agente próprio for abaixo de $100, isso significa que ele é mais barato que o Dots?
Ainda é preciso somar servidor, banco de dados, ferramentas de busca e navegador, desenvolvimento e manutenção, além da revisão humana, e descontar o impacto das reexecuções por falha. Só dá para concluir qual caminho é mais barato comparando o custo por tarefa bem-sucedida no mesmo conjunto de tarefas e sob o mesmo critério de aceitação.
Q5: Como estimar rapidamente o custo de modelo de um agente próprio usando a API?
Você pode seguir estes passos:
1. Cadastre-se em APIYI apiyi.com e obtenha uma chave API, resgatando os créditos de teste para novos usuários.
2. Defina o base_url do código deste artigo como `https://api.apiyi.com/v1` e conecte o Ledger para registrar os Tokens de cada chamada.
3. Com tarefas reais, chame o Opus 5.5 e o Sonnet 5.5 separadamente, registre os resultados da aceitação e o tempo de correção humana, e calcule o custo por tarefa bem-sucedida.
Q6: Qual é o impacto do cache no custo de um agente?
Em chamadas de múltiplos turnos do agente, o comando de sistema e as definições de ferramentas são enviados repetidamente. Quando há acerto no cache, a cobrança usa o preço de leitura de cache, que na série Claude 5.5 fica em torno de um vigésimo do preço de entrada normal. No exemplo hipotético deste artigo, quando dois terços da entrada acertam o cache, o custo de modelo por tarefa cai cerca de um terço. O preço de escrita em cache deve ser conferido no console.
Q7: O Dots consegue substituir totalmente o trabalho humano?
Tanto os materiais oficiais quanto os testes de terceiros mostram que os resultados do Dots precisam de verificação humana. No teste da Axios, o guia do evento produzido pelo Dots trouxe dados duvidosos, e operações que envolvem contas e dinheiro ainda exigem que o usuário assuma o controle. Por isso, o custo de revisão humana deve entrar sempre no total.
Q8: O Dots consegue processar tarefas em paralelo sem limite?
O Dots suporta vários projetos e agentes em segundo plano rodando em paralelo, mas o ambiente de execução e a cota de uso têm limites. Um usuário do Reddit relatou que, ao iniciar uma tarefa independente, encontrou o ambiente de execução indisponível e só conseguiu continuar depois de conectar seu computador Linux local. Ele também disse não ter conseguido confirmar como a cota é calculada em cada caminho de execução.
Principais pontos sobre o custo de um funcionário de IA
- Base de comparação: meça pelo custo de tarefas bem-sucedidas sob o mesmo padrão de entrega — a mensalidade e o preço por Token são apenas parte da conta.
- Pessoa física e empresa calculam separado: o Pro individual começa em $100/mês; o Dot empresarial é cobrado por tipo de trabalho ou volume de uso, conforme o contrato.
- A assinatura já empacota o ambiente: computador na nuvem, contexto de longo prazo, conexões com aplicativos e mecanismos de aprovação são custos que você teria de cobrir se construísse do zero.
- O custo do modelo é só uma camada: no cenário de exemplo, 300 tarefas por mês custam $33–$66 em modelo, sem contar infraestrutura e mão de obra.
- A taxa de sucesso define o custo real: cada minuto extra de correção manual pode anular toda a diferença de preço unitário entre os dois modelos.
- Misturar é mais flexível: use a assinatura para delegação no dia a dia e chame os modelos por volume via APIYI para tarefas padronizadas em lote, com contabilidade separada.
Resumo
Vale a pena pagar $100 por mês para manter um funcionário de IA? Depende das tarefas que você entrega a ele e do seu critério de aceitação:
- O valor do Dots está na capacidade de trabalho contínuo pronta para usar: computador na nuvem, colaboração entre aplicativos e contexto de longo prazo dispensam desenvolvimento e manutenção, o que é ideal para usuários individuais e equipes que valorizam baixa carga de manutenção.
- A vantagem de construir seu próprio Agente está no controle e na mensurabilidade: a lógica de execução pode ser personalizada e cada chamada pode ser rastreada e faturada, o que é adequado para equipes com capacidade técnica estável e tarefas altamente padronizadas.
- A decisão final deve vir de um experimento controlado: registre Tokens, novas tentativas e tempo de correção manual em três tipos de tarefas reais e compare o custo total por tarefa aprovada.
Sugestão: mantenha a assinatura atual para o trabalho diário e, ao mesmo tempo, escolha uma categoria de tarefa padronizada para fazer um teste comparativo com a API. Recomendamos acessar vários modelos com uma única chave API via APIYI apiyi.com, pagando por uso e registrando o consumo real, para decidir com dados quais tarefas vale a pena migrar.
📚 Referências
-
OpenAI: Introducing dots — Anúncio de lançamento do Dots: posicionamento do produto, computador na nuvem e ecossistema de aplicações
- Link:
openai.com/index/introducing-dots - Descrição: material oficial de primeira mão, publicado em 29/09/2026
- Link:
-
ChatGPT Learn: Meet dots / Tasks and memory — Visão geral do produto, requisitos de assinatura, tarefas de longa duração e mecanismo de memória
- Link:
learn.chatgpt.com/docs/dots - Descrição: documentação de referência sobre o Agent em segundo plano, pesquisa proativa e tarefas agendadas
- Link:
-
ChatGPT Learn: Enterprise Dots 管理员指南 — Como habilitar e cobrar em workspaces corporativos
- Link:
learn.chatgpt.com/docs/enterprise/dots-admin-guide - Descrição: explicação vigente sobre taxa fixa corporativa e cobrança por uso
- Link:
-
OpenAI Help Center: About ChatGPT Pro tiers — Preços e regras de cota do Pro 100 / 200 / 500
- Link:
help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers - Descrição: base oficial para os preços das assinaturas individuais
- Link:
-
OpenAI Help Center: Dots privacy, security, and safety FAQs — Permissões, aprovações, Auto-review e políticas de dados
- Link:
help.openai.com/en/articles/20001529-dots-privacy-security-and-safety-faqs - Descrição: leitura obrigatória para avaliar revisão humana e custos de segurança
- Link:
-
Axios: I tested Dots and Muse — Teste prático de terceiros com Dots e Meta Muse
- Link:
axios.com/2026/10/20/battle-of-bots-openai-meta-ai-agents-test - Descrição: desempenho em tarefas específicas e casos de falha
- Link:
-
APIYI: cotas de pacotes de Token não podem ser comparadas diretamente — Método de cálculo em cinco passos para assinatura versus pagamento por uso
- Link:
help.apiyi.com/token-plan-quota-subscription-vs-pay-as-you-go.html - Descrição: framework de cálculo do custo equivalente por tarefa
- Link:
-
Tabela de preços de modelos APIYI — Preços vigentes de modelos como Claude
- Link:
docs.apiyi.com/models - Descrição: antes da invocação real, use esta página e o console como referência
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: fale conosco pela página inicial do site da APIYI. Para mais materiais sobre integração de modelos e cobrança, acesse o centro de documentação em docs.apiyi.com