摘要:本文解读 Qwen4-Max-Preview 的夜间 8% Credits 优惠,并从使用范围、计费单位和任务总成本三个方面,比较 Token Plan 订阅套餐、正式版按量付费 API 与多模型 API 聚合平台。
Qwen4-Max-Preview 8% Credits 结论先行
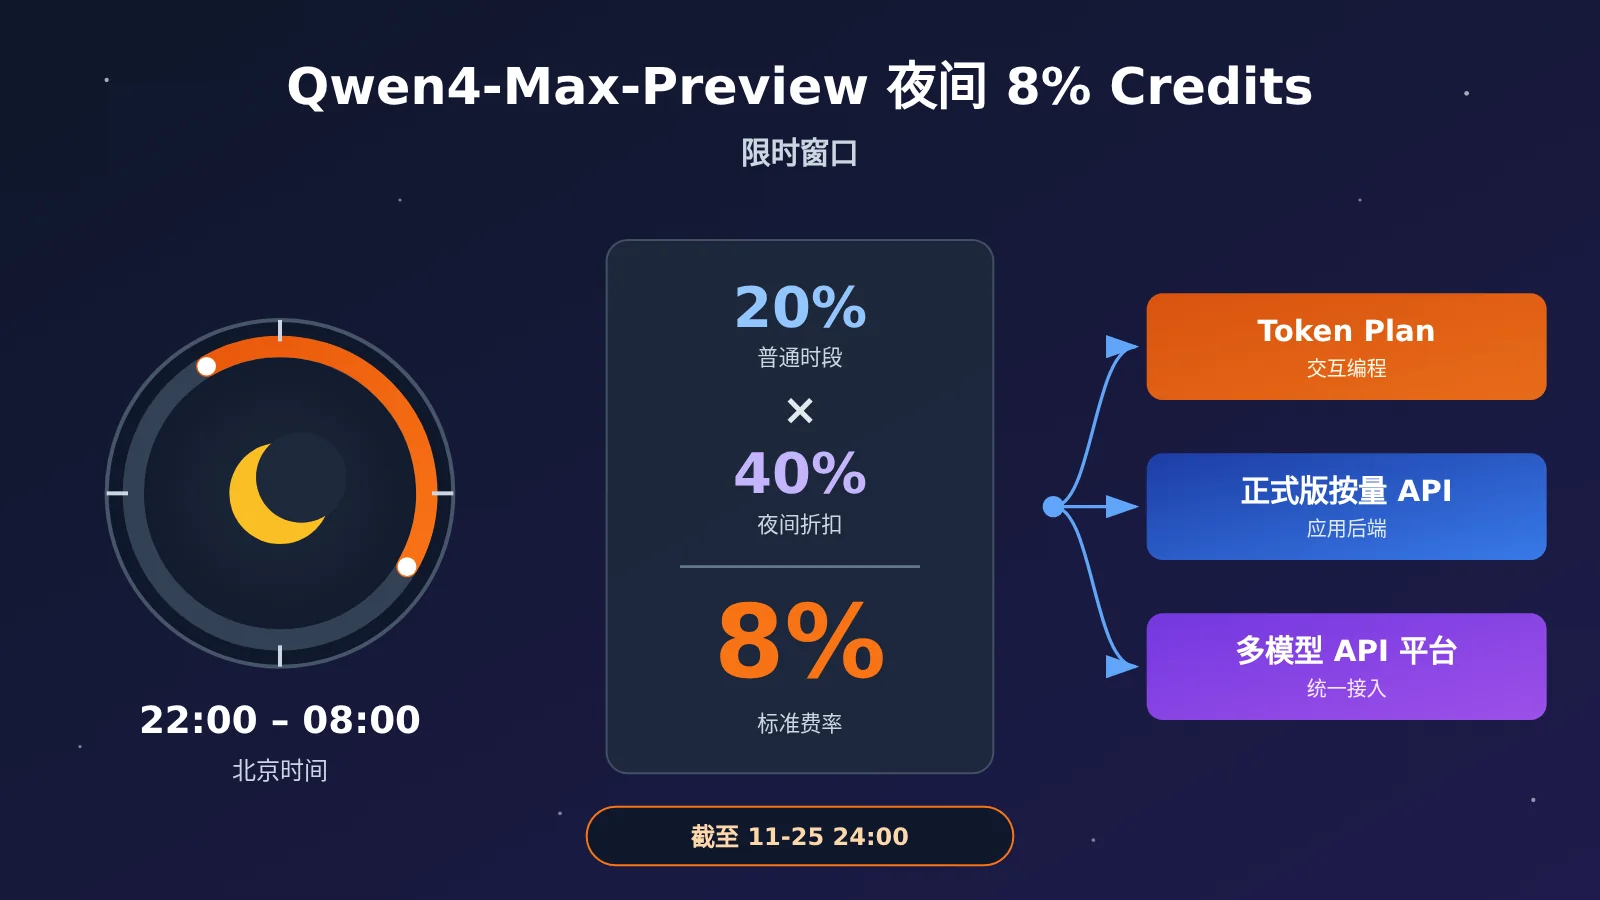
在 Token Plan 中调用 Qwen4-Max-Preview 时,北京时间每晚 22:00 至次日 08:00 的 Credits 消耗为标准费率的 8%。这个比例由普通时段的 2 折和夜间额外的 4 折叠加得出。优惠截至 Preview 预览结束,即 2026 年 11 月 25 日 24:00(北京时间),之后该模型下线。
这项优惠只适用于 Token Plan 允许的场景,也就是在编程工具和智能体工具中进行交互式使用。如果要把模型接入自建应用后端或自动化业务,需要选择允许这类用途的按量付费 API 产品。11 月 16 日上线的 Qwen4-Max 正式版已经提供独立的按量计费价格,可以承接这部分需求。
下文先拆解 8% 的计算方式和 Token Plan 套餐价格,再说明正式版的按量计费口径和缓存机制。随后从适用任务、使用形态、计费单位和接口四个方面比较三类调用方案,并给出一套按任务归集成本的计算框架。最后按开发者的实际任务类型给出选择建议。
To Know:Qwen4-Max-Preview 计费相关术语
| 术语 | 解释 |
|---|---|
| Credits | Token Plan 订阅套餐的抵扣单位,消耗量取决于所用模型和这次调用的具体构成 |
| Token | 模型输入、输出以及思考内容的计量单位 |
| Token Plan | 阿里云按订阅周期发放 Credits 权益的产品,分个人版和团队版 |
| 按量付费 API | 按实际调用量计费、面向应用接入的模型服务方式 |
| 缓存命中 | 重复传入的输入被服务端复用,按缓存对应的计费规则计算 |
| 思考 Token | 模型推理过程产生的 Token,会占用输出预算并计入输出计费 |
| API 聚合平台 | 用一个统一接口提供多种模型调用和用量管理的服务 |
| 单位任务成本 | 完成同一个目标所需的全部请求、重试、工具调用和模型消耗之和 |
1 Qwen4-Max-Preview 0.8 折优惠是怎么来的
1.1 两层折扣叠加:20% × 40% = 8%
Preview 活动期内,Token Plan 对 Qwen4-Max-Preview 设置了两层 Credits 优惠:
- 普通时段:Credits 消耗为标准费率的 20%,也就是 2 折。同样的 Credits 预算,理论上可以完成标准费率下约 5 倍的调用量。
- 夜间时段:北京时间每天 22:00 至次日 08:00,在 2 折的基础上再打 4 折。
- 叠加结果:20% × 40% = 8%,即标准费率的 0.8 折。
官方给出过一个比例示例:如果某次调用按标准费率应消耗 100 Credits,普通时段实际消耗 20 Credits,夜间时段实际消耗 8 Credits。这只是演示比例的数学示例,单次调用实际消耗多少,要以控制台的用量明细为准。官方也保留根据运营情况调整优惠的权利。
1.2 Qwen4-Max-Preview 限时窗口的时间边界
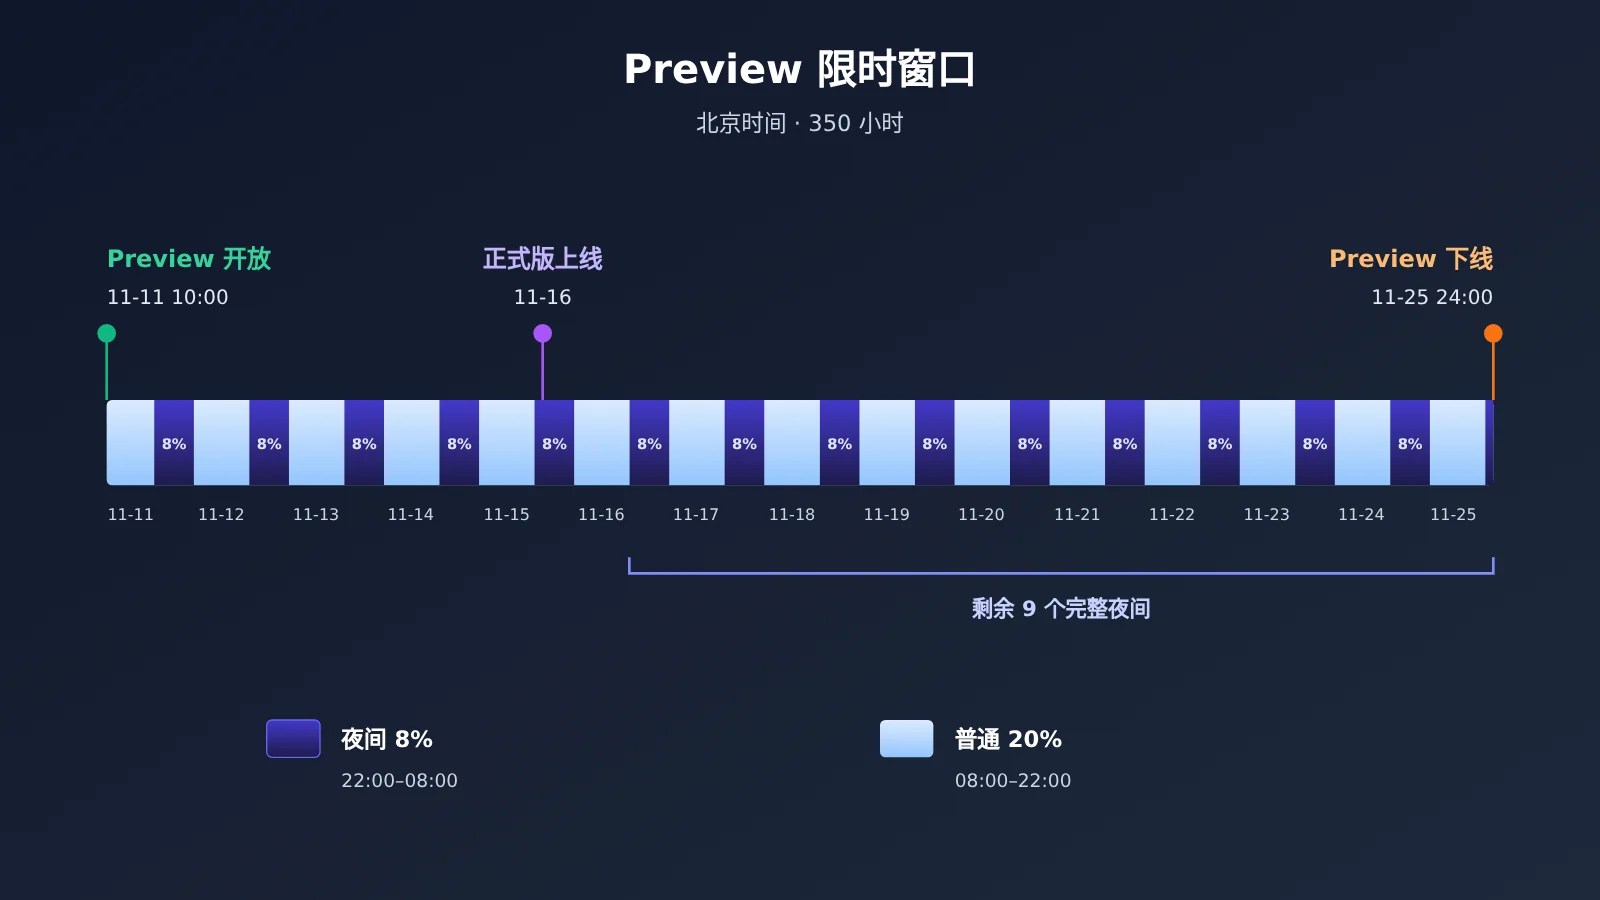
Preview 于 2026 年 11 月 11 日 10:00 开放,11 月 25 日 24:00 结束(均为北京时间),总计 350 小时。以今天 11 月 16 日计算,剩余的完整夜间时段是 11 月 16 日晚至 11 月 25 日早晨这 9 个夜晚。11 月 25 日当晚的夜间时段只有 22:00 到 24:00 两小时,之后 Preview 下线。
11 月 16 日正式版 Qwen4-Max 上线后,Preview 的下线时间保持不变。官方模型文档已提示建议使用正式版,因此在 Preview 窗口内形成的工作流,应同步准备迁移到 qwen4-max。
2 Token Plan 的 Credits 怎么买、怎么消耗
2.1 Token Plan 个人版套餐价格与额度
截至 2026 年 11 月 16 日,阿里云 Token Plan 个人版官方页面公布的套餐如下。月度额度和价格在 11 月 9 日调整过,更早的截图和文章中的价格已经不适用。
| 套餐 | 月价格 | 月度 Credits | 并发 Agent | 新用户价格 |
|---|---|---|---|---|
| Lite | 39 元 | 20,000 | 1–2 | 19.5 元/月 |
| Essential | 79 元 | 45,000 | 2–3 | 39.5 元/月 |
| Standard | 139 元 | 80,000 | 3–4 | 页面未列新用户优惠 |
| Pro | 312 元 | 200,000 | 6–8 | 页面未列新用户优惠 |
新用户价格截至 2026 年 11 月 30 日 23:59:59(UTC+8),仅限此前从未购买过 Token Plan 个人版的账号。新用户优惠降低的是套餐订阅价格;Preview 的 2 折和 0.8 折降低的是模型调用时的 Credits 消耗,两者作用在不同环节。
2.2 Token Plan 额外用量包的规则
套餐额度用完后可以购买额外用量包,规则如下:
- 价格 100 元/个/月,每包 20,000 Credits。
- 必须已经持有有效套餐,最多同时持有 5 个。
- 有效期一个月,未用完的额度到期作废。
- 用量包额度独立于套餐原有的月度额度。
2.3 Credits 与 Token 的计量关系
Credits 是 Token Plan 的抵扣单位,Token 是模型的计算单位,两者不能按一比一换算。根据官方说明,一次调用扣多少 Credits,取决于以下因素:
- 模型类型及其计费系数;
- 输入 Token 数,以及其中缓存命中的 Token 数;
- 输出 Token 数,包括思考 Token;
- 工具调用次数,以及内置工具和子任务带来的额外调用。
因此,用 39 元和 20,000 Credits 无法推算出 Qwen4-Max-Preview 每百万 Token 的单价。官方没有公布 Preview 独立的按百万 Token 定价,也不支持 Preview 按量付费。可以参考的实际记录有:一位开发者在 Qoder 中完成抓娃娃机交互项目,耗时约 75 分钟,估算消耗约 65 Credits。这是单个任务在特定工具下的记录,仅用于了解消耗量级。
3 Qwen4-Max-Preview 与正式版的计费方式对比
3.1 Preview:只能通过 Token Plan 专属接入
Preview 的接入方式是固定的:订阅 Token Plan 个人版或团队版,获取套餐专用 API Key,使用专用 Base URL https://token-plan.cn-beijing.maas.aliyuncs.com,并把模型 ID 设为 qwen4-max-preview(别名 qwen4.0-max-preview,账单中统一显示为后者)。它兼容 OpenAI Chat Completions、Responses 和 Anthropic Messages 接口规范。
Preview 的输出预算为 393,216 Tokens,由思考内容和最终回答共享,默认推理力度为 xhigh。从其他模型迁移过来时,如果只按最终回答长度设置 max_tokens,回答可能会因为思考内容占满预算而被截断。
3.2 正式版 Qwen4-Max:按量付费 API 价格
正式版 qwen4-max 于 11 月 16 日上线。它既可以在 Token Plan 中使用,也可以按量付费调用。以下是官方模型页面列出的正式版按量计费价格(人民币,单位为元/百万 Token):
| 部署地域 | 输入 | 输出(含思考及回答) |
|---|---|---|
| 中国内地华北 2(北京) | 10 元 | 30 元 |
| 美国弗吉尼亚 | 10 元 | 30 元 |
| 德国法兰克福 | 10 元 | 30 元 |
| 日本东京 | 10 元 | 30 元 |
| 中国香港 | 10 元 | 30 元 |
| 新加坡 | 10.938 元 | 32.813 元 |
北京地域另有 100 万 Token 免费额度,在开通百炼、模型发布或申请通过等起算时间后的 90 天内有效,具体以官方页面规则为准。这些价格只适用于正式版,不能用来反推 Preview 的标准 Credits 消耗。
正式版的参数也和 Preview 不同:上下文同样是 1,000,000 Tokens,最大输出在思考模式下为 262,144 Tokens、非思考模式下为 131,072 Tokens;默认推理力度为 high,默认思考预算为 131,072。迁移时需要重新检查输出上限的设置。
3.3 正式版 Qwen4-Max 的显式缓存机制
正式版支持显式缓存,可以复用系统提示词、工具说明、参考文档等固定的输入前缀。显式缓存支持 OpenAI Chat Completions、Responses 和 Anthropic Messages 三种接口,TTL 可选 5 分钟或 1 小时。
多轮 Agent 任务通常每轮都要重复传入相同的系统指令和工具描述,这正是缓存最能节省成本的地方。缓存有独立的计费规则,具体单价请查阅对应地域的模型调用计费页面。
4 Qwen4-Max-Preview 三种调用方式分别适合谁
4.1 三类方案对照
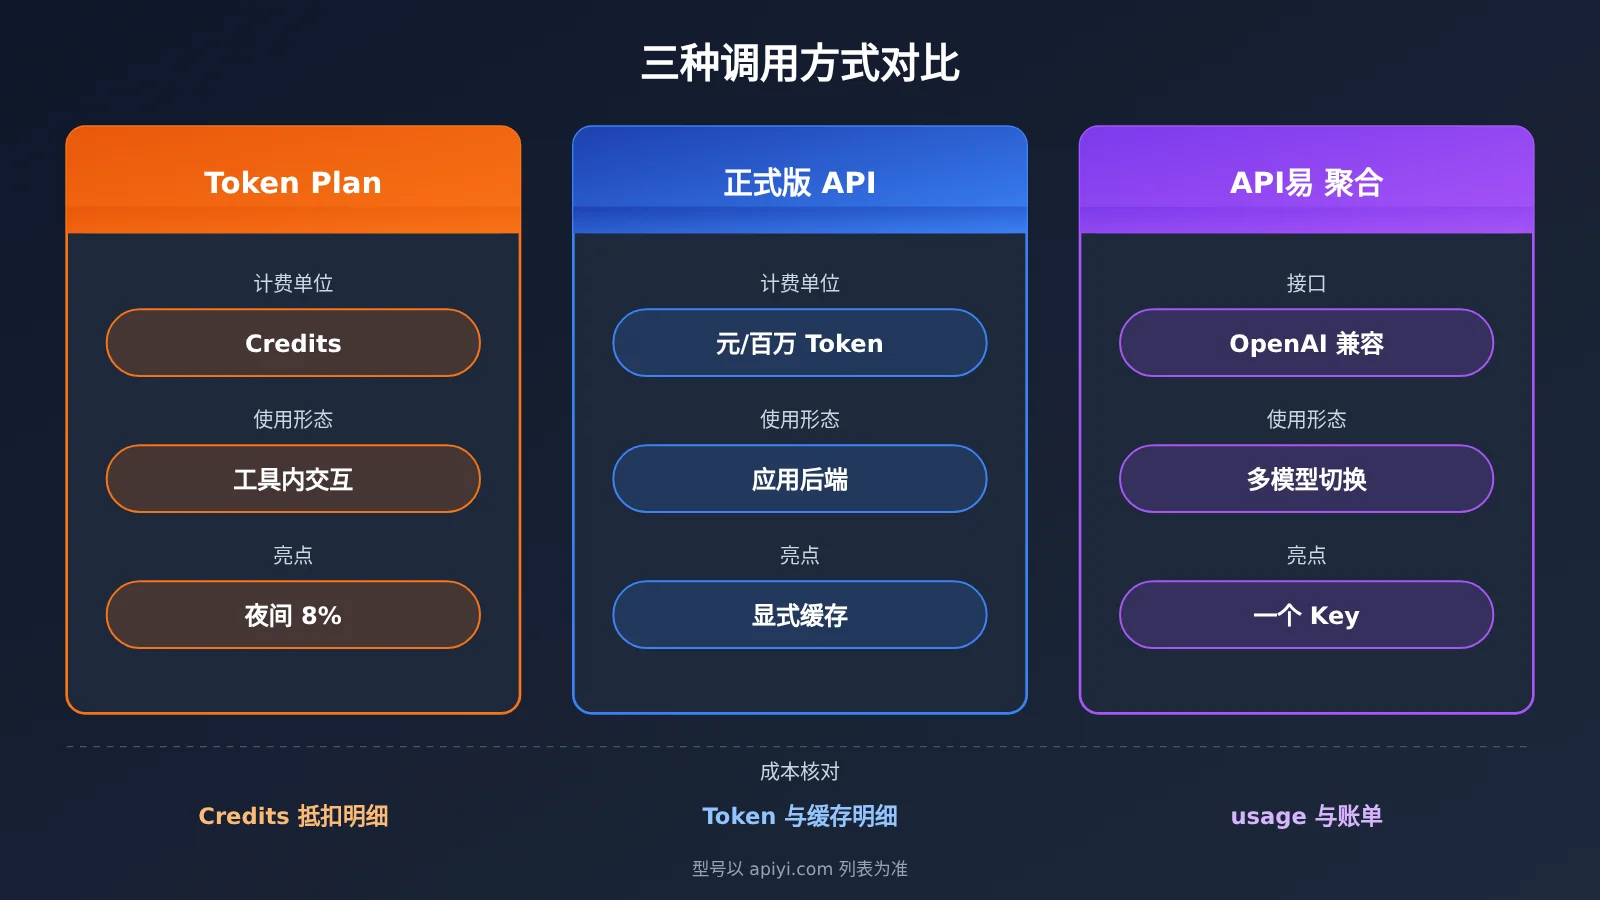
| 维度 | Token Plan 订阅 | 正式版按量付费 API | 多模型 API 聚合平台 |
|---|---|---|---|
| 适用任务 | 交互式编程、Agent 对话 | 自建应用后端、自动化业务 | 多模型应用、模型对比与切换 |
| 允许的使用形态 | 仅限编程工具和智能体工具中的交互式使用 | 应用接入 | 应用接入,统一管理多个模型 |
| 计费单位 | Credits | 元/百万 Token(分地域) | 按平台价格接口公布的 Token 单价 |
| 额度期限 | 套餐与用量包按月,到期作废 | 按量结算;北京免费额度 90 天 | 按量结算 |
| 接口 | 专用 Base URL 和套餐专用 Key | 百炼官方接口 | OpenAI 兼容接口,如 API易 apiyi.com |
| 成本核对方法 | 控制台 Credits 实际抵扣明细 | 按 Token 明细和缓存计费归集 | 按请求 usage 字段和平台账单归集 |
4.2 Token Plan 订阅:适合工具内的交互式编程
Token Plan 支持 Claude Code、Cursor、Qwen Code、Qoder、Qoder CN、OpenClaw 等工具,具体以官方工具接入文档为准。开发者在这些工具中主动发起任务,Preview 的夜间 8% 优惠就能直接生效,成本也以 Credits 的形式提前锁定。
使用边界写在官方权限规范中:不能用自动化脚本批量调用,不能把套餐 Key 放进自建应用后端,不能做非交互式批量调用,也不能通过 Dify、n8n、Coze 等工作流平台,或 Postman、Insomnia 等 API 测试工具违规使用套餐权益。超出范围可能导致订阅暂停或 Key 被封禁。此外,个人版订阅须知规定,使用期间的输入和生成内容会被用于服务改进与模型优化,处理机密资料前需要先核查协议。
4.3 官方按量付费 API:适合正式版的应用接入
自建应用后端、批量任务和自动化流程,应该使用正式版 qwen4-max 的按量付费 API。计费口径是公开的元/百万 Token 单价,配合显式缓存,成本可以按请求逐笔核对。这条路径没有 Credits 那样的大幅折扣,但使用形态和计费方式都清晰、合规。
4.4 多模型 API 聚合平台:适合需要统一接口的团队
如果应用同时要用 OpenAI、Claude、Gemini 等多家模型,聚合平台可以用一个 API Key 和一套 OpenAI 兼容接口完成调用,并集中管理用量。API易 是这类平台之一。需要说明的是,API易 帮助中心 11 月 13 日的文章记录 Qwen4 尚未进入模型总表和价格接口,11 月 16 日的公开文章也把 qwen4-max 标为暂未上架。这些都是当日的快照,是否已上架,请以当前的模型总表和价格接口为准。
🎯 技术建议:搭建多模型应用时,可以先在 API易 apiyi.com 用同一套代码对比几款已上架模型在你任务上的表现。等目标模型上架后,只需修改
model参数即可切换。
5 开发者如何计算 Qwen4-Max-Preview 与 API 的实际成本
5.1 Qwen4-Max 单位任务成本的计算框架
模型单价低,完成一个任务的总成本不一定低。一个 Agent 任务可能包含几十次请求、大量重复上下文、较长的思考输出和失败重试。比较方案时,应以“完成同一个目标”为单位,按各产品的计费明细归集成本:
| 成本项 | 按量付费 API 的计算方式 | Credits 方案的记录方式 |
|---|---|---|
| 未缓存输入 | 未缓存输入量 × 对应输入单价 | 直接记录控制台实际抵扣的 Credits |
| 缓存 | 缓存读取、写入及存储费用,按对应地域规则计算 | 已包含在实际抵扣中 |
| 输出 | 输出量(含计费的思考 Token)× 输出单价 | 已包含在实际抵扣中 |
| 工具与重试 | 工具调用费用 + 重试请求的全部消耗 | 已包含在实际抵扣中 |
写成公式就是:任务成本 = 未缓存输入量 × 输入价 + 缓存读取/写入及存储费用 + 输出(含计费思考)量 × 输出价 + 工具/重试等费用。Credits 方案不做 Token 换算,直接记录任务开始和结束时的 Credits 余额差。两类结果的单位不同,对比时应分别评估“每个任务花了多少元”和“每个任务扣了多少 Credits”,再结合套餐月费判断性价比。
5.2 用代码记录每次请求的 Token 用量
按量付费方案的核对,依赖每次请求返回的 usage 字段。下面的极简示例展示了如何在 OpenAI 兼容接口中读取用量。模型 ID 请替换为平台模型列表中已上架的型号:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_ID",  # 以平台模型列表中已上架的型号为准
    messages=[{"role": "user", "content": "总结这段日志中的错误类型"}],
)
print(resp.usage)  # 记录 prompt_tokens / completion_tokens 等,用于成本归集
查看按任务归集成本的完整代码
import openai
from dataclasses import dataclass, field

@dataclass
class TaskLedger:
    """按任务归集 Token 用量,单价由调用方按所选产品和地域传入"""
    input_price_per_m: float          # 元/百万 Token,未缓存输入
    output_price_per_m: float         # 元/百万 Token,输出(含思考)
    cache_cost: float = 0.0           # 缓存读写及存储费用,按明细手工填入
    tool_cost: float = 0.0            # 工具调用费用
    records: list = field(default_factory=list)

    def add(self, usage):
        cached = 0
        details = getattr(usage, "prompt_tokens_details", None)
        if details is not None:
            cached = getattr(details, "cached_tokens", 0) or 0
        self.records.append({
            "uncached_input": usage.prompt_tokens - cached,
            "output": usage.completion_tokens,
        })

    def total(self) -> float:
        inp = sum(r["uncached_input"] for r in self.records)
        out = sum(r["output"] for r in self.records)
        return (inp / 1e6 * self.input_price_per_m
                + out / 1e6 * self.output_price_per_m
                + self.cache_cost + self.tool_cost)

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 单价请按实际选用的产品和地域填写
ledger = TaskLedger(input_price_per_m=0.0, output_price_per_m=0.0)

for attempt in range(3):  # 重试产生的消耗同样计入任务成本
    resp = client.chat.completions.create(
        model="YOUR_MODEL_ID",
        messages=[{"role": "user", "content": "修复 query.py 中的分页错误"}],
    )
    ledger.add(resp.usage)
    if resp.choices[0].finish_reason == "stop":
        break

print(f"本任务请求数: {len(ledger.records)},合计成本: {ledger.total():.4f} 元")
5.3 假设计算:正式版北京地域的一个 Agent 任务
以下为假设计算,数字仅用于演示公式。 假设一个任务在正式版 Qwen4-Max 北京地域按量付费调用,累计未缓存输入 2,000,000 Tokens,输出(含思考)50,000 Tokens,不使用缓存和计费工具:
- 输入:2 × 10 元 = 20 元
- 输出:0.05 × 30 元 = 1.5 元
- 合计:21.5 元
这个结果说明,长上下文 Agent 任务的成本主要来自反复传入的输入。如果把其中固定的系统提示词和工具说明改为显式缓存,输入部分的结构会改变,具体能省多少,取决于缓存命中率和对应地域的缓存单价。Credits 方案下的同一任务,请直接记录实际抵扣量,不要用这 21.5 元去换算 Credits。
💰 成本核对:如果业务需要同时比较多款已上架模型在同一任务上的单位任务成本,可以通过 API易 apiyi.com 的统一接口读取各模型的 usage,用上面的 TaskLedger 按同一口径归集。
6 如何选择 Qwen4-Max-Preview 时期的调用方案
6.1 交互式编程:在夜间窗口用 Token Plan 处理长任务
如果主要在 Claude Code、Cursor、Qoder 等工具里写代码,Token Plan 与 Preview 优惠最契合。具体做法:
- 把需要大上下文、长思考的交互任务安排到 22:00 至 08:00 之间,由本人在工具中发起并跟进,例如代码库理解、跨模块调试、长文档分析。
- 为思考内容预留输出预算,Preview 的 393,216 Tokens 由思考和回答共享。
- 每个任务开始和结束时记下 Credits 余额,积累自己的单位任务消耗数据。
- 首次购买时比较 Lite 19.5 元和 Essential 39.5 元两档新用户价格,优惠截至 11 月 30 日。
- 在 11 月 25 日之前,用正式版
qwen4-max跑一遍常用任务,确认输出上限和推理力度设置。
6.2 自建应用与自动化业务:选择按量付费 API 或聚合平台
后端服务、定时任务、批量数据处理以及工作流平台接入,都属于 Token Plan 个人版限制的范围,应该选择允许商业后端调用的按量付费 API。只用通义系列模型时,可以直接接入正式版 Qwen4-Max 的官方按量付费 API,并利用显式缓存控制输入成本。应用需要组合多家模型时,可以使用 API 聚合平台统一接口和账单。
💡 选择建议:接入渠道应以模型的实际可用状态为准。目标模型已在 API易 apiyi.com 上架时,可以直接通过统一接口调用;尚未上架时,可先在平台上用已上架的模型完成接口和成本核算流程的开发,待上架后切换 model 参数。
6.3 Qwen4-Max-Preview 决策速查
- 个人开发者,主要在编程工具内交互:Token Plan 加 Preview 夜间窗口,11 月 25 日后改用正式版
qwen4-max。 - 团队开发自建应用:正式版按量付费 API,按地域选择单价,开启显式缓存。
- 多模型应用或模型选型阶段:多模型 API 聚合平台,统一接口,按任务归集成本。
- 处理机密数据:先核查对应产品的数据使用条款,再决定接入方式。
7 总结:Qwen4-Max-Preview 8% Credits 窗口的正确用法
Qwen4-Max-Preview 夜间 8% Credits 是 Token Plan 内的限时优惠,在 11 月 25 日 24:00 前有效,适用于编程工具和智能体工具中的交互式使用。正式版 Qwen4-Max 已在 11 月 16 日上线,北京地域按量付费价格为输入 10 元、输出 30 元/百万 Token,适合应用后端和自动化业务。Credits 和 Token 属于两套计量体系,比较成本时应以单位任务为准,分别记录 Credits 抵扣和按 Token 归集的金额。
做决定时可以按这个顺序:先判断任务是工具内交互还是后端调用,再确定对应的合规产品,最后用同一个任务实测成本。需要在多款已上架模型之间对比效果和成本时,可以通过 API易 apiyi.com 的统一接口快速完成验证。
📚 参考资料
-
Qwen4-Max-Preview 官方文档:模型规格、开放时间与接入方式
- 链接:
help.aliyun.com/zh/model-studio/qwen4-max-preview - 说明: 输出预算、思考参数、专用 Base URL
- 链接:
-
Qwen4-Max 正式版官方文档:按量计费价格与显式缓存
- 链接:
help.aliyun.com/zh/model-studio/qwen4-max - 说明: 各地域单价、输出上限、缓存 TTL
- 链接:
-
Token Plan 个人版订阅与权益:套餐价格、Credits 与限时优惠
- 链接:
help.aliyun.com/zh/model-studio/token-plan-personal-overview - 说明: 2 折与夜间 4 折规则、新用户价格、用量包
- 链接:
-
Token Plan 权限与使用规范:允许与禁止的使用场景
- 链接:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - 说明: 交互式使用范围与违规后果
- 链接:
-
Token Plan 用量与额度:Credits 消耗机制
- 链接:
help.aliyun.com/zh/model-studio/token-plan-usage-quota - 说明: 影响 Credits 消耗的各项因素
- 链接:
-
Token Plan 功能更新:Preview 与正式版上线记录
- 链接:
help.aliyun.com/zh/model-studio/token-plan-product-updates - 说明: 11 月 11 日与 11 月 16 日的版本事件
- 链接:
作者: APIYI 技术团队
技术交流: 欢迎在 API易 apiyi.com 首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心