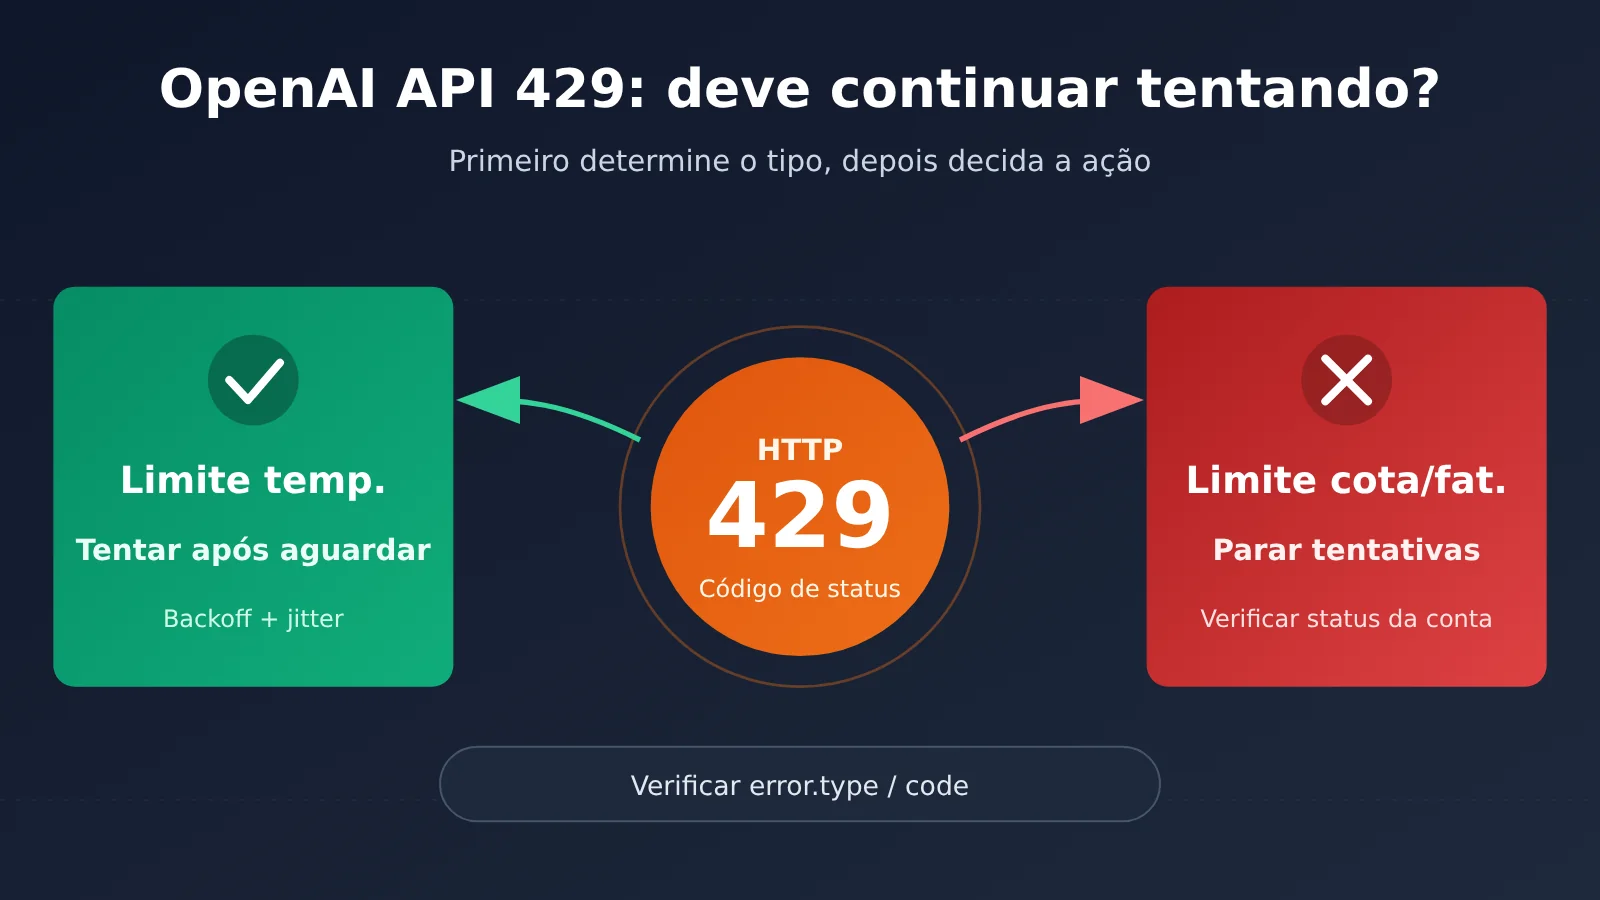
Não se deve ficar repetindo indefinidamente. Quando a API da OpenAI devolve um 429, isso não significa “é só esperar um pouco que resolve”. Apenas limites de taxa de natureza temporária valem a pena esperar e tentar de novo. Cota esgotada, cobrança anômala ou restrições de uso no nível da organização não voltam a funcionar por mais que você repita a chamada — pelo contrário, você só acaba travando a fila.
O caminho certo é primeiro olhar a mensagem de erro, o error.type e o error.code quando estiver disponível, para identificar a qual categoria de 429 aquele erro pertence. Se for limitação temporária de taxa e existir um Retry-After válido, basta esperar o tempo indicado por ele; se não houver, use backoff exponencial com jitter aleatório, sempre com um limite de tentativas.
O que você vai encontrar neste artigo:
- Quais são, no mínimo, as categorias de 429 da API da OpenAI e como tratar cada uma delas.
- Como se relacionam
Retry-After, backoff exponencial e jitter aleatório, e quando usar cada um. - Por que a combinação entre retry automático do SDK oficial, fila de tarefas e um botão manual de “tentar de novo” acaba amplificando o 429.
- Soluções distintas para gargalos de número de requisições e de tokens, além dos cuidados quando uma requisição em streaming falha no meio do caminho.
Índice: antes do texto principal, uma tabela de conceitos e uma visão rápida dos impactos ajudam a alinhar a terminologia e a localizar a parte que interessa para você. A seção “fatos objetivos” reúne o que a documentação oficial da OpenAI diz sobre o 429, incluindo a classificação dos erros, as regras de retry e o comportamento do SDK. A seção “análise e julgamento” trata da implementação na prática: ajustar a estratégia conforme o tipo de gargalo, projetar os estados da fila, investigar o acúmulo de tentativas e observar as diferenças de semântica ao migrar para outro gateway.
To Know: conceitos necessários para entender o OpenAI API 429
| Conceito | Explicação resumida |
|---|---|
| HTTP 429 | Código de status “Too Many Requests”. O OpenAI API usa esse código tanto para indicar limite de taxa quanto para indicar limites de cota ou de uso |
| Rate Limit (limite de taxa) | Quantidade máxima de requisições que podem ser feitas em um determinado período. A OpenAI conta separadamente o número de requisições e o volume de tokens |
| RPM / TPM | Requisições por minuto e tokens por minuto. Basta um dos dois atingir o teto para disparar um 429 |
error.type / error.code |
Campos estruturados no corpo da resposta de erro, usados para distinguir a causa específica do 429. São mais confiáveis do que olhar apenas o código de status |
| Retry-After | Campo de cabeçalho da resposta que indica quanto tempo o servidor sugere esperar antes de tentar novamente. Quando o valor é válido, deve ser seguido preferencialmente |
| Exponential Backoff (backoff exponencial) | A cada falha, o tempo de espera aumenta em múltiplos, por exemplo 1 segundo, 2 segundos, 4 segundos, com um limite máximo definido |
| Jitter (variação aleatória) | Adiciona uma quantidade aleatória ao tempo de backoff, evitando que muitos clientes retentem exatamente no mesmo momento |
| Streaming (saída em fluxo) | O modelo retorna o conteúdo conforme o gera. Depois que a saída começa, se ocorrer um erro no meio do caminho, não dá para simplesmente reproduzir tudo do zero |
| Sobreposição de retentativas | SDK, filas de negócio e ações manuais do usuário retentam cada um por si, fazendo o volume real de requisições ser multiplicado |
Visão rápida dos impactos: o que o erro 429 da OpenAI API significa para diferentes funções
| Função | Principais impactos | Pontos de atenção |
|---|---|---|
| Desenvolvedores de backend | Uma lógica de novas tentativas mal implementada pode transformar uma limitação temporária de taxa em uma falha persistente | Distinguir os tipos de 429 e centralizar as novas tentativas em uma única camada |
| Responsáveis por processamento em lote e tarefas de dados | Tarefas em grandes volumes podem esbarrar ao mesmo tempo nos dois limites: número de requisições e tokens | Ritmo de envio, tamanho do contexto e design do estado da fila |
| Produto e front-end | Usuários clicando em “tentar novamente” repetidamente continuam gerando novos erros 429 | Informar quando o usuário poderá tentar de novo ou deixar claro que é um problema da conta |
| Operações e administradores da conta | Erros 429 de cota ou cobrança não se resolvem sozinhos via código | Detectar e tratar o estado da conta em tempo hábil, em vez de permitir tentativas automáticas sem controle |
Fatos objetivos: como a documentação oficial da OpenAI descreve o 429
Esta seção tem como base o guia de códigos de erro, o guia de limites de taxa e o artigo sobre diagnóstico de 429 da Central de Ajuda da OpenAI, todos mantidos publicamente. A verificação foi feita em 2026-11-17. Como são documentos de manutenção atualizados continuamente, este artigo não consegue confirmar quando o conteúdo relacionado foi publicado pela primeira vez; portanto, não o trata como notícia do dia, mas apenas como uma explicação das regras válidas atualmente.
As diferentes origens do erro 429 da API OpenAI
A posição central da documentação oficial é: um 429 igual pode ter significados diferentes; é preciso avaliar em conjunto a mensagem de erro, o error.type e o error.code disponível. Limites temporários de taxa e restrições de cota, cobrança e uso da organização são tratados de formas diferentes.
O primeiro caso é “requisições rápidas demais ou em excesso dentro da janela atual”; após algum tempo, quando a janela for atualizada, a situação se normaliza. O segundo envolve o estado da própria conta, por exemplo cota esgotada, problemas de pagamento ou limite de uso no nível da organização. Esse tipo de problema não desaparece automaticamente com o tempo.
| Tipo de 429 | Sinal típico | Esperar resolve? | Ação recomendada |
|---|---|---|---|
| Limite de taxa por número de requisições | A mensagem de erro indica o limite de número de requisições; o code comum é rate_limit_exceeded |
Normalmente sim | Respeitar o Retry-After ou usar backoff exponencial com jitter |
| Limite de taxa por volume de tokens | A mensagem de erro indica o limite de tokens | Normalmente sim, mas é fácil disparar repetidamente | Reduzir a quantidade de tokens por requisição enquanto aplica backoff |
| Restrição de cota/cobrança/organização | A mensagem de erro indica cota ou fatura; o code comum é insufficient_quota |
Não | Parar as tentativas automáticas e notificar o responsável para tratar a conta |
Vale destacar que o valor específico de error.code deve ser determinado pelo conteúdo realmente retornado e pela documentação oficial. Os códigos da tabela acima são apenas exemplos comuns; no código, não tome decisões com base apenas em strings codificadas manualmente e preserve a mensagem de erro original para investigação nos logs.
Requisições e tokens podem ter limites separados
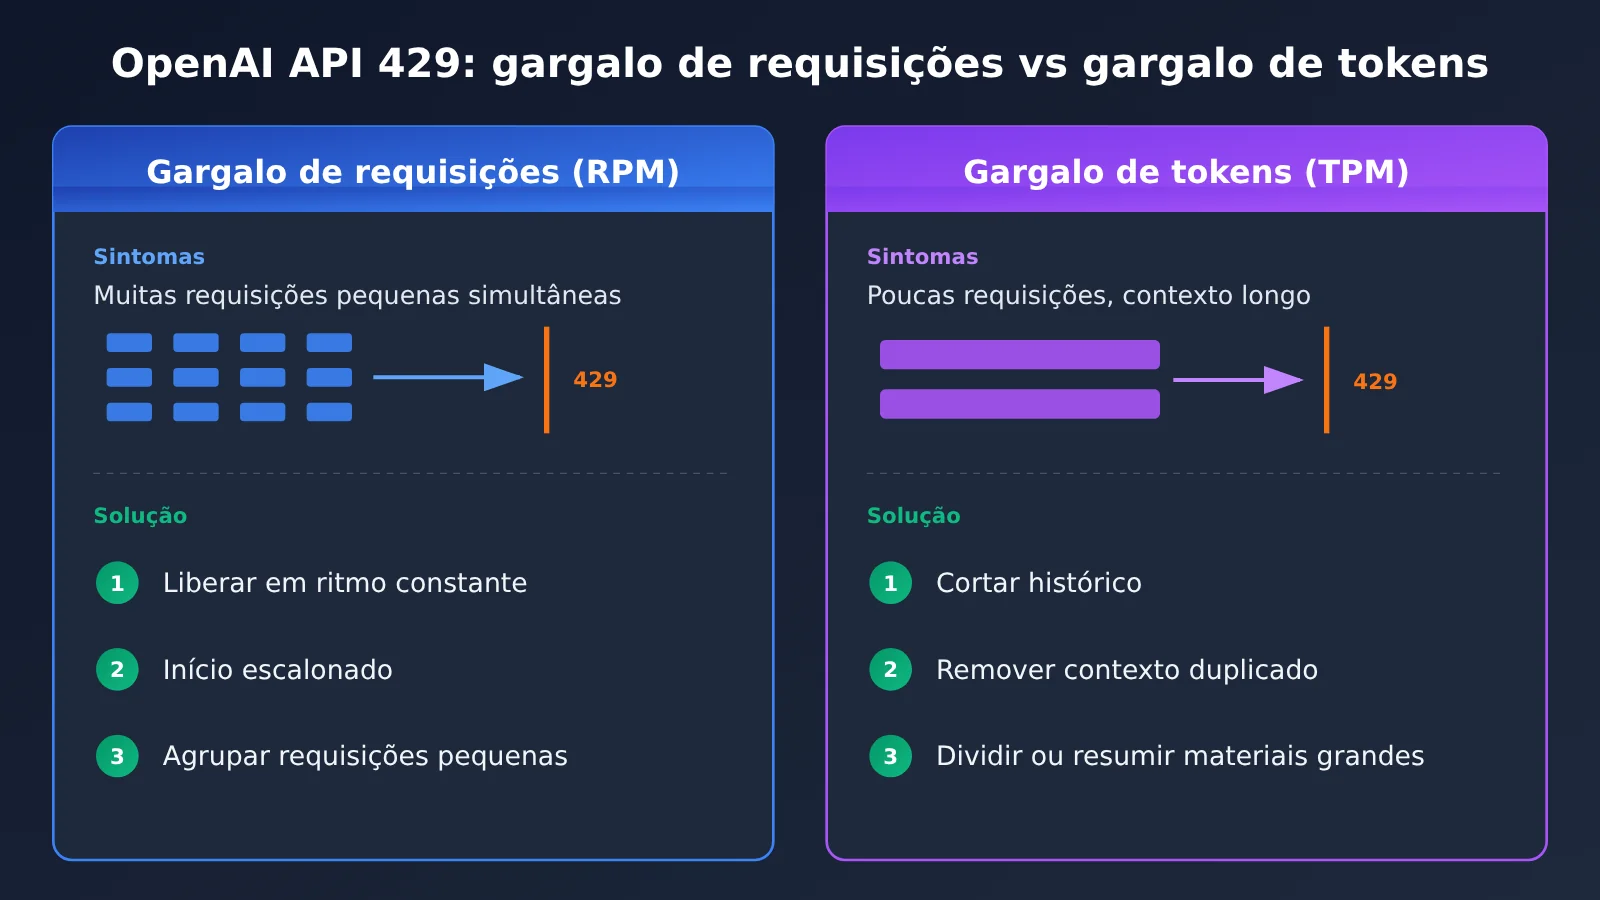
O guia de limites de taxa explica que os limites são medidos em várias dimensões. As duas mais comuns são o número de requisições e a quantidade de tokens, e cada uma funciona de forma independente. Ou seja, mesmo quando o número de requisições ainda está longe do teto, você pode atingir primeiro o limite de tokens porque cada requisição leva um contexto muito longo. Por outro lado, muitas requisições bem pequenas também podem esgotar primeiro o limite de requisições.
A OpenAI fornece informações sobre limites de taxa nos cabeçalhos da resposta, como número de requisições restantes, tokens restantes e o respectivo tempo de reset. Esses campos ajudam a saber, antes de realmente receber um 429, qual limite está mais próximo.
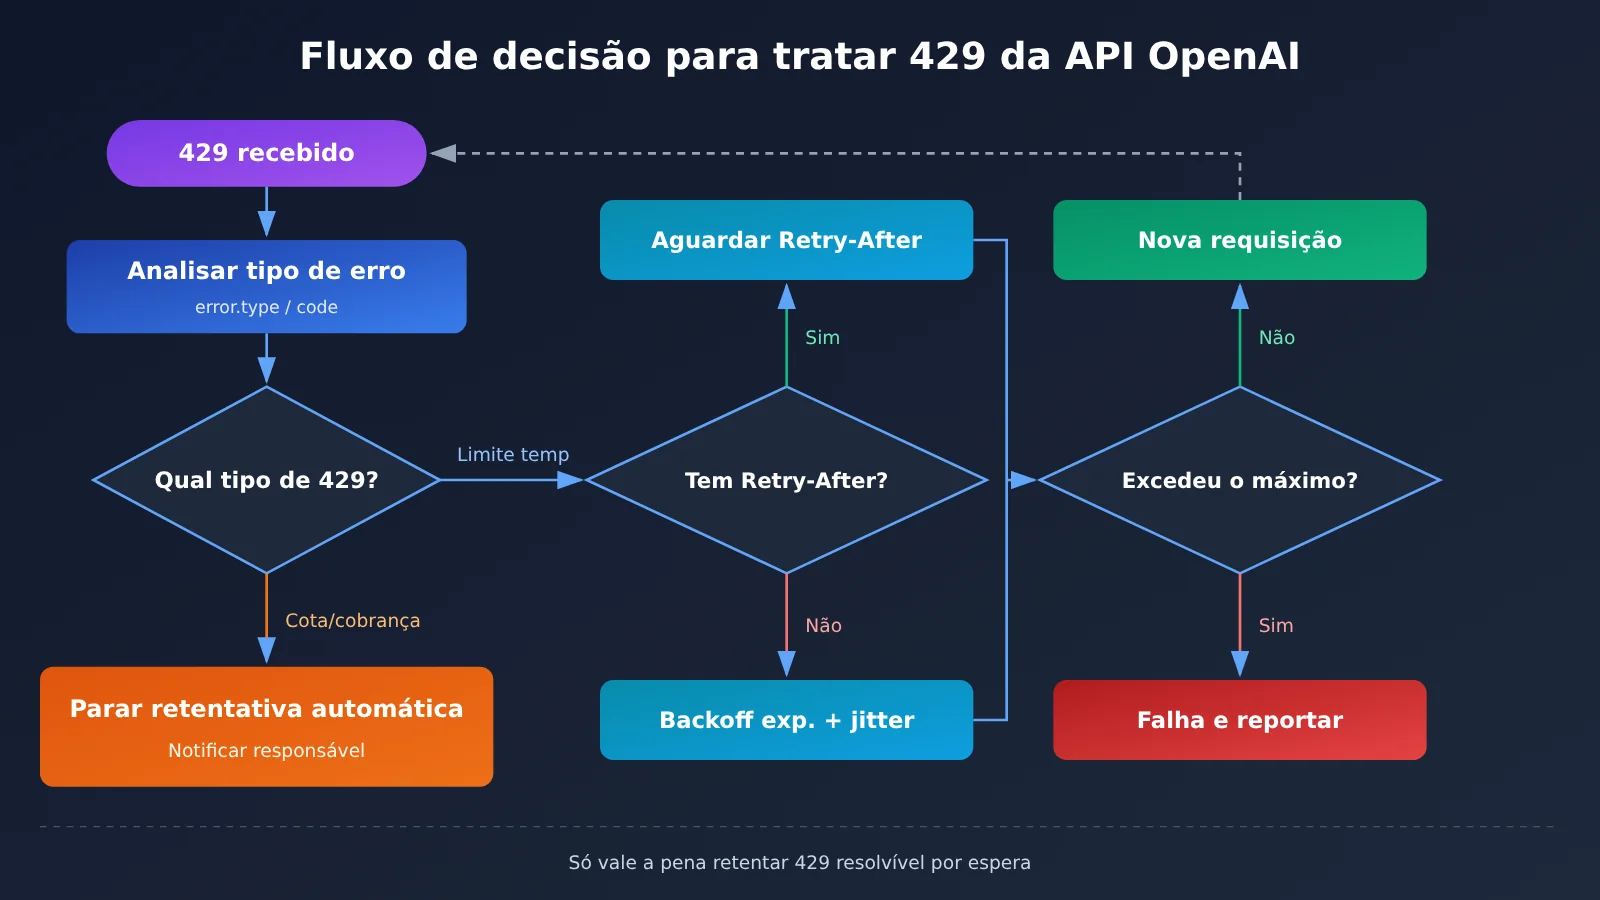
Como a OpenAI recomenda tentar novamente após um 429
Para limites de taxa temporários que valem a pena tentar novamente, as recomendações oficiais podem ser resumidas em duas regras:
- Quando houver um Retry-After válido, siga-o. É o sinal mais direto fornecido pelo servidor, mais preciso do que o próprio cliente tentar adivinhar.
- Quando não houver Retry-After, use backoff exponencial com jitter aleatório. O tempo de espera aumenta a cada falha e recebe um valor aleatório adicional, evitando que todos os clientes tentem novamente ao mesmo tempo.
As duas regras pressupõem que “este 429 é do tipo que se resolve esperando”. Se for um problema de cota ou cobrança, até o algoritmo de backoff mais preciso vai apenas girar em falso.
Comportamento de nova tentativa automática do SDK oficial
O SDK oficial da OpenAI faz nova tentativa automática em erros de limite de taxa que se enquadram nas condições, e o comportamento específico depende da configuração do cliente. No SDK Python, por exemplo, dá para ajustar pelo parâmetro max_retries, ou definir como 0 para desligar a nova tentativa automática.
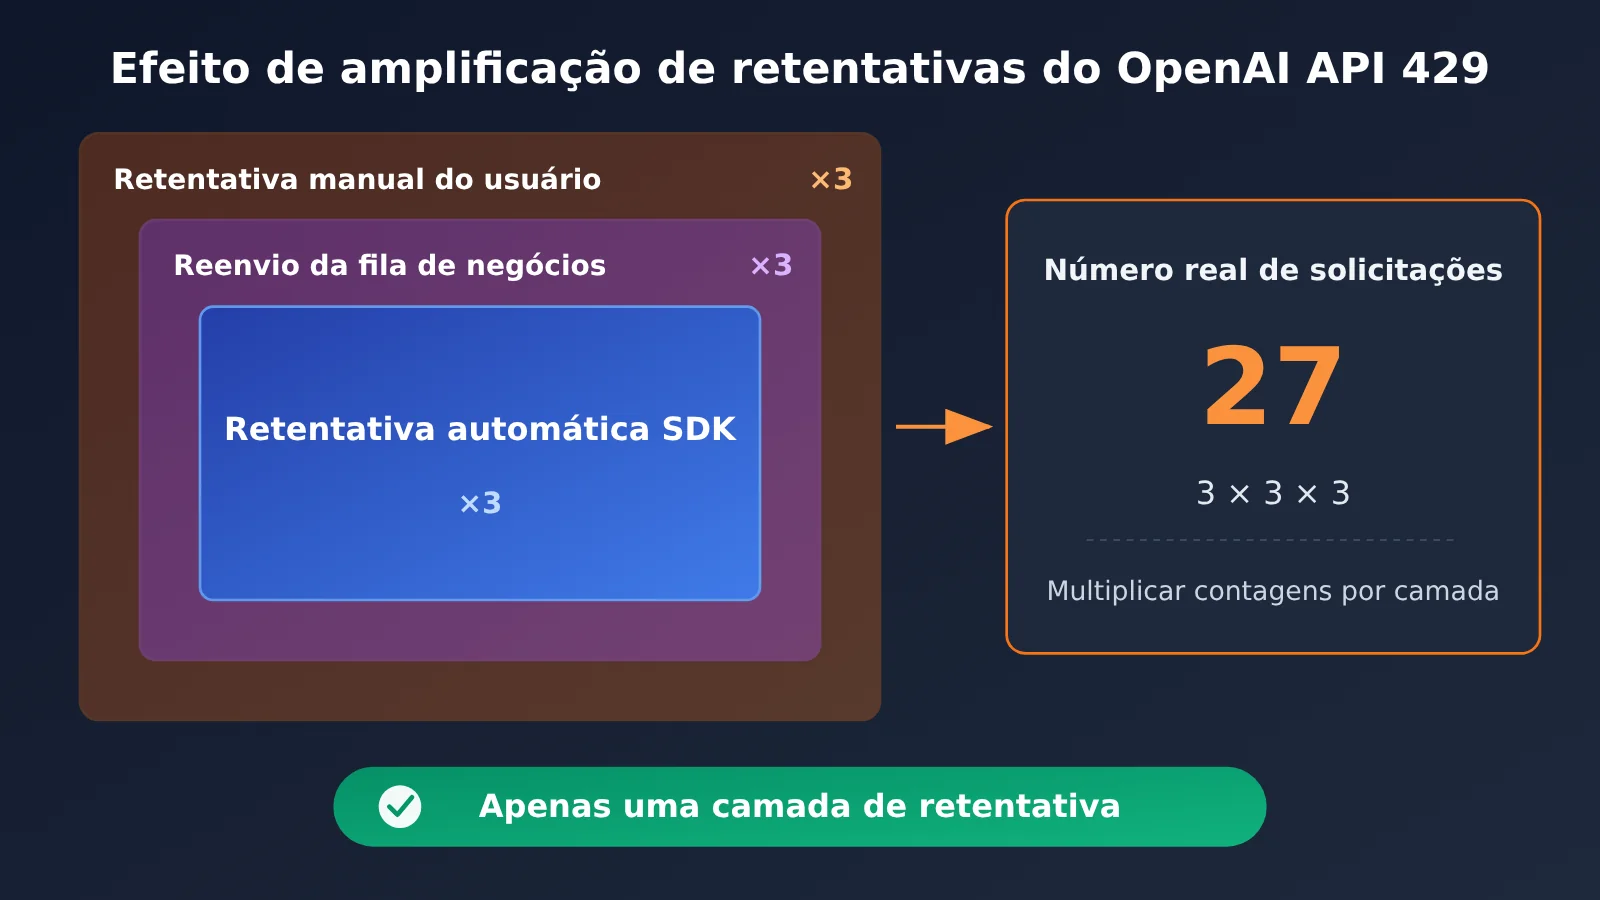
Isso quer dizer que, mesmo que seu código de negócio não tenha uma única linha de lógica de nova tentativa, a requisição pode já ter sido repetida algumas vezes. Se a camada de negócio ainda colocar mais uma camada de nova tentativa, o número real de requisições é a multiplicação das duas.
Erros no meio de uma requisição de streaming não podem ser sempre reenviados
A documentação oficial também destaca uma fronteira fácil de passar despercebida: depois que a saída em streaming já começou, os erros que ocorrem em seguida não podem ser tratados de forma uniforme reenviando toda a requisição. O usuário pode já ter visto parte do conteúdo, e sistemas downstream podem já ter consumido parte dos dados. Reenviar diretamente causa duplicação de conteúdo, inconsistência entre o antes e o depois, e ainda consome tokens duas vezes.
Análise: como colocar em prática o tratamento do erro 429 da OpenAI API na engenharia
O conteúdo a seguir é um julgamento de engenharia baseado nos fatos acima, e não as palavras oficiais da OpenAI.
Um exemplo de backoff para o erro 429 da OpenAI API que você pode adaptar diretamente
O exemplo abaixo aplica alguns princípios: desativar o retry automático do SDK, deixando que a camada de negócio cuide disso de forma centralizada; lançar imediatamente erros relacionados a cota; priorizar o cabeçalho Retry-After quando presente; usar backoff exponencial com jitter completo quando ele não existir; e limitar o número máximo de tentativas.
import random
import time
from openai import OpenAI, RateLimitError

# Desativa o retry automático do SDK para evitar sobreposição com o retry customizado abaixo
client = OpenAI(max_retries=0)

# Tipos de 429 que não se resolvem esperando (conforme a resposta real e a documentação oficial)
NON_RETRYABLE_CODES = {"insufficient_quota"}


def parse_retry_after(response):
    """Interpreta o valor em segundos do Retry-After; retorna None se for inválido. Formatos de data HTTP podem ser tratados conforme a necessidade."""
    if response is None:
        return None
    value = response.headers.get("retry-after")
    try:
        seconds = float(value)
        return seconds if seconds >= 0 else None
    except (TypeError, ValueError):
        return None


def call_with_backoff(messages, model, max_attempts=5, base=1.0, cap=60.0):
    for attempt in range(max_attempts):
        try:
            return client.chat.completions.create(model=model, messages=messages)
        except RateLimitError as e:
            if e.code in NON_RETRYABLE_CODES:
                raise  # Problemas de cota/cobrança: deixa o fluxo de tratamento da conta cuidar disso
            if attempt == max_attempts - 1:
                raise  # Passou do limite máximo: deixa a fila ou o alerta cuidar disso
            wait = parse_retry_after(e.response)
            if wait is None:
                # Jitter completo: sorteia um valor aleatório em [0, limite exponencial]
                wait = random.uniform(0, min(cap, base * 2 ** attempt))
            time.sleep(wait)
Os valores de max_attempts, base e cap no exemplo são apenas pontos de partida, não valores recomendados. Cada conta tem níveis de limite diferentes e formatos de tarefa diferentes. Não existe um número único de concorrência ou de tentativas que sirva para todas as contas; ajuste com base nos seus próprios dados de monitoramento.
Ajuste conforme o tipo de gargalo: soluções diferentes para gargalo de requisições e gargalo de tokens
O backoff só resolve “como esperar nesta vez”; não resolve “por que você sempre bate no limite”. Para reduzir os erros 429, primeiro é preciso entender qual limite está sendo atingido.
O gargalo de requisições tem como ponto-chave espaçar o ritmo de envio. Na entrada da fila, faça uma liberação em taxa constante, como um token bucket ou envio em intervalos fixos, para evitar que muitas tarefas surjam no mesmo segundo. Ao iniciar tarefas em lote, também é preciso escalonar, sem disparar tudo junto no mesmo horário exato.
O gargalo de tokens tem como ponto-chave reduzir o volume de cada requisição. Desperdícios comuns incluem: levar junto, em cada turno da conversa, um comando de sistema longo e todo o histórico; passar repetidamente o mesmo documento grande em várias requisições; e enfiar o material inteiro no modelo quando na verdade só uma parte dele é necessária. Primeiro podar, resumir ou fazer recuperação e só depois enviar costuma ser muito mais eficaz do que aumentar o número de tentativas.
O status da fila precisa distinguir “aguardando nova tentativa” de “bloqueio de conta”
Muitos sistemas têm apenas dois estados: “na fila” e “falhou”. Quando aparece um 429, isso gera dois tipos de erro de julgamento: a limitação de taxa temporária é tratada como falha e a tarefa é descartada, enquanto um problema de cota é tratado como “na fila” e a espera se torna infinita.
A abordagem mais razoável é dividir os dois tipos de 429 em dois estados, com exibições diferentes:
| Status da fila | Condição de disparo | Informação a exibir | Tratamento posterior |
|---|---|---|---|
| Aguardando nova tentativa | Limitação de taxa temporária | Horário previsto da próxima tentativa, número de tentativas já realizadas | Nova tentativa automática no horário previsto; ao atingir o limite, passa a falha |
| Bloqueio de conta | Cota, cobrança, limite de uso da organização | Motivo do bloqueio (ex.: cota insuficiente) | Pausar as tarefas subsequentes da mesma conta e notificar o responsável |
| Falha | Limite de novas tentativas excedido ou outro erro irrecuperável | Tipo de erro e informação original | Intervenção manual ou degradação do negócio |
O “bloqueio de conta” tem um efeito colateral. As outras tarefas da mesma conta provavelmente também vão encontrar o mesmo 429; nesse caso, o certo é pausar tudo de uma vez, em vez de deixar cada tarefa bater na parede por conta própria.
Investigar a sobreposição de novas tentativas: SDK, fila e botão manual
Se você perceber que, quanto mais tenta novamente, mais 429 aparece, a primeira coisa a fazer é verificar se há várias camadas de nova tentativa ativas ao mesmo tempo. A cadeia típica é: o SDK tenta novamente automaticamente algumas vezes, a fila de negócio reenvia a tarefa mais algumas vezes depois da falha, e o usuário na interface vê o erro e clica manualmente em “tentar novamente”. Multiplicando as três camadas, uma requisição original pode virar mais de uma dúzia de requisições reais, e essas requisições costumam se concentrar dentro da janela de limitação de taxa, justamente agravando a limitação.
Na investigação, recomendo confirmar camada por camada:
- Camada do SDK: confirme o valor real de
max_retries, não confie no valor padrão de memória. - Camada da fila: confirme se a tarefa é reenviada automaticamente após falhar e se o reenvio tem backoff.
- Camada de interação: confirme se o botão “tentar novamente” fica desabilitado durante a espera e se exibe o horário da próxima tentativa.
- Camada de log: atribua um ID único a cada tarefa original e conte quantas requisições ela realmente enviou.
O princípio é simples: mantenha apenas uma camada responsável por novas tentativas em cada cadeia, e as demais camadas apenas repassam o estado.
Cenários de streaming exigem uma estratégia de recuperação própria para 429 da OpenAI API
Quando uma requisição de streaming encontra 429 ao estabelecer a conexão e antes de produzir qualquer saída, ela pode ser tratada como uma requisição normal. Depois que a saída já começou, porém, a decisão sobre “reproduzir ou não” deve ser passada para o negócio. Por exemplo, avisar claramente ao usuário que a geração foi interrompida e deixar que ele escolha gerar novamente; ou descartar a parte já emitida e substituí-la por inteiro. Não faça replay silencioso em segundo plano, pois isso faz a interface exibir dois trechos duplicados.
Ao migrar para outras plataformas, não copie a semântica de 429 da OpenAI
A classificação de erros, os valores de error.code, o comportamento de Retry-After e os cabeçalhos de resposta descritos neste artigo são a semântica da API oficial da OpenAI. Se você chama o modelo por meio de gateways de terceiros, proxies ou plataformas de agregação (por exemplo, APIYI), os códigos de erro, as dimensões de limitação de taxa e as recomendações de nova tentativa do outro lado devem seguir a documentação da própria plataforma, verificados separadamente, sem copiar diretamente o comportamento da OpenAI. Uma abordagem mais segura é fazer uma camada de normalização de erros na camada de integração, mapear os 429 de diferentes origens para os três estados citados neste artigo — “aguardar nova tentativa / conta bloqueada / falha” — e então entregar ao módulo de nova tentativa unificado.
Mudanças que merecem atenção contínua
A documentação de códigos de erro e a documentação de limites de taxa da OpenAI estão em manutenção constante. Os níveis de limite, as dimensões de medição e os campos de cabeçalho de resposta podem ser ajustados a qualquer momento. Recomendo manter no código os logs com o texto original do erro e revisar periodicamente a lógica de decisão comparando com a documentação oficial. Além disso, não coloque a ideia de que “todo 429 pode ser resolvido esperando” em nenhuma configuração padrão. Se essa suposição entrar em vigor quando a cota estiver esgotada, o preço será uma fila de tarefas girando em falso a noite inteira.
No fundo, o 429 é o servidor dizendo “vá com calma” e, às vezes, também dizendo “este caminho não funciona por enquanto”. Distinguir qual dos dois casos é e só então decidir se é hora de esperar, mudar ou parar é mais importante do que qualquer algoritmo de retentativa por mais sofisticado que seja. Como dizem os Analectos de Confúcio, no capítulo Zi Lu:
“Não queira pressa, não se apegue a pequenos ganhos. Querer pressa não leva a nada; apegar-se a pequenos ganhos impede grandes conquistas.”