Nota do autor: quais são os componentes do preço do GPT-6.1 Terra, como funcionam as faixas de contexto longo e quanto o cache pode economizar? Este artigo explica tudo com preços oficiais e três exemplos de cálculo.
O GPT-6.1 Terra foi lançado em 26 de outubro de 2026 com foco em velocidade e economia. Muita gente olha a página de preços pela primeira vez e só guarda a informação de que “a entrada custa US$ 1”. Quando a fatura chega, porém, a conta não bate. Isso acontece porque o preço do Terra combina quatro componentes de cobrança, duas faixas de contexto e três modos de processamento.
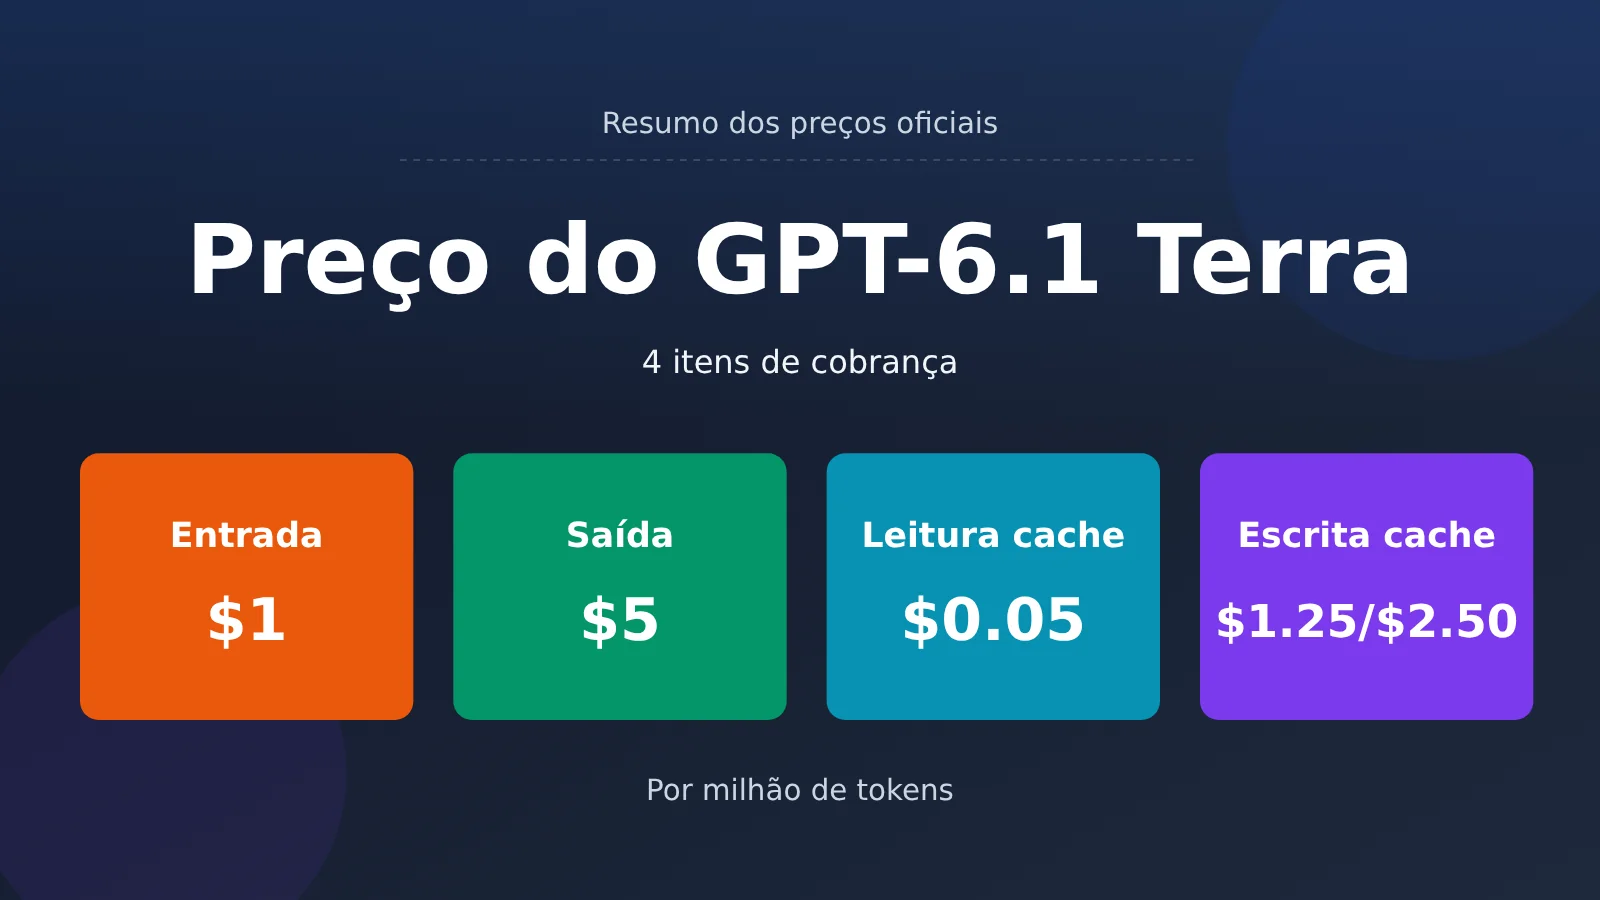
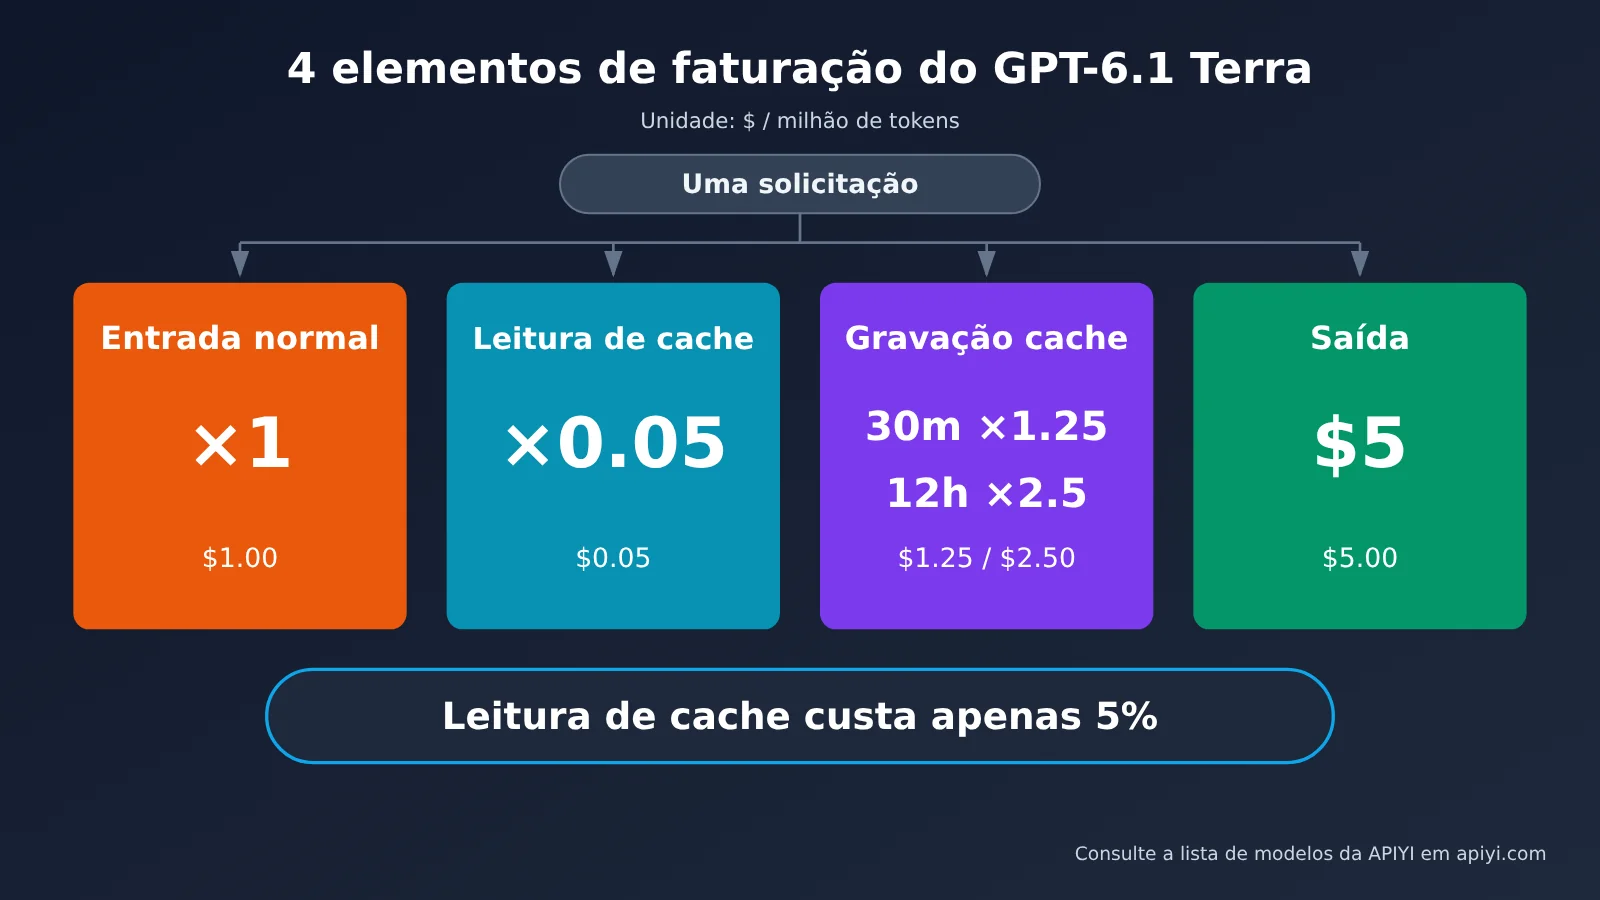
Resumindo a estrutura de preços do Terra: cada solicitação é cobrada por quatro componentes: entrada comum, saída, leitura de cache e gravação em cache. A gravação em cache tem dois períodos de retenção: 30 minutos e 12 horas. Quando a entrada de uma única solicitação ultrapassa 272 mil tokens, toda a solicitação passa para a segunda faixa. Também há três modos de processamento: Batch e Flex custam metade do preço, enquanto Fast custa o dobro.
Sobre os dados: os preços oficiais vêm da página do modelo e da página de preços da OpenAI. Os dados informados pela própria empresa vêm do blog de lançamento de 26 de outubro de 2026. Os dados de terceiros vêm da Artificial Analysis e foram coletados em 27 de outubro de 2026.
Principais pontos sobre os preços do GPT-6.1 Terra
Começando pelo modelo: o ID é gpt-6.1-terra, com apenas um snapshot. A janela de contexto é de 1.050.000 tokens, com limite de 922.000 tokens de entrada e 128.000 de saída por requisição. O conhecimento vai até 01/06/2026. O modelo aceita texto e imagens como entrada, mas gera apenas texto. Áudio e vídeo não são compatíveis.
O preço padrão se aplica a requisições com até 272K tokens de entrada. Todos os valores são por milhão de tokens:
| Item de cobrança | Preço padrão (≤272K) | Descrição |
|---|---|---|
| Entrada | $1.00 | Entrada não encontrada no cache |
| Saída | $5.00 | Inclui a saída gerada durante o raciocínio |
| Leitura de cache | $0.05 | 0,05 vez o preço de entrada |
| Gravação em cache (30 minutos) | $1.25 | 1,25 vez o preço de entrada |
| Gravação em cache (12 horas) | $2.50 | 2,5 vezes o preço de entrada |
Detalhes da cobrança de cache do GPT-6.1 Terra
A leitura de cache custa apenas 5% do preço de entrada. Na maioria dos modelos da mesma geração, esse valor é de 10%. É nesse item que o Terra apresenta a maior redução em relação à geração anterior.
O valor da gravação em cache é o preço total, não uma taxa adicional ao preço de entrada. Os tokens gravados em cache são cobrados diretamente a $1.25 ou $2.50, sem uma segunda cobrança de $1.00. Há mais algumas regras importantes:
- O prefixo mínimo para uso do cache é de 1.024 tokens. Abaixo desse tamanho, ele não é armazenado.
- A retenção de 12 horas só pode ser configurada na Responses API, por meio de
prompt_cache_options.ttl. - Se
ttlreceber um valor inválido, a API retornará400 invalid_request_error.
Preço do GPT-6.1 Terra para contextos longos: faixa de 272K
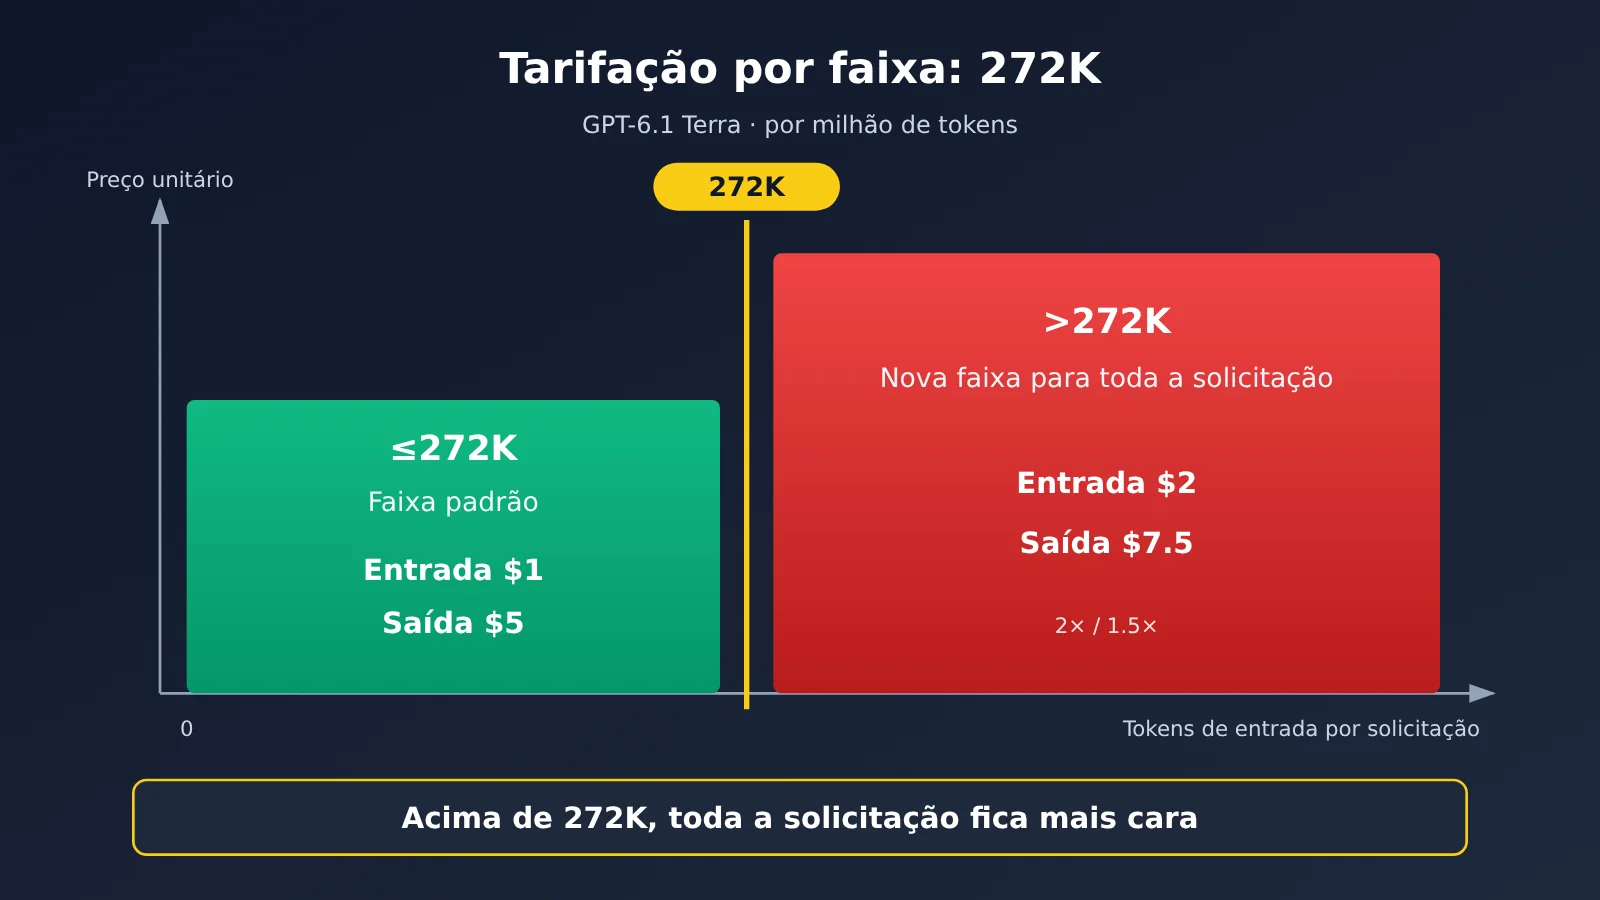
Esta é a regra que mais pode pegar você de surpresa. Quando a entrada de uma única requisição ultrapassa 272K tokens, a requisição inteira passa para a segunda faixa: os preços de entrada e cache dobram, e o preço de saída passa a ser 1,5 vez maior. O novo preço é aplicado a todos os tokens, não apenas aos que excedem o limite.
| Item de cobrança | ≤272K | >272K (requisição inteira) | Multiplicador |
|---|---|---|---|
| Entrada | $1.00 | $2.00 | 2× |
| Saída | $5.00 | $7.50 | 1.5× |
| Leitura de cache | $0.05 | $0.10 | 2× |
| Gravação de cache por 30 minutos | $1.25 | $2.50 | 2× |
| Gravação de cache por 12 horas | $2.50 | $5.00 | 2× |
Outras faixas de cobrança do GPT-6.1 Terra
| Modo | Regra de preços | Quando usar |
|---|---|---|
| Batch / Flex | 50% do preço padrão: entrada $0.50, saída $2.50, leitura de cache $0.025, gravação de cache $0.625 (30 min) / $1.25 (12 h) | Processamento em lote offline e tarefas que toleram maior latência |
| Fast | 2 vezes o preço padrão: entrada $2.00, saída $10.00 | Aplicações online sensíveis à latência |
| Ultrafast | O Terra não é compatível; disponível apenas para gpt-6-astra e gpt-6.1-sol | — |
| Processamento regional / FedRAMP | Acréscimo de 10%, aplicável a modelos lançados após 2026-03-05 | Residência de dados e conformidade |
Não encontramos valores explícitos para o cache no modo Fast na página oficial que consultamos, então consideramos essa informação como «não divulgada oficialmente». Além disso, o Priority processing foi renomeado para Fast mode em 2026-07-30. Fique atento a essa mudança ao consultar documentos antigos.
Comparativo de preços do GPT-6.1 Terra: geração atual e anterior
| Modelo | Entrada | Saída | Leitura de cache | Gravação de cache 30 min | Lista de modelos da APIYI apiyi.com (2026-10-27) |
|---|---|---|---|---|---|
| gpt-6-astra | $10.00 | $50.00 | $1.00 | $12.50 | Disponível |
| gpt-6.1-sol | $2.00 | $10.00 | $0.10 | $2.50 | Disponível |
| gpt-6.1-terra | $1.00 | $5.00 | $0.05 | $1.25 | Disponível |
| gpt-6-sol | $2.00 | $10.00 | $0.20 | $2.50 | Disponível |
| gpt-6-luna | $0.10 | $0.50 | $0.01 | $0.125 | Disponível |
| gpt-5.6-terra | $2.00 | $12.00 | $0.20 | $2.50 | Disponível |
Em comparação com o GPT-5.6 Terra, o preço de entrada do Terra caiu 50%, o de saída caiu cerca de 58% e o de leitura de cache caiu 75%. Segundo o blog oficial, o preço padrão da API é 50% menor que o do GPT-5.6 Terra e o do GPT-6.1 Sol.
Preço do GPT-6.1 Terra na prática: três exemplos
Todos os cálculos abaixo usam o preço por milhão de tokens: número de tokens × preço ÷ 1.000.000.
Exemplo 1: registro de faturas em lote
Suponha que cada chamada tenha 2.000 tokens de entrada (incluindo uma imagem de fatura) e 300 tokens de saída, com 5.000 chamadas por dia.
Sem uso do cache:
- Entrada: 2.000 × US$ 1 ÷ 1 milhão = US$ 0,0020
- Saída: 300 × US$ 5 ÷ 1 milhão = US$ 0,0015
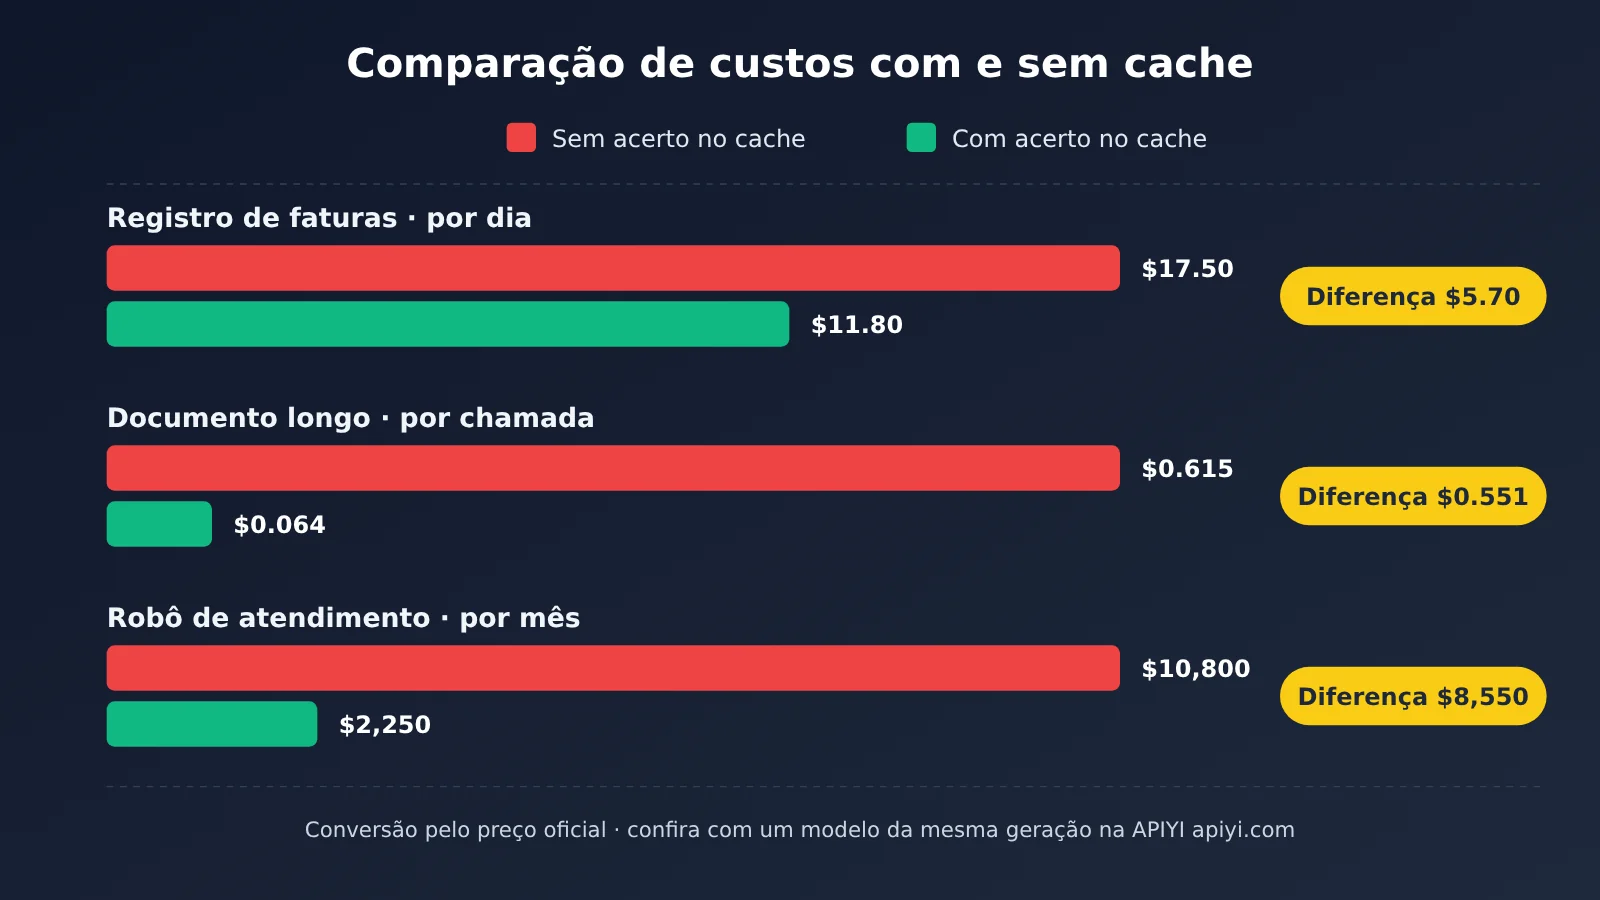
- Total por chamada: US$ 0,0035; 5.000 chamadas por dia × US$ 0,0035 = US$ 17,50
Com uso do cache: suponha que as instruções fixas do sistema e as descrições dos campos somem 1.200 tokens armazenados em cache (acima do limite mínimo de 1.024). Os 800 tokens restantes correspondem à imagem e a outros conteúdos variáveis.
- Leitura do cache: 1.200 × US$ 0,05 ÷ 1 milhão = US$ 0,00006
- Entrada normal: 800 × US$ 1 ÷ 1 milhão = US$ 0,0008
- Saída: US$ 0,0015
- Total por chamada: US$ 0,00236; US$ 11,80 por dia, uma economia diária de US$ 5,70 em relação ao cenário sem cache
Depois que o cache expira, é preciso gravá-lo novamente. O custo de gravação com retenção de 30 minutos é de 1.200 × US$ 1,25 ÷ 1 milhão = US$ 0,0015. Diluído nas 5.000 chamadas diárias, esse valor é desprezível. Como o registro de faturas geralmente não exige resposta em tempo real, também é possível usar o Batch. Nesse caso, sem cache, o custo por chamada é de 2.000 × US$ 0,5 ÷ 1 milhão + 300 × US$ 2,5 ÷ 1 milhão = US$ 0,00175, ou US$ 8,75 por dia.
Exemplo 2: revisão de um documento longo (acima de 272K)
Suponha uma entrada de 300.000 tokens e uma saída de 2.000 tokens em uma única solicitação. Como a entrada ultrapassa 272K, toda a solicitação é cobrada pela segunda faixa.
Sem uso do cache:
- Entrada: 300.000 × $2 ÷ 1M = $0,60
- Saída: 2.000 × $7,5 ÷ 1M = $0,015
- Total por solicitação: $0,615
Com uso do cache: ao fazer várias perguntas sobre o mesmo documento, suponha que o prefixo do documento, com 290.000 tokens, seja recuperado do cache e que a nova pergunta ocupe 10.000 tokens.
- Leitura do cache: 290.000 × $0,10 ÷ 1M = $0,029
- Entrada comum: 10.000 × $2 ÷ 1M = $0,020
- Saída: $0,015
- Total por solicitação: $0,064, uma economia de $0,551 em relação à solicitação sem cache
A primeira solicitação precisa gravar os dados no cache. Com retenção de 30 minutos, o custo inicial é 290.000 × $2,5 ÷ 1M + $0,02 + $0,015 = $0,76. Basta fazer uma pergunta adicional sobre o mesmo documento para que o total das duas solicitações seja de $0,824, menos que os $1,23 de duas solicitações sem cache.
Há outra maneira ainda mais direta de economizar: reduzir a entrada para até 272K. Com 270.000 tokens de entrada e 2.000 tokens de saída, o custo é 270.000 × $1 ÷ 1M + 2.000 × $5 ÷ 1M = $0,28, menos da metade do custo na segunda faixa.
Exemplo três: chatbot de atendimento com alta taxa de acerto no cache
Suponha que cada interação receba 50.000 tokens de entrada, dos quais 45.000 sejam encontrados no cache, e gere 800 tokens de saída. São 200 mil interações por mês.
Sem acerto no cache:
- Entrada: 50.000 × $1 ÷ 1M = $0,05; saída: 800 × $5 ÷ 1M = $0,004
- $0,054 por interação; por mês: 200.000 × $0,054 = $10.800
Com acerto no cache:
- Leitura do cache: 45.000 × $0,05 ÷ 1M = $0,00225
- Entrada normal: 5.000 × $1 ÷ 1M = $0,005
- Saída: $0,004
- $0,01125 por interação; $2.250 por mês, uma economia mensal de $8.550 em relação ao cenário sem acerto no cache
Se a leitura do cache fosse cobrada a 0,1 vez o preço da entrada, como acontece com a maioria dos modelos da mesma geração, o custo seria de $0,0135 por interação e $2.700 por mês. Nesse cenário, a tarifa de 0,05 vez do Terra economiza mais $450 por mês. Os cálculos acima não incluem a amortização do custo de gravação no cache.
Custo por tarefa do GPT-6.1 Terra: dados de terceiros
Os dados abaixo são da Artificial Analysis (coletados em 27/10/2026). São resultados de uma avaliação independente e não equivalem aos custos da sua operação. A distribuição de tokens nas tarefas avaliadas é diferente da dos seus pedidos reais. Para uma estimativa mais precisa, use os preços oficiais e a distribuição de tokens dos seus próprios pedidos.
| Modelo | Intelligence Index | Custo por tarefa | Velocidade de saída |
|---|---|---|---|
| GPT-6.1 Terra(max) | 48 | US$ 0,40 | 91 t/s |
| GPT-6.1 Sol | 52 | US$ 0,72 | 69,4 t/s |
| GPT-5.6 Terra | 42 | US$ 1,40 | 135,4 t/s |
| GPT-6 Astra | 53 | US$ 3,26 | 67,8 t/s |
| Claude Opus 5.5(Max) | 58 | US$ 5,98 | — |
Segundo esses dados, o índice do Terra é 5 pontos menor que o do Astra, enquanto seu custo por tarefa é cerca de 1/8 do Astra e 1/15 do Opus 5.5.
O blog oficial também apresenta algumas comparações de custo feitas pelo próprio fabricante, que não foram reproduzidas de forma independente:
- No Agents’ Last Exam, a configuração medium pontuou 15 pontos percentuais acima do GPT-5.6 Terra, com cerca de um terço do custo.
- A configuração max tem mais de 3 vezes a eficiência de tokens do Claude Opus 5.5, com um custo por tarefa cerca de 9 vezes menor.
Primeiros passos com o GPT-6.1 Terra: como integrar
Em 27 de outubro de 2026, gpt-6.1-terra já estava disponível para invocação direta na APIYI, em apiyi.com: US$ 1 para entrada, US$ 5 para saída, US$ 0,05 para leitura de cache e US$ 1,25 para gravação de cache, por milhão de tokens. Esses valores correspondem a um multiplicador de modelo de 0,5 e a um multiplicador de conclusão de 5 na plataforma, e são idênticos aos da faixa ≤272K do site oficial. Os modelos da mesma geração, gpt-6.1-sol e gpt-6-astra, e os da geração anterior, gpt-5.6-terra, gpt-6-sol e gpt-6-luna, também estão disponíveis. Consulte a lista de modelos da plataforma para confirmar modelos e preços. Para faixas de contexto longo, o valor final cobrado é o que aparece na fatura do console.
A integração exige apenas quatro passos:
- Crie uma conta na APIYI, em apiyi.com, e gere uma chave API.
- No SDK compatível com OpenAI, defina
base_urlcomohttps://api.apiyi.com/v1e preenchaapi_keycom sua chave. - Antes de fazer a chamada, consulte a lista de modelos atualizada em
api.apiyi.com/api/pricing, confira o preço unitário e os grupos disponíveis paragpt-6.1-terrae defina o campomodelcom esse ID. - Configure
reasoning.effortde acordo com a tarefa. Os valores possíveis sãonone / low / medium / high / xhigh / max, e o padrão émedium. - Se precisar de cache por 12 horas, use a Responses API e configure
prompt_cache_options.ttl. - Antes de colocar a aplicação em produção, confira nas estatísticas de usage retornadas quantos tokens foram atendidos pelo cache e use a fórmula deste artigo para estimar o custo.
🚀 Início rápido: consulte a lista de modelos da plataforma para confirmar modelos e preços. Contas novas recebem US$ 0,05 em crédito de teste. Na APIYI, em apiyi.com, basta definir
modelcomogpt-6.1-terrapara testar o fluxo de chamada e a lógica de cache. Se quiser comparar preços, é só trocar paragpt-6.1-sol.
Perguntas frequentes (FAQ)
Q1: Como resumir o preço do GPT-6.1 Terra?
Na faixa padrão (entrada de até 272K por requisição), os preços por milhão de tokens são: entrada $1, saída $5, leitura de cache $0.05 e gravação de cache $1.25 por 30 minutos ou $2.50 por 12 horas.
Q2: Acima de 272K, o preço maior se aplica só ao excedente?
Não. Quando a entrada de uma requisição ultrapassa 272K, a requisição inteira passa para a segunda faixa: os preços de entrada e cache dobram, e o preço de saída aumenta 1,5 vez.
Q3: Como escolher entre Batch e Fast?
Para tarefas offline, escolha Batch ou Flex: todos os itens de cobrança têm 50% de desconto. Para tarefas sensíveis à latência, você pode escolher Fast, mas pagará o dobro. O Terra não é compatível com Ultrafast.
Q4: A gravação de cache é cobrada à parte?
O preço da gravação de cache é o valor total, não uma taxa adicional. Os tokens gravados são cobrados a 1,25 ou 2,5 vezes o preço de entrada, sem uma segunda cobrança pela entrada normal. Em geral, basta reutilizar o mesmo prefixo uma vez para compensar o custo.
Q5: Posso usar o Terra na APIYI?
Sim. Desde 27/10/2026, o `gpt-6.1-terra` está disponível na APIYI, em apiyi.com, com os quatro itens de cobrança iguais aos da faixa de até 272K no site oficial. Consulte a lista de modelos da plataforma para confirmar os modelos e preços.
Q6: Posso usar diretamente o custo por tarefa de terceiros para fazer um orçamento?
Não é recomendado. Esse custo se refere a tarefas de avaliação e pode ter uma distribuição de tokens diferente da do seu negócio. Uma opção mais segura é testar requisições reais na APIYI, em apiyi.com, para medir a distribuição de tokens e calcular o custo com base nos preços oficiais.
Preços do GPT-6.1 Terra: principais pontos
- Quatro componentes de cobrança: entrada a $1, saída a $5, leitura de cache a $0,05 e escrita de cache em duas faixas: $1,25 e $2,50.
- 272K é o limite decisivo: acima dele, toda a requisição passa para outra faixa; o preço da entrada dobra e o da saída aumenta 1,5 vez.
- O cache oferece a maior economia: em um cenário de atendimento ao cliente, o custo mensal cai de $10.800 para $2.250.
- Batch/Flex custam metade, Fast custa o dobro; o Terra não oferece suporte a Ultrafast.
- Os custos por tarefa de terceiros são apenas uma referência: para fazer seu orçamento, é mais preciso calcular com base nos preços oficiais.
- Acesso pela plataforma: na APIYI apiyi.com, basta definir o campo
modelcomogpt-6.1-terrapara invocar o modelo. Consulte a lista de modelos da plataforma para confirmar a disponibilidade e os preços.
Resumo
A fatura do Terra depende principalmente de três fatores: se a entrada ultrapassa 272K, qual é a taxa de acerto do cache e se você escolheu Batch ou Fast. Controlando esses fatores, o custo de um mesmo volume de trabalho pode variar várias vezes.
Comece medindo a distribuição de tokens nas suas próprias requisições reais e depois calcule cada componente usando as fórmulas deste artigo. Você pode executar requisições reais com gpt-6.1-terra diretamente na APIYI apiyi.com e comparar os preços com o gpt-6.1-sol, da mesma geração.
📚 Referências
- Página do modelo OpenAI GPT-6.1 Terra: especificações e parâmetros de contexto
- Link:
platform.openai.com/docs/models/gpt-6.1-terra - Descrição: contexto, modalidades de entrada e saída e níveis de raciocínio
- Página de preços da OpenAI: preços padrão, contexto longo e Batch/Flex/Fast
- Link:
platform.openai.com/docs/pricing - Descrição: informações oficiais sobre todos os itens de cobrança
- Guia de Prompt Caching da OpenAI: regras de cache
- Link:
platform.openai.com/docs/guides/prompt-caching - Descrição: prefixo mínimo, configuração de TTL e cobrança pela gravação
- Artigo de lançamento do GPT-6.1 Terra: dados de custo informados pela fabricante
- Link:
openai.com/index/introducing-gpt-6-1-terra - Descrição: publicado em 26/10/2026; os dados não foram reproduzidos de forma independente
Autor: Equipe técnica da APIYI
Troca de informações técnicas: entre em contato conosco pela página inicial da APIYI em apiyi.com. Para mais informações, acesse a central de documentação em docs.apiyi.com