Nota do autor: Partindo de uma tarefa de desenvolvimento de software executada por um agente em 30 minutos, este artigo detalha os custos de entradas comuns, gravações e leituras de cache, saídas e interações com ferramentas ao longo de várias chamadas do agente. Também compara a cobrança pelo uso de cache de três provedores e mostra, com um exemplo de 12 chamadas, em que condições o cache realmente reduz os custos.
Em 9 de novembro de 2026, o Google Cloud lançou dois sistemas TPU de oitava geração: TPU 8tx e TPU 8i Max. A empresa também abriu o código do TPU Sync, usado para transferir KV Cache. A “parede da memória na era dos agentes” voltou a ser assunto, e muitos desenvolvedores naturalmente se perguntam: com o KV Cache subjacente cada vez mais rápido, a conta da API do meu agente também vai ficar mais barata?
Principal benefício: ao terminar de ler, você terá uma fórmula completa para calcular os custos de um agente, uma comparação da cobrança pelo uso de cache de três provedores e uma lista de otimizações de custos que já pode colocar em prática.
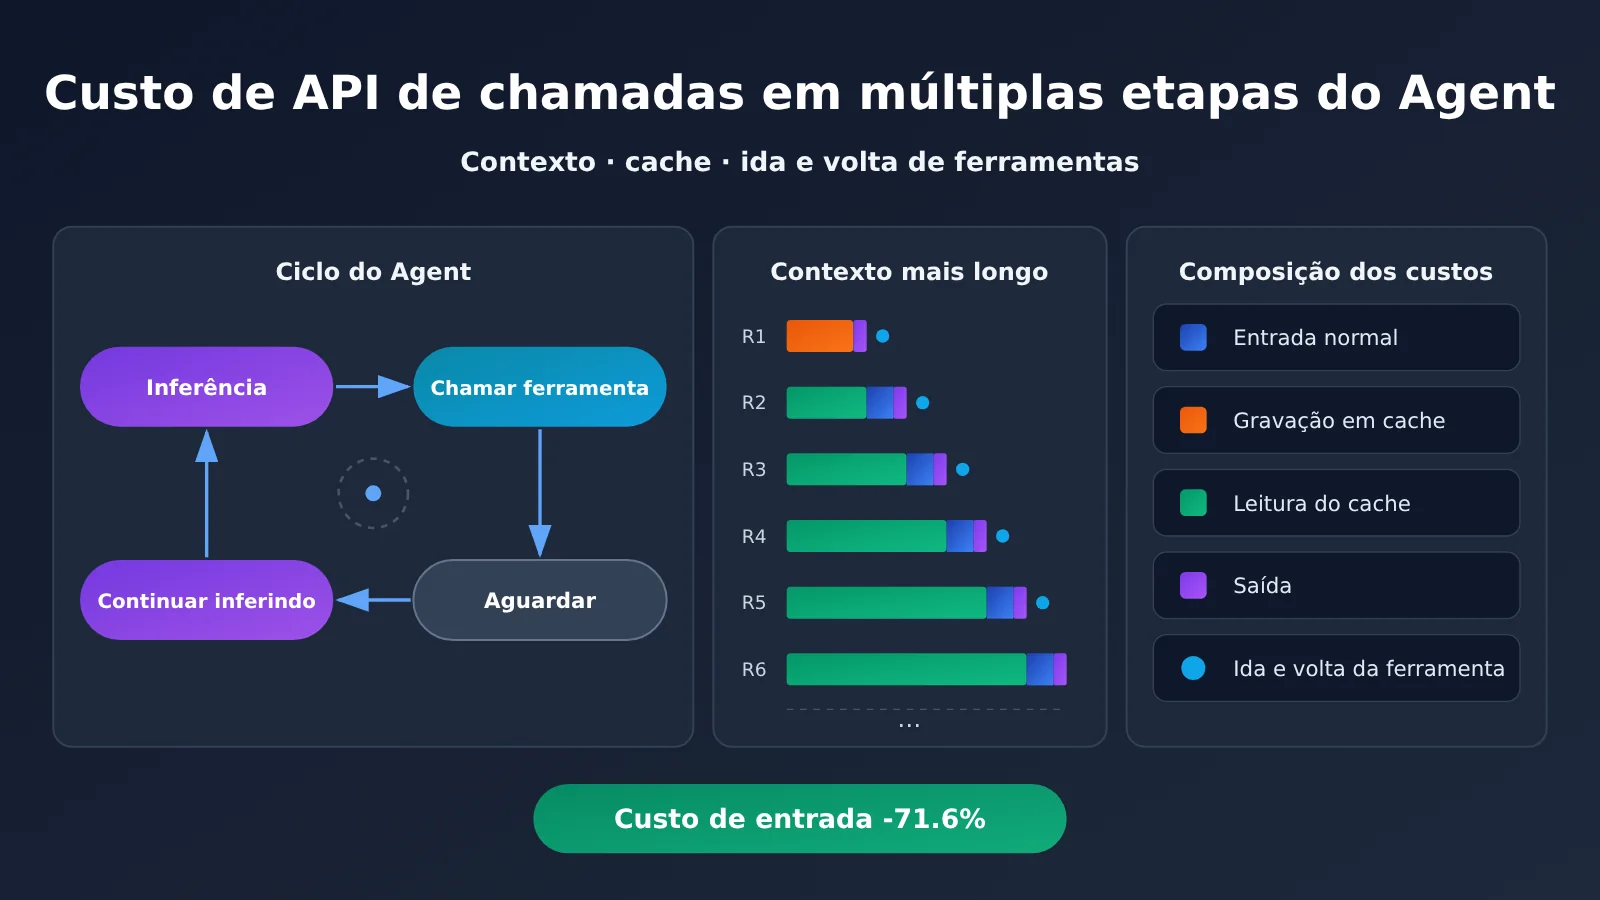
Custos de API em chamadas de várias etapas de um Agent: visão geral
| Item | Detalhes |
|---|---|
| Contexto | Em 2026-11-09, o Google lançou o TPU 8tx, o TPU 8i Max e o TPU Sync, com foco nos gargalos de memória e KV Cache dos Agents |
| Dúvida dos desenvolvedores | As otimizações de baixo nível podem reduzir a conta de API de um Agent? |
| Conclusão principal | A conta é determinada em conjunto por tokens de entrada comuns, gravações no cache, leituras do cache, tokens de saída, número de chamadas e custos de ferramentas |
| Variáveis-chave | Se o prefixo permanece estável, se o TTL do cache cobre o tempo de espera pelas ferramentas e se o contexto histórico cresce sem controle |
| Cenários afetados | Codificação com Agents, Agents para documentos longos, colaboração entre vários Agents e outros cenários com chamadas em várias etapas |
Como é uma tarefa de 30 minutos com várias chamadas de um Agent
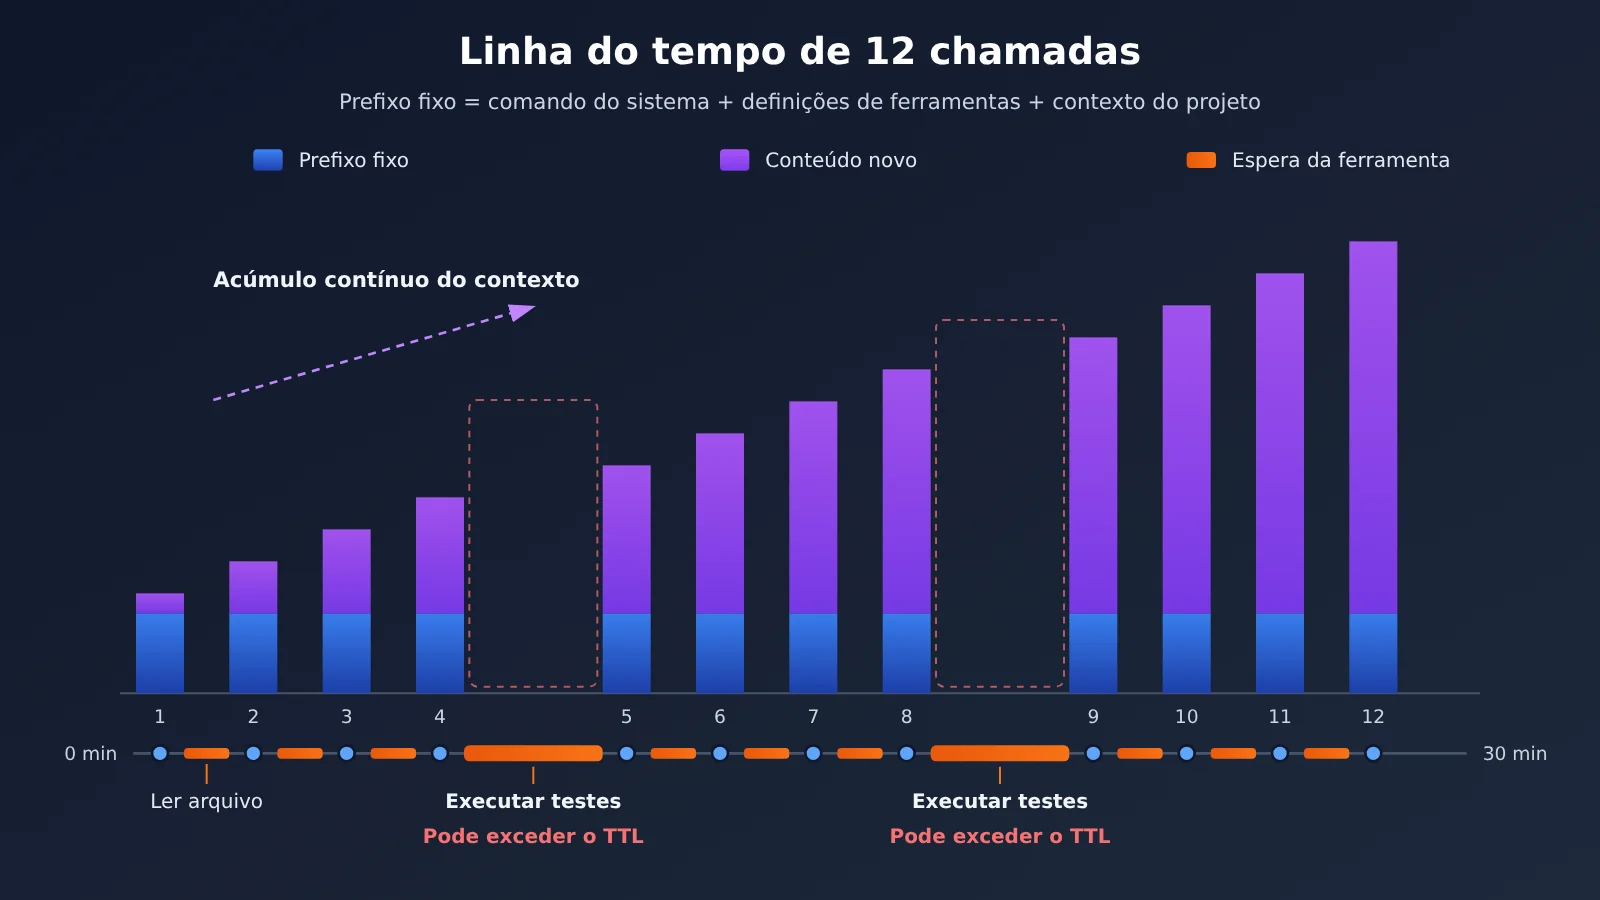
Imagine que um Agent de desenvolvimento de software recebe uma solicitação: corrigir falhas nos testes de um módulo. Primeiro, ele lê a estrutura do projeto e o código-fonte relevante, elabora um plano de alterações, usa ferramentas para editar arquivos e executar testes, aguarda os resultados e, em seguida, continua o raciocínio com base nos erros. Em 30 minutos, esse ciclo de “raciocínio — ferramenta — espera — raciocínio” pode se repetir mais de dez vezes.
O problema é que, essencialmente, as APIs de Modelos de Linguagem Grandes não têm estado. Em cada solicitação, o Agent precisa enviar novamente ao modelo o comando do sistema, as definições das ferramentas, o contexto do projeto e as conversas e saídas das ferramentas anteriores. A 12ª solicitação costuma incluir quase todo o histórico das 11 rodadas anteriores. É daí que vem a “recomputação do contexto”.
Quais são os componentes do custo de chamadas de API em múltiplas etapas de um Agent
Ao dividir uma tarefa de Agent, vemos que o custo inclui pelo menos cinco componentes. Os quatro primeiros são custos de tokens do modelo; o quinto ocorre fora do modelo, mas muitas vezes passa despercebido.
| Item de custo | Significado | Características de cobrança |
|---|---|---|
| Entrada comum | Tokens de entrada que não atingem o cache e são cobrados pelo preço padrão | Preço padrão de entrada |
| Gravação no cache | Parte da entrada usada para criar um cache reutilizável | Alguns provedores e modelos cobram uma tarifa maior que a de entrada padrão |
| Leitura do cache | Entrada que encontra dados no cache existente | Geralmente custa bem menos que a tarifa padrão de entrada |
| Tokens de saída | Conteúdo gerado pelo modelo, incluindo parâmetros de chamadas de ferramentas | Em geral, é a parte mais cara; o cache não reduz esse custo |
| Ferramentas e execução externa | Serviços externos, como busca, execução de código e bancos de dados | Cobrança conforme as tarifas de cada serviço; também aumentam o número de chamadas ao modelo |
Com base nisso, podemos escrever a fórmula do custo de uma tarefa:
Custo total da tarefa = Σ (entrada comum × tarifa de entrada + gravação no cache × tarifa de gravação + leitura do cache × tarifa de leitura + saída × tarifa de saída) + custos de ferramentas e execução externa
O símbolo Σ na fórmula representa a soma de cada chamada ao modelo feita durante a tarefa. Isso significa que o número de chamadas funciona como um multiplicador: quanto mais interações com ferramentas, mais chamadas ao modelo e mais vezes o prefixo fixo é cobrado. As chamadas de ferramentas não geram apenas o custo dos próprios serviços: elas também dividem uma etapa de raciocínio em várias chamadas, cada uma delas precisando incluir o contexto novamente.
Diferenças entre KV Cache, Prompt Cache e compressão de contexto em chamadas Agent com várias etapas
Ao falar sobre custos de Agent, é fácil confundir esses três conceitos. Eles atuam em camadas diferentes e têm impactos bem distintos na fatura.
| Tecnologia | Camada | O que significa na prática | Impacto para quem usa a API |
|---|---|---|---|
| KV Cache | Camada inferior da inferência do modelo | Armazena os estados Key/Value dos cálculos de atenção para evitar recalcular Tokens do histórico | O usuário não controla diretamente; afeta os custos e a latência do provedor |
| Prompt Cache | Camada de serviço da API | O provedor reutiliza prefixos repetidos dos comandos e cobra separadamente as gravações e leituras do cache | Aparece diretamente nos campos de cache da fatura |
| Compressão de contexto | Camada da aplicação | Resume, filtra ou corta o histórico antes de enviá-lo | Reduz a quantidade de Tokens enviados, mas pode eliminar detalhes |
Vale observar que a documentação oficial da OpenAI explica que o Prompt Cache armazena, na prática, tensores KV, e não o texto original dos Tokens. Por isso, o Prompt Caching pode ser entendido como a disponibilização e a tarifação do reaproveitamento de estados KV da camada inferior. Os dois conceitos têm relação, mas, para o usuário, o que fica visível são apenas as regras de cobrança.
Já a compressão de contexto é outra coisa. Ela muda o que as próximas solicitações “carregam”, e não a forma como o conteúdo é reutilizado. Quanto mais agressiva a compressão, menos Tokens são usados, mas maior é o risco de o Agent esquecer detalhes importantes.
Por que as otimizações de baixo nível em chamadas Agent com várias etapas não reduzem necessariamente a fatura
O TPU 8i Max anunciado pelo Google dobra a largura de banda da HBM e a SRAM no chip. Em testes internos na plataforma Ironwood, o TPU Sync reduziu em mais de 90% a latência de transferência do KV Cache. Já o Agent Compute Engine pausa as sessões quando o Agent fica ocioso e transfere a memória de trabalho para fora do chip. Essas otimizações melhoram o aproveitamento dos recursos do provedor e a latência de inferência — como o TTFT —, o que pode resultar em respostas mais rápidas para o usuário.
Mas o preço da API é definido comercialmente pelo provedor, e a fatura do usuário continua sendo calculada por Token. O aumento da eficiência do hardware pode influenciar os preços no longo prazo, mas essa redução não é automática nem proporcional. Além disso, em 2026-11-10, o TPU 8tx e o TPU 8i Max ainda estavam marcados como Coming soon, sem preços divulgados. Para quem desenvolve, o que dá para controlar imediatamente é a estrutura dos próprios Tokens, não o hardware do provedor.
Custo de chamadas de API em várias etapas por agentes: comparação da cobrança por cache entre três provedores
Os três principais provedores oferecem mecanismos de cache, mas diferem bastante na forma de acionamento, no TTL e nos critérios de cobrança. A tabela abaixo foi compilada com base na documentação oficial de cada provedor. Consulte as informações do modelo e da interface correspondentes para confirmar os detalhes.
| Provedor | Mecanismo de cache | Opções de TTL | Cobrança por gravação | Cobrança por leitura | Plataformas disponíveis |
|---|---|---|---|---|---|
| OpenAI | Prompt Caching, com cache automático de prefixos em alguns modelos | 30 minutos por padrão em alguns modelos novos; alguns modelos oferecem suporte a 12 horas | Em modelos e interfaces com as configurações correspondentes: 30 minutos custam 1,25 vez o preço normal de entrada; 12 horas, 2,5 vezes. Outros modos de cache podem não cobrar pela gravação | Em geral, 0,1 vez o preço normal de entrada; em alguns modelos, o valor é ainda menor | API oficial, APIYI apiyi.com |
| Anthropic | Prompt Caching | 5 minutos por padrão, com opção de estender para 1 hora | 5 minutos custam 1,25 vez o preço normal de entrada; 1 hora, 2 vezes | Varia conforme o modelo | API oficial, APIYI apiyi.com |
| Google Gemini | Context Caching, com cache implícito e explícito | É possível definir o TTL do cache explícito | O cache explícito tem cobranças adicionais, calculadas com base no número de tokens em cache e no tempo de armazenamento | Quando há correspondência no cache, o custo de entradas repetidas pode diminuir | API oficial, APIYI apiyi.com |
Como exemplo, considere os preços oficiais do Claude Sonnet 5.5: a entrada normal custa US$ 2,00 por milhão de tokens; a gravação em cache por 5 minutos custa US$ 2,50; por 1 hora, US$ 4,00; e a leitura do cache, US$ 0,10. A leitura do cache custa apenas 5% do valor da entrada normal, o que explica a grande redução de custos quando há prefixos repetidos.
Vale lembrar que a OpenAI informa claramente que o cache não é garantido em todas as chamadas. Além disso, o cache explícito do Gemini não oferece “armazenamento gratuito”: o tempo de armazenamento também é cobrado. O cache é um desconto condicionado, não uma redução de preço aplicada automaticamente.
🎯 Recomendação técnica: os recursos de cache, as regras de cobrança e os campos de resposta variam entre os modelos de diferentes provedores. Um gateway unificado não garante automaticamente os mesmos descontos de cache para todos os modelos. Recomendamos testar os modelos candidatos com o mesmo código compatível com OpenAI, usando a APIYI apiyi.com, e conferir os campos
usageretornados e a fatura.
Cálculo real do custo de cache em várias chamadas de um Agent: exemplo com 12 chamadas
Vamos retomar a tarefa de desenvolvimento de 30 minutos apresentada antes e usar os preços oficiais do Claude Sonnet 5.5 para montar um exemplo. As premissas são:
- A tarefa faz 12 chamadas ao modelo, cada uma com 22,000 tokens de entrada;
- Desses, 20,000 tokens são compostos por comando do sistema, definições de ferramentas e contexto do projeto repetidos;
- Cada chamada acrescenta 2,000 tokens;
- É usado um cache de 1 hora, e as solicitações seguintes reutilizam o conteúdo com sucesso.
Sem cache: 12 × 22,000 × $2 / 1,000,000 = $0.528.
Com cache de 1 hora: a gravação inicial de 20,000 tokens custa $0.080; os 2,000 tokens da entrada comum inicial custam $0.004; as 11 leituras seguintes do cache custam $0.022; e as 11 entradas adicionais custam $0.044. O total é $0.150, uma economia de aproximadamente 71.6% nas entradas.
Este exemplo considera apenas os tokens de entrada e não inclui tokens de saída, chamadas de ferramentas nem custos de serviços externos. O histórico de um Agent real também cresce a cada rodada, mas a conclusão continua a mesma: o contexto repetido é o custo que mais tende a se multiplicar nas chamadas sucessivas de um Agent.
Como a expiração do cache, as mudanças no prefixo e o TTL afetam o custo de um Agent
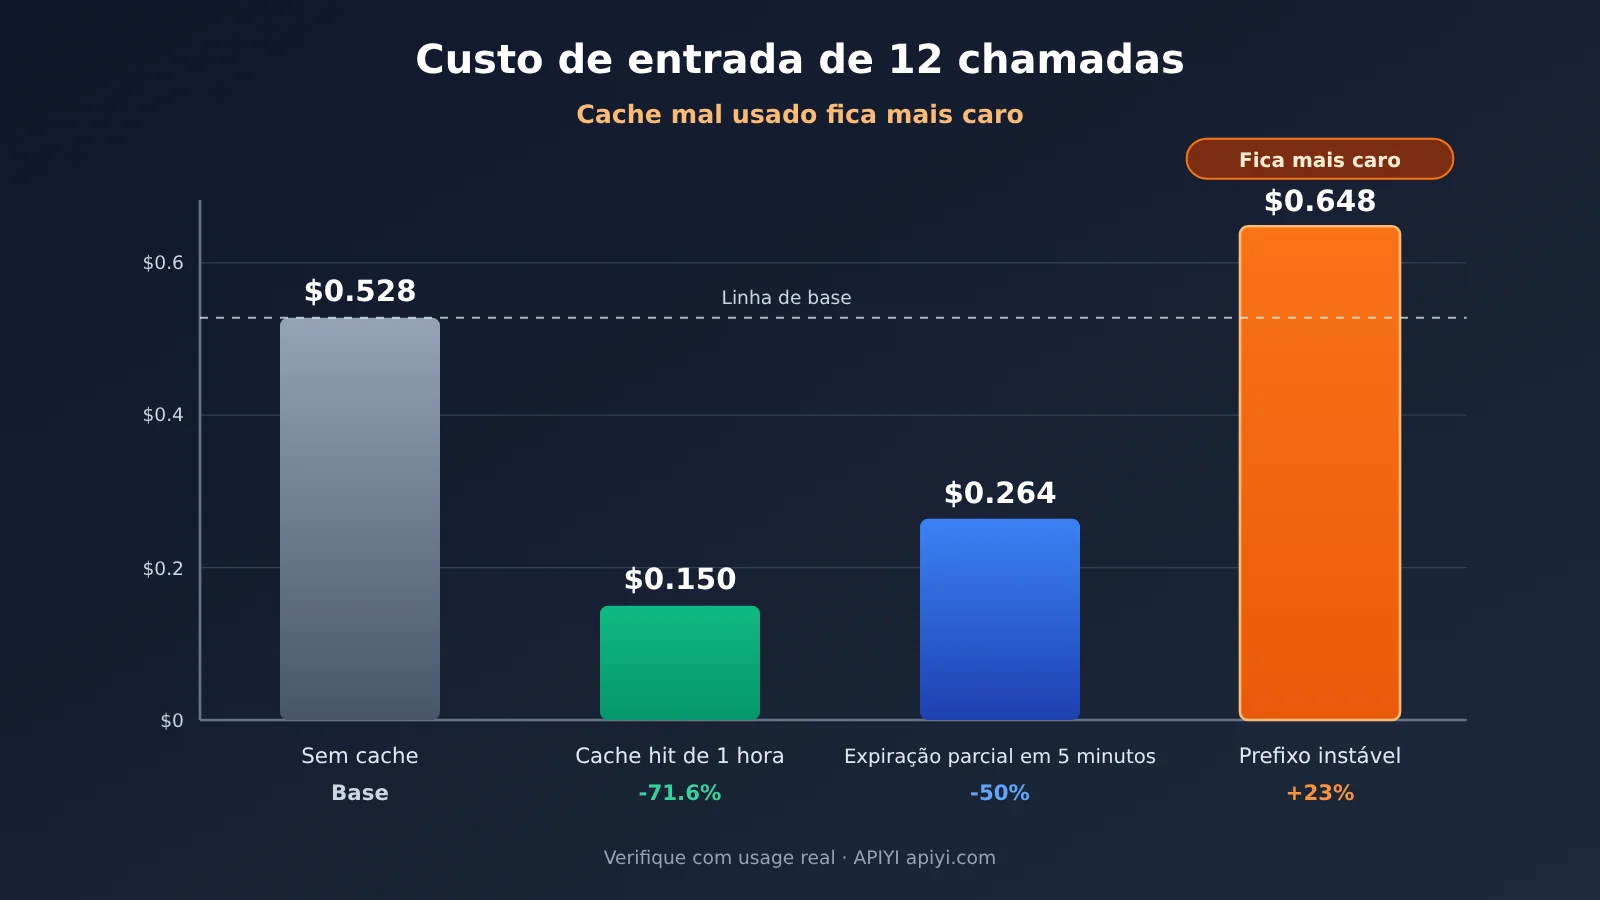
O exemplo acima representa uma situação ideal. A seguir, usamos os mesmos preços para analisar três desvios comuns. (Os cenários ilustrativos abaixo foram calculados neste artigo com base nos preços oficiais.)
| Cenário | Premissa | Custo de entrada | Em relação a não usar cache |
|---|---|---|---|
| Sem cache | As 12 chamadas usam entrada comum | $0.528 | Referência |
| Cache de 1 hora com todos os acertos | 1 gravação e 11 leituras | $0.150 | Economia de aproximadamente 71.6% |
| Cache de 5 minutos com todos os acertos | Preço de gravação de $2.50 e 11 leituras | $0.120 | Economia de aproximadamente 77.3% |
| Cache de 5 minutos com expiração parcial | A espera por ferramentas causa 4 gravações e 8 leituras | $0.264 | Economia de aproximadamente 50% |
| Prefixo instável | O prefixo muda a cada chamada; as 12 são cobradas como gravações com cache de 5 minutos | $0.648 | Custa aproximadamente 23% a mais |
Alguns pontos que podem ajudar diretamente na tomada de decisão:
- O TTL precisa cobrir o tempo de espera pelas ferramentas: gravar no cache de 5 minutos custa menos, mas, se a execução de um teste ou a confirmação manual ultrapassar esse tempo, o cache expira e precisa ser gravado novamente. A economia diminui bastante.
- Manter o prefixo estável é mais importante do que o TTL: colocar um timestamp ou ID aleatório no início do comando impede que as chamadas seguintes encontrem o cache. Nos modos em que há cobrança adicional pela gravação, o cache pode acabar deixando a conta mais cara.
- Um TTL mais longo não é necessariamente melhor: a gravação com TTL de 1 hora custa 1.6 vez o valor da gravação com TTL de 5 minutos. Só vale a pena quando o intervalo entre chamadas pode realmente passar de 5 minutos.
Como reduzir os custos de API em chamadas de Agent com várias rodadas
Exemplo mínimo: registrar os acertos de cache em cada chamada
O primeiro passo para otimizar os custos é “enxergá-los”. O código abaixo faz uma solicitação pela interface compatível com a OpenAI e imprime os campos relacionados ao cache em usage:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com a OpenAI da APIYI
)

resp = client.chat.completions.create(
    model="your-model-name",  # Substitua pelo modelo que deseja testar
    messages=[
        {"role": "system", "content": "固定的系统提示词与工具说明……"},
        {"role": "user", "content": "本轮新增的任务内容"}
    ]
)
usage = resp.usage
details = getattr(usage, "prompt_tokens_details", None)
print("输入:", usage.prompt_tokens, "输出:", usage.completion_tokens,
      "缓存命中:", getattr(details, "cached_tokens", None))
Ver implementação completa: prefixo estável + rastreamento de custos por tarefa
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Prefixo fixo: instruções do sistema, definições de ferramentas e contexto compartilhado do projeto. Mantenha-o no início e exatamente igual, byte a byte.
STABLE_PREFIX = [
    {"role": "system", "content": "你是代码修复 Agent。工具定义与项目规范如下……"},
]

@dataclass
class TaskCost:
    # Preços unitários: dólares por milhão de tokens. Preencha com os preços oficiais do modelo usado.
    input_price: float
    cache_read_price: float
    output_price: float
    records: list = field(default_factory=list)

    def add(self, usage):
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        uncached = usage.prompt_tokens - cached
        cost = (uncached * self.input_price
                + cached * self.cache_read_price
                + usage.completion_tokens * self.output_price) / 1_000_000
        self.records.append({"cached": cached, "uncached": uncached,
                             "output": usage.completion_tokens, "cost": cost})

    def summary(self):
        total_in = sum(r["cached"] + r["uncached"] for r in self.records)
        hit = sum(r["cached"] for r in self.records) / max(total_in, 1)
        return {"calls": len(self.records), "cache_hit_rate": round(hit, 3),
                "total_cost": round(sum(r["cost"] for r in self.records), 4)}

def run_turn(history, new_msg, tracker, model="your-model-name"):
    # Apenas acrescente a nova mensagem, sem reorganizar o histórico; deixe informações dinâmicas, como registros de data e hora, no final.
    history.append({"role": "user", "content": new_msg})
    resp = client.chat.completions.create(
        model=model, messages=STABLE_PREFIX + history)
    tracker.add(resp.usage)
    history.append({"role": "assistant",
                    "content": resp.choices[0].message.content})
    return resp

tracker = TaskCost(input_price=2.0, cache_read_price=0.1, output_price=0.0)
history = []
run_turn(history, "测试 test_auth 失败,报错如下……", tracker)
print(tracker.summary())
Atenção: a estimativa acima considera apenas o desconto de leitura. Se o modelo usado cobrar separadamente pela gravação no cache, inclua esse custo com base nos campos retornados. Os nomes e significados dos campos de usage podem variar entre modelos; use os dados retornados na prática como referência.
🚀 Comece rápido: recomendamos testar primeiro o script de rastreamento acima na APIYI, em apiyi.com, usando a cota gratuita de testes. Assim, você obtém a taxa de acerto do cache e o custo por tarefa do mesmo trabalho em diferentes modelos e pode decidir qual modelo e qual TTL usar em produção.
Cinco ações para otimizar os custos de chamadas múltiplas de um agente
- Mantenha estável o prefixo do comando: coloque as instruções do sistema, as definições de ferramentas e os materiais de referência compartilhados no início. Deixe os carimbos de data e hora e as informações dinâmicas do usuário para o final. Além disso, evite alterar sem necessidade a ordem e os campos das definições das ferramentas.
- Escolha o TTL adequado: use um TTL curto em tarefas com chamadas frequentes e intervalos pequenos. Para agentes com longos períodos de teste, compilação ou aprovação humana, avalie se a sobretaxa de gravação de um TTL mais longo pode ser compensada pelas regravações evitadas.
- Controle o contexto do histórico: apenas acrescente conteúdo, sem reordená-lo, para não invalidar o prefixo em cache. Resuma as saídas extensas das ferramentas e preserve as conclusões principais, o estado da tarefa e as evidências necessárias.
- Reduza chamadas desnecessárias ao modelo: agrupe em uma única chamada as ferramentas que podem ser executadas em lote. Deixe as etapas determinísticas a cargo do código, em vez de pedir ao modelo que as avalie, reduzindo assim o número de interações desde o início.
- Monitore métricas reais: registre por tarefa os tokens de entrada comuns, as gravações e leituras em cache, os tokens de saída, a taxa de acerto do cache, o TTFT e o custo total. Avalie o custo por tarefa, não por solicitação individual.
Análise do impacto das chamadas múltiplas de agentes nos custos de API
Impacto para desenvolvedores
- O modelo de custos precisa passar de “por solicitação” para “por tarefa”: o custo de um agente depende de toda a cadeia de chamadas. Considerar apenas o preço unitário pode levar a uma grande subestimativa da fatura real.
- A engenharia de comandos também precisa considerar a estrutura de cobrança: a estabilidade do prefixo determina diretamente se o cache pode ser aproveitado. Por isso, projetar a estrutura dos comandos passa a fazer parte da engenharia de custos.
- A escolha entre vários modelos exige testes práticos: os descontos de cache, o TTL e as sobretaxas de gravação variam de um modelo para outro. O custo da mesma tarefa pode mudar bastante ao trocar de modelo.
Impacto para o setor
- A concorrência em infraestrutura se concentra nas cargas de trabalho de agentes: o foco do Google em largura de banda de memória, transferência de KV Cache e pausa e retomada de agentes mostra que interações múltiplas e contextos longos já se tornaram formatos de carga de trabalho predominantes.
- Os benefícios para os usuários aparecem primeiro na latência: as otimizações de baixo nível melhoram primeiro o TTFT e a taxa de transferência. Uma possível redução no preço dos tokens depende da estratégia de preços do provedor; por isso, desenvolvedores não devem incluí-la antecipadamente no orçamento.
Perguntas frequentes
P1: Por que o custo da API em chamadas múltiplas de um Agent é maior do que o esperado?
Como a API não mantém estado, cada chamada precisa enviar novamente o comando do sistema, as definições das ferramentas e o contexto histórico. Quanto mais chamadas, mais vezes esse conteúdo fixo é cobrado. As interações com as ferramentas também aumentam o número de chamadas.
P2: KV Cache e Prompt Cache são a mesma coisa?
Não exatamente. O KV Cache reutiliza estados na camada de inferência do modelo. Já o Prompt Cache é o cache de prefixos reutilizáveis oferecido pelo provedor na camada da API, com cobrança específica. A documentação da OpenAI informa que o conteúdo armazenado é o KV Tensor. O usuário só percebe o Prompt Cache pelas regras de cobrança e não consegue controlar diretamente o KV Cache.
P3: Os preços da API vão cair logo após o lançamento dos novos TPUs do Google?
Não há base para afirmar isso. Até 10/11/2026, TPU 8tx e TPU 8i Max ainda aparecem como “Coming soon”, sem preços divulgados. As otimizações de hardware melhoram principalmente o aproveitamento de recursos e a latência dos provedores. A redução será repassada ao preço por token depende da política de preços de cada provedor.
P4: O cache sempre ajuda a economizar?
Não necessariamente. Se o prefixo mudar a cada chamada e impedir o acerto do cache, e o modo utilizado cobrar um valor adicional pela gravação em cache, o custo pode acabar sendo maior do que sem cache. Se as ferramentas demorarem mais do que o TTL, as gravações frequentes também reduzem a economia.
P5: Como comparar rapidamente o desempenho do cache em diferentes modelos?
Recomendamos executar a mesma tarefa de Agent com o mesmo fluxo em vários modelos e registrar a taxa de acerto do cache e o custo total por tarefa. Com a APIYI em apiyi.com, você pode chamar modelos como OpenAI, Claude e Gemini usando uma única chave API. Basta alterar o parâmetro `model` para fazer a comparação.
P6: Quais são os riscos da compressão de contexto?
A compressão altera o conteúdo enviado nas solicitações seguintes e pode eliminar detalhes importantes, levando o Agent a repetir erros e até aumentar o número de chamadas. Além disso, se o conteúdo comprimido for gerado novamente a cada rodada, o prefixo em cache será prejudicado. Por isso, a compressão deve ser planejada junto com a estratégia de cache.
P7: Ao chamar modelos por um gateway unificado, os descontos de cache são iguais para todos?
Não. Os recursos de cache, as regras de cobrança e os campos retornados dependem do modelo upstream. Ao testar na APIYI em apiyi.com, confira separadamente os campos de cache e os valores realmente cobrados para cada modelo antes de incluí-los no orçamento.
Principais pontos sobre os custos de APIs em chamadas em várias etapas de agentes
- A unidade de custo é a tarefa: a conta do agente soma toda a cadeia de chamadas, não apenas uma solicitação.
- O contexto repetido é o principal fator de custo: no exemplo com 12 chamadas, o cache de 1 hora reduz os custos de entrada em cerca de 71,6%.
- O cache oferece descontos condicionais: se o prefixo for instável ou o TTL for curto demais, a economia diminui e os custos podem até aumentar.
- Cada provedor tem critérios de cobrança diferentes: confirme as taxas de gravação, os descontos de leitura e os custos de armazenamento para cada modelo.
- Otimização de hardware não significa redução na conta: otimizações de KV em baixo nível melhoram primeiro a latência; o preço depende das tarifas do provedor.
- Meça antes de otimizar: use a interface unificada da APIYI, em apiyi.com, para medir na prática a taxa de acertos do cache e o custo por tarefa de cada modelo.
Resumo
O custo de APIs em chamadas de agentes com várias etapas depende de três fatores: o recálculo de contextos repetidos, os acertos do cache e as idas e voltas das ferramentas. Nenhum deles pode ser ignorado:
- O recálculo de contextos repetidos define a base do custo: quanto mais chamadas, mais conteúdo repetido;
- Os acertos do cache determinam o desconto aplicado às partes repetidas; a estabilidade do prefixo e o TTL são fundamentais;
- As idas e voltas das ferramentas geram custos externos e também aumentam o número de chamadas ao modelo.
Os investimentos do Google em KV Cache e na barreira de memória, no nível da infraestrutura, tornam a execução dos agentes mais rápida. Mas o que os desenvolvedores podem controlar desde já é a estrutura dos próprios Tokens. Recomendamos começar por cinco frentes: estabilizar o prefixo, definir um TTL adequado, resumir o histórico, reduzir o número de chamadas e monitorar os custos por tarefa. Depois, use dados reais com a APIYI, em apiyi.com, para verificar o efeito de cada otimização.
📚 Referências
- Google Cloud Blog – Introducing TPU 8tx and TPU 8i Max: anúncio do lançamento dos novos sistemas TPU de oitava geração
- Link:
cloud.google.com/blog/topics/ai-infrastructure/tpu-8tx-and-tpu-8i-max -
Saiba mais sobre o gargalo de memória dos agentes e o contexto do KV Cache.
-
Google Cloud Blog – Introducing TPU Sync: biblioteca de código aberto para transferência de KV Cache e pesos
- Link:
cloud.google.com/blog/topics/ai-infrastructure/introducing-tpu-sync-fast-kv-cache-and-weight-transfer-on-tpu -
Saiba mais sobre as otimizações de transferência de KV Cache em baixo nível e os critérios dos testes.
-
Documentação da API da OpenAI – Prompt Caching: mecanismo de cache e práticas recomendadas
- Link:
platform.openai.com/docs/guides/prompt-caching -
Saiba mais sobre as regras de cache de prefixo, o tempo de retenção e as recomendações de monitoramento.
-
Documentação da Anthropic – Prompt Caching: TTL do cache e informações de cobrança
- Link:
docs.anthropic.com/en/docs/build-with-claude/prompt-caching -
Saiba mais sobre os preços de gravação e leitura do cache de 5 minutos e de 1 hora.
-
Google AI for Developers – Context Caching: cache implícito e explícito do Gemini
- Link:
ai.google.dev/gemini-api/docs/caching - Saiba mais sobre o TTL do cache explícito e as taxas de armazenamento.
Autor: equipe técnica da APIYI
Contato técnico: acesse a página inicial da APIYI em apiyi.com para falar conosco. Para mais informações sobre integração, consulte a central de documentação em docs.apiyi.com.