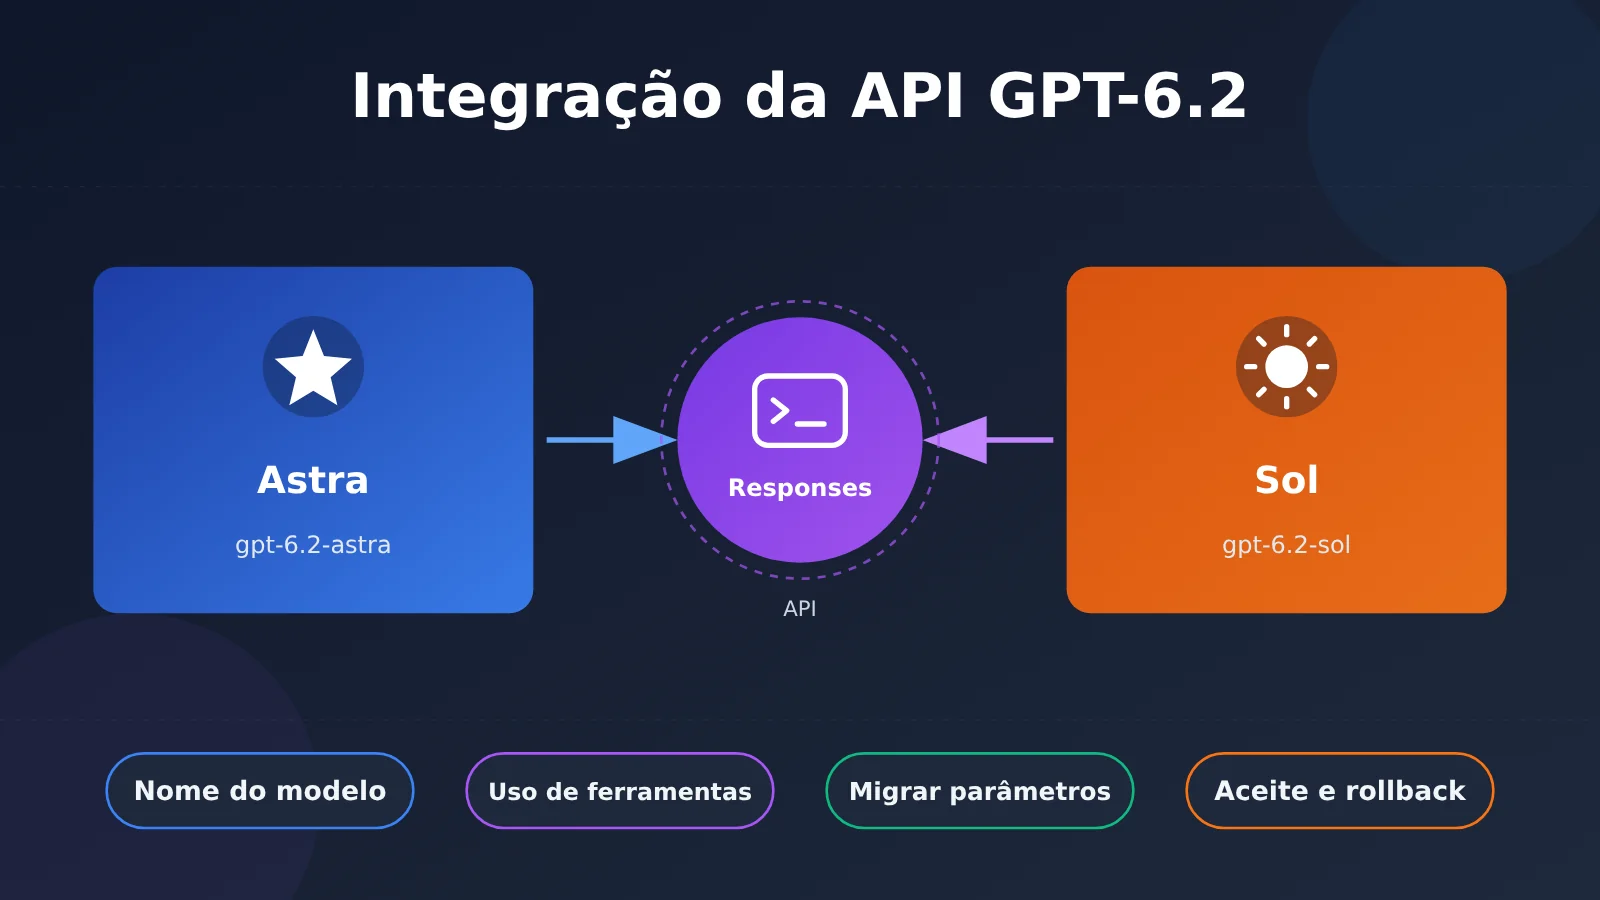
Resposta direta: ao integrar a API do GPT-6.2, troque o nome do modelo para gpt-6.2-astra ou gpt-6.2-sol. Em integrações novas, a recomendação é usar medium como intensidade de raciocínio; em códigos antigos, none ou minimal precisam virar low. Requisições só de texto ainda podem usar Chat Completions, mas basta envolver chamada de ferramentas para o Responses API se tornar obrigatório. Além disso, remova parâmetros de amostragem como temperature e top_p. Se a migração vier do GPT-5.5 ou de versões anteriores, também é preciso mudar o parâmetro de cache para prompt_cache_options.ttl="30m". O detalhe que mais passa despercebido na migração é o prefixo do histórico: novas instruções devem ser acrescentadas depois do histórico existente, sem reescrevê-lo.
O que você vai descobrir lendo este artigo?
- Quais informações são confirmadas sobre o GPT-6.2 Astra e Sol, lançados pela OpenAI em 17 de novembro de 2026, e o que faz parte da divulgação oficial de benchmarks.
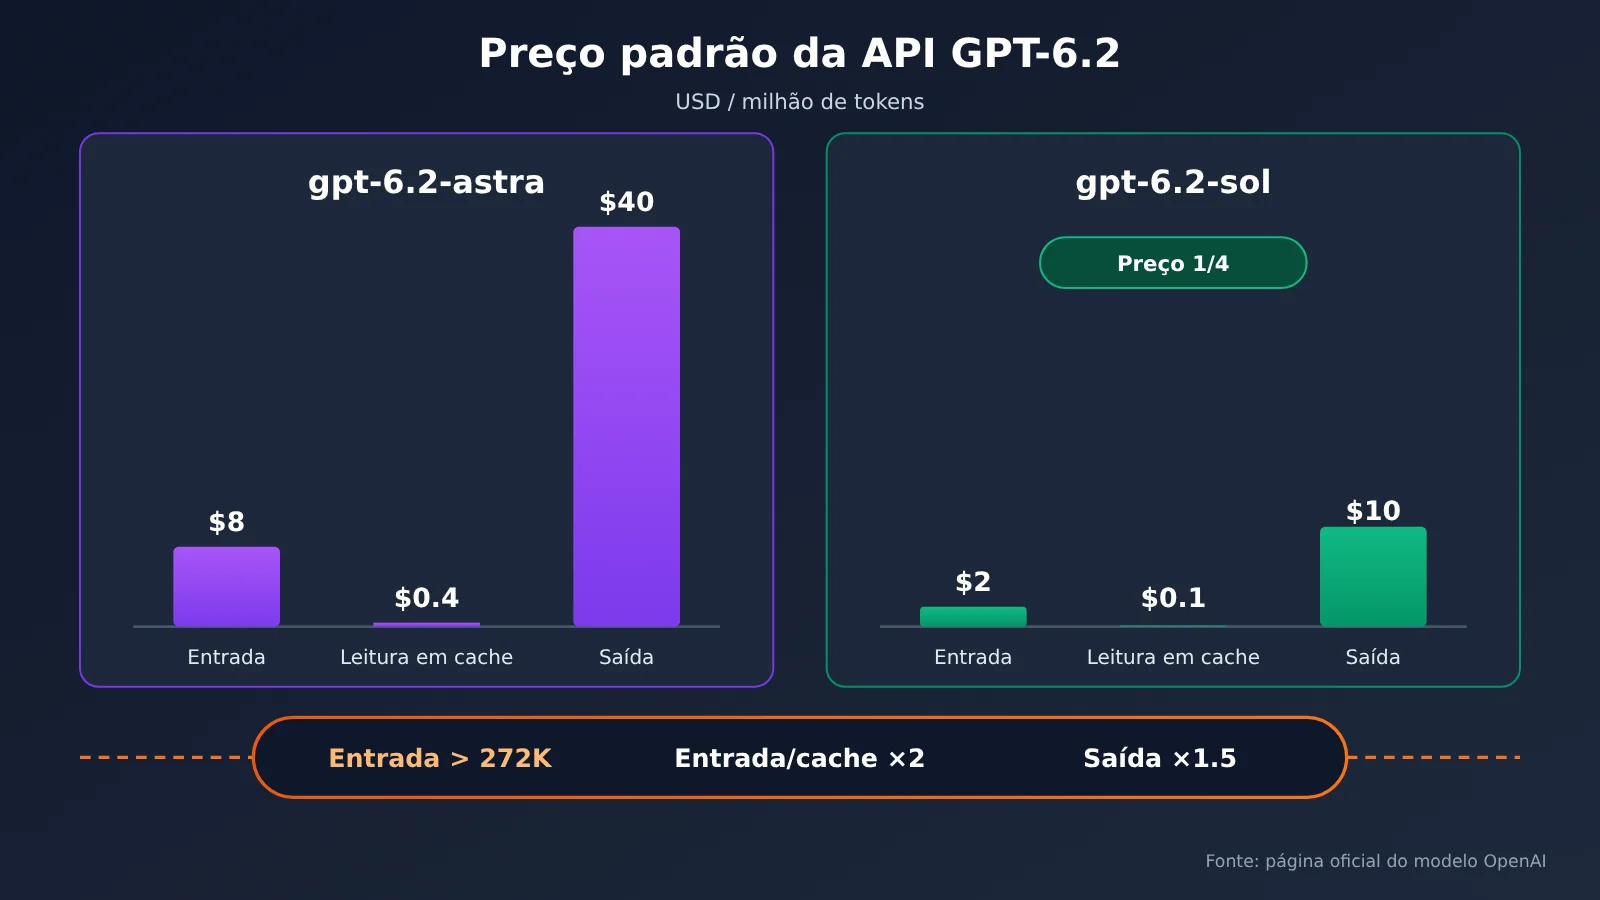
- O preço padrão de API dos dois modelos e o multiplicador de cobrança quando a entrada passa de 272K.
- Uma lista de migração de parâmetros por versão: quais mudanças valem para toda migração de GPT-6.2 e quais se aplicam apenas ao GPT-5.5 e versões anteriores.
- Um exemplo de loop de chamada de ferramentas no Responses, reescrito com base no formato oficial.
- Como diagnosticar os erros mais comuns, além de uma checklist de aceitação com pouco tráfego e de rollback.
Índice: comece por “To Know” e “Visão rápida do impacto” para alinhar a terminologia e entender como os diferentes papéis são afetados. A primeira parte, “Fatos objetivos”, reúne as informações do lançamento, os benchmarks oficiais, o preço e os pontos principais do guia de migração original. A segunda parte, “Prática de migração e análise crítica”, percorre na ordem a escolha do modelo, um exemplo mínimo, a lista de parâmetros, o loop de ferramentas, o diagnóstico de erros e a aceitação com rollback — essa parte reflete julgamento editorial e recomendações operacionais.
GPT-6.2 API To Know: explicação dos conceitos
| Conceito | Explicação breve |
|---|---|
| GPT-6.2 Astra / Sol | Os dois modelos lançados pela OpenAI nesta rodada. Os nomes dos modelos na API são gpt-6.2-astra e gpt-6.2-sol; o Astra tem preço mais alto e o Sol, mais baixo. |
| Responses API | A interface unificada mais recente da OpenAI. As chamadas de ferramentas do GPT-6.2 precisam passar por essa interface. |
| Chat Completions | A interface tradicional de completação de chat. O GPT-6.2 ainda aceita requisições de texto puro por ela. |
| reasoning effort | O nível de esforço de raciocínio. A recomendação oficial para novas integrações é usar medium. |
| Itens de raciocínio (reasoning items) | Itens de saída relacionados ao raciocínio que o modelo retorna na resposta. Em conversas de múltiplas rodadas e loops de ferramentas, eles precisam ser devolvidos exatamente como vieram. |
| Prefixo histórico | A sequência de entrada já enviada em uma conversa de múltiplas rodadas. Mantê-la inalterada ajuda nos acertos de cache e na continuidade do raciocínio. |
| prompt caching | Cache de comando (prompt). Prefixos repetidos podem ser cobrados pelo preço mais baixo de leitura do cache. |
| GDPval v2 / ALE / FrontierCode 2.0 | Nomes de avaliações citadas pela OpenAI nos materiais de lançamento. As pontuações dos três não podem ser comparadas misturando-se os resultados. |
Visão rápida do impacto da API GPT-6.2
- Desenvolvedores que já têm aplicações com a API OpenAI: trocar o nome do modelo não é o difícil; o trabalho principal está na limpeza de parâmetros e na troca de interface. Aplicações de Chat Completions que usam function calling precisam migrar para a Responses API, e essa é a principal carga de trabalho desta rodada de migração.
- Aplicações que dependem de parâmetros de amostragem: sistemas que controlam o estilo da saída via
temperatureetop_p, ou que dependem delogprobspara avaliar confiança, perdem esses recursos no GPT-6.2 e precisam adotar outra abordagem. - Responsáveis por custos: o preço unitário de Astra e Sol difere em 4 vezes. Quando a requisição de contexto longo passa de 272K, a cobrança do pedido inteiro sobe, então o orçamento precisa ser recalculado com base na distribuição real do comprimento das requisições.
- Usuários comuns do ChatGPT: o escopo liberado nesta rodada é ChatGPT Work, Codex e a API; o Chat comum não entra no lançamento desta rodada.
1. Fatos objetivos sobre a API GPT-6.2
Esta seção reúne apenas informações dos materiais oficiais da OpenAI, com data de verificação em 18 de novembro de 2026. Os dados de avaliação citados no texto são todos de relatórios oficiais da OpenAI, não são medições da nossa equipe.
1.1 Data de lançamento, nomes dos modelos e escopo de disponibilidade da API GPT-6.2
A OpenAI lançou o GPT-6.2 Astra e o GPT-6.2 Sol em 17 de novembro de 2026. Os nomes dos modelos na API são gpt-6.2-astra e gpt-6.2-sol, respectivamente. Ambos os modelos aceitam entrada de texto e imagem, produzem saída em texto e não têm capacidade nativa de geração de vídeo.
O ritmo de liberação é gradual, abrangendo ChatGPT Work, Codex e a API; o ChatGPT Chat comum não faz parte desta rodada de lançamento. Por isso, em curto prazo, algumas contas ou organizações podem ainda não conseguir invocar esses dois modelos. Antes da mudança oficial, vale confirmar a disponibilidade dentro da própria organização.
1.2 Dados oficiais de avaliação da API GPT-6.2 (narrativa de divulgação oficial)
A OpenAI apresentou os seguintes resultados de avaliação nos materiais de lançamento. Cada item só é válido dentro da sua respectiva avaliação:
- GDPval v2: O GPT-6.2 Astra é 6,2 pontos percentuais superior ao GPT-6 Astra, com 22% menos tokens de saída. O GPT-6.2 Sol é 5,3 pontos percentuais superior ao GPT-6.1 Sol.
- Agents’ Last Exam (ALE): O GPT-6.2 Astra tem um ganho de 5,2 pontos em relação ao GPT-6 Astra.
- FrontierCode 2.0: No nível de raciocínio max, Sol e Astra diferem em 0,5 ponto, e o custo da tarefa é cerca de 1/5 do custo do Astra. Essa é apenas a conclusão deste teste e não pode ser generalizada como uma conclusão universal sobre custo.
As três séries de números usam unidades e linhas de base diferentes, portanto não podem ser somadas nem ordenadas transversalmente. Por exemplo, os “6,2 pontos percentuais” do GDPval v2 e os “5,2 pontos” do ALE não estão na mesma escala.
1.3 Preços padrão da API GPT-6.2
A tabela abaixo traz o preço padrão da API oficial, em dólares por milhão de tokens:
| Modelo | Entrada não cacheada | Leitura de cache | Saída | Quando a entrada excede 272K |
|---|---|---|---|---|
gpt-6.2-astra |
$8 | $0.4 | $40 | Taxas de entrada e cache de todo o pedido ×2, saída ×1.5 |
gpt-6.2-sol |
$2 | $0.1 | $10 | Taxas de entrada e cache de todo o pedido ×2, saída ×1.5 |
Há mais dois pontos de atenção. Primeiro, a gravação em cache é cobrada separadamente e não aparece na tabela. Segundo, a sobretaxa de contexto longo é calculada sobre o “pedido inteiro”; ou seja, se a entrada de uma requisição ultrapassar 272K, toda a entrada dessa requisição será cobrada em dobro, e não apenas a parte que excedeu o limite.
1.4 Pontos principais do guia oficial de migração da API GPT-6.2
O guia de migração dos modelos mais recentes da OpenAI (página latest-model) lista os seguintes ajustes:
| Item | Chat Completions | API Responses | Abrangência |
|---|---|---|---|
| Chamada de ferramentas | Não suportado, é obrigatório migrar para Responses | Suportado | Todas as aplicações que migram para o GPT-6.2 |
| Parâmetros de amostragem | Remoção de temperature, top_p |
Remoção de temperature, top_p |
Todas as migrações |
| Saída de probabilidades | Remoção de logprobs, top_logprobs |
Remoção de top_logprobs e exclusão de message.output_text.logprobs do include |
Todas as migrações |
| Intensidade de raciocínio | Novas integrações usam medium; none e minimal passam a low |
Idem | Todas as migrações |
| Retenção de cache | prompt_cache_retention passa a ser prompt_cache_options.ttl="30m" |
Idem | Migrações do GPT-5.5 e versões anteriores |
Sobre conversas com múltiplos turnos, o guia também destaca: mantenha o prefixo de histórico já existente, acrescente as novas instruções ao final e não reescreva. Fazer downgrade de modelo, ou trocar de usuário ou de organização, pode resultar na perda dos itens de raciocínio.
2. Prática e análise da migração da API GPT-6.2
Esta parte traz o julgamento e as recomendações operacionais do editor com base nas informações oficiais acima. O código foi reescrito no formato da documentação oficial, sem ter sido validado em execução, então confira item por item na documentação oficial antes de integrar.
2.1 Seleção de modelos da API GPT-6.2: primeiro Sol, depois Astra
Se olharmos apenas para o preço oficial, tanto o preço unitário de entrada quanto o de saída do Sol são 1/4 dos do Astra. O resultado do FrontierCode 2.0 — “Sol e Astra diferem em 0,5 ponto, com custo cerca de 1/5” — indica que, em algumas tarefas de programação, o custo-benefício do Sol pode ser bastante vantajoso. Mas essa conclusão vem de uma única avaliação; se ela também vale para o seu negócio, só dá para confirmar com seus próprios dados.
A estratégia padrão sugerida pela equipe editorial é: primeiro rodar todo o conjunto de regressão com gpt-6.2-sol, filtrar os tipos de tarefa em que o Sol não atinge o requisito de qualidade e, em seguida, avaliar o Astra para esse subconjunto de tarefas. Além disso, observe que, no GDPval v2, o fato de o Astra “ter 22% menos tokens de saída” é resultado da comparação com o GPT-6 Astra, e isso não pode ser usado diretamente para compensar a diferença de preço unitário entre Astra e Sol.
💡 Sugestão de escolha: ao fazer testes comparativos entre Astra e Sol, use o mesmo conjunto de regressão e o mesmo nível de raciocínio, registrando separadamente qualidade, latência e consumo de tokens. Se você precisa comparar vários modelos em uma mesma interface, pode primeiro verificar na lista de modelos da APIYI (apiyi.com) se a série GPT-6.2 já está disponível; se não estiver, use diretamente a API oficial da OpenAI.
2.2 Exemplo mínimo de Responses da API do GPT-6.2
A seguir está o exemplo mínimo de chamada apenas com texto, usando a Responses API e o nível de raciocínio medium. Primeiro, instale ou atualize o SDK oficial de Python: python -m pip install --upgrade openai. Configure a variável OPENAI_API_KEY no ambiente de execução e não coloque a chave real no código, no artigo ou no repositório. O exemplo abaixo chama a API oficial da OpenAI por padrão.
import os
from openai import OpenAI

# Adaptado do formato da documentação oficial, não executado nem verificado
client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])  # Chama a API oficial da OpenAI por padrão

response = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "medium"},
    input="用三句话说明什么是提示词缓存。"
)
print(response.output_text)
De propósito, o exemplo não inclui temperature nem top_p, porque o GPT-6.2 já removeu esses dois parâmetros. Se a sua função de encapsulamento os adiciona por padrão, é preciso filtrá-los de forma unificada na camada de chamada.
🎯 Recomendação técnica: Ao integrar serviços de terceiros como a APIYI apiyi.com, verifique primeiro a documentação oficial do serviço, a lista de modelos, o suporte a Responses e o preço real, e só então configure o endereço e a chave dedicada emitida por ele. Não envie a chave oficial da OpenAI para endereços de terceiros. Este artigo não verificou a compatibilidade da interface de terceiros.
2.3 Lista de migração de parâmetros da API do GPT-6.2
A lista de migração está dividida em dois grupos conforme a versão de origem, para não sair aplicando a todos os projetos mudanças que só valem para versões antigas.
2.3.1 O que todo projeto que migra para o GPT-6.2 precisa fazer
- Troque o nome do modelo por
gpt-6.2-astraougpt-6.2-sole gerencie isso de forma centralizada na central de configuração, para facilitar um rollback depois. - Remova
temperatureetop_p. Se antes você usava temperatura baixa para deixar a saída mais estável, dá para substituir por instruções mais explícitas, formatos de saída estruturados ou lógica de validação. - Em projetos que usam Chat Completions, remova
logprobsetop_logprobs. Em projetos que usam Responses, removatop_logprobse tiremessage.output_text.logprobsdo arrayinclude. - Nível de raciocínio: em novas integrações, use
mediumpor padrão; se antes estava configurado comononeouminimal, mude paralow. - Toda requisição que tenha
toolsdeve passar a usar a Responses API.
2.3.2 O que só é necessário ao migrar do GPT-5.5 ou de versões anteriores
- Troque
prompt_cache_retentionporprompt_cache_options.ttl="30m". - Depois da migração, verifique se a taxa de acerto do cache está normal. O preço de leitura do cache é só 1/20 do de uma entrada não cacheada, então uma queda na taxa de acerto encarece o custo na hora.
Se você está migrando do GPT-6 ou do GPT-6.1, os itens da lista 2.3.1 ainda precisam ser checados um por um. E se o código de invocação de ferramentas já era Responses, confirme também que não sobrou nenhum parâmetro removido.
2.4 Loop de ferramentas e prefixo de histórico da API GPT-6.2
A chamada de ferramentas é a parte de maior risco nesta migração. Na Responses API, um ciclo completo de ferramentas envolve quatro etapas: o modelo retorna um item function_call; seu código executa a função correspondente; o resultado é anexado à entrada como function_call_output; e o modelo é solicitado novamente. O modelo pode continuar solicitando ferramentas, então não se pode presumir que a segunda resposta será necessariamente a resposta final.
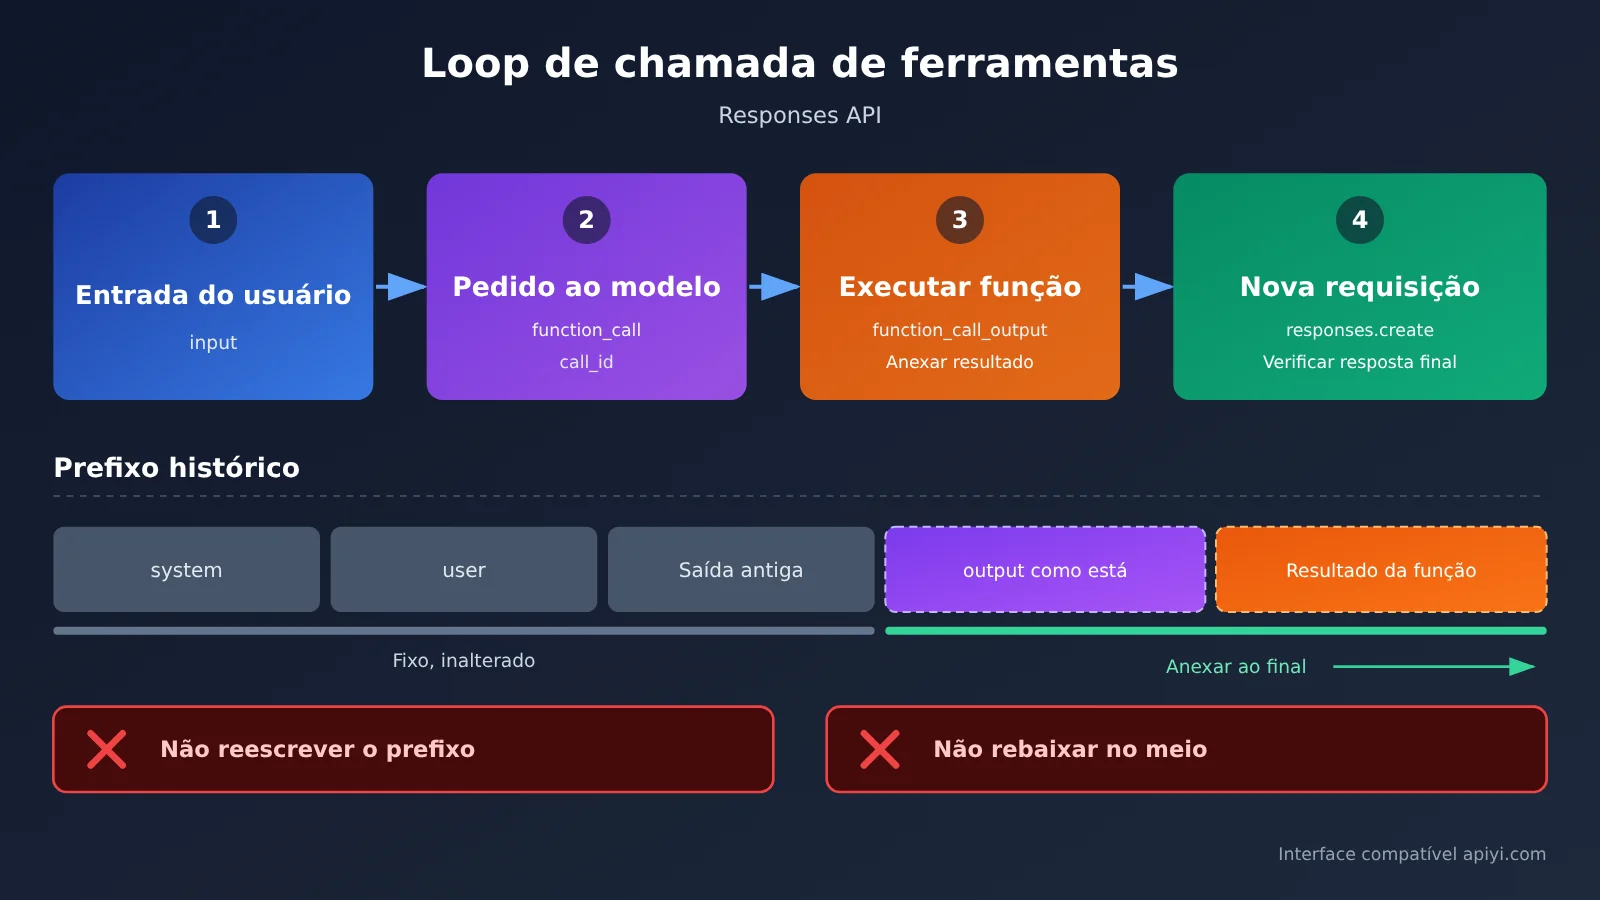
O princípio-chave é: anexe o output retornado pelo modelo ao histórico exatamente como está, sem filtragem e sem remontagem. Os itens de raciocínio estão incluídos nessas saídas. Se você mantiver apenas a parte textual, ou reescrever instruções de sistema anteriores no meio do caminho, as rodadas seguintes podem perder a continuidade do raciocínio, e o prefixo de cache também se tornará inválido.
Ver exemplo de chamada de função em uma única rodada (adaptado do formato oficial, não executado nem verificado)
import os
import json
from openai import OpenAI

client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])  # Por padrão, chama a API oficial da OpenAI

MODEL = "gpt-6.2-sol"

tools = [{
    "type": "function",
    "name": "get_order_status",
    "description": "Consulta o status do pedido com base no número do pedido",
    "parameters": {
        "type": "object",
        "properties": {"order_id": {"type": "string"}},
        "required": ["order_id"],
        "additionalProperties": False
    },
    "strict": True
}]

def get_order_status(order_id: str) -> dict:
    # Substitua pela sua lógica de negócio real
    return {"order_id": order_id, "status": "shipped"}

# Prefixo de histórico existente: mantenha-o inalterado, apenas anexe ao final
history = [
    {"role": "user", "content": "Me ajude a verificar o status do pedido A1024"}
]

first = client.responses.create(
    model=MODEL,
    input=history,
    tools=tools,
    reasoning={"effort": "medium"}
)

# Anexe a saída do modelo exatamente como está (incluindo itens de raciocínio e itens function_call)
history += first.output

for item in first.output:
    if item.type == "function_call" and item.name == "get_order_status":
        args = json.loads(item.arguments)
        result = get_order_status(**args)
        history.append({
            "type": "function_call_output",
            "call_id": item.call_id,
            "output": json.dumps(result, ensure_ascii=False)
        })

final = client.responses.create(
    model=MODEL,
    input=history,
    tools=tools,
    reasoning={"effort": "medium"}
)
if final.status != "completed":
    raise RuntimeError(f"Resposta não concluída: {final.status}")
if any(item.type == "function_call" for item in final.output):
    raise RuntimeError("O modelo ainda está solicitando ferramentas; continue o processamento pelo mesmo fluxo, não o trate como resposta final")
print(final.output_text)
A função acima retorna dados de demonstração, não uma consulta real de pedido; o exemplo mostra apenas uma rodada de chamada de função. Em ambiente de produção, também é necessário validar o nome da chamada e os parâmetros, verificar permissões de consulta, tratar erros de ferramenta, definir um loop com limite superior para solicitações subsequentes de ferramentas, e lidar com timeouts e respostas não concluídas.
Quando precisar adicionar novas restrições, como «a partir de agora responda em inglês», você deve adicioná-la como um novo item ao final de history, sem voltar para modificar a instrução do início. Na mesma sessão, não faça downgrade para uma versão inferior do modelo e não migre a sessão entre usuários ou organizações. A documentação oficial já deixou claro que essas mudanças podem causar a perda dos itens de raciocínio.
2.5 Diagnóstico de erros da API GPT-6.2
A tabela abaixo organiza as direções de investigação com base nos pontos de migração da documentação oficial. As «possíveis causas» são inferências editoriais; o texto exato do erro deve ser consultado na resposta real:
| Sintoma | Possível causa | Como tratar |
|---|---|---|
| Requisição recusada, com aviso de parâmetro não suportado | Parâmetros removidos que ainda ficaram para trás, como temperature, top_p, logprobs |
Filtrar de forma unificada na camada de encapsulamento da chamada |
Falha no Chat Completions quando há tools |
A invocação de ferramentas do GPT-6.2 só é suportada no Responses | Migrar para responses.create |
| Erro no nível de raciocínio | Ainda está usando none ou minimal |
Mudar para low |
| Configuração de cache inválida ou taxa de acerto despencando | Ainda está usando prompt_cache_retention, ou o prefixo do histórico foi reescrito |
Mudar para prompt_cache_options.ttl="30m" e manter o prefixo estável |
| Qualidade cai visivelmente na segunda metade de um diálogo de vários turnos | Os itens de raciocínio não foram enviados de volta, ou o modelo foi rebaixado no meio do caminho, ou a organização foi trocada | Anexar output exatamente como veio e fixar o modelo na mesma sessão |
| Fatura muito acima do esperado | Algumas requisições de entrada ultrapassaram 272K, acionando o aumento da fatura inteira | Analisar a distribuição do comprimento da entrada e truncar ou resumir as requisições longas |
| Nome do modelo não existe ou sem permissão | Liberação gradual pela oficial, ou a interface de terceiros ainda não oferece esse modelo | Confirme as permissões da organização; para interfaces de terceiros, use como referência a lista de modelos da plataforma |
🛠 Dica de diagnóstico: se o problema só aparecer na interface de terceiros, primeiro envie a mesma requisição pela API oficial para fazer uma comparação. Assim você consegue identificar se o problema está no seu código ou na camada de compatibilidade da interface. Se encontrar problemas de compatibilidade no APIYI apiyi.com, entre em contato com o suporte técnico da plataforma informando o ID da requisição.
2.6 Aceitação com tráfego reduzido e rollback da API GPT-6.2
A recomendação editorial é não fazer uma troca total, mas avançar em três etapas: teste sombra → implantação canário em pequena escala → aumento de volume. Defina critérios de aceitação e condições de rollback claras para cada etapa:
| Etapa | Sugestão de tráfego | Critérios de aceitação | Condições para acionar rollback |
|---|---|---|---|
| Teste sombra | Copiar requisições de produção, sem devolver resultados ao usuário | Qualidade do conjunto de regressão, taxa de sucesso das chamadas de ferramentas, taxa de parsing de saídas estruturadas | Qualidade das tarefas críticas claramente inferior à do modelo antigo |
| Canário em pequena escala | Poucos usuários reais | Taxa de erro, latência P95, número de tokens por requisição, taxa de acerto do cache | Taxa de erro ou custo acima do limite predefinido |
| Aumento de volume | Elevar a proporção gradualmente | Proporção de requisições com contexto longo, custo diário, feedback dos usuários | Grande volume de requisições acima de 272K faz o custo sair de controle |
O design de rollback tem dois pontos principais. Primeiro, nome do modelo, tipo de interface e nível de raciocínio entram em flags de configuração; no rollback, basta alterar a configuração, sem precisar publicar uma nova versão. Segundo, o rollback é por nova sessão: sessões que já estão em andamento no GPT-6.2 devem, se possível, terminar no modelo original, para evitar que uma degradação no meio do caminho provoque a perda dos itens de raciocínio.
🚀 Início rápido: ao fazer implantação gradual, você pode usar a mesma chave API no APIYI apiyi.com para chamar o modelo antigo e o candidato ao mesmo tempo e comparar os resultados, desde que a plataforma ofereça os modelos correspondentes. Isso deve ser conferido no console da plataforma; este artigo não oferece garantia.
Na migração para o GPT-6.2, o esforço real não está em trocar o nome do modelo, mas em três frentes: migrar as chamadas de ferramentas para Responses, remover os parâmetros que foram excluídos e manter estável o prefixo do histórico. As avaliações oficiais indicam direções que vale a pena observar, especialmente o custo-benefício do Sol em algumas tarefas. Mas se esses números se aplicam ao seu negócio é algo que só o seu próprio conjunto de regressão e os dados de canário podem responder.
O que se aprende no papel é sempre raso; para realmente saber, é preciso praticar. — Lu You, “Lendo numa noite de inverno para meu filho Ziyu”
Referências
Para a estrutura do código, consulte também o Quickstart da OpenAI e o guia de Function calling. Este artigo apenas verifica a documentação e a estrutura do código; não realizamos testes pagos com a API.
-
Anúncio de lançamento da OpenAI: apresentando GPT-6.2 Astra e Sol
- Link: material oficial
- Descrição: data de lançamento, dados de avaliação e escopo de liberação
-
Página do modelo OpenAI: GPT-6.2 Astra
- Link: material oficial
- Descrição: nome do modelo, modalidades e preço padrão
-
Página do modelo OpenAI: GPT-6.2 Sol
- Link: material oficial
- Descrição: nome do modelo, modalidades e preço padrão
-
Guia de migração da OpenAI: Latest model
- Link: material oficial
- Descrição: remoção de parâmetros, níveis de raciocínio, configuração de cache e requisitos de prefixo de histórico
-
Central de Ajuda da OpenAI: ChatGPT Work and Codex
- Link: material oficial
- Descrição: notas de liberação do ChatGPT Work e do Codex
Autor: Equipe técnica da APIYI
Contato técnico: se você encontrar problemas de compatibilidade de interface durante a migração, fale conosco pela página inicial da APIYI (apiyi.com). Mais materiais de integração estão disponíveis na central de documentação em docs.apiyi.com.