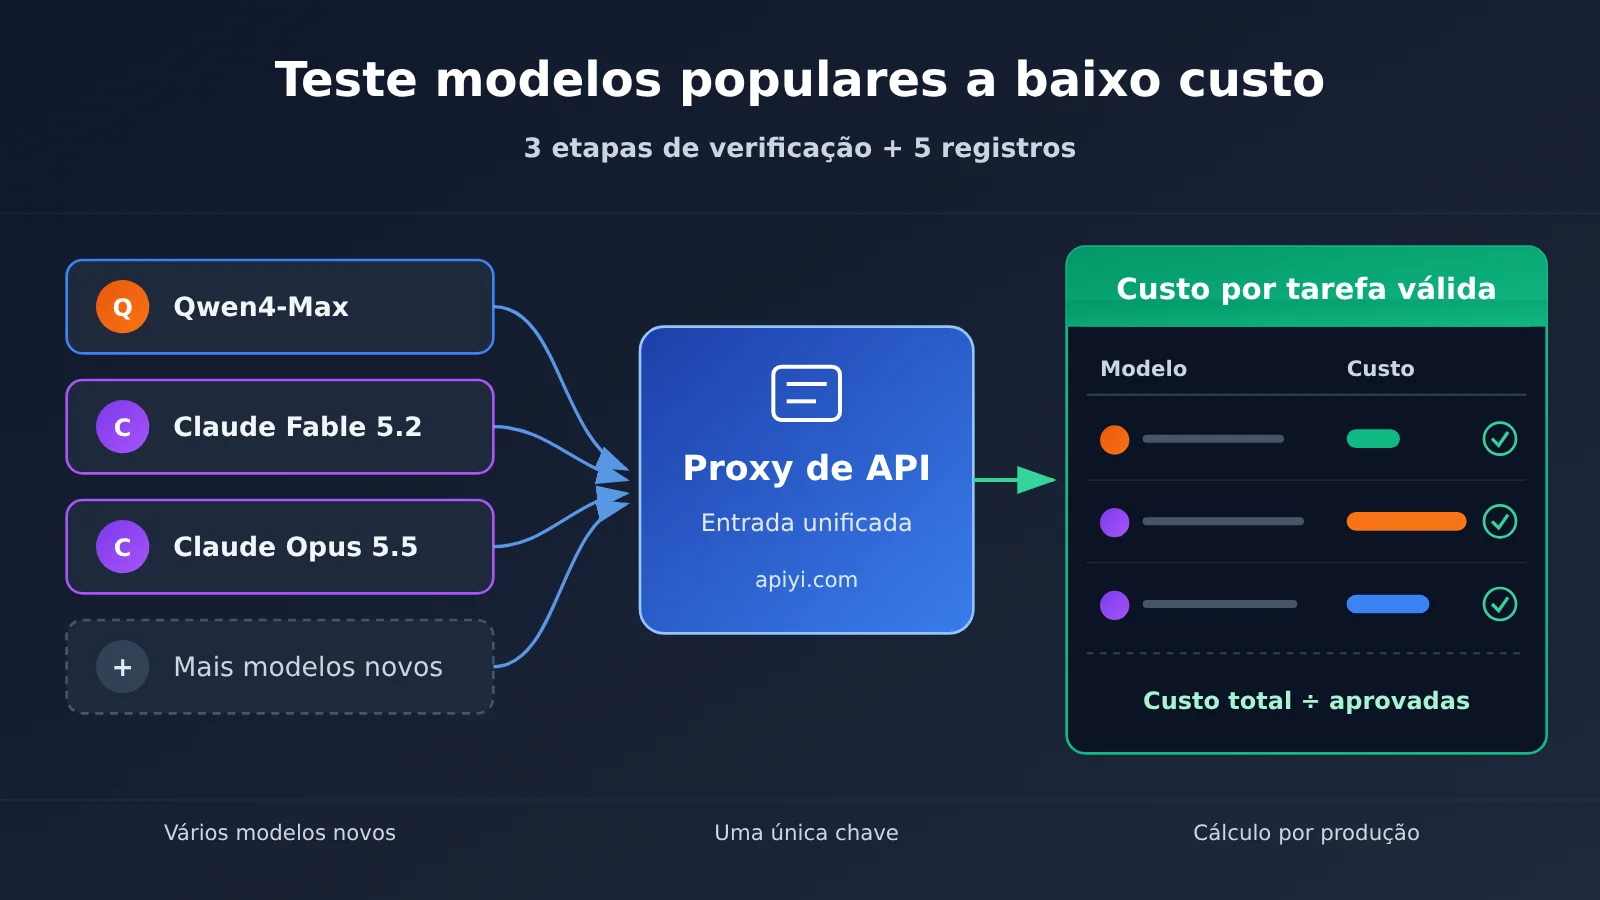
Quando novos modelos surgem em massa, se você quer testar todos os modelos populares com baixo custo, o caminho mais prático é fazer a integração por um único ponto de entrada de serviço proxy de API. Assim você elimina o trabalho repetitivo de se registrar em cada provedor e configurar um SDK para cada um. Só que um ponto de entrada unificado resolve apenas o “como conectar”, não responde “qual escolher”. A ordem correta é: primeiro conferir o catálogo de modelos, as permissões da chave e os endpoints; depois, usar o mesmo lote de tarefas reais para comparar saídas aprovadas e custo total. Neste artigo usamos APIYI apiyi.com como exemplo para demonstrar esse fluxo de teste com orçamento pequeno e critérios de aceitação.
O que você vai aprender ao ler este artigo?
- Os IDs exatos dos modelos Qwen4-Max e Claude Fable 5.2 no catálogo atual, os endpoints disponíveis e os grupos.
- Um conjunto reutilizável de código básico de integração, além do método para primeiro verificar “quais modelos esta chave consegue enxergar”.
- Como usar tarefas de amostra pequena, registros de usage e faturas para controlar o custo do teste, e como decidir com base no “custo por tarefa aprovada”.
Índice: a parte “Fatos objetivos” começa listando, com data de referência 2026-11-17, os itens do catálogo, as condições de acesso e as políticas de teste, e explica a quem pertencem as cotações e as pontuações de ranking citadas em materiais de terceiros. A parte “Análise e julgamento” discute três coisas: como desenhar uma amostra pequena com a mesma pergunta, como registrar o custo, e a distância entre catálogo visível, chamada bem-sucedida e saída aprovada. No final, deixamos uma tabela de registro para o leitor preencher por conta própria.
To Know: conceitos necessários antes de testar modelos populares com um serviço proxy de API
| Conceito | Breve explicação |
|---|---|
| Serviço proxy de API | Um gateway que conecta as requisições de modelos de vários fornecedores a um único ponto de entrada de serviço |
| ID do modelo | A string usada na requisição para especificar com precisão o modelo, por exemplo qwen4-max |
| Endpoint | O caminho de requisição específico pelo qual o serviço oferece uma determinada capacidade, como chat, responses, messages |
| Grupo de tokens | Configuração que define por quais canais de modelo uma determinada chave pode passar e com qual coeficiente de cobrança a liquidação é feita |
| usage | O registro de uso na resposta, usado para verificar os Tokens realmente consumidos nesta chamada |
| Leitura de cache | Reutiliza um prefixo de entrada já processado, cujo preço pode ser diferente do de uma nova entrada |
| Custo por tarefa qualificada | Custo total de todas as tentativas ÷ o número de tarefas que finalmente atendem aos critérios de aceitação |
Visão rápida do impacto: o que testar modelos em um serviço proxy de API significa para diferentes públicos
- Desenvolvedores na primeira integração: com um Base URL e uma chave, já dá para trocar de modelo, sem precisar configurar repetidamente contas e SDKs em várias plataformas.
- Equipes que já têm um negócio em operação: podem testar novos modelos com seus próprios critérios de aceitação, sem depender das conclusões dos rankings de terceiros; mas parâmetros como chamada de ferramentas, visão e raciocínio ainda precisam de adaptação individual.
- Usuários individuais sensíveis a orçamento: primeiro limitem a quantidade de tarefas e o comprimento da entrada, depois façam as contas com base no “resultado utilizável”. Não olhem apenas para o preço por milhão de Tokens.
Fatos objetivos: catálogo atual de modelos populares e condições de acesso do serviço proxy de API
O que há no catálogo: entradas para qwen4-max e claude-fable-5-2
O registro de modelos legível por máquina disponibilizado publicamente pela APIYI (docs.apiyi.com/model-registry.json) declara que a fonte dos dados é a interface de preços da plataforma e que foi gerado em 2026-11-17T07:54:33Z. A tabela tem 285 registros de modelos. Vale notar que esse é o número de registros no catálogo, e não a quantidade de modelos realmente disponíveis para uma conta. As três entradas relevantes para este artigo são:
| ID exato do modelo | Endpoint do catálogo | Grupo (ID de máquina) | Preço de catálogo: entrada / saída / leitura de cache (USD por milhão de tokens) |
|---|---|---|---|
claude-fable-5-2 |
chat / messages | ClaudeCode / ClaudeCodeReverse / ClaudeOfficial / default / svip | 8 / 40 / 0.2 |
claude-opus-5-5 |
chat / messages | ClaudeCode / ClaudeCodeReverse / ClaudeOfficial / default / svip | 4 / 20 / 0.2 |
qwen4-max |
chat / responses / messages | ClaudeCode / CodexResponses / default / svip | 1.5 / 4.5 / 0.075 |
Todos os preços acima são preços de catálogo de 2026-11-17, não o valor efetivamente pago pela conta; a cobrança real também é afetada por fatores como o grupo do token. Além disso, blogs e comunicados antigos já afirmaram que esses dois modelos “ainda não estavam no catálogo”. Essas declarações refletem apenas o estado na época de sua publicação e não servem como conclusão sobre se podem ser invocados hoje.
O registro lista o grupo reverso (ClaudeCodeReverse) para o Fable, mas os comunicados iniciais e o FAQ não liberaram esse grupo. Por isso, este artigo usa como exemplo o grupo default ou ClaudeCode, sem garantir que o grupo reverso esteja disponível. Se você precisar do canal oficial de encaminhamento, vale ficar de olho no grupo ClaudeOfficial na entrada do Fable.
Como integrar: Base URL e verificação de visibilidade
A documentação de início rápido (docs.apiyi.com/getting-started, consultada em 2026-11-17) traz a configuração básica abaixo:
- Base URL para SDK compatível com OpenAI:
https://api.apiyi.com/v1 - Base URL para SDK da Anthropic:
https://api.apiyi.com - No primeiro passo, faça uma requisição
GET /v1/modelspara verificar quais modelos a chave atual consegue enxergar e, então, escolha o endpoint compatível.
Os dois modelos suportam o endpoint de chat, então os exemplos abaixo usam o Chat Completions compatível com OpenAI. Primeiro confirme se o modelo está visível, depois envie a requisição mais curta possível e imprima o usage:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Entrada compatível com OpenAI da APIYI
)

visible = {m.id for m in client.models.list().data}
for model in ["qwen4-max", "claude-fable-5-2"]:
    if model not in visible:
        print(f"{model}: 本密钥不可见,检查令牌分组")
        continue
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是API中转站。"}],
        max_tokens=100,
    )
    print(model, r.usage, r.choices[0].message.content)
Crédito de teste: vale o que está na página de início rápido atual
A página de início rápido atual deixa claro que o cadastro da conta inclui US$ 0,05 de crédito de teste, o suficiente para validar a primeira chamada sem fazer recarga. A antiga menção nos cards iniciais de “3 milhões de tokens grátis ao se registrar” já não se aplica — o que vale é a regra exibida na página da conta. Vale esclarecer também que, durante a escrita deste artigo, nenhuma invocação de modelo paga foi realizada; todos os “custos” citados aqui são estimativas feitas com base no preço de catálogo, não faturas reais medidas.
O que a interface unificada compartilha — e o que não compartilha
Segundo a documentação de geração de texto da APIYI, a interface de chat unificada serve bem para comparar a parte compartilhada de entrada e saída de texto. Já o histórico de conversas de múltiplos turnos fica a cargo de quem faz a chamada. As capacidades, configurações de raciocínio e parâmetros opcionais ainda variam de modelo para modelo; necessidades como chamada de ferramentas, entrada visual e intensidade de raciocínio exigem adaptação individual. Só trocar o campo model não isenta ninguém desse trabalho.
Como ler fontes de terceiros: os preços e as pontuações do OrcaRouter
Os materiais em inglês que discutem esses dois modelos recentemente vêm, em boa parte, do blog de outro provedor de roteamento, o OrcaRouter (publicado em 2026-11-16). As informações-chave são as seguintes:
- Data de lançamento: o Qwen4-Max ficou oficialmente disponível em 2026-11-16; o Claude Fable 5.2 foi lançado em 2026-11-09; o suposto “Claude Fable 5.5” não existe na lista oficial de modelos da Anthropic.
- Pontuações e custo por tarefa: os dados do Artificial Analysis citados no artigo (lidos em 2026-11-17) mostram que o índice geral do Qwen4-Max é de cerca de 42.9, com um custo medido de 3.27 dólares por tarefa do índice; o Fable 5.2, no nível medium padrão, tem índice de 56.4 e custo de 3.80 dólares por tarefa. O artigo também observa que o Qwen4-Max tende a gerar um volume maior de Tokens de saída nas avaliações.
- Descontinuação das versões de prévia: IDs de prévia como
qwen4-max-previewdeixarão de funcionar em 2026-11-25 24:00 (UTC+8); o ID oficial mantido a partir daí éqwen4-max.
Todos esses números pertencem a esse provedor e às avaliações de terceiros correspondentes: não são preços da APIYI, nem conclusões de testes práticos deste artigo. O valor de referência deles está em oferecer uma ideia: preço unitário baixo não significa custo por tarefa baixo.
Análise e decisão: como testar exaustivamente os modelos populares com baixo custo usando um serviço proxy de API
Primeiro defina a tarefa e os critérios de aceite, depois faça uma pequena amostra com o mesmo enunciado
A entrada unificada reduziu o custo de integração a quase zero, e o custo real passou a estar em “o que testar”. Nossa sugestão é escolher de 3 a 5 tarefas pequenas a partir de necessidades reais e, para cada tarefa, fixar a versão da entrada, o critério de aprovação e a base de julgamento. Por exemplo: “a saída precisa ser um JSON parseável e conter 5 campos”, ou “o resumo não pode omitir os 3 números do texto original”. Se você não escrever os critérios antes, no fim do teste vai sobrar só o “achei esse melhor”.
Em seguida, envie a mesma entrada para cada modelo candidato, mantendo a mesma regra de julgamento: retorno vazio, formato errado e truncamento não contam como aprovado. Nos parâmetros, comece também pelo conjunto mínimo comum, definindo apenas model, messages e max_tokens. Necessidades como chamada de ferramentas, visão e intensidade de raciocínio devem ter uma rodada de teste separada, para você não confundir “parâmetro mal ajustado” com “modelo ruim”.
🚀 Dica para começar: a primeira rodada de amostras pode ser feita direto com os créditos de teste que acompanham o cadastro no APIYI apiyi.com. Primeiro confirme que dois ou três modelos candidatos estão visíveis e podem ser invocados com a sua chave API, e só depois decida se vale recarregar para ampliar o escopo do teste.
Contabilizando todas as tentativas: custo por tarefa qualificada
Em cada requisição, registre os tokens de entrada, de saída e de leitura de cache do campo usage (caso a resposta traga esse campo) — e registre também os retries e as requisições que falharam. O indicador central é o custo por tarefa qualificada = custo total de todas as tentativas ÷ número de tarefas qualificadas. Calcular apenas o custo da tentativa bem-sucedida subestima sistematicamente os modelos “baratos, mas que exigem vários retries”.
A seguir faço uma estimativa puramente aritmética com base nos preços de tabela (não representa a cobrança real; os coeficientes de agrupamento alteram o resultado). Suponha 2,000 Token de entrada e 500 Token de saída por requisição:
| Modelo | Custo de entrada | Custo de saída | Estimativa por chamada | US$ 0.05 dá para rodar aproximadamente |
|---|---|---|---|---|
qwen4-max (1.5 / 4.5) |
US$ 0.003 | US$ 0.00225 | cerca de US$ 0.0053 | cerca de 9 vezes |
claude-fable-5-2 (8 / 40) |
US$ 0.016 | US$ 0.02 | cerca de US$ 0.036 | cerca de 1 vez |
Desta tabela saem duas conclusões. Primeiro, usar o crédito de teste para verificar “se funciona” é o suficiente, mas comparar qualidade de verdade exige mais orçamento. Segundo, se um modelo gerar saídas mais longas na prática, ou precisar de dois retries para passar, a vantagem no preço unitário some — é exatamente o fenômeno citado antes nos materiais de terceiros. Por isso o orçamento deve ser controlado em duas camadas: primeiro use o saldo da conta e o max_tokens de cada requisição como teto, rode textos curtos primeiro e, depois de confirmar a taxa de aprovação, parta para contextos longos.
A seguir, um script de registro pronto para reutilizar, que grava cada tentativa em um CSV, facilitando o cálculo posterior do custo por tarefa qualificada:
Ver o script de registro das amostras do mesmo teste
import csv, time
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

MODELS = ["qwen4-max", "claude-fable-5-2"]
TASKS = [
    {"id": "t1", "prompt": "把下面的会议记录整理为 JSON:...", "check": lambda s: s.strip().startswith("{")},
    # Adicione mais 2–4 tarefas reais, cada uma com sua função de verificação
]

with open("trial_log.csv", "w", newline="", encoding="utf-8") as f:
    w = csv.writer(f)
    w.writerow(["model", "task", "attempt", "prompt_tokens", "completion_tokens",
                "cached_tokens", "passed", "latency_s", "error"])
    for model in MODELS:
        for t in TASKS:
            for attempt in range(1, 3):  # no máximo um retry; registre também as falhas
                start = time.time()
                try:
                    r = client.chat.completions.create(
                        model=model,
                        messages=[{"role": "user", "content": t["prompt"]}],
                        max_tokens=800,
                    )
                    text = r.choices[0].message.content or ""
                    u = r.usage
                    details = getattr(u, "prompt_tokens_details", None)
                    cached = getattr(details, "cached_tokens", 0) if details else 0
                    ok = bool(text) and t["check"](text)
                    w.writerow([model, t["id"], attempt, u.prompt_tokens,
                                u.completion_tokens, cached, ok,
                                round(time.time() - start, 2), ""])
                    if ok:
                        break
                except Exception as e:
                    w.writerow([model, t["id"], attempt, 0, 0, 0, False,
                                round(time.time() - start, 2), str(e)[:120]])
O que um ponto de entrada unificado elimina e o que não elimina
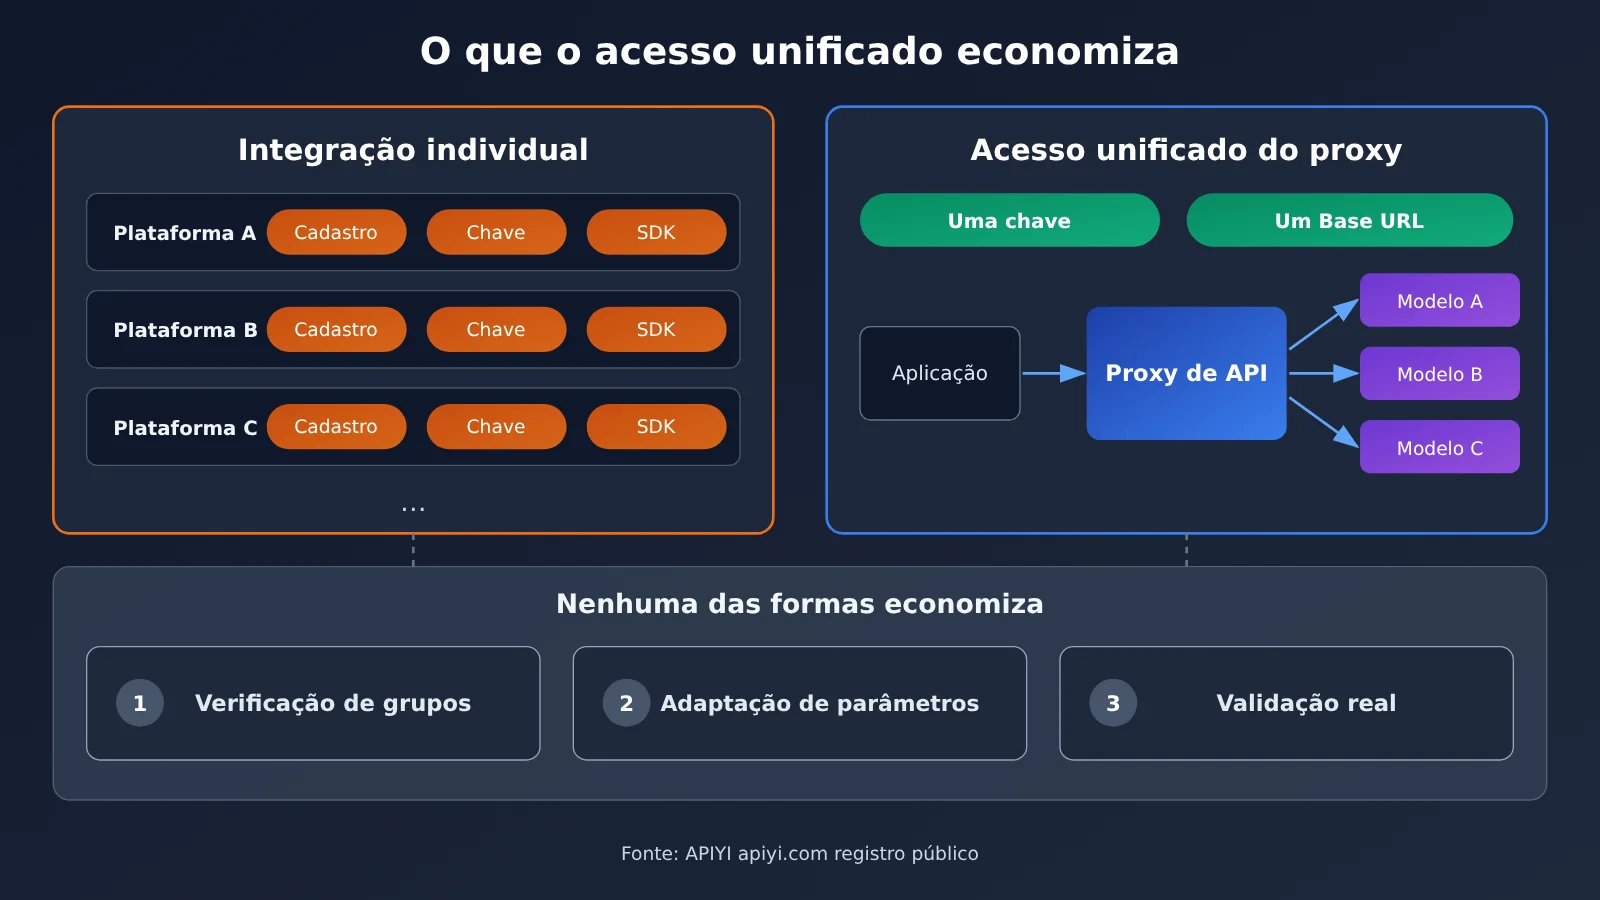
O que um ponto de entrada unificado elimina são as contas, chaves e configurações de SDK duplicadas. O que ele não elimina são três coisas:
- Grupos e visibilidade: o modelo estar no catálogo não significa que sua chave consiga vê-lo;
- Adaptação de parâmetros: parâmetros não públicos precisam ser tratados individualmente por modelo;
- Aceitação dos resultados: poder ver o modelo também não significa que a invocação terá sucesso e que a saída será qualificada.
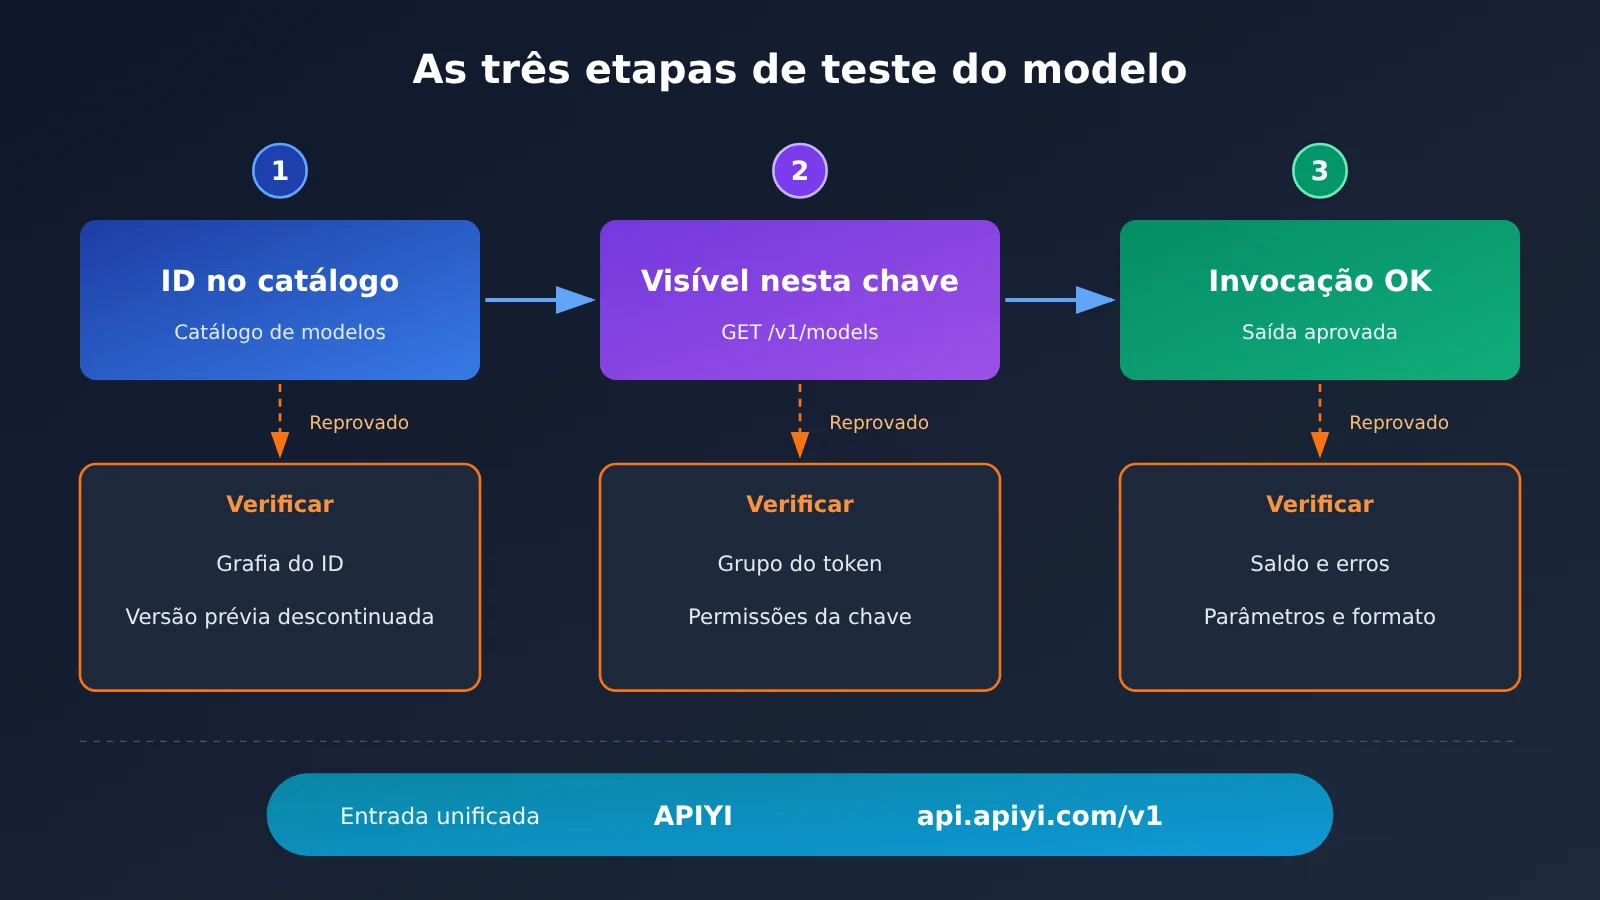
Catálogo visível, chave visível, invocação bem-sucedida e saída qualificada são quatro etapas que avançam em sequência, e cada uma precisa ser verificada separadamente. A tabela abaixo pode ser marcada item a item durante os testes:
| Item de verificação | Como verificar | Causas comuns quando não passa |
|---|---|---|
| O ID do modelo existe no catálogo | Consulte o registro público e confirme a grafia exata do ID | Foi usado um ID de prévia ou um alias |
| Visível para esta chave | Chame GET /v1/models |
O grupo de tokens não inclui esse canal |
| Endpoint compatível | Compare com a coluna de endpoints do catálogo | Foi usado chat para chamar uma capacidade que só aceita responses |
| Invocação bem-sucedida | Faça uma requisição mínima de verdade | Saldo insuficiente ou parâmetros não suportados |
| Saída qualificada | Verifique com regras de julgamento predefinidas | Formato incorreto, truncamento ou retorno vazio |
💡 Sugestão de escolha: no console do APIYI apiyi.com, crie um token separado só para testes e marque apenas os grupos necessários para o teste. Assim, a cobrança e o usage ficam separados do tráfego de produção, e o cálculo posterior do custo por tarefa qualificada fica mais claro.
Tabela de conclusão para você mesmo preencher
Este artigo não apresenta um ranking de qualidade entre qwen4-max e claude-fable-5-2, porque não realizamos experimentos nas suas tarefas, e rankings de terceiros também não representam o seu negócio. A abordagem mais confiável é rodar uma amostra pequena e depois preencher você mesmo a tabela abaixo, para só então decidir:
| Modelo | Número de tentativas | Número de aprovações | Custo total (conforme a fatura) | Custo por tarefa aprovada | Parâmetros que exigem adaptação extra |
|---|---|---|---|---|---|
| qwen4-max | |||||
| claude-fable-5-2 | |||||
| Seu modelo atual |
Duas sugestões para referência, ambas julgamentos e não conclusões já verificadas. Primeira: inclua o modelo atual na mesma tabela; um novo modelo só vale a migração quando vence claramente em “custo por tarefa aprovada” ou em “taxa de aprovação”. Segunda: no início do lançamento de um novo modelo, ID, preço e limites de parâmetros podem mudar — o ID de pré-visualização mencionado acima, que será desativado em 25 de novembro, é um exemplo disso. A recomendação é colocar os IDs dos modelos em arquivos de configuração em vez de hardcode, mantendo também uma rota de fallback. Quando precisar ampliar o leque de candidatos, você pode continuar adicionando novos modelos pelo ponto de entrada unificado da APIYI (apiyi.com) e rodar tudo de novo com o mesmo conjunto de tarefas e as mesmas regras de avaliação.
Rankings e catálogos só dizem quais modelos vale a pena experimentar; qual modelo realmente serve ao seu negócio é uma pergunta que só a tabela que você mesmo construiu pode responder. Como escreveu Lu You em “Lendo à noite no inverno, para mostrar a meu filho Ziyu”: “O que se obtém no papel é sempre raso; para saber de verdade, é preciso colocar a mão na massa.”