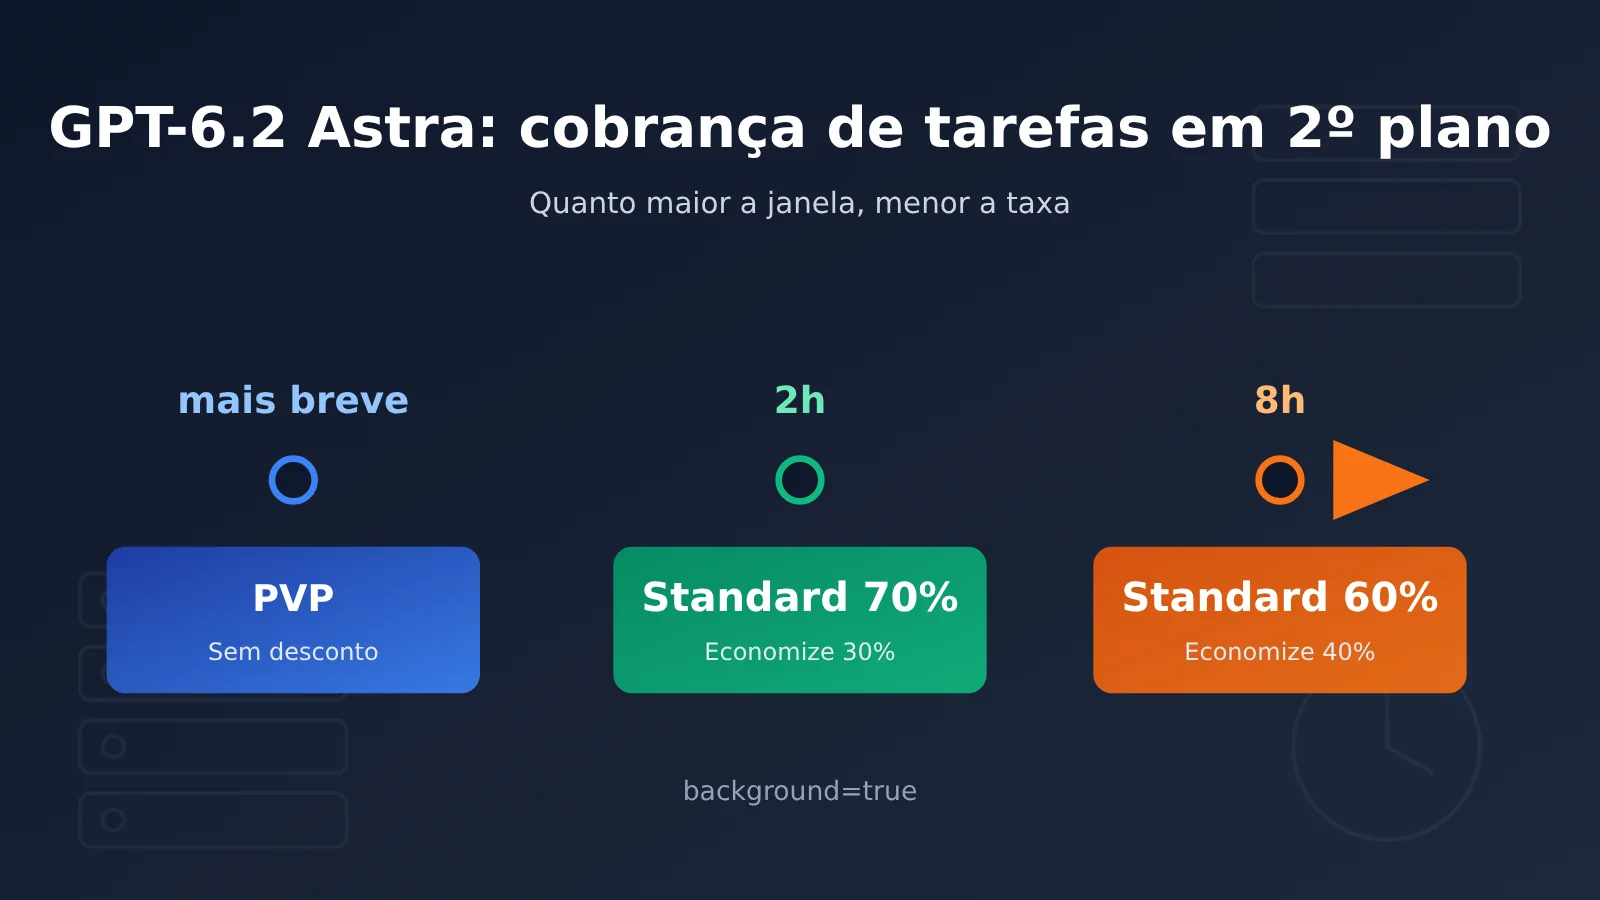
As regras de cobrança das tarefas em segundo plano do GPT-6.2 Astra podem ser resumidas em uma frase: se puder esperar, sai mais barato. A partir de 17 de novembro de 2026, as janelas de conclusão em segundo plano da Responses API entram em beta público. A janela padrão soonest é cobrada pelo preço cheio do nível de processamento utilizado; as requisições elegíveis para a janela de 2h são cobradas a 70% da tarifa de tokens do modelo Standard, e a janela de 8h a 60% — ou seja, 30% e 40% mais baratas, respectivamente.
Qual nível escolher depende de duas perguntas: até quando você precisa do resultado, e se as requisições dependem do resultado intermediário da etapa anterior. Responder essas duas perguntas primeiro e só depois estimar o custo com base no volume de uso é mais confiável do que comparar preços unitários diretamente.
O que você vai encontrar neste artigo?
- Definição, ponto de partida da contagem de tempo e base de cobrança das três janelas de conclusão:
soonest, 2h e 8h - O custo concreto de um mesmo volume de uso (100 mil tokens de entrada + 10 mil de saída) em 7 modos diferentes
- As condições de parâmetros que a requisição precisa atender para ter direito ao desconto, além dos limites de cota de fila e de reutilização de cache
- Qual forma de envio é mais adequada para perguntas interativas, resumo de tickets, revisão noturna e tarefas de classificação independentes
Índice: começamos com uma tabela de conceitos e um panorama de impactos para alinhar a terminologia. A seção «fatos objetivos» explica, em ordem, as regras da janela de conclusão, os preços de cada nível, as condições de desconto e o tratamento de continuação em fluxos de trabalho com várias etapas. A seção «análise e julgamento» discute se os descontos podem ser acumulados, o orçamento de tempo em tarefas de múltiplas etapas, os trade-offs trazidos por cache e cota de fila, e traz recomendações de escolha de nível por tipo de carga de trabalho.
GPT-6.2 Astra — cobrança de tarefas em segundo plano, para saber: explicação dos conceitos
| Conceito | Explicação breve |
|---|---|
| Standard | Faixa de processamento padrão da API OpenAI; os descontos das janelas em segundo plano de 2h e 8h têm como base a tarifa do modelo dessa faixa |
| Fast | Faixa acelerada atual do Astra; a tarifa de token do modelo é 2 vezes a do Standard |
| Ultrafast | Faixa de processamento ainda mais rápida; 3 vezes o Standard no período promocional e 6 vezes no preço de tabela depois |
| Modo em segundo plano | A requisição retorna primeiro um ID de resposta; a aplicação consulta o status mais tarde e recupera o resultado |
| Janela de conclusão | Meta de conclusão usada para o agendamento depois que a resposta em segundo plano é aceita; divide-se em soonest, 2h e 8h |
| soonest | Janela padrão das requisições em segundo plano: executa o quanto antes e mantém a tarifa de modelo da faixa de processamento usada |
| Batch API | Agrupa requisições independentes em um arquivo JSONL e as executa de forma assíncrona como um único job |
| continuation_id | Identificador que a aplicação define para o mesmo fluxo de trabalho em segundo plano, usado para vincular requisições de acompanhamento elegíveis |
| Tarifa de token do modelo | Preço unitário correspondente a cada item de medição, como entrada normal, entrada com acerto de cache e saída |
GPT-6.2 Astra — visão rápida do impacto na cobrança de tarefas em segundo plano
- Desenvolvedores de API: as tarefas assíncronas ganharam duas opções de desconto que ficam entre a chamada em tempo real e o Batch, mas é preciso adaptar o código para o modo em segundo plano e lidar com polling ou webhook.
- Product managers: é preciso deixar claro nos requisitos “até quando, no mais tardar, o resultado precisa estar disponível”. Funcionalidades que aceitam entrega em 2 horas ou 8 horas podem reduzir o custo de token do modelo em 30% ou 40%, respectivamente.
- Responsáveis por custo e operações: 2h, 8h e Batch compartilham a mesma cota de fila. Jobs Batch de grande volume e tarefas com desconto em segundo plano precisam ser planejados em conjunto — não dá para estimar capacidade de forma independente para cada um.
Fato objetivo: regras de cobrança de tarefas em segundo plano do GPT-6.2 Astra
Quais são as três janelas de conclusão das tarefas em segundo plano do GPT-6.2 Astra
A OpenAI lançou o GPT-6.2 Astra e o GPT-6.2 Sol em 17 de novembro de 2026. O Astra é voltado para raciocínio complexo, programação e trabalho profissional, e o ID do modelo na API é gpt-6.2-astra. No mesmo dia, o changelog da API da OpenAI registrou a entrada em beta público das janelas de conclusão em segundo plano da Responses API.
As solicitações assíncronas do Astra exigem a definição de background=true, e as janelas se dividem em três tipos:
- soonest (padrão): executa o quanto antes; os tokens do modelo são cobrados conforme a faixa de processamento efetivamente utilizada, sem desconto.
- 2h: as solicitações elegíveis são cobradas a 70% da tarifa de tokens do modelo Standard.
- 8h: as solicitações elegíveis são cobradas a 60% da tarifa de tokens do modelo Standard.
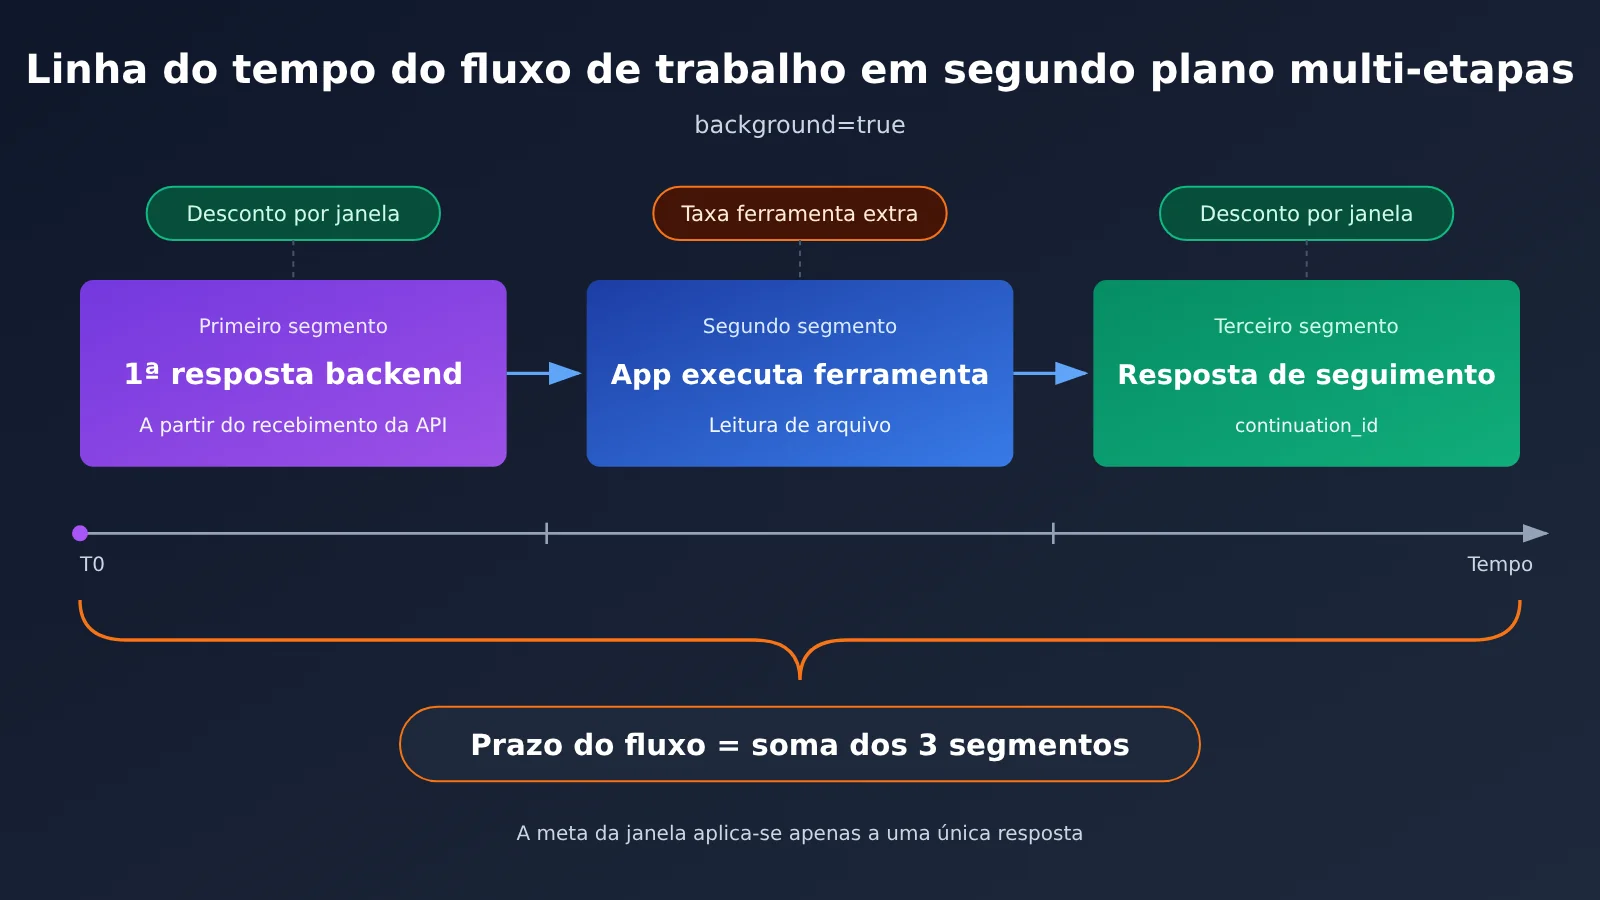
O cronômetro começa no momento em que a API aceita a solicitação inicial, e o alvo da janela corresponde a essa resposta específica. Se a tarefa exigir que a aplicação execute ferramentas no meio do caminho e inicie a próxima resposta, esse tempo de execução e de continuação precisa ser contado à parte, dentro do prazo total do fluxo de trabalho.
Pegue o exemplo de “consultar o arquivo primeiro e depois seguir com a revisão”: a primeira resposta é concluída dentro da janela e retorna uma chamada de ferramenta que a aplicação precisa executar. Depois de ler o arquivo, a aplicação envia o resultado como solicitação de acompanhamento, e o modelo retoma a revisão. O tempo total do processo é a soma dos três trechos — a primeira resposta, a execução da ferramenta e a resposta de continuação —, e não apenas uma janela.
Quanto custa uma mesma solicitação em cada modo do GPT-6.2 Astra
A tabela abaixo mostra as tarifas de contexto curto do GPT-6.2 Astra, em dólares por milhão de tokens. As linhas de 2h e 8h são convertidas a partir dos percentuais de desconto oficiais; as datas de preço do Ultrafast seguem o horário do Pacífico dos EUA.
| Modo | Relativo ao Standard | Entrada normal | Entrada com cache hit | Saída |
|---|---|---|---|---|
| Standard | 1x | $8,00 | $0,40 | $40,00 |
| Fast | 2x | $16,00 | $0,80 | $80,00 |
| Ultrafast (até 2027-02-28) | 3x | $24,00 | $1,20 | $120,00 |
| Ultrafast (a partir de 2027-03-01) | 6x | $48,00 | $2,40 | $240,00 |
| Segundo plano 2h | 0,70x | $5,60 | $0,28 | $28,00 |
| Segundo plano 8h | 0,60x | $4,80 | $0,24 | $24,00 |
| Batch | 0,50x | $4,00 | $0,20 | $20,00 |
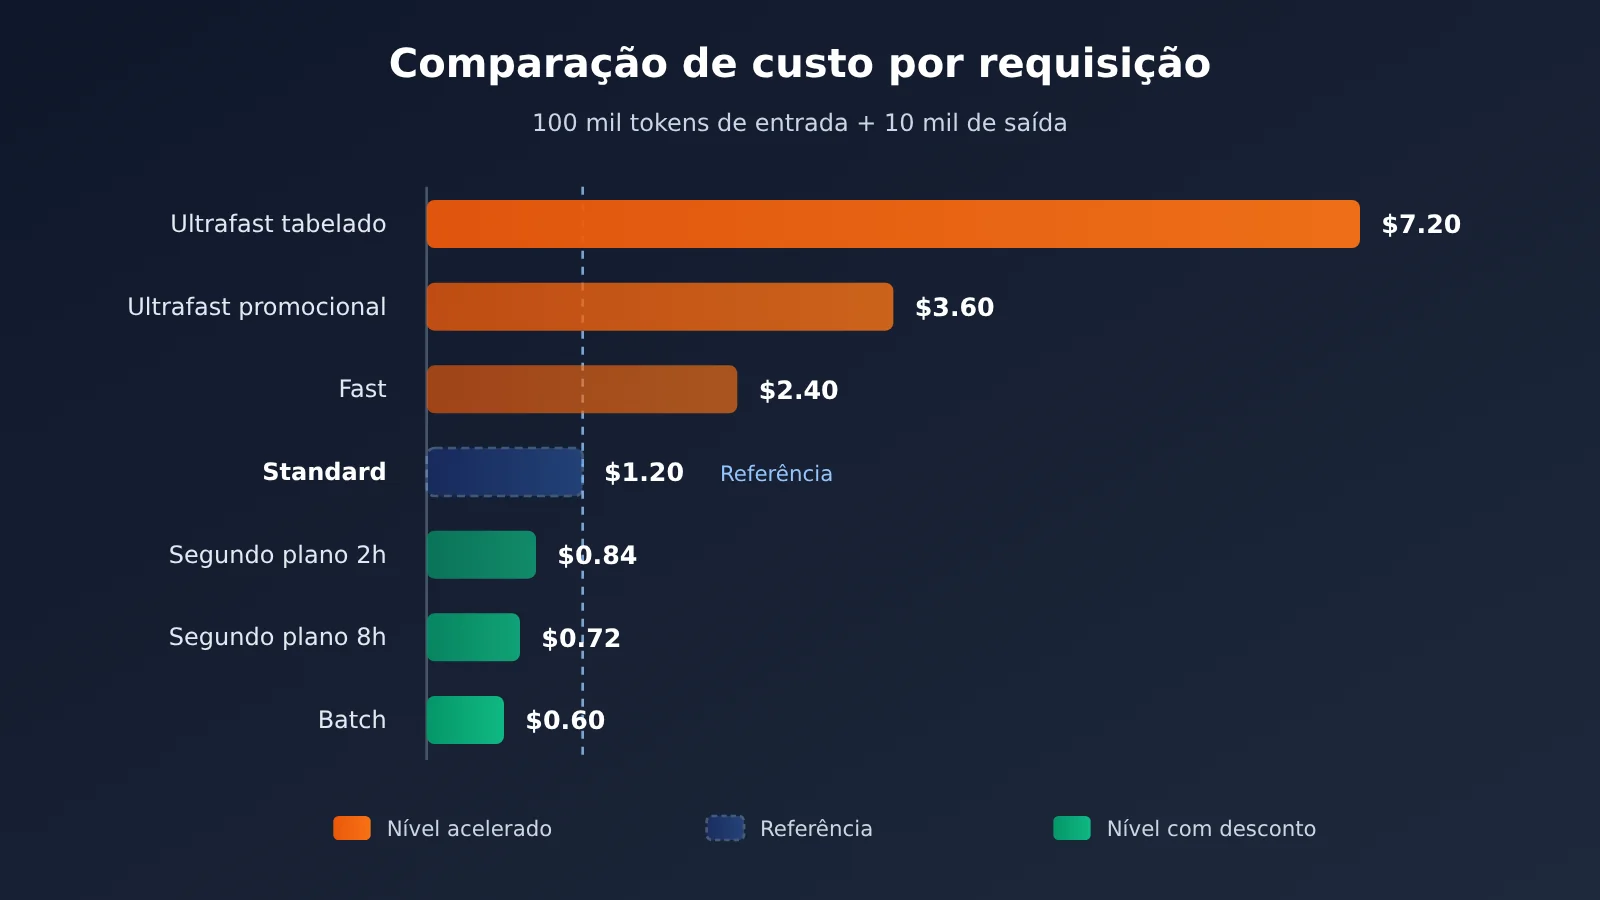
Vamos usar um consumo fixo para comparar: 100.000 tokens de entrada normal + 10.000 tokens de saída cobrados. No Standard, o cálculo é 0,1 × $8 + 0,01 × $40 = $1,20; os demais modos seguem a mesma lógica de conversão:
| Modo | Custo de tokens do modelo por solicitação | Diferença em relação ao Standard |
|---|---|---|
| Ultrafast (preço de tabela) | $7,20 | +$6,00 |
| Ultrafast (preço promocional) | $3,60 | +$2,40 |
| Fast | $2,40 | +$1,20 |
| Standard | $1,20 | Referência |
| Segundo plano 2h | $0,84 | −$0,36 |
| Segundo plano 8h | $0,72 | −$0,48 |
| Batch | $0,60 | −$0,60 |
Esse exemplo considera apenas os tokens do modelo. Chamadas de Web Search, contêineres Shell / Code Interpreter e outros itens são cobrados separadamente por projeto, e a gravação em cache também tem preço próprio.
Além disso, o model card observa: quando a entrada ultrapassa 272K tokens, a solicitação inteira passa a usar a tarifa de contexto longo — os preços de entrada e cache são multiplicados por 2, e o preço de saída por 1,5 — e depois se aplica o modo escolhido ou o desconto elegível. Seguindo essa regra, uma solicitação de contexto longo na janela de 8h fica com entrada normal de $16 × 0,6 = $9,6 e saída de $60 × 0,6 = $36 (por milhão de tokens).
As tarifas acima são convertidas a partir da tabela de preços oficial da OpenAI e dos percentuais de desconto. Se você chamar via APIYI apiyi.com, a cobrança real segue a página de faturamento da plataforma; vale a pena conferir a conta com pouco tráfego antes de levar para produção.
Como fazer as requisições ao GPT-6.2 Astra atenderem aos critérios de desconto de cobrança em segundo plano
O desconto não entra em vigor automaticamente: é preciso atender a todas as condições abaixo ao mesmo tempo:
| Parâmetro / Condição | Valor qualificado | Descrição |
|---|---|---|
| Endpoint | /v1/responses |
A janela concluída em segundo plano tem como referência a API Responses |
background |
true |
Entra no modo segundo plano, retornando primeiro o ID da resposta |
background_options.completion_window |
2h ou 8h |
O padrão soonest não tem desconto |
service_tier |
default (Standard) |
auto só atende à condição se acabar caindo em Standard |
stream |
omitido ou false |
Saída em streaming não se qualifica para o desconto |
Em termos de cota, 2h, 8h e Batch compartilham a cota de fila Batch/Background, contada pelos tokens de entrada no momento de entrar na fila; soonest usa os limites normais de número de requisições e de tokens. No lado do cache há uma fronteira: requisições comuns em Standard não conseguem reaproveitar o cache de prompt criado por essas duas janelas de desconto. Além disso, atenção: o cartão do modelo diz que requisições com reasoning.effort definido como none são rejeitadas.
Abaixo segue um exemplo mínimo. O background_options pode não estar incluído nas definições de tipo do SDK, então passamos via extra_body:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI da APIYI
)

resp = client.responses.create(
    model="gpt-6.2-astra",
    input="请汇总以下 50 张支持工单的共性问题……",
    background=True,
    service_tier="default",          # Segue Standard, atendendo às condições de desconto
    extra_body={"background_options": {"completion_window": "2h"}},
)
print(resp.id, resp.status)  # Guarde o response ID para recuperá-lo depois
Depois de obter o response ID, você pode ler o status via webhook ou polling. Quando o status for queued ou in_progress, continue consultando com o mesmo ID; erros de capacidade qualificados são reprocessados automaticamente pela API, sem necessidade de reenvio pela aplicação.
Ver o exemplo completo de polling e requisição de acompanhamento
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Acesso unificado via APIYI
)

WINDOW = "8h"

def submit(input_items, previous_id=None):
    """Envia uma requisição de desconto em segundo plano.
    A posição exata do parâmetro continuation_id deve seguir o guia de Background mode da OpenAI."""
    return client.responses.create(
        model="gpt-6.2-astra",
        input=input_items,
        background=True,
        service_tier="default",
        previous_response_id=previous_id,
        extra_body={
            "background_options": {"completion_window": WINDOW},
            # "continuation_id": "audit-2026-11-19-batch-01",  # Mantenha consistente no mesmo fluxo de trabalho
        },
    )

def wait(response_id, interval=60):
    """Faz polling até o término; quando queued / in_progress, usa o mesmo ID para continuar consultando."""
    while True:
        r = client.responses.retrieve(response_id)
        if r.status not in ("queued", "in_progress"):
            return r
        time.sleep(interval)

first = wait(submit("审核合同,需要时调用 read_file 工具读取附件").id)

# Se a chamada de ferramenta for de responsabilidade da aplicação: a aplicação executa a ferramenta e então
# dispara uma requisição de acompanhamento com o mesmo projeto, modelo, nível de processamento,
# janela e continuation_id; a etapa de continuação pode ganhar prioridade na fila
for item in first.output:
    if item.type == "function_call":
        tool_result = "……read_file 的实际返回内容……"
        follow = submit(
            [{"type": "function_call_output",
              "call_id": item.call_id,
              "output": tool_result}],
            previous_id=first.id,
        )
        print(wait(follow.id).output_text)
Em fluxos de trabalho de múltiplas etapas, a requisição da etapa de continuação precisa usar o mesmo projeto, modelo, nível de processamento, janela e continuation_id para ter direito à prioridade na fila. Requisições de acompanhamento elegíveis são cobradas individualmente de acordo com o desconto correspondente.
🚀 Recomendação de integração: A janela de conclusão em segundo plano é atualmente um recurso em beta público da OpenAI Responses API. Ao chamar por meio de plataformas agregadoras como APIYI apiyi.com, recomenda-se primeiro usar a cota gratuita de testes para confirmar se os parâmetros
backgroundecompletion_windowsão repassados integralmente e se a cobrança é feita com desconto; só então migre as tarefas de produção.
Análise e julgamento: como aproveitar bem a cobrança de tarefas em segundo plano do GPT-6.2 Astra
O desconto em segundo plano e o nível de aceleração do GPT-6.2 Astra não podem ser combinados
As condições do desconto exigem que service_tier seja default, ou que auto acabe caindo em Standard. Com base nisso, dá para concluir que Fast e Ultrafast não podem usufruir dos descontos de 2h e 8h ao mesmo tempo. O trade-off aqui é claro: o nível de aceleração troca mais custo por menor latência, enquanto a janela em segundo plano troca mais espera por um preço menor — são direções opostas.
Há também um detalhe fácil de passar despercebido: soonest, embora também seja um modo em segundo plano, tem o preço atrelado ao nível de processamento. Usar soonest com Fast continua custando o preço de Fast, só que a forma de interação passa a ser assíncrona. O soonest serve para fazer a interface devolver o controle ao usuário primeiro; ele em si não economiza dinheiro.
Tarefas de múltiplas etapas exigem orçamento de tempo para “o fluxo de trabalho inteiro”
A meta de janela restringe apenas uma única resposta, não o fluxo de trabalho inteiro. Uma tarefa de auditoria que exige três rodadas de chamadas de ferramentas pode, em teoria, passar por três agendamentos de janela, além do tempo que a aplicação leva para executar as ferramentas. Se o negócio promete “resultado antes das 9h da manhã”, ao usar uma janela de 8h para tarefas noturnas, o horário de envio precisa reservar margem para etapas de continuação e não pode ser enviado no limite exato das 8 horas.
O valor de continuation_id está justamente aí. Ele não estende nem mescla janelas, mas permite que as etapas de continuação obtenham prioridade na fila, reduzindo a espera final em fluxos de múltiplas etapas. Do ponto de vista de engenharia, recomenda-se mapear continuation_id e o ID da tarefa de negócio um para um, o que também facilita a investigação em logs e a alocação de custos.
8h e Batch: diferença de 10 pontos percentuais, cenários de uso diferentes
Com o volume de uso do exemplo, o 8h custa $0.72 e o Batch, $0.60 — uma diferença de apenas $0.12. O Batch é mais barato, mas exige que as requisições possam ser montadas antecipadamente em JSONL, sejam independentes entre si e aceitem uma janela de entrega de 24 horas. Já o 8h permite que a requisição continue o raciocínio com base no resultado da ferramenta.
Portanto, o critério não é qual sai mais barato, mas a estrutura da tarefa:
- Requisições com dependência entre si (a próxima etapa precisa ver o resultado da anterior): escolha 8h ou 2h.
- Requisições independentes entre si, que possam ser listadas de uma só vez: escolha Batch.
O desconto de 50% do Batch e o desconto da janela em segundo plano são duas vias de cobrança independentes e não se acumulam.
Custos ocultos gerados por cache e cota de fila
O cache de prompt criado pela janela com desconto não pode ser reutilizado por requisições regulares do Standard. Se o mesmo prompt de sistema longo for usado tanto para perguntas e respostas em tempo real quanto para processamento em lote em segundo plano, cada lado criará seu próprio cache, e o custo de gravação no cache pode acabar sendo cobrado em duplicidade. Além disso, a entrada com cache hit já é barata por si só: $0.40 no Standard e $0.24 no 8h. Para cargas com alta taxa de cache hit, a proporção de economia do desconto em segundo plano na fatura total será menor do que em tarefas intensivas em saída.
O compartilhamento da cota de fila também precisa ser planejado com antecedência. 2h, 8h e Batch compartilham a cota Batch/Background e entram na fila contabilizando tokens de entrada. Se você enviar ao mesmo tempo, à noite, um grande lote de tarefas Batch e um fluxo de revisão 8h, os dois vão competir pela mesma cota.
💡 Sugestão de custo: antes de definir a faixa, use a distribuição real de tokens do prompt (a proporção entre entrada normal, entrada com cache hit e saída) para estimar separadamente o custo de cada faixa. Com a interface unificada da APIYI apiyi.com, o mesmo conjunto de código, bastando alterar os parâmetros, permite comparar as diferenças de faturamento entre o caminho em tempo real e o assíncrono.
Colocando o nível de serviço do GPT-6.2 Astra em cargas de trabalho reais
A seguir, um esboço das cargas de trabalho; os critérios de decisão, em ordem, são: quanto tempo dá para esperar, se há dependência de resultados intermediários e se existe custo de ferramentas.
| Carga de trabalho | Forma de envio recomendada | Justificativa |
|---|---|---|
| Perguntas e respostas interativas em tempo real, análises com alguém aguardando | Comece com Standard; só considere Fast / Ultrafast depois de validar latência e custo | O usuário está esperando; pagar a mais por velocidade exige dados que sustentem a decisão |
| Interface assíncrona, que prefere retornar primeiro e exibir o resultado depois | soonest | Devolve o controle ao cliente e o preço segue o nível de processamento utilizado |
| Consolidação de tickets de suporte para ficar pronta antes da tarde | background 2h | Entrega em algumas horas, com custo de tokens do modelo 30% menor |
| Revisão em várias etapas que pode rodar durante a noite e exige chamadas de ferramentas | background 8h + continuation_id | Redução de 40%, com tempo reservado para a execução de ferramentas e a continuação das etapas |
| Tarefas de classificação independentes que podem ser montadas com antecedência | Batch (JSONL) | São independentes entre si e aceitam uma janela de 24 horas; redução de 50% |
Vale observar que, quando a tarefa usa Web Search ou o contêiner Code Interpreter, essa parte do custo não entra no desconto de tokens do modelo. Quanto maior a proporção de custos de ferramentas, menor a economia geral proporcionada pela janela em background.
🎯 Sugestão de escolha: primeiro rode a mesma amostra no APIYI (apiyi.com) em Standard, 2h e 8h, registre o tempo real de conclusão e a fatura, e só então defina o nível padrão para cada tipo de tarefa. Isso chega mais perto do custo real do que olhar apenas a tabela de preços unitários.
Mudanças que merecem atenção contínua
O modo “background completion window” (janela de conclusão em segundo plano) ainda está em beta público, e os nomes dos parâmetros, os critérios de elegibilidade e as proporções de desconto podem mudar antes do lançamento oficial. Antes de ir para produção, consulte o guia oficial da OpenAI. Duas outras datas também merecem ser anotadas: o preço promocional do Ultrafast vale até 28 de fevereiro de 2027 (horário do Pacífico), e a partir de 1º de março a tarifa sobe de 3x para 6x — produtos que dependem do Ultrafast a longo prazo precisam avaliar o orçamento com antecedência. O GPT-6.2 Astra e o Sol não têm, no momento, o nível Flex; se ele for lançado depois, as opções para tarefas assíncronas aumentarão.
Para equipes que estão planejando capacidades assíncronas com o Astra, uma boa ideia é primeiro usar os créditos de teste no APIYI apiyi.com para validar o modo de segundo plano e a lógica de polling, colocar prazos e dependências de tarefas no documento de requisitos, e só então discutir qual nível usar.
O Lunyu · Zilu diz: “a pressa não leva ao sucesso” (欲速则不达). Na tabela de preços do GPT-6.2 Astra, essa frase ganhou um preço concreto: quem aceita esperar algumas horas a mais paga de 30% a 40% menos nas tarifas do modelo.
📚 Referências
-
Anúncio de lançamento da OpenAI: Introducing GPT-6.2 Astra and Sol (2026-11-17)
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol/ - Descrição: posicionamento do modelo e explicação do ajuste de preços
- Link:
-
Model card do GPT-6.2 Astra: especificações, tarifas de contexto curto e contexto longo
- Link:
developers.openai.com/api/docs/models/gpt-6.2-astra - Descrição: comprimento de contexto e regras de precificação do contexto longo de 272K
- Link:
-
Changelog da API da OpenAI: entradas de lançamento de modelo e janela de segundo plano em 2026-11-17
- Link:
developers.openai.com/api/docs/changelog - Descrição: beta público da janela de conclusão em segundo plano e proporções de desconto
- Link:
-
Tabela de preços da API da OpenAI: preço unitário de cada nível de processamento
- Link:
developers.openai.com/api/docs/pricing - Descrição: tarifas Standard, Fast, Ultrafast e Batch
- Link:
-
Guia do Background mode: modo de segundo plano, janela de conclusão e requisições de acompanhamento
- Link:
developers.openai.com/api/docs/guides/background - Descrição: condições de desconto,
continuation_id, cota de fila e limites de cache
- Link:
-
Guias do Batch API / Fast / Ultrafast
- Link:
developers.openai.com/api/docs/guides/batch,developers.openai.com/api/docs/guides/fast-mode,developers.openai.com/api/docs/guides/ultrafast-mode - Descrição: condições de aplicação de cada forma de submissão
- Link:
Autor: Equipe técnica do APIYI
Contato técnico: fale conosco pela página inicial do APIYI apiyi.com; mais materiais de integração estão disponíveis no centro de documentação docs.apiyi.com