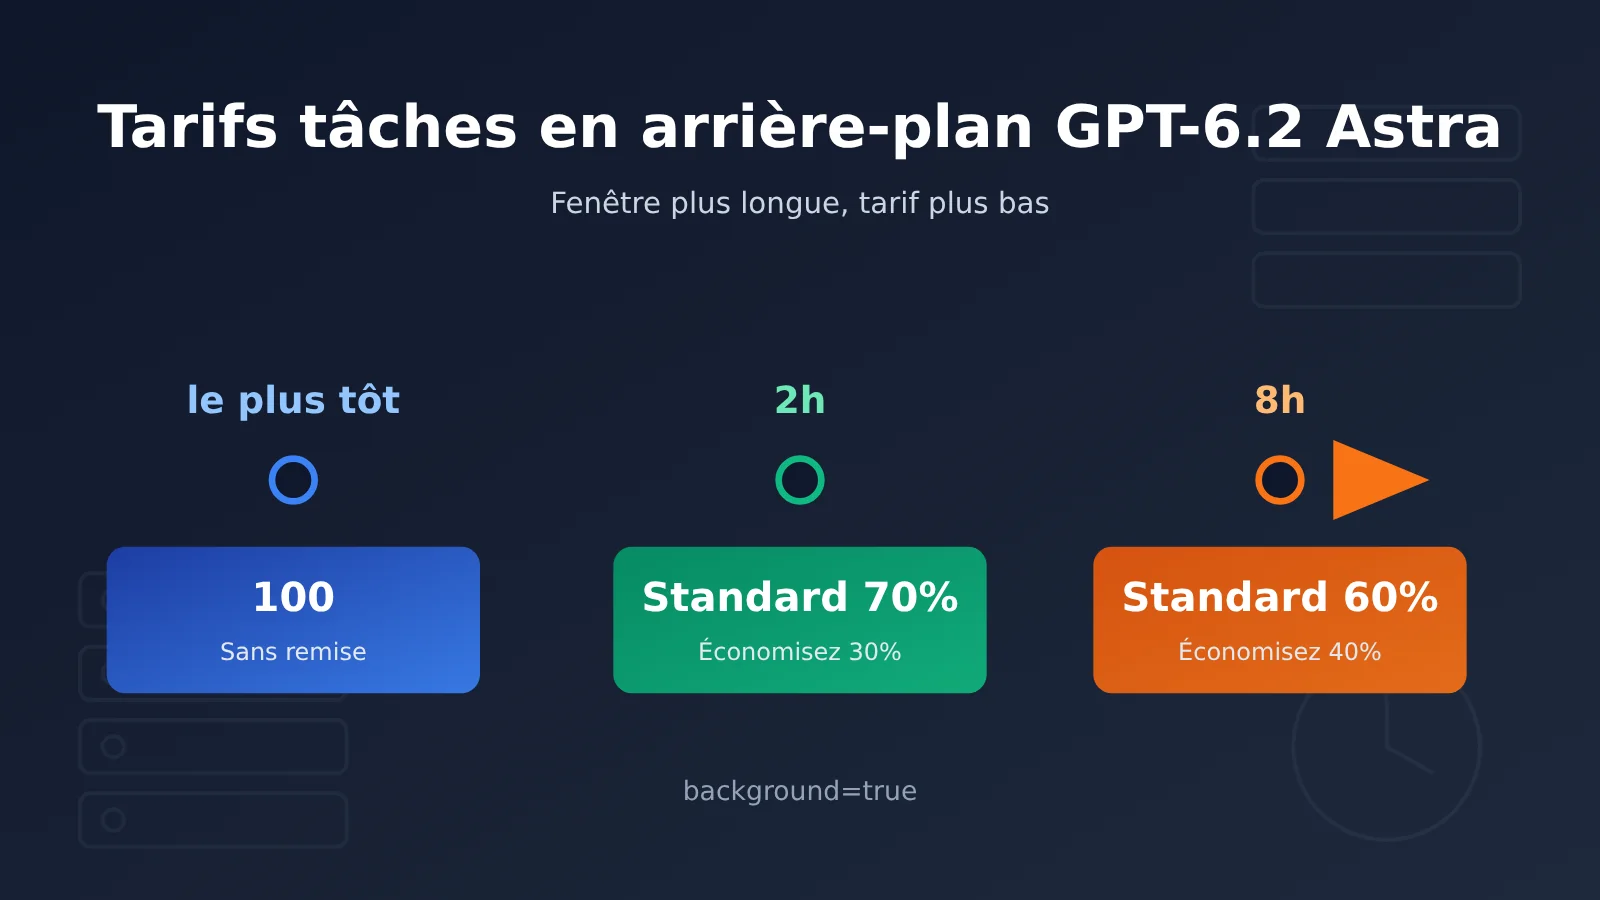
La règle de facturation des tâches en arrière-plan de GPT-6.2 Astra tient en une phrase : plus vous pouvez attendre, moins c’est cher. À partir du 17 novembre 2026, les fenêtres d’achèvement en arrière-plan de l’API Responses entrent en bêta publique. La fenêtre par défaut, soonest, est facturée au tarif normal du palier de traitement utilisé ; en choisissant une fenêtre de 2 h, les requêtes admissibles sont facturées à 70 % du tarif des tokens du modèle Standard, et une fenêtre de 8 h à 60 %, soit respectivement 30 % et 40 % moins cher.
Le choix du palier dépend de deux questions : quand vous avez besoin du résultat au plus tard, et si les requêtes doivent dépendre des résultats intermédiaires de l’étape précédente. Répondez d’abord à ces deux questions, puis estimez le coût en fonction de votre volume d’usage : c’est plus fiable que de comparer directement les prix unitaires.
Que retiendrez-vous de cet article ?
- La définition des trois fenêtres d’achèvement (
soonest, 2 h, 8 h), leur point de départ de chronométrage et leur base de facturation - Le coût concret d’un même volume d’usage (100 000 tokens d’entrée + 10 000 tokens de sortie) dans 7 modes différents
- Les paramètres à respecter obligatoirement pour bénéficier de la remise, ainsi que les limites des quotas de file d’attente et de la réutilisation du cache
- Quel mode de soumission convient aux échanges interactifs, à la synthèse de tickets, aux validations de nuit et aux tâches de classification indépendantes
Sommaire : une table de concepts suivie d’un aperçu des impacts pour harmoniser la terminologie. La partie « Faits objectifs » détaille successivement les règles des fenêtres d’achèvement, les prix de chaque palier, les conditions de remise et le traitement des étapes suivantes dans un workflow à plusieurs étapes. La partie « Analyse et interprétation » examine si les remises sont cumulables, le budget temps des tâches multi-étapes, les compromis liés au cache et aux quotas de file d’attente, et propose des recommandations de palier selon la charge de travail.
GPT-6.2 Astra : facturation des tâches en arrière-plan — concepts clés
| Concept | Brève explication |
|---|---|
| Standard | Niveau de traitement standard de l’API OpenAI ; les remises des fenêtres en arrière-plan de 2 h et 8 h sont calculées sur la base de son tarif de modèle |
| Fast | Niveau accéléré actuel d’Astra, dont le tarif des tokens du modèle est le double de celui de Standard |
| Ultrafast | Niveau de traitement encore plus rapide : 3 fois Standard pendant la promotion, puis 6 fois au prix catalogue |
| Mode arrière-plan | La requête renvoie d’abord un ID de réponse ; l’application interroge ensuite l’état et récupère le résultat |
| Fenêtre d’achèvement | Objectif d’achèvement utilisé pour la planification une fois la réponse en arrière-plan acceptée : soonest, 2 h, 8 h |
| soonest | Fenêtre par défaut des requêtes en arrière-plan : exécution dès que possible, avec le tarif de modèle du niveau de traitement utilisé |
| Batch API | Regrouper des requêtes indépendantes dans un fichier JSONL et les exécuter de façon asynchrone sous forme de job |
| continuation_id | Identifiant défini par l’application pour un même flux de travail en arrière-plan, servant à associer les requêtes de suivi éligibles |
| Tarif des tokens du modèle | Prix unitaire appliqué à chaque poste de mesure : entrée normale, entrée avec cache hit et sortie |
Aperçu de l’impact de la facturation des tâches en arrière-plan de GPT-6.2 Astra
- Développeurs API : les tâches asynchrones gagnent deux options de remise intermédiaires entre l’appel en temps réel et le Batch, mais il faut adapter le code au mode arrière-plan et gérer le polling ou les webhooks.
- Chefs de produit : il faut préciser dans les exigences « à quel moment au plus tard le résultat doit être disponible ». Les fonctionnalités qui tolèrent une livraison sous 2 heures ou sous 8 heures permettent de réduire le coût des tokens du modèle de 30 % ou 40 % respectivement.
- Responsables coûts et opérations : les fenêtres de 2 h, 8 h et le Batch partagent le même quota de file d’attente ; les gros jobs Batch et les tâches à remise en arrière-plan doivent donc être planifiés ensemble, sans estimer la capacité de chacun de façon isolée.
Faits objectifs : règles de facturation des tâches en arrière-plan de GPT-6.2 Astra
Quelles sont les trois fenêtres d’achèvement des tâches en arrière-plan de GPT-6.2 Astra ?
OpenAI a publié GPT-6.2 Astra et GPT-6.2 Sol le 17 novembre 2026. Astra est destiné au raisonnement complexe, au codage et au travail professionnel, avec l’ID de modèle API gpt-6.2-astra. Le même jour, le journal des mises à jour de l’API OpenAI a indiqué que les fenêtres d’achèvement en arrière-plan de la Responses API entraient en bêta publique.
Les requêtes asynchrones d’Astra doivent définir background=true, et les fenêtres se déclinent en trois types :
- soonest (par défaut) : exécution dès que possible, les tokens du modèle étant facturés selon le palier de traitement réellement utilisé, sans remise.
- 2h : les requêtes éligibles sont facturées à 70 % du tarif Standard des tokens du modèle.
- 8h : les requêtes éligibles sont facturées à 60 % du tarif Standard des tokens du modèle.
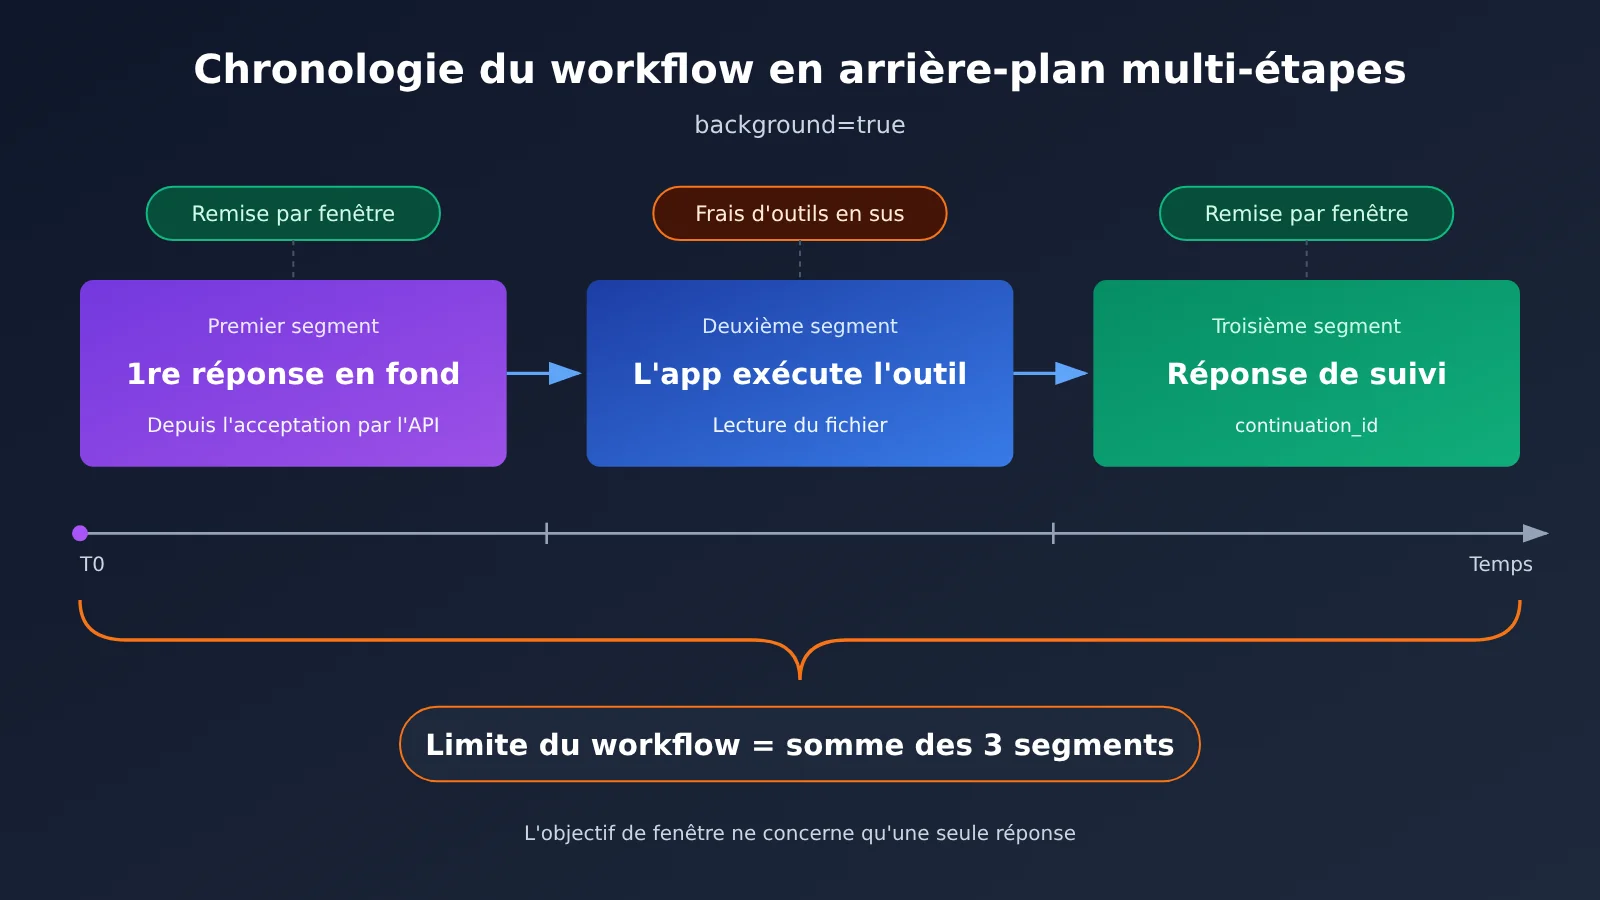
Le décompte commence au moment où l’API accepte la requête initiale, et la fenêtre cible correspond à cette réponse précise. Si la tâche exige que l’application exécute un outil en cours de route, puis déclenche une nouvelle réponse, ce temps d’exécution et de continuation doit être calculé séparément dans le délai global du workflow.
Prenons l’exemple « d’abord consulter le fichier, puis poursuivre la vérification » : la première réponse se termine dans la fenêtre et renvoie un appel d’outil que l’application doit exécuter. Après avoir lu le fichier, l’application soumet le résultat comme requête de suivi, et le modèle poursuit la vérification. La durée totale de l’opération est la somme de trois segments — la première réponse, l’exécution de l’outil et la réponse de continuation — et non celle d’une seule fenêtre.
Combien coûte une même requête selon le niveau de GPT-6.2 Astra
Le tableau ci-dessous donne les tarifs de GPT-6.2 Astra en contexte court, en dollars par million de tokens. Les lignes 2h et 8h sont obtenues en appliquant les ratios de remise officiels ; pour Ultrafast, les dates de tarification sont exprimées en heure du Pacifique (États-Unis).
| Mode | Par rapport à Standard | Entrée normale | Entrée avec cache hit | Sortie |
|---|---|---|---|---|
| Standard | 1× | $8.00 | $0.40 | $40.00 |
| Fast | 2× | $16.00 | $0.80 | $80.00 |
| Ultrafast (jusqu’au 2027-02-28) | 3× | $24.00 | $1.20 | $120.00 |
| Ultrafast (à partir du 2027-03-01) | 6× | $48.00 | $2.40 | $240.00 |
| Arrière-plan 2h | 0.70× | $5.60 | $0.28 | $28.00 |
| Arrière-plan 8h | 0.60× | $4.80 | $0.24 | $24.00 |
| Batch | 0.50× | $4.00 | $0.20 | $20.00 |
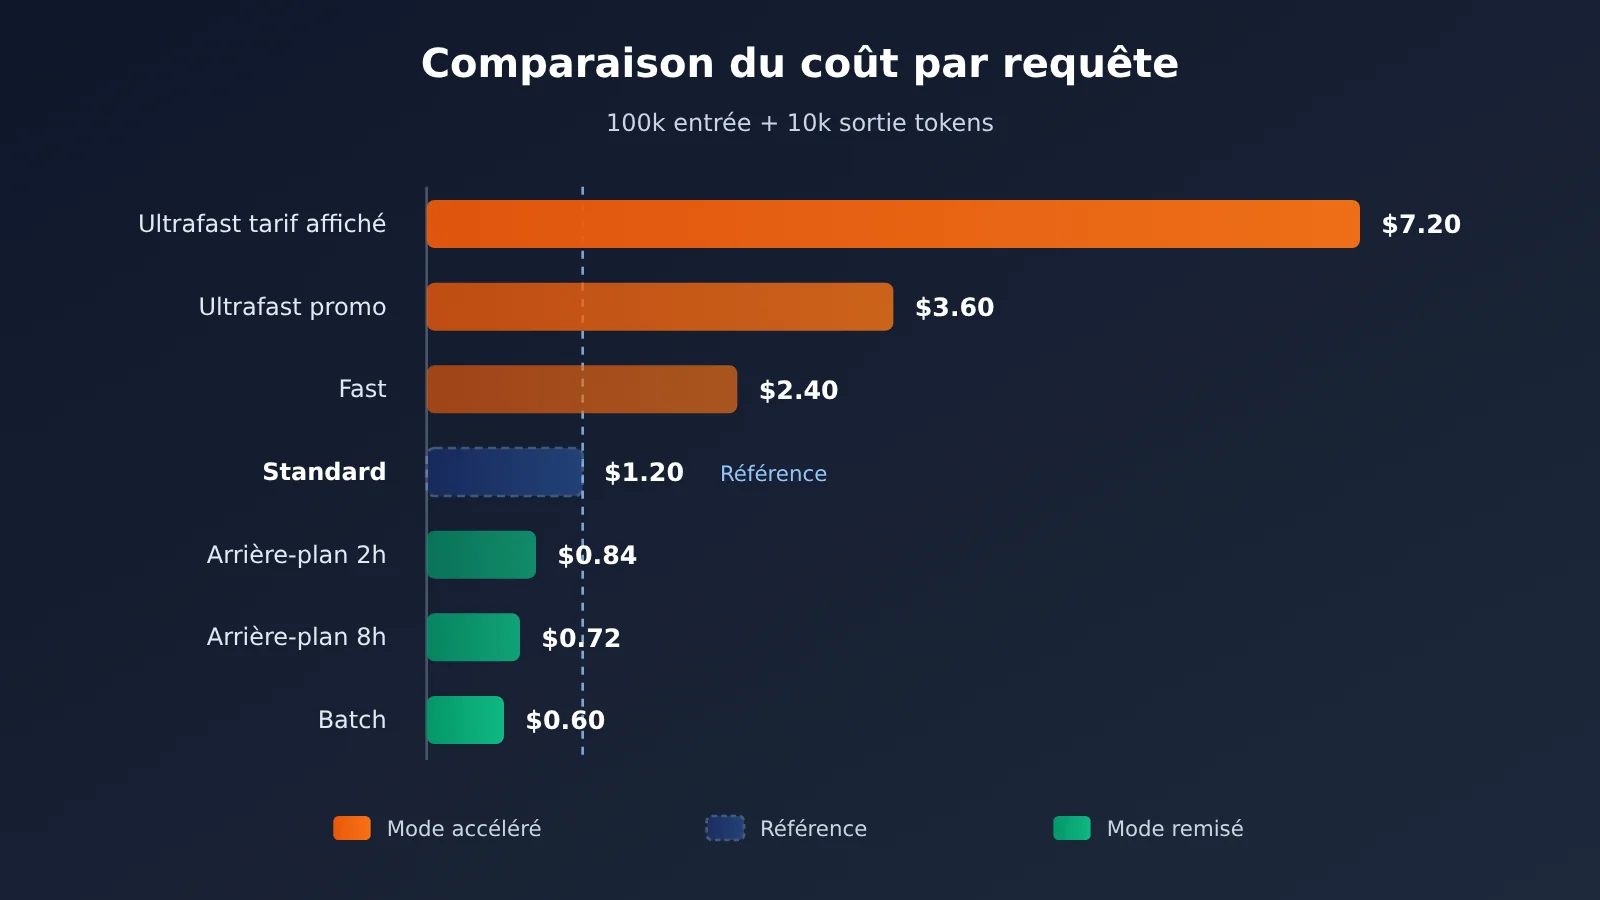
Prenons un volume d’usage fixe comme point de comparaison : 100 000 tokens d’entrée normale + 10 000 tokens de sortie facturés. Pour Standard, le calcul est 0.1 × $8 + 0.01 × $40 = $1.20, et les autres niveaux se convertissent de la même manière :
| Mode | Coût en tokens du modèle par requête | Écart par rapport à Standard |
|---|---|---|
| Ultrafast prix catalogue | $7.20 | +$6.00 |
| Ultrafast prix promo | $3.60 | +$2.40 |
| Fast | $2.40 | +$1.20 |
| Standard | $1.20 | Référence |
| Arrière-plan 2h | $0.84 | −$0.36 |
| Arrière-plan 8h | $0.72 | −$0.48 |
| Batch | $0.60 | −$0.60 |
Cet exemple ne compte que les tokens du modèle. Les appels à Web Search, les conteneurs Shell / Code Interpreter et autres sont facturés à part selon leurs propres tarifs, et l’écriture dans le cache est elle aussi facturée séparément.
Autre point précisé sur la fiche du modèle : lorsque l’entrée dépasse 272K tokens, toute la requête bascule sur le tarif long contexte — les prix d’entrée et de cache sont multipliés par 2, celui de sortie par 1.5, puis on applique le niveau choisi ou la remise éligible. En suivant cette règle, une requête en contexte long sur une fenêtre 8h revient à $16 × 0.6 = $9.6 pour l’entrée normale et à $60 × 0.6 = $36 pour la sortie (par million de tokens).
Les tarifs ci-dessus sont calculés à partir du barème officiel d’OpenAI et des ratios de remise. Si vous passez par APIYI apiyi.com, c’est la page de facturation de la plateforme qui fait foi pour le règlement réel : mieux vaut vérifier la facture avec un petit volume de trafic avant de passer en production.
Comment rendre les requêtes GPT-6.2 Astra éligibles à la remise de facturation en arrière-plan
La remise ne s’applique pas automatiquement : il faut remplir simultanément les conditions suivantes :
| Paramètre / Condition | Valeur éligible | Explication |
|---|---|---|
| Interface | /v1/responses |
La fenêtre d’achèvement en arrière-plan se base sur l’API Responses |
background |
true |
Passe en mode arrière-plan, renvoie d’abord un ID de réponse |
background_options.completion_window |
2h ou 8h |
Par défaut « soonest », aucune remise |
service_tier |
default (Standard) |
auto ne remplit la condition que s’il finit par passer en Standard |
stream |
omis ou false |
La sortie en streaming ne remplit pas les conditions de la remise |
Côté quota, les fenêtres 2h, 8h et Batch partagent le quota de file d’attente Batch/Background, décompté à l’entrée en file selon les tokens d’entrée ; « soonest » utilise les limites habituelles de nombre de requêtes et de tokens. Sur le cache, il existe une limite : les requêtes Standard classiques ne peuvent pas réutiliser le cache d’invite créé par ces deux fenêtres de remise. À noter également : la fiche du modèle précise que les requêtes dont reasoning.effort vaut none seront rejetées.
Voici un exemple minimal. background_options n’est pas forcément présent dans les définitions de types du SDK, on le passe donc via extra_body :
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d'APIYI
)

resp = client.responses.create(
    model="gpt-6.2-astra",
    input="请汇总以下 50 张支持工单的共性问题……",
    background=True,
    service_tier="default",          # Passe par Standard, remplit les conditions de la remise
    extra_body={"background_options": {"completion_window": "2h"}},
)
print(resp.id, resp.status)  # Enregistre l'ID de réponse, à récupérer plus tard
Une fois l’ID de réponse obtenu, on peut lire l’état via un webhook ou par interrogation répétée (polling). Lorsque l’état est queued ou in_progress, on continue à interroger avec le même ID ; les erreurs de capacité admissibles sont réessayées automatiquement par l’API, l’application n’a pas à renvoyer la requête elle-même.
Voir l’exemple complet d’interrogation et de requête de suivi
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Accès unifié via APIYI
)

WINDOW = "8h"

def submit(input_items, previous_id=None):
    """Soumet une requête de remise en arrière-plan.
    Pour l'emplacement exact du paramètre continuation_id, référez-vous au guide OpenAI Background mode."""
    return client.responses.create(
        model="gpt-6.2-astra",
        input=input_items,
        background=True,
        service_tier="default",
        previous_response_id=previous_id,
        extra_body={
            "background_options": {"completion_window": WINDOW},
            # "continuation_id": "audit-2026-11-19-batch-01",  # Conserver la même valeur pour tout le workflow
        },
    )

def wait(response_id, interval=60):
    """Interroge jusqu'à la fin ; en état queued / in_progress, continue avec le même ID."""
    while True:
        r = client.responses.retrieve(response_id)
        if r.status not in ("queued", "in_progress"):
            return r
        time.sleep(interval)

first = wait(submit("审核合同,需要时调用 read_file 工具读取附件").id)

# Si la réponse contient un appel d'outil géré par l'application : l'application exécute l'outil,
# puis lance une requête de suivi avec le même projet, modèle, niveau de traitement,
# fenêtre et continuation_id ; la poursuite de l'étape peut donner droit à une mise en file prioritaire
for item in first.output:
    if item.type == "function_call":
        tool_result = "……read_file 的实际返回内容……"
        follow = submit(
            [{"type": "function_call_output",
              "call_id": item.call_id,
              "output": tool_result}],
            previous_id=first.id,
        )
        print(wait(follow.id).output_text)
Dans les workflows à plusieurs étapes, les requêtes de continuation doivent réutiliser le même projet, le même modèle, le même niveau de traitement, la même fenêtre et le même continuation_id pour bénéficier d’un accès prioritaire à la file d’attente. Les requêtes de suivi éligibles sont ensuite facturées individuellement au tarif remisé correspondant.
🚀 Conseil d’intégration : la fenêtre d’achèvement en arrière-plan est actuellement une capacité en bêta publique de l’API OpenAI Responses. Lorsque vous effectuez des appels via une plateforme d’agrégation comme APIYI apiyi.com, mieux vaut commencer par vérifier, avec un quota de test gratuit, que les paramètres
backgroundetcompletion_windowsont bien transmis dans leur intégralité et que la facturation applique bien la remise, avant de migrer vos tâches de production.
Analyse et évaluation : comment bien tirer parti de la facturation des tâches en arrière-plan de GPT-6.2 Astra
Les remises arrière-plan et les paliers d’accélération de GPT-6.2 Astra ne se cumulent pas
Les conditions de remise exigent que service_tier soit default, ou que auto aboutisse finalement sur Standard. On peut en déduire que Fast et Ultrafast ne peuvent pas bénéficier en même temps des remises 2h et 8h. L’arbitrage est limpide : le palier d’accélération échange un surcoût contre une latence plus courte, tandis que la fenêtre arrière-plan échange une attente plus longue contre un prix plus bas. Les deux vont dans des directions opposées.
Un détail qu’on oublie facilement : soonest est aussi un mode arrière-plan, mais son prix suit le palier de traitement. Avec soonest combiné à Fast, on paie toujours le tarif Fast, seule l’interaction devient asynchrone. Le rôle de soonest est de rendre la main à l’utilisateur au niveau de l’interface ; en soi, ça ne fait pas économiser.
Pour les tâches multi-étapes, budgéter le temps sur « l’ensemble du workflow »
L’objectif de fenêtre ne contraint qu’une seule réponse, pas le workflow dans son entier. Une tâche d’audit qui demande trois tours d’appels d’outils peut théoriquement passer par trois ordonnancements de fenêtre, plus le temps que l’application consacre elle-même à l’exécution des outils. Si le métier promet « un résultat avant 9 h du matin », avec une fenêtre de 8h pour traiter une tâche de nuit, il faut prévoir une marge pour les étapes de continuation au moment de la soumission — pas question de soumettre pile à la limite des 8 heures.
C’est là que continuation_id prend tout son sens. Il ne prolonge ni ne fusionne les fenêtres, mais il permet aux étapes de continuation d’obtenir une priorité dans la file d’attente, ce qui raccourcit l’attente en fin de processus multi-étapes. Côté ingénierie, je conseille de faire correspondre continuation_id un à un avec l’ID de la tâche métier, ce qui facilite aussi le diagnostic dans les logs et l’imputation des coûts.
8h vs Batch : un écart de prix de 10 points de pourcentage, des cas d’usage différents
Pour l’usage de l’exemple, 8h revient à 0,72 $ et Batch à 0,60 $, soit seulement 0,12 $ d’écart. Batch est moins cher, mais il exige que les requêtes puissent être assemblées à l’avance dans un fichier JSONL, qu’elles soient indépendantes les unes des autres et que vous acceptiez un délai de livraison de 24 heures. 8h, en revanche, autorise une requête à poursuivre son raisonnement à partir du résultat d’un outil.
Le critère de choix n’est donc pas le prix, mais la structure de la tâche :
- Les requêtes dépendent les unes des autres (l’étape suivante doit lire le résultat de la précédente) : choisissez 8h ou 2h
- Les requêtes sont indépendantes et peuvent être listées en une seule fois : choisissez Batch
La remise de 50 % de Batch et la remise liée à la fenêtre en arrière-plan sont deux voies de facturation distinctes ; elles ne se cumulent pas.
Les coûts cachés liés au cache et aux quotas de file d’attente
Le cache d’invites créé par une fenêtre de remise ne peut pas être réutilisé par les requêtes Standard classiques. Si la même longue invite système sert à la fois aux questions-réponses en temps réel et au traitement par lots en arrière-plan, chaque côté construit son propre cache, et le coût d’écriture du cache peut être payé deux fois. Par ailleurs, les entrées trouvées dans le cache sont déjà bon marché : 0,40 $ pour Standard, 0,24 $ pour 8h. Pour les charges de travail avec un taux de réussite du cache élevé, la remise en arrière-plan représentera un pourcentage d’économie plus faible sur la facture totale que pour les tâches gourmandes en sortie.
Le partage des quotas de file d’attente doit aussi être anticipé. 2h, 8h et Batch partagent le quota Batch/Background, et les requêtes sont comptées dans la file selon les tokens d’entrée. Si, la nuit, vous soumettez en même temps un gros lot de tâches Batch et un flux de validation 8h, les deux vont se disputer le même quota.
💡 Conseil coût : avant de choisir un palier, vous pouvez estimer le coût de chaque palier à partir de la distribution réelle des tokens d’une invite (proportion d’entrées normales, d’entrées trouvées dans le cache et de sorties). Grâce à l’interface unifiée d’APIYI apiyi.com, le même code, en ne changeant que les paramètres, permet de comparer les factures du chemin temps réel et du chemin asynchrone.
Intégrer le niveau de service GPT-6.2 Astra dans des charges de travail réelles
Le tableau ci-dessous illustre des charges de travail. Les critères de décision sont, dans l’ordre : le temps d’attente acceptable, la dépendance à des résultats intermédiaires et la présence éventuelle de frais d’outils.
| Charge de travail | Mode de soumission recommandé | Justification |
|---|---|---|
| Questions-réponses interactives immédiates, analyses avec des personnes en attente | Commencer par Standard ; envisager Fast / Ultrafast après avoir vérifié la latence et le coût | Des utilisateurs attendent : payer plus pour gagner en vitesse doit être étayé par des données |
| Interface asynchrone, où l’on préfère rendre la main avant d’afficher le résultat | soonest | Rend la main ; le prix reste celui du niveau de traitement utilisé |
| Synthèse de tickets de support à terminer avant l’après-midi | Arrière-plan 2h | Livraison en quelques heures, avec une baisse de 30 % du coût des tokens du modèle |
| Audit multi-étapes pouvant être exécuté pendant la nuit et nécessitant des appels d’outils | Arrière-plan 8h + continuation_id | Baisse de 40 %, avec du temps prévu pour l’exécution des outils et les étapes de continuation |
| Tâches de classification indépendantes pouvant être préparées à l’avance | Batch (JSONL) | Indépendantes les unes des autres et compatibles avec une fenêtre de 24 heures, avec une baisse de 50 % |
À noter : dès qu’une tâche utilise Web Search ou un conteneur Code Interpreter, ces frais ne bénéficient pas de la remise sur les tokens du modèle. Plus la part des frais d’outils est élevée, plus l’économie globale offerte par la fenêtre d’arrière-plan est faible.
🎯 Conseil de sélection : commencez par exécuter un même lot d’échantillons avec Standard, 2h et 8h sur APIYI apiyi.com, puis notez les temps d’achèvement réels et la facture avant de décider du niveau par défaut pour chaque type de tâche. Vous obtiendrez ainsi une estimation plus proche du coût réel qu’en vous contentant de lire le tableau des prix unitaires.
Changements à suivre de près
La fenêtre d’achèvement en arrière-plan reste en bêta publique : les noms de paramètres, les conditions d’éligibilité et les pourcentages de remise peuvent encore évoluer avant la publication officielle. Au moment du lancement, il conviendra de se référer au guide officiel d’OpenAI. Deux autres échéances méritent aussi d’être notées : le tarif promotionnel Ultrafast est valable jusqu’au 28 février 2027 (heure du Pacifique) ; à partir du 1er mars, le taux passera de 3x à 6x. Les produits qui dépendent d’Ultrafast à long terme devront anticiper leur budget. GPT-6.2 Astra et Sol ne disposent actuellement d’aucune offre Flex ; si elle est lancée par la suite, les choix pour les tâches asynchrones se multiplieront.
Pour les équipes qui planifient déjà les capacités asynchrones d’Astra, vous pouvez d’abord utiliser des crédits de test sur APIYI apiyi.com pour valider le mode background et la logique de polling, inscrire les délais limites et les dépendances des tâches dans le document d’exigences, puis discuter des niveaux de service.
Le Lunyu · Zilu dit : « Qui veut aller trop vite n’arrive pas à destination. » Sur la grille tarifaire de GPT-6.2 Astra, cette phrase prend justement un prix : accepter d’attendre quelques heures de plus permet de payer 30 à 40 % de moins en frais de modèle.
📚 Références
-
Annonce de publication OpenAI : Introducing GPT-6.2 Astra and Sol (2026-11-17)
- Lien :
openai.com/index/introducing-gpt-6-2-astra-sol/ - Description : Positionnement du modèle et explications sur l’ajustement des tarifs
- Lien :
-
Fiche modèle GPT-6.2 Astra : Spécifications, tarifs en contexte court et en contexte long
- Lien :
developers.openai.com/api/docs/models/gpt-6.2-astra - Description : Longueur du contexte, règles de tarification du contexte long de 272K
- Lien :
-
Journal des mises à jour de l’API OpenAI : Entrées du 2026-11-17 sur la publication du modèle et la fenêtre background
- Lien :
developers.openai.com/api/docs/changelog - Description : Bêta publique de la fenêtre d’achèvement en arrière-plan et pourcentages de remise
- Lien :
-
Grille tarifaire de l’API OpenAI : Prix unitaires par niveau de traitement
- Lien :
developers.openai.com/api/docs/pricing - Description : Tarifs Standard, Fast, Ultrafast, Batch
- Lien :
-
Guide Background mode : Mode background, fenêtre d’achèvement et requêtes de suivi
- Lien :
developers.openai.com/api/docs/guides/background - Description : Conditions de remise, continuation_id, quotas de file d’attente et limites de cache
- Lien :
-
Guide Batch API / Fast / Ultrafast
- Lien :
developers.openai.com/api/docs/guides/batch,developers.openai.com/api/docs/guides/fast-mode,developers.openai.com/api/docs/guides/ultrafast-mode - Description : Conditions d’application de chaque mode de soumission
- Lien :
Auteur : Équipe technique APIYI
Échanges techniques : N’hésitez pas à nous contacter via la page d’accueil de APIYI apiyi.com ; davantage de ressources d’intégration sont disponibles sur le centre de documentation docs.apiyi.com