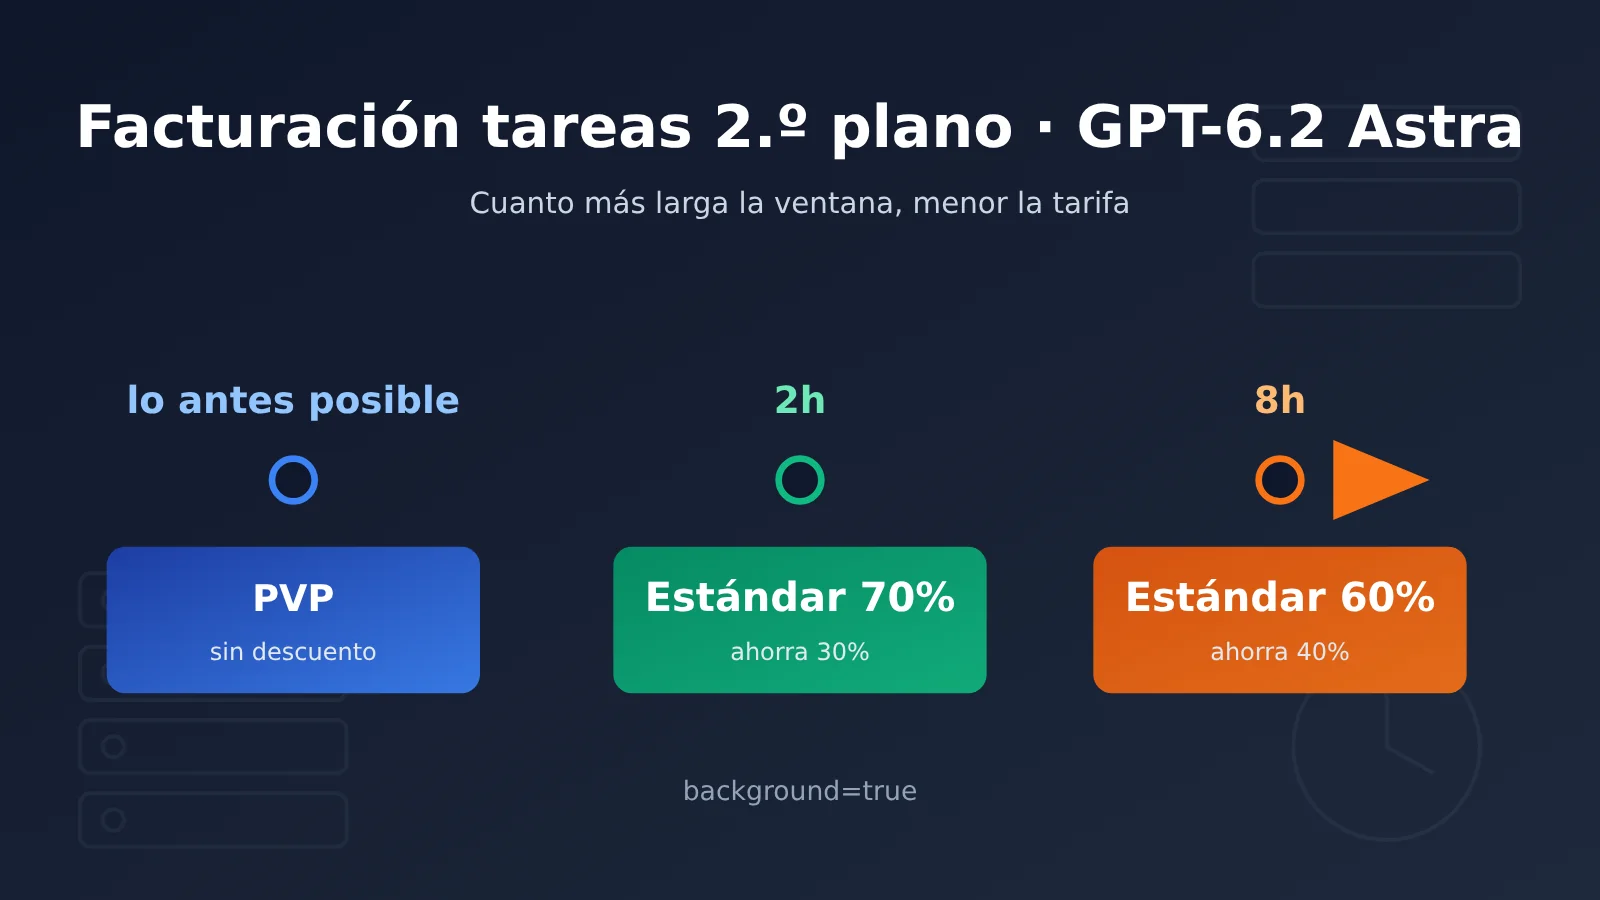
Las reglas de facturación de tareas en segundo plano de GPT-6.2 Astra se pueden resumir en una frase: si puedes esperar, sale más barato. A partir del 17 de noviembre de 2026, la ventana de finalización en segundo plano de Responses API entra en beta pública. La ventana predeterminada, soonest, se factura al precio original del nivel de procesamiento utilizado; las solicitudes elegibles que eligen la ventana de 2h se facturan al 70% de la tarifa de tokens del modelo Standard, y las de la ventana de 8h al 60%, es decir, un 30% y un 40% más baratas, respectivamente.
Qué nivel elegir depende de dos preguntas: cuándo necesitas el resultado como muy tarde y si las solicitudes dependen del resultado intermedio del paso anterior. Responder primero estas dos preguntas y luego estimar el coste según el consumo es más fiable que comparar directamente los precios unitarios.
¿Qué aprenderás al leer este artículo?
- La definición, el punto de inicio del conteo y la base de facturación de las tres ventanas de finalización: soonest, 2h y 8h.
- El coste concreto, con un mismo consumo (100 000 tokens de entrada + 10 000 tokens de salida), en 7 modos.
- Las condiciones de parámetros que debe cumplir una solicitud para obtener el descuento, junto con los límites de la cuota de cola y de la reutilización de caché.
- Qué forma de envío conviene para preguntas y respuestas interactivas, resúmenes de tickets, auditorías nocturnas y tareas de clasificación independientes.
Índice: primero, una tabla de conceptos y un resumen rápido de implicaciones te ayudarán a unificar la terminología. La sección «Hechos objetivos» explica en orden las reglas de las ventanas de finalización, los precios de cada nivel, las condiciones de descuento y el tratamiento de pasos posteriores en flujos de trabajo de varios pasos. La sección «Análisis y valoración» aborda si los descuentos son acumulables, el presupuesto de tiempo de las tareas de varios pasos, los compromisos que conllevan la caché y la cuota de cola, y ofrece recomendaciones para elegir el nivel según la carga de trabajo.
GPT-6.2 Astra: facturación de tareas en segundo plano — lo que debes saber
| Concepto | Explicación breve |
|---|---|
| Standard | Nivel de procesamiento estándar de OpenAI API; los descuentos de las ventanas en segundo plano de 2 h y 8 h se calculan sobre la tarifa de modelo de este nivel. |
| Fast | Nivel acelerado actual de Astra; la tarifa de tokens del modelo es 2 veces la de Standard. |
| Ultrafast | Nivel de procesamiento más rápido; durante la promoción es 3 veces Standard y, después, el precio de lista será 6 veces. |
| Modo en segundo plano | La solicitud primero devuelve un ID de respuesta; la aplicación consulta más tarde el estado y recupera el resultado. |
| Ventana de finalización | Objetivo de finalización usado para la programación una vez aceptada la respuesta en segundo plano; incluye soonest, 2 h y 8 h. |
| soonest | Ventana predeterminada de las solicitudes en segundo plano; se ejecuta lo antes posible y mantiene la tarifa de modelo del nivel de procesamiento utilizado. |
| Batch API | Coloca solicitudes independientes en un archivo JSONL y las ejecuta de forma asíncrona como un único trabajo. |
| continuation_id | Identificador que la aplicación asigna al mismo flujo de trabajo en segundo plano, usado para vincular solicitudes de seguimiento válidas. |
| Tarifa de tokens del modelo | Precio unitario correspondiente a cada métrica de uso, como entrada normal, entrada con acierto de caché y salida. |
Resumen del impacto de facturación de tareas en segundo plano de GPT-6.2 Astra
- Desarrolladores de API: las tareas asíncronas ahora tienen dos opciones de descuento entre las llamadas en tiempo real y Batch, pero es necesario migrar al modo en segundo plano y gestionar sondeo o webhooks.
- Responsables de producto: deben definir en los requisitos «cuándo a más tardar debe estar disponible el resultado». Para funcionalidades que toleran entregas en 2 u 8 horas, el costo de tokens del modelo puede bajar 30 % o 40 %, respectivamente.
- Responsables de costos y operaciones: 2 h, 8 h y Batch comparten una misma cuota de cola; los trabajos Batch de gran volumen y las tareas con descuento en segundo plano deben planificarse de forma conjunta, sin estimar la capacidad por separado.
Hechos objetivos: reglas de facturación de las tareas en segundo plano de GPT-6.2 Astra
¿Cuáles son las tres ventanas de finalización de las tareas en segundo plano de GPT-6.2 Astra?
OpenAI lanzó GPT-6.2 Astra y GPT-6.2 Sol el 17 de noviembre de 2026. Astra está orientado al razonamiento complejo, la programación y el trabajo profesional, y su ID de modelo en la API es gpt-6.2-astra. Ese mismo día, el registro de cambios de OpenAI API documentó que las ventanas de finalización en segundo plano de Responses API entraban en beta pública.
Las solicitudes asíncronas de Astra deben establecerse con background=true, y las ventanas se dividen en tres:
- soonest (predeterminado): se ejecuta lo antes posible; los tokens del modelo se facturan según el nivel de procesamiento realmente utilizado, sin ningún descuento.
- 2h: las solicitudes elegibles se facturan al 70% de la tarifa de tokens del modelo Standard.
- 8h: las solicitudes elegibles se facturan al 60% de la tarifa de tokens del modelo Standard.
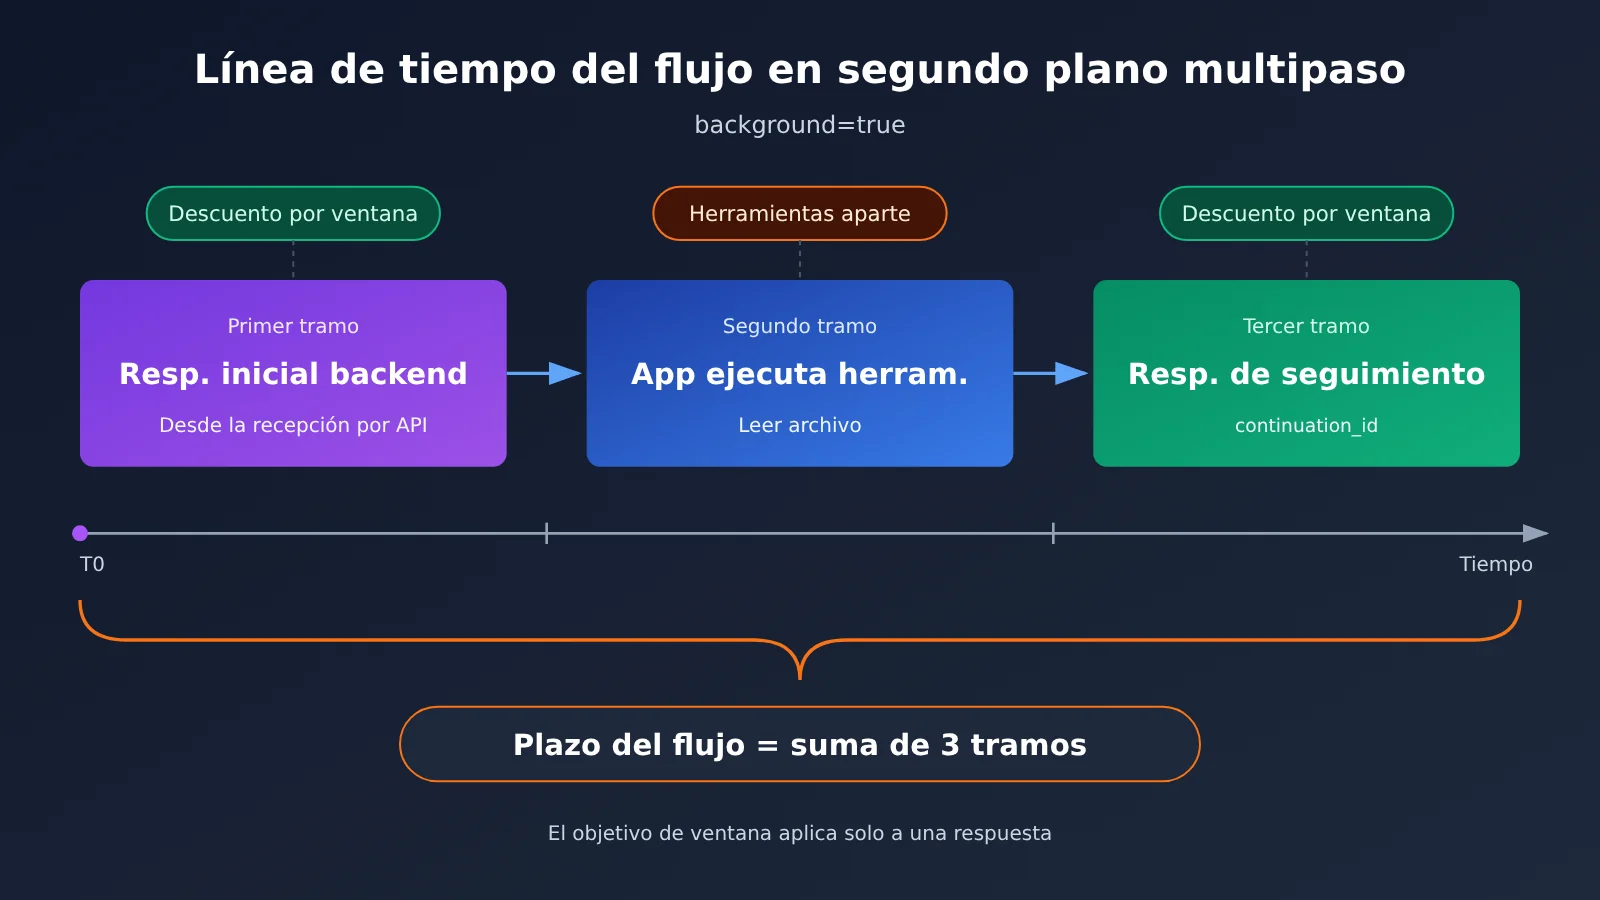
El punto de partida del conteo es el momento en que la API acepta la solicitud inicial, y el objetivo de la ventana corresponde a esa única respuesta. Si la tarea necesita que la aplicación ejecute herramientas a mitad del proceso y lance otra respuesta, ese tiempo de ejecución y de continuación debe calcularse aparte, dentro del límite de tiempo del flujo de trabajo completo.
Tomemos como ejemplo «primero consultar el archivo y luego continuar la revisión»: la primera respuesta se completa dentro de la ventana y devuelve una llamada a herramienta que la aplicación debe ejecutar. Tras leer el archivo, la aplicación envía el resultado como solicitud de seguimiento y el modelo retoma la revisión. El tiempo total del proceso completo equivale a la suma de tres tramos —la primera respuesta, la ejecución de la herramienta y la respuesta de continuación—, y no a una sola ventana.
¿Cuánto cuesta una misma solicitud en cada nivel de GPT-6.2 Astra?
La siguiente tabla muestra las tarifas de contexto corto de GPT-6.2 Astra, en dólares por millón de tokens. Las filas de 2 h y 8 h se calculan a partir de los porcentajes de descuento oficiales; las fechas de precios de Ultrafast se rigen por la hora del Pacífico de EE. UU.
| Modo | Relativo a Standard | Entrada normal | Entrada con acierto de caché | Salida |
|---|---|---|---|---|
| Standard | 1× | $8.00 | $0.40 | $40.00 |
| Fast | 2× | $16.00 | $0.80 | $80.00 |
| Ultrafast (hasta 2027-02-28) | 3× | $24.00 | $1.20 | $120.00 |
| Ultrafast (desde 2027-03-01) | 6× | $48.00 | $2.40 | $240.00 |
| En segundo plano 2 h | 0.70× | $5.60 | $0.28 | $28.00 |
| En segundo plano 8 h | 0.60× | $4.80 | $0.24 | $24.00 |
| Batch | 0.50× | $4.00 | $0.20 | $20.00 |
Usamos un consumo fijo como referencia: 100,000 tokens de entrada normal + 10,000 tokens de salida facturables. Para Standard, el cálculo es 0.1 × $8 + 0.01 × $40 = $1.20; las demás filas se calculan de la misma forma:
| Modo | Costo de tokens del modelo por solicitud | Diferencia frente a Standard |
|---|---|---|
| Ultrafast a precio de lista | $7.20 | +$6.00 |
| Ultrafast a precio promocional | $3.60 | +$2.40 |
| Fast | $2.40 | +$1.20 |
| Standard | $1.20 | Referencia |
| En segundo plano 2 h | $0.84 | −$0.36 |
| En segundo plano 8 h | $0.72 | −$0.48 |
| Batch | $0.60 | −$0.60 |
Este ejemplo solo calcula tokens del modelo. Las llamadas a Web Search, los contenedores Shell / Code Interpreter y otros costos se facturan por separado según cada concepto; la escritura en caché también se factura aparte.
Además, la ficha del modelo indica que, cuando la entrada supera 272K tokens, toda la solicitud pasa a la tarifa de contexto largo: los precios de entrada y caché se multiplican por 2, el de salida por 1.5, y luego se aplica el nivel seleccionado o el descuento aplicable. Con esta regla, para una solicitud de contexto largo en la ventana de 8 h, la entrada normal queda en $16 × 0.6 = $9.6 y la salida en $60 × 0.6 = $36 (por millón de tokens).
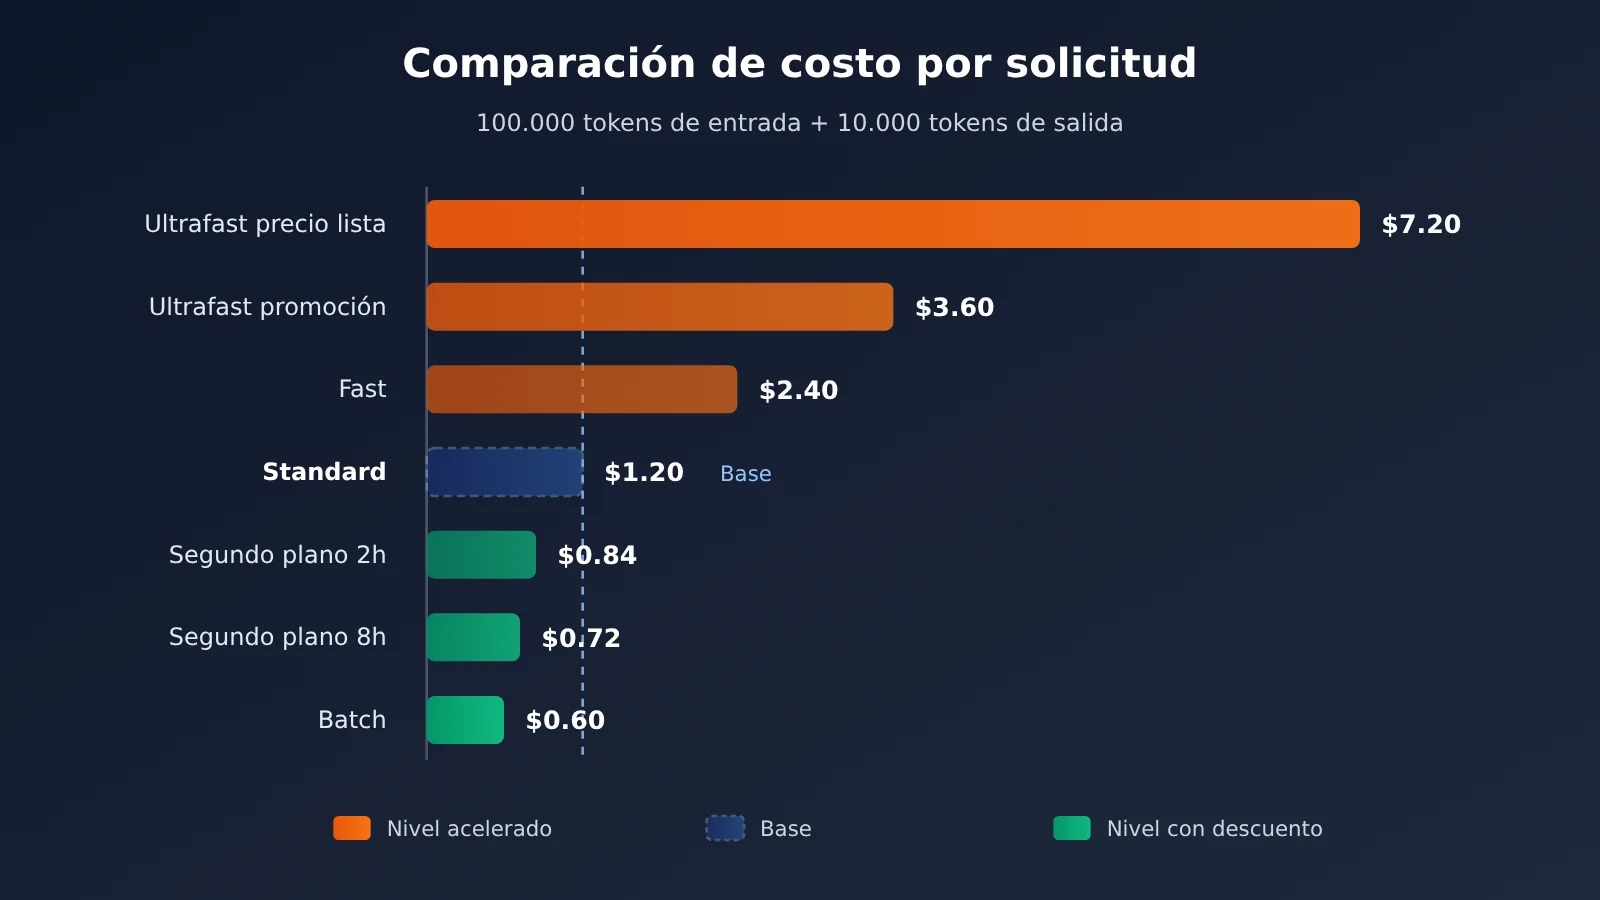
Las tarifas del gráfico anterior se calculan a partir de la lista de precios oficial de OpenAI y los porcentajes de descuento. Si llamas a través de APIYI apiyi.com, la facturación real se rige por la página de precios de la plataforma. Te recomendamos verificar primero la factura con poco tráfico y luego pasar a producción.
Cómo hacer que las solicitudes a GPT-6.2 Astra cumplan con el descuento de facturación en modo background
Los descuentos no se aplican automáticamente. Deben cumplirse todas las condiciones siguientes:
| Parámetro / condición | Valor válido | Descripción |
|---|---|---|
| Endpoint | /v1/responses |
La ventana de finalización en background se rige por la Responses API |
background |
true |
Entra en modo background; primero devuelve un ID de respuesta |
background_options.completion_window |
2h o 8h |
Por defecto soonest, sin descuento |
service_tier |
default (Standard) |
auto solo cumple la condición si finalmente usa Standard |
stream |
omitido o false |
La salida en streaming no cumple las condiciones del descuento |
En cuanto a cuotas, 2h, 8h y Batch comparten la cuota de cola de Batch/Background, y al entrar en la cola se contabilizan los tokens de entrada; soonest usa los límites habituales de número de solicitudes y de tokens. Hay una limitación en cuanto a la caché: las solicitudes normales de Standard no pueden reutilizar la caché de indicaciones creada por estas dos ventanas de descuento. Además, la ficha del modelo indica que se rechazarán las solicitudes con reasoning.effort establecido en none.
A continuación, un ejemplo mínimo. Es posible que background_options aún no esté incluido en las definiciones de tipos del SDK, así que se pasa mediante extra_body:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

resp = client.responses.create(
    model="gpt-6.2-astra",
    input="请汇总以下 50 张支持工单的共性问题……",
    background=True,
    service_tier="default",          # Usar Standard, cumple las condiciones del descuento
    extra_body={"background_options": {"completion_window": "2h"}},
)
print(resp.id, resp.status)  # Guarda el response ID, recupéralo más tarde
Una vez obtenido el response ID, puedes leer el estado mediante webhook o sondeo. Cuando el estado sea queued o in_progress, sigue consultando con el mismo ID; la API reintentará automáticamente los errores de capacidad que cumplan los requisitos, sin que la aplicación tenga que reenviar.
Ver el ejemplo completo de sondeo y solicitudes de seguimiento
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Acceso unificado a través de APIYI
)

WINDOW = "8h"

def submit(input_items, previous_id=None):
    """Envía una solicitud de descuento en background.
    Para saber exactamente dónde pasar continuation_id, consulta la guía de OpenAI Background mode."""
    return client.responses.create(
        model="gpt-6.2-astra",
        input=input_items,
        background=True,
        service_tier="default",
        previous_response_id=previous_id,
        extra_body={
            "background_options": {"completion_window": WINDOW},
            # "continuation_id": "audit-2026-11-19-batch-01",  # Mantener la coherencia en el mismo flujo de trabajo
        },
    )

def wait(response_id, interval=60):
    """Sondea hasta que termine; cuando esté en queued / in_progress, sigue consultando con el mismo ID."""
    while True:
        r = client.responses.retrieve(response_id)
        if r.status not in ("queued", "in_progress"):
            return r
        time.sleep(interval)

first = wait(submit("审核合同,需要时调用 read_file 工具读取附件").id)

# Si devuelve una llamada a herramienta que gestiona la aplicación: la aplicación ejecuta la herramienta y luego envía una solicitud de seguimiento con el mismo proyecto, modelo, nivel de servicio,
# ventana y continuation_id; los pasos de continuación pueden optar a prioridad en la cola
for item in first.output:
    if item.type == "function_call":
        tool_result = "……read_file 的实际返回内容……"
        follow = submit(
            [{"type": "function_call_output",
              "call_id": item.call_id,
              "output": tool_result}],
            previous_id=first.id,
        )
        print(wait(follow.id).output_text)
En flujos de trabajo de varios pasos, las solicitudes de continuación deben usar el mismo proyecto, modelo, nivel de servicio, ventana y continuation_id para poder optar a prioridad en la cola. Las solicitudes de seguimiento que cumplan los requisitos se facturarán por separado con el descuento correspondiente.
🚀 Recomendación de integración: la ventana de finalización en segundo plano es hoy una funcionalidad en beta pública de OpenAI Responses API. Si la invocas a través de plataformas agregadoras como APIYI apiyi.com, conviene usar primero el crédito de prueba gratuito para verificar que los parámetros
backgroundycompletion_windowse transmitan completos y sin recortes, y que la facturación se liquide aplicando el descuento; solo después migra las tareas de producción.
Análisis y criterios: cómo sacar partido a la facturación de tareas en segundo plano de GPT-6.2 Astra
El descuento en segundo plano de GPT-6.2 Astra y el modo acelerado no pueden combinarse
Las condiciones del descuento exigen que service_tier sea default, o que auto acabe cayendo en Standard. De ahí se deduce que Fast y Ultrafast no pueden disfrutar al mismo tiempo de los descuentos de 2h y 8h. La disyuntiva es clara: el modo acelerado cambia más gasto por una latencia menor, mientras que la ventana en segundo plano cambia más espera por un precio más bajo. Son dos direcciones opuestas.
Hay un detalle que se suele pasar por alto: aunque soonest también es un modo en segundo plano, su precio sigue el del nivel de procesamiento. Si usas soonest junto con Fast, sigues pagando el precio de Fast; lo único que cambia es que la interacción pasa a ser asíncrona. Lo que hace soonest es devolverle el control al usuario en la interfaz primero; por sí solo no ahorra dinero.
Las tareas de varios pasos deben presupuestar el tiempo según «todo el flujo de trabajo»
El objetivo de la ventana solo limita una única respuesta, no cubre todo el flujo de trabajo. Una tarea de revisión que necesita tres rondas de llamadas a herramientas podría, en teoría, pasar por tres programaciones de ventana, más el tiempo que la propia aplicación dedica a ejecutar las herramientas. Si el negocio promete «resultados antes de las 9 de la mañana», al usar una ventana de 8h para tareas nocturnas hay que dejar un margen para los pasos de continuación en la hora de envío; no se puede enviar justo en el límite de las 8 horas.
Aquí está el valor de continuation_id. No alarga ni fusiona las ventanas, pero permite que los pasos de continuación obtengan prioridad en la cola, reduciendo la espera final de los flujos de varios pasos. A nivel de ingeniería, conviene que continuation_id se corresponda uno a uno con el ID de la tarea de negocio; al mismo tiempo, esto facilita la revisión de logs y la asignación de costos.
8h y Batch: 10 puntos porcentuales de diferencia, escenarios de uso distintos
Con el uso de ejemplo, 8h cuesta $0.72 y Batch cuesta $0.60, así que la diferencia es de solo $0.12. Batch es más barato, pero exige que las solicitudes se puedan preparar de antemano como JSONL, que sean independientes entre sí y que se pueda aceptar una ventana de entrega de 24 horas. 8h, en cambio, permite que las solicitudes sigan razonando sobre la base de los resultados de las herramientas.
Por eso, el criterio no es cuál es más barato, sino la estructura de la tarea:
- Hay dependencias entre las solicitudes (el siguiente paso necesita ver el resultado del anterior): elige 8h o 2h.
- Las solicitudes son independientes entre sí y se pueden enumerar de una vez: elige Batch.
El descuento del 50 % de Batch y el descuento por ventana en segundo plano son dos vías de facturación independientes; no se acumulan.
Costos ocultos de la caché y la cuota de cola
La caché de indicaciones creada por la ventana con descuento no puede reutilizarse en solicitudes normales de Standard. Si una misma indicación de sistema larga se usa tanto para preguntas y respuestas en tiempo real como para procesamiento por lotes en segundo plano, cada lado creará su propia caché, y el costo de escritura de la caché podría producirse dos veces. Además, la entrada con acierto de caché ya es barata por sí misma: $0.40 en Standard y $0.24 en 8h. En cargas con una alta tasa de aciertos de caché, el ahorro del descuento en segundo plano sobre la factura total será menor que en tareas intensivas en salida.
También hay que planificar con antelación el uso compartido de la cuota de cola. 2h, 8h y Batch comparten la cuota de Batch/Background y se encolan contabilizando los tokens de entrada. Si por la noche se envían a la vez un gran lote de trabajos Batch y un flujo de revisión de 8h, ambos competirán por la misma cuota.
💡 Recomendación de costos: antes de decidir la modalidad, puedes estimar el costo de cada una usando la distribución real de tokens de una indicación (la proporción de entrada normal, entrada con acierto de caché y salida). Con la interfaz unificada de APIYI apiyi.com, el mismo código solo necesita cambiar parámetros para comparar la diferencia de facturación entre la ruta en tiempo real y la ruta asíncrona.
Incorporar los niveles de servicio de GPT-6.2 Astra en cargas de trabajo reales
A continuación se presentan cargas de trabajo ilustrativas. Los criterios de decisión, en orden, son: cuánto se puede esperar, si se depende de resultados intermedios y si hay costos de herramientas.
| Carga de trabajo | Método de envío recomendado | Justificación |
|---|---|---|
| Preguntas y respuestas interactivas inmediatas, análisis con alguien esperando | Empezar con Standard; considerar Fast / Ultrafast después de validar latencia y costo | El usuario está esperando; pagar más por velocidad requiere respaldo en datos |
| Interfaz asíncrona que prefiere devolver primero y mostrar los resultados después | soonest | Devuelve el control; el precio se mantiene según el nivel de procesamiento utilizado |
| Resumen de tickets de soporte para completar antes de la tarde | Segundo plano 2h | Entrega en pocas horas; el costo de tokens del modelo se reduce un 30% |
| Revisión de varios pasos que permite dejarse de un día para otro y requiere invocar herramientas | Segundo plano 8h + continuation_id | Reduce un 40% y reserva tiempo para la ejecución de herramientas y los pasos de continuación |
| Tareas de clasificación independientes que se pueden preparar con antelación | Batch (JSONL) | Son independientes entre sí y admiten una ventana de 24 horas; reduce un 50% |
Hay que tener en cuenta que, cuando una tarea usa Web Search o un contenedor de Code Interpreter, esa parte del costo no recibe el descuento de tokens del modelo. Cuanto mayor sea la proporción de costos de herramientas, menor será el ahorro general que ofrece la ventana en segundo plano.
🎯 Recomendación para elegir el nivel: primero ejecuta con el mismo conjunto de muestras en APIYI apiyi.com usando Standard, 2h y 8h por separado, registra el tiempo real de finalización y la factura, y luego decide el nivel predeterminado para cada tipo de tarea. Esto se acerca más al costo real que mirar solo la tabla de precios unitarios.
Cambios que merecen seguimiento
La ventana de finalización en segundo plano sigue en beta pública: los nombres de los parámetros, las condiciones de elegibilidad y el porcentaje de descuento pueden cambiar antes del lanzamiento oficial, así que hasta que salga conviene guiarse por la guía oficial de OpenAI. Hay otras dos fechas que vale la pena anotar: el precio promocional de Ultrafast estará vigente hasta el 28 de febrero de 2027 (hora del Pacífico), y a partir del 1 de marzo la tarifa sube de 3x a 6x, por lo que los productos que dependen de Ultrafast a largo plazo tendrán que revisar su presupuesto con antelación. GPT-6.2 Astra y Sol no tienen por ahora un nivel Flex; si se añade más adelante, habrá más opciones para las tareas asíncronas.
Si tu equipo está planeando capacidades asíncronas para Astra, lo primero es probar con créditos de prueba en APIYI apiyi.com el modo background y la lógica de sondeo (polling), dejar por escrito las fechas límite y las dependencias entre tareas en el documento de requisitos, y solo después discutir qué nivel elegir.
Las Analectas (Lunyu, libro XIII, «Zilu») dicen: «Las prisas no llevan a ninguna parte.» En la lista de precios de GPT-6.2 Astra, esa frase tiene un precio literal: estar dispuesto a esperar unas horas más se traduce en pagar entre tres y cuatro décimas menos por el modelo.
📚 Referencias
-
Anuncio de OpenAI: Introducing GPT-6.2 Astra and Sol (17-11-2026)
- Enlace:
openai.com/index/introducing-gpt-6-2-astra-sol/ - Descripción: posicionamiento del modelo y ajustes de precio
- Enlace:
-
Ficha del modelo GPT-6.2 Astra: especificaciones y tarifas de contexto corto y contexto largo
- Enlace:
developers.openai.com/api/docs/models/gpt-6.2-astra - Descripción: longitud de contexto y reglas de facturación del contexto largo de 272K
- Enlace:
-
Registro de cambios de la API de OpenAI: lanzamiento del modelo y entrada de la ventana de finalización en segundo plano del 17-11-2026
- Enlace:
developers.openai.com/api/docs/changelog - Descripción: beta pública de la ventana de finalización en segundo plano y porcentaje de descuento
- Enlace:
-
Lista de precios de la API de OpenAI: tarifa unitaria por nivel de procesamiento
- Enlace:
developers.openai.com/api/docs/pricing - Descripción: tarifas de Standard, Fast, Ultrafast y Batch
- Enlace:
-
Guía de Background mode: modo background, ventana de finalización y solicitudes de continuación
- Enlace:
developers.openai.com/api/docs/guides/background - Descripción: condiciones de descuento,
continuation_id, cuota de cola y límites de caché
- Enlace:
-
Guías de Batch API / Fast / Ultrafast
- Enlaces:
developers.openai.com/api/docs/guides/batch,developers.openai.com/api/docs/guides/fast-mode,developers.openai.com/api/docs/guides/ultrafast-mode - Descripción: cuándo aplica cada forma de envío
- Enlaces:
Autor: Equipo técnico de APIYI
Contacto técnico: puedes escribirnos desde la página principal de APIYI apiyi.com; encontrarás más material de integración en el centro de documentación docs.apiyi.com