Nota do autor: na primeira avaliação do GDPx, nenhum modelo foi aprovado integralmente nas áreas de finanças e direito sob o critério binário rigoroso de aceitação. Este artigo examina os erros específicos de dois casos públicos e mostra por que “saber fazer contas e redigir contratos” não é o mesmo que “entregar um resultado que atenda aos requisitos”.
Em 2 de novembro de 2026, a SemiAnalysis lançou o GDPx v1.0, um benchmark de tarefas profissionais de alta dificuldade. Entre as 11 áreas avaliadas, finanças e direito não tiveram nenhum modelo aprovado integralmente segundo o critério binário original. A equipe de pesquisa precisou recorrer à “pontuação parcial média” para mostrar as diferenças entre os modelos.
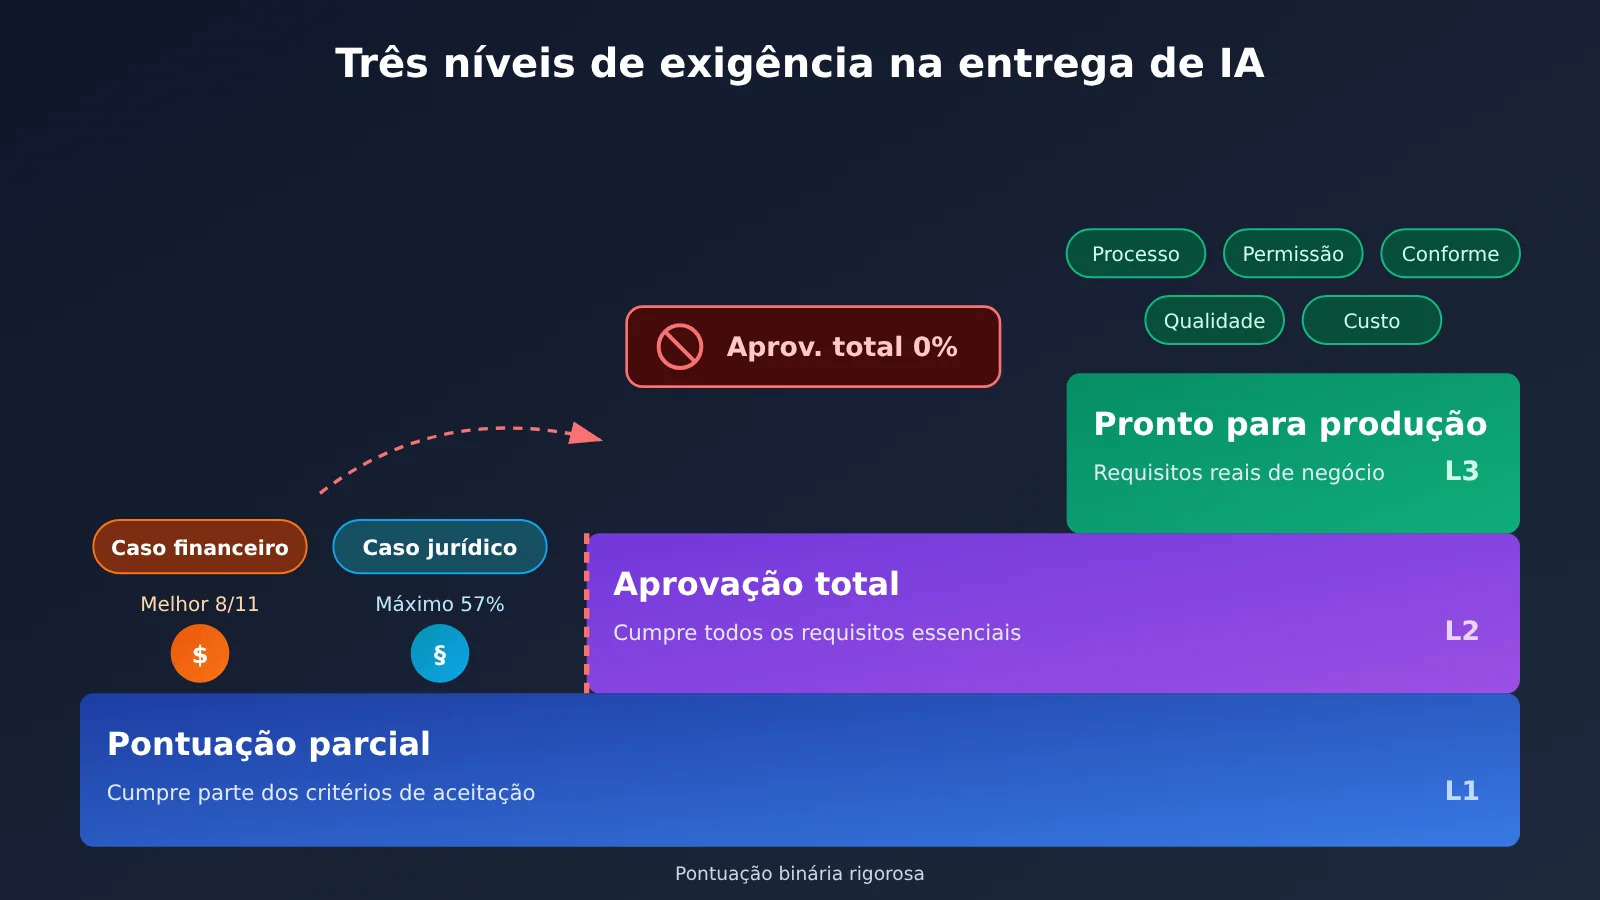
Isso não é uma conclusão precipitada de que “a IA não funciona”. Alguns modelos alcançaram uma pontuação parcial média de 44% no caso jurídico e acertaram cerca de metade das verificações de aceitação no caso financeiro. A pergunta que realmente importa é: por que acertar metade ainda não é suficiente para entregar o resultado?
O que você vai aprender: ao terminar a leitura, você conhecerá os valores principais, o número de falhas e os critérios de pontuação da tarefa financeira Bellwood-QoE e da tarefa de revisão do estatuto para uma rodada de financiamento Série B. Também conseguirá distinguir melhor a capacidade da IA de auxiliar da capacidade de entregar um trabalho assumindo responsabilidade de forma independente.
Fracasso nas tarefas financeiras e jurídicas: os principais dados do GDPx
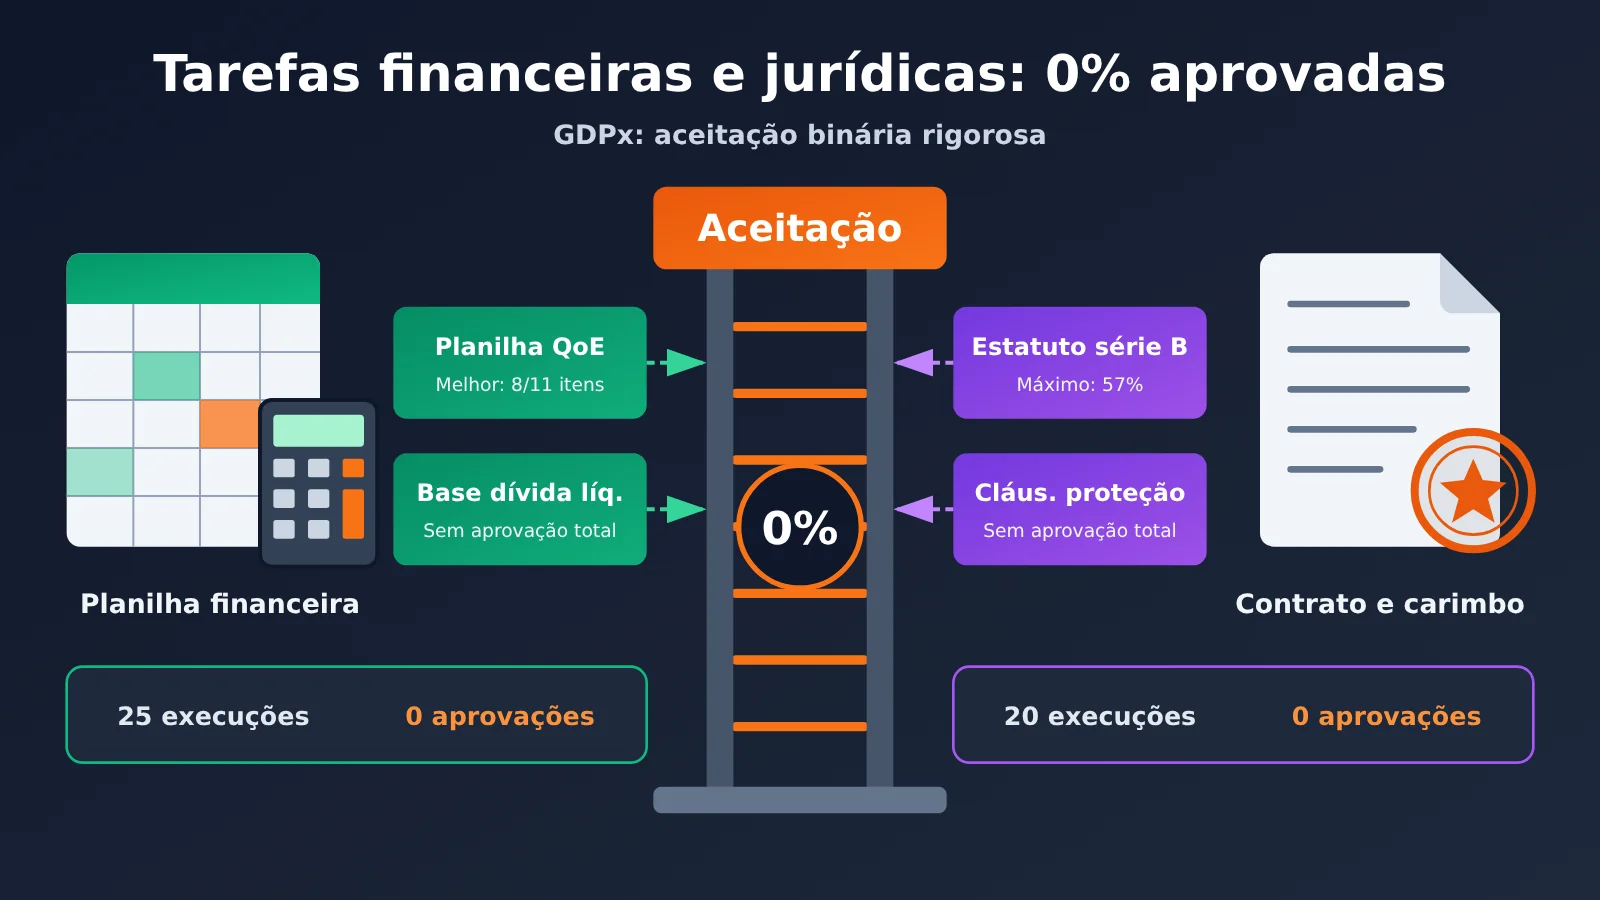
A primeira edição do GDPx abrange 11 áreas profissionais e 206 tarefas, com duração máxima padrão de 8 horas por tarefa. O teste avalia o desempenho conjunto de “modelo + framework de agente + ferramentas + ambiente de trabalho”. O primeiro colocado no ranking geral, Claude Opus 5.5, alcançou apenas 12,0%. Nesse contexto, as áreas financeira e jurídica se destacam pelos resultados.
| Item | Área financeira | Área jurídica |
|---|---|---|
| Número de tarefas | 24 | 20 |
| Parceiro especializado | Living Context | Chakra |
| Caso público | Bellwood-QoE (planilha de análise da qualidade dos resultados) | quillon-series-b-redline (revisão do estatuto para a rodada Série B) |
| Execuções do caso público | 25 execuções selecionadas | 20 execuções com 4 modelos |
| Aprovações completas | 0 | 0 |
| Pontuação binária rigorosa | 0% | 0% |
| Pontuação parcial | Melhor execução aprovada em 8 das 11 verificações | Média de 18%, com máximo de 57% em uma execução |
Ao ler a tabela, vale observar dois pontos. Primeiro, a pontuação binária de 0% não significa que todos os resultados sejam inúteis: as pontuações parciais claramente não foram zero. Segundo, as 25 e 20 execuções da tabela se referem aos testes de um único caso público em cada área. Isso não significa que as 24 tarefas financeiras ou as 20 tarefas jurídicas tenham sido executadas apenas esse número de vezes.
Por que as tarefas financeiras e jurídicas usam critérios rigorosos de aceitação
As entregas nas duas áreas são “arquivos que podem ser incorporados diretamente a transações reais”, e não apenas recomendações. Em uma diligência de fusão ou aquisição, ou em uma negociação de financiamento, um erro no cálculo da dívida líquida ou uma cláusula de proteção que possa ser contornada pode comprometer a utilidade do documento inteiro. Por isso, o GDPx adotou critérios de aceitação rigorosos, próximos aos de uma entrega profissional — o que explica diretamente o resultado de 0%.
Caso de análise financeira: como o Bellwood-QoE fez a IA acertar as contas, mas entregar um resultado inadequado
Contexto da transação e requisitos da tarefa
O Living Context transformou uma experiência real de transação em um ambiente de teste anonimizado: o fundo de private equity Bannock Capital adquiriu cerca de 62% da Haverly Snack Company por aproximadamente US$ 880 milhões, com uma parcela adicional de contraprestação contingente. O ambiente continha cerca de 4.000 documentos anonimizados, incluindo razão geral, extratos bancários, dados da folha de pagamento, análise de vencimentos de contas a receber, correspondências contratuais, acordos da transação, planilhas de ajustes históricos e materiais de trabalho de consultores.
O modelo precisava assumir uma pasta de trabalho inacabada de análise da qualidade dos lucros (QoE). A tarefa era identificar quais dados existentes estavam corretos, corrigir números e classificações incorretos e preservar as entradas corretas e a estrutura dos cálculos. Além disso, precisava verificar os ajustes de EBITDA, reconciliar o capital de giro de 12 meses, tratar o cálculo da dívida líquida, apresentar documentos que comprovassem cada ajuste e garantir a consistência das referências entre as planilhas. O entregável era a própria pasta de trabalho revisada.
Resultados do teste Bellwood-QoE
| Modelo | Média de verificações aprovadas entre as 11 de aceitação | Passou em todas |
|---|---|---|
| GPT-6.1 Sol | 5,6 | Não |
| Claude Opus 5.5 | 5,4 | Não |
| GPT-6 Astra | 5,4 | Não |
| GLM 5.3 | Menos de 2 | Não |
| Grok 4.7 | Menos de 2 | Não |
| Melhor execução individual | 8 | Não |
Os modelos mais fortes acertaram, em média, cerca de metade das verificações, e a melhor execução acertou 8. Mas, se houver um erro financeiro crítico entre as verificações restantes, a pasta de trabalho inteira não pode ser entregue. Os três tipos de erro a seguir mostram onde está o problema.
Erro financeiro 1: interpretação ampliada de um ajuste de US$ 418
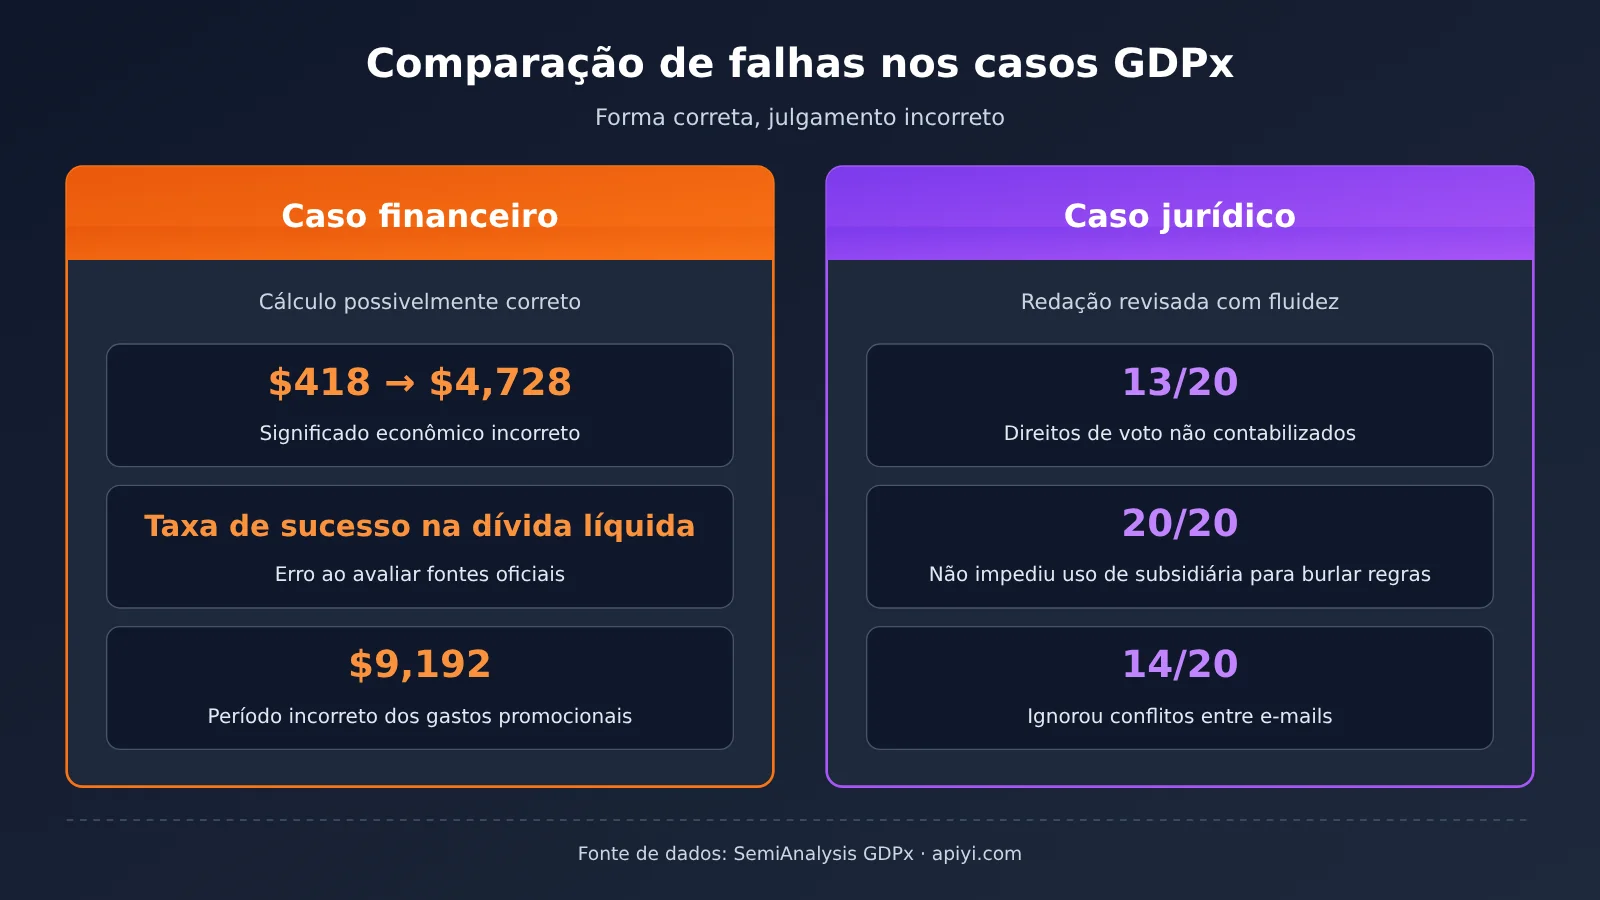
Alguns modelos interpretaram um ajuste de auditoria de seguro de US$ 418, que já havia sido dispensado, como se “toda a obrigação referente à apólice anterior de seguro contra acidentes de trabalho tivesse terminado”. Com isso, o EBITDA dos últimos 12 meses foi subestimado em US$ 4.728. Esse erro de interpretação apareceu em 10 das 15 execuções relevantes com Opus, Astra e Sol.
Não se trata de um erro de multiplicação. O modelo ampliou o significado contábil e jurídico de um ajuste específico para chegar a uma conclusão sobre toda a responsabilidade histórica relacionada ao seguro. A diferença de US$ 4.728 resultou das consequências dessa interpretação equivocada, e não de algum múltiplo de US$ 418. É difícil detectar esse tipo de erro apenas “refazendo os cálculos”, porque a conta em si pode estar correta.
Erro financeiro dois: despesas da transação incluídas na dívida líquida
Em 15 execuções, os honorários de êxito do assessor financeiro foram incluídos na dívida líquida, embora o contrato de compra da transação determinasse que fossem tratados separadamente como despesas da transação. O modelo encontrou os honorários e fez as operações de soma e subtração corretamente, mas não adotou o tratamento exigido pelo contrato.
Essa é a diferença entre “ter os dados” e “classificá-los corretamente do ponto de vista do negócio”. Em fusões e aquisições, a dívida líquida costuma influenciar o valor efetivamente pago pelo comprador. Por isso, uma classificação incorreta não afeta apenas a planilha.
Erro financeiro três: despesas que deveriam ser ajustadas foram omitidas
A equipe de pesquisa também identificou um conjunto de problemas mais sutis:
- Em 17 execuções, a remuneração de familiares que não trabalhavam de fato continuou sendo tratada como despesa operacional normal da empresa;
- A maioria das execuções não identificou despesas pessoais do proprietário registradas apenas no campo de observações do livro-razão;
- Nas 15 execuções do modelo mais avançado, 10 deixaram de ajustar uma despesa promocional histórica de 9192 dólares, incluindo nos 12 meses atuais um gasto que pertencia a outro período.
Esses erros envolvem, ao mesmo tempo, o período contábil, a natureza das despesas, as fontes de evidência e a realidade econômica da transação. O objetivo da análise de qualidade dos lucros é justamente eliminar itens que “parecem despesas operacionais, mas não são”. Se eles passarem despercebidos, o EBITDA não refletirá a capacidade real de geração de lucro da empresa.
Caso jurídico: por que nenhuma das 20 revisões do estatuto para a rodada Série B foi utilizável
Requisitos da tarefa jurídica
Na tarefa quillon-series-b-redline, a IA representava o investidor líder de uma rodada Série B e deveria revisar o estatuto social a ser assinado. Os materiais incluíam o term sheet assinado, a tabela de participação societária, um e-mail do cliente, a minuta do estatuto e outros documentos da transação. Para ser considerada bem-sucedida, a revisão precisava proteger os direitos legítimos do investidor sem alterar, sem justificativa, as condições comerciais já negociadas. Era uma tarefa de análise jurídica que exigia o confronto de vários documentos, não apenas uma revisão de texto.
Resultados do caso jurídico e três erros principais
| Indicador | Resultado |
|---|---|
| Atendeu integralmente aos critérios de uso | 0/20 execuções |
| Pontuação parcial média | 18% |
| Pontuação parcial por modelo | 44% para Opus 5.5, 25% para GPT-6 Astra, 2% para Gemini 4 Argon e 0,5% para GLM 5.3 |
| Maior pontuação parcial em uma execução | 57% (Opus 5.5) |
| Não identificou que os acionistas tinham votos suficientes para remover cláusulas de proteção | 13/20 execuções |
| Não impediu a evasão das restrições por meio de subsidiárias | 20/20 execuções |
| Não apontou o conflito entre o e-mail do cliente e o term sheet | 14/20 execuções |
Vale esclarecer que os 18% são a pontuação parcial média das execuções relacionadas a esse caso, não uma pontuação geral e uniforme da área jurídica no GDPx.
Erro 1: ler as cláusulas sem calcular os votos. Em 13 execuções, a IA não percebeu que os demais acionistas tinham poder de voto suficiente para remover as cláusulas de proteção exigidas pelo investidor líder. A presença dessas cláusulas no estatuto não significa que a proteção esteja garantida. Para avaliar se poderiam ser derrubadas, era necessário calcular os direitos de voto com base na tabela de participação societária.
Erro 2: revisar apenas o texto, sem impedir a evasão. Nenhuma das 20 execuções impediu de forma eficaz que a empresa usasse subsidiárias para contornar as restrições de proteção ao investidor previstas no estatuto. Se a cláusula restringe apenas a própria empresa e não abrange suas subsidiárias, a operação pode ser realizada por outra pessoa jurídica. Entender o sentido literal de uma cláusula não é o mesmo que identificar uma forma concreta de contorná-la.
Erro 3: tratar o e-mail como acordo final. Em 14 execuções, a IA adotou diretamente as condições desejadas no e-mail do cliente, sem apontar que elas conflitavam com o term sheet assinado. Alterar o estatuto dessa forma equivale a renegociar unilateralmente condições já definidas. O procedimento adequado seria identificar o conflito e alertar o usuário, em vez de simplesmente aceitar todas as solicitações.
Como a avaliação jurídica busca garantir a confiabilidade
A metodologia de avaliação da Chakra inclui: requisitos elaborados por profissionais do direito, calibração dos critérios com exemplos válidos, inválidos e parcialmente corretos, revisão humana de decisões controversas e verificação de vieses nos modelos avaliadores. Cada resposta é avaliada cinco vezes, e a consistência dos resultados de cada critério de aceitação é acompanhada. Ainda assim, trata-se de um controle interno de qualidade descrito pela parceira; isso não significa que uma instituição totalmente independente tenha verificado a ausência de erros na avaliação.
A causa comum das falhas em tarefas financeiras e jurídicas: não é falta de capacidade de escrever, mas de julgar corretamente
O Living Context agrupou os erros comuns nos casos financeiros em quatro categorias, que coincidem em grande parte com as observações dos casos jurídicos:
| Padrão de falha | Manifestação nos casos financeiros | Equivalente nos casos jurídicos | Lição profissional |
|---|---|---|---|
| Julgamento equivocado da autoridade dos documentos | Dar mais peso a uma planilha antiga com números mais explícitos e ignorar um acordo assinado | Colocar um e-mail do cliente acima da lista de cláusulas | Primeiro, estabelecer uma “hierarquia de validade dos documentos” |
| Ignorar efeitos de segunda ordem | Concluir os cálculos, mas deixar de considerar impactos tributários, sobre dívidas e obrigações da transação | Alterar uma cláusula de proteção sem avaliar a estrutura de votação | Investigar os efeitos posteriores de cada alteração |
| Verificar apenas as contas, não as premissas | Conferir repetidamente as operações, mesmo com uma premissa de negócio incorreta | Redigir com precisão, mas sem contemplar o caminho envolvendo subsidiárias | Revisar as premissas é mais importante do que revisar os cálculos |
| Comprometer a estrutura existente durante as alterações | Substituir fórmulas por números fixos, rompendo as conexões entre planilhas | Alterar termos comerciais já negociados | O material entregue deve “corrigir sem estragar” |
Esses são padrões de falha identificados pela equipe de pesquisa, não taxas de erro aplicáveis a todos os modelos financeiros empresariais ou documentos jurídicos. O ponto em comum é que a principal dificuldade muitas vezes não está em gerar texto, mas em selecionar documentos, aplicar raciocínio especializado, identificar restrições implícitas, manter a consistência entre arquivos e validar o resultado final. Quanto mais fluida for a resposta do modelo, mais fácil é deixar esses problemas passarem despercebidos.
Análise do impacto da IA em finanças e no direito: como distinguir apoio de entrega
Impacto para responsáveis por IA e desenvolvedores nas empresas
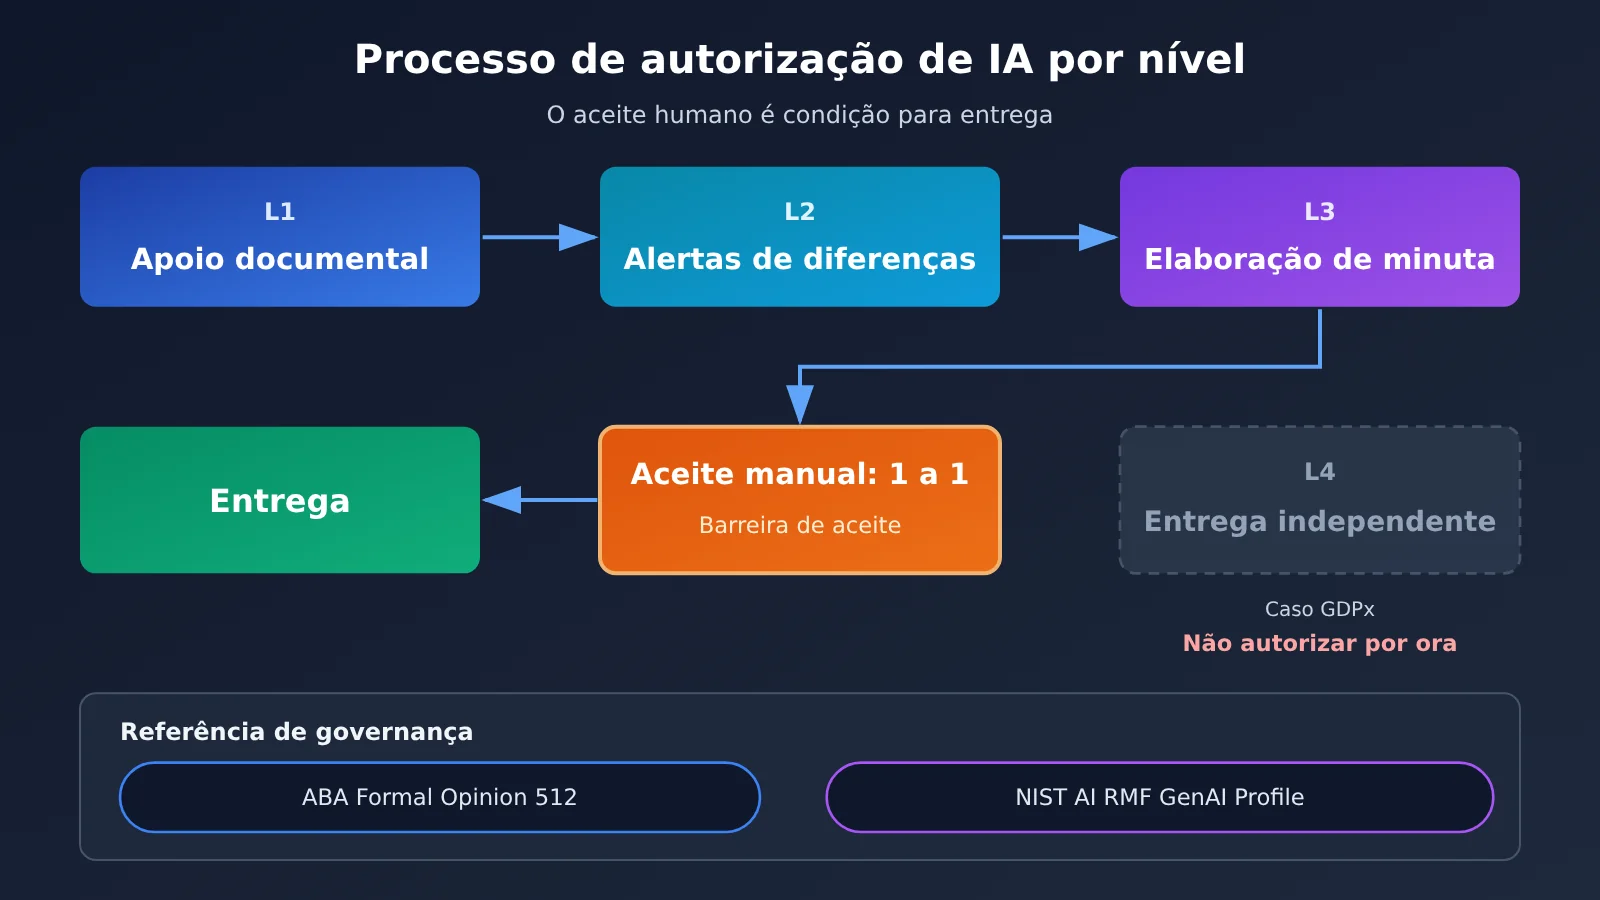
O GDPx não questiona o valor da IA como apoio ao trabalho especializado. As pontuações parciais mostram que os modelos já conseguem cumprir parte dos requisitos de aceitação. Mas a pesquisa não oferece dados para comprovar quanto tempo ou custo pode ser economizado com participação humana. Por isso, não se deve converter diretamente os resultados dos casos em ROI. Uma abordagem mais prática é definir níveis de autorização conforme o risco, como na tabela abaixo:
| Nível de autorização | Usos típicos | Papel humano | Critério de aceitação |
|---|---|---|---|
| L1 Apoio na organização de informações | Organização preliminar de informações e verificação de dados atípicos | Verificação por amostragem | Resultados usados apenas como pistas |
| L2 Sinalização de divergências | Identificação de diferenças em cláusulas e dados, listas de conflitos | Confirmação item por item | Profissionais avaliam a veracidade |
| L3 Produção de rascunhos | Rascunho de revisão de planilhas, primeira versão com alterações marcadas (redline) de estatutos | Revisão completa | Verificação item por item com base em uma lista de critérios |
| L4 Entrega independente | Assinatura ou envio direto a terceiros | — | Os casos do GDPx mostram que, no momento, não é recomendável conceder essa autorização |
Essa classificação segue uma linha semelhante à de orientações externas. Em 29 de julho de 2024, a Associação Americana de Advogados (ABA) publicou a Formal Opinion 512, que destaca que, ao usar IA generativa, advogados continuam responsáveis por competência profissional, confidencialidade das informações dos clientes, comunicação, supervisão e cobrança razoável. Eles também devem entender as capacidades e limitações das ferramentas e não podem adotar seus resultados sem verificação. O perfil de IA generativa do AI RMF, publicado pelo NIST dos Estados Unidos em 26 de julho de 2024, também enfatiza que as organizações devem definir medidas de supervisão humana, avaliação, registro e governança de acordo com o contexto de uso. Vale lembrar que a opinião da ABA é uma orientação sobre ética profissional para advogados nos Estados Unidos e que o documento do NIST não apresenta resultados dos testes do GDPx. Ambos servem apenas como referências de outras áreas.
Como criar um fluxo de apoio com API para sinalizar conflitos
Um dos erros mais comuns no caso jurídico do GDPx foi não apontar os conflitos entre o e-mail do cliente e os termos já assinados. Esse tipo de trabalho, que envolve identificar diferenças e levantar questões, é adequado para assistência de nível L2 — desde que a saída sirva apenas como pista para confirmação humana. No exemplo abaixo, o modelo compara dois textos e lista os conflitos e os pontos que precisam de verificação humana:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface da APIYI compatível com OpenAI
)

resp = client.chat.completions.create(
    model="claude-sonnet-4-20250514",
    messages=[{"role": "user", "content": "对照【已签署条款清单】与【客户邮件】,只列出冲突项和需人工确认的问题,不要直接修改条款。\n条款清单:...\n客户邮件:..."}]
)
print(resp.choices[0].message.content)
Veja o código completo (comparação entre modelos + checklist de revisão humana)
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Uma chave para acessar modelos de vários provedores
)

SYSTEM = (
    "你是交易文件审查助手。你的输出只作为专业人员的审查线索,"
    "必须遵守:1) 已签署文件效力优先于邮件和旧表格;"
    "2) 发现冲突时提示,不得自行改写商业条款;"
    "3) 每条结论标注依据的文件名和段落;"
    "4) 无法确认的事项明确写'需人工确认'。"
)

CHECKS = [
    "客户邮件中的要求是否与已签署条款清单冲突",
    "结合股权结构,其他股东能否凭投票权移除保护条款",
    "保护条款是否覆盖子公司,是否存在绕行路径",
]

def review(docs: str, models: List[str]) -> Dict[str, str]:
    """Gera pistas de revisão separadamente com vários modelos para facilitar a comparação humana"""
    prompt = "请逐项检查:\n" + "\n".join(f"- {c}" for c in CHECKS) + f"\n\n材料:\n{docs}"
    results = {}
    for m in models:
        try:
            r = client.chat.completions.create(
                model=m,
                messages=[{"role": "system", "content": SYSTEM},
                          {"role": "user", "content": prompt}],
                temperature=0
            )
            results[m] = r.choices[0].message.content
        except Exception as e:
            results[m] = f"调用失败: {e}"
    return results

if __name__ == "__main__":
    out = review("条款清单:...\n股权结构表:...\n客户邮件:...\n章程草稿:...",
                 ["claude-sonnet-4-20250514", "gpt-4o"])
    for model, text in out.items():
        print(f"===== {model} =====\n{text}\n")
    # A decisão final de adoção cabe a um advogado ou profissional financeiro, com base no checklist de aceitação
🚀 Dica para começar: ao montar esse tipo de fluxo, você pode usar a APIYI em apiyi.com para acessar vários modelos conhecidos com a mesma chave API e comparar quantos conflitos cada um identifica nas suas próprias amostras com dados anonimizados. Novos usuários podem usar a cota gratuita de testes para uma validação em pequena escala antes de decidir se vale iniciar um projeto-piloto.
Impacto nos setores financeiro e de tecnologia jurídica
Os resultados do GDPx lembram ao setor que, ao avaliar produtos profissionais de IA, não basta verificar se as demonstrações de conversa são fluidas. É preciso analisar se as entregas finais passam pela avaliação de especialistas. Para os fornecedores, a competitividade dependerá cada vez mais de detalhes de engenharia, como “priorização de documentos oficiais”, “alertas de conflito”, “preservação da estrutura original das fórmulas” e “rastreabilidade das evidências”. Já os compradores devem testar os produtos de forma independente, com tarefas próximas às de seu próprio negócio. O próprio GDPx divulgou apenas parte das tarefas e dos registros de execução, por isso ainda são necessárias mais análises e reproduções independentes.
💡 Dica para a escolha: o desempenho dos modelos varia bastante entre áreas, e uma classificação geral não representa necessariamente as necessidades do seu negócio. Com a interface unificada da APIYI apiyi.com, você pode testar vários modelos em paralelo nas suas próprias tarefas, registrando as pontuações parciais e a aprovação nos critérios essenciais, em vez de olhar apenas para a média. Consulte a lista atualizada da plataforma para verificar a disponibilidade de cada modelo.
Perguntas frequentes (FAQ)
Q1: O “fracasso total” nas tarefas financeiras e jurídicas significa que a IA não acertou nada?
Não. O resultado de 0% segue um critério de aprovação binário e rigoroso: nenhuma execução atendeu a todos os requisitos essenciais. No caso financeiro, a melhor execução passou em 8 das 11 verificações; no caso jurídico, o Opus 5.5 obteve uma pontuação parcial média de 44%. Concluir parte da tarefa e entregar um resultado aprovado são coisas diferentes.
Q2: Por que a IA pode acertar as contas e ainda assim chegar ao resultado errado?
Porque o erro muitas vezes está na premissa de negócio, não no cálculo em si. Por exemplo, um ajuste de isenção de US$ 418 foi interpretado como o encerramento das obrigações de toda a apólice, fazendo com que o EBITDA fosse subestimado em US$ 4.728. Em outro caso, o valor da comissão de sucesso do banco estava correto, mas foi classificado como dívida líquida. Refazer as contas várias vezes não identifica esse tipo de erro.
Q3: As conclusões do GDPx podem ser generalizadas para todas as aplicações de IA em finanças e direito?
Não. Esses resultados vêm de tarefas específicas de alta dificuldade e de regras de avaliação próprias. As causas de falha identificadas nos casos também não podem ser generalizadas para todo o setor. Aplicações menos complexas ou com colaboração humana precisam ser avaliadas separadamente.
Q4: Que tipos de trabalho financeiro e jurídico a IA pode assumir hoje?
Alguns usos razoáveis incluem organizar materiais preliminares, apontar divergências em cláusulas e dados, preparar rascunhos, verificar dados atípicos e ajudar a criar listas de verificação. Para saber se a IA é adequada a uma atividade específica, é preciso testá-la separadamente, considerando o nível de risco e os critérios profissionais de aprovação.
Q5: Como avaliar, com baixo custo, o desempenho de um modelo no meu negócio?
Você pode seguir estes passos:
1. Prepare algumas amostras reais com dados anonimizados e crie uma lista de verificação para avaliar cada uma delas;
2. Cadastre-se na APIYI apiyi.com, obtenha uma chave API e use os créditos gratuitos de teste;
3. Defina o base_url do código deste artigo como `https://api.apiyi.com/v1` e faça chamadas paralelas a vários modelos;
4. Registre separadamente as pontuações parciais e a aprovação nos itens essenciais, deixando a decisão final para profissionais da área.
Q6: O custo por tarefa no relatório GDPx pode servir de referência para preços de API?
Não. Os valores em dólares no GDPx representam o custo médio por tarefa nas condições de execução do benchmark, e não uma tarifa uniforme de qualquer plataforma. O custo real depende dos preços atuais da plataforma utilizada e do volume de chamadas. Você pode consultar os detalhes da cobrança por uso no console da APIYI apiyi.com.
Principais conclusões da avaliação de IA em tarefas financeiras e jurídicas
- Nenhuma aprovação integral sob critérios rigorosos: nenhum modelo passou por completo nas tarefas financeiras e jurídicas do GDPx segundo o critério binário.
- Pontuação parcial não é zero: no caso financeiro, o melhor resultado em uma única execução passou em 8 de 11 verificações; no caso jurídico, a maior pontuação em uma execução foi de 57%.
- O erro está no julgamento, não no cálculo: a interpretação equivocada de um ajuste de US$ 418 levou a uma subestimação do EBITDA em US$ 4.728.
- A hierarquia das fontes é decisiva: em 14 de 20 execuções, o e-mail do cliente foi priorizado em relação à lista de termos assinada.
- Restrições implícitas são as mais difíceis de contemplar: o risco de contornar as regras por meio de uma subsidiária não foi prevenido em nenhuma das 20 execuções.
- Três conceitos não são intercambiáveis: pontuação parcial, aprovação integral e uso em produção precisam ser avaliados separadamente.
- Primeiro, apoio; depois, piloto: com a interface unificada para vários modelos da APIYI, em apiyi.com, é possível fazer uma validação por etapas com amostras próprias.
Resumo
As principais lições das tarefas financeiras e jurídicas do GDPx podem ser resumidas em três pontos:
- Fluência não é sinônimo de qualidade: mesmo com cálculos corretos nas tabelas e cláusulas bem redigidas, ainda podem ocorrer erros na substância econômica, na estrutura de direitos e interesses e na resolução de conflitos entre documentos;
- Entregas profissionais dependem de julgamento: a autoridade das fontes, os efeitos de segunda ordem, as restrições implícitas e a consistência entre documentos são os verdadeiros desafios do trabalho especializado;
- A delegação deve ser gradual e os critérios de aceite, claros: seguindo as abordagens da ABA e do NIST, mantenha a revisão humana e use a IA como apoio e para produzir rascunhos.
A IA já consegue realizar parte do trabalho em tarefas profissionais complexas, mas ainda há uma distância considerável até que possa assumir, de forma independente, a responsabilidade por uma entrega. Se você está avaliando soluções de IA para cenários financeiros ou jurídicos, vale comparar, em amostras do seu próprio negócio, as pontuações parciais e as taxas de aprovação em critérios essenciais de vários modelos pela APIYI, em apiyi.com. Só então defina os limites de delegação.
📚 Referências
- Relatório original do GDPx da SemiAnalysis: capítulos sobre finanças e direito, casos e padrões de falha
- Link:
newsletter.semianalysis.com/p/gdpx-measuring-frontier-model-capabilities -
Descrição: fonte primária dos dados dos casos Bellwood-QoE e quillon-series-b-redline
-
Descrição dos domínios e trajetórias de execução públicas do GDPx: número de tarefas, parceiros e trajetórias dos agentes
- Links:
gdpx.semianalysis.com/domains,gdpx.semianalysis.com/rollouts -
Descrição: permite consultar a execução de algumas tarefas públicas
-
Comunicado sobre a ABA Formal Opinion 512: orientações éticas para o uso de IA generativa por advogados
- Link:
americanbar.org/news/abanews/aba-news-archives/2024/07/aba-issues-first-ethics-guidance-ai-tools/ -
Descrição: aplicável à advocacia nos Estados Unidos; serve como referência para princípios de revisão humana
-
Perfil de IA Generativa do NIST AI RMF: framework de gestão de riscos de IA generativa
- Link:
nist.gov/publications/artificial-intelligence-risk-management-framework-generative-artificial-intelligence - Descrição: referência multidisciplinar sobre supervisão humana, avaliação e medidas de governança
Autor: equipe técnica da APIYI
Troca de informações técnicas: entre em contato pela página inicial do site oficial da APIYI. Para mais informações sobre integração, acesse a documentação em docs.apiyi.com