Nota do autor: em 2 de novembro de 2026, a OpenAI apresentou o Pando, seu backend Git interno. Este artigo parte do fato de que o projeto chegou à produção em 10 semanas para analisar a divisão de trabalho entre pessoas e agentes, os testes e a migração, além de reunir práticas de engenharia com agentes que outras equipes podem aproveitar.
Em 2 de novembro de 2026, a OpenAI publicou o artigo técnico《Scaling Git at OpenAI》e apresentou o Pando, novo backend Git que sustenta todas as atividades de desenvolvimento de seu monorepo: do início do projeto até receber tráfego de produção, foram cerca de 10 semanas. Um engenheiro projetou a arquitetura central, várias equipes de agentes cuidaram da implementação e um pequeno grupo de engenheiros fez a implantação. É fácil transformar esses fatos na história de “uma pessoa comandando uma IA para construir infraestrutura”, mas os detalhes divulgados pela empresa mostram que o que fez a diferença foi um conjunto de restrições e mecanismos de validação de engenharia.
Este não é mais um conto sobre os milagres da programação com IA. Com base nas informações divulgadas pela OpenAI, o artigo separa o que já é público do que ainda não foi revelado. O tamanho das equipes, o custo em tokens, os registros das tarefas e a proporção de código alterado manualmente, por exemplo, não foram divulgados.
O que você vai aprender: por que o Pando foi criado, o que as equipes de agentes Codex fizeram, quais métodos de validação permitiram que os agentes participassem do desenvolvimento de infraestrutura e como aplicar essas práticas aos seus próprios projetos.
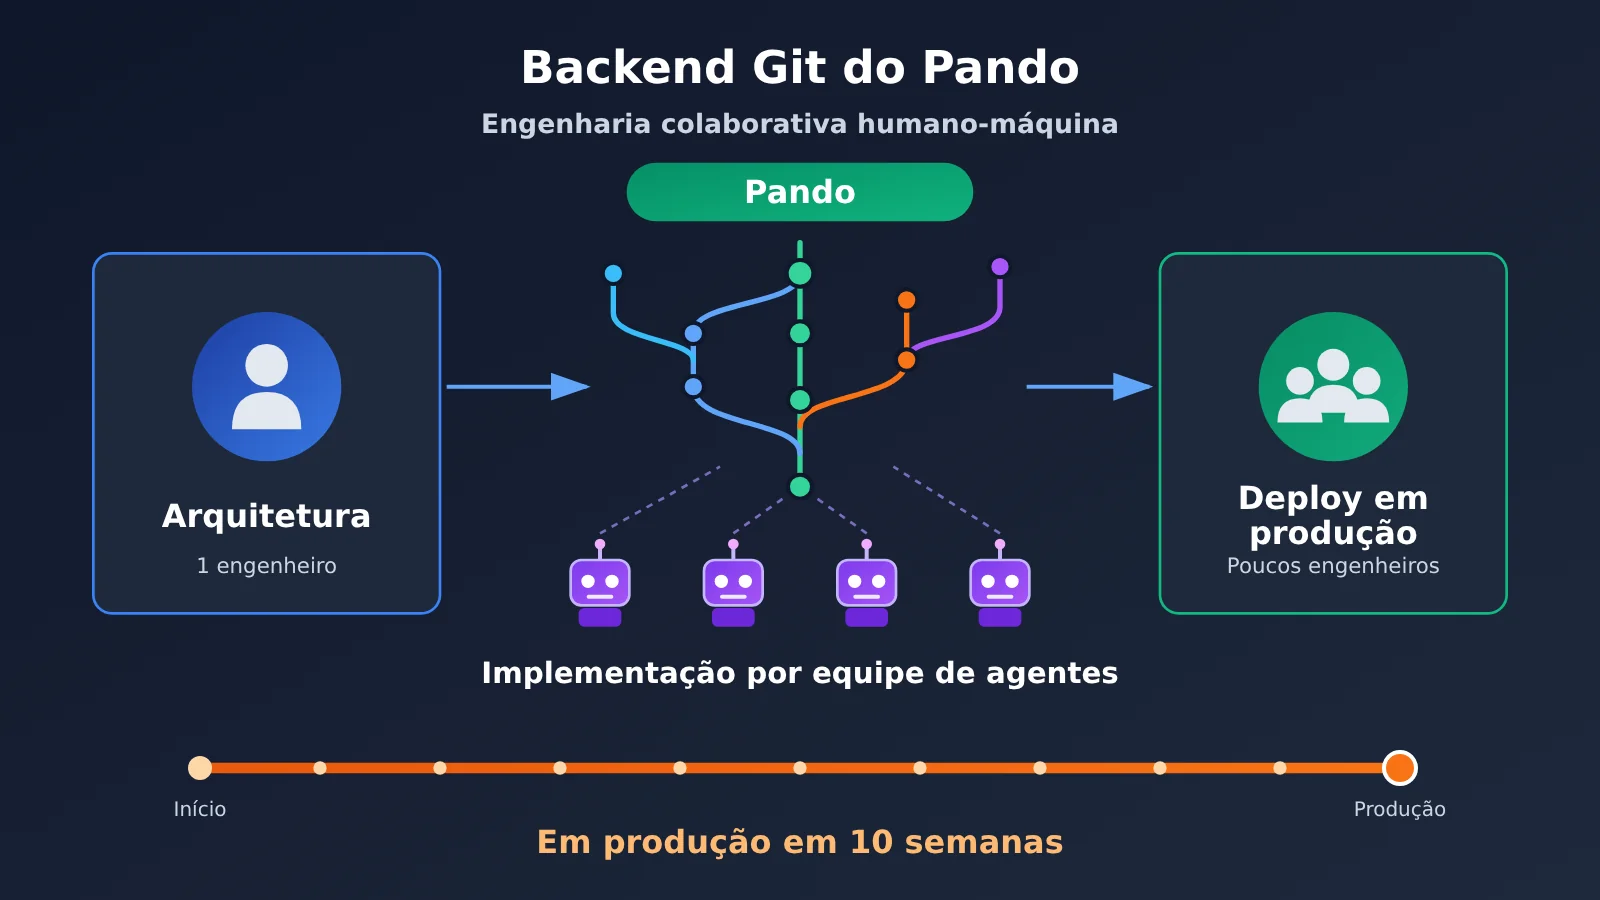
Pando em resumo: o que as equipes de agentes Codex entregaram
A tabela reúne as informações confirmadas pela OpenAI. Vale lembrar que o Pando é um backend de servidor compatível com Git: não é um novo protocolo de controle de versão nem um substituto direto do GitHub.
| Item | Detalhes |
|---|---|
| Data de publicação | 2 de novembro de 2026, no artigo oficial《Scaling Git at OpenAI》 |
| Autores | Aaron Friel, Taylor Blau e Ted Nyman (profissionais técnicos da OpenAI) |
| Duração do projeto | Cerca de 10 semanas do início à entrada em produção; começou a receber tráfego de produção em abril de 2026 |
| Linguagem de implementação | Servidor desenvolvido principalmente em Rust, do zero, evitando deliberadamente dependências do sistema antigo |
| Divisão entre pessoas e agentes | Um engenheiro projetou a arquitetura central, várias equipes de agentes fizeram a implementação e um pequeno grupo de engenheiros cuidou da implantação |
| Resultados em produção | A latência mediana de push caiu quase 80%, com entrega diária de quase 1 PB de dados Git |
| Disponibilidade | Até 2026-11-03, não havia servidor público, API ou preços divulgados |
Por que a OpenAI precisou reconstruir o backend Git com agentes Codex
O ponto de partida do Pando foi a explosão no volume de commits. O gráfico oficial usa como referência o número de commits mesclados à branch principal no primeiro trimestre de 2024 e mostra o crescimento nos trimestres seguintes. A tabela abaixo destaca alguns desses períodos.
| Trimestre | Crescimento de commits em relação ao 1º trimestre de 2024 | Observação |
|---|---|---|
| 4º trimestre de 2024 | +98% | Quase o dobro |
| 4º trimestre de 2025 | +264% | O sistema antigo começou a ter dificuldade para acompanhar a demanda |
| 1º trimestre de 2026 | +432% | Fase de desenvolvimento do projeto Pando |
| 3º trimestre de 2026 | +1.378% | Cerca de 14,78 vezes o valor de referência |
| 4º trimestre de 2026 | +2.442% | Projeção oficial, não resultado de um trimestre concluído |
É importante não confundir as métricas: o número de commits não equivale ao número de linhas de código, à quantidade de PRs nem à produtividade de desenvolvimento. Portanto, não dá para concluir que “o volume de código aumentou 25 vezes” ou que “o Codex tornou os engenheiros 25 vezes mais produtivos”. Segundo a própria OpenAI, o Codex permite que os engenheiros avancem em mais tarefas ao mesmo tempo, gerando mais branches paralelas, pushes, merges, jobs de CI e solicitações de fetch e clone.
Por volta do quarto trimestre de 2025, o sistema antigo apresentava lentidão em pushes e fetches e falhas em merges, com confiabilidade às vezes abaixo de 90%. A OpenAI não divulgou como essa métrica foi calculada nem sua evolução ao longo do tempo. Por isso, também não dá para interpretá-la como “mais de 10% dos commits falharam”.
4 decisões fundamentais na arquitetura técnica do Pando
O Pando não abandonou o Git. O que ele redesenhou foi a forma como o backend armazena dados, atualiza referências e entrega dados. Entender essas decisões ajuda a enxergar as escolhas que só os humanos poderiam ter feito.
- Atualização independente de branches: em vez de manter um único snapshot consistente de todo o repositório em um dado momento, cada branch mantém sua própria versão. Apenas solicitações que modificam a mesma Ref precisam ser coordenadas, seguindo um modelo de consistência causal. Em contrapartida, uma leitura de várias branches pode retornar versões de momentos diferentes.
- Armazenamento e reutilização de Packfiles: o Packfile recebido em cada Push é gravado como dado imutável no Blob Store. No Fetch, Packfiles já existentes são selecionados com base nos
have/wantdo cliente, e seus endereços de download são enviados pelo mecanismopackfile-urido Git. Isso evita empacotar e compactar os mesmos dados para cada cliente. - Cache regional Express: clusters e caches locais são distribuídos em várias regiões, com solicitações encaminhadas por hashing consistente. A taxa de acerto do cache de Packfiles ultrapassa 99%. Esse é um cache de dados do Git, diferente do Prompt Caching de APIs de Modelos de Linguagem Grande.
- Compaction em camadas no background: de forma semelhante a uma LSM Tree, Packfiles pequenos são mesclados gradualmente em conjuntos maiores que cobrem intervalos contínuos de versões. Atualmente, o repositório monolítico usa até o nível L4.
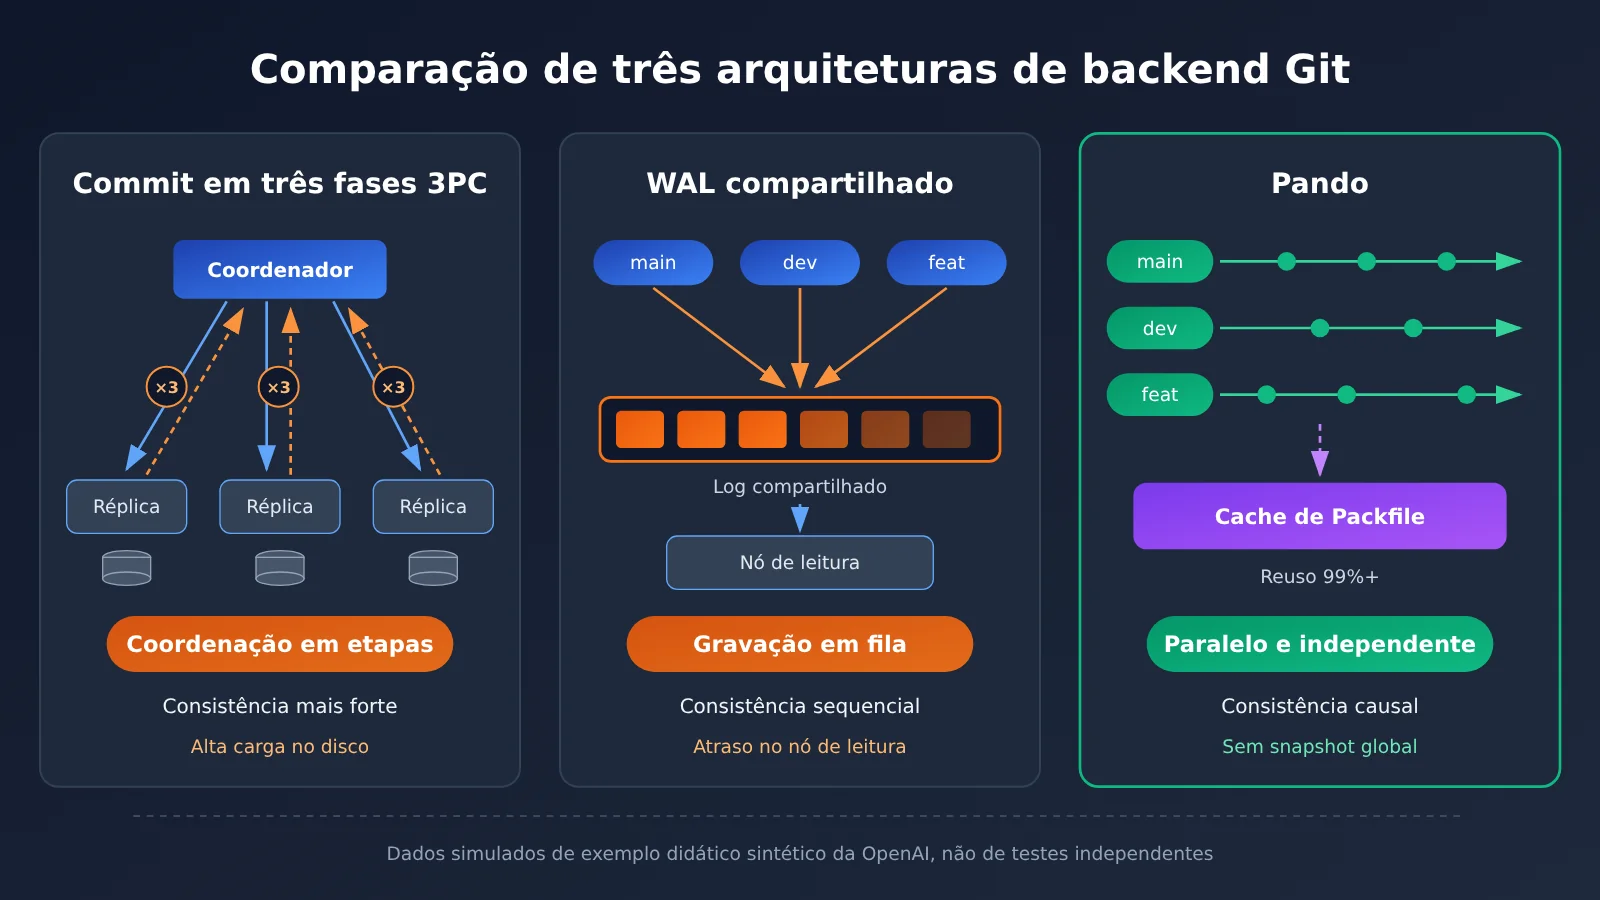
A equipe também comparou três tipos de arquitetura em uma simulação com 1.000 clientes e um total de 10.000 Pushes. Trata-se de uma simulação sintética criada pela OpenAI para fins didáticos, não de um benchmark independente de terceiros.
| Arquitetura | Forma de gravação | Consistência | Principal gargalo |
|---|---|---|---|
| Commit em três fases (3PC) | Gravação coordenada entre várias réplicas completas | Mais forte | Múltiplas rodadas de coordenação e carga no disco tornam as gravações simultâneas mais lentas |
| WAL compartilhado | Todas as atualizações disputam o mesmo log | Consistência sequencial | Nós de leitura ficam defasados quando as gravações chegam mais rápido do que são aplicadas |
| Pando | Transações atômicas independentes para cada Ref | Consistência causal | Abre mão de um snapshot de todo o repositório em um único momento |
Os dados de produção divulgados também incluem: pico de entrega de Packfiles superior a 57 TB em uma hora, com mais de 99% dos bytes vindos do cache em disco local; Clone e Fetch capazes de saturar uma conexão de 10 Gbps em máquinas virtuais comuns na nuvem; leituras e gravações de metadados de Push em O(1)e leituras de metadados para planejamento de Fetch em O(log Δ). Essas complexidades descrevem operações de metadados, não o tempo total de rede de ponta a ponta.
Como a equipe de Agents Codex dividiu o trabalho para concluir o Pando
“Um engenheiro projetou o núcleo” não significa que apenas uma pessoa trabalhou no projeto. Da mesma forma, “uma equipe de Agents implementou o sistema” não significa que cada linha de código foi escrita por IA. Com base no escopo de trabalho divulgado oficialmente, podemos organizar a divisão da seguinte forma. A OpenAI, porém, não revelou a lista específica de tarefas de cada Agent.
| Papel | Trabalho realizado | Por que esse papel assumiu o trabalho |
|---|---|---|
| Engenheiro de arquitetura (humano) | Identificar os gargalos do sistema antigo, manter a compatibilidade com o protocolo Git, escolher atualizações independentes por branch e reutilização de Packfiles, e abrir mão da consistência forte em todo o repositório | São decisões técnicas irreversíveis que definem os limites do sistema |
| Equipe de Agents, incluindo o Codex | Implementar o backend em Rust, garantir a compatibilidade com os protocolos Push/Fetch, implementar gravações concorrentes, otimizar o desempenho e corrigir problemas em casos-limite | O volume de implementação é grande e pode ser verificado repetidamente por testes, o que favorece iterações paralelas |
| Agents de validação | Executar sessões prolongadas para encontrar casos-limite; usar modelos com capacidade Daybreak para testes adversariais 24 horas por dia | É um trabalho contínuo, difícil para humanos manterem na mesma frequência |
| Engenheiro de implantação (humano) | Fazer o redirecionamento gradual do tráfego, sincronizar os sistemas antigo e novo e migrar centenas de integrações | Os riscos em produção e a coordenação entre equipes exigem responsabilidade humana |
O ponto central da tabela é: os humanos definem a arquitetura, as restrições e os critérios de aceitação; os Agents assumem grande parte da implementação e das iterações; e os engenheiros são responsáveis pela migração para produção e pela confiabilidade do sistema. Como a OpenAI não apresentou um grupo de comparação com desenvolvimento humano, não é possível calcular quantas vezes o Codex acelerou o projeto.
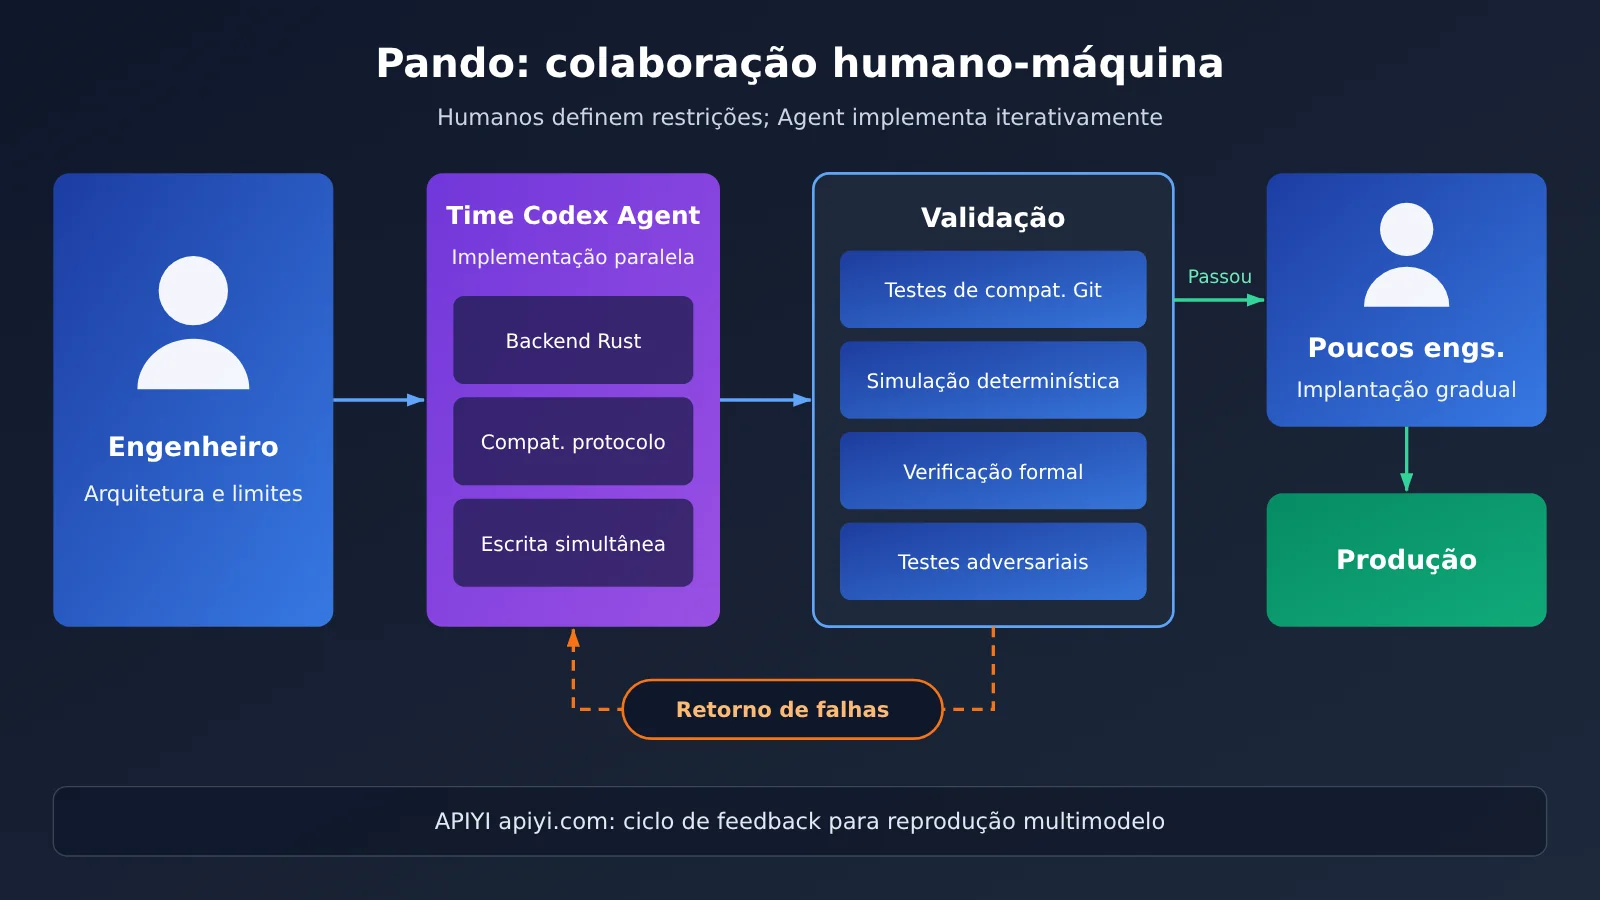
Sistema de testes do Pando: por que o Codex Agent consegue participar do desenvolvimento de infraestrutura
O Pando é um software de infraestrutura. Se algo der errado, uma branch pode apontar para o commit incorreto, um Push pode perder objetos ou um Fetch pode trazer um histórico incompleto. Um erro em uma página web muitas vezes se resolve com uma atualização; um erro no backend Git pode paralisar o desenvolvimento de uma empresa inteira. Por isso, a OpenAI equipou o Agent não com um comando mais longo, mas com um sistema de validação executável.
Testes de compatibilidade com Git: o que importa é o comportamento, não a compilação
A OpenAI criou o Git Conformance Test Suite para que o Agent possa verificar, após alterar a implementação do servidor, se o comportamento corresponde ao esperado no Git padrão. A validação abrange atualização de Ref, Push, Fetch, transferência de Packfile e compatibilidade de protocolo. O ponto principal é que o critério é “comportar-se como o Git”, não apenas “compilar e passar nos testes unitários”. A OpenAI não divulgou o número de casos de teste.
Simulação determinística de concorrência: tornando condições de corrida reproduzíveis
Os erros mais difíceis em sistemas distribuídos costumam aparecer quando várias operações se intercalam. A OpenAI usa Deterministic Simulation Harnesses para simular estados do sistema e eventos concorrentes de maneira reproduzível, ajudando a identificar condições de corrida, problemas na negociação do Git, erros no planejamento de Packfiles e regressões. Por exemplo, se dois Agents modificarem a mesma branch ao mesmo tempo, duas atualizações conflitantes não podem ser consideradas bem-sucedidas; antes de atualizar o ponteiro da branch, o objeto do novo commit já precisa estar disponível para leitura. Esses exemplos explicam os objetivos dos testes, mas não são casos divulgados individualmente pela OpenAI.
Verificação formal com Lean e TLA+: atenção à linha do tempo
A OpenAI informou que usou o GPT-6 Astra para ajudar o Agent a escrever descrições formais em Lean e TLA+, formando a chamada “Theory of Pando”. Ela serve para verificar invariantes, encontrar e corrigir erros e demonstrar propriedades específicas. Há duas ressalvas: primeiro, a verificação se aplica às propriedades definidas, o que não significa que todos os caminhos de código do sistema tenham sido comprovados matematicamente; segundo, segundo a OpenAI, novos modelos foram sendo usados continuamente para melhorar o desempenho e a confiabilidade à medida que surgiam. Portanto, não dá para atribuir todas essas práticas às 10 semanas iniciais.
Sessões longas de Agent e testes adversariais de segurança
A OpenAI também mencionou que várias sessões consecutivas de Agent somaram centenas de horas em busca e correção de problemas de casos extremos, enquanto modelos com capacidades do Daybreak realizavam testes adversariais contínuos no Git e no Pando. A empresa não divulgou o número de Agents, a duração de cada sessão, o consumo de Tokens, a quantidade de bugs corrigidos nem a frequência da supervisão humana. Por isso, não é possível concluir que “o Agent escreveu código sem supervisão durante centenas de horas seguidas”. O que chama atenção é a mudança de abordagem: o Agent é usado para validação contínua, não apenas para gerar código pela primeira vez.
O fork do Git publicado pela OpenAI também traz indícios dessa melhoria contínua. Entre os exemplos estão patches para hash paralelo no index-pack, em agosto de 2026, e para novas tentativas após limitação de taxa e reutilização de Packs concluídos, em outubro. Mas esses commits são posteriores à primeira entrada em produção, em abril de 2026, e, portanto, também não podem ser contabilizados como entregas das 10 semanas iniciais.
Migração gradual do Pando: código escrito pelo Codex Agent não significa que esteja pronto para produção
As 10 semanas correspondem ao período entre o início do projeto e a entrada em produção, não ao tempo total necessário para o amadurecimento completo. O lançamento do Pando seguiu uma abordagem típica de migração gradual sem interrupção, com as seguintes etapas divulgadas oficialmente:
- O Pando foi colocado à frente do sistema antigo como proxy de passagem para leitura e escrita, mantendo os backends antigo e novo sincronizados.
- Durante o processamento de solicitações reais, requisições idênticas foram agrupadas e dados do Git foram armazenados em cache. Depois que parte do tráfego foi migrada, a carga sobre o sistema antigo diminuiu.
- Os clientes usados pelos desenvolvedores foram migrados em lotes por meio de um wrapper interno da CLI do Git.
- Foram migradas centenas de integrações que dependiam da API antiga, de Webhooks e dos métodos de download de repositórios, além dos fluxos de trabalho de Review e Change Request.
- Foram disponibilizadas Codex Skills para a migração, permitindo que os desenvolvedores usassem o Codex para preparar os repositórios locais e o ambiente de migração.
- Uma versão aprimorada do cliente Git foi implantada nos dispositivos dos engenheiros e no aplicativo desktop do ChatGPT.
Segundo a divulgação oficial, a migração inteira ocorreu sem interromper o trabalho de engenharia. Porém, não foram divulgados dados sobre taxas de rollback, distribuição de falhas ou casos malsucedidos. Para quem lidera equipes técnicas, essa parte merece mais atenção do que as “10 semanas”: manter a compatibilidade com fluxos antigos, migrar integrações e transferir o tráfego em etapas costuma ser tão complexo quanto criar o novo sistema.
Análise do impacto do Pando: o que significa para desenvolvedores de Agents e equipes técnicas
Impacto para desenvolvedores de Agents
- A capacidade de verificação determina o potencial do Agent: o Pando permite que Agents participem da implementação central, desde que existam testes de compatibilidade, simulações determinísticas e descrições formais que forneçam feedback confiável.
- O papel dos Agents está se expandindo: além de escrever código, eles passam a buscar continuamente problemas de casos extremos, realizar testes adversariais e ajudar usuários na migração.
Impacto para líderes técnicos
- AI Coding aumenta a carga nas etapas seguintes: o crescimento no volume de commits afeta CI, revisão e hospedagem de código. Em outro artigo publicado em julho de 2026, a OpenAI revelou que o número semanal de PRs internos havia mais que dobrado em relação ao quarto trimestre anterior, tornando a revisão de código um dos novos gargalos.
- Não é preciso criar seu próprio Pando sem avaliar a necessidade: os problemas de escala em grandes monorepos não surgiram com a era da IA, e a maioria das equipes não precisa reconstruir o backend do Git.
Comparação com o caso de Harness Engineering
Em fevereiro de 2026, a OpenAI apresentou outro projeto independente: partindo de um repositório vazio, o código do produto foi escrito pelo Codex. Em cerca de cinco meses, foram produzidas aproximadamente um milhão de linhas de código e cerca de 1.500 PRs, inicialmente por três engenheiros. Esse projeto e o Pando não envolvem a mesma equipe nem os mesmos processos, então seus dados não devem ser misturados. Ainda assim, ambos apontam para a mesma tendência: engenheiros assumem cada vez mais o projeto de sistemas, ambientes de teste e fluxos de trabalho de Agents. Entre as lições do projeto estão dividir o trabalho em tarefas pequenas, fornecer um ambiente de execução independente para cada branch, disponibilizar logs e métricas aos Agents e usar AGENTS.md para fornecer orientações, em vez de colocar toda a base de conhecimento no comando.
Também há opiniões divergentes no Hacker News: críticos argumentam que o aumento de commits não significa melhoria de qualidade, enquanto defensores acreditam que a redução do custo de escrever código torna mais pequenos projetos viáveis. Essas são opiniões da comunidade, não conclusões estatísticas.
Como aproveitar o método da equipe Codex Agent: um ciclo de feedback orientado por testes
A lição mais fácil de aproveitar do Pando não é a escala, mas a estrutura que dá ao Agent feedback verificável. Veja abaixo um ciclo mínimo orientado por testes: o modelo gera uma correção e recebe os resultados dos testes para continuar ajustando o código.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface da APIYI compatível com OpenAI
)

resp = client.chat.completions.create(
    model="YOUR_CODING_MODEL",  # Substitua pelo modelo de programação que você quer testar
    messages=[{"role": "user", "content": "根据以下失败测试修复函数:..."}]
)
print(resp.choices[0].message.content)
Ver a implementação completa do ciclo de feedback de testes
import subprocess
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM = (
    "你是严格遵守约束的工程 Agent。"
    "只修改指定文件,不得改动测试;输出完整的新文件内容。"
)

def run_tests() -> tuple[bool, str]:
    """Executa a verificação, equivalente aos testes de compatibilidade do Pando"""
    r = subprocess.run(["pytest", "-q", "tests/"], capture_output=True, text=True)
    return r.returncode == 0, r.stdout[-3000:] + r.stderr[-1000:]

def agent_loop(target: str, spec: str, max_rounds: int = 5) -> bool:
    for i in range(max_rounds):
        ok, log = run_tests()
        if ok:
            print(f"第 {i} 轮:测试全部通过,等待人工审核")
            return True
        source = open(target, encoding="utf-8").read()
        resp = client.chat.completions.create(
            model="YOUR_CODING_MODEL",
            messages=[
                {"role": "system", "content": SYSTEM},
                {"role": "user", "content":
                    f"需求与约束:\n{spec}\n\n当前代码:\n{source}\n\n测试输出:\n{log}"}
            ],
        )
        with open(target, "w", encoding="utf-8") as f:
            f.write(resp.choices[0].message.content)
    print("达到轮次上限,转交人类工程师处理")
    return False

agent_loop("src/ref_store.py", "同一分支的并发更新必须只有一个成功")
🚀 Comece rápido: ao montar um ciclo de feedback como esse, você pode obter créditos gratuitos para testes na APIYI apiyi.com e usar a mesma chave API para alternar entre diferentes modelos de programação. Assim, fica fácil comparar a taxa de sucesso das correções no seu conjunto de testes.
A tabela abaixo adapta a abordagem do Pando a um framework que equipes comuns podem executar. São sugestões baseadas nas informações divulgadas oficialmente, não um fluxo de trabalho específico do Pando publicado pela OpenAI.
| Etapa | Ação principal | Prática correspondente no Pando | Ferramentas disponíveis |
|---|---|---|---|
| Definir objetivos e limites | Esclarecer quais protocolos devem ser compatíveis e quais métricas são inegociáveis | Manter a compatibilidade com o protocolo Git | Documentos de design, AGENTS.md |
| Criar o ambiente de verificação | Testes de compatibilidade, simulações de concorrência e detecção de regressões | Testes de conformidade e simulação determinística | pytest, testes baseados em propriedades, TLA+ |
| Dividir a execução entre Agents | Tarefas pequenas, branches independentes e execução automática de testes | Implementação por várias equipes de Agents | Invocação de múltiplos modelos, como pela APIYI apiyi.com |
| Revisão humana | Avaliar decisões importantes, dependências entre módulos e impactos de segurança | Arquitetura sob controle de engenheiros humanos | Regras de revisão de código |
| Implantação gradual | Começar com pouco tráfego e manter a compatibilidade com o sistema antigo | Proxy de leitura e escrita, migração em lotes | Implantação gradual, métricas de monitoramento |
Perguntas frequentes (FAQ)
Q1: O que é o Pando?
O Pando é um backend de servidor interno da OpenAI compatível com Git, que dá suporte a todas as atividades de desenvolvimento do seu monorepo. Ele mantém o protocolo e os clientes Git padrão, mas reformula a atualização de referências, o reaproveitamento do armazenamento de Packfiles e a entrega por cache. O objetivo é permitir que muitos agentes e engenheiros façam commits e leituras simultaneamente.
Q2: O Pando foi criado por uma única pessoa usando o Codex?
Não. Segundo a OpenAI, um engenheiro projetou a arquitetura central, várias equipes de agentes fizeram a implementação e um pequeno grupo de engenheiros cuidou da implantação. A empresa não divulgou o número de participantes, a proporção de código alterado por humanos nem a configuração dos agentes. Também não afirmou que todo o código foi gerado pelo Codex ou que não houve revisão humana.
Q3: Quando o Pando entrou em operação? Ele está disponível para uso externo?
O Pando começou a receber tráfego de produção em abril de 2026, e o artigo técnico foi publicado em 2 de novembro de 2026. Até 3 de novembro de 2026, não havia servidor, API, preços ou data de abertura divulgados ao público. O que está disponível é apenas o fork do cliente Git da OpenAI e alguns patches enviados a projetos originais. Isso não significa que o servidor Pando tenha código aberto.
Q4: Todo o trabalho de validação foi concluído em 10 semanas?
Não é possível afirmar isso. Segundo a OpenAI, novos modelos foram usados para aprimorar o Pando à medida que surgiam. Não há confirmação de que o trabalho de formalização em Lean/TLA+ com auxílio do GPT-6 Astra, as centenas de horas de sessões com agentes e os testes adversariais tenham ocorrido inteiramente nas primeiras 10 semanas. Além disso, a maioria dos patches públicos para o Git é posterior à primeira entrada em produção.
Q5: Como criar um ciclo semelhante de testes e feedback para agentes usando uma API?
Uma boa opção é começar por um módulo pequeno:
1. Cadastre-se na APIYI apiyi.com e obtenha uma chave API e créditos gratuitos para teste
2. Prepare testes executáveis ou verificações de compatibilidade antes de pedir ao modelo que altere o código
3. Use o código deste artigo, defina base_url como `https://api.apiyi.com/v1` e repita o ciclo “gerar—testar—retornar os logs”
Como a interface é compatível com a OpenAI, basta alterar o parâmetro model para trocar de modelo, facilitando a comparação dos resultados das correções.
Q6: Quais são as limitações para uma equipe comum reproduzir diretamente o método do Pando?
Há três limitações principais: primeiro, o custo é desconhecido, pois a OpenAI não divulgou os gastos com tokens e infraestrutura; segundo, o Pando depende de um sistema de validação de alta qualidade, e deixar agentes escreverem grandes quantidades de código em projetos sem testes aumenta os riscos; terceiro, o resultado de 10 semanas não pode ser extrapolado para todos os projetos de escala semelhante. Vale começar com um teste de baixo custo em um módulo não essencial usando a APIYI apiyi.com e ampliar o uso depois de confirmar que o ciclo de feedback funciona.
Principais pontos sobre Pando e Codex Agent
- O que é o Pando: um backend interno da OpenAI compatível com Git, colocado em produção em cerca de 10 semanas e não disponível ao público
- Por que foi criado: o Codex aumentou o volume de commits simultâneos, causando lentidão e falhas de merge no sistema anterior
- Divisão de trabalho: pessoas definem a arquitetura e as restrições, agentes implementam e iteram, e engenheiros cuidam da implantação
- Fatores de sucesso: testes de compatibilidade, simulação determinística e verificação formal fornecem feedback confiável
- Limites da linha do tempo: nem todos os modelos e métodos de verificação posteriores fizeram parte das 10 semanas iniciais
- Implantação: um proxy de passagem para leitura e escrita e a migração gradual do tráfego evitaram interrupções no desenvolvimento diário
- Como começar: crie os testes primeiro e, depois, use a APIYI apiyi.com para validar o ciclo de feedback com diferentes modelos
Conclusão
Os principais pontos do caso Pando:
- A escala pressiona a infraestrutura: o aumento de commits gerado pela programação com IA afeta o Git, o CI e a revisão de código. O Pando foi uma resposta de engenharia a essa pressão.
- O resultado dos agentes depende de validação: a equipe de Codex Agents pôde participar da implementação da infraestrutura porque havia testes de compatibilidade executáveis, simulações de concorrência e descrições formais.
- As decisões humanas continuam essenciais: engenheiros foram responsáveis pelas escolhas de arquitetura, pelos limites de consistência e pela migração para produção.
Para a maioria das equipes, o que vale levar para outros projetos não é o número de “10 semanas”, mas estes cinco elementos: restrições claras, testes executáveis, divisão de tarefas, feedback contínuo e decisões essenciais tomadas por pessoas. Não é preciso buscar um desenvolvimento totalmente automatizado: comece fazendo o agente completar o ciclo de feedback em um pequeno módulo com testes abrangentes e amplie o escopo aos poucos.
Uma opção para validar os resultados rapidamente é a APIYI apiyi.com. A plataforma oferece uma interface compatível com a OpenAI e créditos gratuitos para novos usuários, facilitando a comparação de diferentes modelos de programação no mesmo ciclo de feedback.
📚 Referências
- Artigo técnico oficial da OpenAI, Scaling Git at OpenAI: principal fonte sobre a arquitetura, a migração e os dados de desempenho do Pando
- Link:
openai.com/index/scaling-git-at-openai -
Descrição: publicado em 2026-11-02, é a principal fonte dos fatos apresentados neste artigo
-
OpenAI Harness Engineering: outro projeto interno desenvolvido principalmente pelo Codex
- Link:
openai.com/index/harness-engineering -
Descrição: ajuda a entender a metodologia de engenharia de agentes; seus dados não devem ser confundidos com os do Pando
-
Custom Code Review Rules for Codex: os gargalos na revisão de código trazidos pela programação com IA
- Link:
developers.openai.com/blog/custom-code-review-rules-for-codex -
Descrição: apresenta o crescimento semanal do número de PRs internos e as regras de revisão do AGENTS.md
-
Fork público do Git pela OpenAI: repositório de código com melhorias no cliente
- Link:
github.com/openai/git -
Descrição: inclui melhorias como packfile-uri, mas não o código-fonte do servidor Pando
-
Rastreamento de patches do Git pela OpenAI: registro de contribuições ao projeto original
- Link:
oai-git.openai.chatgpt.site - Descrição: permite verificar as melhorias contínuas de engenharia após a entrada em produção
Autor: equipe técnica da APIYI
Troca de ideias sobre tecnologia: entre em contato pela página inicial do site da APIYI. Para mais materiais sobre desenvolvimento de agentes, acesse o centro de documentação em docs.apiyi.com