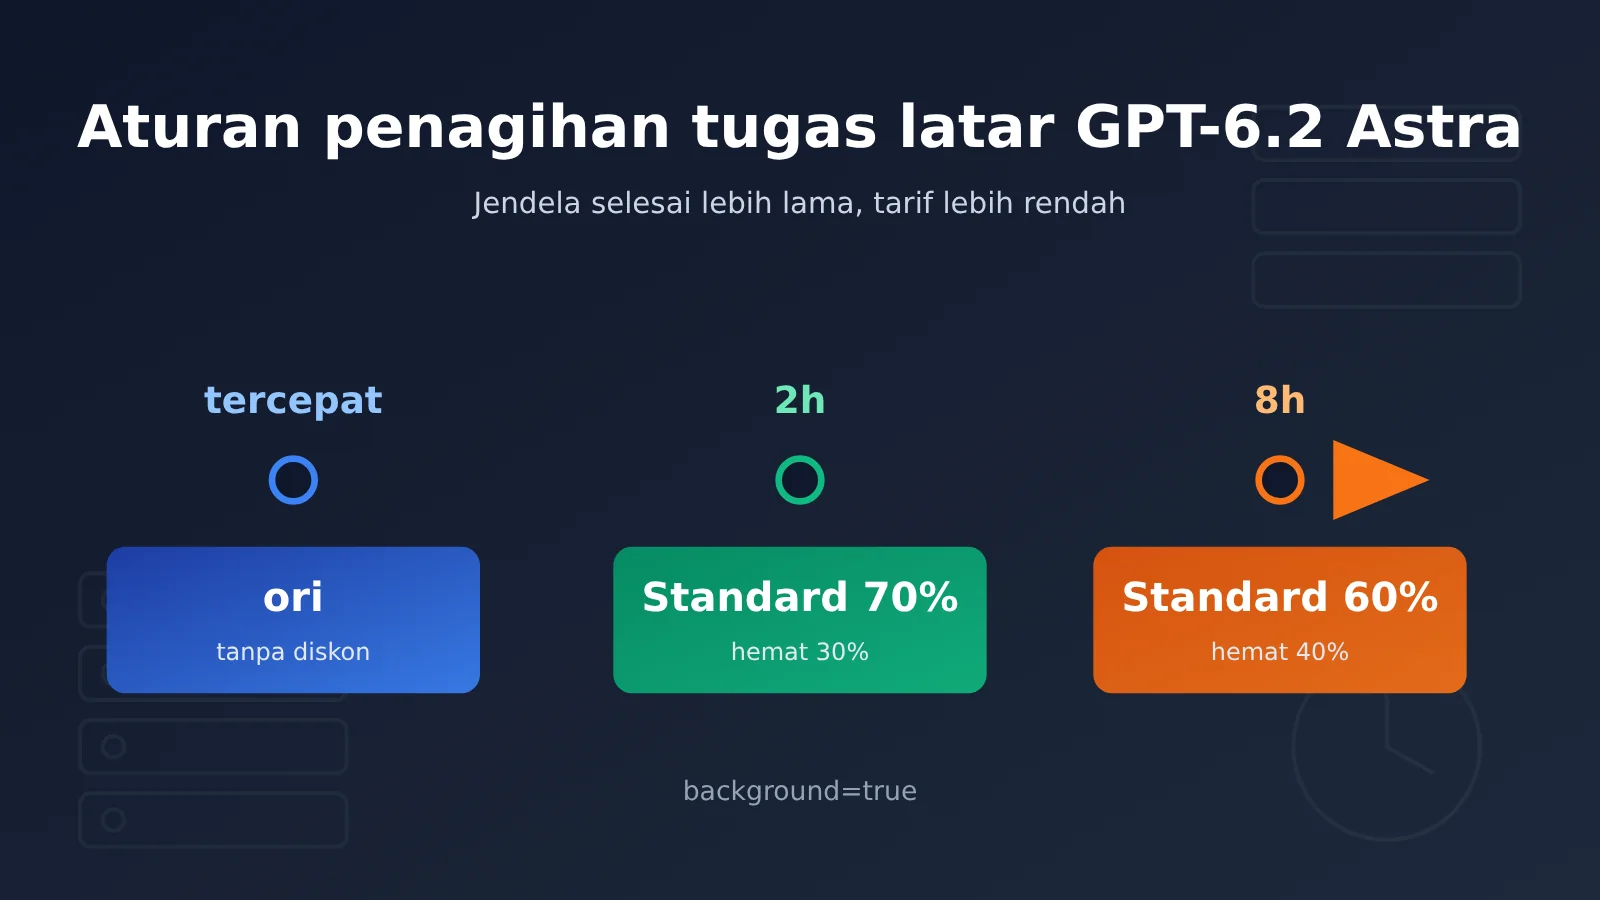
Aturan penagihan tugas latar belakang GPT-6.2 Astra bisa diringkas dalam satu kalimat: kalau bisa menunggu, lebih murah. Mulai 17 November 2026, jendela penyelesaian latar belakang di Responses API memasuki tahap uji publik. Jendela soonest default ditagih dengan harga penuh sesuai tingkat pemrosesan yang digunakan; permintaan yang memenuhi syarat dengan jendela 2 jam ditagih 70% dari tarif token model Standard, dan jendela 8 jam ditagih 60%, artinya masing-masing 30% dan 40% lebih murah.
Tingkat mana yang dipilih bergantung pada dua pertanyaan: kapan paling lambat hasilnya dibutuhkan, dan apakah antarpermintaan perlu bergantung pada hasil antara dari langkah sebelumnya. Jawab dua pertanyaan ini dulu, lalu perkirakan biaya berdasarkan pemakaian — itu lebih andal daripada langsung membandingkan harga satuan.
Apa yang bisa Anda pelajari dari artikel ini?
- Definisi, titik awal penghitungan waktu, dan dasar penagihan untuk tiga jendela penyelesaian: soonest, 2h, dan 8h
- Biaya konkret untuk pemakaian yang sama (100 ribu token input + 10 ribu token output) pada 7 mode
- Syarat parameter yang harus dipenuhi agar permintaan mendapat diskon, serta batas kuota antrean dan penggunaan ulang cache
- Metode pengiriman yang cocok untuk tanya jawab interaktif, ringkasan tiket, peninjauan semalam, dan tugas klasifikasi mandiri
Panduan navigasi: mulailah dengan satu tabel konsep dan ringkasan dampak untuk menyamakan istilah. Bagian «Fakta Objektif» menjelaskan berturut-turut aturan jendela penyelesaian, harga tiap tingkat, syarat diskon, dan penanganan langkah lanjutan dalam alur kerja multi-langkah. Bagian «Analisis dan Penilaian» membahas apakah diskon bisa ditumpuk, anggaran waktu untuk tugas multi-langkah, trade-off yang muncul dari cache dan kuota antrean, serta memberikan saran pemilihan tingkat berdasarkan beban kerja.
GPT-6.2 Astra Penagihan Tugas Latar Belakang yang Perlu Diketahui: Penjelasan Konsep
| Konsep | Penjelasan singkat |
|---|---|
| Standard | Tingkat pemrosesan standar OpenAI API; diskon untuk jendela latar belakang 2h dan 8h mengacu pada tarif modelnya. |
| Fast | Tingkat percepatan Astra saat ini; tarif token modelnya 2 kali Standard. |
| Ultrafast | Tingkat pemrosesan yang lebih cepat; selama periode promosi 3 kali Standard, setelah itu harga resminya 6 kali. |
| Mode latar belakang | Permintaan pertama-tama mengembalikan ID respons; aplikasi nanti menanyakan status dan mengambil hasilnya. |
| Jendela penyelesaian | Target penyelesaian yang dipakai untuk penjadwalan setelah respons latar belakang diterima; terbagi menjadi soonest, 2h, dan 8h. |
| soonest | Jendela default untuk permintaan latar belakang, dijalankan secepat mungkin, dan menggunakan tarif model dari tingkat pemrosesan yang dipakai. |
| Batch API | Memasukkan permintaan yang saling independen ke dalam file JSONL dan menjalankannya secara asinkron sebagai satu pekerjaan. |
| continuation_id | Pengenal yang ditetapkan aplikasi untuk alur kerja latar belakang yang sama, dipakai untuk mengaitkan permintaan lanjutan yang memenuhi syarat. |
| Tarif token model | Harga satuan untuk tiap item pengukuran seperti input biasa, input cache hit, dan output. |
GPT-6.2 Astra: Ringkasan Dampak Penagihan Tugas Latar Belakang
- Pengembang API: Tugas asinkron kini memiliki dua opsi diskon di antara panggilan real-time dan Batch, tetapi perlu diubah ke mode latar belakang dan menangani polling atau webhook.
- Manajer produk: Perlu memperjelas dalam persyaratan produk kapan hasil paling lambat tersedia. Untuk fitur yang dapat menerima hasil dalam 2 jam atau 8 jam, biaya token model masing-masing dapat turun 30% atau 40%.
- Penanggung jawab biaya dan operasional: 2h, 8h, dan Batch berbagi satu kuota antrean; pekerjaan Batch bervolume besar dan tugas dengan diskon latar belakang perlu direncanakan secara terpadu, tidak bisa masing-masing memperkirakan kapasitas secara terpisah.
Fakta Objektif: Aturan Penagihan Tugas Latar Belakang GPT-6.2 Astra
Apa Saja Tiga Jendela Penyelesaian untuk Tugas Latar Belakang GPT-6.2 Astra?
OpenAI merilis GPT-6.2 Astra dan GPT-6.2 Sol pada 17 November 2026. Astra ditujukan untuk penalaran kompleks, penulisan kode, dan pekerjaan profesional, dengan ID model API gpt-6.2-astra. Pada hari yang sama, catatan perubahan API OpenAI mencatat bahwa jendela penyelesaian latar belakang Responses API memasuki uji publik.
Permintaan asinkron Astra perlu menyetel background=true, dan jendelanya dibagi menjadi tiga:
- soonest (default): dijalankan secepat mungkin; token model ditagih berdasarkan tingkat pemrosesan yang benar-benar digunakan, tanpa diskon.
- 2h: permintaan yang memenuhi syarat ditagih sebesar 70% dari tarif token model Standard.
- 8h: permintaan yang memenuhi syarat ditagih sebesar 60% dari tarif token model Standard.
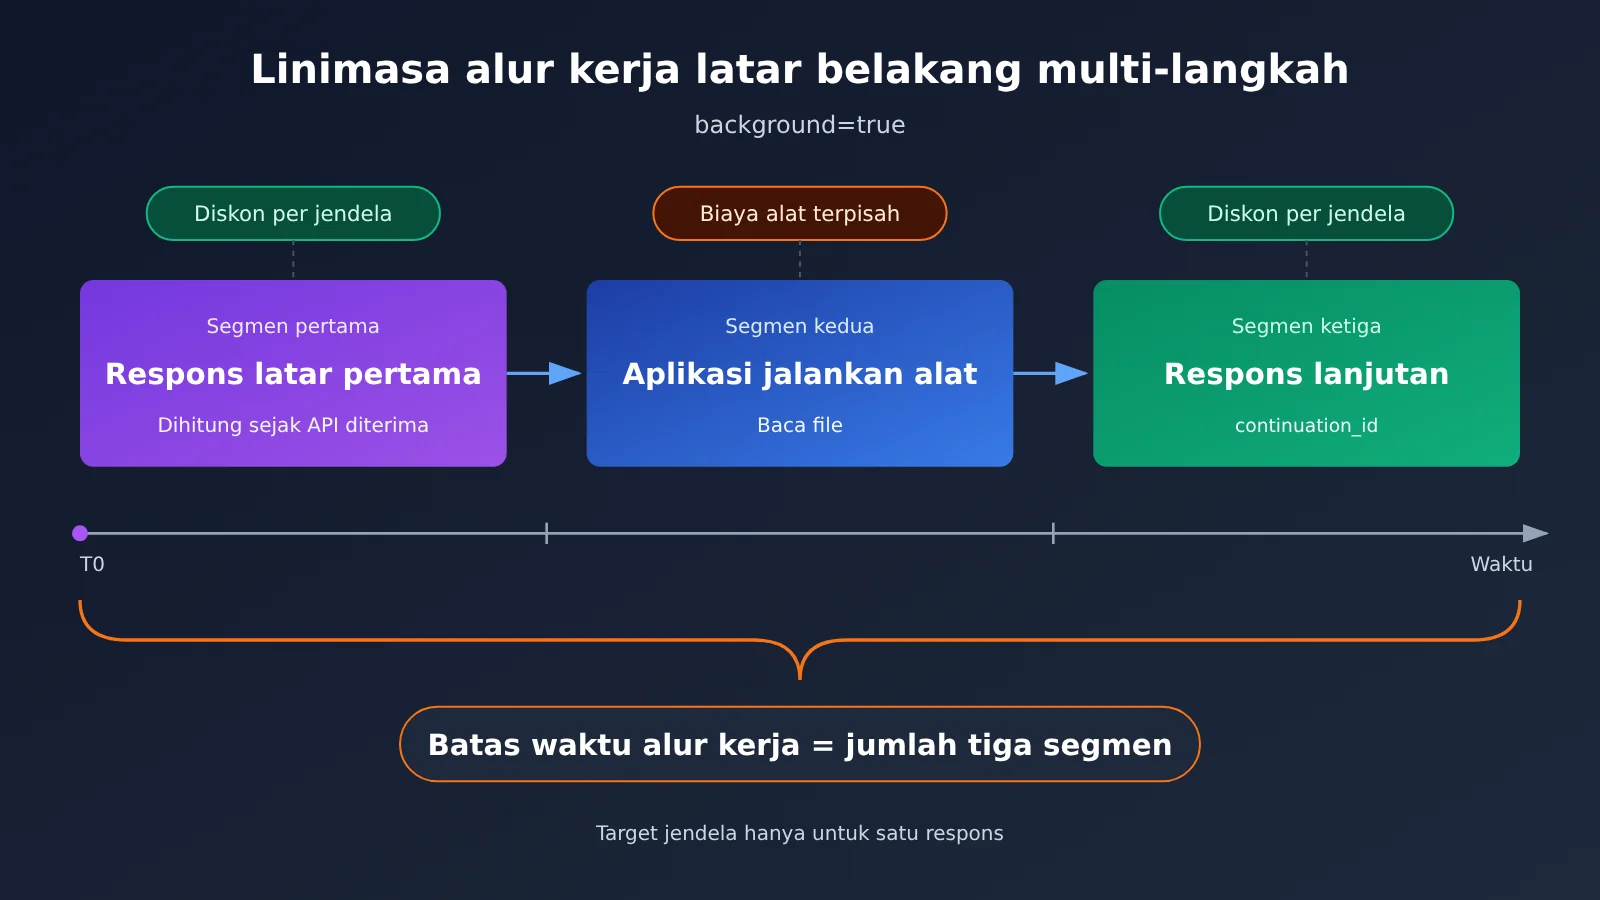
Titik awal penghitungan waktu adalah saat API menerima permintaan awal, dan target jendela berlaku untuk respons ini. Jika tugas mengharuskan aplikasi menjalankan alat di tengah proses, lalu mengirim respons berikutnya, waktu eksekusi bagian ini dan langkah lanjutan harus dihitung terpisah dalam batas waktu keseluruhan alur kerja.
Ambil contoh “periksa file dulu, lalu lanjutkan peninjauan”: respons pertama selesai dalam jendela dan mengembalikan pemanggilan alat yang perlu dijalankan oleh aplikasi. Setelah aplikasi membaca file, hasilnya dikirim sebagai permintaan lanjutan, lalu model melanjutkan peninjauan. Total waktu keseluruhan sama dengan jumlah dari tiga bagian—respons pertama, eksekusi alat, dan respons langkah lanjutan—bukan hanya satu jendela.
Berapa biaya satu permintaan yang sama untuk setiap tier GPT-6.2 Astra
Tabel berikut menunjukkan tarif konteks pendek GPT-6.2 Astra, dalam dolar per juta token. Baris 2h dan 8h dihitung dari proporsi diskon resmi; tanggal harga Ultrafast dihitung berdasarkan waktu Pasifik AS.
| Mode | Relatif terhadap Standard | Input biasa | Input cache hit | Output |
|---|---|---|---|---|
| Standard | 1 kali | $8.00 | $0.40 | $40.00 |
| Fast | 2 kali | $16.00 | $0.80 | $80.00 |
| Ultrafast (hingga 2027-02-28) | 3 kali | $24.00 | $1.20 | $120.00 |
| Ultrafast (mulai 2027-03-01) | 6 kali | $48.00 | $2.40 | $240.00 |
| Background 2h | 0,70 kali | $5.60 | $0.28 | $28.00 |
| Background 8h | 0,60 kali | $4.80 | $0.24 | $24.00 |
| Batch | 0,50 kali | $4.00 | $0.20 | $20.00 |
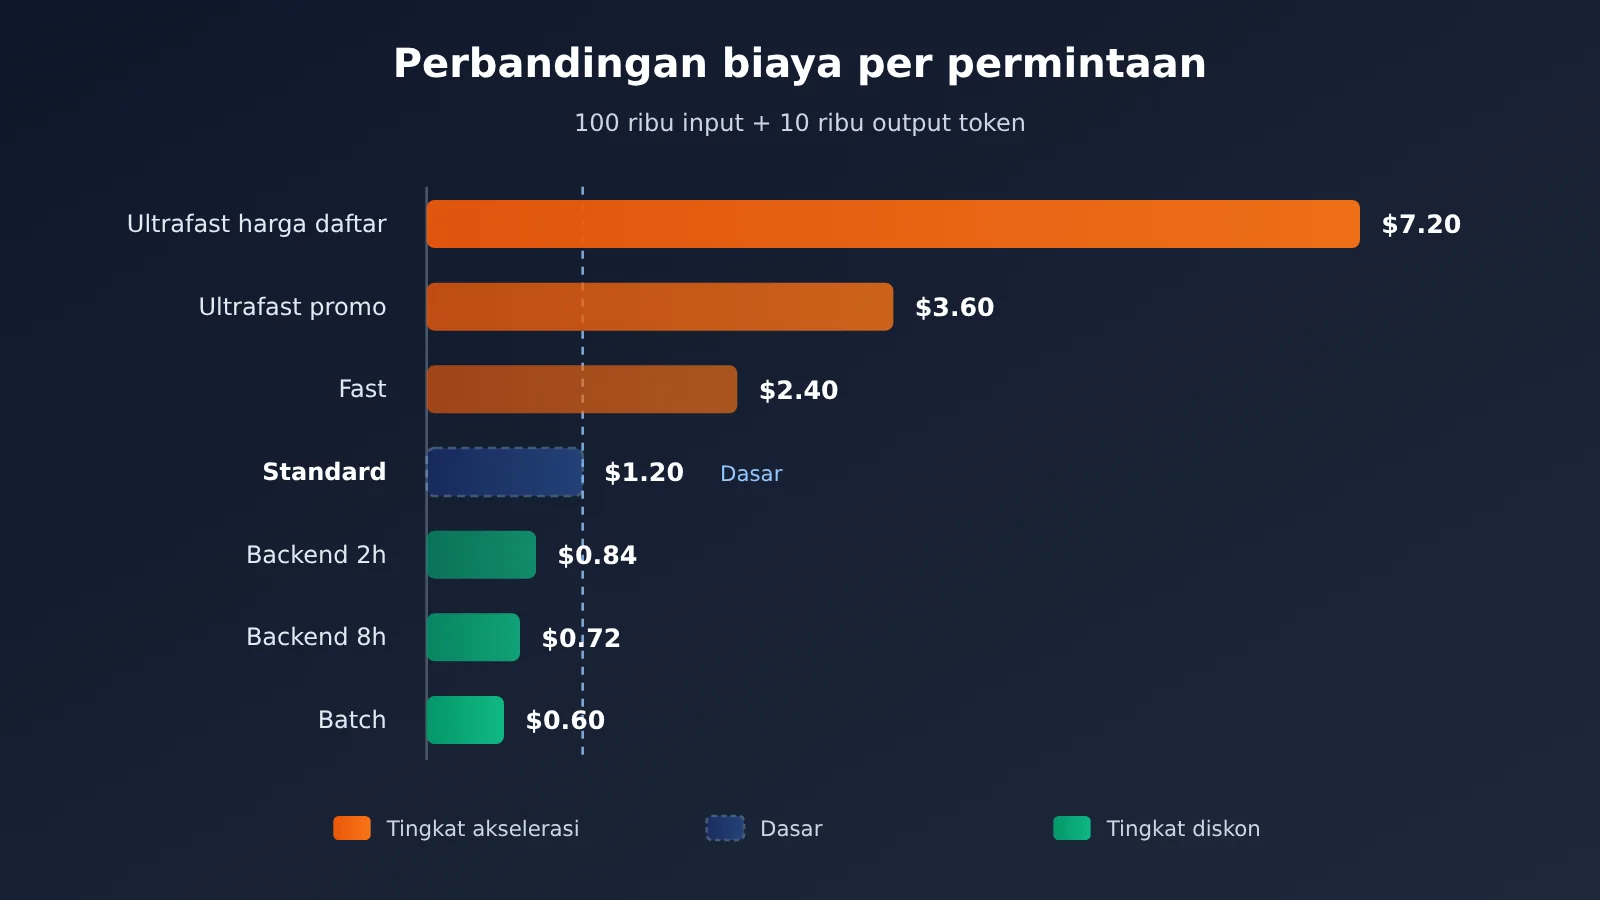
Kami menggunakan volume penggunaan tetap sebagai pembanding: 100.000 token input biasa + 10.000 token output yang ditagih. Perhitungan Standard adalah 0,1 × $8 + 0,01 × $40 = $1,20, dan tier lainnya dikonversi dengan cara yang sama:
| Mode | Biaya token model per permintaan | Selisih relatif terhadap Standard |
|---|---|---|
| Harga tercantum Ultrafast | $7.20 | +$6.00 |
| Harga promo Ultrafast | $3.60 | +$2.40 |
| Fast | $2.40 | +$1.20 |
| Standard | $1.20 | Acuan |
| Background 2h | $0.84 | −$0.36 |
| Background 8h | $0.72 | −$0.48 |
| Batch | $0.60 | −$0.60 |
Contoh ini hanya menghitung token model. Panggilan Web Search, kontainer Shell / Code Interpreter, dan biaya lainnya dihitung terpisah per item masing-masing; penulisan cache juga dihitung terpisah.
Selain itu, kartu model mencatat: ketika input melebihi 272K token, seluruh permintaan dikenai tarif konteks panjang, harga input dan cache dikalikan 2, harga output dikalikan 1,5, lalu dihitung berdasarkan tier yang dipilih atau diskon yang memenuhi syarat. Menurut aturan ini, permintaan konteks panjang dalam jendela 8h memiliki input biasa sebesar $16 × 0,6 = $9,6 dan output sebesar $60 × 0,6 = $36 (per juta token).
Tarif di atas dihitung berdasarkan daftar harga resmi OpenAI dan proporsi diskon. Jika Anda memanggil melalui APIYI apiyi.com, penyelesaian aktual mengikuti halaman penagihan platform; sebaiknya verifikasi tagihan terlebih dahulu dengan volume kecil sebelum diterapkan ke lingkungan produksi.
Cara Membuat Permintaan GPT-6.2 Astra Memenuhi Diskon Penagihan Backend
Diskon tidak berlaku secara otomatis; Anda harus memenuhi semua kondisi berikut secara bersamaan:
| Parameter / Kondisi | Nilai yang Memenuhi Syarat | Keterangan |
|---|---|---|
| Endpoint | /v1/responses |
Jendela penyelesaian backend mengikuti Responses API |
background |
true |
Masuk ke mode background, mengembalikan response ID terlebih dahulu |
background_options.completion_window |
2h atau 8h |
Default soonest tidak mendapat diskon |
service_tier |
default(Standard) |
auto hanya memenuhi syarat jika akhirnya menggunakan Standard |
stream |
Dihilangkan atau false |
Output streaming tidak memenuhi syarat diskon |
Dari sisi kuota, 2h, 8h, dan Batch berbagi kuota antrean Batch/Background, dihitung berdasarkan token input saat masuk antrean; soonest menggunakan batas jumlah permintaan dan token reguler. Ada satu batasan terkait cache: permintaan reguler Standard tidak dapat menggunakan ulang cache petunjuk yang dibuat oleh dua jendela diskon ini. Perhatikan juga bahwa kartu model menyatakan permintaan dengan reasoning.effort disetel ke none akan ditolak.
Berikut contoh minimal. background_options mungkin belum tercantum dalam definisi tipe SDK, jadi masukkan melalui extra_body:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka kompatibel OpenAI APIYI
)

resp = client.responses.create(
    model="gpt-6.2-astra",
    input="Tolong rangkum masalah umum dari 50 tiket dukungan berikut……",
    background=True,
    service_tier="default",          # Menggunakan Standard, memenuhi syarat diskon
    extra_body={"background_options": {"completion_window": "2h"}},
)
print(resp.id, resp.status)  # Simpan response ID, ambil kembali nanti
Setelah mendapatkan response ID, Anda dapat membaca status melalui webhook atau polling. Saat statusnya queued atau in_progress, teruskan kueri dengan ID yang sama; kesalahan kapasitas yang memenuhi syarat akan diulang secara otomatis oleh API, tidak perlu aplikasi mengirim ulang sendiri.
Lihat contoh lengkap polling dan permintaan tindak lanjut
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Akses terpadu melalui APIYI
)

WINDOW = "8h"

def submit(input_items, previous_id=None):
    """Mengirim satu permintaan diskon background.
    Untuk posisi parameter konkret continuation_id, ikuti panduan OpenAI Background mode."""
    return client.responses.create(
        model="gpt-6.2-astra",
        input=input_items,
        background=True,
        service_tier="default",
        previous_response_id=previous_id,
        extra_body={
            "background_options": {"completion_window": WINDOW},
            # "continuation_id": "audit-2026-11-19-batch-01",  # Konsisten dalam alur kerja yang sama
        },
    )

def wait(response_id, interval=60):
    """Polling hingga selesai; saat queued / in_progress gunakan ID yang sama untuk melanjutkan kueri."""
    while True:
        r = client.responses.retrieve(response_id)
        if r.status not in ("queued", "in_progress"):
            return r
        time.sleep(interval)

first = wait(submit("Tinjau kontrak, panggil alat read_file untuk membaca lampiran bila perlu").id)

# Jika mengembalikan pemanggilan alat yang menjadi tanggung jawab aplikasi: aplikasi menjalankan alat, lalu
# ajukan permintaan tindak lanjut dengan proyek, model, tier pemrosesan, jendela, dan continuation_id yang sama;
# langkah lanjutan dapat memperoleh hak antrean prioritas
for item in first.output:
    if item.type == "function_call":
        tool_result = "……isi sebenarnya yang dikembalikan read_file……"
        follow = submit(
            [{"type": "function_call_output",
              "call_id": item.call_id,
              "output": tool_result}],
            previous_id=first.id,
        )
        print(wait(follow.id).output_text)
Dalam alur kerja multi-langkah, permintaan langkah lanjutan harus menggunakan proyek, model, tier pemrosesan, jendela, dan continuation_id yang sama agar memenuhi syarat antrean prioritas. Permintaan tindak lanjut yang memenuhi syarat akan ditagih masing-masing sesuai diskon yang berlaku.
🚀 Saran integrasi: Jendela penyelesaian di latar belakang saat ini merupakan kemampuan beta publik dari OpenAI Responses API. Saat memanggil melalui platform agregator seperti APIYI apiyi.com, disarankan untuk lebih dulu memakai kuota uji gratis untuk memastikan parameter
backgrounddancompletion_windowditeruskan secara utuh, serta apakah penagihan dihitung dengan diskon, baru kemudian memindahkan tugas produksi.
Analisis dan penilaian: cara memanfaatkan penagihan tugas latar belakang GPT-6.2 Astra dengan baik
Diskon latar belakang dan tier akselerasi GPT-6.2 Astra tidak dapat digunakan bersamaan
Syarat diskon mengharuskan service_tier bernilai default, atau auto yang pada akhirnya jatuh ke Standard. Dari sini bisa disimpulkan: Fast dan Ultrafast tidak bisa menikmati diskon 2h dan 8h sekaligus. Trade-off-nya jelas: tier akselerasi menukar biaya lebih tinggi dengan latensi lebih pendek, sedangkan jendela latar belakang menukar waktu tunggu lebih lama dengan harga lebih rendah—keduanya bergerak ke arah yang berlawanan.
Ada satu detail yang mudah terlewat: meskipun soonest juga merupakan mode latar belakang, harganya mengikuti tier pemrosesan. Jika soonest dipadukan dengan Fast, Anda tetap membayar harga Fast, hanya saja interaksinya menjadi asinkron. Fungsi soonest adalah mengembalikan kendali antarmuka kepada pengguna lebih dulu; soonest sendiri tidak menghemat biaya.
Tugas multi-langkah harus dianggarkan waktunya berdasarkan「seluruh alur kerja」
Target jendela hanya membatasi satu respons, tidak mencakup seluruh alur kerja. Tugas peninjauan yang membutuhkan tiga putaran pemanggilan tool secara teoretis dapat melewati penjadwalan jendela tiga kali, ditambah waktu aplikasi mengeksekusi tool itu sendiri. Jika bisnis menjanjikan「hasil keluar sebelum pukul 9 pagi」, saat memproses tugas semalam dengan jendela 8h, waktu pengajuan perlu menyisakan ruang untuk langkah lanjutan; jangan mengajukan tepat di batas 8 jam.
Di sinilah nilai continuation_id. Ia tidak memperpanjang atau menggabungkan jendela, tetapi memberi langkah lanjutan hak antrean prioritas, sehingga mempersingkat waktu tunggu di bagian akhir alur multi-langkah. Secara teknis, disarankan memetakan continuation_id satu-ke-satu dengan ID tugas bisnis; ini juga memudahkan penelusuran log dan pengelompokan biaya.
8h vs Batch: Selisih 10 poin persen, skenario penggunaan berbeda
Pada contoh penggunaan, 8h adalah $0.72 dan Batch $0.60, selisihnya hanya $0.12. Batch lebih murah, tetapi mengharuskan permintaan disusun lebih dulu menjadi JSONL, saling independen, dan mampu menerima jendela pengiriman 24 jam. 8h memungkinkan permintaan melanjutkan penalaran berdasarkan hasil alat.
Karena itu, dasar penentuannya bukan mana yang lebih murah, melainkan struktur tugas:
- Ada ketergantungan antarpermintaan (langkah berikutnya perlu melihat hasil langkah sebelumnya): pilih 8h atau 2h
- Permintaan saling independen dan bisa didaftar sekaligus: pilih Batch
Diskon setengah harga Batch dan diskon jendela latar belakang adalah dua jalur penagihan yang independen dan tidak saling bertumpuk.
Biaya tersembunyi akibat cache dan kuota antrean
Cache petunjuk yang dibuat di jendela diskon tidak dapat dipakai ulang oleh permintaan Standard biasa. Jika petunjuk sistem panjang yang sama dipakai baik untuk tanya jawab real-time maupun pemrosesan batch latar belakang, kedua sisi akan membangun cache masing-masing, dan biaya penulisan cache bisa terjadi berulang. Selain itu, input yang kena cache hit memang sudah murah: Standard $0.40, 8h $0.24. Untuk beban kerja dengan tingkat cache hit tinggi, proporsi penghematan diskon latar belakang pada total tagihan akan lebih rendah dibandingkan tugas yang padat output.
Kuota antrean yang dibagi bersama juga perlu direncanakan sejak awal. 2h, 8h, dan Batch berbagi kuota Batch/Background dan dihitung masuk antrean berdasarkan token input. Jika pada malam hari sekaligus mengirim banyak pekerjaan Batch dan alur审核 8h, keduanya akan berebut kuota yang sama.
💡 Saran biaya: sebelum menentukan tingkatan, gunakan distribusi token dari prompt nyata (proporsi input biasa, input cache hit, dan output) untuk mengestimasi biaya tiap tingkatan. Dengan antarmuka terpadu APIYI apiyi.com, satu set kode yang sama cukup mengubah parameter untuk membandingkan perbedaan tagihan antara jalur real-time dan asinkron.
Menempatkan tingkat layanan GPT-6.2 Astra ke dalam beban kerja nyata
Berikut adalah ilustrasi beban kerja; kondisi keputusannya secara berurutan adalah: berapa lama bisa menunggu, apakah bergantung pada hasil antara, dan apakah ada biaya alat.
| Beban kerja | Cara pengiriman yang direkomendasikan | Dasar |
|---|---|---|
| Tanya jawab interaktif langsung, analisis yang ditunggu orang | Mulai dari Standard; pertimbangkan Fast / Ultrafast setelah memverifikasi latensi dan biaya | Pengguna sedang menunggu, menaikkan harga demi kecepatan perlu didukung data |
| Antarmuka asinkron, ingin mengembalikan lebih dulu lalu menampilkan hasil | soonest | Mengembalikan kendali, harga mengikuti tingkat pemrosesan yang digunakan |
| Ringkasan tiket dukungan yang harus selesai sebelum sore | Latar belakang 2 jam | Diserahkan dalam beberapa jam, biaya token model turun 30% |
| Peninjauan multi-langkah yang boleh semalam dan perlu memanggil alat | Latar belakang 8 jam + continuation_id | Turun 40%, sekaligus menyediakan waktu untuk eksekusi alat dan kelanjutan langkah |
| Tugas klasifikasi independen yang bisa dirakit lebih awal | Batch (JSONL) | Saling independen dan menerima jendela 24 jam, turun 50% |
Perlu diperhatikan, begitu tugas menggunakan Web Search atau kontainer Code Interpreter, biaya bagian tersebut tidak mendapatkan diskon token model. Semakin tinggi porsi biaya alat, semakin rendah proporsi penghematan keseluruhan dari jendela latar belakang.
🎯 Saran pemilihan: Jalankan dulu Standard, 2 jam, dan 8 jam secara terpisah di APIYI apiyi.com menggunakan batch sampel yang sama, catat waktu penyelesaian aktual dan tagihan, lalu tentukan tingkat default untuk setiap jenis tugas. Ini lebih mendekati biaya sebenarnya dibandingkan hanya melihat tabel harga satuan.
Perubahan yang perlu terus dipantau
Jendela penyelesaian di latar belakang (background) saat ini masih dalam tahap beta publik. Nama parameter, syarat kelayakan, dan persentase diskon bisa saja berubah sebelum rilis resmi, jadi sebelum peluncuran sebaiknya mengacu pada panduan resmi OpenAI. Ada dua titik waktu lain yang juga layak dicatat: harga promosi Ultrafast berlaku hingga 28 Februari 2027 (waktu Pasifik), dan mulai 1 Maret tarifnya naik dari 3x menjadi 6x. Produk yang bergantung pada Ultrafast dalam jangka panjang perlu mengevaluasi anggaran lebih awal. GPT-6.2 Astra dan Sol saat ini belum punya tier Flex; kalau nanti tersedia, pilihan untuk tugas asinkron akan lebih banyak.
Bagi tim yang sedang merencanakan kemampuan asinkron Astra, Anda bisa lebih dulu menjalankan mode background dan logika polling memakai kuota uji di APIYI apiyi.com, menuliskan tenggat waktu dan dependensi tugas ke dalam dokumen kebutuhan, baru setelah itu membicarakan soal tier.
《论语·子路》 (Analek Lunyu, pasal Zilu) mengatakan: “欲速则不达” — terburu-buru justru membuat tujuan tak tercapai. Pada daftar harga GPT-6.2 Astra, kalimat itu seolah punya angka: bersedia menunggu beberapa jam lebih lama berarti bisa membayar biaya model tiga sampai empat puluh persen lebih murah.
📚 Referensi
-
Pengumuman rilis OpenAI: Introducing GPT-6.2 Astra and Sol (2026-11-17)
- Tautan:
openai.com/index/introducing-gpt-6-2-astra-sol/ - Keterangan: penjelasan posisi model dan penyesuaian harga
- Tautan:
-
Kartu model GPT-6.2 Astra: spesifikasi, tarif konteks pendek dan konteks panjang
- Tautan:
developers.openai.com/api/docs/models/gpt-6.2-astra - Keterangan: panjang konteks, aturan penetapan harga konteks panjang 272K
- Tautan:
-
Changelog API OpenAI: entri rilis model dan jendela background 2026-11-17
- Tautan:
developers.openai.com/api/docs/changelog - Keterangan: beta publik jendela penyelesaian background dan persentase diskon
- Tautan:
-
Daftar harga API OpenAI: harga satuan tiap tier pemrosesan
- Tautan:
developers.openai.com/api/docs/pricing - Keterangan: tarif Standard, Fast, Ultrafast, Batch
- Tautan:
-
Panduan Background mode: mode background, jendela penyelesaian, dan permintaan lanjutan
- Tautan:
developers.openai.com/api/docs/guides/background - Keterangan: syarat diskon, continuation_id, kuota antrean, dan batas cache
- Tautan:
-
Panduan Batch API / Fast / Ultrafast
- Tautan:
developers.openai.com/api/docs/guides/batch,developers.openai.com/api/docs/guides/fast-mode,developers.openai.com/api/docs/guides/ultrafast-mode - Keterangan: syarat penggunaan tiap cara pengiriman
- Tautan:
Penulis: Tim Teknis APIYI
Komunikasi teknis: Silakan hubungi kami lewat halaman utama APIYI apiyi.com; materi integrasi lainnya bisa diakses di pusat dokumentasi docs.apiyi.com