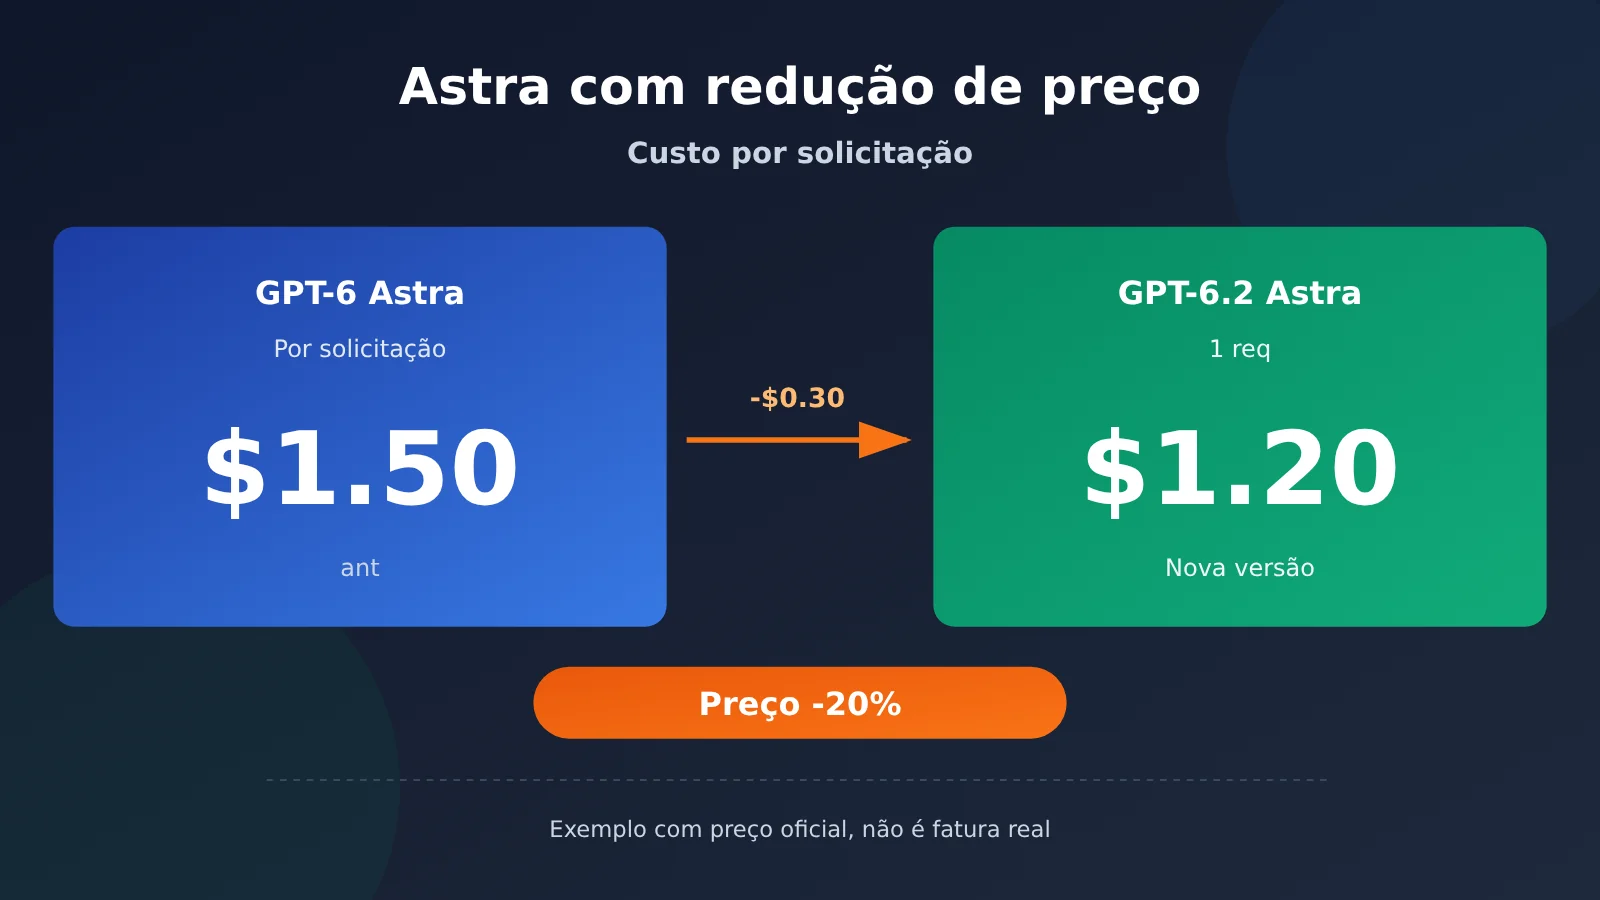
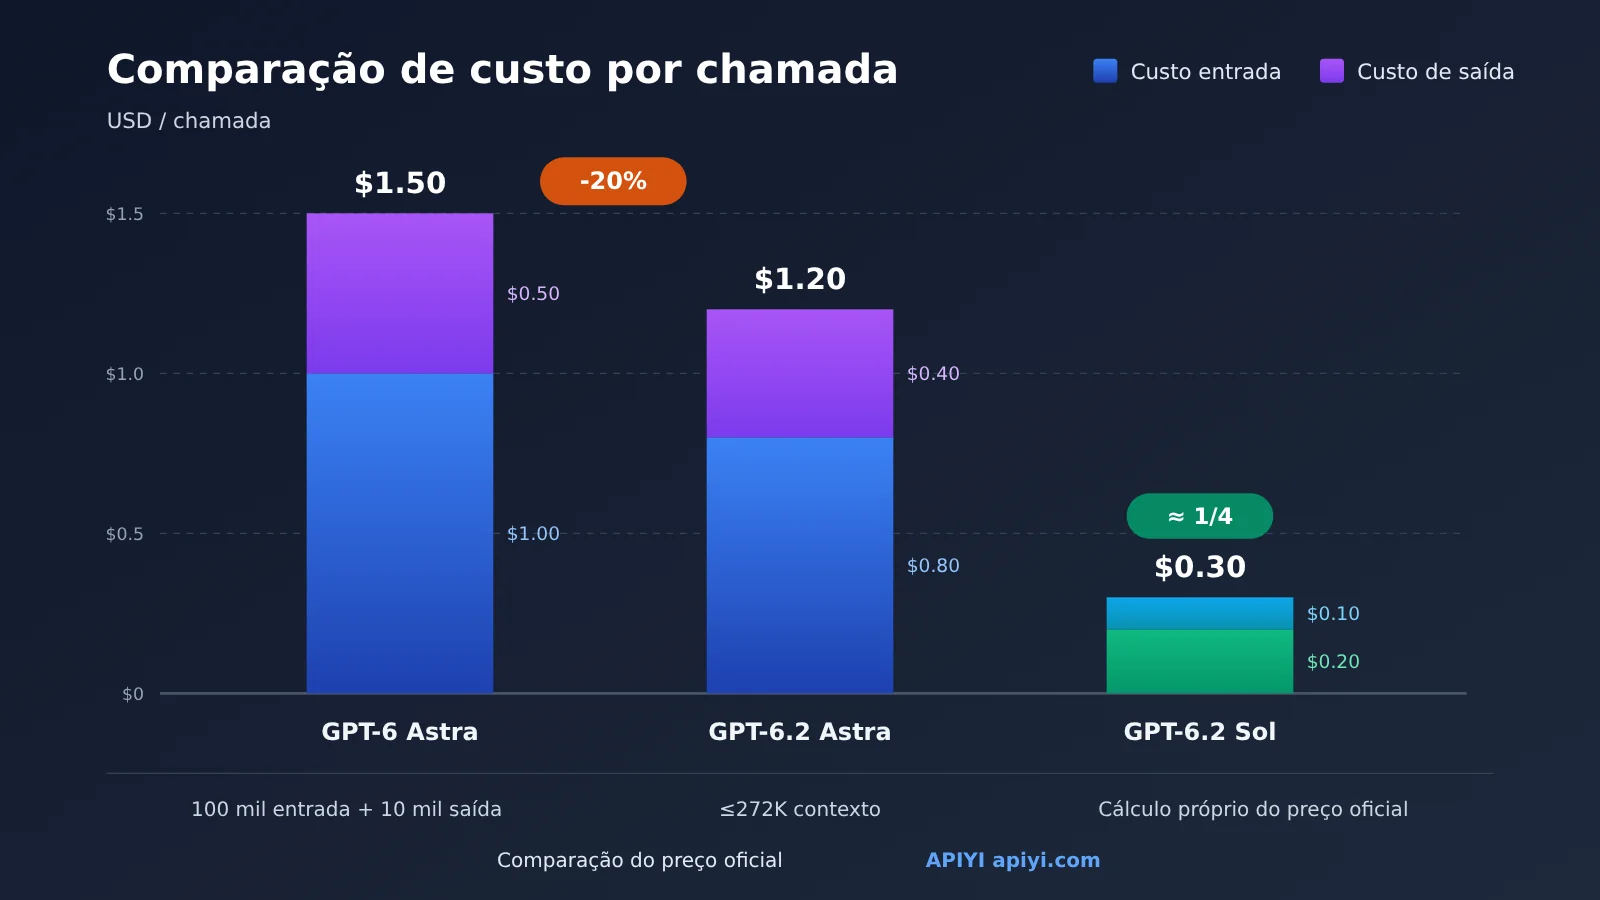
Vamos tomar como exemplo uma requisição padrão sem cache, com 100 mil tokens de entrada + 10 mil tokens de saída e entrada não superior a 272K: calculando pelos preços unitários padrão oficiais, o GPT-6 Astra custa cerca de $1.50, o GPT-6.2 Astra cerca de $1.20, uma economia de $0.30 por chamada, exatamente 20%. Com a mesma quantidade de tokens, usar o GPT-6.2 Sol sai por apenas cerca de $0.30. Vale notar que isso é uma “queda de 20% no preço unitário”. Cache, faixas de contexto longo, volume de saída de raciocínio, chamadas de ferramentas e outros fatores afetam o custo final; a fatura real não necessariamente cai 20% na mesma proporção.
O que você vai aprender ao ler este artigo?
- Quais são os preços padrão oficiais do GPT-6.2 Astra e do GPT-6.2 Sol, modelos lançados pela OpenAI em 17 de novembro de 2026.
- Como se calcula o custo de uma chamada à API: cada multiplicação, cada conversão de unidades e as premissas adotadas.
- Quanto a leitura de cache, o contexto longo acima de 272K e as variações na quantidade de tokens de saída podem fazer o custo real se afastar da “redução de 20%”.
- Como desenvolvedores e responsáveis pelo orçamento devem reestimar seus custos de chamada.
Índice: este artigo começa contextualizando com uma tabela conceitual e um resumo de impactos; a primeira parte, “Fatos objetivos”, reúne as informações oficiais do lançamento, a tabela de preços e as avaliações oficiais, além de apresentar três exemplos de cálculo feitos por nós com base nos preços unitários oficiais; a segunda parte, “Análise e julgamento”, explica a diferença entre a redução do preço unitário e a redução da fatura, oferece recomendações de ação para diferentes perfis e inclui um trecho de código de estimativa de custos que pode ser executado diretamente.
Conceitos relacionados ao corte de preço do GPT-6.2 Astra
| Conceito | Explicação resumida |
|---|---|
| Token | Unidade básica de cobrança e processamento de texto do modelo; a API é precificada “por milhão de tokens” |
| Entrada não armazenada em cache | Neste artigo, refere-se à parte comum da entrada que não é cobrada como leitura de cache nem como gravação em cache |
| Leitura de cache | Parte da solicitação que aciona o cache de comandos, com preço unitário bem abaixo da entrada não armazenada em cache |
| Gravação em cache | Os tokens gravados usam uma tarifa total independente; o mesmo token não acumula a taxa de entrada comum |
| Escalonamento de contexto longo | Quando a entrada ultrapassa 272K tokens, as tarifas de entrada e de cache de toda a solicitação passam a ser 2x, e a tarifa de saída passa a 1,5x |
| Nível de raciocínio | Intensidade de raciocínio que o modelo aplica antes de responder; quanto maior o nível, mais tokens costuma consumir |
| GDPval v2 / ALE / FrontierCode 2.0 | Três avaliações citadas pela OpenAI no lançamento, com objetos e critérios diferentes; os resultados não podem ser convertidos entre si |
Visão rápida do impacto do corte de 20% no preço do GPT-6.2 Astra
| Público | Principais impactos |
|---|---|
| Desenvolvedores de API | Em solicitações de comprimento normal, os preços unitários de entrada e saída do Astra caem 20%, e o custo para o mesmo volume de invocações diminui na mesma proporção; solicitações com contexto muito longo precisam ser calculadas separadamente |
| Responsáveis pelo orçamento | Podem reavaliar o orçamento de preço unitário do Astra com base em 20%, mas a redução real deve considerar a taxa de acerto de cache, o comprimento do contexto e o volume de saída, e ser conferida com os dados da fatura |
| Equipes em processo de seleção | O preço padrão do Sol é cerca de 1/4 do Astra, o que acrescenta uma opção que vale a pena avaliar para tarefas sensíveis a custo |
| Usuários comuns do ChatGPT | Nesta rodada, a liberação ocorre gradualmente para ChatGPT Work, Codex e API; o Chat comum não está no escopo de lançamento desta fase |
I. Fatos objetivos sobre a redução de 20% no preço do GPT-6.2 Astra
O conteúdo a seguir vem da página oficial de lançamento da OpenAI, da documentação do modelo e da página de preços, com data de verificação em 18 de novembro de 2026. Todos os dados de avaliação são relatórios oficiais, não são resultados de testes realizados pela nossa equipe.
1.1 Informações básicas sobre o lançamento do GPT-6.2 Astra e do Sol
A OpenAI lançou o GPT-6.2 Astra e o GPT-6.2 Sol em 17 de novembro de 2026. Os dois modelos aceitam texto e imagens como entrada, geram texto como saída e não conseguem gerar vídeo nativamente.
Em relação ao escopo de disponibilização, a OpenAI informa que os novos modelos serão liberados gradualmente para usuários de ChatGPT Work, Codex e API; o Chat comum não faz parte desta rodada. O ritmo específico de liberação deve ser consultado na documentação de ajuda da OpenAI.
1.2 Preços padrão da API oficial do GPT-6.2 Astra
A tabela abaixo traz os preços oficiais da OpenAI no nível Standard, para entradas de até 272K tokens, em dólares por milhão de tokens — e não os preços da APIYI. O volume de saída é calculado pelo total de saída cobrado no campo usage, incluindo tokens de raciocínio, e não corresponde ao comprimento do texto visível.
| Modelo | Entrada sem cache | Leitura de cache | Saída | Fonte dos dados |
|---|---|---|---|---|
| GPT-6 Astra (geração anterior) | $10 | $1.00 | $50 | Página do modelo da OpenAI |
| GPT-6.2 Astra | $8 | $0.4 | $40 | Página do modelo da OpenAI / página de preços |
| GPT-6.2 Sol | $2 | $0.1 | $10 | Página do modelo da OpenAI / página de preços |
A OpenAI também tem duas regras de cobrança que merecem atenção:
- A gravação em cache é cobrada como uma tarifa independente: no Standard de contexto curto, a taxa de gravação do Astra é de $10 por milhão de tokens para 30 minutos e $20 por milhão de tokens para 12 horas — esse valor não é somado à entrada normal de $8. O mesmo token de entrada deve entrar em apenas uma categoria: entrada normal, leitura de cache ou gravação em cache com o tempo de vida correspondente. Não pode haver cobrança duplicada.
- Quando a entrada ultrapassa 272K tokens, as tarifas de entrada e de cache de toda a requisição passam a ser calculadas em dobro, e a tarifa de saída em 1,5 vez.
Em comparação com a geração anterior, a entrada sem cache do Astra caiu de $10 para $8, e a saída caiu de $50 para $40 — queda de 20% nos dois casos. É exatamente isso que significa “redução de 20%”: queda de 20% no preço unitário padrão.
1.3 Dados de avaliação oficiais do GPT-6.2 Astra (não medidos por nossa equipe)
A OpenAI apresentou alguns resultados de avaliação no anúncio de lançamento. Cada avaliação usa critérios diferentes, então não dá para misturar as leituras:
- GDPval v2: o GPT-6.2 Astra fica 6,2 pontos percentuais acima do GPT-6 Astra, com 22% menos tokens de saída; o GPT-6.2 Sol fica 5,3 pontos percentuais acima do GPT-6.1 Sol.
- ALE: o GPT-6.2 Astra melhora 5,2 pontos. Essa é outra avaliação e não pode ser somada nem comparada com os pontos percentuais do GDPval.
- FrontierCode 2.0: no nível de raciocínio max, a pontuação do Sol fica 0,5 ponto abaixo do Astra, com custo por tarefa de cerca de 1/5 do Astra. Isso vale apenas para esse teste e esse nível — não serve como conclusão genérica sobre custo.
1.4 Exemplo de cálculo próprio do custo de uma única requisição do GPT-6.2 Astra
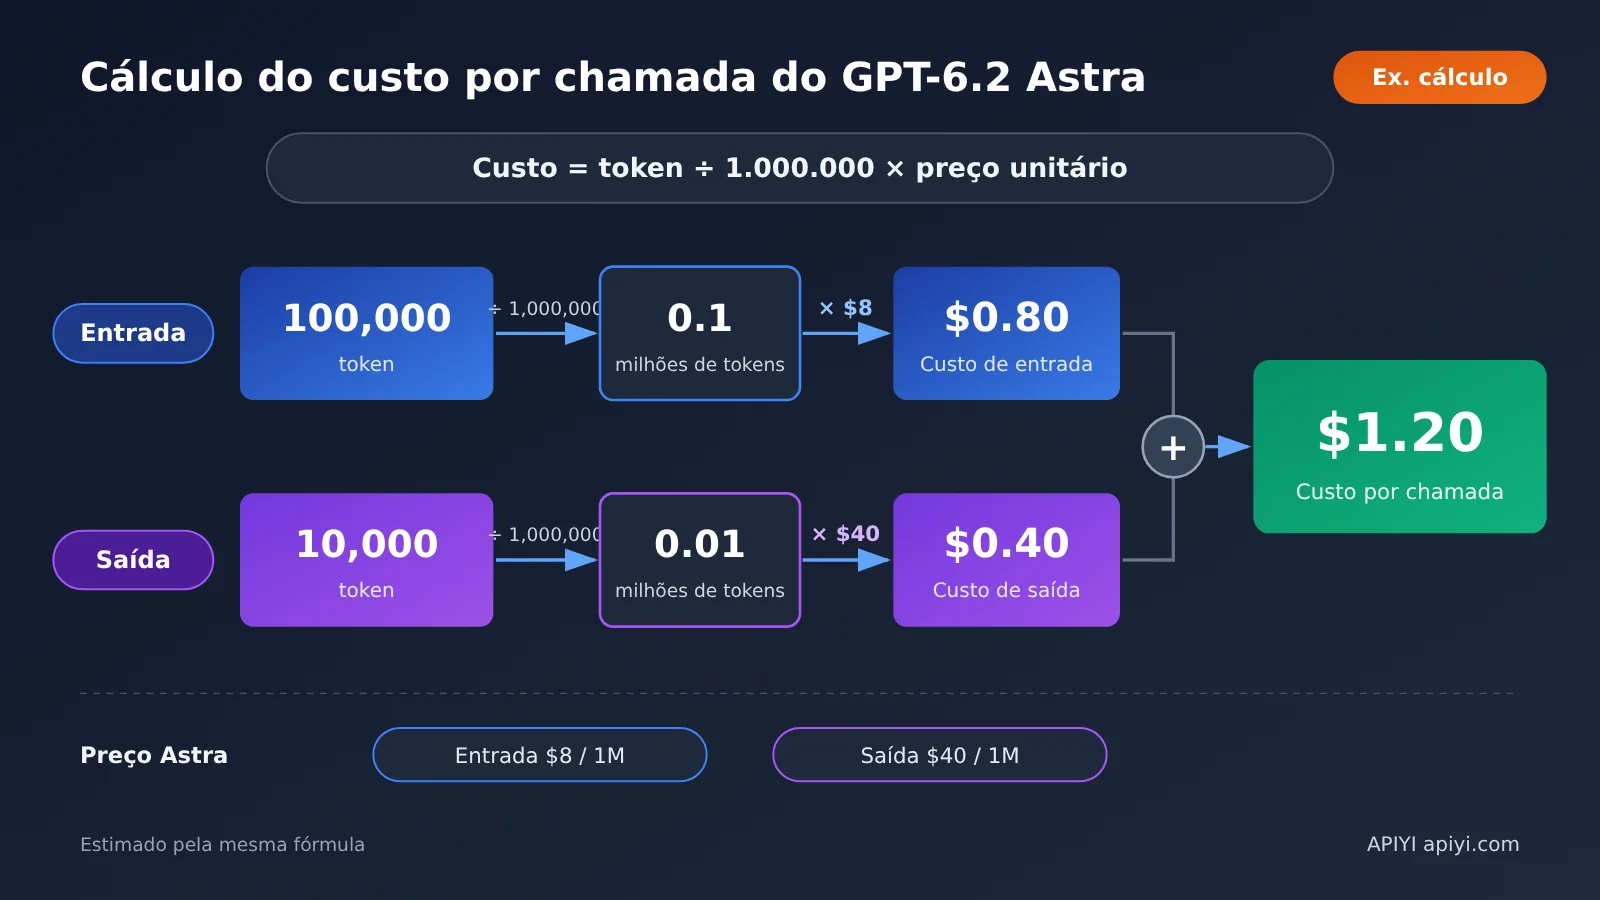
Os três grupos de cálculos abaixo são aritmética que fizemos com os preços unitários padrão do site oficial, não medições reais da API, e também não representam a fatura real de nenhuma conta. A fórmula de cálculo é:
Custo = número de tokens ÷ 1.000.000 × preço unitário por milhão de tokens
Cálculo 1: Requisição padrão, comparação entre Astra antigo e novo e Sol
Premissas: entrada não cacheada de 100.000 tokens, saída de 10.000 tokens, entrada não superior a 272K, sem leitura nem gravação de cache, sem chamadas de ferramentas, cobrado pelo preço padrão.
| Item | GPT-6 Astra | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|---|
| Custo de entrada | 0,1 × $10 = $1,00 | 0,1 × $8 = $0,80 | 0,1 × $2 = $0,20 |
| Custo de saída | 0,01 × $50 = $0,50 | 0,01 × $40 = $0,40 | 0,01 × $10 = $0,10 |
| Total por requisição | $1,50 | $1,20 | $0,30 |
| Em relação ao GPT-6 Astra | Referência | $0,30 a menos (-20%) | $1,20 a menos (-80%) |
Na tabela, “0,1” corresponde a 100.000 ÷ 1.000.000, e “0,01” a 10.000 ÷ 1.000.000. Se você enviar 10.000 requisições iguais por mês, com essas premissas, o GPT-6 Astra fica em cerca de $15.000 e o GPT-6.2 Astra em cerca de $12.000. Esse resultado é apenas uma extrapolação linear e não constitui nenhuma garantia de custo.
Cálculo 2: Requisição do GPT-6.2 Astra com acerto de cache
Premissas: entrada total de 100.000 tokens, dos quais 80.000 tokens acertam a leitura de cache, 20.000 tokens são entrada comum sem gravação em cache, saída de 10.000 tokens; o volume de gravação em cache nesta requisição é considerado zero, e o custo histórico de estabelecer o cache não entra neste cálculo.
- Entrada não cacheada: 0,02 × $8 = $0,16
- Leitura de cache: 0,08 × $0,4 = $0,032
- Saída: 0,01 × $40 = $0,40
- Total: cerca de $0,592
O preço de leitura de cache do GPT-6 Astra da geração anterior era $1,00 por milhão de tokens, e o da nova versão é $0,40, uma queda de 60%. Com o mesmo conjunto de tokens, o custo da geração anterior seria $0,20 + $0,08 + $0,50 = $0,78; a nova versão fica em $0,592, $0,188 a menos, uma queda de cerca de 24,1%. Ambos não incluem gravação de cache, ferramentas e outros custos, portanto não podem ser considerados uma fatura completa.
Cálculo 3: Requisição de contexto longo do GPT-6.2 Astra acima de 272K
Premissas: entrada comum de 300.000 tokens (acima de 272K), saída de 10.000 tokens, leitura e gravação de cache ambas zero.
- Entrada: 0,3 × ($8 × 2) = $4,80
- Saída: 0,01 × ($40 × 1,5) = $0,60
- Total: $5,40
Observe que a faixa escalonada é calculada para a requisição inteira. Assim que a entrada ultrapassa 272K, toda a entrada dessa requisição é cobrada com a tarifa em dobro, e não apenas a parte que excede o limite.
A configuração do tempo de vida do cache usa o prompt_cache_options.ttl da API Responses: o padrão é "30m", com a opção "12h", e cada ponto de interrupção explícito pode ser sobrescrito com prompt_cache_breakpoint.ttl. Ele representa o tempo de vida mínimo do cache, não um prazo para exclusão dos dados, e não deve ser confundido com o parâmetro prompt_cache_retention dos modelos antigos.
Quando a entrada ultrapassa 272K, o Astra na faixa Standard cobra, por milhão de tokens, $16 para entrada comum, $0.80 para leitura de cache, $20 para escrita de 30 minutos, $40 para escrita de 12 horas e $60 para saída; o multiplicador se aplica à requisição inteira, não apenas à parte excedente.
1.5 Fontes oficiais do GPT-6.2 Astra
-
Anúncio de lançamento da OpenAI: openai.com/index/introducing-gpt-6-2-astra-sol/
- Documentação do modelo GPT-6 Astra: preço oficial do modelo antigo
- Documentação do modelo GPT-6.2 Astra: preço oficial do novo modelo e condições de tarifação
- Documentação do modelo GPT-6.2 Sol: developers.openai.com/api/docs/models/gpt-6.2-sol
- Página de preços da API OpenAI: developers.openai.com/api/docs/pricing
- Documentação de ajuda do ChatGPT Work e Codex: help.openai.com/en/articles/20001275-chatgpt-work-and-codex
2. Análise e avaliação da redução de 20% no preço do GPT-6.2 Astra
A interpretação a seguir é feita pela editoria com base nos fatos acima; trata-se de análise e julgamento, não de uma conclusão oficial.
2.1 O preço unitário cai 20%; por que a fatura não necessariamente cai 20%?
O exemplo de cálculo 1 consegue chegar aos rigorosos 20% porque inclui apenas dois itens: entrada não cacheada e saída padrão. Ambos caíram exatamente 20%. As faturas de negócios reais geralmente são compostas por vários tipos de custos, e qualquer mudança proporcional em um item fará o desconto total se desviar dos 20%.
| Fator de custo | Possível impacto na fatura real | Base para o julgamento |
|---|---|---|
| Leitura e gravação de cache | O preço unitário da leitura de cache cai 60%, diferente dos 20% da entrada não cacheada; deve ser calculado conforme o número de tokens de cada um, não se pode presumir a redução total; a gravação de cache usa uma tarifa total independente, sem somar à taxa normal de entrada | Tabela de preços oficial |
| Escalonamento de contexto longo | Ao ultrapassar 272K, a tarifa de toda a solicitação aumenta; em cenários de documentos longos, o custo por solicitação pode ser significativamente maior que o do exemplo de cálculo 1 | Regras oficiais de cobrança |
| Quantidade de tokens de saída / raciocínio | A avaliação oficial no GDPval v2 relata 22% menos tokens de saída; se suas tarefas também tiverem mudança semelhante, a economia pode passar de 20%; se o nível de raciocínio for mais alto, também pode ficar mais caro | Avaliação oficial (tarefas específicas) |
| Chamadas de ferramentas e níveis de velocidade | O Fast do GPT-6.2 Astra custa o dobro da tarifa Standard para o mesmo contexto, e o Batch custa 50%; as taxas de ferramentas são calculadas separadamente conforme a ferramenta usada | Página oficial do modelo e página de preços |
| Canal de chamada | Ao chamar por plataformas de terceiros, como APIYI apiyi.com, prevalece a cobrança real divulgada pela plataforma; não se pode aplicar diretamente o preço oficial | Diferenças entre canais |
Um ponto facilmente esquecido é o “22% menos saída”. Esse número vem da avaliação GDPval v2. Se você o aplicar diretamente a todos os negócios e concluir que “a economia real é de mais de 30%”, estará tratando um resultado oficial de uma avaliação específica como regra geral. Uma abordagem mais segura é fazer um teste de pequena amostra com suas próprias solicitações reais, registrar o número de tokens no campo usage e então tirar conclusões.
2.2 Como decidir entre GPT-6.2 Astra e Sol
Considerando o preço unitário padrão, cada item do Sol custa cerca de 1/4 do Astra. No exemplo de cálculo 1, o custo por chamada do Sol é apenas um quarto do Astra. Os resultados do FrontierCode 2.0 mostram que, no nível de raciocínio max, a diferença entre Sol e Astra é pequena, mas a documentação oficial não afirma que essa conclusão se aplica a outras tarefas.
Portanto, nossa avaliação é: em cenários sensíveis a custo e com dificuldade média, vale a pena avaliar o Sol primeiro; em cenários que exigem alta qualidade ou tarefas complexas, a barreira de entrada do Astra também diminuiu após a redução de preço. A escolha final deve ser feita com um teste A/B no seu próprio conjunto de tarefas.
💡 Sugestão de seleção: se você precisa comparar o consumo de tokens e a qualidade de saída de vários modelos no mesmo código, considere alternar entre modelos por meio de uma interface agregadora compatível com OpenAI, como a APIYI apiyi.com. Se a série GPT-6.2 já está disponível na plataforma e quanto custa, consulte a lista de modelos e a página de cobrança da plataforma.
2.3 Código de estimativa de custo do GPT-6.2 Astra
O script abaixo faz apenas aritmética local, sem chamar a API. Ele divide a entrada em quatro categorias mutuamente exclusivas: entrada comum, leitura de cache, gravação de 30 minutos e gravação de 12 horas; o volume total de entrada é usado para determinar a faixa de 272K. A tarifa de gravação é a tarifa total, e não se soma novamente a tarifa de entrada comum aos tokens de gravação.
# Tarifas Standard da OpenAI, em dólares por milhão de token; não inclui ferramentas, impostos e outras faixas de preço
PRICES = {
    "gpt-6-astra":   {"input": 10.0, "cached": 1.0, "output": 50.0},
    "gpt-6.2-astra": {"input": 8.0, "cached": 0.4, "output": 40.0},
    "gpt-6.2-sol":   {"input": 2.0, "cached": 0.1, "output": 10.0},
}

def estimate_cost(model, ordinary_input, output_tokens, cached_read=0,
                  write_30m=0, write_12h=0):
    counts = (ordinary_input, output_tokens, cached_read, write_30m, write_12h)
    if any(n < 0 for n in counts):
        raise ValueError("token 数不得为负")
    p = PRICES[model]
    total_input = ordinary_input + cached_read + write_30m + write_12h
    im, om = (2.0, 1.5) if total_input > 272_000 else (1.0, 1.0)
    input_cost = (ordinary_input * p["input"] + cached_read * p["cached"]
                  + write_30m * p["input"] * 1.25
                  + write_12h * p["input"] * 2.5) * im
    return round((input_cost + output_tokens * p["output"] * om) / 1e6, 6)

print(estimate_cost("gpt-6-astra", 100_000, 10_000))  # 1.5
print(estimate_cost("gpt-6.2-astra", 100_000, 10_000))  # 1.2
print(estimate_cost("gpt-6.2-sol", 100_000, 10_000))  # 0.3
print(estimate_cost("gpt-6.2-astra", 20_000, 10_000, cached_read=80_000))  # 0.592
# Os mesmos 100 mil de entrada, todos cobrados como gravação de 30 minutos: não é 1.2 mais 1.0
print(estimate_cost("gpt-6.2-astra", 0, 10_000, write_30m=100_000))  # 1.4
Para o usage do Responses, primeiro identifique o volume de leitura de cache e o volume de gravação, e depois subtraia ambos do total de entrada para obter a entrada comum. Ao misturar vidas úteis de 30 minutos e 12 horas, também é preciso alocar o volume de gravação conforme o detalhamento real de cobrança; não se pode aplicar uma única tarifa a todas as gravações. Se o canal não tiver o detalhamento de gravação ou usar um critério de cobrança diferente, confira com a fatura desse canal e não assuma que o volume de gravação é zero. Quando a saída cobrada inclui tokens de raciocínio, não some novamente o volume de raciocínio. Este artigo não chamou a API de fato; se plataformas de terceiros suportam essas configurações e como cobram, consulte a documentação delas.
2.4 Sugestões para lidar com a redução de preço do GPT-6.2 Astra
Para desenvolvedores: primeiro levantem a distribuição do comprimento de entrada das requisições atuais, para ver quantas estão próximas ou passam dos 272K. Se a proporção de requisições com contexto longo for alta, dá para controlar a entrada dentro das faixas escalonadas usando fatias de recuperação, compressão por resumo e afins — a economia pode ser até maior do que os 20% da redução. Ao mesmo tempo, coloquem os comandos de sistema fixos no início da requisição, para aumentar a taxa de acerto do cache.
Para quem responde pelo orçamento: podem usar “queda de 20% no preço unitário padrão do Astra” como referência de base para o orçamento em igual volume de entrada e saída não cacheadas — não como limite máximo do decréscimo real nem como economia certa. A recomendação é comparar as faturas reais de um período antes e outro depois da migração, listando separadamente as mudanças em cache, contexto longo e tokens de saída. Equipes que chamam modelos por meio de plataformas como a APIYI apiyi.com também precisam seguir o critério de cobrança da fatura da plataforma.
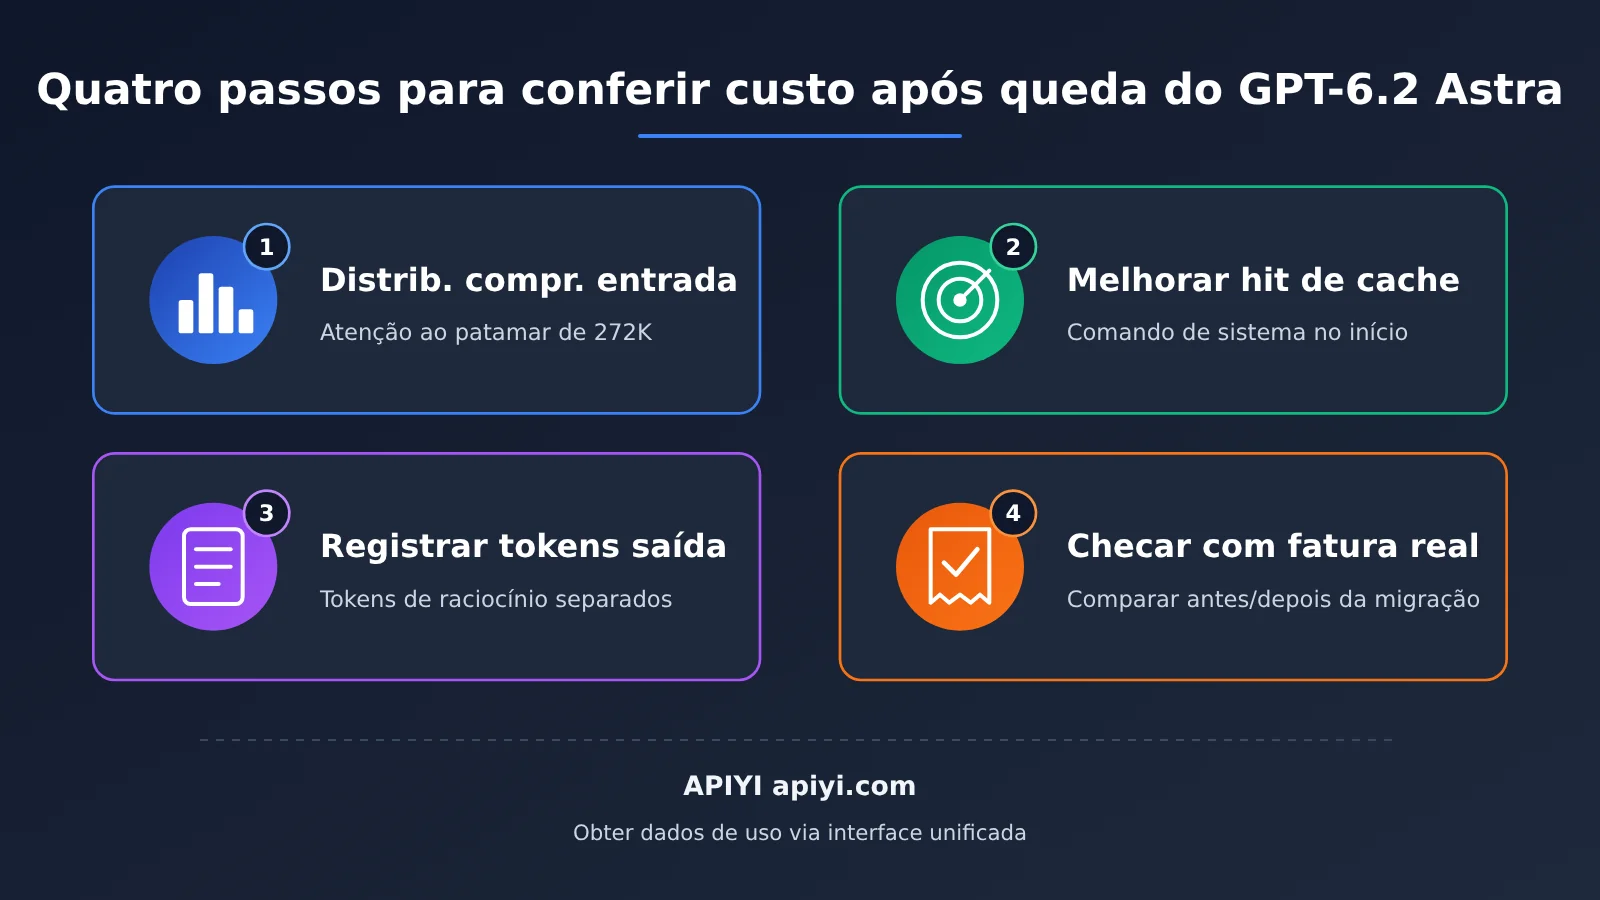
Pontos que ainda merecem atenção: atualizações oficiais de preço, andamento da abertura de canais e se avaliações independentes de terceiros conseguem reproduzir os dados oficiais. A documentação oficial já detalhou as tarifas de escrita de cache e de nível de velocidade, então, ao fazer a estimativa, é preciso conferir o nível escolhido — não tratem esses valores como se ainda não tivessem sido publicados. No novo Astra, em contexto curto Standard, a escrita de cache com retenção de 30 minutos é US$ 10/milhão de tokens, e com 12 horas é US$ 20/milhão de tokens; os três cálculos principais deste artigo assumem que o volume de escrita de cache nesta operação é zero, o que não significa que uma requisição padrão da API necessariamente não tenha escrita.
Se quiser primeiro passar pelo fluxo de conferência de cobrança, dá para comparar os dados de usage de modelos diferentes com o mesmo código em APIYI apiyi.com. Quando a série GPT-6.2 estiver disponível no canal que você usa, será possível simplesmente inserir os números reais de tokens nas funções de estimativa acima.
A redução de 20% é um sinal claro, mas os números na fatura dependem de quão longa é a entrada em cada requisição, de quantos acertos de cache acontecem e de qual é o volume de saída. Calcular bem cada multiplicação é mais útil do que decorar uma porcentagem.
“Beware of little expenses; a small leak will sink a great ship.”
——Benjamin Franklin, Poor Richard’s Almanack
(Fique atento às pequenas despesas; um pequeno vazamento basta para afundar um grande navio.)